💡 一句话总结:中国科大团队的 CPSE 解决一个特别真实的工程痛:schema 设计好了、下游接口也接好了,但 LLM 就是抽不可靠,而你只有三五份已核验的标注。它的做法是把 schema 拆成「冻结的结构契约 + 可变的字段语义」,用文本反馈自动校准提示词和字段描述,再让模型「先列材料清单、再按清单填空」------聚合物论文抽取提升 9.93 分,输出 100% 合法,接口一个字节没动。
导语:schema 不是设计出来的,是「调」出来的
先问一个做过文档抽取的朋友都懂的问题:你的抽取 prompt 迭代到第几版了?
典型剧情是这样的:产品定了一个几百个字段的 JSON schema,字段路径、类型、嵌套都跟下游系统焊死了。然后你开始写 prompt------「聚合温度要抽聚合时的温度,不要抽后期测试的温度」「缺测就填 null,别编」------跑一批文档,发现某个字段总串味,改一句描述;另一个字段总把相邻两个样品的值混到一起,再改一句。三百个字段这么手工试错下来,人对 schema 的热情基本就耗干了。
更扎心的是,这时候你手里可能只有几份专家核验过的标注------不算训练模型,够不着;纯手工调 prompt,调不动。这个夹缝里的活,论文给了个正式名字:few-instance schema calibration(少样本 schema 校准)------只有少量已核验抽取结果时,怎么系统地改字段语义,而不是傻试。
中科大团队的回答是 CPSE(contract-preserving semantic extraction,契约保持的语义抽取),核心主张就藏在标题里:改语义,别动结构。想自己看?资源在这:
想自己动手试?
- 📄 论文:arXiv 2609.34841
- 💻 代码:GitHub · yyhlm/CPSE
这篇论文到底想解决什么问题?
先拆一下「schema 执行不可靠」的病灶在哪。一个 JSON schema 规定了字段叫什么、什么类型、嵌套在哪,但它没规定的是操作语义:这个字段的证据在哪几页?单位怎么归一?两个样品的值怎么归属?「聚合温度」和「测试温度」差在哪?这些知识全存在领域专家脑子里,schema 本身不携带。
为什么不让自动 prompt 优化来救?现有的路子分两派,各有各的局限:
- 优化任务指令(OPRO、GEPA、MIPROv2 这些):改的是全局指导,字段级的「证据归属」问题它够不着------三百个字段的细微差别塞不进一段总指令。
- 优化 schema 本身(如 PARSE):直接改 schema 表示,抽取质量可能上去,但下游接口跟着变了------生产系统里这一步等于掀桌。
于是问题变成:在结构完全冻结的前提下,只用少量金标注,能不能把字段级语义校准到位?
它的思路是什么?
CPSE 的管线分四步,我们一步步看。
📐 第一步:归纳出「契约」,其余全部设为可变
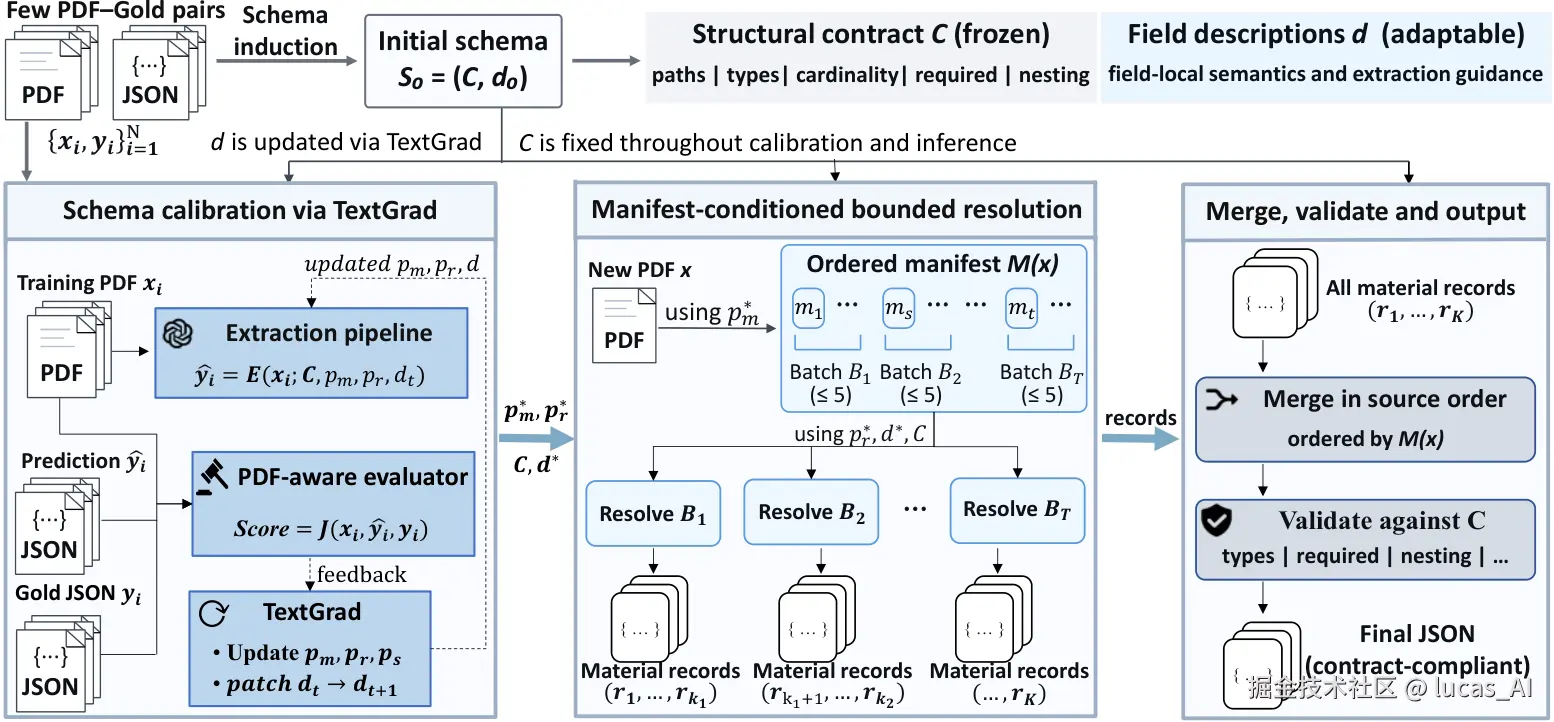
拿那 3 篇有专家标注的论文,先把结构契约 C 定下来:字段路径、类型、基数、必填性、嵌套关系------这些是下游接口,一个都不许动。同时让 LLM 生成每个字段的初始描述 d₀。之后整个优化过程中,只有字段描述和提示词能改,而且改描述只能打「稀疏补丁」------系统层有个 schema-patch 提示词专门负责把反馈转成 description-only 的补丁,想增删改名字段?门都没有。这一条硬约束保证了不管怎么优化,输出结构永远合规。
🔁 第二步:文本反馈校准(TextGrad 打底)
校准引擎用的 TextGrad(用文本「梯度」迭代改提示词的框架),但加了个关键设计:评估器是 PDF 感知 的------打分时拿着原始 PDF 对照金标注,反馈的是根因(「这个字段把 B 样品的值归给了 A 样品」),并且反馈会被聚合成可复用的规则 ,而不是「这篇论文如何如何」的琐碎事实。为什么要强调这个?后面审计有答案:作者检查了 581 个训练专属字符串,校准后的提示词一个都没复用------证明它学到的是规则,不是背题。这个防过拟合的自觉,很多 prompt 优化工作都欠着。
📋 第三步:先列清单------把「找身份」和「填记录」拆开
这是针对第二类失败模式的手术。聚合物论文常在一篇里塞几十种材料,传统单遍抽取让模型同时「发现有哪些材料」和「补全每种材料的完整记录」,实体一密集,记录边界就开始糊------A 样品的玻璃化转变温度跑到 B 样品头上。
CPSE 把它拆成两步:先让身份发现提示输出一份按原文出现顺序排列的材料清单 (每条含名称、类别、形态、结构特征、来源位置),重复身份合并;然后每次只取清单里最多 5 个身份的切片,让记录解析提示对着 PDF 逐片填完整记录,最后按源顺序确定性合并、跑契约校验。一次只填 5 个空,相邻样品串味的空间就被压住了。
效果到底怎么样?
实验设定:20 篇聚合物科学论文、专家标注 JSON,3 篇训练、17 篇 held-out;抽取模型 GPT-5.6-Sol(温度 0),校准 5 轮;评委打分用 100 分制 rubric(身份 10 + 工艺 30 + 性质 50 + 表征 10),配 paired-bootstrap 置信区间和盲测专家审计。主结果三句话:
- 绝对提升 :CPSE 拿 90.95 分,未校准单遍基线 76.45------+14.50,17 篇里 16 胜 1 平。
- 拆开看贡献 :对着「同样用清单执行但不做文本校准」的执行对齐基线 81.02,CPSE 还能再涨 +9.93(95% CI 5.12, 16.11,全正),说明分阶段执行和语义校准各有贡献、缺一不可。消融也印证:只调提示 +6.81,只调字段描述 +5.64,联合 +10.29------两层文本是互补的。
- 外部对照:把 GEPA(当前很强的 prompt 进化优化器)接到同样的清单执行上,拿 85.52,仍比 CPSE 低 5.43 分;OPRO、MIPROv2、固定 three-shot ICL 都更靠后,不给 schema 直接抽垫底。
两个特别有说服力的旁证:一是换了一个没参与校准的独立评委(Terra),提升趋势不变(+7.21);二是盲测专家审计------10 篇 × 8 条证据项,CPSE 78 条完全正确 vs 基线 62 条,8 篇改善 2 篇持平零回退(p=0.0078)。加上 schema 合法输出率从 94.1% 提到 100%,契约从头到尾没变过。
值得琢磨的三个细节
🎲 训练样本从 1 篇到 3 篇,提升不是单调涨的
有意思的是子集实验:1 篇范文平均 +3.48,2 篇反而 +2.23,3 篇 +9.93。低资源区间的收益不只看样本量,子集构成(那 1-2 篇论文覆盖了哪些字段形态)和优化过程的随机性都在搅局。想复现的朋友注意:范文挑得比多更重要,尽量让那几篇覆盖 schema 里最刁钻的字段用法。
🕳️ 清单漏了,后面全完
案例复盘里有个冷峻的发现:提升最大的案例(+49.2)是实体密集文档的记录边界修复,但方法的上界由身份发现那一步决定------清单里没列出的材料,下游永远救不回来。样品命名极不规范的文档,这一步的召回就是整个系统的天花板。
🧾 校准不是背题
「581 个训练专属字符串零复用」这条审计值得单独说。prompt 优化工作最容易被质疑的就是「你在训练集上过拟合提示词」,作者直接做了字符串级审计来自证清白------这个验证姿势本身就可以抄进你们的 prompt 优化流程。
能拿来做什么?
- 生产抽取系统的「交付后调优」:schema 已经接进下游、没法改结构,只有零星几份核验标注------这正是 CPSE 的主场,把它当 schema 交付流程里的一个标准工序。
- 科研数据管线的领域迁移:换一个新材料领域,不用重建系统,拿 3 篇领域金标注跑一遍校准即可。
- 任何「接口冻结 + 语义漂移」的场景:合同要素抽取、财报字段、医疗文书的结构化,逻辑同构。
泼冷水时间
- 评委和教练是同一个模型:主表的 Sol 分数来自「既当校准目标又当评委」的 GPT-5.6-Sol,虽然有独立评委 Terra 和盲测专家兜底、方向可信,但 +9.93 这个具体数字要留点余地(Terra 视角是 +7.21)。
- 规模与领域都很小:20 篇聚合物论文、一个 478 节点的 schema。换个字段更稀疏或证据更碎的领域,清单式方法是否还这么稳,论文没给证据。
- 省的是标注,不是算力:TextGrad 校准 + 双评委打分 + 逐片解析,全是强模型推理;「few-instance」指的是人只标 3 篇,不是便宜。
- 对照组全是 prompt 优化器,没跟化学/材料领域的专用 IE 系统(ChemDataExtractor 一类)比,「SOTA」只在自家赛道内成立。
理性看待
CPSE 最有价值的地方,是把一个散落在各家 prompt 里的手工活,抬成了一个有正式定义、有约束条件、有验证方法的工程阶段:schema calibration 是 schema design 之后的独立工序。契约冻结保证了它在生产里敢用,零字符串复用审计证明了它学的是规则而非记忆,「先清单后填空」则顺手解决了实体密集文档的老毛病。
对每天在「改一句 prompt 描述、跑一批、再改一句」的朋友,这篇的答案是:别再手工试错了,把字段描述变成可以被系统性优化的参数------但记得给你的下游接口上一把锁。
(数据与结论均来自论文原文,解读部分为作者观点,欢迎交流。)