一、前言:你的RAG系统,可能正在"高效地重复废话"
如果你正在做RAG项目,大概率经历过这样的场景:
向量相似度分数很高,检索结果看起来条条精准,可一送进大模型,回答却空洞、片面、车轱辘话来回说。你以为是生成模型不行,换了更大的模型,效果依然不理想。
问题很可能不在生成端,而在检索端------你检索到的内容,本身就是一堆"复读机式"的冗余信息。
大多数RAG优化文章都在讲嵌入模型微调、向量库选型、Chunk切片规则,却很少有人认真聊一个更隐蔽、更致命的问题:检索结果高度同质化。
传统Top-K检索只做一件事:找和用户问题最像的内容。但它从不关心------这些内容彼此之间是不是在重复同一件事。
结果就是:上下文窗口被重复信息塞满,真正有价值的其他维度信息进不来。大模型不是不会答,而是你根本没给它足够丰富的信息去答。
解决这个问题的核心方案,就是 MMR(Maximal Marginal Relevance,最大边际相关性) 算法。
这篇文章不堆学术公式,用生活化案例+实战逻辑,把MMR的原理、优势、调参技巧和落地场景一次讲透。读完你就能直接上手,用极低的成本换来RAG上下文质量的明显提升。
建议先收藏,后续做检索优化时直接对照落地。
二、传统Top-K检索:看似精准,实则是"复读机式检索"
2.1 核心逻辑
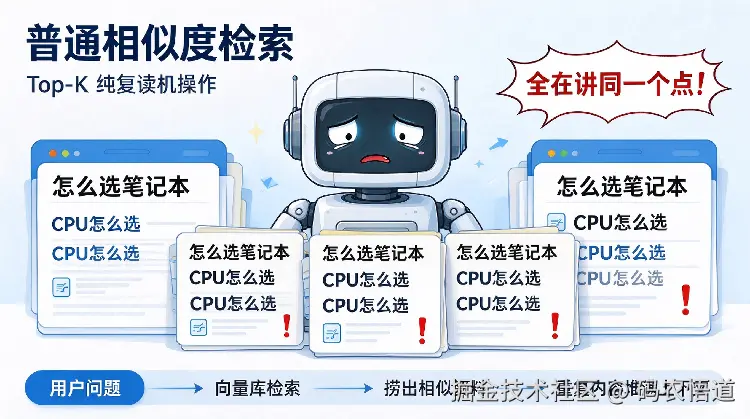
传统向量检索的逻辑非常单一:将用户Query和知识库所有文档做向量相似度计算,只根据相似度分数从高到低排序,直接返回前K条结果。
它的评判标准只有一个:和用户问题像不像,完全不考虑检索结果之间是否重复、是否冗余。
2.2 通俗实战案例
假设用户的查询需求是:怎么挑选一台好用的笔记本电脑。
Top-K检索会优先匹配语义最相近的内容,最终筛选出5条高相似度文档,内容大概率是这样的:
-
文档1:选购笔记本重点看CPU性能,CPU决定运行速度
-
文档2:挑选笔记本时,核心参数是CPU,高性能CPU更流畅
-
文档3:笔记本选购避坑:不要忽视CPU的版本和功耗
-
文档4:日常办公笔记本,优先选择主流中端CPU
-
文档5:游戏本和办公本的CPU选购区别
可以清晰看到:5条高匹配度内容,全程只围绕"CPU"一个点展开。虽然每一条都和用户问题高度相关,但内容高度同质化,属于无效冗余信息。
2.3 核心弊端
这种复读机式检索,会给RAG系统带来三大致命问题:
-
上下文浪费:有限的上下文窗口被重复内容挤占,没有空间容纳其他维度信息;
-
回答片面单一:大模型只能基于单一维度信息生成答案,无法给出全面、完整的解答;
-
推理效率降低:冗余文本增加大模型输入token,提升推理成本和耗时。
三、MMR算法:兼顾相关性与多样性的智能检索方案
3.1 MMR核心定位
MMR全称最大边际相关性,是RAG落地中解决检索冗余、提升上下文信息丰富度的核心算法。如果说Top-K是只会找相似的"机器复读机",那MMR就是懂得筛选、取舍的"智能资料管理员"。
它的核心设计思想:不盲目追求相似度最高,而是在保证内容和用户问题相关的前提下,最大化检索结果的多样性,剔除重复冗余内容。
3.2 MMR检索实战效果
同样面对用户查询「怎么挑选一台好用的笔记本电脑」,MMR的筛选逻辑完全不同:
第一步:优先选取相似度最高的「CPU选购技巧」作为核心基准内容;
第二步:自动剔除所有和已选内容高度重复的CPU相关文档;
第三步:在剩余候选池中,持续选取「和Query相关、和已选内容不重复」的新维度内容。
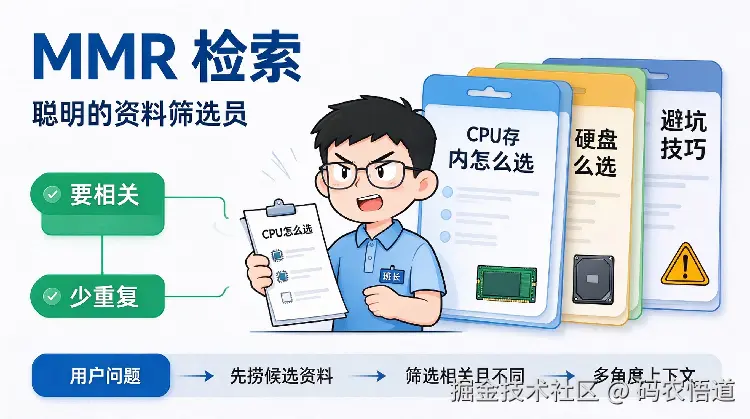
最终MMR筛选出的5条文档,会实现全维度覆盖、零核心冗余:
-
文档1:笔记本CPU选购核心技巧(核心相关性)
-
文档2:笔记本内存容量与频率选购指南(全新维度)
-
文档3:硬盘固态、机械硬盘选型区别(全新维度)
-
文档4:屏幕分辨率、色域选购参数解读(全新维度)
-
文档5:笔记本选购常见陷阱与避坑技巧(全新维度)
所有内容紧扣用户问题,同时互不重复、多角度补充,让送入大模型的上下文信息价值最大化。
3.3 MMR核心公式(人话通俗解读)
MMR的核心打分公式可以简化为:MMR分数 = query相关性分数 − 已选内容重复度分数
算法会通过贪心迭代的方式,逐一遍历候选文档,每次选取「相关性高、重复度低」的最优文档,直到选满预设条数,完美平衡精准度 和多样性。
四、关键参数λ:MMR的调参核心
λ(lambda)是MMR算法的唯一核心调节参数,取值范围0~1,直接决定检索的偏向性,是工程落地的关键调参点:
-
λ = 1(纯相关性模式):完全忽略内容重复度,只参考向量相似度,等价于传统Top-K检索,适合极致精准的单点查询;
-
λ = 0.5(平衡模式,工业默认最优):对半兼顾相关性和多样性,既保证内容不跑偏,又杜绝冗余,适配90%以上的RAG业务场景;
-
λ = 0(纯多样性模式):完全忽略和用户问题的相关性,只追求内容不一样,极易出现答非所问,业务中基本不使用。
五、落地场景:什么时候必须用MMR?什么时候不用?
5.1 优先使用MMR的场景
-
知识库切片同质化严重,大量Chunk语义重叠、内容重复;
-
用户需要多角度、全方位的解答(原理、方法、案例、避坑、方案对比);
-
上下文窗口有限,需要最大化利用有效信息,杜绝冗余占用;
-
通用问答、知识库咨询、产品手册答疑等综合性问答场景。
5.2 无需使用MMR的场景
-
单点事实查询:仅需要精准固定答案(如公司成立时间、接口地址、参数定义);
-
高精准、低发散的专业核验场景,不需要多角度补充。
六、工程极简落地代码(LangChain)
在LangChain中开启MMR检索无需复杂改造,仅需修改检索参数,一键替代传统Top-K:
python
from langchain.vectorstores import Chroma

# MMR检索配置:兼顾相关性与多样性
retriever = vectorstore.as_retriever(
    search_type="mmr",          # 开启MMR算法
    search_kwargs={
        "k": 5,                 # 最终返回5条最优文档
        "fetch_k": 20,          # 先批量捞出20条候选,再精细化筛选
        "lambda_mult": 0.5      # 平衡相关性与多样性
    }
)
核心优化点:通过 fetch_k 扩大候选池,再通过MMR算法精细化筛选,是业界通用的最优落地方式。
七、总结
传统Top-K检索的核心缺陷是重相似度、轻多样性,极易造成RAG上下文冗余、回答片面的问题。而MMR算法作为轻量化、低成本、高收益的检索优化方案,通过简单的贪心策略,完美平衡了检索精准度与内容多样性。
在RAG项目落地中,无需复杂模型优化,仅通过开启MMR检索、合理调节λ参数,就能大幅提升上下文质量,从根源上优化大模型的生成效果,是性价比极高的核心优化手段。
如果这篇文章帮你理清了MMR的落地思路,欢迎点赞、收藏,后续做检索优化时直接翻出来对照配置即可。