最近很多网友问我:
agent skill长得像什么样子?
agent skill 要如何自定义一个符合自己情况的?
发现网上视频好看,但对方不给ppt怎么办,总不能一直收藏吧?
为了一次性能够比较全面的回答问题,专门试验了下最大合集的实验。
第一部分 复盘「这个 Skill 是怎么从一次真实任务里被提炼出来的」 ------ 一套可迁移的**「把一次性任务沉淀为可复用 Skill」的方法论**;
第二部分 告诉别人「怎么用这个 Skill」。
附件会分享skill.md 以及运行记录
Part 1 · 从 0 到 1 诞生记(方法论,可迁移)
1.1 起点:一个真实的一次性任务
输入只有一句:「提取这个视频的 PPT、主要研究:」 。 当时没有任何现成流程,全部靠现场试错跑通。Skill 不是凭空写的,而是**把这次真实轨迹「复盘 → 抽象 → 封装」**得到的。
1.2 我实际经历了什么(真实轨迹,含踩坑)
这一步是诞生 Skill 的原材料------如果没有这些「真实的坑」,写出来的 Skill 就是空话。
| 阶段 | 发生了什么 | 遇到的坑 | 最终解法 |
|---|---|---|---|
| 环境 | 需要视频工具链 | 无 yt-dlp/ffmpeg;pip install 被 PEP 668 拦 |
brew install yt-dlp ffmpeg |
| 下载 | 抓取视频 | 仅有 danmaku 弹幕、无字幕 → 必须自己转写 |
yt-dlp 下载 1080P + ffmpeg 抽 16k 音频 |
| 转写 | faster-whisper |
HF 连接超时 → 换镜像后 Xet 401 → 又报 PyAV metadata_errors |
①HF_ENDPOINT=hf-mirror.com ②HF_HUB_DISABLE_XET=1 ③改用 ffmpeg 解码成 numpy 数组喂模型 |
| 抽帧 | 想用场景切换找翻页点 | 全片只有 6 处硬切(幻灯片是淡入淡出式换页,场景检测失灵) | 换思路:OCR 右下角页码角标 N/21 建时间线 |
| OCR | ocrmac 识别页码 |
language_preference 传 en/zh 直接报错 |
必须传全称 en-US / zh-Hans |
| 收敛 | 逐页抽帧 | 需要「内容最完整、且不是转场中间态」的一帧 | 取该页稳定段靠后处(b-4) |
| 结果 | --- | --- | 21 页全部拿到,报告完成 |
关键洞察 :真正让流程「稳」的,不是最初设想的方案(场景切换),而是换了观测信号(页码角标)。 这类「方案失效 → 换信号源」的经验,正是 Skill 里最值钱的部分。
1.3 提炼四步法:把「做过一遍」变成「任何人可重跑」
text
① 记录轨迹        ② 抽象步骤链        ③ 沉淀坑与对策       ④ 按规范封装
(命令/产物/报错) → (参数化的最小链路) → (现象→原因→处理) → (front-matter+六段式)
第 ① 步 记录轨迹:完整保留「执行了哪些命令、产生了哪些文件、报了什么错」。
第 ② 步 抽象 + 参数化:把本例专属值抽成变量,让流程能套用到任意视频。
| 变量 | 作用 | 示例 |
|---|---|---|
URL |
视频地址 | https://www.bilibili.com/video/BV... |
WORK |
输出目录 | video_demo |
LANG |
转写语言(空=自动) | zh |
TOTAL |
页码分母/总页数 | 21 |
STEP |
角标抽样间隔(秒) | 2 |
CROP |
角标裁切表达式 | iw*0.16:ih*0.10:iw*0.84:ih*0.90 |
第 ③ 步 沉淀「坑 → 对策」:把 1.2 表格里的每一行,改写为一条「现象 → 原因 → 处理」的 if-then,全部写进 Skill 的「失败怎么办」。
第 ④ 步 按规范封装:套用本仓库既有的 Skill 格式(见 1.4)。
1.4 本仓库的 Skill 封装规范
-
放置位置 :
agent/skills/*.md(或agent/*.md)------由agent/skills.py的discover_skills()扫描。 -
front-matter(决定能否被发现):
markdown--- type: skill name: video_slides_extract description: "一句话说清技能能干什么" tags: [视频, PPT, OCR, ...] --- -
正文六段式(照抄这个骨架即可):
- 何时使用(含反例)
- 前置准备(只做一次的环境/变量)
- 步骤预算(长任务提示、省时捷径)
- 执行步骤(第 1~N 步,每步给可复制命令)
- 失败怎么办(现象→原因→处理)
- 输出要求(产物清单、不允许编造等)
-
设计原理·渐进式披露 :Skill 的 name+description 常驻 system prompt (让模型「知道有它」), 正文不进 prompt ,模型需要时自己
cat读取------既省上下文,又把「用不用」的决定权交给模型。
1.5 一个好 Skill 的 7 条标准(自检清单)
- 1. 何时使用 明确,且写出反例(不适合的场景)
- 2. 命令可复制即用(不是伪代码)
- 3. 全部参数化(URL/语言/总页数/步长...都有变量位)
- 4. 坑与对策齐全(每个真实报错都有一条 if-then)
- 5. 幂等 / 增量落盘 (长任务被打断能续跑,如
fh.flush()) - 6. 输出物明确且可验证(列出要产出哪些文件)
- 7. 只写「用哪些命令、按什么顺序、看什么输出、失败怎么办」,不写复杂代码逻辑
1.6 通用模板(可套用到任何「把任务变成 Skill」)
markdown
---
type: skill
name: <英文短名>
description: "<一句话:做什么、用什么手段>"
tags: [<标签1>, <标签2>]
---

# 技能:<中文名>(<name>)

## 何时使用
- 触发场景...;反例:...不适合

## 前置准备(只做一次)
1. 依赖安装:`...`

## 步骤预算
- 长任务提示 / 省时捷径 / 命令条数上限

## 执行步骤
### 第 1 步:...(命令)
```bash
<可复制命令>
失败怎么办
- 现象 → 原因 → 处理
shell 引号避坑(重要)
- heredoc 落盘、变量同命令 export ...
输出要求
- 产物清单;不编造;时间敏感信息标注抓取时间
1.7 验收:确认 Skill 已被加载
bash
cd agent && python3 -c "import sys;sys.path.insert(0,'.');from pathlib import Path;from skills import discover_skills,skills_overview;print(skills_overview(discover_skills(Path('.'))))"看到 video_slides_extract 出现在技能表里,即表示从 0 到 1 完成闭环 (本仓库实测输出:['baidu_search', 'video_slides_extract'])。
1.8 怎么分享给别人
| 分享内容 | 对方要做的 |
|---|---|
agent/skills/video_slides_extract.md |
放进自己工作区的 agent/skills/(或 agent/)下,即可被 Agent 发现并按需读取 |
| 本文档 | 用于理解「怎么造 + 怎么用」,可作团队 Skill 写作模板 |
video_bv16yhd6bedf/ |
作为「跑通样例 / 参考实现」,对照检查自己的产物 |
分享前提醒:视频、逐字稿、幻灯片属原视频作者版权,仅作学习与研究用途,请勿二次分发受版权保护的内容。
Part 2 · 使用指南(给别人用)
2.1 一句话说明
给一个视频链接,自动产出:每页幻灯片图片 + 每页文字 + 全程逐字稿 + 一份图文报告(含主要内容/研究归纳)。
text
视频链接
  │ ① yt-dlp 下载视频
  ▼
video.mp4 ──② ffmpeg 抽音频──▶ audio.wav
  │                                  │
  │                       ③ faster-whisper 转写
  │                                  ▼
  │                          transcript.txt / .srt(逐字稿)
  │
  │ ④ 裁右下角页码角标 → OCR → "时间→页码"时间线
  ▼
corner_pages.txt ──⑤ 每页抽全分辨率帧 + Vision OCR──▶ slides/slide_XX.png + .txt
                                                             │
                                              ⑥ 汇总 ────────▶ README.md(图文报告)
2.2 适用 / 不适用
| 说明 | |
|---|---|
| ✅ 适合 | 「幻灯片 + 讲解」型视频:课程、技术分享、论文解读、发布会、AI 生成课件 |
| ⚠️ 部分适合 | 纯口播(无幻灯片):只能拿到逐字稿与要点,抽不到 PPT |
| ❌ 不适合 | 游戏直播、纯实拍/演示类画面(幻灯片定位会失效,需改用帧差兜底或放弃抽帧) |
2.3 环境依赖
- 操作系统 :macOS(OCR 用系统 Vision 框架,识别中文效果最好且无需下载模型)。
- 非 macOS 见 2.7 FAQ 的降级方案(改用
tesseract)。
- 非 macOS 见 2.7 FAQ 的降级方案(改用
- 命令行工具 :
yt-dlp、ffmpeg、uv(用brew安装)。 - Python 依赖 :
faster-whisper、pillow、ocrmac(由uv建独立 venv 安装)。 - 网络 :需能访问 B 站/YouTube 与 HuggingFace 镜像(
hf-mirror.com)。
2.4 两种使用方式
方式 A(推荐):交给 Agent 自动执行
前提:技能文件已放在工作区的 agent/skills/ 下(本仓库即如此)。
- 确认技能已被加载(可选):
bash
cd agent && python3 -c "import sys;sys.path.insert(0,'.');from pathlib import Path;from skills import discover_skills;print([s.name for s in discover_skills(Path('.'))])"预期输出包含 video_slides_extract。 2. 直接对话触发,例如:
帮我把这个视频的 PPT 和主要内容提取出来:
https://www.bilibili.com/video/BV16yhd6BEdf
- Agent 会先
cat agent/skills/video_slides_extract.md读取全文,再严格按文档步骤执行命令(这是本仓库 Skill 的「渐进式披露」机制:摘要常驻、正文按需读取)。
方式 B:手动照着文档跑
打开 agent/skills/video_slides_extract.md,按其中「执行步骤」1~7 逐步执行即可(每一步都给了可直接复制的命令与脚本)。
2.5 快速上手(复制即用)
bash
# 0) 准备
which yt-dlp ffmpeg uv || brew install yt-dlp ffmpeg uv
URL="https://www.bilibili.com/video/BV16yhd6BEdf"
WORK=video_demo; mkdir -p "$WORK" && cd "$WORK"
uv venv --python 3.12 .venv && uv pip install --python .venv faster-whisper pillow ocrmac

# 1) 看元信息 + 是否有官方字幕(有字幕就优先用,能省 20 分钟)
yt-dlp --no-warnings --skip-download --print "TITLE:%(title)s|DUR:%(duration)s" "$URL"
yt-dlp --no-warnings --skip-download --list-subs "$URL"

# 2) 下载 + 抽音频
yt-dlp --newline -f "bv*[height<=1080]+ba/b[height<=1080]" --merge-output-format mp4 -o "video.%(ext)s" "$URL"
ffmpeg -y -v error -i video.mp4 -vn -ac 1 -ar 16000 audio.wav

# 3) 转写(脚本 transcribe_av.py 见技能文档;含绕开 PyAV 版本坑的处理)
export HF_ENDPOINT=https://hf-mirror.com; export HF_HUB_DISABLE_XET=1
.venv/bin/python transcribe_av.py audio.wav large-v3 transcript zh   # ~20 分钟(CPU)

# 4) 定位每页(页码角标 OCR,脚本见技能文档)
.venv/bin/python detect_corner_pages.py video.mp4 21 2                # ~15 分钟

# 5) 每页抽帧 + OCR,产出 slides/
.venv/bin/python finalize_slides.py video.mp4 corner_pages.txt

# 6) 合并成 README.md 报告(人工/由 Agent 归纳)
transcribe_av.py、detect_corner_pages.py、finalize_slides.py三个脚本的完整代码在技能文档里, 用cat > xxx.py <<'PY' ... PY一次性落盘即可。
2.6 产物长什么样(真实案例)
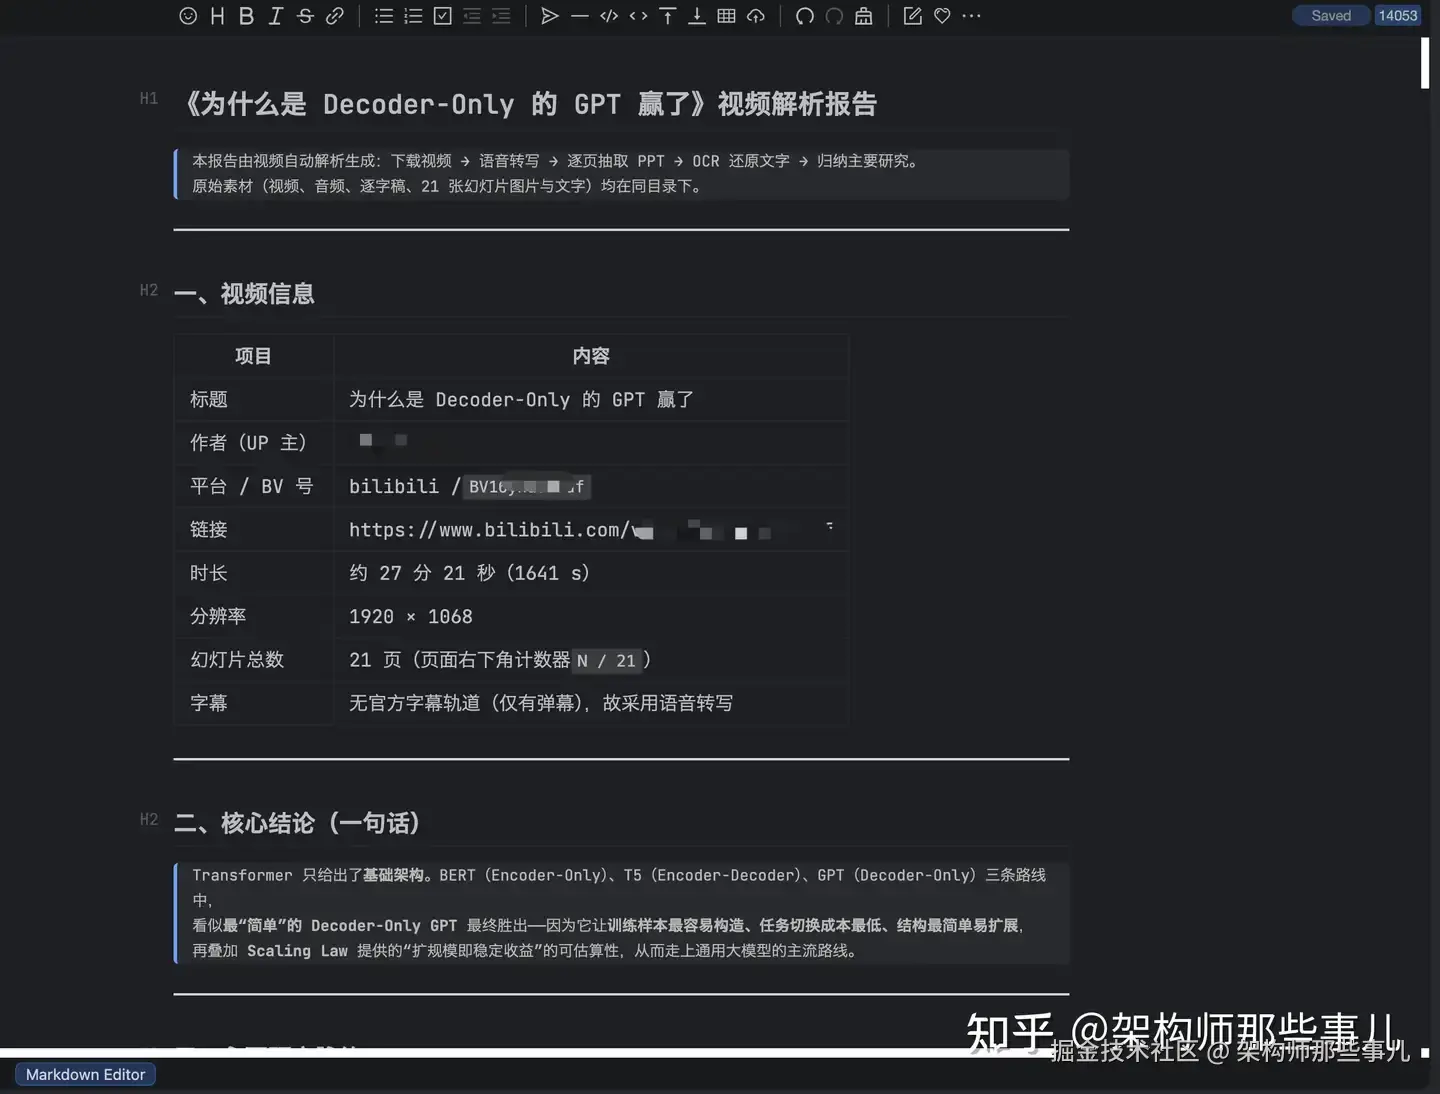
以 BV16yhd6BEdf(《为什么是 Decoder-Only 的 GPT 赢了》,27 分钟,21 页)为例:
| 产物 | 说明 |
|---|---|
slides/slide_01.png ... slide_21.png |
21 张全分辨率幻灯片(1920×1068) |
slides/slide_XX.txt |
每页 OCR 文本(含少量噪声) |
slides/_index.txt |
页码 ↔ 时间区间 ↔ 抽帧时间 ↔ 图片路径 |
transcript.txt / .srt |
924 段逐字稿(纯文本 + 带时间戳) |
README.md |
图文报告:视频信息 + 核心结论 + 研究脉络 + 21 页逐页还原 + 术语纠错表 |
video.mp4 / audio.wav / corner_pages.txt / *.py |
原始素材与可复现脚本 |
2.7 常见问题(FAQ)
| 现象 | 原因 | 处理 |
|---|---|---|
yt-dlp 报 403 / 拿不到 1080P 高码率 |
需登录/大会员 | 加 --cookies-from-browser chrome,或降档 height<=720 |
转写报 open() got an unexpected keyword argument 'metadata_errors' |
PyAV 与 faster-whisper 版本不兼容 | 已用「ffmpeg 解码成 numpy」绕过;或 uv pip install -U faster-whisper av |
模型下载超时 / 401 ... xethub |
HuggingFace 不可达 | 同一条命令里设 HF_ENDPOINT=https://hf-mirror.com 与 HF_HUB_DISABLE_XET=1 |
ValueError: Invalid language preference |
ocrmac 只认全称 locale |
用 zh-Hans / en-US,不要写 zh/en |
| 只识别到几页 / 页码读不出 | 角标不在右下角 / 无页码 | 调 detect_corner_pages.py 的 crop 参数;或改用帧差兜底(技能文档第 5 步) |
| 抽到的帧是转场中间态(发虚) | 取帧时刻太靠页尾 | 把代表时刻改为该页段中点 int((a+b)/2) |
非 macOS 用不了 ocrmac |
Vision 仅 macOS | brew install tesseract tesseract-lang → tesseract x.png out -l chi_sim+eng |
2.8 成本与耗时预期(27 分钟视频,CPU 转写)
| 阶段 | 耗时 | 加速手段 |
|---|---|---|
| 下载 | < 1 分钟 | 降分辨率 |
| 转写(large-v3, int8) | ~20 分钟 | 换 small/medium;或有字幕直接跳过 |
| 页码角标 OCR(每 2 秒一帧) | ~15 分钟 | 加大步长(如 5 秒);缩小裁切区域 |
| 抽帧 + 每页 OCR | ~1 分钟 | --- |
附:一页速览
| 问题 | 答案 |
|---|---|
| 这是什么 | 从视频提取 PPT 图片+文字、逐字稿与主要内容归纳的 Skill |
| 怎么用 | 对 Agent 说「提取这个视频的 PPT:」,或照技能文档手动跑 |
| 核心难点 | 无字幕要转写;渐变翻页导致场景检测失灵 → 改用页码角标 OCR;HF 需镜像+禁 Xet;PyAV 版本坑 |
| 怎么造出来 | 记录真实轨迹 → 参数化步骤链 → 沉淀坑与对策 → 按六段式规范封装 → discover_skills 验收 |
| 通用性 | 「记录→抽象→沉淀→封装→验收」五步可迁移到任意任务 |
附:video_slides_extract.md
python
type: skill
name: video_slides_extract
description: "从视频(B站/YouTube 等)提取 PPT 幻灯片、逐字稿与主要内容:yt-dlp 下载 → ffmpeg 抽音频 → faster-whisper 转写 → 页码角标 OCR 定位每页 → 抽全分辨率帧 + Vision OCR → 汇总成报告"
tags: [视频, PPT, 幻灯片, 转写, OCR, 字幕, bilibili, yt-dlp, ffmpeg, whisper]
---
# 技能:视频 PPT / 主要内容提取(video_slides_extract)
> 本文件是「技能文档」:Agent 通过 `cat agent/skills/video_slides_extract.md` 读到它,照着下面的命令一步步执行。
> 目标产物:**每个幻灯片一页全分辨率图片 + 每页 OCR 文字 + 全程逐字稿 + 一份图文报告**。
> 参考实现(一次真实跑通的结果)见工作区 `video_bv16yhd6bedf/`。
## 何时使用
- 用户给出**视频链接**,要求「提取 PPT / 课件 / 幻灯片」「总结视频的主要研究 / 内容」「把视频转成文字 / 字幕」;
- 视频形态是「**幻灯片 + 讲解**」(课程、技术分享、论文解读等),需要还原图文内容;
- 需要**逐页对齐**(第几页讲什么、在视频第几秒)。
## 前置准备(只做一次)
1. 确认/安装工具(macOS 用 brew;缺什么装什么):
```bash
which yt-dlp ffmpeg uv || brew install yt-dlp ffmpeg uv
```
2. 建工作目录(`$WORK` 换成有意义的短名,如 `video_bv16yhd6bedf`):
```bash
WORK=video_demo; mkdir -p "$WORK" && cd "$WORK"
```
3. **HuggingFace 常不可达**:转写前必须设镜像并禁用 Xet,否则下载模型会超时/401。
> 变量跨命令不保留,`export` 要和后面的 python 命令写在**同一条命令**里。
>
```bash
export HF_ENDPOINT=https://hf-mirror.com; export HF_HUB_DISABLE_XET=1; echo "hf mirror set"
```
4. Python 环境(用 uv,避免污染系统 Python):
```bash
uv venv --python 3.12 .venv && uv pip install --python .venv faster-whisper pillow ocrmac
```
## 步骤预算(很重要)
- 下载、转写、逐帧 OCR 都是**长任务**:合并命令、能后台跑就后台跑(转写 27 分钟视频约 20 分钟;页码 OCR 约 15 分钟)。
- **有官方字幕就优先用字幕**(第 1 步判定),跳过第 4 步转写,能省最多时间。
- 每个阶段产出的中间文件都**增量落盘**(`fh.flush()`),长任务被超时打断也能续跑。
## 执行步骤
### 第 1 步:读元信息 + 查字幕(先决定要不要转写)
```bash
yt-dlp --no-warnings --skip-download --print "TITLE:%(title)s|DUR:%(duration)s|UP:%(uploader)s" "$URL"
yt-dlp --no-warnings --skip-download --list-subs "$URL"
```
判定:
- 列表里出现 `zh-Hans / zh-CN / en` 等**语言字幕**(不是 `danmaku`)→ 走「优先用字幕」:
```bash
yt-dlp --no-warnings --skip-download --write-subs --sub-langs "zh-Hans,zh-CN,en" --convert-subs srt -o "sub.%(ext)s" "$URL"
```
得到 `sub.zh-Hans.srt` 即为逐字稿,跳到第 3 步。
- 只有 `danmaku`(弹幕)或无字幕 → **必须自己转写**(第 4 步)。
- 记录视频时长(秒),用于估算转写耗时与抽样步长。
### 第 2 步:下载视频
```bash
yt-dlp --newline -f "bv*[height<=1080]+ba/b[height<=1080]" --merge-output-format mp4 -o "video.%(ext)s" "$URL"
ls -lh video.mp4
```
> 1080P 高码率 / 4K 常需大会员 Cookie;拿不到就退回 `height<=1080` 的普通档即可,抽帧 OCR 足够清晰。
### 第 3 步:抽音频(16kHz 单声道,转写必需)
```bash
ffmpeg -y -v error -i video.mp4 -vn -ac 1 -ar 16000 audio.wav && ls -lh audio.wav
```
### 第 4 步:语音转写(写脚本再跑,别硬塞一行)
> **关键坑**:`faster-whisper` 走 `av.open(..., metadata_errors=...)`,某些 PyAV 版本没有该参数会报
> `TypeError: open() got an unexpected keyword argument 'metadata_errors'`。
> 解决办法:**不让它读文件**,改用 ffmpeg 把音频解码成 float32 numpy 数组再喂给模型(下面脚本已内置)。
先把转写脚本落盘(`<<'PY'` 加引号,避免 `$`/反斜杠被 shell 解释):
```bash
cat > transcribe_av.py <<'PY'
"""视频/音频 -> 逐字稿:ffmpeg 解码 + faster-whisper(绕过 PyAV 版本问题)。
用法: python transcribe_av.py <media> [model] [out_prefix] [lang]
model 默认 large-v3;lang 留空则自动识别(中文视频传 zh 更稳)。
"""
import subprocess, sys
import numpy as np
from faster_whisper import WhisperModel
def load_audio(path, sr=16000):
cmd = ["ffmpeg", "-nostdin", "-v", "error", "-i", path,
"-f", "f32le", "-ac", "1", "-ar", str(sr), "-"]
return np.frombuffer(subprocess.run(cmd, capture_output=True, check=True).stdout, dtype=np.float32)
def ts(t):
h = int(t // 3600); m = int((t % 3600) // 60); s = t % 60
return f"{h:02d}:{m:02d}:{s:06.3f}".replace(".", ",")
media = sys.argv[1]
model_size = sys.argv[2] if len(sys.argv) > 2 else "large-v3"
prefix = sys.argv[3] if len(sys.argv) > 3 else "transcript"
lang = sys.argv[4] if len(sys.argv) > 4 else None
model = WhisperModel(model_size, device="cpu", compute_type="int8", cpu_threads=8)
segments, info = model.transcribe(
load_audio(media), language=lang, beam_size=5, vad_filter=True,
vad_parameters=dict(min_silence_duration_ms=500),
)
print("lang:", info.language, round(info.language_probability, 2), flush=True)
plain, srt = [], []
for i, seg in enumerate(segments, 1):
text = seg.text.strip()
if not text:
continue
plain.append(text)
srt.append(f"{i}\n{ts(seg.start)} --> {ts(seg.end)}\n{text}\n")
print(f"[{seg.start:8.1f}] {text}", flush=True)
open(prefix + ".txt", "w", encoding="utf-8").write("\n".join(plain) + "\n")
open(prefix + ".srt", "w", encoding="utf-8").write("\n".join(srt))
print("DONE", len(plain))
PY
```
跑转写(`export` 与运行写同一条命令;27 分钟视频约 20 分钟):
```bash
export HF_ENDPOINT=https://hf-mirror.com; export HF_HUB_DISABLE_XET=1; \
.venv/bin/python transcribe_av.py audio.wav large-v3 transcript zh
```
> 字幕已有则跳过本步;ASR 会把专有名词听错(如 JPT→GPT、Board/Bolt→BERT、Skilling Law→Scaling Law),
> 报告阶段需按上下文纠正。
### 第 5 步:定位每一页幻灯片(首选用「页码角标」)
幻灯片通常在角落有页码 `N / 总页数`(本项目在**右下角**,如 `11 / 21`)。
按固定时间间隔裁切该角标并 OCR,即可得到「时间 → 页码」时间线,**比场景切换更稳**(淡入淡出/动画切页也能识别)。
先用一张全帧确认角标位置(可选,`bbox` 的 y 以**底边**为原点):
```bash
cd .. && ffmpeg -y -v error -ss 600 -i video.mp4 -frames:v 1 probe.png && cd - >/dev/null; \
.venv/bin/python -c "from ocrmac import ocrmac; [print(r) for r in ocrmac.OCR('probe.png', language_preference=['zh-Hans','en-US']).recognize() if '/ 21' in r[0] or '/21' in r[0]]"
```
把「裁角标 + OCR」脚本落盘(默认裁右下角 16%×10%,每 2 秒一帧,可调):
```bash
cat > detect_corner_pages.py <<'PY'
"""用右下角页码角标建立 时间->页码 时间线。
用法: python detect_corner_pages.py <video> [total] [step] [crop]
total 页码分母(如 21);step 抽样间隔秒;crop 为 ffmpeg crop=w:h:x:y 表达式。
"""
import glob, os, re, subprocess, sys
from ocrmac import ocrmac
video = sys.argv[1]
total = sys.argv[2] if len(sys.argv) > 2 else "21"
step = float(sys.argv[3]) if len(sys.argv) > 3 else 2.0
crop = sys.argv[4] if len(sys.argv) > 4 else "iw*0.16:ih*0.10:iw*0.84:ih*0.90"
os.makedirs("corner", exist_ok=True)
subprocess.run(["ffmpeg", "-y", "-v", "error", "-i", video, "-vf",
f"fps=1/{step},crop={crop},scale=iw*4:ih*4", "corner/c_%05d.png"], check=True)
files = sorted(glob.glob("corner/c_*.png"))
pat = re.compile(rf"(\d{{1,2}})\s*/\s*{total}")
fh = open("corner_pages.txt", "w", encoding="utf-8")
for i, f in enumerate(files):
t = i * step
txt = " ".join(r[0] for r in ocrmac.OCR(f, language_preference=["en-US", "zh-Hans"]).recognize())
m = pat.search(txt)
p = int(m.group(1)) if m else None
fh.write(f"{t:.0f}\t{p if p is not None else ''}\n"); fh.flush()
if i % 50 == 0:
print(i, len(files), t, p, flush=True)
fh.close()
PY
```
```bash
.venv/bin/python detect_corner_pages.py video.mp4 21 2
```
**兜底:视频没有页码角标**时,改用「场景切换 + 帧差」找切页点:
```bash
mkdir -p thumbs && ffmpeg -y -v error -i video.mp4 -vf "fps=1,scale=320:-1" -q:v 5 thumbs/f_%05d.jpg
# 逐秒算相邻帧灰度差,差值尖峰处即切页点(幻灯片切换通常 diff 远大于动画/光标)
.venv/bin/python - <<'PY'
import glob, numpy as np
from PIL import Image
fs = sorted(glob.glob("thumbs/*.jpg"))
a = [np.asarray(Image.open(f).convert("L"), dtype=np.float32) for f in fs]
d = np.array([0.0] + [float(np.mean(np.abs(a[i]-a[i-1]))) for i in range(1, len(a))])
th = max(15.0, float(np.percentile(d, 99))) # 阈值:或人工看分布定
print("切页秒点:", [i for i in range(len(d)) if d[i] > th])
PY
```
### 第 6 步:每页抽全分辨率帧 + OCR → `slides/`
把「按时间线抽帧 + OCR + 重建文本行」脚本落盘(`bbox` 以底边为原点,按 y 聚成行、按 x 排序):
```bash
cat > finalize_slides.py <<'PY'
"""按 corner_pages.txt 每页抽一张全分辨率帧并 OCR。
用法: python finalize_slides.py [video] [tl_file]
"""
import os, subprocess, sys
from ocrmac import ocrmac
video = sys.argv[1] if len(sys.argv) > 1 else "video.mp4"
tl = sys.argv[2] if len(sys.argv) > 2 else "corner_pages.txt"
OUT = "slides"; os.makedirs(OUT, exist_ok=True)
for f in os.listdir(OUT):
if f.endswith((".png", ".txt")):
os.remove(os.path.join(OUT, f))
# 读时间线 -> 前向填充 -> 压成 runs
raw = []
for line in open(tl, encoding="utf-8"):
t, _, p = line.rstrip("\n").partition("\t")
raw.append((float(t), int(p) if p.strip() else None))
seq, last = [], None
for t, p in raw:
if p is not None:
last = p
seq.append((t, last))
runs = []
for t, p in seq:
if runs and runs[-1][2] == p:
runs[-1][1] = t
else:
runs.append([t, t, p])
def lines(res):
items = [(r[0], r[2][0], r[2][1], r[2][2], r[2][3]) for r in res]
items.sort(key=lambda it: -(it[2] + it[4] / 2))
rows = []
for text, x, y, w, h in items:
cy = y + h / 2
for ln in rows:
if abs(ln["cy"] - cy) <= max(h, ln["h"]) * 0.6:
ln["items"].append((x, text))
ln["cy"] = (ln["cy"] * (len(ln["items"]) - 1) + cy) / len(ln["items"])
break
else:
rows.append({"cy": cy, "h": h, "items": [(x, text)]})
rows.sort(key=lambda l: -l["cy"])
out = []
for ln in rows:
ln["items"].sort()
out.append("".join(t for _, t in ln["items"]))
return "\n".join(out)
index = []
for a, b, page in runs:
if page is None:
continue
t = int(max(a + 2, b - 4)) # 取该页稳定段靠后处:内容最完整、避开转场
png = f"{OUT}/slide_{page:02d}.png"
subprocess.run(["ffmpeg", "-y", "-v", "error", "-ss", str(t), "-i", video,
"-frames:v", "1", png], check=True)
text = lines(ocrmac.OCR(png, language_preference=["zh-Hans", "en-US"]).recognize())
open(f"{OUT}/slide_{page:02d}.txt", "w", encoding="utf-8").write(text + "\n")
index.append(f"{page}\t{a:.0f}\t{b:.0f}\t{t}\t{png}")
print(f"page {page:2d} ({a:.0f}-{b:.0f}s) -> {png}")
open(f"{OUT}/_index.txt", "w", encoding="utf-8").write("\n".join(index) + "\n")
print("slides:", len(index))
PY
```
```bash
.venv/bin/python finalize_slides.py video.mp4 corner_pages.txt && ls slides | head
```
### 第 7 步:汇总报告
把 21 页 OCR 文本 + 逐字稿合并,写一份 `README.md`:
- 视频信息(标题/UP/链接/时长/分辨率/页数);
- **核心结论**(1~3 句);
- **主要研究脉络**(时间线 + 方法对比表);
- **逐页还原**(每页:时间区间 + 内嵌图片 `` + 要点);
- **术语纠错对照**(ASR/OCR 听错写错的专有名词);
- 产出文件清单 + 复现说明。
```bash
for i in $(seq -w 1 21); do echo "### SLIDE $i"; cat slides/slide_${i}.txt; echo; done | head -120
cat transcript.txt | head -80
```
## 失败怎么办
按现象对症,任一步解决就继续:
1. `yt-dlp` 报 403 / 需要登录 / 拿不到 1080P 高码率 → 加浏览器 Cookie:`--cookies-from-browser chrome`(或 `edge/firefox`),或降档 `height<=720`。
2. 转写报 `metadata_errors` → 已经用「ffmpeg 解码成 numpy」绕过;若仍报错,升级 `uv pip install --python .venv -U faster-whisper av`。
3. 模型下载超时 / `401 Unauthorized ... xethub` → 确认同一条命令里有 `HF_ENDPOINT=https://hf-mirror.com` 和 `HF_HUB_DISABLE_XET=1`。
4. 页码 OCR 大量读不出 → 调 `detect_corner_pages.py` 的 `crop`(角标可能在左下/右上:如左下 `iw*0.16:ih*0.10:0:ih*0.90`);或直接走第 5 步的帧差兜底。
5. 非 macOS / 没有 Vision → `ocrmac` 不可用,改 `brew install tesseract tesseract-lang` 后
`tesseract slide_01.png out -l chi_sim+eng`。
6. 抽到的帧是转场中间态(模糊/半透明)→ 把 `finalize_slides.py` 里的代表时刻从 `b - 4` 提前到该页段**中点**:`int((a + b) / 2)`。
## shell 引号避坑(重要)
- `python3 -c` 的代码**用单引号包裹**、内部一律用双引号;`echo` 中文无需转义。
- 代码超过一行 / 含 `$`、反斜杠、引号嵌套 → **先用 `cat > x.py <<'PY' ... PY` 落盘再执行**,不要硬塞一行。
- 变量的 `export` 与使用它的命令**写在同一条命令**里(用 `;` 或 `&&` 连接),跨命令不保留。
- 路径含中文/空格时一律加引号:`cd "$WORK"`。
## 输出要求
- 给出:**逐字稿**(`transcript.txt` / `.srt` 或字幕文件)+ **每页幻灯片图片**(`slides/slide_XX.png`)+ **每页文字**(`slides/slide_XX.txt`)+ **图文报告**(`README.md`)。
- 报告里每页幻灯片必须标注**视频时间区间**,方便回看定位。
- **不要编造**:OCR / ASR 有噪声要在报告里注明,并按上下文纠正明显的专有名词错误(附术语纠错表)。
- 全程用到的命令、脚本、中间文件都留在工作目录,便于复现。
- 最后说明「视频是否有官方字幕、是否使用转写、抽到多少页、抽帧方法与 OCR 引擎」。运行该agent skill后 的相关记录:
css
video_bv16yhd6bedf % tree .
.
├── README.md
├── audio.wav
├── corner_pages.txt
├── detect_pages.py
├── extract_slides.py
├── finalize_slides.py
├── scene_times.txt
├── slides
│   ├── _index.txt
│   ├── slide_01.png
│   ├── slide_01.txt
│   ├── slide_02.png
│   ├── slide_02.txt
│   ├── slide_03.png
│   ├── slide_03.txt
│   ├── slide_04.png
│   ├── slide_04.txt
│   ├── slide_05.png
│   ├── slide_05.txt
│   ├── slide_06.png
│   ├── slide_06.txt
│   ├── slide_07.png
│   ├── slide_07.txt
│   ├── slide_08.png
│   ├── slide_08.txt
│   ├── slide_09.png
│   ├── slide_09.txt
│   ├── slide_10.png
│   ├── slide_10.txt
│   ├── slide_11.png
│   ├── slide_11.txt
│   ├── slide_12.png
│   ├── slide_12.txt
│   ├── slide_13.png
│   ├── slide_13.txt
│   ├── slide_14.png
│   ├── slide_14.txt
│   ├── slide_15.png
│   ├── slide_15.txt
│   ├── slide_16.png
│   ├── slide_16.txt
│   ├── slide_17.png
│   ├── slide_17.txt
│   ├── slide_18.png
│   ├── slide_18.txt
│   ├── slide_19.png
│   ├── slide_19.txt
│   ├── slide_20.png
│   ├── slide_20.txt
│   ├── slide_21.png
│   └── slide_21.txt
├── transcribe.py
├── transcript.srt
├── transcript.txt
└── video.mp4
最终生成的关于该视频内容的研究报告