作者:来自 Elastic David Pilato
在上一篇文章中,我们介绍了如何将邮政地址转换为标准化地址,并获取对应的地理坐标,或者反过来,根据地理坐标获取对应的邮政地址。
现在,假设我们已经有一个现成的数据集,希望对其中的数据进行增强和补全。
我们将考虑以下三种场景:
-
数据存储在 CSV 文件中。
-
数据存储在关系型数据库 MySQL 中。
-
数据已经存储在 Elasticsearch 中。
接下来,让我们看看如何对这些不同来源的数据进行增强。
对 CSV 文件进行数据增强
每当需要通过 Logstash 读取文件时,我都非常喜欢使用 Filebeat 来完成这项工作。
因此,我修改了 Logstash 的输入部分,不再使用 http-input 插件,而是改用 beats-input 插件:
markdown
`

1.  input {
2.    beats {
3.      port => 5044
4.    }
5.  }

`AI写代码
在 filebeat.yml 配置文件中,我只进行了以下配置:
yaml
`

1.  filebeat.prospectors:
2.  - type: log
3.    paths:
4.      - /path/to/data/*.csv
5.    close_eof: true
6.  output.logstash:
7.    hosts: ["localhost:5044"]

`AI写代码
此外,我还启用了 X-Pack Monitoring(监控功能),以便了解 Pipeline(数据处理管道)的执行情况和性能表现:
yaml
`

1.  xpack.monitoring.enabled: true
2.  xpack.monitoring.elasticsearch:
3.    hosts: ["localhost:9200"]

`AI写代码
我编写了一个简单的负载测试脚本,如下所示。该脚本会对数据进行 10 轮处理:
bash
``

1.  cd filebeat*
2.  time for i in `seq 1 10`;
3.  do
4.    echo Launch $i
5.    rm data/registry ; ./filebeat --once
6.  done
7.  cd -

``AI写代码
以下是我使用的输入数据集:
bash
`

1.  $ wc -l data/person_dataset.csv
2.      2499 data/person_dataset.csv

`AI写代码
因此,数据集大约包含 2,500 行记录。
数据内容如下:
markdown
`

1.  3,Joe Smith,2000-11-15 23:00:00.000000,male,3,Paris,France,FR,47.26917867489252,-1.5316220472168889,44000
2.  24,Nail Louisa,1980-05-02 22:00:00.000000,male,3,Nantes,France,FR,47.18584787904486,-1.6181576666034811,44000
3.  36,Lison Nola,1985-09-23 22:00:00.000000,female,3,Nantes,France,FR,47.168657958748916,-1.5826229006751034,44000
4.  45,Selena Sidonie,1964-10-18 23:00:00.000000,female,0,Paris,France,FR,48.82788569687699,2.2706737741614242,75000

`AI写代码
我们需要使用 csv 过滤器(CSV Filter)来解析这些数据:
ini
`
1. csv {
2. columns => ["id","name","dateOfBirth","gender","children","[address][city]","[address][country]","[address][countrycode]","[location][lat]","[location][lon]","[address][zipcode]"]
3. convert => {
4. "children" => "integer"
5. "[location][lat]" => "float"
6. "[location][lon]" => "float"
7. }
8. remove_field => ["host", "@version", "@timestamp","beat","source","tags","offset","prospector","message"]
9. }
`AI写代码在这里,由于输入数据包含地理坐标点( Geo Location Points),我们将采用上一篇文章中介绍的性能最慢的查询策略:按地理距离排序(Geo Distance Sorting)。
为了确保不会因为输出操作而过度拖慢 Pipeline(数据处理管道)的执行速度,我将标准输出(stdout)的编解码器(Codec)替换为 dots:
markdown
`

1.  output {
2.    stdout { codec => dots }
3.  }

`AI写代码
完成 10 轮测试总共耗时 3m3.842s(约 3 分 4 秒)。
这意味着,每处理 2,500 条文档并完成数据增强,大约需要 18 秒,相当于每秒处理约 140 条文档。
这个性能还算不错。
如果查看 Logstash 的监控数据,可以看到每个事件的处理延迟(Event Latency )大约在 20--40 毫秒之间。
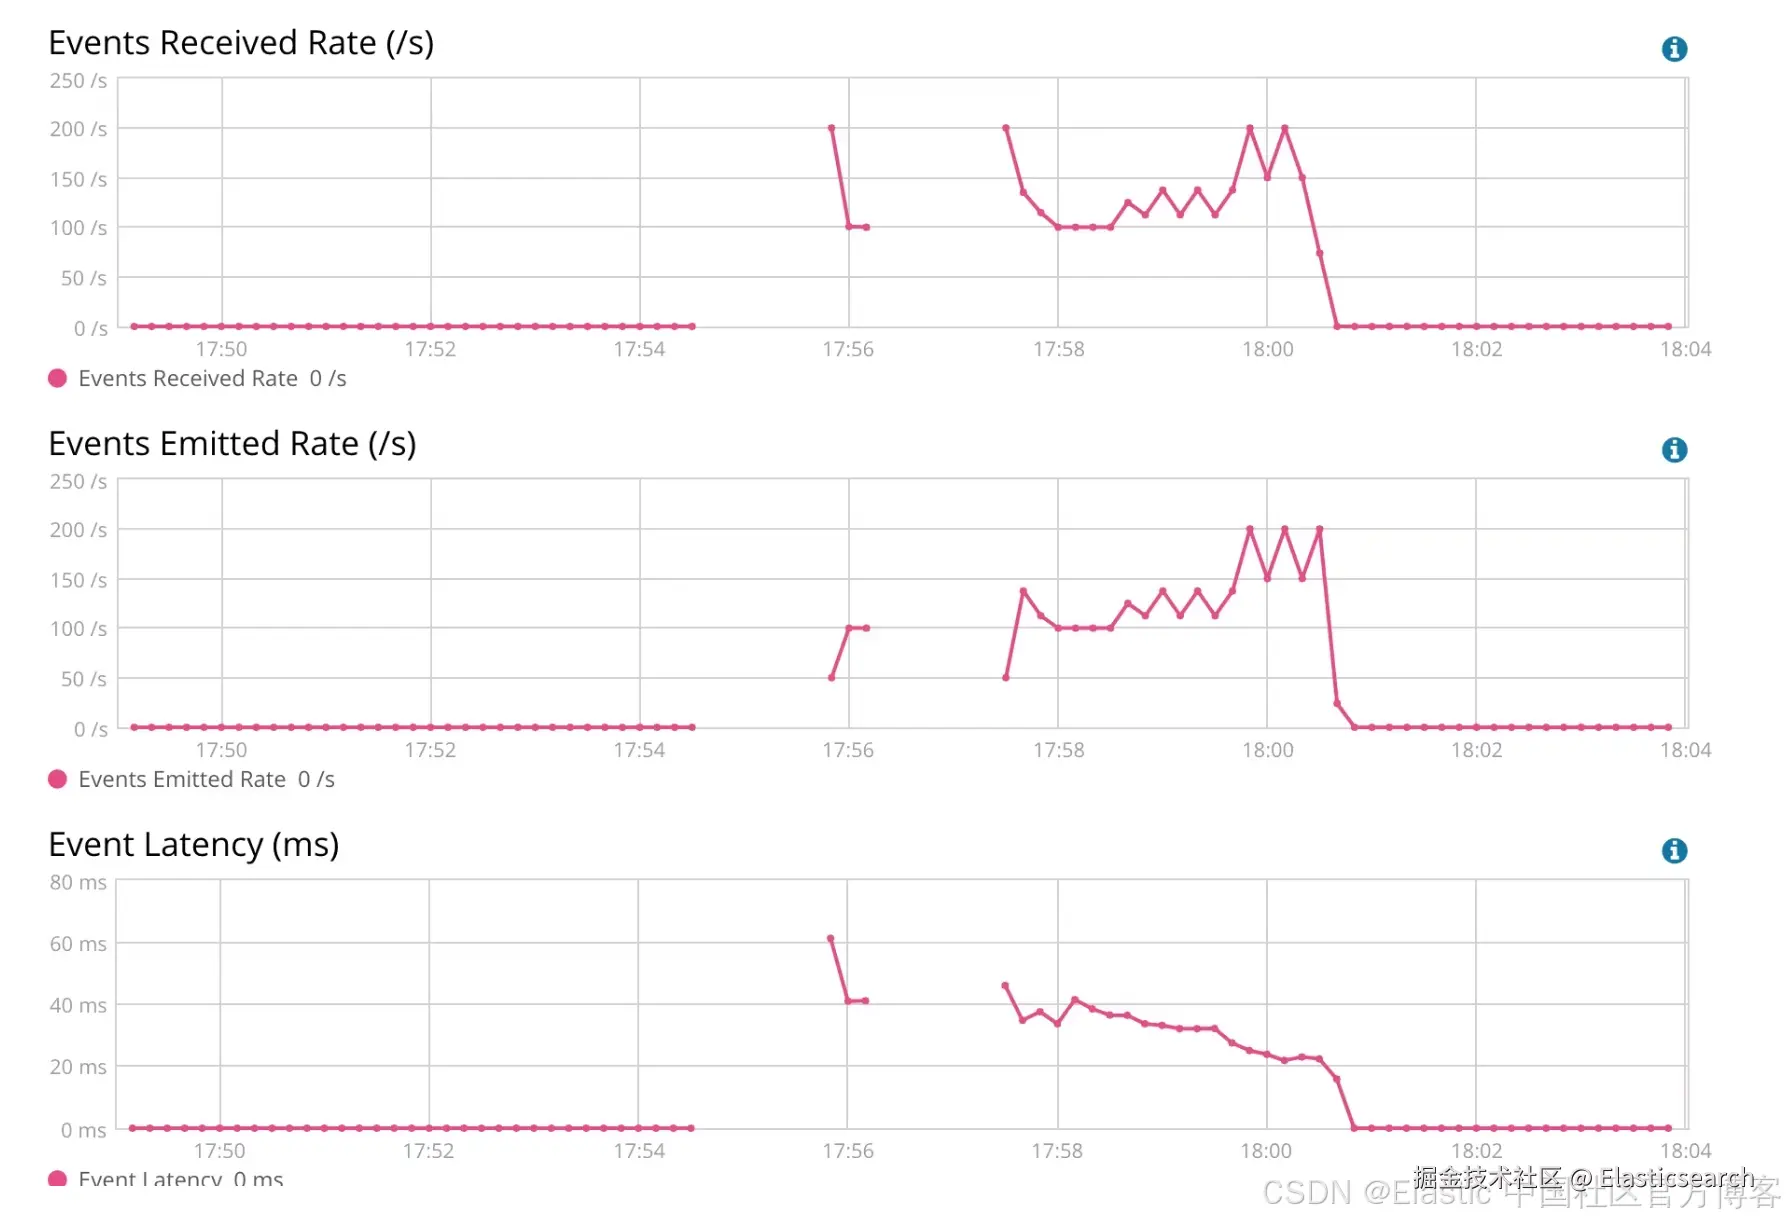
Logstash 监控(Logstash Monitoring)
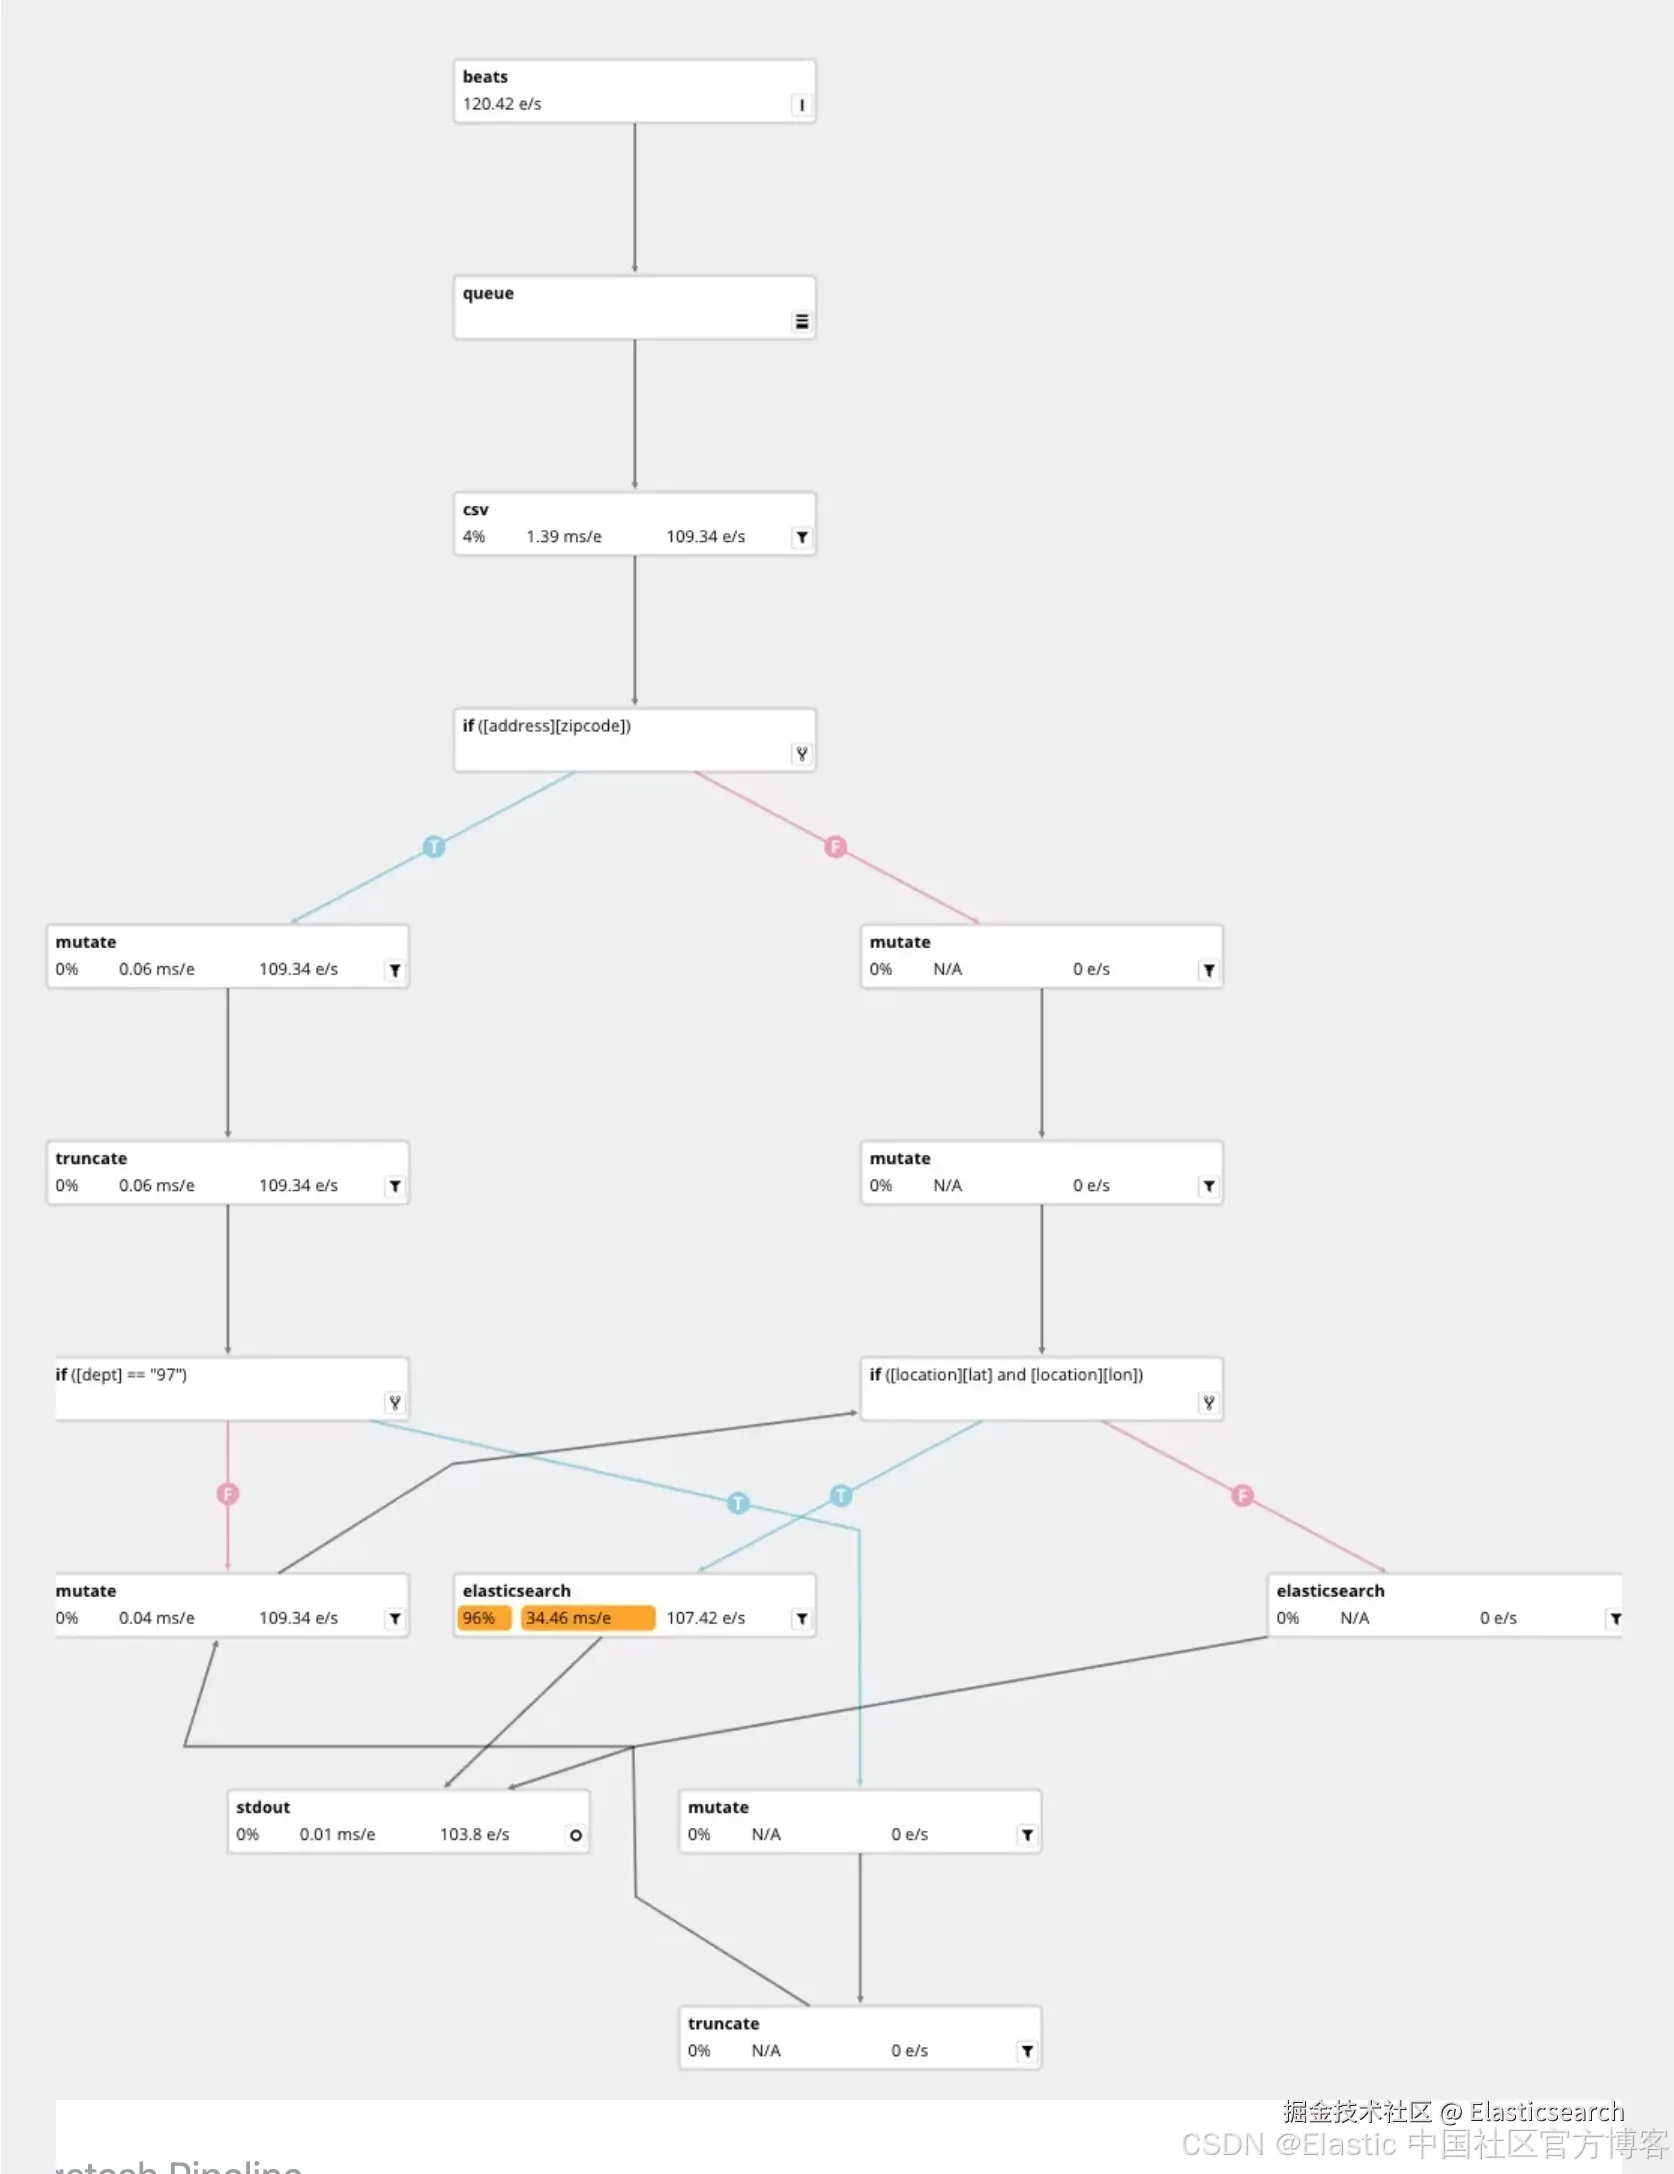 Logstash 数据处理管道(Logstash Pipeline)
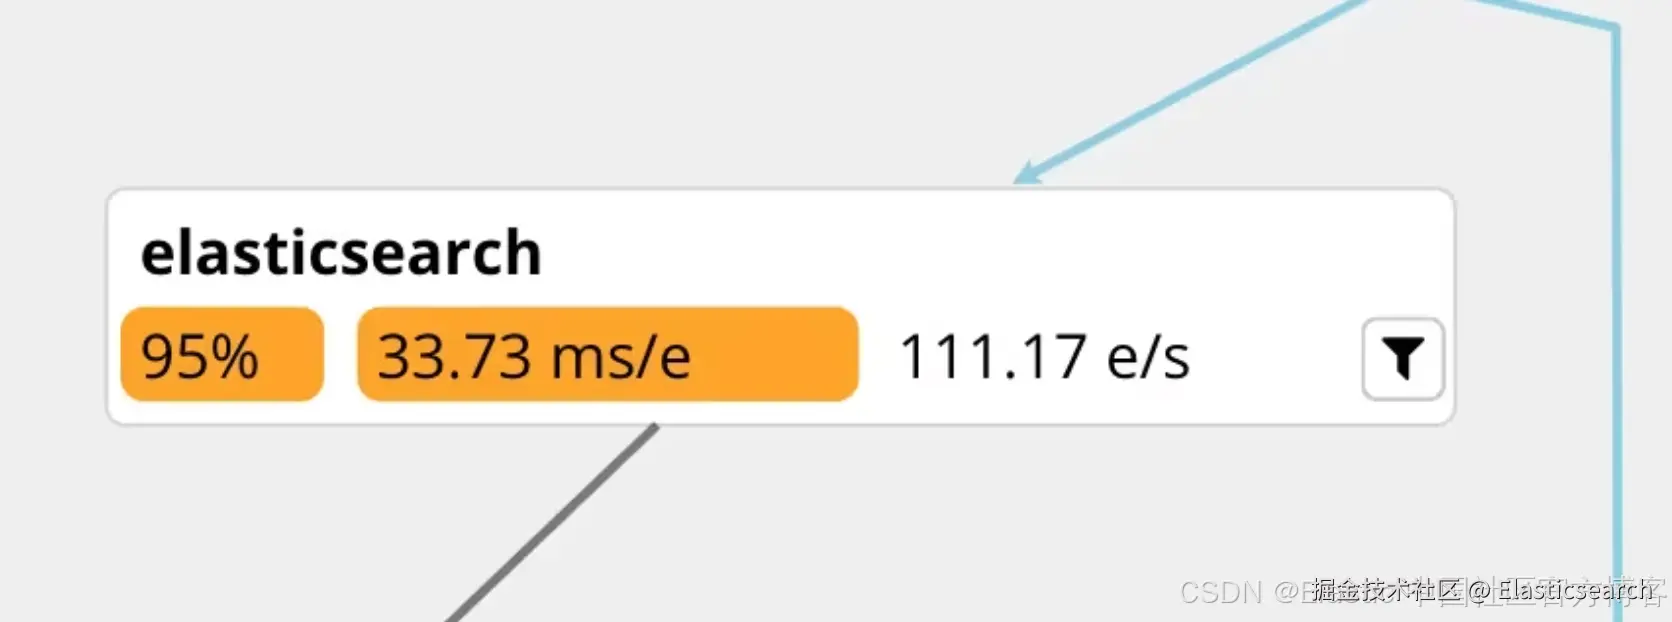 Elasticsearch 过滤器插件
在 Elasticsearch 中执行数据查找(Lookup)确实会降低整个处理流程的速度,但我认为影响并不算太大(平均每个事件耗时约 34 毫秒)。
对于 ETL(提取、转换、加载)操作来说,这样的性能完全可以接受。
这也是为什么在 Logstash 中执行耗时较长的操作,通常比直接在 Elasticsearch 的 Ingest Pipeline(摄取管道)中执行更合适。
因为 Ingest Pipeline 是在文档索引写入过程中调用的,如果其中包含执行时间较长的操作,就可能导致 Elasticsearch 的索引写入请求不断积压,最终使索引写入队列逐渐被填满。
连接其他数据源
除了通过 Filebeat 读取 CSV 文件之外,我们还可以从其他数据源读取数据。
例如,如果现有数据存储在 SQL 数据库中,就可以使用 jdbc-input 插件直接读取数据库中的数据。
相应的配置大致如下:
ini
`
1. jdbc {
2. jdbc_driver_library => "mysql-connector-java-6.0.6.jar"
3. jdbc_driver_class => "com.mysql.cj.jdbc.Driver"
4. jdbc_connection_string => "jdbc:mysql://127.0.0.1:3306/person?useSSL=false"
5. jdbc_user => "root"
6. jdbc_password => ""
7. schedule => "* * * * *"
8. parameters => { "country" => "France" }
9. statement => "SELECT p.id, p.name, p.dateOfBirth, p.gender, p.children, a.city, a.country, a.countrycode, a.lat, a.lon, a.zipcode FROM Person p, Address a WHERE a.id = p.address_id AND a.country = :country AND p.id > :sql_last_value"
10. use_column_value => true
11. tracking_column => "id"
12. }
`AI写代码我们还可以使用 elasticsearch-input 插件连接到 Elasticsearch,读取已经存储在某个索引中的现有数据,并对其进行增强和补全。
现在,你已经掌握了实现类似地址转换和数据增强功能所需的全部工具。
需要注意的是,你可以使用任何可用的数据集,并不局限于 BANO。
我的下一步计划是将其他开放数据源导入 Elasticsearch,尝试将地址数据的覆盖范围从法国扩展到更多国家。
敬请期待!
原文:Enriching your postal addresses with Elastic stack - part 3 | David Pilato