目录
[一、Provider 已经统一,为什么还需要 LLMManager](#一、Provider 已经统一,为什么还需要 LLMManager)
[1.1 统一接口不等于统一管理](#1.1 统一接口不等于统一管理)
[1.2 LLMManager 的职责边界](#1.2 LLMManager 的职责边界)
[二、先看 LLMManager 的接口和内部结构](#二、先看 LLMManager 的接口和内部结构)
[2.1 头文件提供哪些能力](#2.1 头文件提供哪些能力)
[2.2 为什么需要两张 map](#2.2 为什么需要两张 map)
[三、注册 Provider:为什么使用 unique_ptr 和 std::move](#三、注册 Provider:为什么使用 unique_ptr 和 std::move)
[3.1 unique_ptr 表示谁负责对象的生命周期](#3.1 unique_ptr 表示谁负责对象的生命周期)
[3.2 registerProvider() 怎样完成注册](#3.2 registerProvider() 怎样完成注册)
[3.3 Ollama 为什么需要带模型名的构造函数](#3.3 Ollama 为什么需要带模型名的构造函数)
[4.1 initModel() 为什么仍然只需要模型名称](#4.1 initModel() 为什么仍然只需要模型名称)
[4.2 什么叫"可用"](#4.2 什么叫“可用”)
[5.1 获取所有可用模型](#5.1 获取所有可用模型)
[5.2 检查指定模型是否可用](#5.2 检查指定模型是否可用)
[6.1 sendMessage() 只做必要的检查与转发](#6.1 sendMessage() 只做必要的检查与转发)
[6.2 sendMessageStream() 为什么同样不需要协议判断](#6.2 sendMessageStream() 为什么同样不需要协议判断)
[6.3 一次请求真正经过了哪些层](#6.3 一次请求真正经过了哪些层)
[7.1 全量测试:同样的 Provider,不同的调用入口](#7.1 全量测试:同样的 Provider,不同的调用入口)
[7.2 流式测试:模型路由不变,只是多了回调](#7.2 流式测试:模型路由不变,只是多了回调)
前言
系列:从零实现 C++ AI 大模型接入 SDK,第九篇
项目源码:
AI-CHAT-SDK
https://gitee.com/kuang-zhenting/my_ai_cpp_project
前面几篇,我们分别完成了四种模型后端的接入:
- DeepSeekProvider → DeepSeek 云端接口;
- ChatGPTProvider → OpenAI Responses API;
- GeminiProvider → Gemini 兼容接口;
- OllamaLLMProvider → 本地 Ollama 服务。
虽然它们使用的认证方式、请求字段、响应格式和流式协议不尽相同,但对外已经遵守同一个 ILLMProvider 接口。
这说明我们解决了第一个问题:无论底层接的是哪一种模型,都能通过同一组函数发起请求。
不过,真正准备让业务层同时使用这四种模型时,又会遇到新的麻烦。
假如用户在页面上选中了 gpt-5.5,上层代码还得知道对应的是 ChatGPTProvider;切换到 deepseek-chat,又要找到 DeepSeekProvider。初始化、检查状态、发送消息时,都要做类似的选择。
我们总不能每增加一个 Provider,就在业务代码里再写一组 if/else。
第八篇结尾已经留下了这个问题:四个 Provider 都会调用了,接下来由谁统一保存它们、管理它们,并把请求送到正确的模型?
这一篇,我们就在 ILLMProvider 之上增加一层 LLMManager。
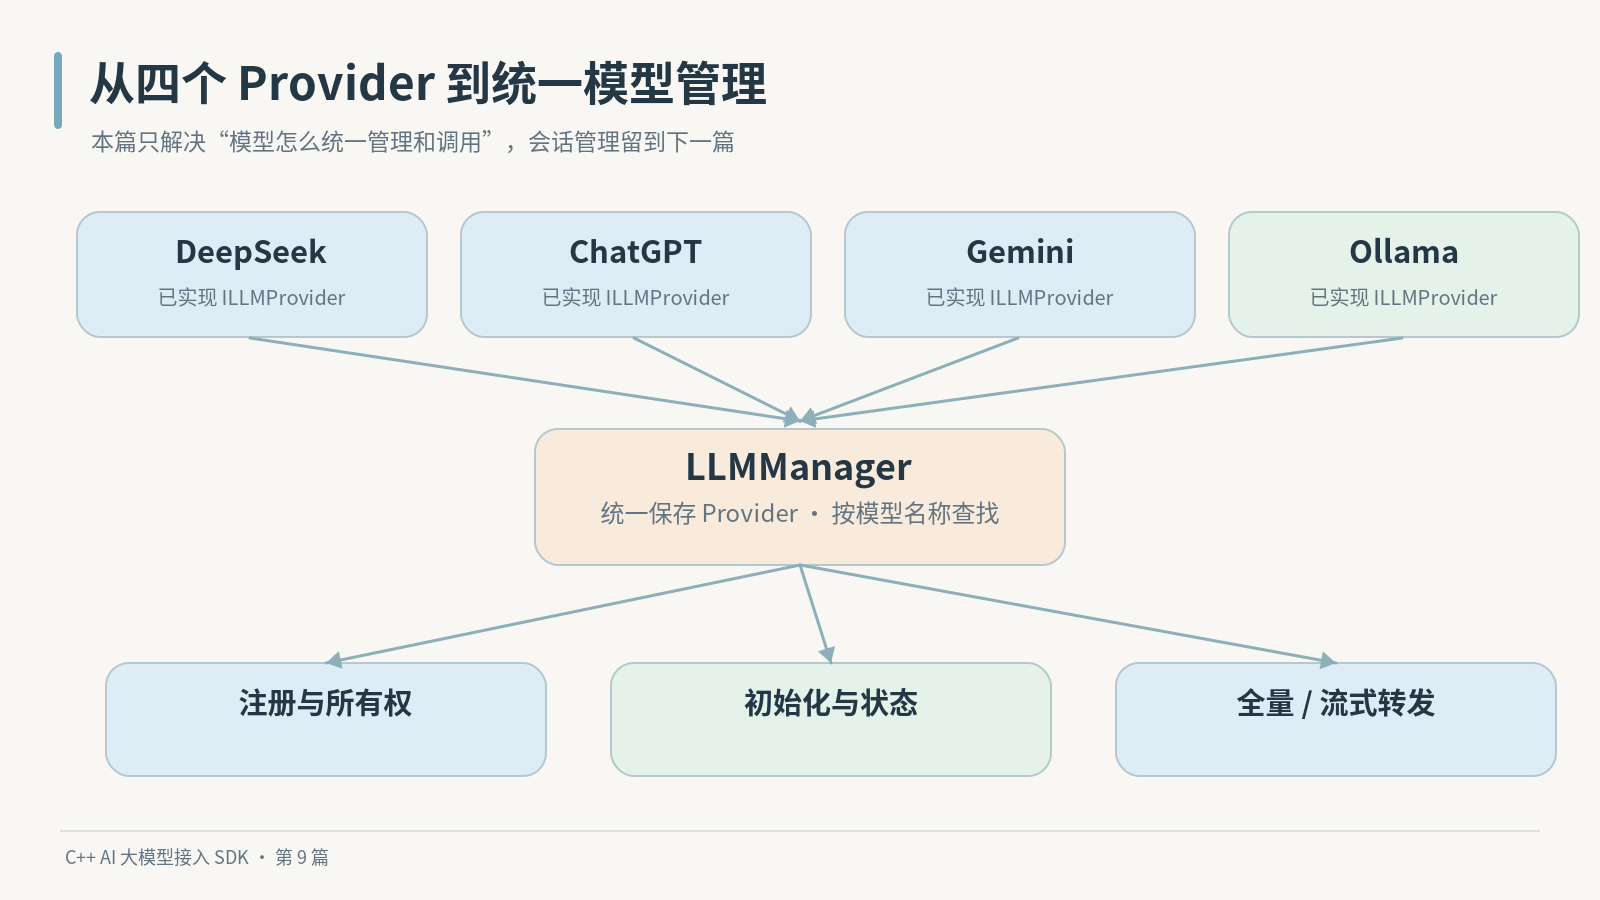
它不重新实现 HTTP,也不重新解析 SSE 或 NDJSON。它要解决的是另一件事:
cpp
模型名称
    ↓
找到对应 Provider
    ↓
确认已经初始化、当前可用
    ↓
通过统一接口转发全量 / 流式请求
一、Provider 已经统一,为什么还需要 LLMManager
1.1 统一接口不等于统一管理
回顾前面已经定义好的 ILLMProvider。它要求具体 Provider 实现这些能力:
cpp
virtual bool initModel(
    const std::map<std::string, std::string> model_config
) = 0;

virtual bool isAvailable() = 0;
virtual std::string getModelName() const = 0;
virtual std::string getModelDesc() const = 0;

virtual std::string sendMessage(
    const std::vector<Message>& messages,
    const std::map<std::string, std::string>& request_param
) = 0;

virtual std::string sendMessageStream(
    const std::vector<Message>& messages,
    const std::map<std::string, std::string>& request_param,
    std::function<void(const std::string&, bool)> callback
) = 0;
有了这些虚函数,不管基类指针实际指向哪一个 Provider,我们调用的函数形式都一样。
但是这只解决了怎么调用一个已经找到的 Provider,并没有回答:
-
多个 Provider 对象放在哪里?
-
给出一个模型名称,怎么找到对应对象?
-
一个 Provider 被创建后,是否就已经能调用?
-
用户想查看当前可用的模型列表,应该向谁查询?
如果把这些工作都交给业务层,逻辑可能会变成:
cpp
// 以下只是说明问题的伪代码,不是项目中的实际实现。
if (model_name == "deepseek-chat") {
    return deepseek->sendMessage(messages, params);
} else if (model_name == "gpt-5.5") {
    return chatgpt->sendMessage(messages, params);
} else if (model_name == "gemini-3.5-flash") {
    return gemini->sendMessage(messages, params);
} else if (model_name == "deepseek-r1:1.5b") {
    return ollama->sendMessage(messages, params);
}
这种分支在全量请求里写一遍,流式请求、初始化、状态检查里可能还要再写一遍。新增模型时,许多位置都需要跟着修改。
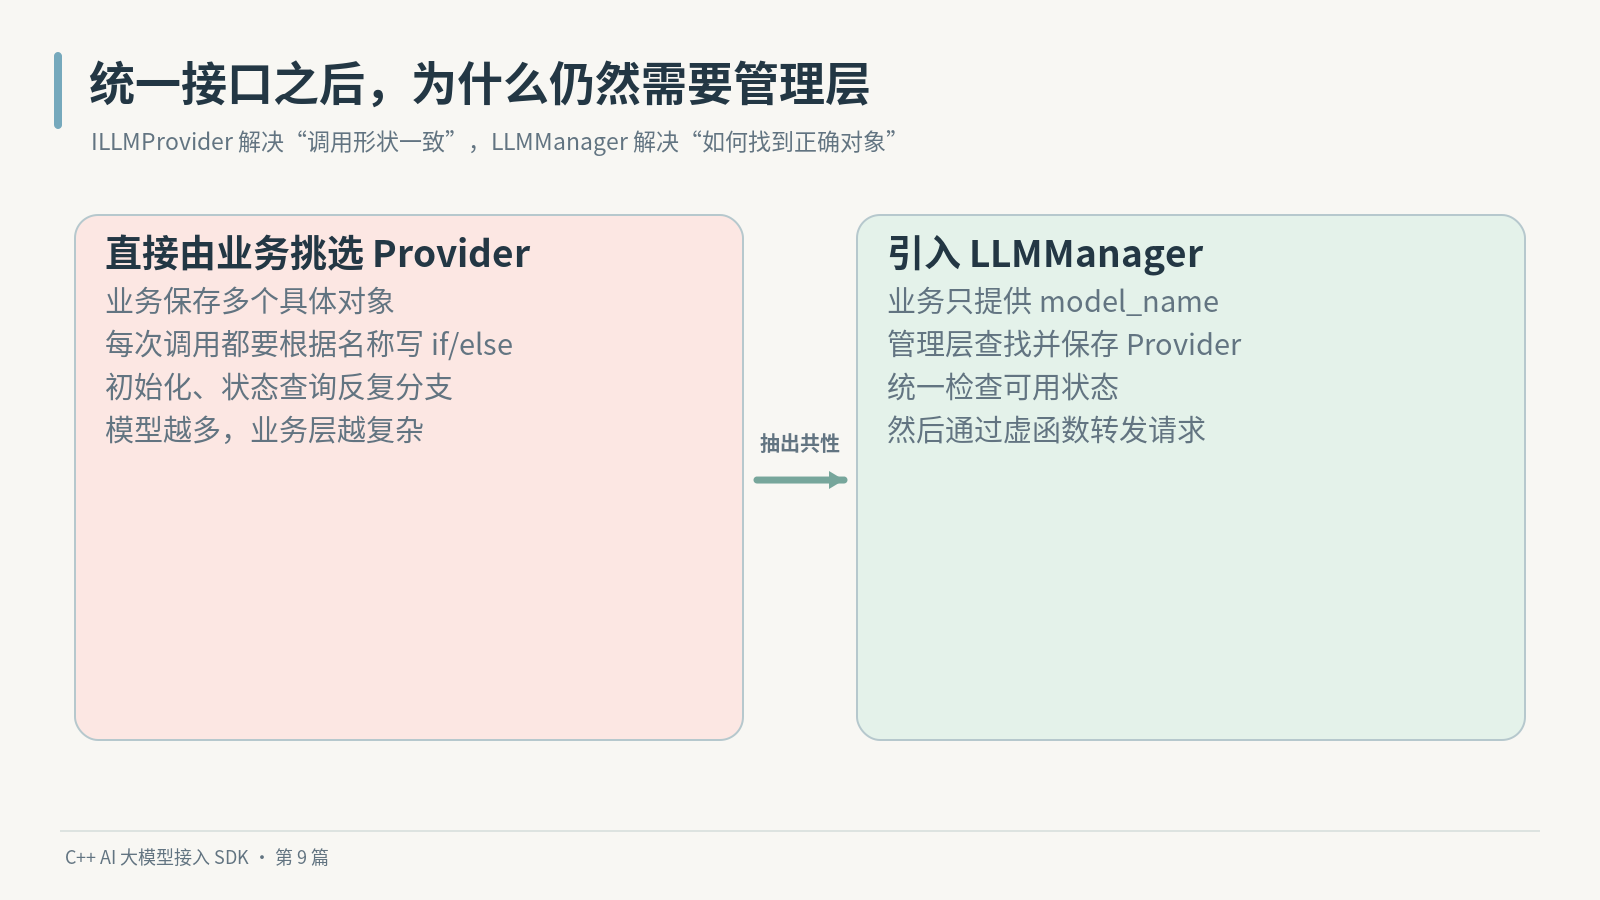
我们真正希望业务层表达的是:
cpp
std::string reply = manager.sendMessage(
    model_name,
    messages,
    request_param
);
这里的 model_name 是模型的身份,messages 是要发送的消息,request_param 是这一轮调用的参数。至于应当进入哪一个 Provider,由管理层负责。
1.2 LLMManager 的职责边界
LLMManager 不是第五种 Provider。
它既不继承 ILLMProvider,也不向 DeepSeek、ChatGPT、Gemini、Ollama 重新发送一份自己构造的 HTTP 请求。
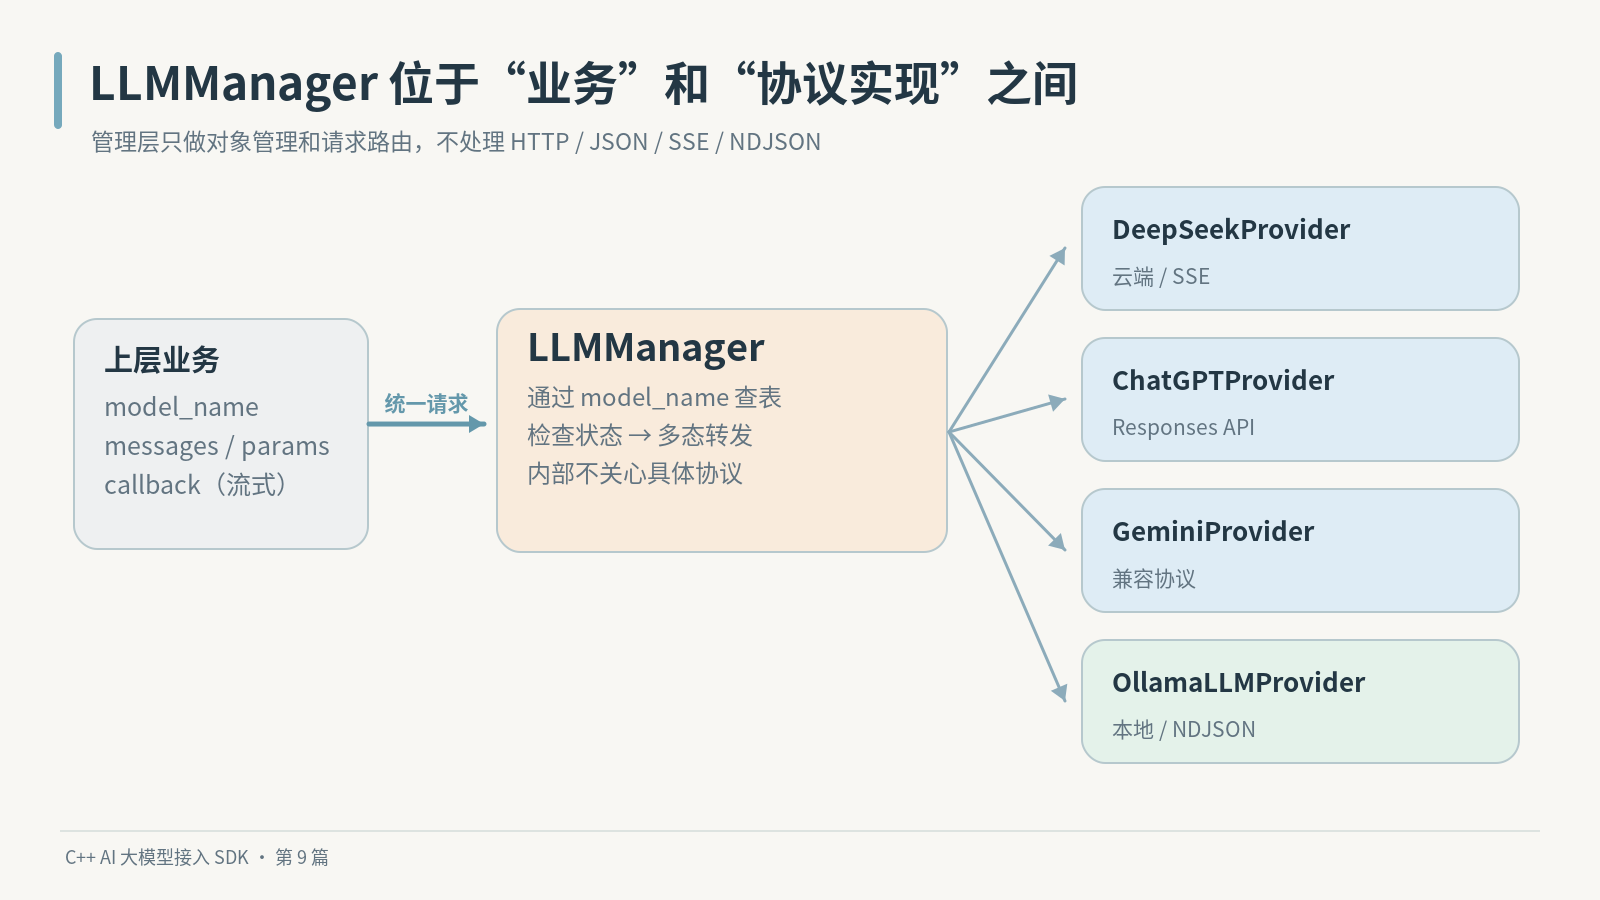
这层设计把两类变化隔开了:
- **具体 Provider 处理协议差异:**它们负责各自的初始化配置、请求构造、网络通信、响应解析与流式事件处理。
- **LLMManager 处理模型管理问题:**它负责保存 Provider、建立模型名索引、维护模型状态,以及把调用转交给选定的 Provider。
因此,增加一个 Provider 时,不需要为了选择它而在 LLMManager::sendMessage() 里添加新的模型类型判断。
这正是统一接口配合多态真正发挥价值的地方。
二、先看 LLMManager 的接口和内部结构
本篇直接围绕当前工程的两个文件展开:
cpp
SDK/
├── include/
│   └── LLMManager.h
└── src/
    └── LLMManager.cpp
2.1 头文件提供哪些能力
LLMManager.h 的核心接口如下:
cpp
namespace ai_chat_sdk {

class LLMManager {
public:
    bool registerProvider(
        std::unique_ptr<ILLMProvider> provider
    );

    bool initModel(
        const std::string& model_name,
        const std::map<std::string, std::string>& model_config
    );

    std::vector<ModelInfo> getAvailableModels() const;

    bool isModelAvailable(
        const std::string& model_name
    ) const;

    std::string sendMessage(
        const std::string& model_name,
        const std::vector<Message>& messages,
        const std::map<std::string, std::string>& request_param
    );

    std::string sendMessageStream(
        const std::string& model_name,
        const std::vector<Message>& messages,
        const std::map<std::string, std::string>& request_param,
        std::function<void(const std::string&, bool)> callback
    );

private:
    std::map<std::string, std::unique_ptr<ILLMProvider>> _providers;
    std::map<std::string, ModelInfo> _models;
};

} // namespace ai_chat_sdk
可以把这六个公开接口分成三组:
| 阶段 | 接口 | 解决的问题 |
|---|---|---|
| 准备 | registerProvider()、initModel() |
谁负责这个模型,以及怎样初始化 |
| 查询 | getAvailableModels()、isModelAvailable() |
当前哪些模型可以被调用 |
| 使用 | sendMessage()、sendMessageStream() |
这次请求应当转发给谁 |
这里有一个值得留意的变化:registerProvider() 没有要求外部额外传一个模型名称 。管理层会直接向 Provider 询问 getModelName(),以它返回的字符串作为索引。
同一个模型名称因此应当代表同一个被注册的 Provider。
2.2 为什么需要两张 map
继续看私有成员:
cpp
std::map<std::string, std::unique_ptr<ILLMProvider>> _providers;
std::map<std::string, ModelInfo> _models;
两张表的 key 都是 std::string 类型的模型名称,但保存的内容不同。
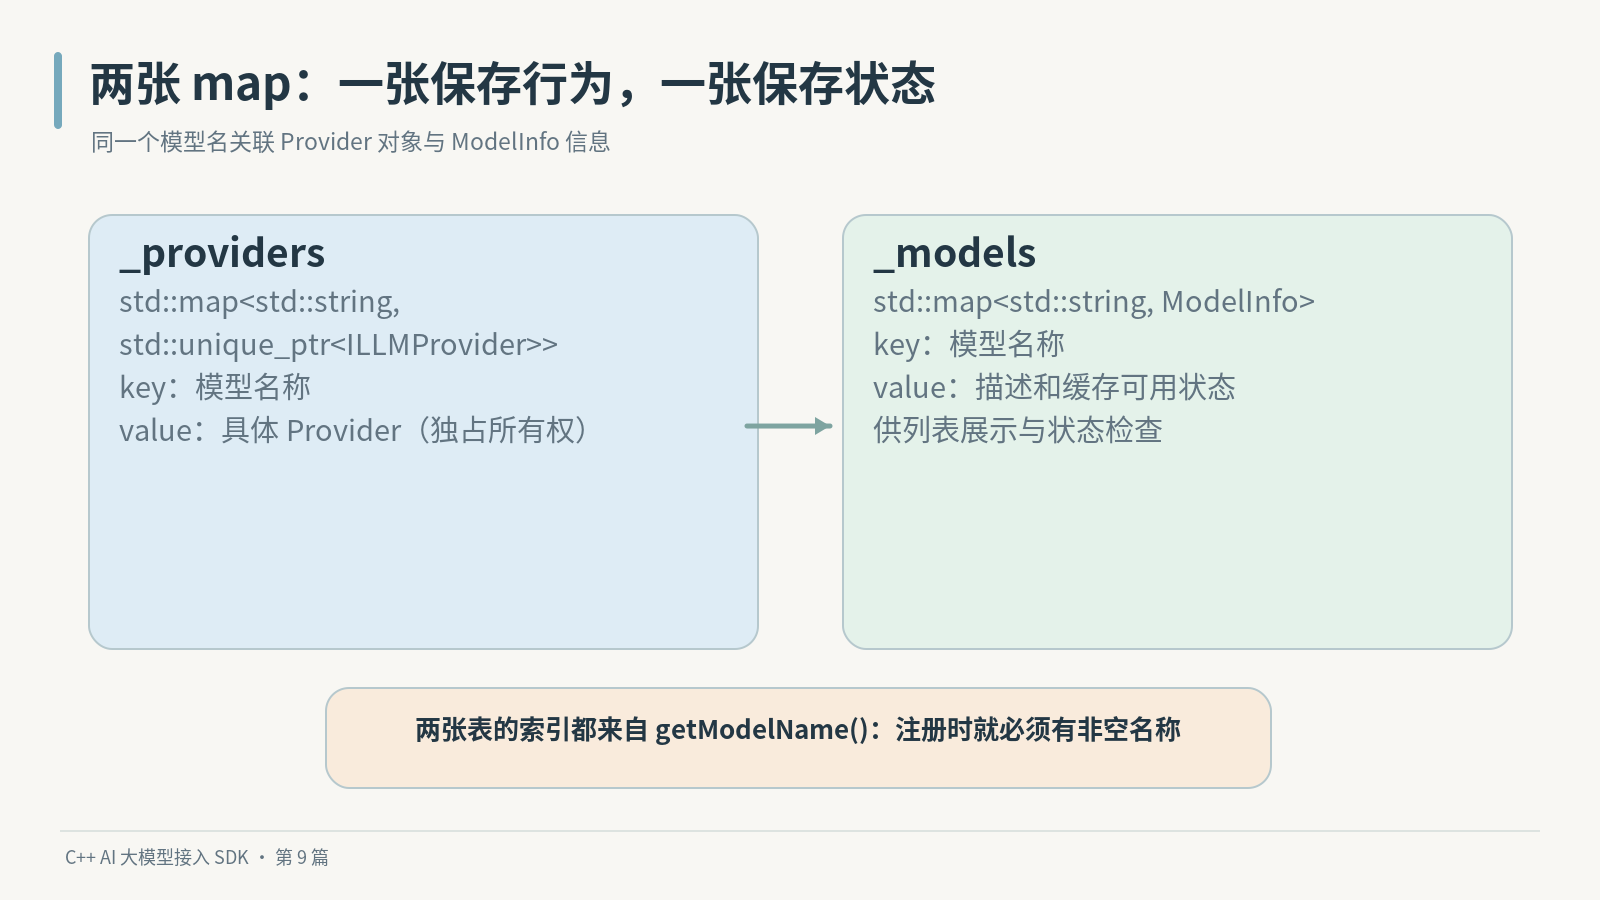
_providers 保存的是可以真正执行请求的对象:
cpp
"deepseek-chat"     → DeepSeekProvider
"gpt-5.5"           → ChatGPTProvider
"gemini-3.5-flash"  → GeminiProvider
"deepseek-r1:1.5b"  → OllamaLLMProvider
表的 value 是 std::unique_ptr<ILLMProvider>,所以这里能存入不同的具体 Provider,同时统一通过基类接口调用。
_models 则保存便于查询和展示的模型信息 。这些信息已经在 common.h 中定义:
cpp
struct ModelInfo {
    std::string _model_name;
    std::string _desc;
    std::string _provider;
    std::string _endpoint;
    bool _isAvailable;
ModelInfo(
    const std::string& model_name,
    const std::string& desc = "",
    const std::string& provider = "",
    const std::string& endpoint = ""
)
    : _model_name(model_name)
    , _desc(desc)
    , _provider(provider)
    , _endpoint(endpoint)
    , _isAvailable(false)
{}
};也就是说,_providers 更关心"这个模型由哪个对象执行",_models 更关心"这个模型叫什么、怎么描述、是否被标记为可用"。
为什么不在查询列表时每次都去遍历 Provider、重新拼装信息?
当然可以设计成那样,但当前工程选择了两张映射表:行为对象与对外模型信息分开保存 。这样获取可用列表时只需要查看 _models,发送请求时再查 _providers。
需要注意两点:
第一,当前 registerProvider() 只填入模型名称、描述和初始可用状态,_provider、_endpoint 虽然存在于 ModelInfo 中,但管理层没有自动填充这两个字段。不能因为结构体定义了字段,就以为接口已经提供了完整的服务商和地址元数据。
第二,状态存放在另一张表,就意味着管理层必须主动同步状态 。否则,实际 Provider 的状态和 _models 中缓存的状态可能不一致。这个问题在后面的初始化实现里会再次出现。
三、注册 Provider:为什么使用 unique_ptr 和 std::move
LLMManager 需要长期保存四种 Provider。如果对象由上层创建,却一直留在上层,那么模型管理的所有权仍然没有真正交给管理层。
当前实现采用 std::unique_ptr,让管理层独占这些 Provider 对象。
3.1 unique_ptr 表示谁负责对象的生命周期
std::unique_ptr<T> 是一个独占所有权的智能指针。同一时刻,它所管理的对象只能由一个 unique_ptr 拥有;当这个智能指针销毁时,对象会被自动释放。
例如:
cpp
std::unique_ptr<ILLMProvider> provider =
    std::make_unique<DeepSeekProvider>();
这里创建的是具体的 DeepSeekProvider,但变量类型使用统一的 ILLMProvider 基类指针。因为基类提供了虚析构函数:
cpp
virtual ~ILLMProvider() = default;所以通过基类智能指针释放对象时,可以正确执行派生类的析构过程。
注册时再调用:
cpp
manager.registerProvider(std::move(provider));unique_ptr 不能复制;std::move 让这里的智能指针能够转移所有权。std::move 本身不移动底层 Provider 对象,更不是重新创建一个 Provider。
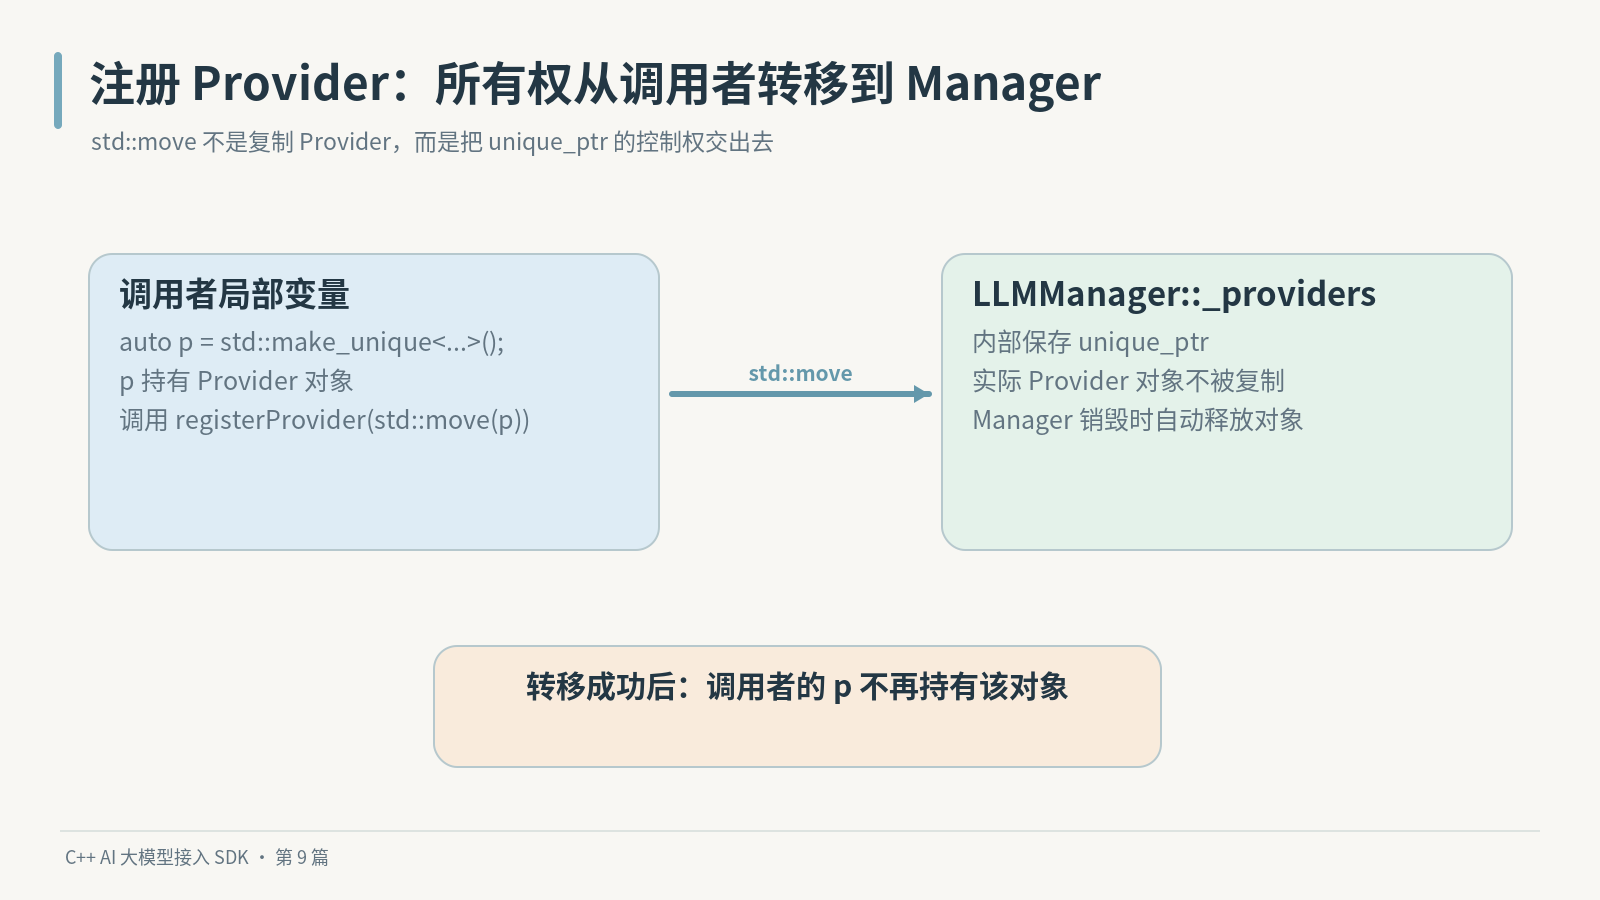
这里的意义不是为了少写一次 delete,而是把 Provider 的生命周期统一交给 Manager。从此,上层无需分别管理四种 Provider 对象什么时候释放。
对于成功转移的调用,原变量 provider 不再拥有对象,后面不应该继续通过它解引用。要再次使用模型,应当从 Manager 的公开接口进入。
3.2 registerProvider() 怎样完成注册
当前 LLMManager.cpp 的注册逻辑可以按五步来看:
cpp
bool LLMManager::registerProvider(
    std::unique_ptr<ILLMProvider> provider
)
{
    if (!provider) {
        ERR("cannot register a null provider");
        return false;
    }

    const std::string model_name = provider->getModelName();
    if (model_name.empty()) {
        ERR("cannot register provider with an empty model name");
        return false;
    }

    if (_providers.find(model_name) != _providers.end()) {
        ERR("model already registerad:{}", model_name);
        return false;
    }

    ModelInfo model_info(model_name);
    model_info._desc = provider->getModelDesc();
    model_info._isAvailable = false;
    _models.emplace(model_name, model_info);

    _providers.emplace(model_name, std::move(provider));
    INFO("model registerd:{}", model_name);
    return true;
}
先看前面的检查:
-
指针为空,说明根本没有可注册的 Provider,直接拒绝。
-
模型名称为空,就无法建立模型名与对象的对应关系,直接拒绝。
-
_providers中已经有相同名称,拒绝重复注册,避免覆盖已有对象。
通过检查以后,代码先建立 ModelInfo,并且明确写入:
cpp
model_info._isAvailable = false;注册成功只表示 Manager 已经认识了这个模型,不表示 Provider 已完成初始化。
最后再执行:
cpp
_providers.emplace(model_name, std::move(provider));此时 Manager 接管 Provider 对象,后续就可以通过模型名称查找它。
这里还存在一个容易忽略的细节:参数本身是按值接收的 unique_ptr。如果调用者写的是 std::move(provider),所有权会在进入函数时就转入形参;
即使函数随后因为空名称或重复名称而返回 false,调用者的那个原始智能指针也通常已经失去所有权,形参销毁时对象随之释放。所以不能把 false 理解为"原 Provider 对象还在调用者手里"。
3.3 Ollama 为什么需要带模型名的构造函数
第八篇有一个特意留下的接口:
cpp
explicit OllamaLLMProvider(const std::string& model_name);原因到这里就明白了。
DeepSeek、ChatGPT、Gemini 的 getModelName() 在当前代码中返回固定的模型名称;但 Ollama 可以接入不同的本地模型,它的名称由对象配置决定。
如果我们先使用没有模型名的默认构造函数:
cpp
std::make_unique<OllamaLLMProvider>()然后马上注册,getModelName() 可能返回空字符串,Manager 就会拒绝它。
因此在当前注册流程中,需要先把模型身份交给 Provider:
cpp
manager.registerProvider(
    std::make_unique<OllamaLLMProvider>("deepseek-r1:1.5b")
);
还要保证后续 initModel() 配置中的 model_name 与注册时的名字保持一致。因为 Manager 已经用最初的名称建立了索引,而当前代码不会在 Provider 初始化后重新建立这个索引。
这就是"先有模型身份,再能进行统一管理"的实际含义。
四、初始化与模型可用状态:注册成功还不够
注册只是建立了模型名与 Provider 的关系。想真正调用模型,还要给具体 Provider 配置 API Key、服务地址或本地模型参数。
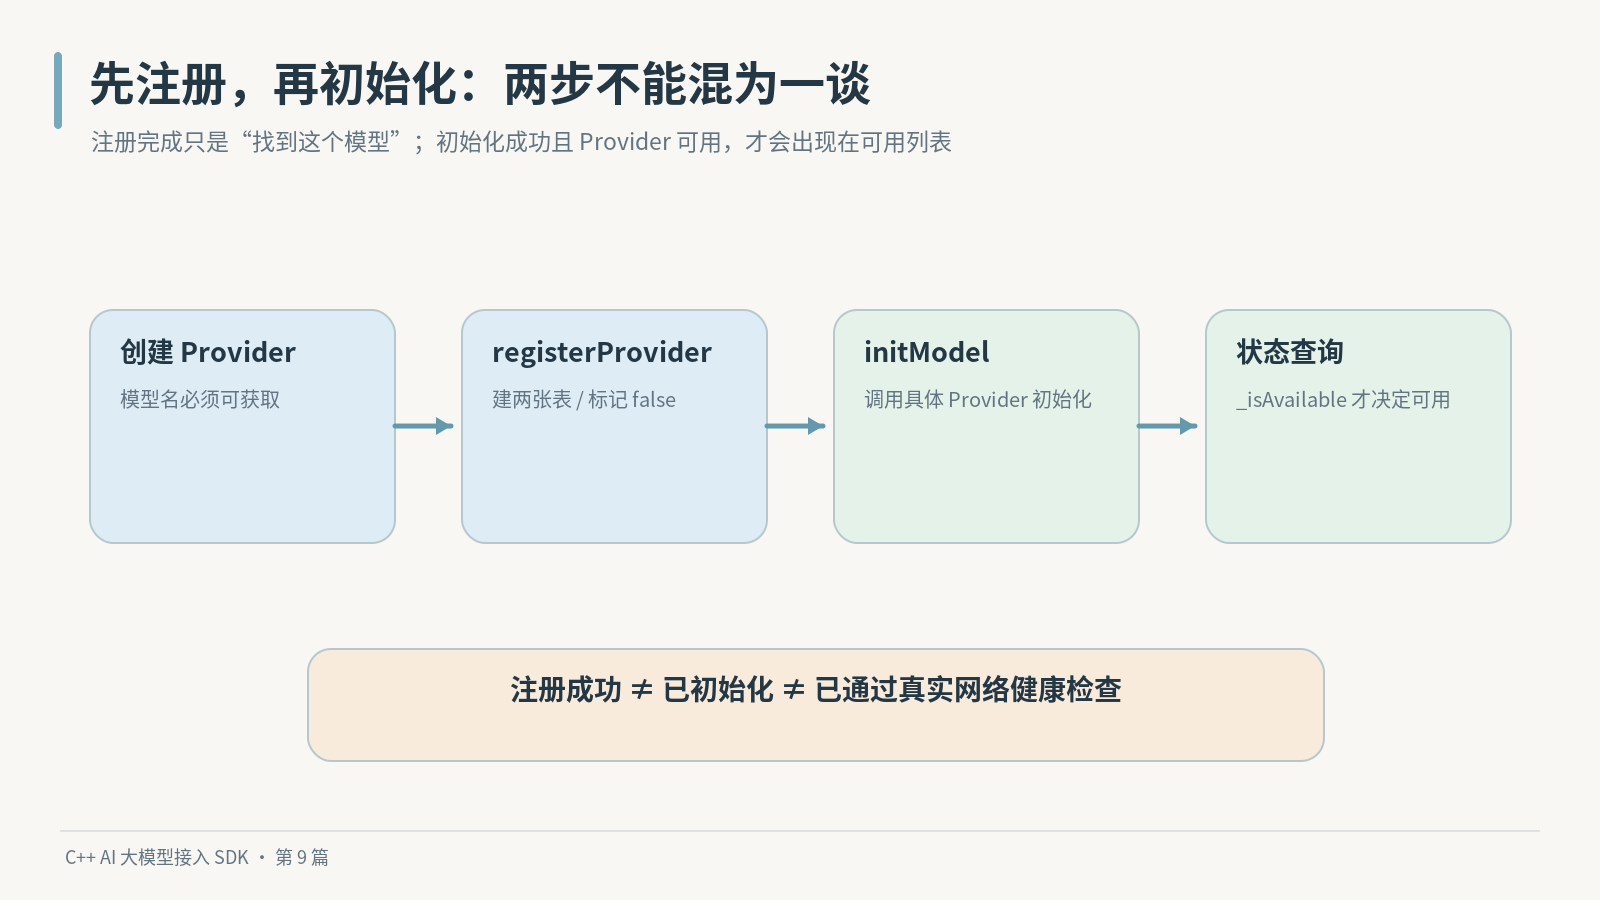
4.1 initModel() 为什么仍然只需要模型名称
当前 initModel() 的实现如下:
cpp
bool LLMManager::initModel(
    const std::string& model_name,
    const std::map<std::string, std::string>& model_config
)
{
    auto provider_it = _providers.find(model_name);
    if (provider_it == _providers.end()) {
        ERR("model is not registered: {}", model_name);
        return false;
    }

    const bool success =
        provider_it->second->initModel(model_config);

    if (!success) {
        ERR("model initialization failed: {}", model_name);
        return false;
    }

    auto info_it = _models.find(model_name);
    if (info_it != _models.end()) {
        info_it->second._desc =
            provider_it->second->getModelDesc();
        info_it->second._isAvailable =
            success && provider_it->second->isAvailable();
    }

    INFO("model initialized: {}", model_name);
    return true;
}
这里不再需要知道具体的 Provider 类名,而是:
cpp
provider_it->second->initModel(model_config);通过 ILLMProvider 的虚函数机制,实际执行的仍然是 DeepSeek、ChatGPT、Gemini 或 Ollama 各自的初始化逻辑。
管理层只知道"我要初始化这个名字对应的模型",具体配置内容由对应 Provider 解释。
对于云端模型,配置可能是:
cpp
std::map<std::string, std::string> model_config{
    {"api_key", api_key}
};
对于 Ollama,则可以是:
cpp
std::map<std::string, std::string> model_config{
    {"model_name", "deepseek-r1:1.5b"},
    {"model_desc", "本地 Ollama 模型"},
    {"endpoint", "http://127.0.0.1:11434"}
};
这两份配置格式不同,但都通过同一个 manager.initModel(model_name, model_config) 入口提交。
4.2 什么叫"可用"
在当前设计里,模型状态至少要区分三个阶段:
- 没有注册 → Manager 找不到这个 model_name;
- 注册成功,但尚未初始化 → _modelsmodel_name._isAvailable = false;
- 初始化成功,并且 Provider 报告可用 → _modelsmodel_name._isAvailable = true。
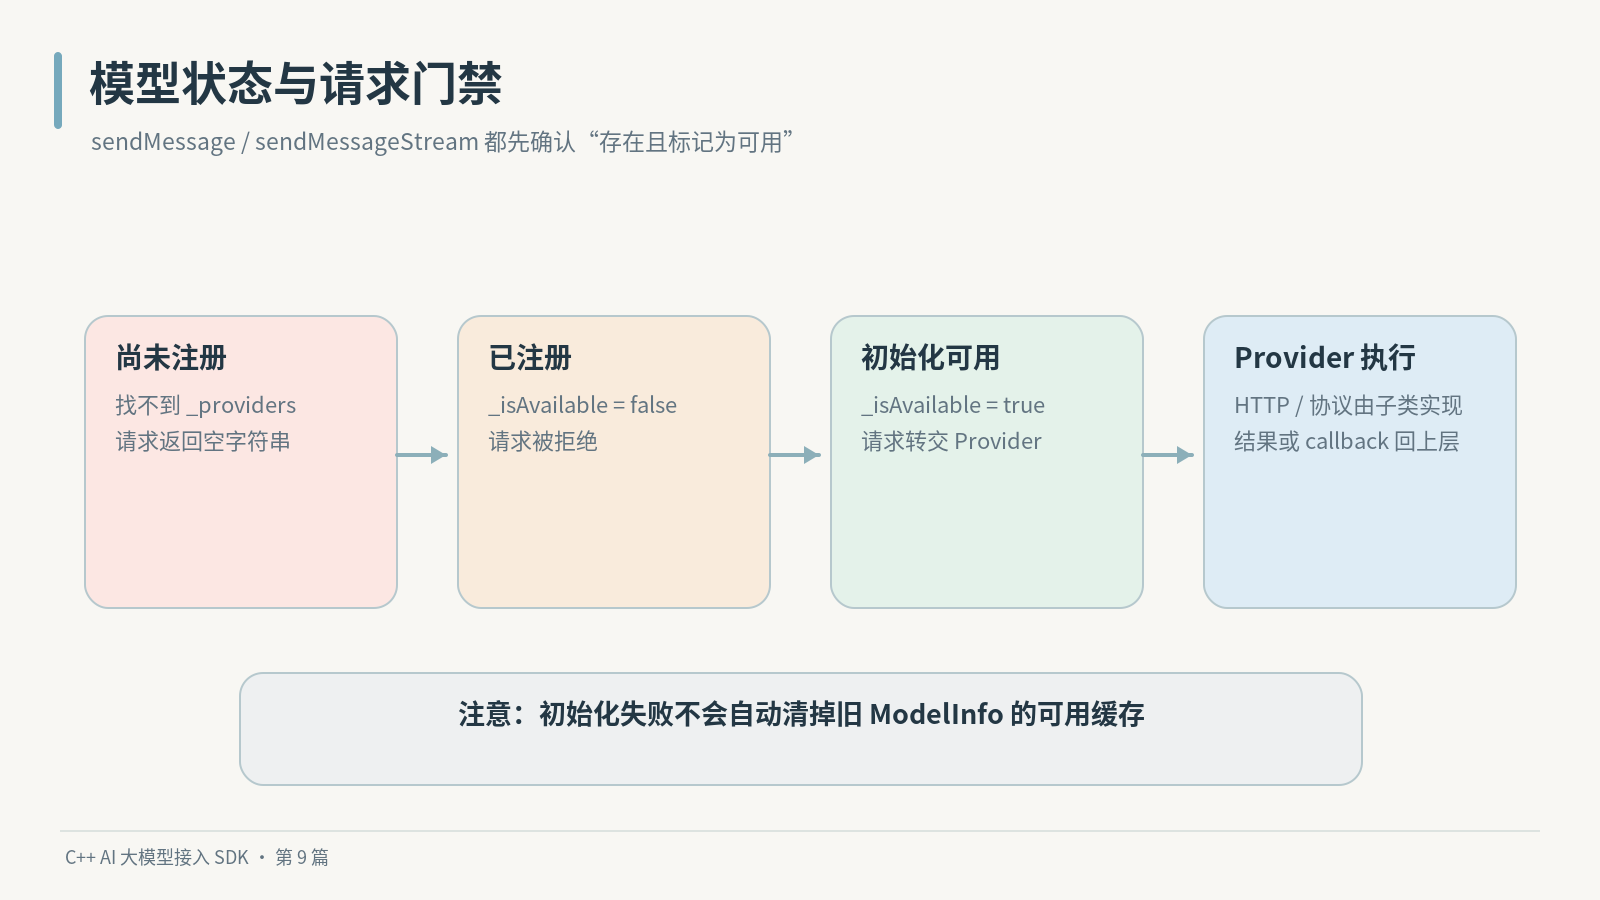
这个 true 有明确的项目语义:Provider 已通过自己的初始化检查,并被 Manager 标记为可用。它不意味着此刻已经进行过一次真实请求,更不能保证远端服务始终在线、密钥长期有效或本地模型随时能加载。
此外,initModel() 存在两个值得按真实代码理解的边界:
第一,如果具体 Provider 的 initModel() 返回 true,但随后的 isAvailable() 返回 false,Manager 会把缓存标记为 false;不过当前 LLMManager::initModel() 仍然返回 true 。因此需要检查实际可用性时,还应调用 isModelAvailable()。
第二,如果一个已经成功初始化的模型之后再次初始化失败,当前实现会提前 return false,不会主动把 _models 中旧的 _isAvailable 清零 。因此这一版的 ModelInfo 是由初始化过程维护的缓存,不是每次查询都重新探测 Provider 状态。在业务使用上,不应该把它理解为实时健康检查。
理解这些边界,比简单记住"true 就是成功"更重要。
五、查询模型状态:两张表怎样配合工作
当页面准备展示模型选择列表,或者业务准备给某个模型发消息时,都需要知道现在能使用哪些模型,所以LLMManager 提供了两个查询函数。
5.1 获取所有可用模型
cpp
std::vector<ModelInfo> LLMManager::getAvailableModels() const
{
    std::vector<ModelInfo> result;
    result.reserve(_models.size());

    for (const auto& pair : _models) {
        const ModelInfo& info = pair.second;

        if (info._isAvailable) {
            result.push_back(info);
        }
    }

    return result;
}
代码没有遍历 _providers 去重复调用每一个 Provider 的 isAvailable(),而是直接读取 _models 保存的状态。
它做了三件事:
-
为返回结果预留最多
_models.size()个元素的空间,减少扩容次数。 -
遍历模型信息表,只收集
_isAvailable == true的模型。 -
返回
std::vector<ModelInfo>,由调用方用于展示或进一步处理。
由于底层使用 std::map,遍历时按模型名称的键顺序访问,而不是按照注册时间或用户偏好排序。后面若需要自定义列表顺序,应由另外的展示逻辑负责。
返回的是 ModelInfo 的副本,而不是 Manager 内部表项的可修改引用。因此上层修改返回列表里的字段,不会直接改写 Manager 保存的状态。
5.2 检查指定模型是否可用
cpp
bool LLMManager::isModelAvailable(
    const std::string& model_name
) const
{
    auto it = _models.find(model_name);
    if (it == _models.end()) {
        ERR("model is not registered or not initialized: {}", model_name);
        return false;
    }
    if (!it->second._isAvailable) {
        ERR("model is not available: {}", model_name);
    }
    return it->second._isAvailable;
}
先查名称是否存在,再读取缓存的可用标记。
这个函数不会在调用时主动发网络请求,也不会再次执行具体 Provider 的初始化。它的职责就是依据当前模型信息表判断是否允许向下转发。
这也是为什么我们要在注册时把模型设为不可用,在初始化后再更新它。两个阶段如果混为一谈,业务就可能向一个尚未准备好的 Provider 发送请求。
六、全量和流式请求怎样统一路由
模型已经注册、初始化、状态也能查询。接下来就要让业务层真正不再判断"这次用的是哪个具体 Provider"。
这部分也是 LLMManager 最直接的价值:同一个模型名选择逻辑,既服务全量请求,也服务流式请求。
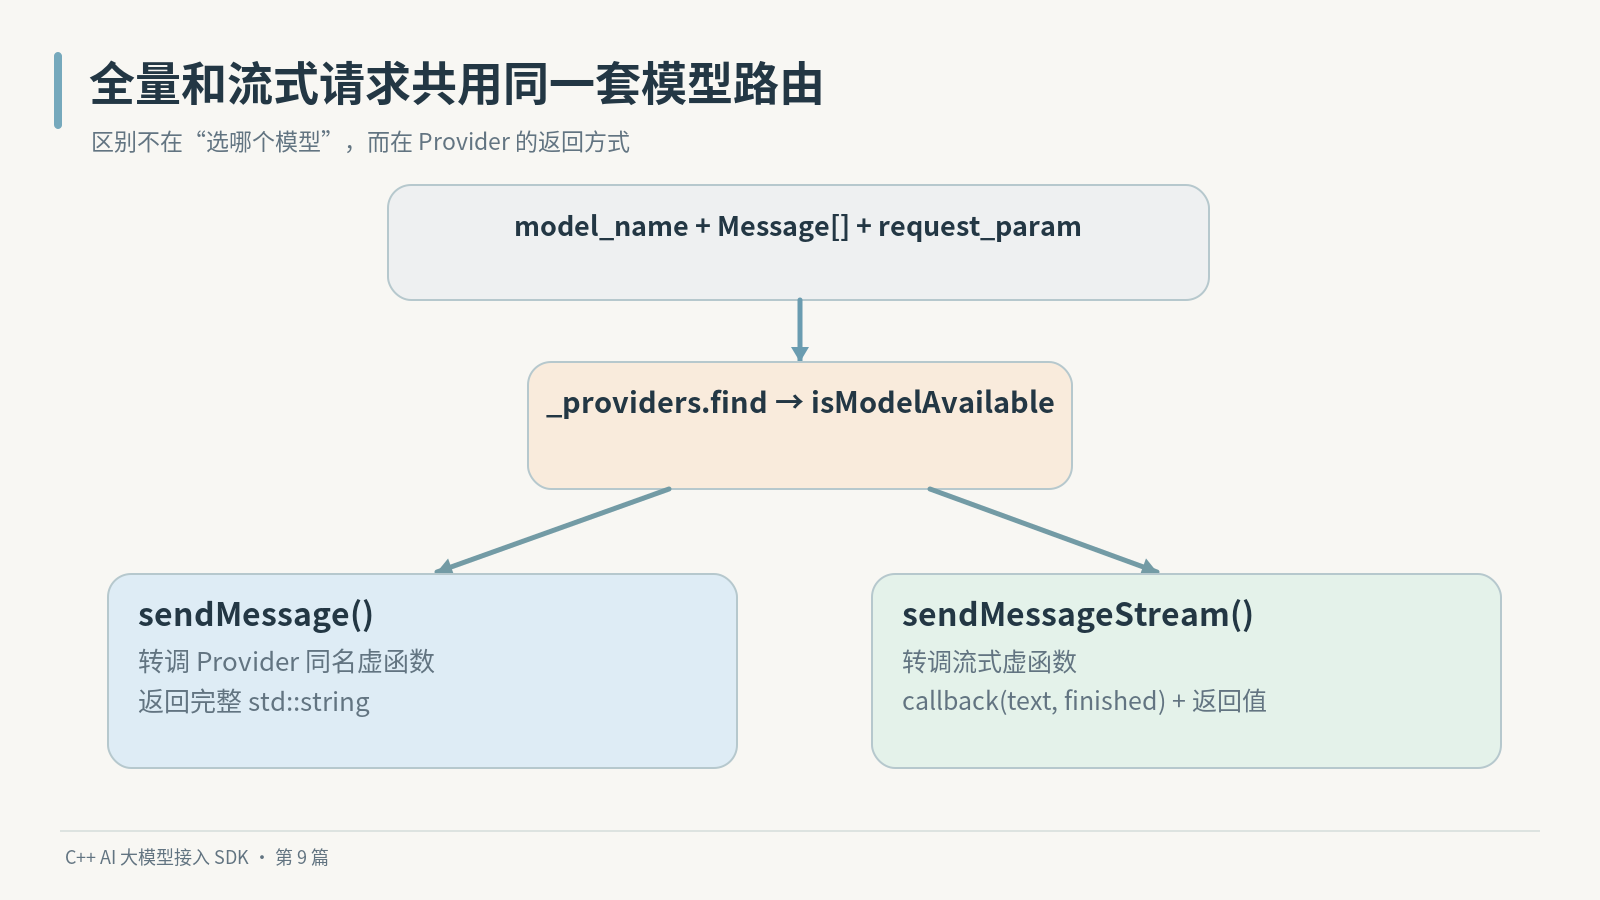
6.1 sendMessage() 只做必要的检查与转发
cpp
std::string LLMManager::sendMessage(
    const std::string& model_name,
    const std::vector<Message>& messages,
    const std::map<std::string, std::string>& request_param
)
{
    auto provider_it = _providers.find(model_name);
    if (provider_it == _providers.end()) {
        ERR("model is not registered: {}", model_name);
        return "";
    }

    if (!isModelAvailable(model_name)) {
        ERR("model is not available: {}", model_name);
        return "";
    }

    return provider_it->second->sendMessage(
        messages, request_param
    );
}
相比前几篇一个 Provider 内部可能有很长的网络处理流程,这个函数反而很短。
原因正是它没有越界做别人的工作:
cpp
查 _providers,确认模型存在
    ↓
查 _models,确认当前标记为可用
    ↓
调用 ILLMProvider::sendMessage(...)
    ↓
具体 Provider 完成 HTTP / JSON / 业务响应解析
    ↓
返回 std::string
因此,路由到 ChatGPT 时会进入 ChatGPTProvider::sendMessage();路由到 Ollama 时会进入 OllamaLLMProvider::sendMessage()。管理层不需要知道一个使用 Responses API,另一个使用 /api/chat。
对于不存在或当前被标记为不可用的模型,当前实现返回空字符串,同时记录错误日志。空字符串并不是一种可以区分所有失败原因的结构化错误类型:调用方如果需要判断失败原因,还必须结合日志或后续更明确的错误设计。
6.2 sendMessageStream() 为什么同样不需要协议判断
流式转发的实现与全量几乎平行:
cpp
std::string LLMManager::sendMessageStream(
    const std::string& model_name,
    const std::vector<Message>& messages,
    const std::map<std::string, std::string>& request_param,
    std::function<void(const std::string&, bool)> callback
)
{
    auto provider_it = _providers.find(model_name);
    if (provider_it == _providers.end()) {
        ERR("model is not registered: {}", model_name);
        return "";
    }

    if (!isModelAvailable(model_name)) {
        ERR("model is not available: {}", model_name);
        return "";
    }

    return provider_it->second->sendMessageStream(
        messages, request_param, std::move(callback)
    );
}
增加的参数是:
cpp
std::function<void(const std::string&, bool)> callback前面已经多次接触过这个形式。std::string 负责传递这一段增量文本,bool 表示当前回调通知的结束状态。
LLMManager 在这里并不直接执行 callback(text, finished),而是把它交给具体 Provider。底层 Provider 如何判断结束,仍然由它自己的协议处理逻辑负责。
例如:
- DeepSeekProvider → 解析 SSE 和 DONE;
- ChatGPTProvider → 解析 Responses API 事件;
- GeminiProvider → 解析兼容 SSE 响应;
- OllamaLLMProvider → 解析 NDJSON 与 done=true。
它们把协议差异整理成统一的回调形状,再交给上层。LLMManager 不负责在这里把 SSE 转 NDJSON,也不会直接拼接网络 chunk。
需要特别区分两件事:
-
sendMessageStream()可以在一次请求执行过程中持续触发回调; -
当前管理层仍然同步调用具体 Provider 的方法,并最终返回该方法返回的字符串。
存在回调不代表当前 Manager 自动创建了异步任务或后台线程。 同样,std::move(callback) 只是将当前回调对象向下传递的方式,并不会改变网络协议本身。
6.3 一次请求真正经过了哪些层
把前面的代码连起来,业务要调用本地 Ollama,可以这样理解:
cpp
上层传入 "deepseek-r1:1.5b"
    ↓
LLMManager::_providers.find(model_name)
    ↓
LLMManager::isModelAvailable(model_name)
    ↓
ILLMProvider::sendMessageStream(...)
    ↓ 运行时多态
OllamaLLMProvider::sendMessageStream(...)
    ↓
本地 POST /api/chat
    ↓
NDJSON 解析、增量 callback、最终字符串
    ↓
返回上层
换成 gpt-5.5,Manager 的查找流程仍然一样;只是在多态调用之后,进入了 ChatGPTProvider 的具体实现。
模型选择与模型协议从此成为两个独立的问题。
七、用现有测试验证管理层的调用链
理解一个管理类,最直观的办法就是从使用方把注册、初始化、查询、发送连起来看一遍。
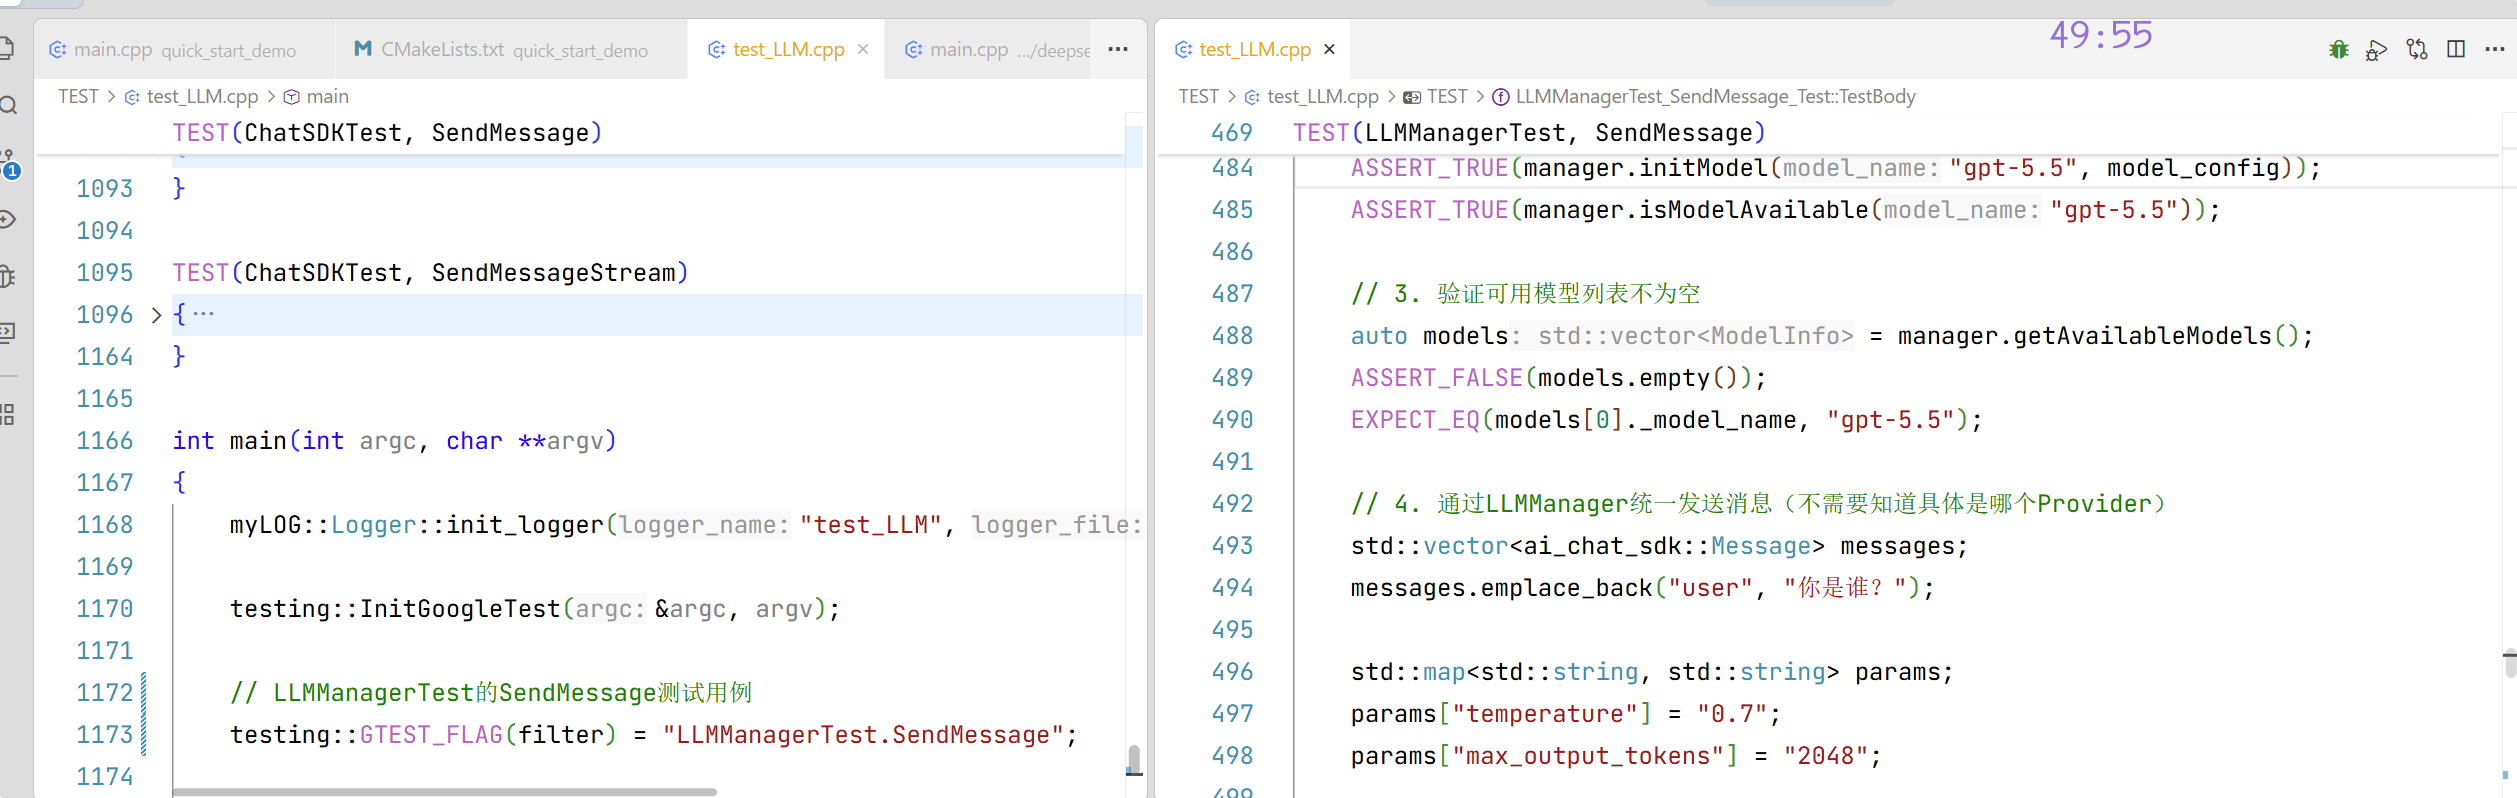
项目中的测试代码位于:
cpp
TEST/test_LLM.cpp其中已经提供:
cpp
TEST(LLMManagerTest, SendMessage)
TEST(LLMManagerTest, SendMessageStream)
这两个测试使用 ChatGPTProvider 来验证 Manager 的全量与流式转发。
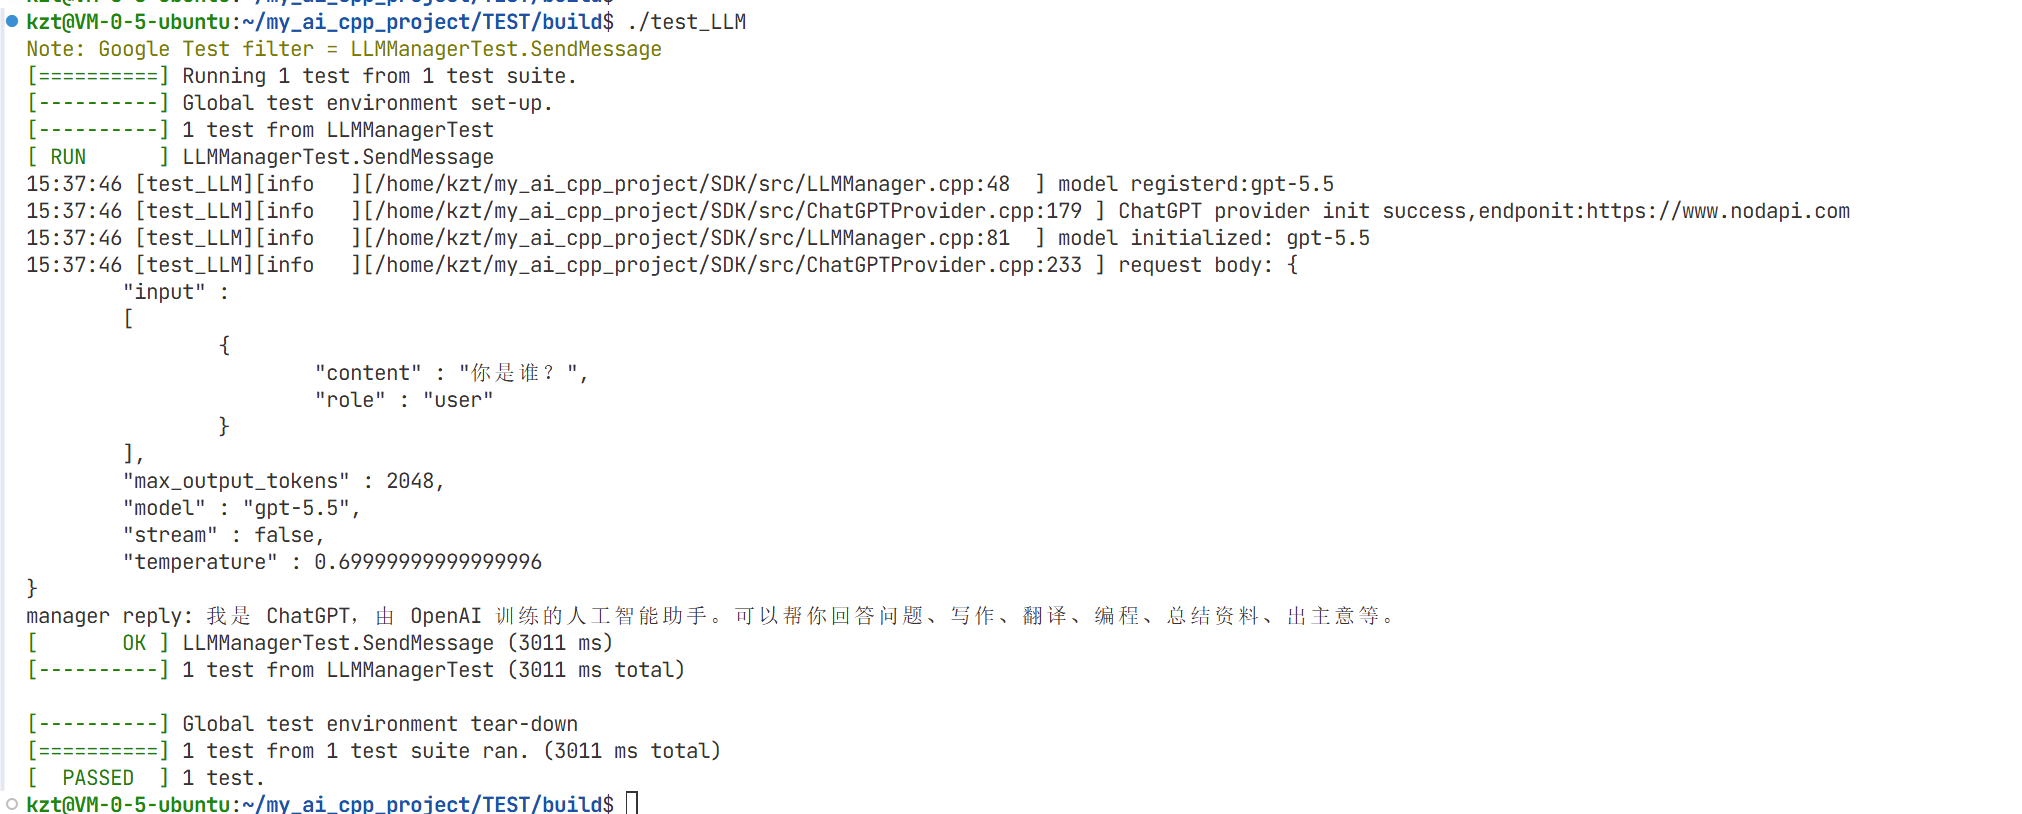
7.1 全量测试:同样的 Provider,不同的调用入口
测试中首先创建管理器并注册 Provider:
cpp
ai_chat_sdk::LLMManager manager;
ASSERT_TRUE(manager.registerProvider(
    std::make_unique<ai_chat_sdk::ChatGPTProvider>()
));
接着读取 API Key 并初始化模型。项目现有测试使用的环境变量名为 CHATGPT_KEY_API:
cpp
const char* api_key = std::getenv("CHATGPT_KEY_API");
ASSERT_NE(api_key, nullptr);
std::map<std::string, std::string> model_config;
model_config["api_key"] = api_key;
model_config["base_url"] = "https://www.nodapi.com";
ASSERT_TRUE(manager.initModel("gpt-5.5", model_config));
ASSERT_TRUE(manager.isModelAvailable("gpt-5.5"));
这里的 base_url 是当前测试代码写入的地址,使用时需要自行确认该服务地址和 API 凭据确实可访问;它并不是 SDK 固定只能使用的服务器。
然后查询可用模型:
cpp
auto models = manager.getAvailableModels();
ASSERT_FALSE(models.empty());
EXPECT_EQ(models[0]._model_name, "gpt-5.5");
最后构造消息并通过管理层发送:
cpp
std::vector<ai_chat_sdk::Message> messages;
messages.emplace_back("user", "你是谁?");
std::map<std::string, std::string> params;
params["temperature"] = "0.7";
params["max_output_tokens"] = "2048";
std::string reply = manager.sendMessage(
    "gpt-5.5", messages, params
);
EXPECT_FALSE(reply.empty());注意这里展示的是现有测试代码中的参数写法 。当前 ChatGPTProvider::sendMessage() 实际读取的通用请求参数键是 max_tokens,再把它映射成上游协议中的 max_output_tokens;所以上面测试里的 params["max_output_tokens"] 并不会被当前 Provider 按该键读取,它会使用默认的最大输出值。自己编写新的调用代码时应使用:
cpp
params["max_tokens"] = "2048";这个细节也说明 Manager 只负责透传 request_param,它不负责替具体 Provider 纠正参数键名。
7.2 流式测试:模型路由不变,只是多了回调
另一个测试仍然先注册和初始化同一个 gpt-5.5,然后准备多条消息,再调用:
cpp
std::string streamedText;

auto writeChunk = [&](const std::string& chunk, bool isDone) {
    if (!chunk.empty()) {
        streamedText += chunk;
        INFO("chunk: {}", chunk);
    }

    if (isDone) {
        INFO("[DONE]");
    }
};

const std::string fullData = manager.sendMessageStream(
    "gpt-5.5",
    messages,
    requestParam,
    writeChunk
);

EXPECT_FALSE(fullData.empty());
EXPECT_FALSE(streamedText.empty());
EXPECT_EQ(fullData, streamedText);
这里有三个不同的观察点:
-
chunk:流式处理期间收到的增量文本。 -
streamedText:测试代码自己把这些增量文本拼接起来的结果。 -
fullData:具体 Provider 的sendMessageStream()最后返回的完整字符串。
最后用 EXPECT_EQ 比较两个完整结果,目的就是检查:通过统一管理层转发以后,回调累计的文本与 Provider 返回的文本是否一致。
这个比较发生在实际请求之后。只有网络请求和具体 Provider 的流式实现真实执行了,才能用结果证明这条链路工作正常。
cpp
./build-test/test_LLM --gtest_filter=LLMManagerTest.SendMessageStream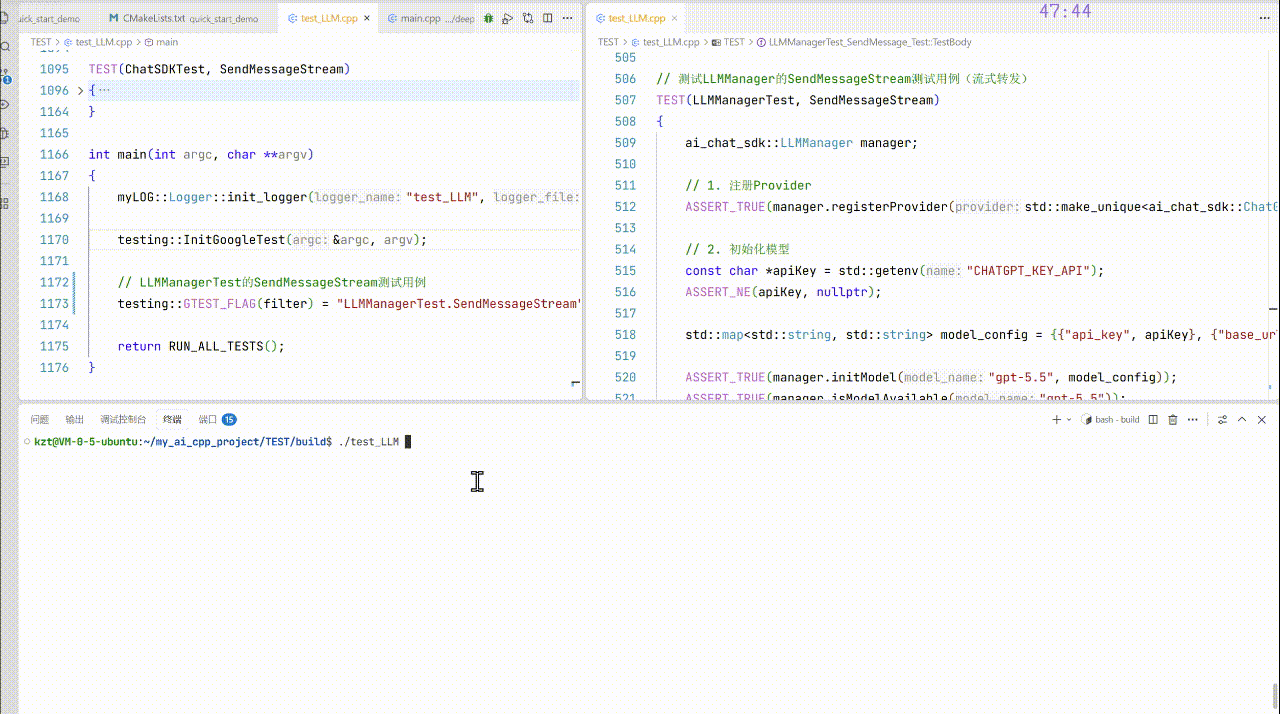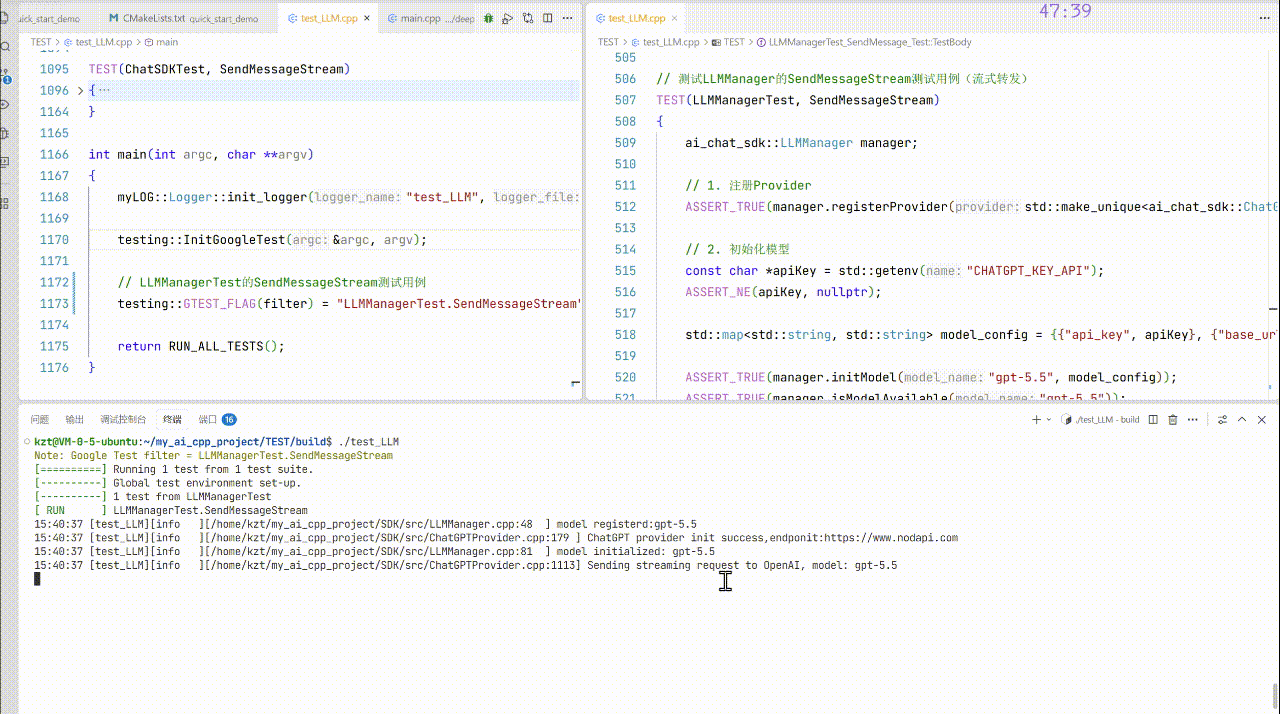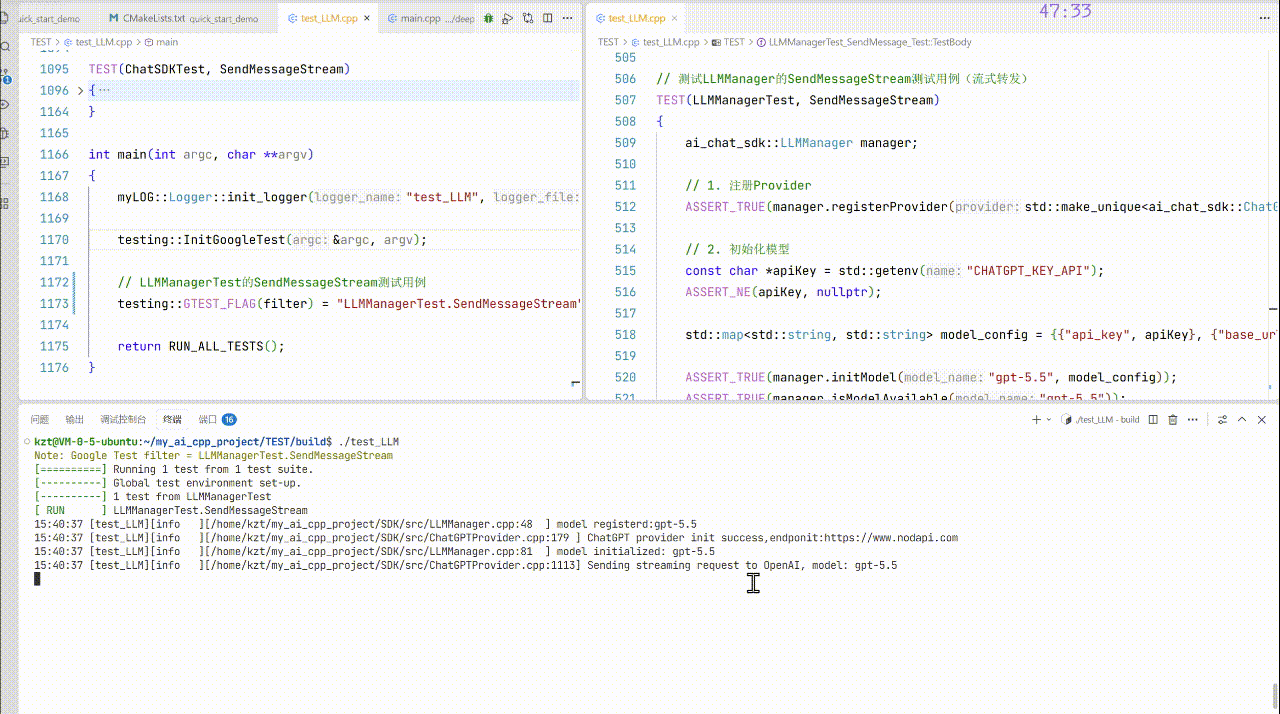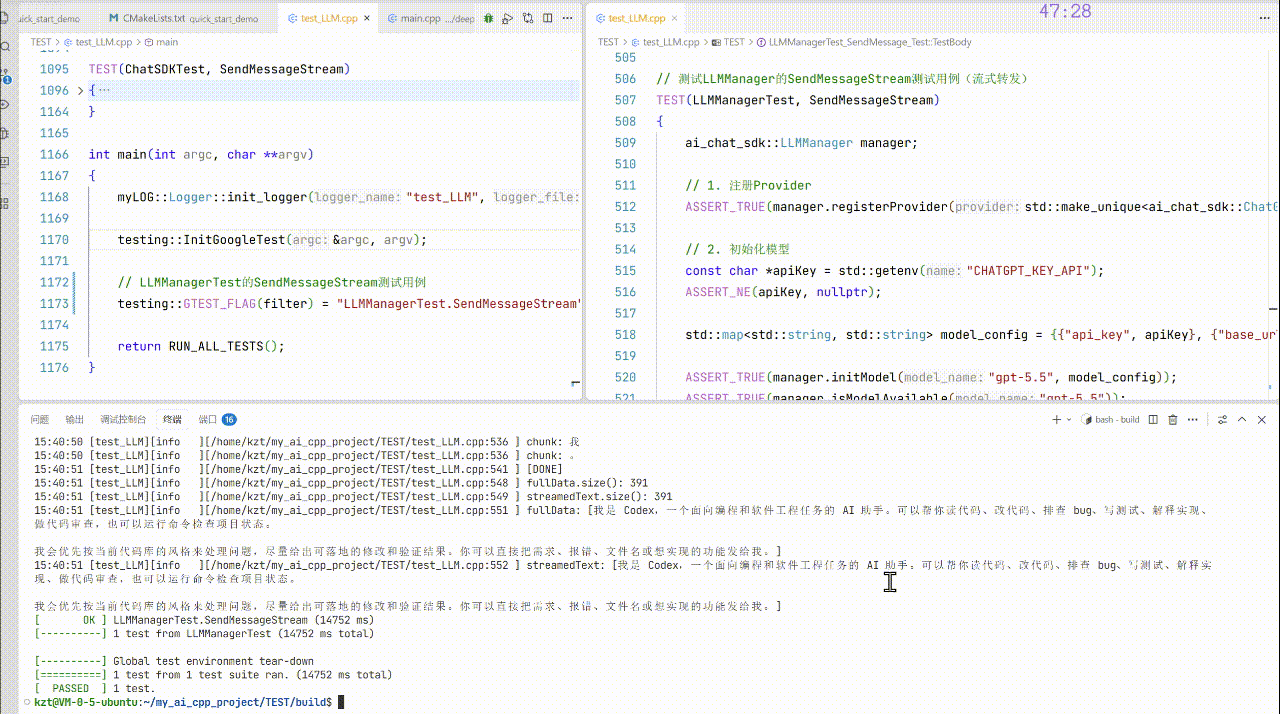
写在最后
到这里,LLMManager 已经把前面四个相互独立的 Provider 收到了同一个入口下。
回头看这篇的核心变化,其实就是两件事:
- 原来:业务代码自己保存 Provider,再按类型分支调用;
- 现在:业务只给出 model_name,LLMManager 负责查找和转发。
为了实现这件事,我们分别解决了 Provider 所有权、模型名索引、注册与初始化的阶段区分、可用状态查询,以及全量/流式调用的统一路由。
因此,增加模型时最重要的不是向业务层追加新的分支,而是为新模型准备一个遵守 ILLMProvider 的实现,并让它进入管理层。
但现在还差一层。
LLMManager 能回答"这次消息交给哪个模型",却不负责回答"这条消息属于哪个会话""上一轮聊过什么""重新打开页面以后怎样找回聊天记录"。
一次请求可以携带 Message[],但谁创建这些消息、谁维护多轮对话历史、谁给每段对话分配 ID,不是模型管理层的职责。
所以下一篇,我们开始进入 SessionManager:从模型调用走向真正可以连续对话的会话管理,并结合当前项目的数据持久化实现,理解会话生命周期与历史消息是如何保存和恢复的。