一.项目创建
Linux 机器上创建 mq 项目, 并且规划开发目录, 使用 Makefile 组织项目。
cpp
bitmq/                  项目根目录
├── mqdemo/             示例代码 ------ 各个模块怎么用的演示
├── mqclient/           客户端模块 ------ 生产者 / 消费者
├── mqcommon/           公共模块 ------ 协议定义、工具类、日志、SQLite 封装
├── mqserver/           服务端模块 ------ Broker:交换机、队列、绑定、消息存储
├── mqtest/             单元测试 ------ GTest 用例
└── mqthird/            第三方依赖 ------ muduo、protobuf、gtest、sqlite3 等
目录结构说明
- mqdemo:编写一些功能用例时所在的目录
- mqcommon:公共模块代码(线程池、数据库访问、文件访问、日志打印、PB 相关,以及其他一些琐碎的功能模块代码)
- mqclient:客户端模块代码
- mqserver:服务器模块代码
- mqtest:单元测试
- mqthird:用到的第三方库存放目录
二.消息队列服务端核心模块实现
1.日志打印工具
为了便于编写项目中能够快速定位程序的错误位置,因此编写一个日志打印类,进行
简单的日志打印。
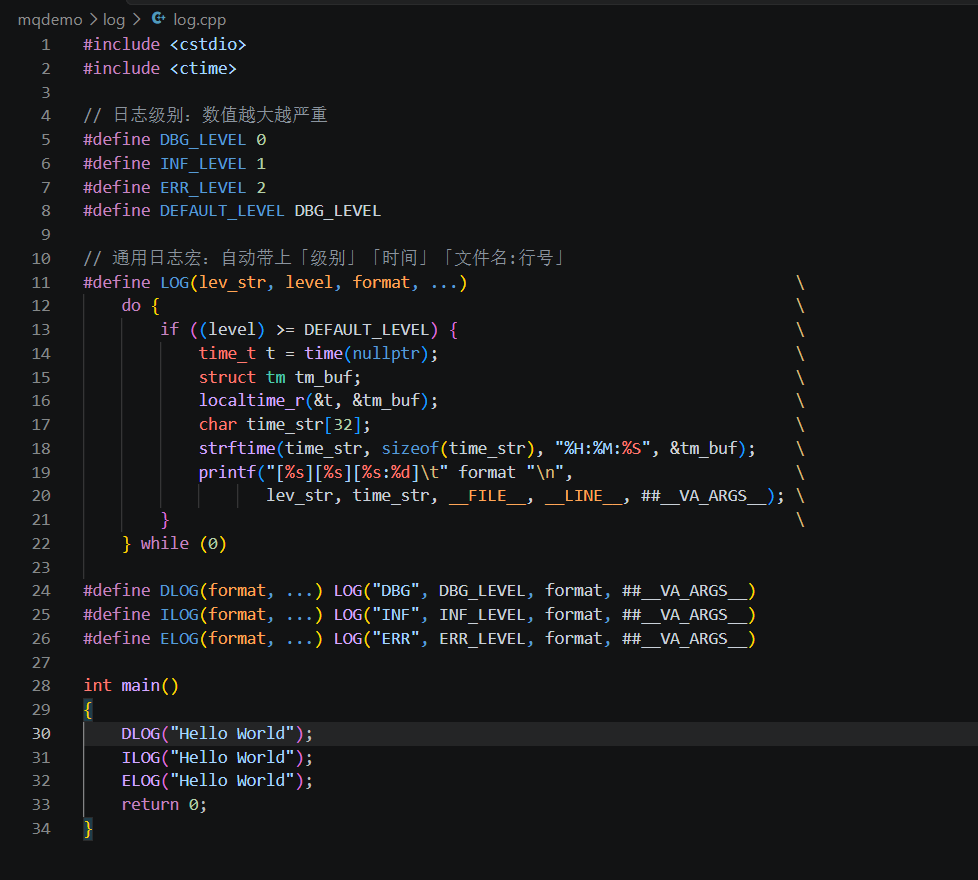
直接看代码:
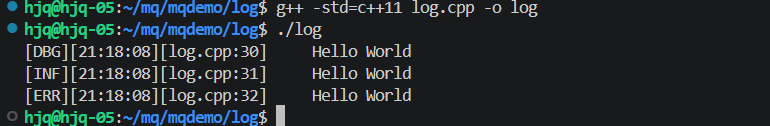
运行结果:
一共用了四个函数,串成一条链
1. time(nullptr)
cpp
time_t t = time(nullptr);
- 头文件 :
<ctime>- 作用 :拿到当前的时间戳------也就是自 1970-01-01 00:00:00 UTC 以来经过的秒数
- 参数传
nullptr:表示"我只想要返回值,不通过指针出参"
2.localtime_r(&t, &tm_bu
struct tm tm_buf;
localtime_r(&t, &tm_buf);
- 头文件 :
<ctime>(POSIX 标准,不是 C 标准)- 作用 :把
time_t时间戳转换成本地时间的结构体(年、月、日、时、分、秒)_r后缀 :表示 reentrant(可重入) ,也就是线程安全版 ------结果写进你传进去的tm_buf,不用内部静态缓冲区
-
strftime(time_str, sizeof(time_str), "%H:%M:%S", &tm_buf)
char time_str[32];
strftime(time_str, sizeof(time_str), "%H:%M:%S", &tm_buf);
- 头文件 :
<ctime>- 作用 :把
struct tm按格式串拼成文本,写进缓冲区- 四个参数:目标缓冲区、缓冲区大小、格式串、时间结构体
- 格式符 :
%H= 小时(24 小时制)、%M= 分钟、%S= 秒- 注意 :秒是大写
%S,小写%s在 glibc 里是"自纪元以来的秒数",会打出一串十位数
4. printf(...)
- 头文件 :
<cstdio>- 作用:按格式串输出到标准输出
调用链串起来
cpp
time(nullptr)
    ↓  拿到时间戳(一个整数,比如 1717149200)
localtime_r(&t, &tm_buf)
    ↓  转换成本地时间结构(年、月、日、时、分、秒都拆好了)
strftime(buf, sizeof(buf), "%H:%M:%S", &tm_buf)
    ↓  格式化成文本(比如 "20:15:24")
printf("[%s][%s][%s:%d]\t" format "\n", ...)
↓ 连同级别、文件名、行号一起打出来每一步都在"换一种表示":整数 --> 结构体 --> 字符串 --> 最终输出。
除了函数,还用到了两个宏
| 宏 | 内容 | 类型 |
|---|---|---|
__FILE__ |
当前源文件名 | const char* |
__LINE__ |
当前行号 | int |
2.实用 Helper 工具
A.文件基础操作
Helper 工具类中要完成的是项目中需要的一些辅助零碎的功能代码实现,其中包括文件的基础操作,字符串的额外操作等在项目中用到的零碎功能。
a. 文件是否存在判断
b. 文件大小获取
c. 文件读/写
d. 文件创建/删除
e. 目录创建/删除
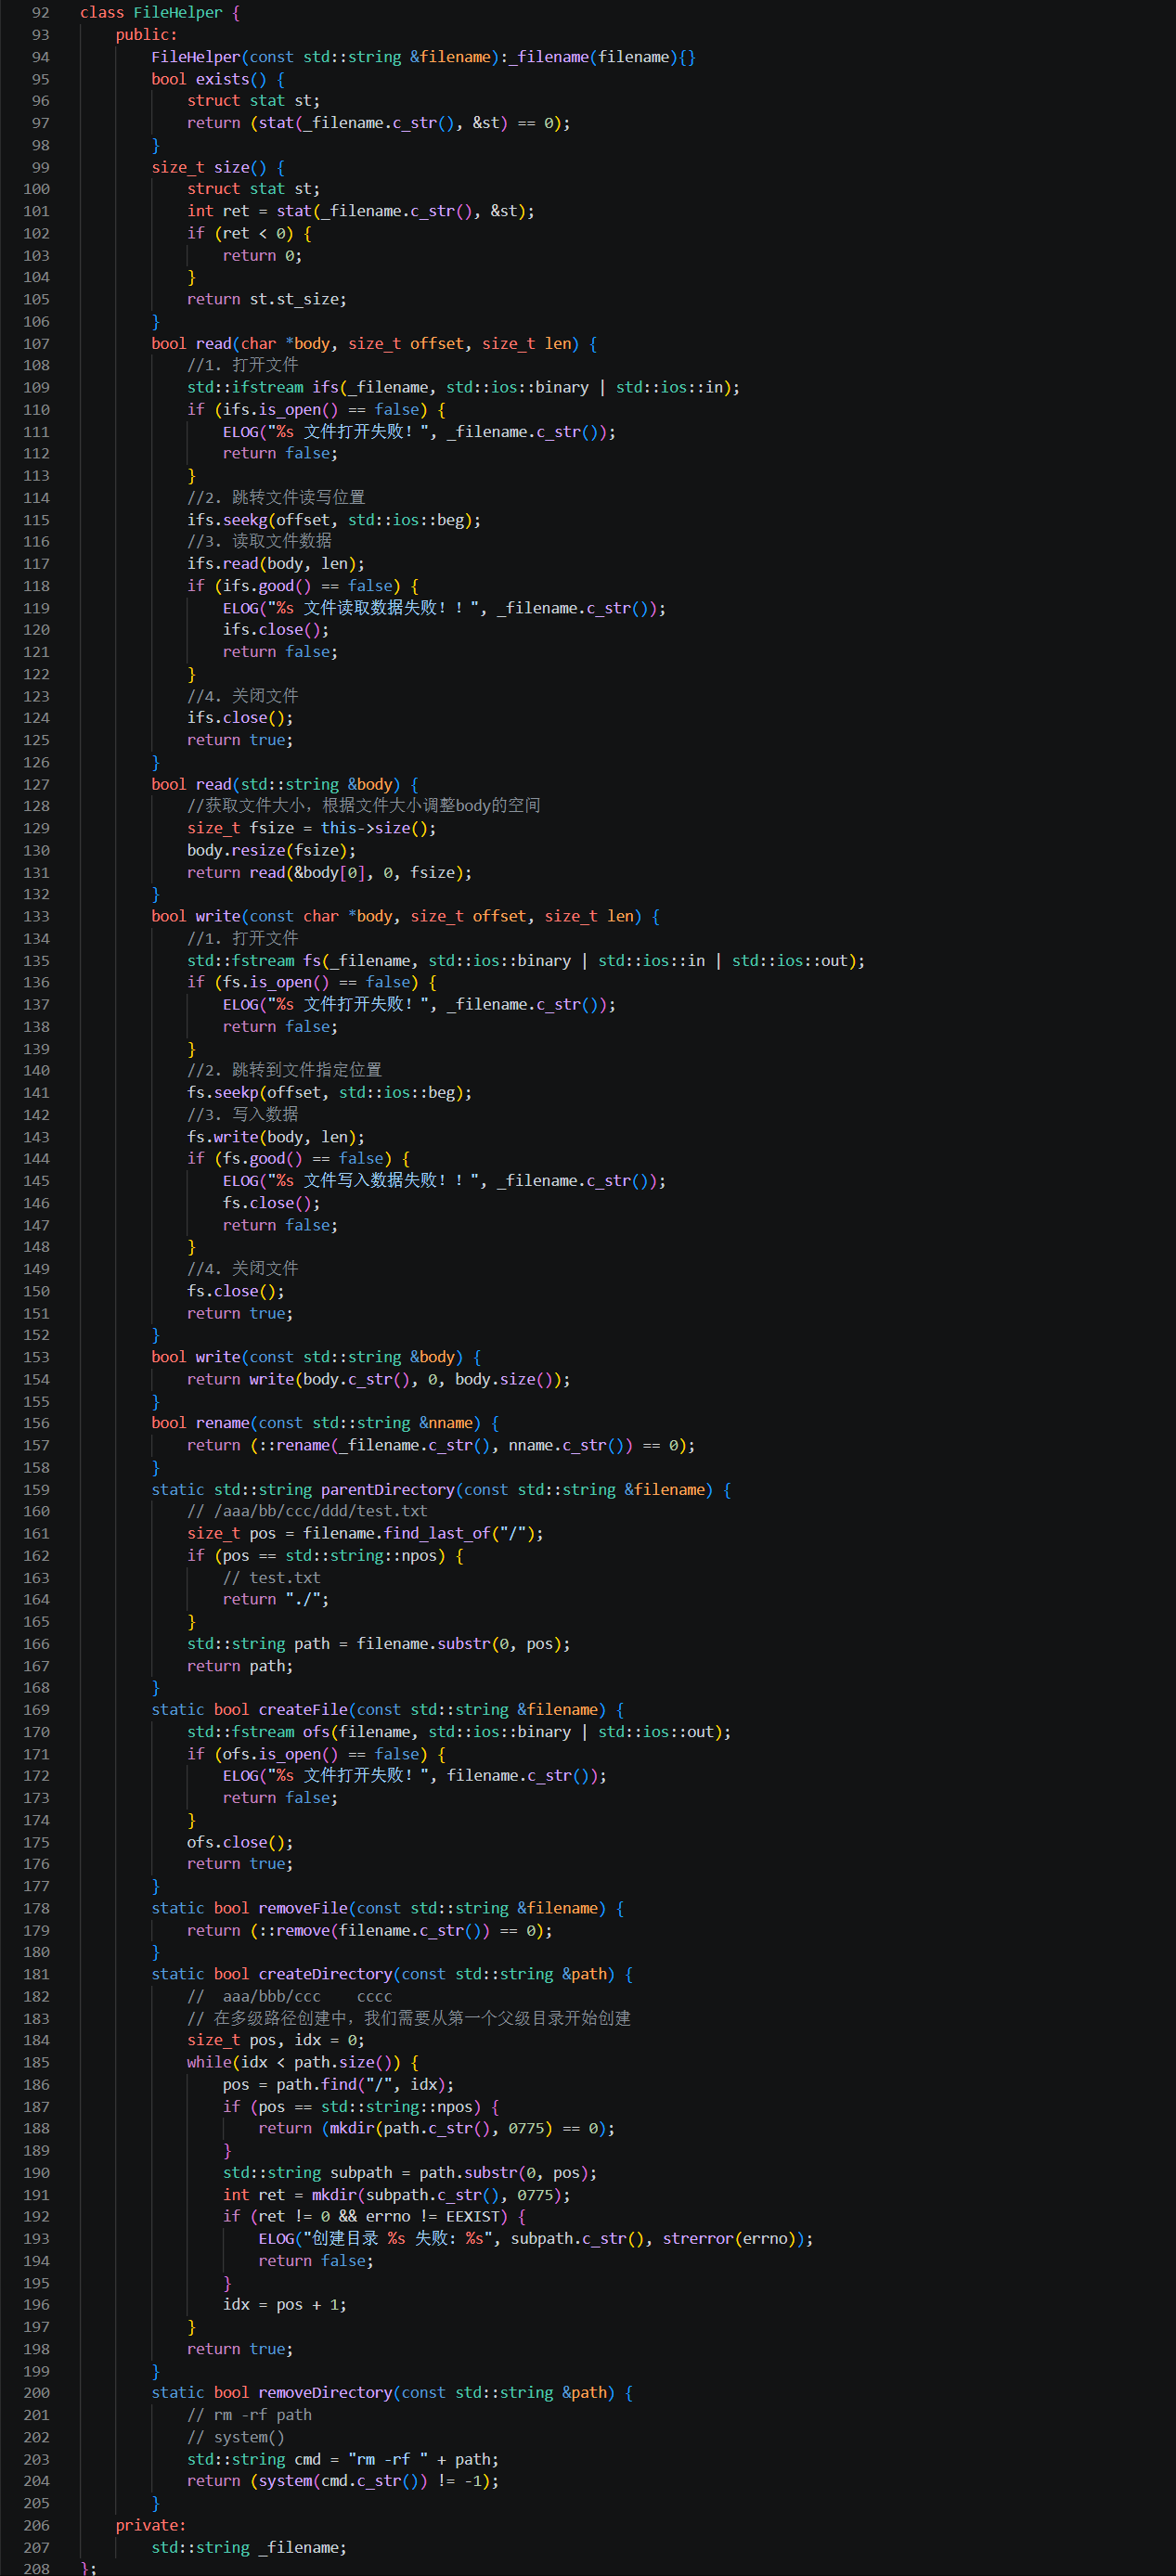
直接上代码:
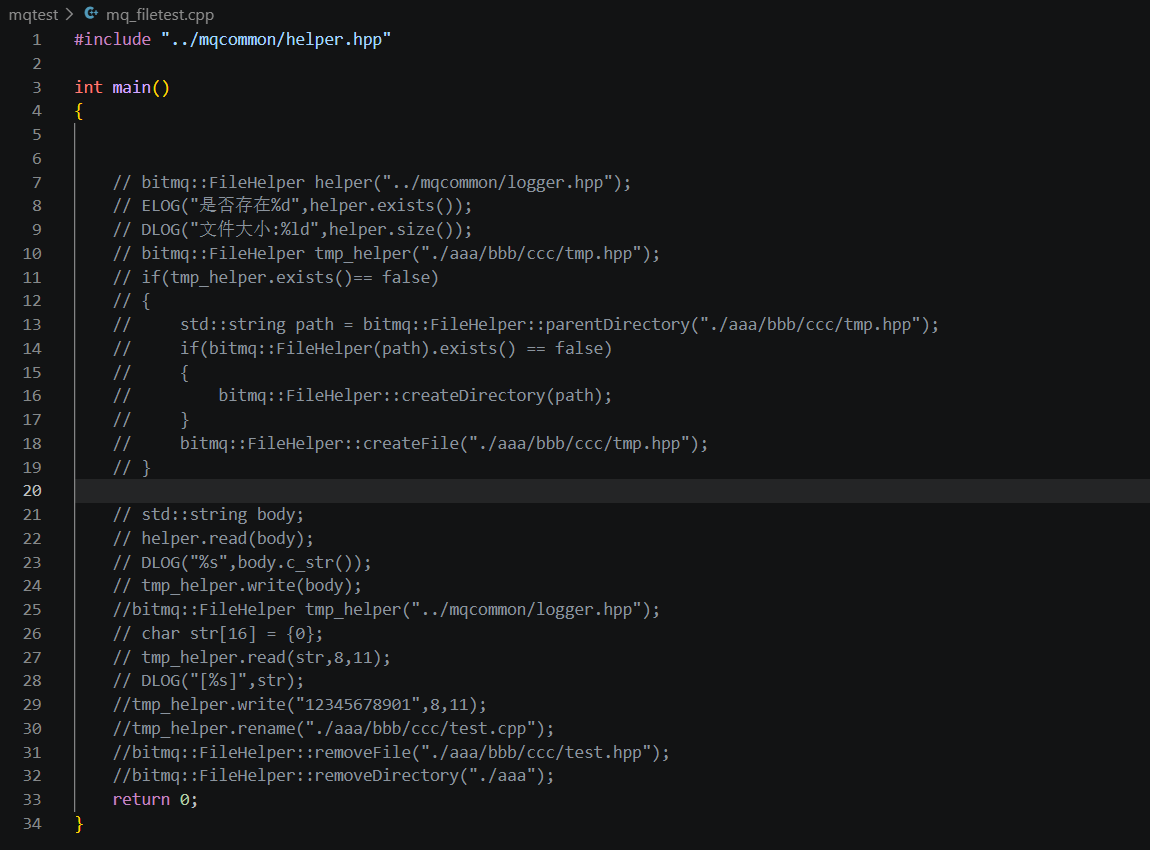
运行结果开始:
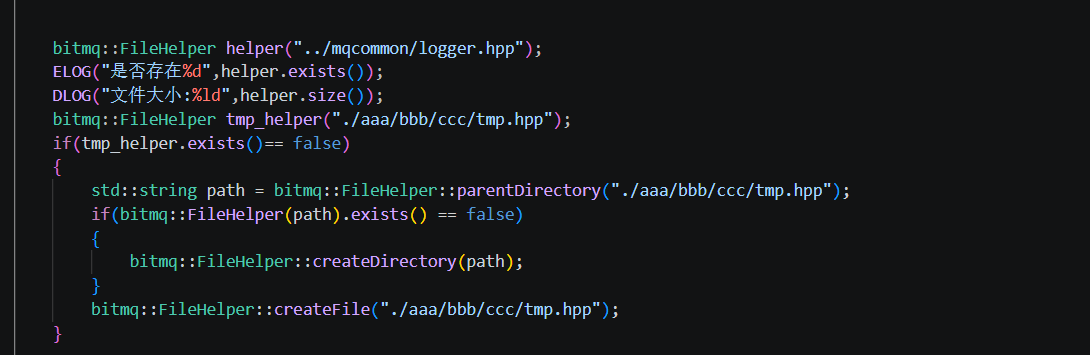
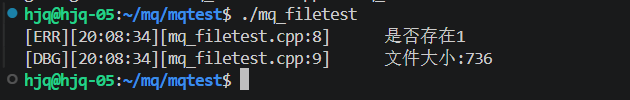
我们进行详细的查看文件的大小:
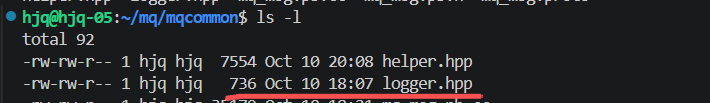
接着继续运行:
这个是读取文件的操作:
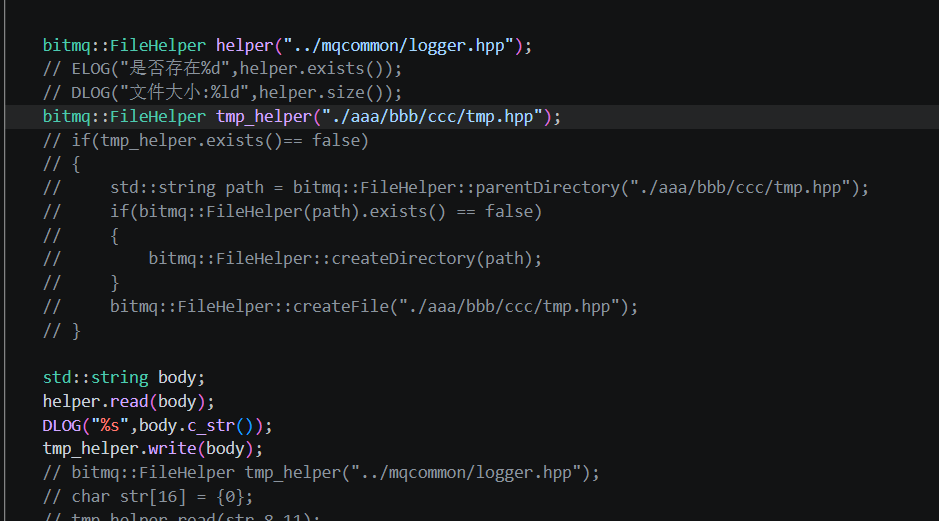
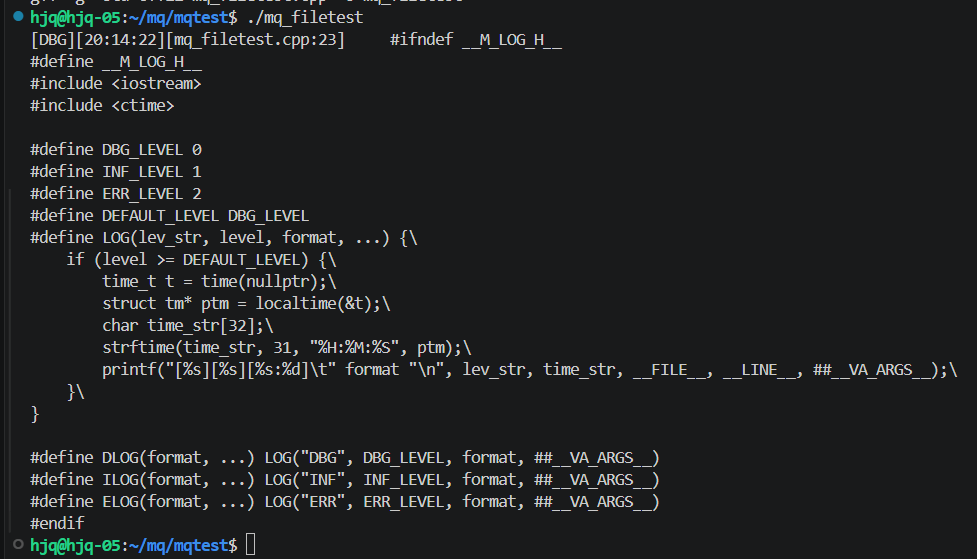
运行结果如下
read(str, 8, 11) = 从文件第 8 字节开始,抄 11 个字节到 str。 这一行测的是 read 的 offset 和 len 参数------从头读到尾只能验证"能读",从中间读一段才能验证"定位准不准"。
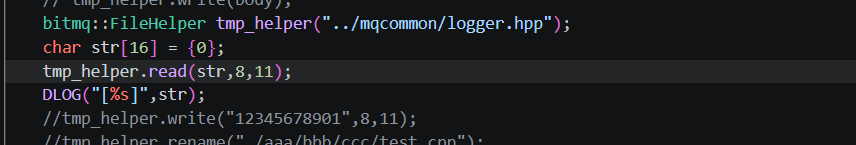
运行结果如下:
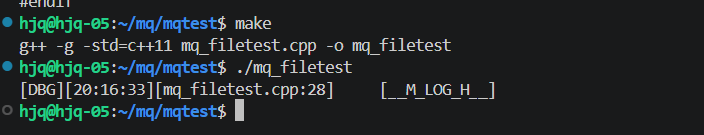
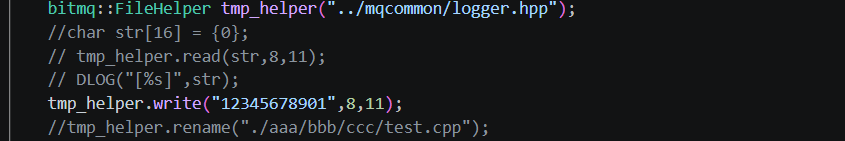
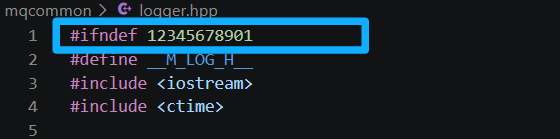
这个是文件的写操作,直接就覆盖在上面
cpp
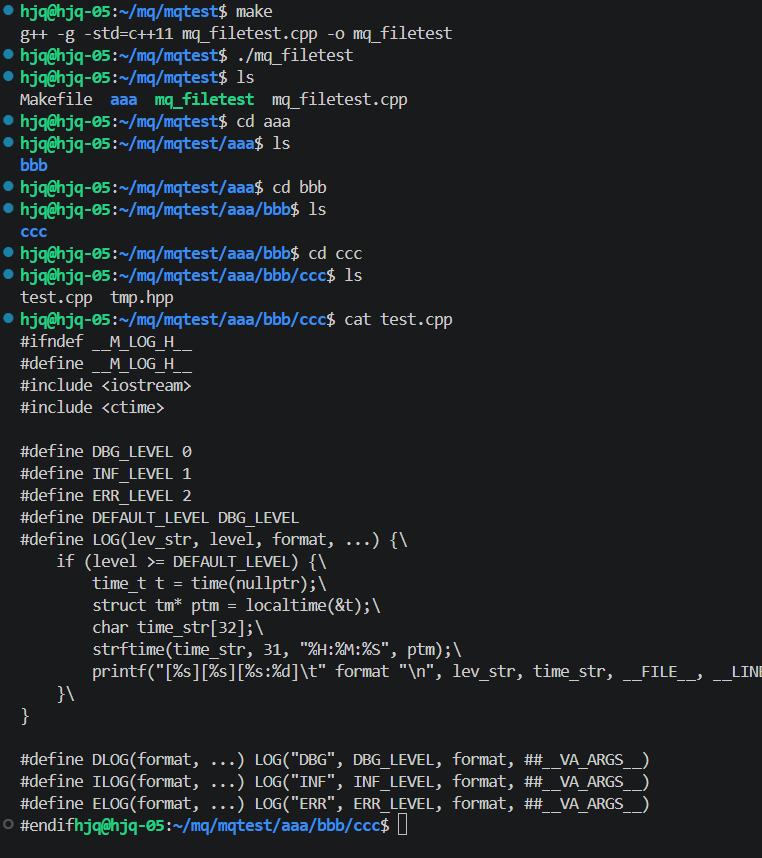
tmp_helper.rename("./aaa/bbb/ccc/test.cpp");结果如下:
cpp
tmp_helper.rename("./aaa/bbb/ccc/test.cpp");rename 是改名 / 移动文件。关键是------tmp_helper 是用 logger.hpp 构造的:
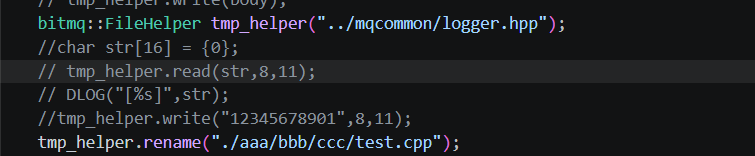
执行完这一句,logger.hpp 就不在原地了------它被"搬"到 ./aaa/bbb/ccc/ 下,并且换了个名字叫 test.cpp。
cpp
bitmq::FileHelper::removeFile("./aaa/bbb/ccc/test.cpp");删除文件 ./aaa/bbb/ccc/test.hpp。
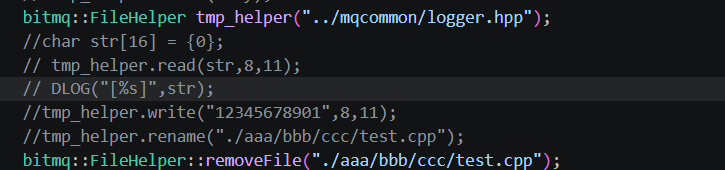
对照上面的结果我们会发现test.cpp已经不存在了
cpp
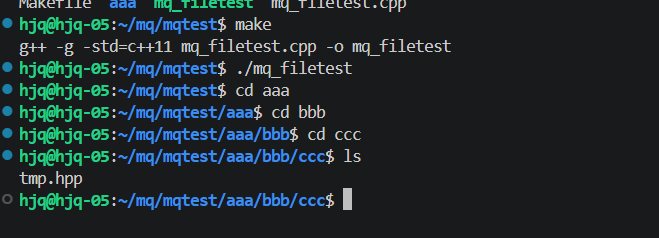
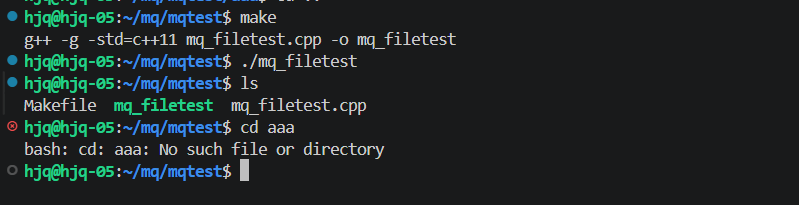
bitmq::FileHelper::removeDirectory("./aaa");递归删除整个 ./aaa 目录。
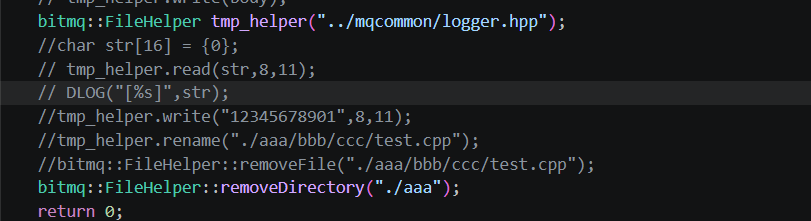
整个./aaa的目录也不存在了
用到的接口汇总
- bitmq::FileHelper helper(文件路径); FileHelper 构造函数,创建文件操作对象,绑定对应的文件路径。
- helper.exists(); 判断当前绑定路径的文件 / 目录是否存在,存在返回 true,不存在返回 false。
- helper.size(); 获取文件大小,返回文件的字节长度。
- bitmq::FileHelper::parentDirectory(文件路径); 静态成员函数,获取传入文件路径对应的父目录字符串。
- bitmq::FileHelper::createDirectory(目录路径); 静态成员函数,创建指定路径目录,支持多级目录创建。
- bitmq::FileHelper::createFile(文件路径); 静态成员函数,创建指定路径的空文件。
- helper.read(body); 从绑定的文件读取全部内容,存入字符串 body。
- helper.read(buf, offset, len); 从文件指定偏移 offset 位置,读取 len 字节数据,存入字符缓冲区 buf。
- helper.write(body); 将字符串 body 的全部数据写入文件,覆盖原有内容。
- helper.write(body, offset); 从文件指定偏移 offset 位置,写入字符串 body 的数据。
- helper.rename(新路径); 对当前绑定的文件进行重命名,也可实现文件移动。
- bitmq::FileHelper::removeFile(文件路径); 静态成员函数,删除指定路径的文件。
- bitmq::FileHelper::removeDirectory(目录路径); 静态成员函数,删除指定路径的目录。
- DLOG() / ELOG() 日志打印宏,输出调试日志、错误日志。
整体原理总结
FileHelper是封装的文件工具类,把文件读写、目录创建删除、文件重命名、路径解析等系统调用做了一层封装。消息队列持久化模块使用该类,完成交换机、队列、消息数据的落地存储与文件管理。
B.sqlite 基础操作类
a. 判断库是否存在
b. 创建并打开库 / 关闭库 / 删除库
c. 启动 / 提交 / 回滚事务
d. 执行语句
直接来看代码:
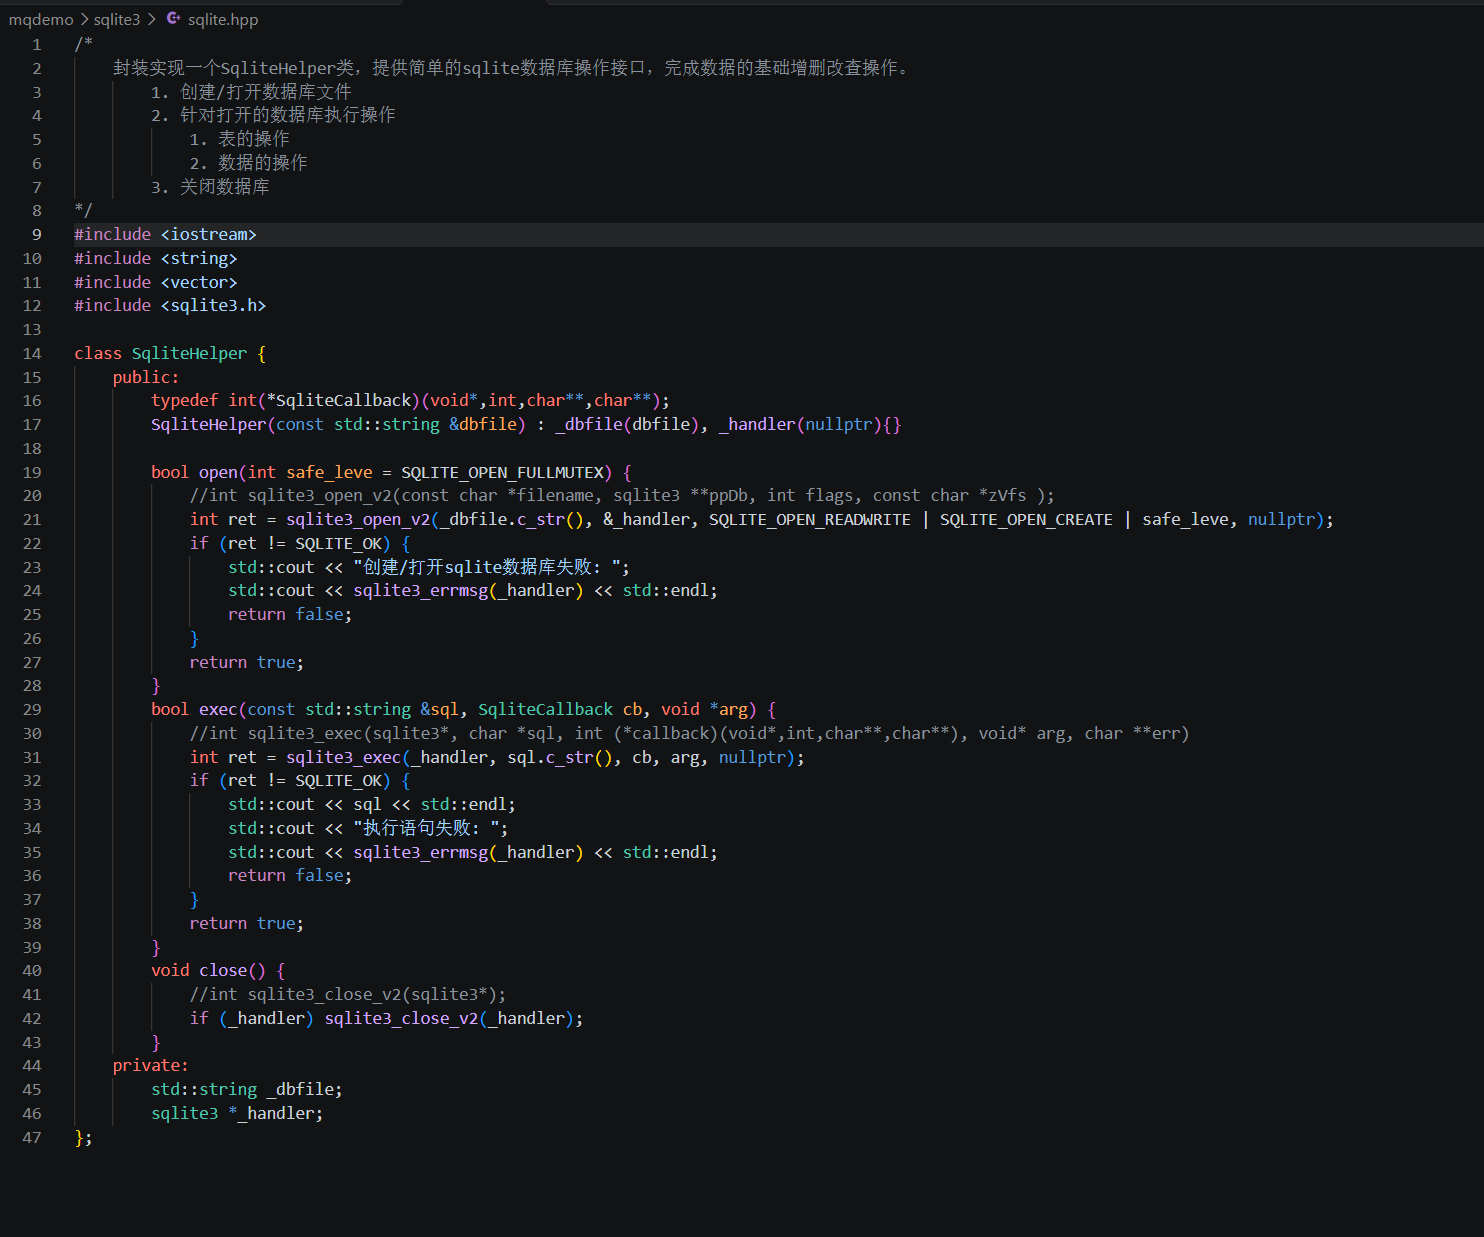
上述代码的运行结果以及更多内容可以看:【C++ 标准项目】发布订阅消息队列(篇四):sqlite 与 gtest 断言框架介绍及实战应用-CSDN博客
一共四个 SQLite API 函数
1. sqlite3_open_v2 ------ 打开 / 创建数据库
cpp
int sqlite3_open_v2(const char *filename, sqlite3 **ppDb, int flags, const char *zVfs);
- 作用 :打开数据库文件,文件不存在就按
flags决定是否创建ppDb是二级指针 :因为要把内部的sqlite3*交出来给调用方(出参)flags用|组合 :READWRITE | CREATE | FULLMUTEX- 返回值 :
SQLITE_OK(也就是 0)表示成功
2.sqlite3_errmsg ------ 取错误信息
cpp
const char *sqlite3_errmsg(sqlite3 *db);
- 作用 :返回最近一次操作的错误描述文本
- 必须紧跟着出错的那次调用使用------下一次操作会把错误信息覆盖掉
- 返回的是内部静态字符串,不用 free
3.sqlite3_exec ------ 执行 SQL
cpp
int sqlite3_exec(sqlite3 *db, const char *sql,
                 int (*callback)(void*, int, char**, char**),
                 void *arg, char **errmsg);
- 作用:一次执行一条或多条 SQL 语句
callback:查询时对每一行结果回调一次 ;建表、增删改可以传nullptrarg:透传给回调的用户数据(用来把结果收集出来)errmsg:传nullptr表示不需要详细错误文本(用sqlite3_errmsg取也行)- 返回值 :
SQLITE_OK表示成功
4.sqlite3_close_v2 ------ 关闭数据库
cpp
int sqlite3_close_v2(sqlite3 *db);
- 作用:关闭连接、释放句柄
- 比
sqlite3_close好用的地方 :即使还有未 finalize 的语句,它也会返回SQLITE_OK(把连接标记成"僵尸",等语句都释放后自动关),不会因为一句 SQL 没释放就关不掉
还有一个函数指针类型
cpp
typedef int(*SqliteCallback)(void*, int, char**, char**);这不是函数,是"回调函数的类型"------用来说明回调要有这样的签名:
| 参数 | 含义 |
|---|---|
void* |
从 sqlite3_exec 的 arg 传进来的 |
int |
这一行有几列 |
char** |
一行的数据(每列一个字符串) |
char** |
每列的列名 |
返回值必须是 0 ,返回非 0 会让 sqlite3_exec 直接中止。
几个宏常量(不是函数)
| 名字 | 含义 |
|---|---|
SQLITE_OK |
成功,值为 0 |
SQLITE_OPEN_READWRITE |
以可读可写方式打开 |
SQLITE_OPEN_CREATE |
不存在则创建 |
SQLITE_OPEN_FULLMUTEX |
串行化模式(同一句柄可跨线程用) |
调用链
cpp
构造对象
   ↓  _handler = nullptr
open()
   ↓  sqlite3_open_v2()   -> 拿到句柄 _handler
exec()
   ↓  sqlite3_exec()      -> 执行 SQL;查询时通过回调逐行取结果
   ↓  出错时 sqlite3_errmsg() -> 取错误文字
close()
   ↓  sqlite3_close_v2()  -> 释放句柄
C.字符串操作类
提供字符串分割功能
直接来看代码:
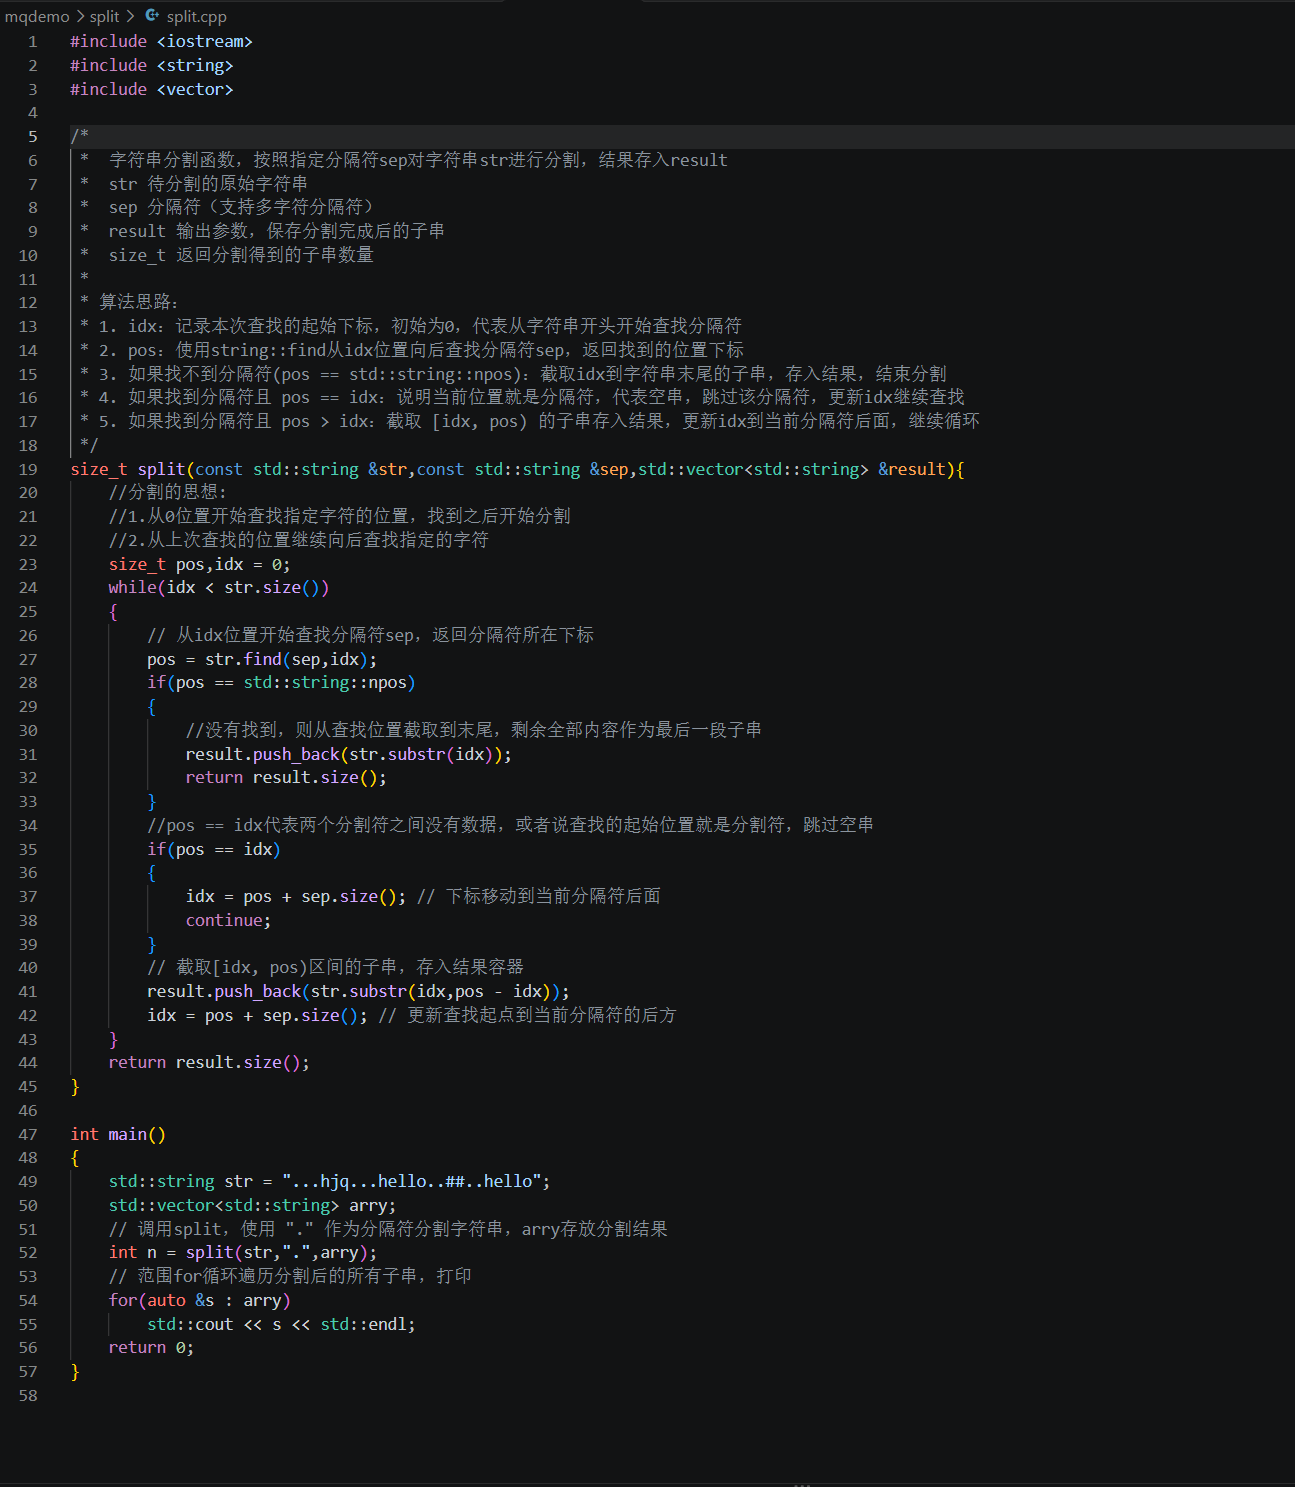
运行结果如下:
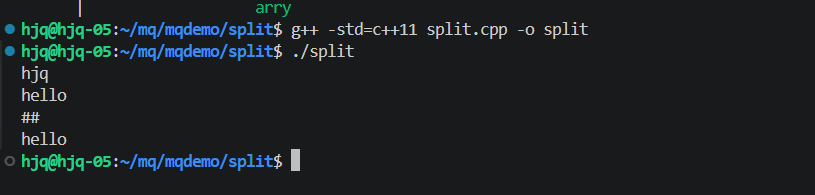
1. str.find(sep, idx)
cpp
pos = str.find(sep, idx);
- 作用 :从字符串
str的下标idx位置开始,向后查找子串sep- 返回值:
- 如果找到了:返回sep 第一个字符所在的下标,赋值给 pos
- 如果找不到:返回
std::string::npos- 参数说明:
- 第 1 个参数:要查找的分隔符(可以是单字符,也可以是多字符)
- 第 2 个参数:查找的起始位置,不写默认从 0 开始
示例:"abc123abc".find("abc",3),从下标 3 开始找 abc,找到返回下标 6
2. str.substr(idx, len)
cpp
str.substr(idx, pos - idx);
- 作用:截取字符串的一段子串
- 参数:
- 第 1 个参数
idx:起始下标(从哪里开始截取)- 第 2 个参数:截取长度 (不是结束下标!),可以省略
- 如果省略第二个参数:从 idx 一直截取到字符串末尾
例子:"hello".substr(1,3) --> 从下标 1 开始取 3 个字符,得到 "ell" 例子:"hello".substr(2) --> 从下标 2 一直截到末尾,得到 "llo"
3. std::string::npos
cpp
if(pos == std::string::npos)
- 本质:
size_t类型的常量(无符号整数,值是 -1 的无符号表示)- 含义 :
find查找失败的标记,代表没有找到目标子串- 判断:当
find返回值等于npos,说明后面再也没有分隔符了,直接截取剩下所有内容
4. result.push_back(xxx)
cpp
result.push_back(str.substr(idx));vector 的方法,往动态数组 result 的末尾追加一个字符串。
5. 变量说明(split 函数内)
idx:本次查找的起始位置,分割完一段之后,更新到分隔符后面pos:find 找到的分隔符下标
完整走一遍字符串
str = "...hjq...hello..##..hello",分隔符 "."
- idx=0,find
.,pos=0,pos==idx,跳过,idx 更新为 1- idx=1,find
.,pos=1,pos==idx,跳过,idx 更新为 2- idx=2,find
.,pos=2,pos==idx,跳过,idx 更新为 3- idx=3,find
.,pos=6,截取 [3,6) →"hjq",存入 vector,idx=7- idx=7,find
.,pos=7,跳过...... 以此类推
输出: 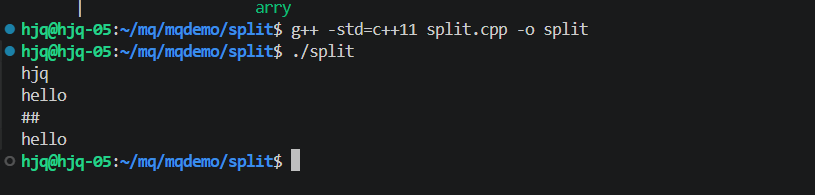
D. UUID 生成器类
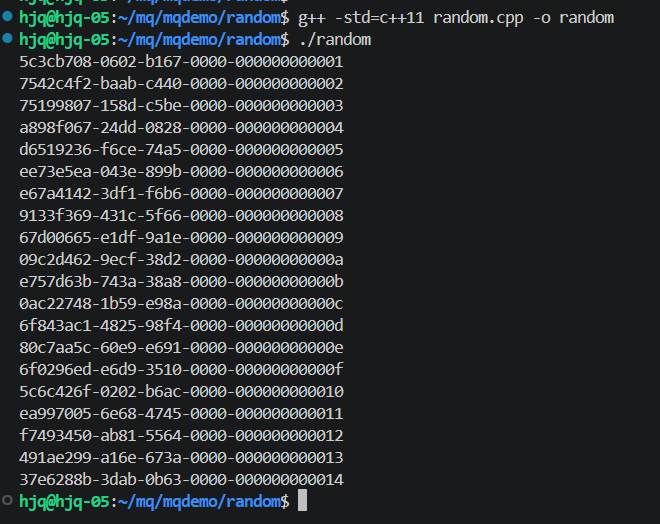
UUID(Universally Unique Identifier), 也叫通用唯一识别码,通常由 32 位 16 进制数字字符组成。
UUID 的标准型式包含 32 个 16 进制数字字符,以连字号分为五段,形式为 8-4-4-4-12的 32 个字符,如:550e8400-e29b-41d4-a716-446655440000。
在这里,uuid 生成,我们采用生成 8 个随机数字,加上 8 字节序号,共 16 字节数组生成 32 位 16 进制字符的组合形式来确保全局唯一的同时能够根据序号来分辨数据(随机数肉眼分辨起来真是太难了....)。
我们直接来看代码:
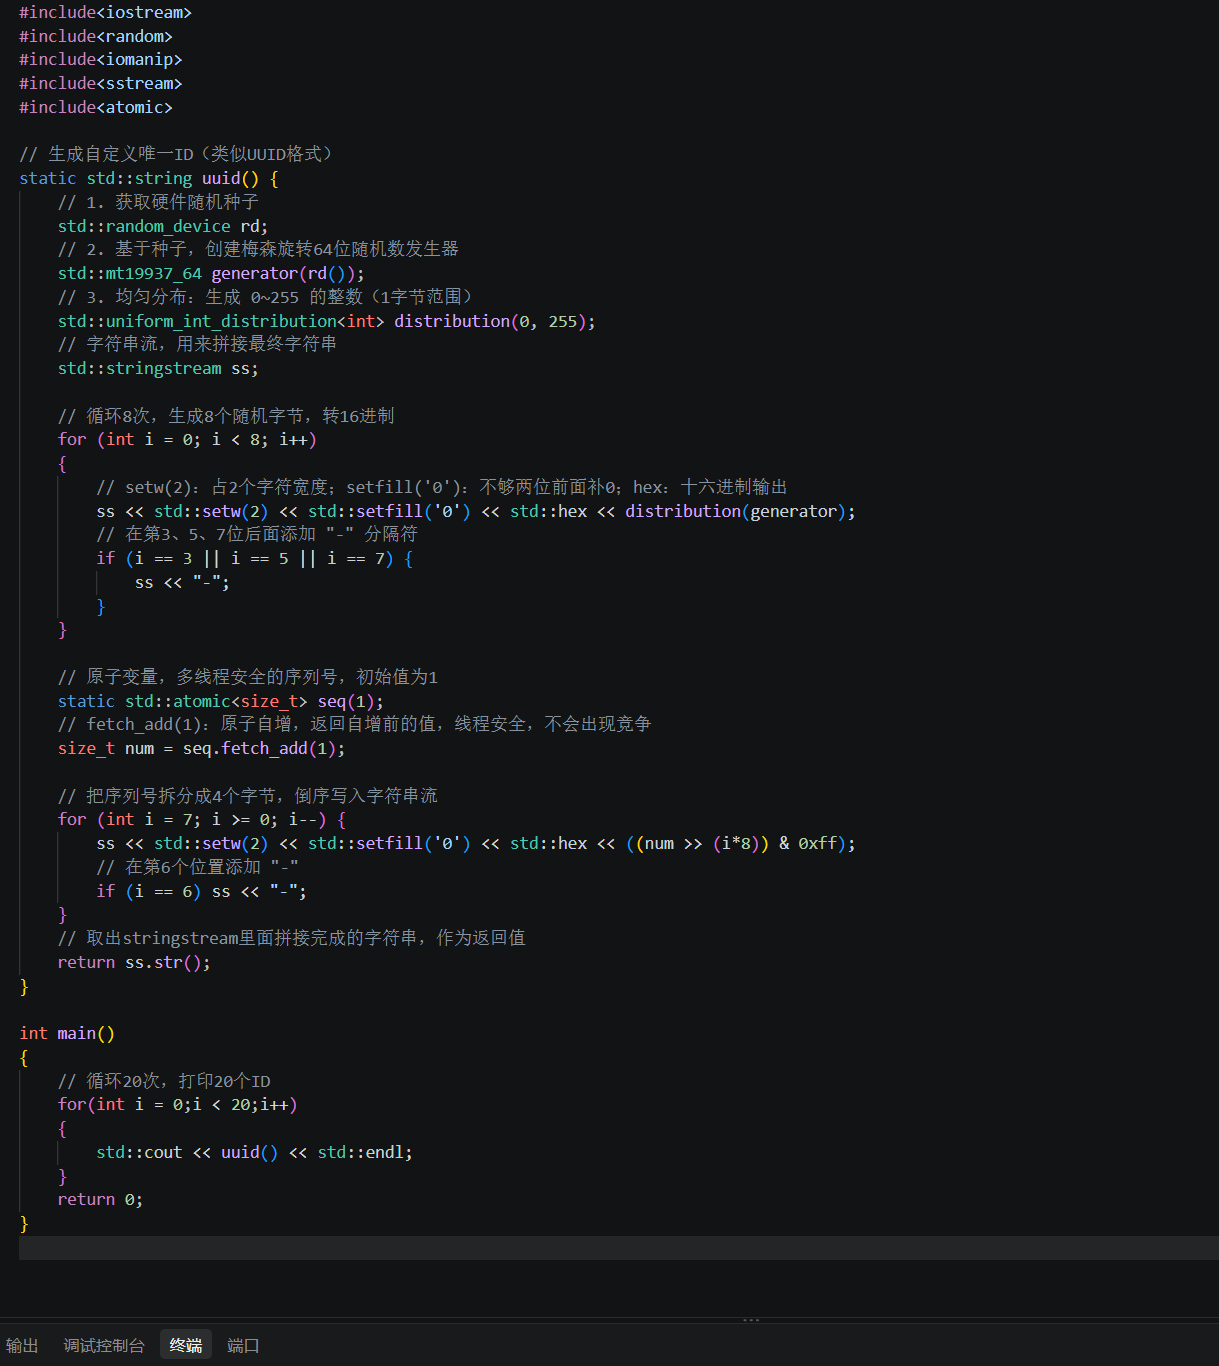
运行结果:
用到的接口如下:
- std::random_device rd; 获取随机种子,尝试读取硬件真随机;Linux 虚拟机下一般为 urandom 伪随机。
- std::mt19937_64 generator(rd()); 梅森旋转算法,高性能伪随机数生成器,64 位版本。
- std::uniform_int_distribution<int> distribution(0,255); 均匀整数分布类,限定随机数输出范围 0,255。调用distribution(generator)得到随机值。
- std::stringstream ss; 字符串流,像 cout 一样用<<拼接内容,最后调用.str()取出完整字符串。
- std::setw(2) 设置输出宽度为 2 个字符,只对紧随其后的一次输出生效。
- std::setfill('0') 当输出内容达不到 setw 设置宽度时,使用字符 0 填充空位。
- std::hex 修改流输出格式,后续数字以十六进制展示。
- std::atomic<size_t> seq(1); 原子类型变量,多线程环境下访问不会产生数据竞争。
- seq.fetch_add(1); 原子操作:变量 + 1,返回增加之前的旧值;线程安全,用来生成全局递增序列号。
- std::cout / std::endl 标准输出,endl 输出换行并刷新 IO 缓冲区。
总结
ID 分为两部分:
- 前半段:8 个随机字节(16 进制),固定位置加
-,由随机数生成;- 后半段:原子递增序列号拆分为 4 字节,拼接在后面,中间加
-。
随机部分保证多样性,原子序列号保证多线程场景下 ID 全局唯一,适合消息队列用来生成消息唯一 id。
3.消息类型定义&交换机类型定义
在正式编写项目功能模块代码前,需要预先定义消息类型。 消息需要持久化存储,涉及数据序列化与反序列化,因此采用 protobuf 生成消息类型代码。 定义消息类型,本质就是编写 proto 描述文件,并编译生成对应的程序代码。
1. 消息所需要素
a. 消息本身要素
i. 消息属性:消息属性包含以下内容
- 消息 ID
- 消息投递模式:非持久化模式 / 持久化模式
- 消息的 routing_key ii. 消息有效载荷内容
b. 消息额外存储所需要素
i. 消息的存储位置
ii. 消息的长度
iii. 消息是否有效:不使用 bool 类型,采用字符 0/1。 原因:bool 持久化占用字节长度不固定,如果修改文件内消息有效标记,会改变整条消息占用长度,因此舍弃 bool。
客户端与服务端都需要交换机相关信息(交换机类型、消息持久化模式),因此把交换机类型枚举、消息投递模式枚举一并定义在 proto 文件中。
2. 枚举定义
A. 交换机类型
a. DIRECT
b. FANOUT
c. TOPIC
B. 消息投递模式
a. UNDURABLE:参考 RabbitMQ,取值为 1
b. DURABLE:取值为 2
直接看代码:
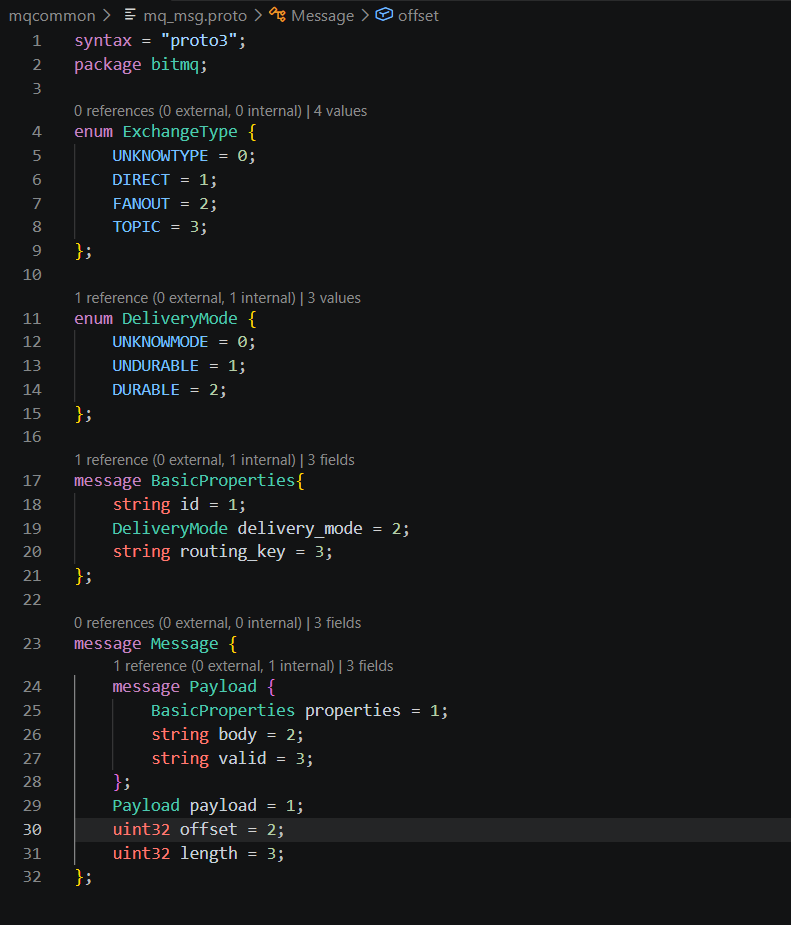
用到的接口汇总
cpp
syntax = "proto3";- 声明使用 protobuf3 语法版本,决定 proto 文件的语法规则与序列化行为。
cpp
package bitmq;- 定义包名 bitmq,生成 C++ 代码后所有类都会放在
bitmq命名空间下,防止命名冲突。
cpp
enum ExchangeType交换机类型枚举,定义服务端支持的交换机种类。
- UNKNOWTYPE = 0; 默认枚举值,未知交换机类型,proto3 枚举必须 0 号默认值
- DIRECT = 1; 直连交换机
- FANOUT = 2; 广播交换机
- TOPIC = 3; 主题交换机
cpp
enum DeliveryMode消息投递模式枚举,标记消息是否持久化,对标 RabbitMQ 设计。
- UNKNOWMODE = 0; 默认枚举值,未知投递模式
- UNDURABLE = 1; 非持久化消息
- DURABLE = 2; 持久化消息
cpp
message BasicProperties消息基础属性结构体,存放消息的元数据。
- string id = 1; 消息唯一 ID,用来标识每条消息
- DeliveryMode delivery_mode = 2; 消息投递模式,引用上面的投递模式枚举
- string routing_key = 3; 路由键,交换机依靠 routing_key 完成消息路由匹配
cpp
message Message消息主体结构体,对外使用的消息完整模型。
- message Payload 内部嵌套消息,承载消息核心数
- BasicProperties properties = 1; 消息基础属性
- string body = 2; 消息有效载荷,也就是业务数据
- string valid = 3; 消息是否有效,用字符串存储 "0"/"1",不用 bool,避免持久化时占用字节变动
- Payload payload = 1; 消息载荷对象
- uint32 offset = 2; 消息在持久化文件中的偏移位置
- uint32 length = 3; 整条消息的字节长度
整体原理总结
该 proto 文件是消息队列项目的数据描述文件,使用 protobuf 定义消息、枚举结构。
- 定义交换机类型枚举、消息投递模式枚举,客户端和服务端共用同一套类型定义。
- BasicProperties 存放消息元信息(消息 ID、投递模式、路由键)。
- 嵌套 Payload 存放消息属性、业务数据、消息有效标记。
- Message 外层结构体额外记录消息在磁盘文件的偏移与长度,用于持久化文件的读取定位。 编译该 proto 文件后,protobuf 自动生成 C++ 序列化 / 反序列化代码,方便消息在网络传输和磁盘持久化。
protobuf 编译命令:
cpp
protoc --cpp_out=. mq_msg.proto