先问一个问题:你有多久没打开过 .jsonl 文件了?
不是不想看,是不敢看 。一行一个 JSON 对象,密密麻麻,全是花括号和双引号,像被揉碎又撒了一地的代码。想找某个字段?用 Ctrl+F 一行行翻。想比较几条记录?得用眼睛在几百个字符里做"找不同"。想把整个文件拖进表格软件?那得先写个脚本把它转成 CSV。
这不叫数据分析,这叫自虐。
但问题是,JSONL(JSON Lines)和 NDJSON(Newline Delimited JSON)压根不是什么冷门格式。恰恰相反,它们是日志、事件流、机器学习数据集最常用的存储格式之一。每一行都是一个独立的 JSON 对象,写起来方便,读起来......就是另一回事了。
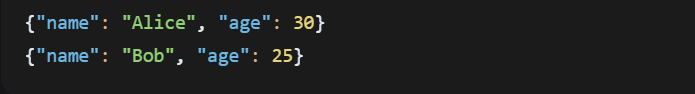
很多人第一次看到 .jsonl 或 .ndjson 文件时,会以为它是某种 JSON 的变体或新标准。其实它比你想的简单得多:JSONL = JSON Lines,NDJSON = Newline Delimited JSON,本质上是同一种东西,只是叫法不同。
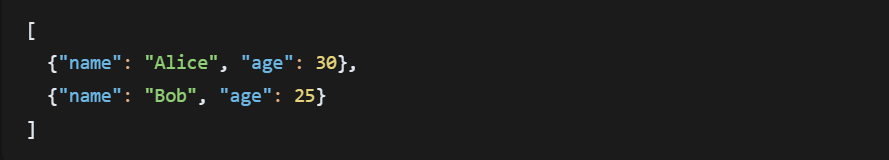
普通的json长这样
jsonl长这样
Zed 团队大概也受够了这种痛苦。所以他们给编辑器加了一个功能:打开 .jsonl 或 .ndjson 文件,直接以表格形式预览。
这个表格长什么样?
你打开一个 JSONL 文件,运行 tabular data: open preview,然后------花括号消失了,取而代之的是一个整齐的表格。
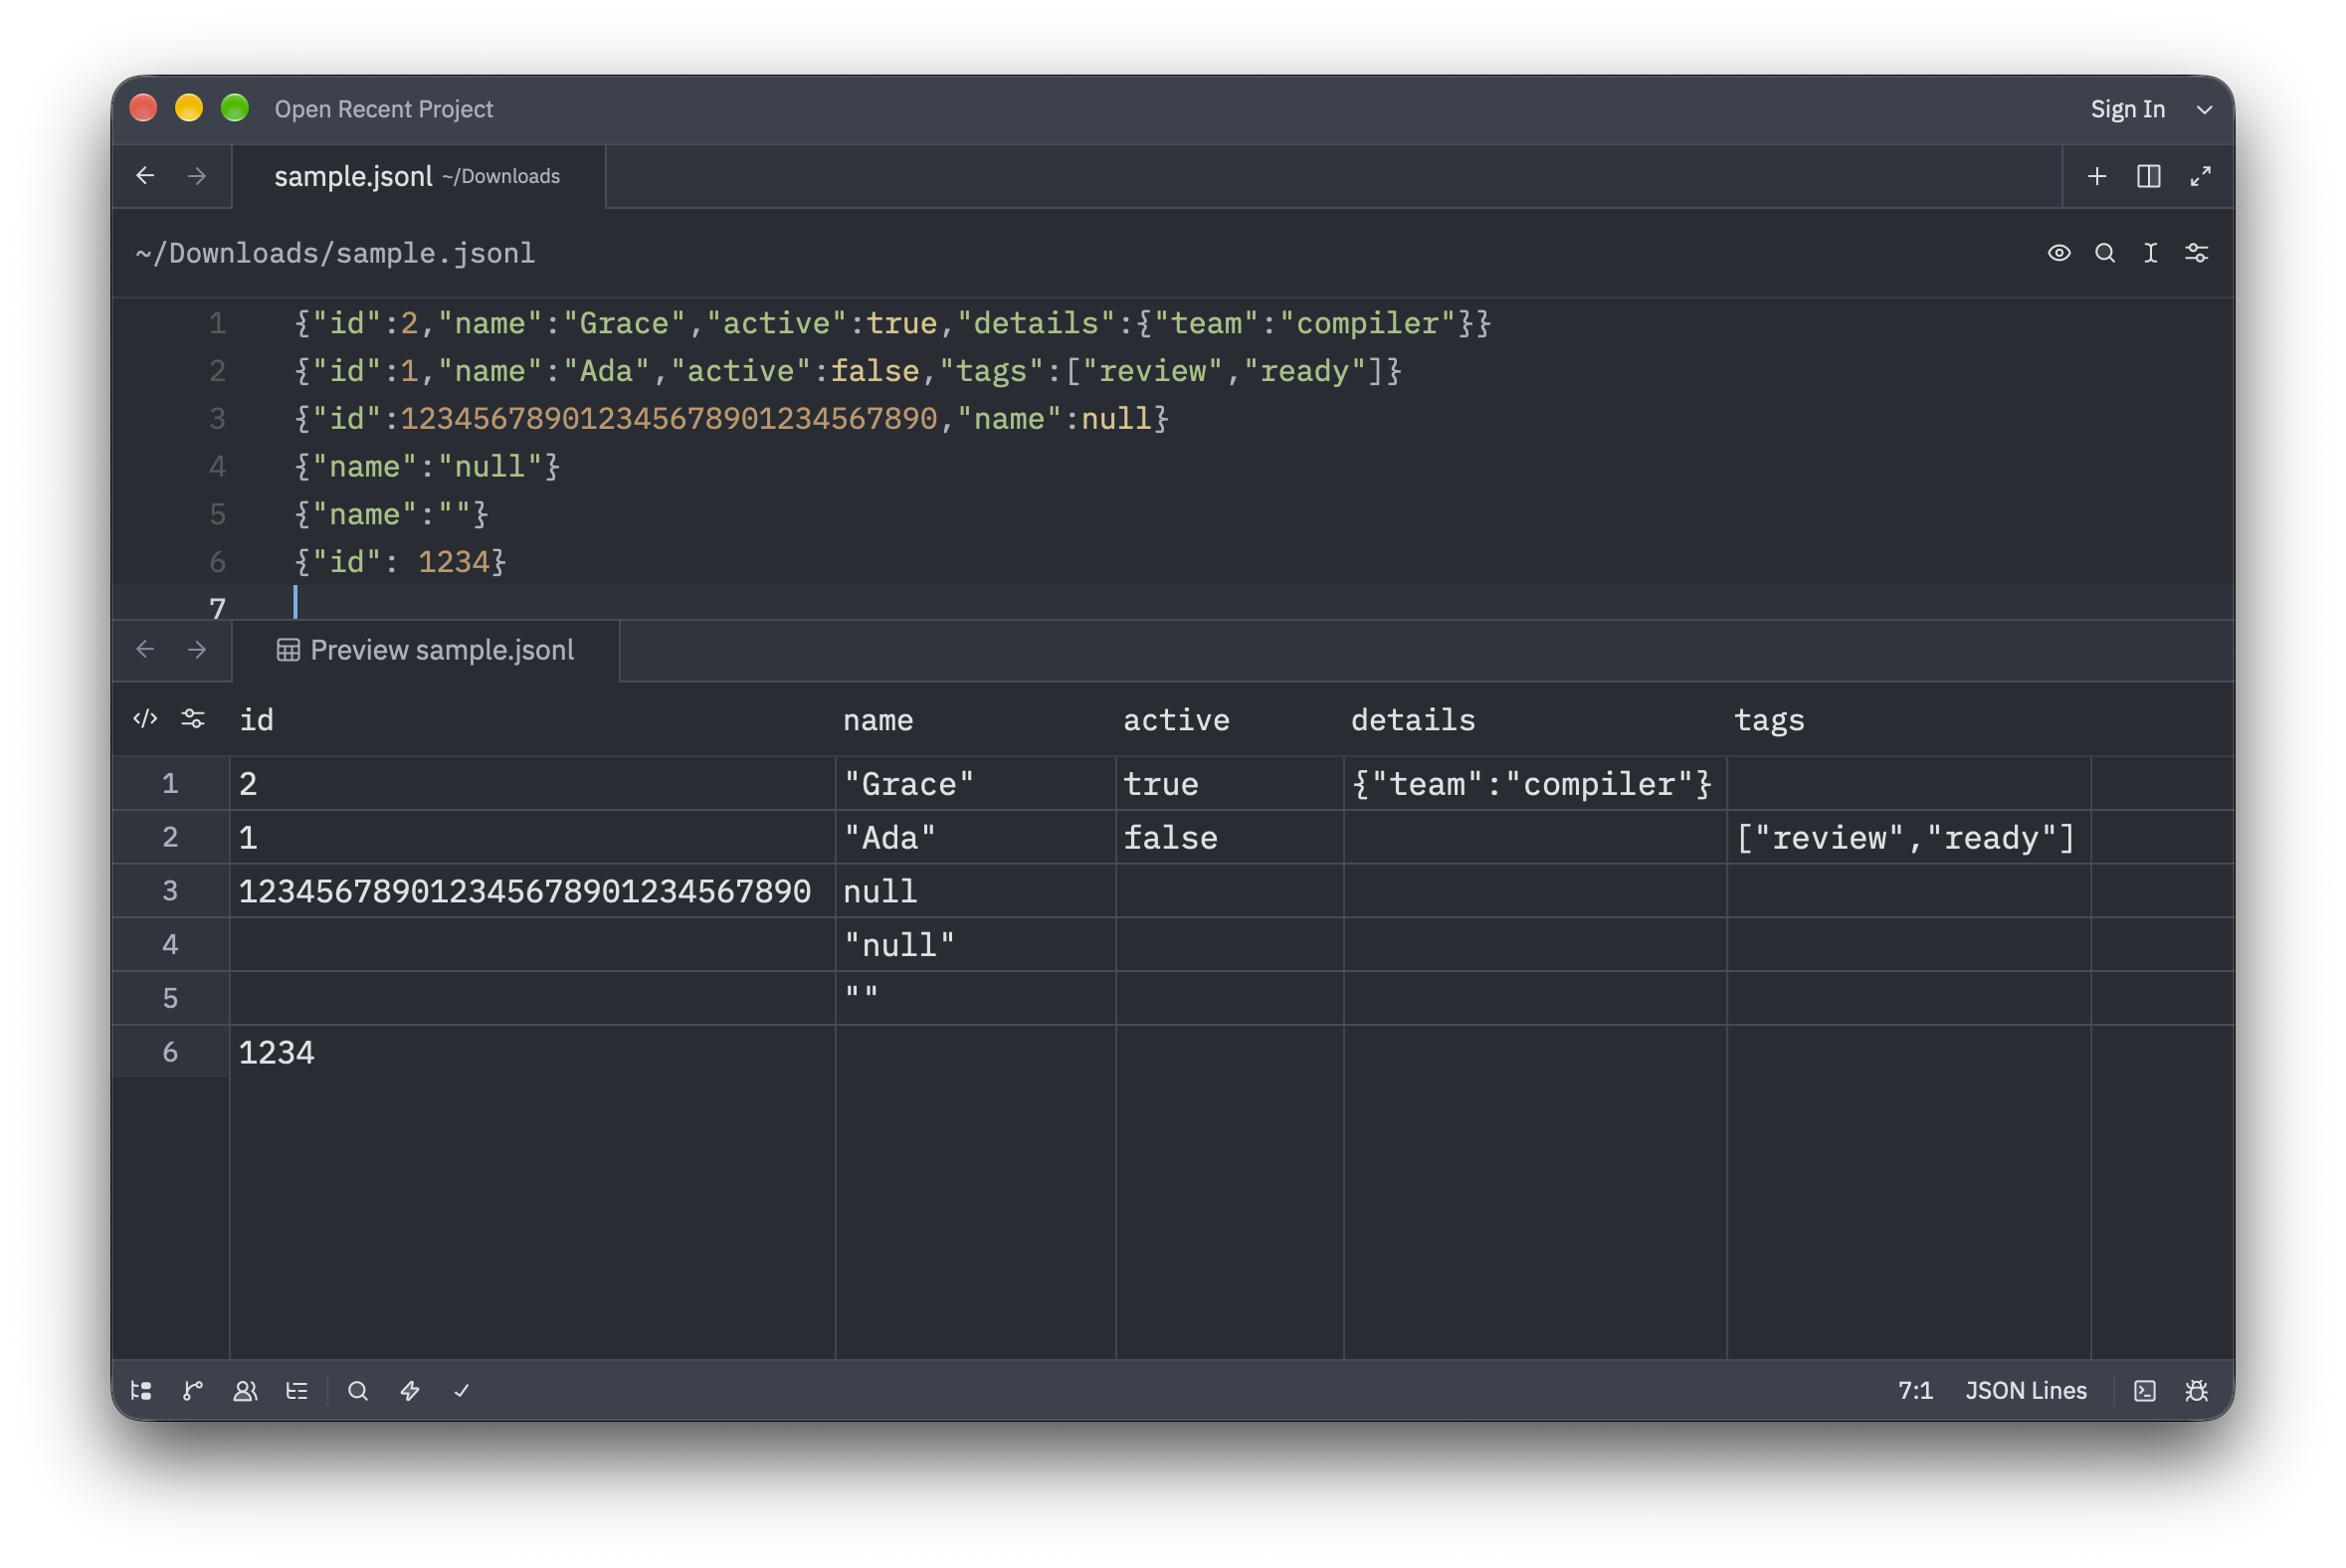
每一行是一条记录,每一个顶层字段变成了一列 。第一行里出现的字段排在最左边,后面行里才出现的新字段,会依次追加到右边 。列的顺序就是字段"第一次出现"的顺序,忠实反映源文件结构。
最贴心的是,它不会擅自转换你的数据 。大数字不会被搞成科学计数法,嵌套对象和数组会以紧凑 JSON 的形式展示,缺失的字段、null、字符串 "null" 和空字符串------这四种状态被严格区分。这在处理日志时太重要了,因为你最怕的就是工具自作聪明,把"没有这个字段"和"字段是 null"混为一谈。
如果某一行 JSON 写坏了,它会告诉你哪一行出了错 ,你改完保存,预览会自动恢复。排序和筛选也会保留,除非列名或列的顺序变了。
大多数编辑器的表格预览,都只盯着 CSV。JSONL 明明更常见,却一直是个二等公民。你要么忍受文本视图,要么装个第三方工具,要么写脚本。
Zed 的选择是:把 JSONL 当一等公民对待。你不需要转换格式,不需要写脚本,不需要离开编辑器。打开文件,切到表格,看数据。
就这么简单。
当然,它目前只接受对象记录 ,而且预览是只读的。但如果你只是想"看一眼数据长什么样",这个功能已经够用了。
所以,下次你面对一个几百 MB 的日志 JSONL 文件时,别再用眼睛一行行扫了。打开 Zed,按一下快捷键,让表格替你干活。
你的眼睛会感谢你的。