4. Channel面试题
#4.1 什么是CSP?
CSP(Communicating Sequential Processes,通信顺序进程)并发编程模型,它的核心思想是:通过通信共享内存,而不是通过共享内存来通信。Go 语言的Goroutine 和 Channel机制,就是 CSP 的经典实现,具有以下特点:
-
避免共享内存:协程(Goroutine)不直接修改变量,而是通过 Channel 通信
-
天然同步:Channel 的发送/接收自带同步机制,无需手动加锁
-
易于组合:Channel 可以嵌套使用,构建复杂并发模式(如管道、超时控制)
#4.2 Channel的底层实现原理是怎样的?
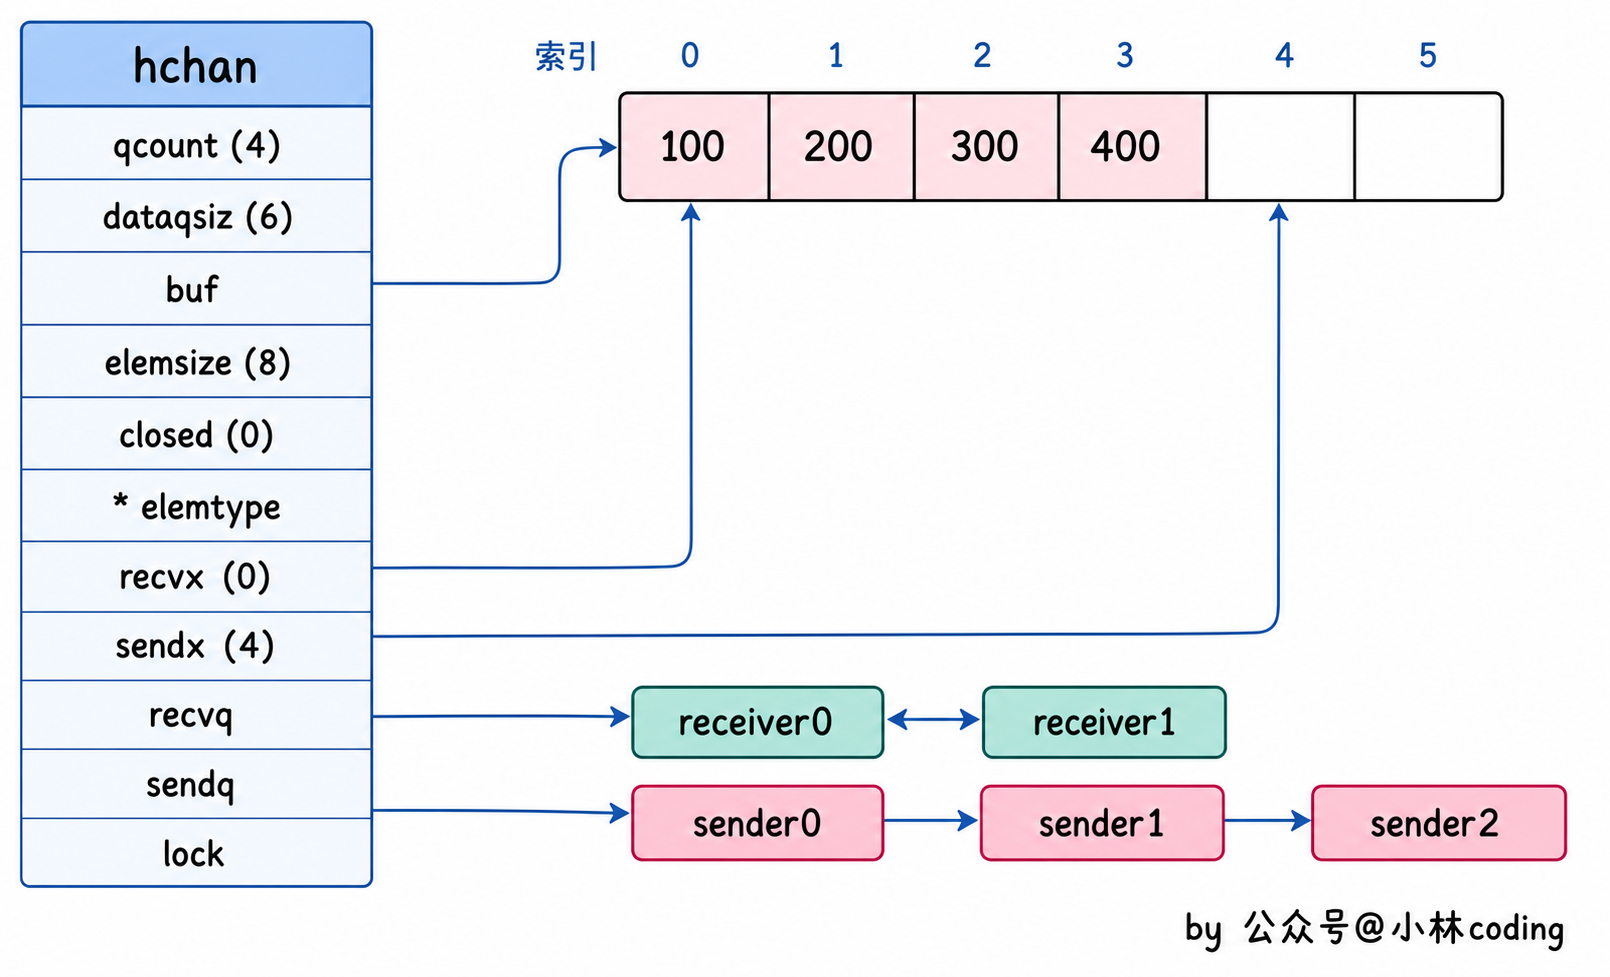
Channel的底层是一个名为hchan的结构体,核心包含几个关键组件:
环形缓冲区: 有缓冲channel内部维护一个固定大小的环形队列,用buf指针指向缓冲区,sendx和recvx分别记录发送和接收的位置索引。这样设计能高效利用内存,避免数据搬移。
两个等待队列sendq和recvq: 用来管理阻塞的goroutine。sendq存储因channel满而阻塞的发送者,recvq存储因channel空而阻塞的接收者。这些队列用双向链表实现,当条件满足时会唤醒对应的goroutine。
互斥锁: hchan内部有个mutex,所有的发送、接收操作都需要先获取锁,用来保证并发安全。虽然看起来可能影响性能,但Go的调度器做了优化,大多数情况下锁竞争并不激烈。
分析:
hchan定义如下:
type hchan struct {
        // chan 里元素数量
        qcount   uint
        // chan 底层循环数组的长度
        dataqsiz uint
        // 指向底层循环数组的指针
        // 只针对有缓冲的 channel
        buf      unsafe.Pointer
        // chan 中元素大小
        elemsize uint16
        // chan 是否被关闭的标志
        closed   uint32
        // chan 中元素类型
        elemtype *_type // element type
        // 已发送元素在循环数组中的索引
        sendx    uint   // send index
        // 已接收元素在循环数组中的索引
        recvx    uint   // receive index
        // 等待接收的 goroutine 队列
        recvq    waitq  // list of recv waiters
        // 等待发送的 goroutine 队列
        sendq    waitq  // list of send waiters

        // 保护 hchan 中所有字段
        lock mutex
}
#4.3 向channel发送数据的过程是怎样的?
向channel发送数据的整个过程都会在mutex保护下进行,保证并发安全。会经历几个关键步骤:
-
首先是检查是否有等待的接收者 。如果
recvq队列不为空,说明有goroutine在等待接收数据,这时会直接把数据传递给等待的接收者,跳过缓冲区,这是最高效的路径。同时会唤醒对应的goroutine继续执行。 -
如果没有等待接收者,就尝试写入缓冲区 。检查缓冲区是否还有空间,如果
qcount < dataqsiz,就把数据复制到buf[sendx]位置,然后更新sendx索引和qcount计数。这是无缓冲或缓冲区未满时的正常流径。 -
当缓冲区满了就需要阻塞等待 。创建一个
sudog结构体包装当前goroutine和要发送的数据,加入到sendq等待队列中,然后调用gopark让当前goroutine进入阻塞状态,让出CPU给其他goroutine。
被唤醒后继续执行 。当有接收者从channel读取数据后,会从sendq中唤醒一个等待的发送者,被唤醒的goroutine会完成数据发送并继续执行。
还有个特殊情况是向已关闭的channel发送数据会直接panic。这是Go语言的设计原则,防止向已关闭的通道写入数据。
分析:
package main

import (
    "fmt"
    "time"
)

func goroutineA(a <-chan int) {
    val := <-a
    fmt.Println("goroutine A received data: ", val)
    return
}

func goroutineB(b <-chan int) {
    val := <-b
    fmt.Println("goroutine B received data: ", val)
    return
}

func main() {
    ch := make(chan int)
    go goroutineA(ch)
    go goroutineB(ch)
    ch <- 3
    time.Sleep(time.Second)

    ch1 := make(chan struct{})
}
在第 17 行,主协程向 ch 发送了一个元素 3,来看下接下来会发生什么。
sender 发现 ch 的 recvq 里有 receiver 在等待着接收,就会出队一个 sudog,把 recvq 里 first 指针的 sudo "推举"出来了,并将其加入到 P 的可运行 goroutine 队列中。然后,sender 把发送元素拷贝到 sudog 的 elem 地址处,最后会调用 goready 将 G1 唤醒,状态变为 runnable。
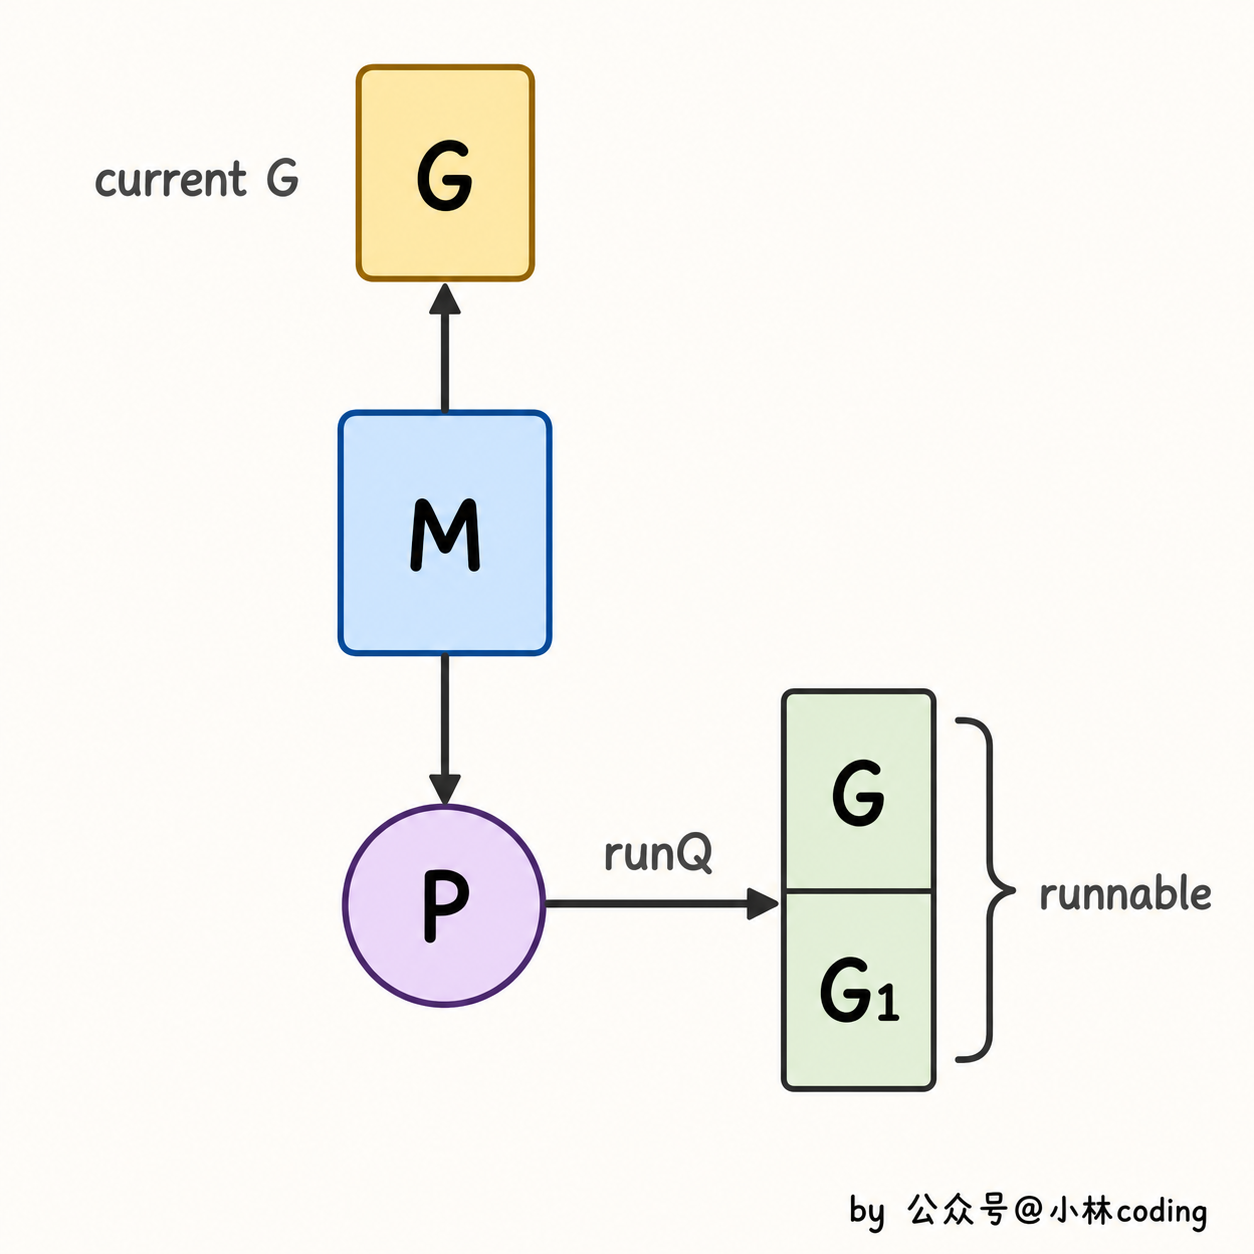
当调度器光顾 G1 时,将 G1 变成 running 状态,执行 goroutineA 接下来的代码。G 表示其他可能有的 goroutine。
这里其实涉及到一个协程写另一个协程栈的操作。有两个 receiver 在 channel 的一边虎视眈眈地等着,这时 channel 另一边来了一个 sender 准备向 channel 发送数据,为了高效,用不着通过 channel 的 buf "中转"一次,直接从源地址把数据 copy 到目的地址就可以了,效率高啊!
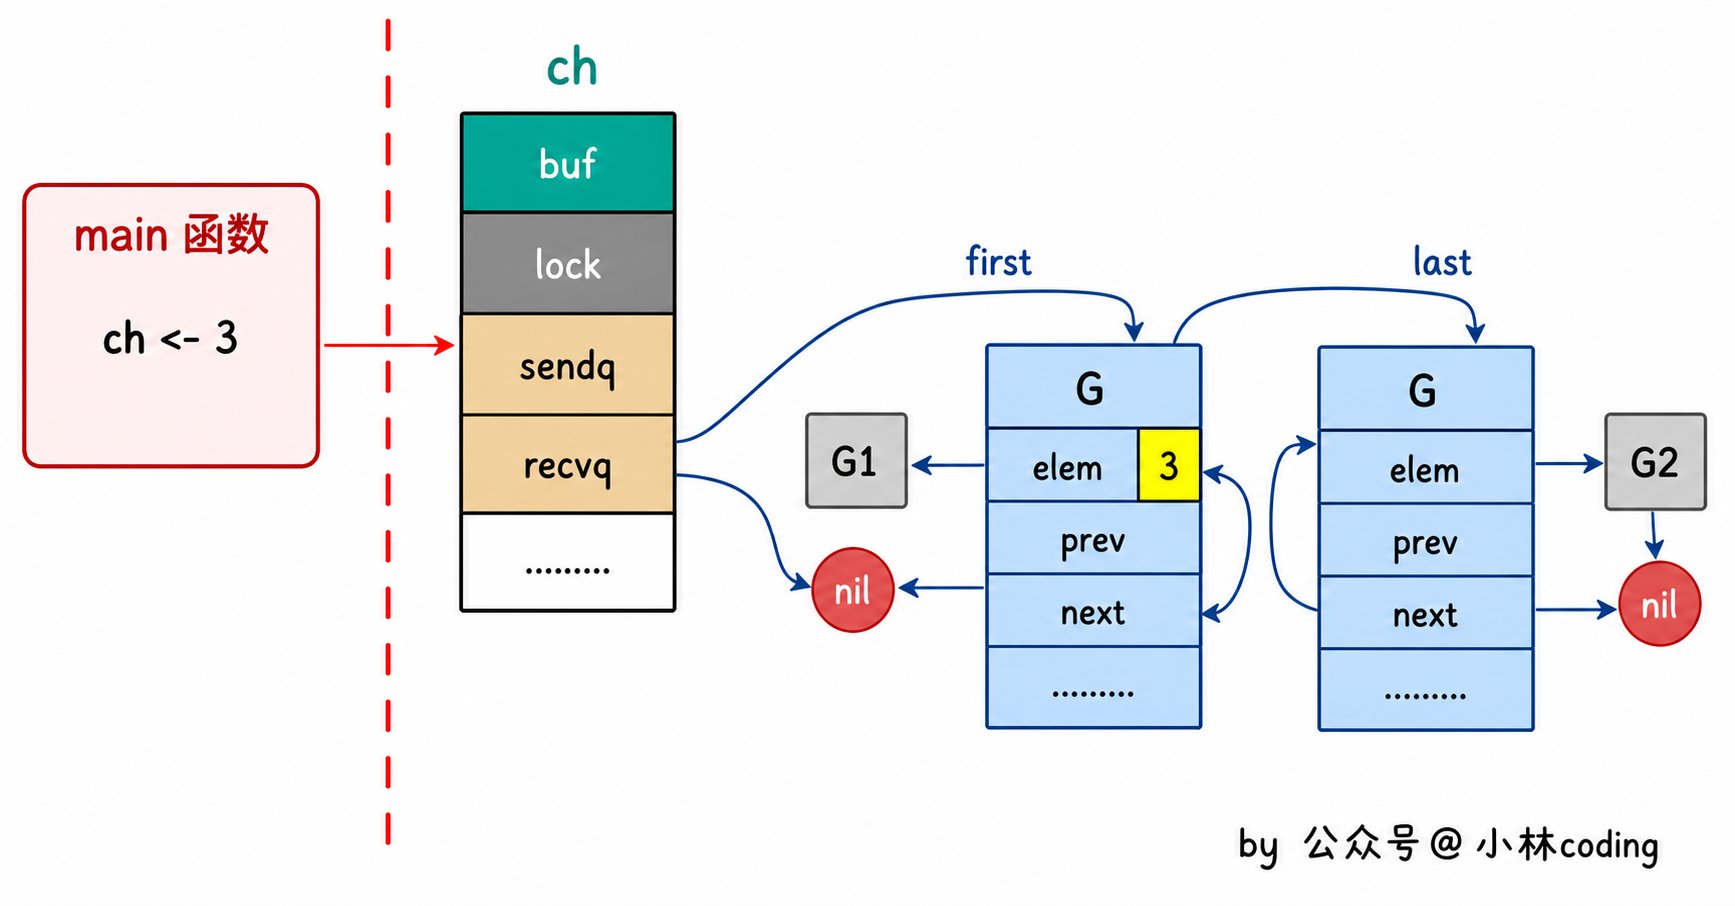
上图是一个示意图,3 会被拷贝到 G1 栈上的某个位置,也就是 val 的地址处,保存在 elem 字段。
#4.4 从Channel读取数据的过程是怎样的?
从channel读取数据也有几个关键步骤:
-
首先检查是否有等待的发送者 。如果
sendq队列不为空,说明有goroutine在等待发送数据。对于无缓冲channel,会直接从发送者那里接收数据;对于有缓冲channel,会先从缓冲区取数据,然后把等待发送者的数据放入缓冲区,这样保持FIFO顺序。 -
如果没有等待发送者,尝试从缓冲区读取 。检查
qcount > 0,如果缓冲区有数据,就从buf[recvx]位置取出数据,然后更新recvx索引和qcount计数。这是缓冲区有数据时的正常路径。
缓冲区为空时需要阻塞等待 。创建sudog结构体包装当前goroutine,加入到recvq等待队列,调用gopark进入阻塞状态。当有发送者写入数据时会被唤醒继续执行。
从已关闭channel读取有特殊处理 。如果channel已关闭且缓冲区为空,会返回零值和false标志;如果缓冲区还有数据,可以正常读取直到清空。这就是为什么v, ok := <-ch中的ok能判断channel状态的原因。
#4.5 从一个已关闭Channel仍能读出数据吗?
从一个有缓冲的 channel 里读数据,当 channel 被关闭,依然能读出有效值。只有当返回的 ok 为 false 时,读出的数据才是无效的。
示例:
func main() {
        ch := make(chan int, 5)
        ch <- 18
        close(ch)
        x, ok := <-ch
        if ok {
                fmt.Println("received: ", x)
        }

        x, ok = <-ch
        if !ok {
                fmt.Println("channel closed, data invalid.")
        }
}
程序输出:
received:  18
channel closed, data invalid.
先创建了一个有缓冲的 channel,向其发送一个元素,然后关闭此 channel。之后两次尝试从 channel 中读取数据,第一次仍然能正常读出值。第二次返回的 ok 为 false,说明 channel 已关闭,且通道里没有数据。
#4.6 Channel在什么情况下会引起内存泄漏?
Channel引起内存泄漏最常见的是引起goroutine泄漏从而导致的间接内存泄漏,当goroutine阻塞在channel操作上永远无法退出时,goroutine本身和它引用的所有变量都无法被GC回收。比如一个goroutine在等待接收数据,但发送者已经退出了,这个接收者就会永远阻塞下去。或者**select语句使用不当,**在没有default分支的select中,如果所有case都无法执行,goroutine会永远阻塞。出现内存泄漏
#4.7 关闭Channel会产生异常吗?
试图重复关闭一个channel、,关闭一个nil值的channel、关闭一个只有接收方向的channel都将导致panic异常。
#4.8 往一个关闭的Channel写入数据会发生什么?
往已关闭的channel写入数据会直接panic。
向已关闭的channel发送数据时,runtime会检测到channel的closed标志位已经设置,立即抛出"send on closed channel"的panic。这个检查发生在发送操作的最开始阶段,甚至在获取mutex锁之前就会进行判断,所以不会有任何数据写入的尝试,直接就panic了。
#4.9 什么是select?
select是Go语言专门为channel操作设计的多路复用控制结构,类似于网络编程中的select系统调用。
核心作用是同时监听多个channel操作。当有多个channel都可能有数据收发时,select能够选择其中一个可执行的case进行操作,而不是按顺序逐个尝试。比如同时监听数据输入、超时信号、取消信号等。
#4.10 select的执行机制是怎样的?
select的执行机制是随机选择。如果多个case同时满足条件,Go会随机选择一个执行,这避免了饥饿问题。如果没有case能执行就会执行default,如果没有default,当前goroutine会阻塞等待。
select {
case data := <-ch1:
    // 处理ch1的数据
case ch2 <- value:
    // 向ch2发送数据
case <-timeout:
    // 超时处理
default:
    // 所有channel都不可用时执行
}#4.11 select的实现原理是怎样的?
Go语言实现select时,定义了一个数据结构scase表示每个case语句(包含default)。scase结构包含channel指针、操作类型等信息。select操作的整个过程通过selectgo函数在runtime层面实现。
Go运行时会将所有case进行随机排序 ,这是为了避免饥饿问题。然后执行两轮扫描策略 :第一轮 直接检查每个channel是否可读写,如果找到就绪的立即执行;如果都没就绪,第二轮就把当前goroutine加入到所有channel的发送或接收队列中,然后调用gopark进入睡眠状态,使当前goroutine让出CPU。
当某个channel变为可操作时,调度器会唤醒对应的goroutine,此时需要从其他channel的等待队列中清理掉这个goroutine,然后执行对应的case分支。
其核心原理是:case随机化 + 双重循环检测
分析:
scase结构定义:
type scase struct {
    c    *hchan   // channel指针
    elem unsafe.Pointer  // 数据元素指针,用于存放发送/接收的数据
    kind uint16   // case类型:caseNil、caseRecv、caseSend、caseDefault
    pc   uintptr  // 程序计数器,用于调试
    releasetime int64  // 释放时间,用于竞态检测
}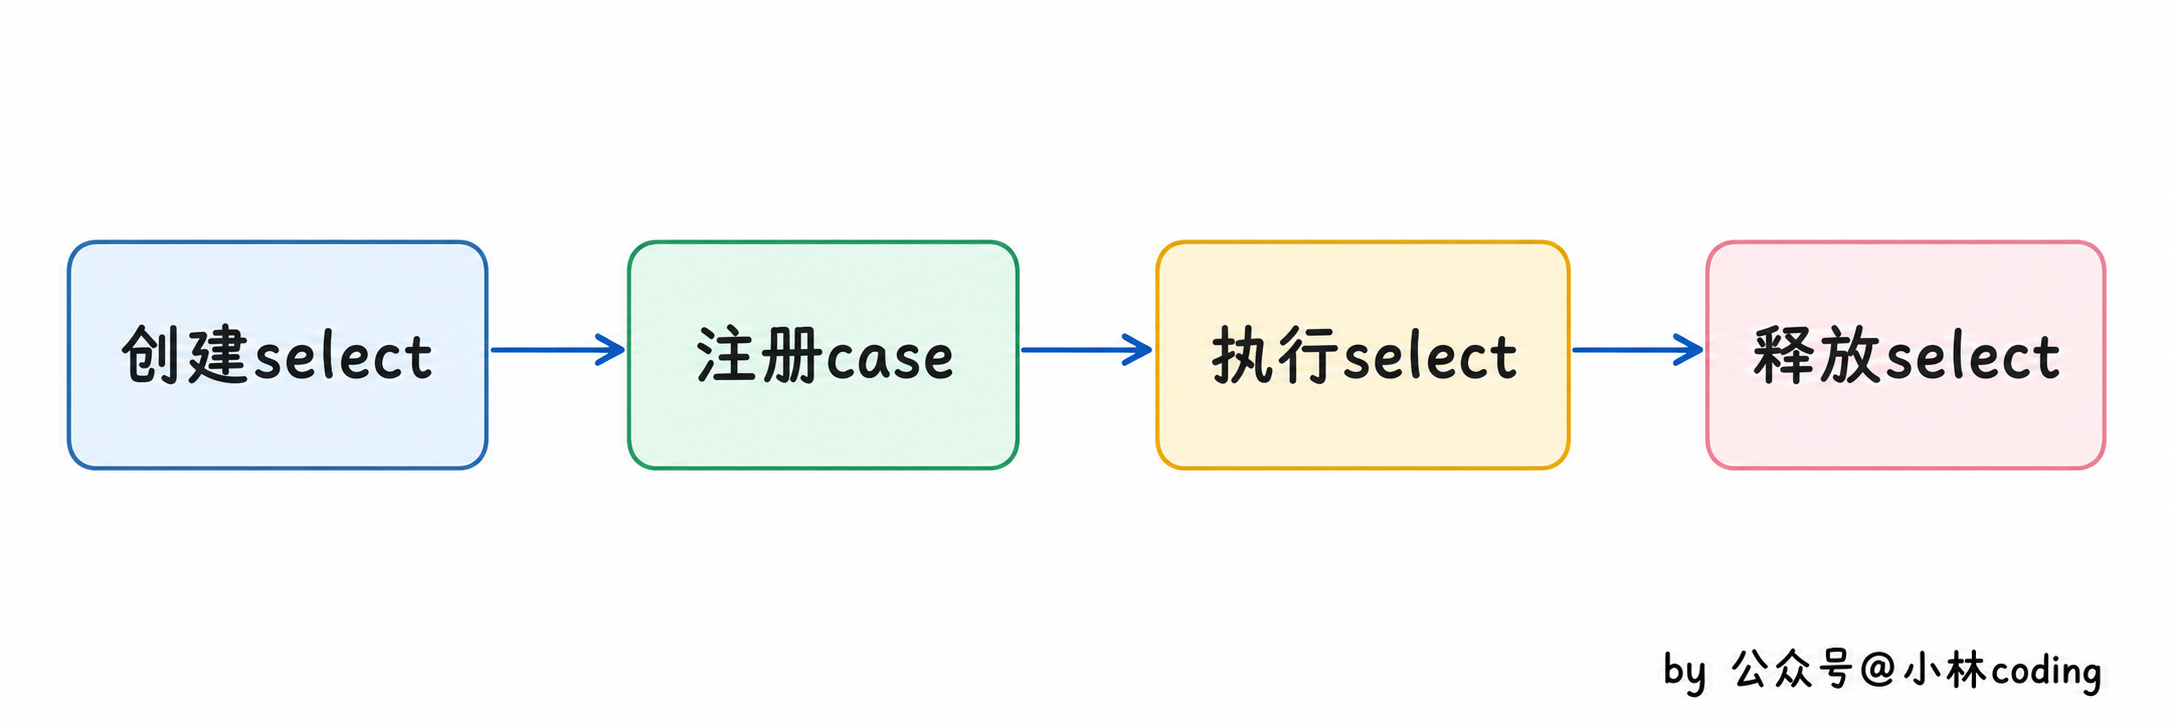
在默认的情况下,select 语句会在编译阶段经过如下过程的处理:
-
将所有的
case转换成包含Channel以及类型等信息的 scase 结构体; -
调用运行时函数
selectgo获取被选择的scase结构体索引,如果当前的scase是一个接收数据的操作,还会返回一个指示当前case是否是接收的布尔值; -
通过
for循环生成一组if语句,在语句中判断自己是不是被选中的case。
#5. Sync面试题
#5.1 除了 mutex 以外还有那些方式安全读写共享变量?
除了Mutex,主要还有信号量 、**通道(Channel),原子操作(atomic)**这几种方式。
信号量的实现其实跟mutex差不多,实现起来也很方便,主要通过信号量计数来保证。chanenl是Go最推崇的方式,它通过通信来传递数据所有权,从根源上避免竞争,更适合复杂的业务逻辑;而原子操作则针对最简单的整型或指针等进行无锁操作,性能最高,常用于实现计数器或状态位。选择哪种,完全取决于数据结构的复杂度和业务的读写模型。
#5.2 Go 语言是如何实现原子操作的?
Go语言实现原子操作,其根本是依赖底层CPU硬件提供的原子指令,而不是通过操作系统或更上层的锁机制。
具体来说,Go的sync/atomic包中的函数,在编译时会被编译器识别,并直接转换成对应目标硬件平台(如x86、ARM)的单条原子机器指令。例如,在x86架构上,atomic.AddInt64这类操作会对应到像LOCK; ADD这样的指令。前面的LOCK前缀是关键,它会锁住总线或缓存行,确保后续的ADD指令在执行期间,其他CPU核心不能访问这块内存,从而保证了整个操作的原子性。
#5.3 聊聊原子操作和锁的区别?
原子操作和锁最核心的区别在于它们的实现层级 和保护范围。
原子操作是CPU硬件层面的"微观"机制,它保证对单个数据(通常是整型或指针)的单次读改写操作是绝对不可分割的,性能极高,因为它不涉及操作系统内核的介入和goroutine的挂起。
锁 则是操作系统或语言运行时提供的"宏观"机制,它保护的是一个代码块(临界区),而不仅仅是单个变量。当获取锁失败时,它会让goroutine休眠,而不是空耗CPU。虽然锁的开销远大于原子操作,但它能保护一段复杂的、涉及多个变量的业务逻辑。
所以,对于简单的计数器或标志位更新,用原子操作追求极致性能;而只要需要保护一段逻辑或多个变量的一致性,就必须用锁。
#5.4 Go语言互斥锁mutex底层是怎么实现的?
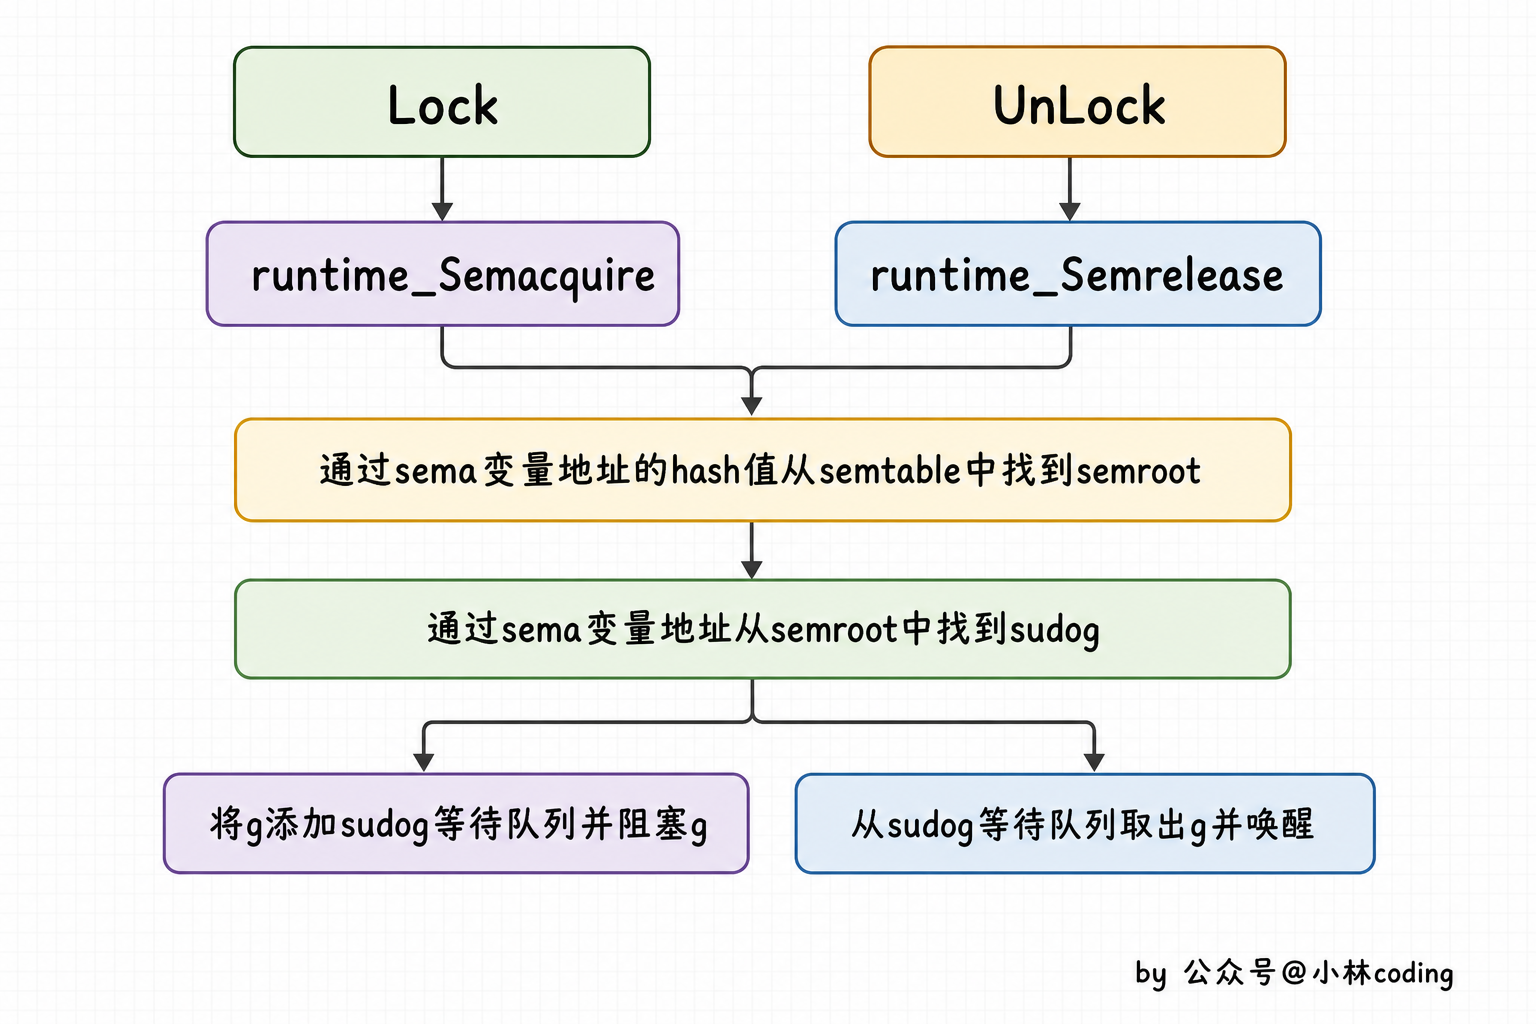
mutex底层是通过原子操作加信号量来实现的,通过atomic 包中的一些原子操作来实现锁的锁定,通过信号量来实现协程的阻塞与唤醒
分析
互斥锁对应的是底层结构是sync.Mutex结构体
type Mutex struct {
  state int32
  sema  uint32
 }
state表示锁的状态,有锁定、被唤醒、饥饿模式等,并且是用state的二进制位来标识的,不同模式下会有不同的处理方式
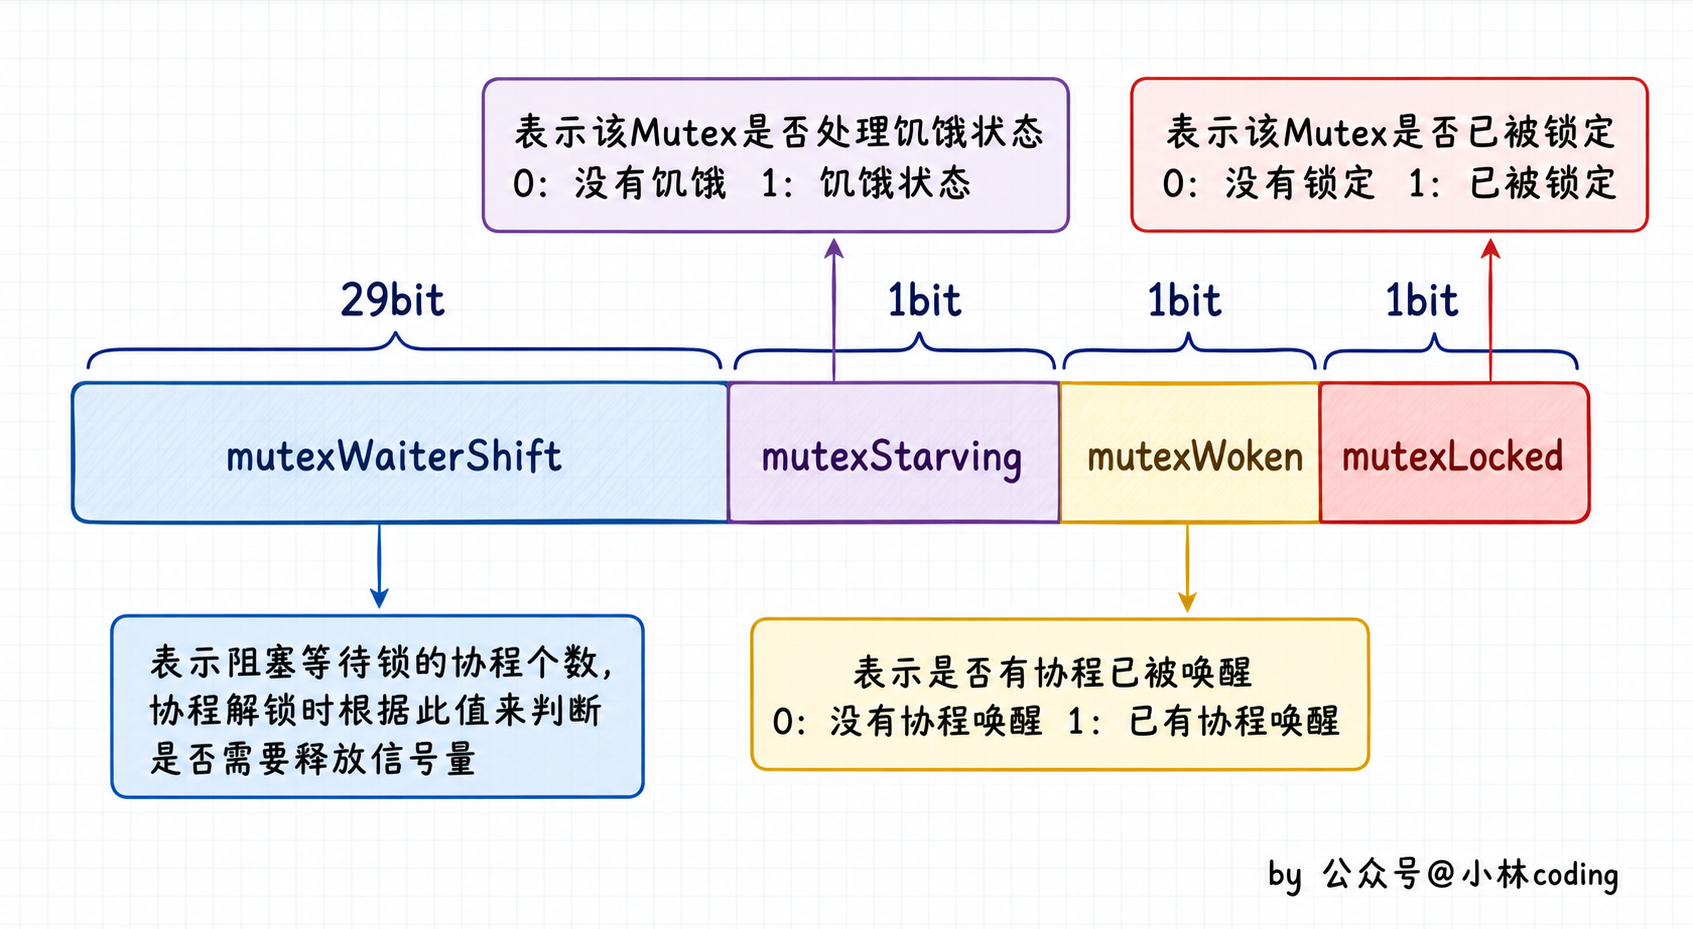
sema表示信号量,mutex阻塞队列的定位是通过这个变量来实现的,从而实现goroutine的阻塞和唤醒
#5.5 Mutex 有几种模式?
Go的Mutex主要有两种模式:正常模式(Normal Mode)和饥饿模式(Starvation Mode)。
-
正常模式:这是默认模式,讲究的是性能。新请求锁的goroutine会和等待队列头部的goroutine竞争,新来的goroutine有几次"自旋"的机会,如果在此期间锁被释放,它就可以直接抢到锁。这种方式吞吐量高,但可能会导致队列头部的goroutine等待很久,即"不公平"。
-
饥饿模式:当一个 goroutine 在等待队列中等待超过 1 毫秒(1ms)后,Mutex 就会切换到此模式,讲究的是公平。在此模式下,锁的所有权会直接从解锁的goroutine移交给等待队列的头部,新来的goroutine不会自旋,必须排到队尾。这样可以确保队列中的等待者不会被"饿死"。
当等待队列为空,或者一个goroutine拿到锁时发现它的等待时间小于1ms,饥饿模式就会结束,切换回正常模式。这两种模式的动态切换,是Go在性能和公平性之间做的精妙平衡。
#5.6 在Mutex上自旋的goroutine 会占用太多资源吗
并不会,因为Go的自旋设计得非常"克制"和"智能"。
首先,自旋不是无休止的空转,它有严格的次数和时间限制,通常只持续几十纳秒。其次,自旋仅仅在特定条件下才会发生,比如CPU核数大于1,并且当前机器不算繁忙(没有太多goroutine在排队)。它是在赌,与其付出"goroutine挂起和唤醒"这种涉及内核调度的巨大代价,不如原地"稍等一下",因为锁可能马上就释放了。
所以,这种自旋是一种机会主义的短线优化,目的是用极小的CPU开销去避免一次昂贵的上下文切换,在锁竞争不激烈、占用时间极短的场景下,它反而是节省了资源。
#5.7 Mutex 已经被一个 Goroutine 获取了, 其它等待中的 Goroutine 们只能一直等待。那么等这个锁释放后,等待中的 Goroutine 中哪一个会优先获取 Mutex 呢?
取决于Mutex当前处于正常模式还是饥饿模式。
在正常模式 下,锁的分配是"不公平"的。当锁被释放时,等待队列中的第一个goroutine会被唤醒,但它不一定能拿到锁。它需要和那些此刻刚刚到达、正在自旋的新goroutine进行竞争。新来的goroutine因为正在CPU上运行,很有可能"插队"成功,直接抢到锁。这种策略的优点是吞吐量高,但缺点是可能导致等待队列中的goroutine被饿死。
而一旦Mutex进入饥饿模式,锁的分配就变得"绝对公平"。锁被释放后,会直接移交给等待队列的队头goroutine,任何新来的goroutine都不会参与竞争,必须乖乖排到队尾。
#5.8 sync.Once 的作用是什么,讲讲它的底层实现原理?
sync.Once的作用是确保一个函数在程序生命周期内,无论在多少个goroutine中被调用,都只会被执行一次。它常用于单例对象的初始化或一些只需要执行一次的全局配置加载
sync.Once保证代码段只执行1次的原理主要是其内部维护了一个标识位,当它 == 0 时表示还没执行过函数,此时会加锁修改标识位,然后执行对应函数。后续再执行时发现标识位 != 0,则不会再执行后续动作了
分析
Once其实是一个结构体
type Once struct {
    done uint32  // 标识位
    m    Mutex
}核心依赖一个uint32的done标志位和一个互斥锁Mutex,
当Once.Do(f)首次被调用时:
-
它首先会通过原子操作(
atomic.LoadUint32)快速检查done标志位。如果done为1,说明初始化已完成,直接返回,这个路径完全无锁,开销极小。 -
如果
done为0,说明可能是第一次调用,这时它会进入一个慢路径(doSlow)。 -
在慢路径里,它会先加锁 ,然后再次检查
done标志位。这个"双重检查"(Double-Checked Locking)是关键,它防止了在多个goroutine同时进入慢路径时,函数f被重复执行。 -
如果此时
done仍然为0,那么当前goroutine就会执行传入的函数f。执行完毕后,它会通过原子操作(atomic.StoreUint32)将done标志位置为1,最后解锁。
之后任何再调用Do的goroutine,都会在第一步的原子Load操作时发现done为1而直接返回。整个过程结合了原子操作的速度和互斥锁的安全性,高效且线程安全地实现了"仅执行一次"的保证
#5.9 WaitGroup 是怎样实现协程等待?
WaitGroup实现等待,本质上是一个原子计数器和一个信号量的协作。
调用Add会增加计数值,Done会减计数值。而Wait方法会检查这个计数器,如果不为零,就利用信号量将当前goroutine高效地挂起。直到最后一个Done调用将计数器清零,它就会通过这个信号量,一次性唤醒所有在Wait处等待的goroutine,从而实现等待目的。
分析:
waitgroup的结构定义:
// A WaitGroup waits for a collection of goroutines to finish.
// The main goroutine calls Add to set the number of goroutines to wait for.
// Then each of the goroutines runs and calls Done when finished. At the same
// time, Wait can be used to block until all goroutines have finished.
//
// A WaitGroup must not be copied after first use.
type WaitGroup struct {
        noCopy noCopy // 用于vet工具检查是否被复制

        // 64位的值:高32位是计数器,低32位是等待的goroutine数量。
        // 通过原子操作访问,保存了状态和等待者数量。
        state atomic.Uint64

        // 用于等待者休眠的信号量。
        sema uint32
}
noCopy : 这是一个特殊的字段,用于静态分析工具(go vet)在编译时检查WaitGroup实例是否被复制。WaitGroup被复制后会导致状态不一致,可能引发程序错误,因此该字段的存在旨在防止此类问题的发生。
state : 这是WaitGroup的核心,一个64位的无符号整型,通过sync/atomic包进行原子操作,以保证并发安全。这个64位的空间被巧妙地分成了两部分:
-
高32位 : 作为计数器(counter),记录了需要等待的 goroutine 的数量。
-
低32位 : 作为等待者计数器(waiter count) ,记录了调用
Wait()方法后被阻塞的 goroutine 的数量。
sema : 这是一个信号量,用于实现 goroutine 的阻塞和唤醒。当主 goroutine 调用Wait()方法且计数器不为零时,它会通过这个信号量进入休眠状态。当所有子 goroutine 完成任务后,会通过这个信号量来唤醒等待的主 goroutine。
#5.10 讲讲sync.Map的底层原理
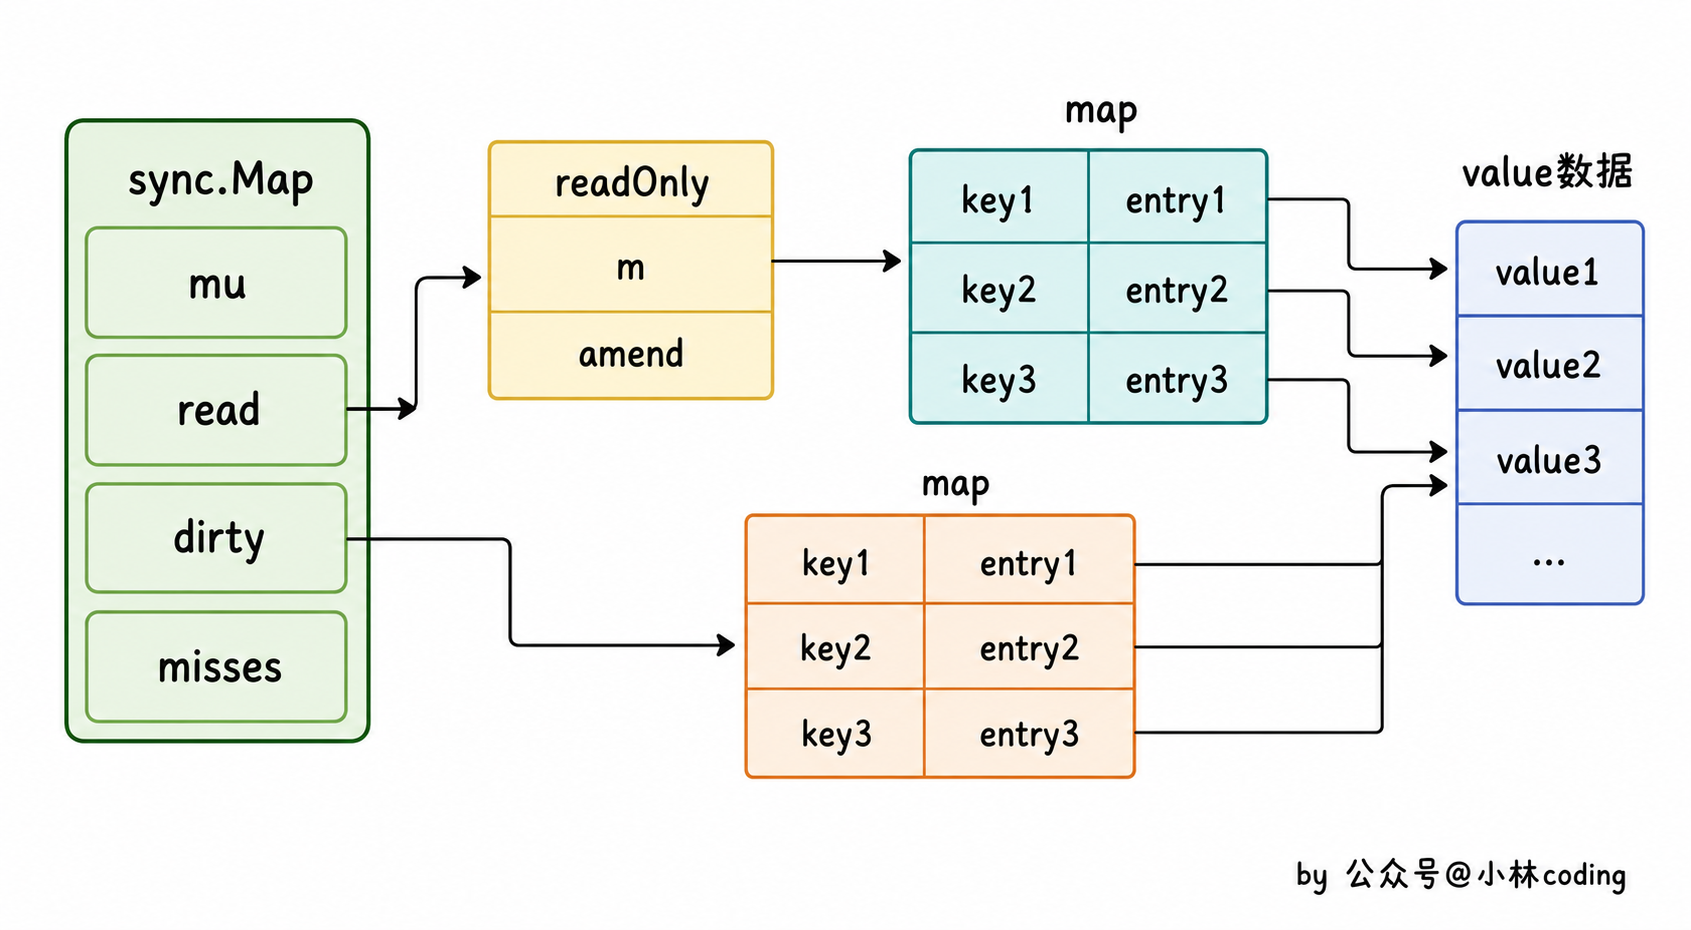
sync.Map的底层核心是**"空间换时间",** 通过两个Map(read和dirty)** 的冗余结构,实现"读写分离",最终达到针对特定场景的"读"操作无锁优化。
它的read是一个只读的map,提供无锁的并发读取,速度极快。写操作则会先操作一个加了锁的、可读写的dirty map。当dirty map的数据积累到一定程度,或者read map中没有某个key时,sync.Map会将dirty map里的数据"晋升"并覆盖掉旧的read map,完成一次数据同步。
分析:
sync.Map的结构定义
type Map struct {
   mu Mutex             //  用于保护dirty字段的锁
   read atomic.Value    // 只读字段,其实际的数据类型是一个readOnly结构
   dirty map[interface{}]*entry  //需要加锁才能访问的map,其中包含在read中除了被expunged(删除)以外的所有元素以及新加入的元素
   misses int // 计数器,记录在从read中读取数据的时候,没有命中的次数,当misses值等于dirty长度时,dirty提升为read
}read字段的类型是atomic.Value,但是在使用中里面其实存储的是readOnly结构,readOnly结构定义如下:
// readOnly is an immutable struct stored atomically in the Map.read field.
type readOnly struct {
   m       map[interface{}]*entry   // key为任意可比较类型,value为entry指针
   amended bool // amended为true,表明dirty中包含read中没有的数据,为false表明dirty中的数据在read中都存在
}entry这个结构:
type entry struct {
    p unsafe.Pointer  // p指向真正的value所在的地址
}
#5.11 read map和dirty map之间有什么关联?
它们之间是**"只读缓存"** 和**"最新全集"**的关联。
read map是dirty map的一个不完全、且可能是过期的只读快照。dirty map则包含了所有的最新数据。
具体来说,read map中的所有数据,在dirty map里一定存在。一个key如果在read map里,那它的value要么就是最终值,要么就是一个特殊指针,指向dirty map里对应的条目。而dirty map里有,read map里却可能没有,因为dirty是最新、最全的。
当dirty map积累了足够多的新数据后,它会"晋升"为新的read map,旧的read map则被废弃。这个过程,就完成了"缓存"的更新。
#5.12 为什么要设计nil和expunged两种删除状态?
设计nil和expunged这两个状态,是为了解决在sync.Map的"读写分离"架构下,如何高效、无锁地处理"删除"操作。
因为 read map 本身是只读的,我们不能直接从中删除一个 key。所以,当用户调用 Delete 时,如果这个 key 存在于 read 中,系统会通过原子操作把 entry.p 置为 nil(这就是"逻辑删除"状态 ),后续的读操作如果看到 nil 就直接返回 nil, false。
而 expunged 是更彻底的删除标记:当之后某次写操作需要基于 read 重建 dirty map 时,会扫描 read,把所有 p == nil 的 entry 进一步标记为 expunged ,表示"该 key 不再被复制到新的 dirty 中"。后续如果要重新 Store 一个 expunged 的 key,必须先把它从 expunged 回退为 nil 并同步到 dirty,再写入。
简单来说,这两个状态就像是在只读的read map上打的"逻辑删除"补丁。它避免了因为一次Delete操作就引发加锁和map的整体复制,把真正的物理删除延迟到了dirty map"晋升"为read map的那一刻,是典型的用状态标记来换取无锁性能的设计。
#5.13 sync.Map 适用的场景?
sync.Map适合读多写少的场景,而不是适合写多读少的场景。
因为我们期望将更多的流量在read map这一层进行拦截,从而避免加锁访问dirty map 对于更新,删除,读取,read map可以尽量通过一些原子操作,让整个操作变得无锁化,这样就可以避免进一步加锁访问dirty map。倘若写操作过多,sync.Map 基本等价于一把互斥锁 + map,其读写效率会大大下降