一、为什么需要Attention?
人类每时每刻都会接收到大量信息,但大脑的处理能力是有限的,因此我们需要有选择地关注重要信息。例如,当我们走在路上,周围有行人、汽车、建筑、广告等信息,但我们不会同等程度地关注所有信息。人类的注意力主要收到两种提示的引导。
1.非自主性提示(Non-volitional Cues)
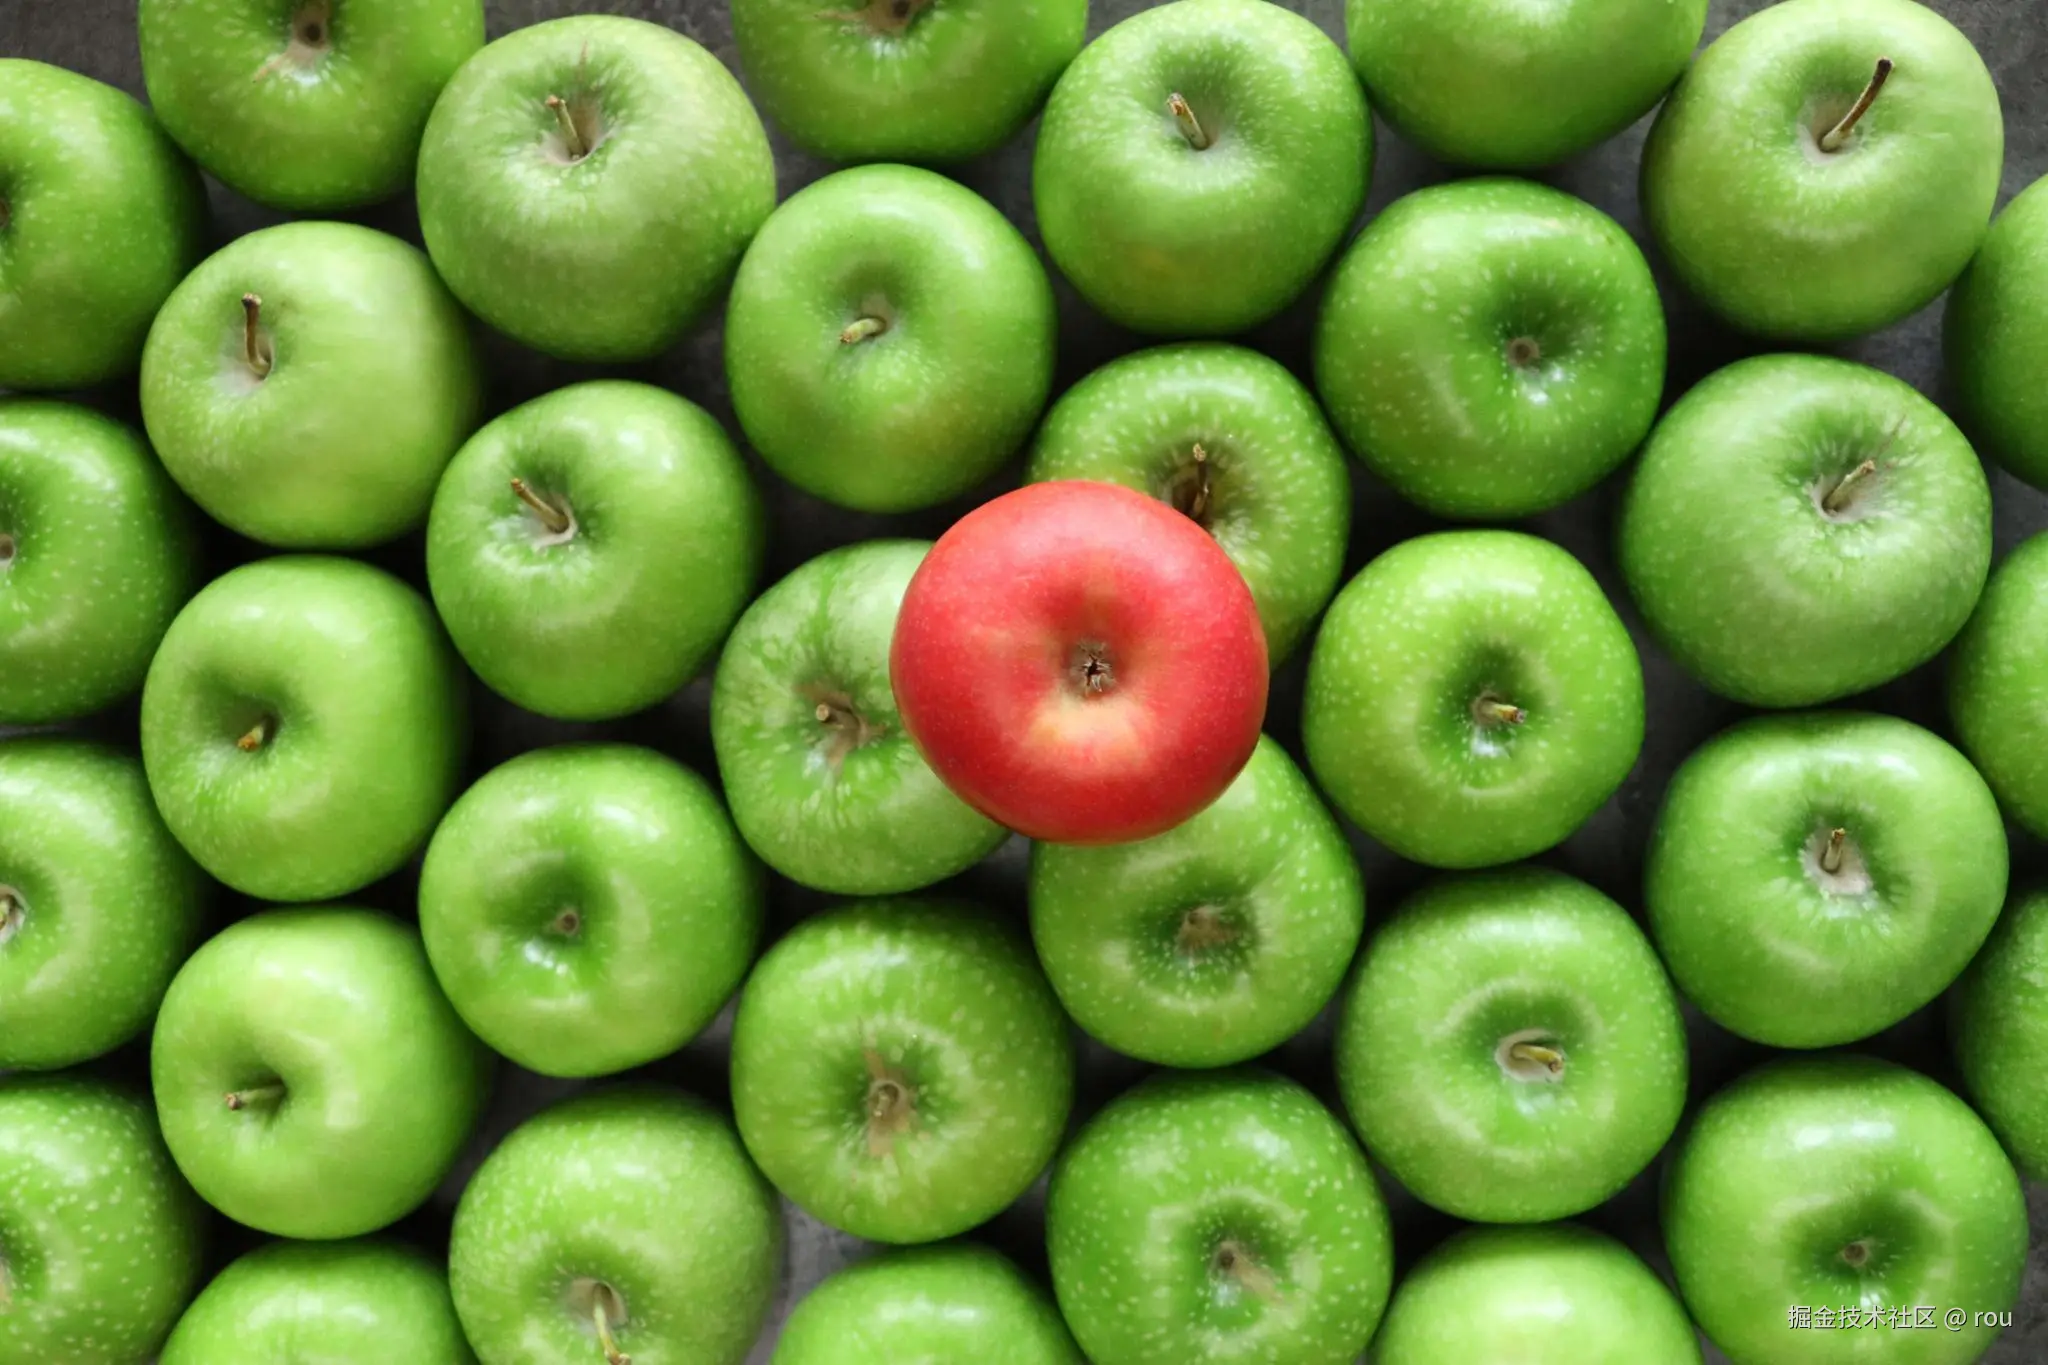 非自主性提示是指:注意力受到输入自身显著特征的影响,不需要明确的查询目标。
例如,一堆绿色苹果中有一个红色苹果,我们可能会自然地注意到红色苹果。
2.自主性提示(Volitional Cues)
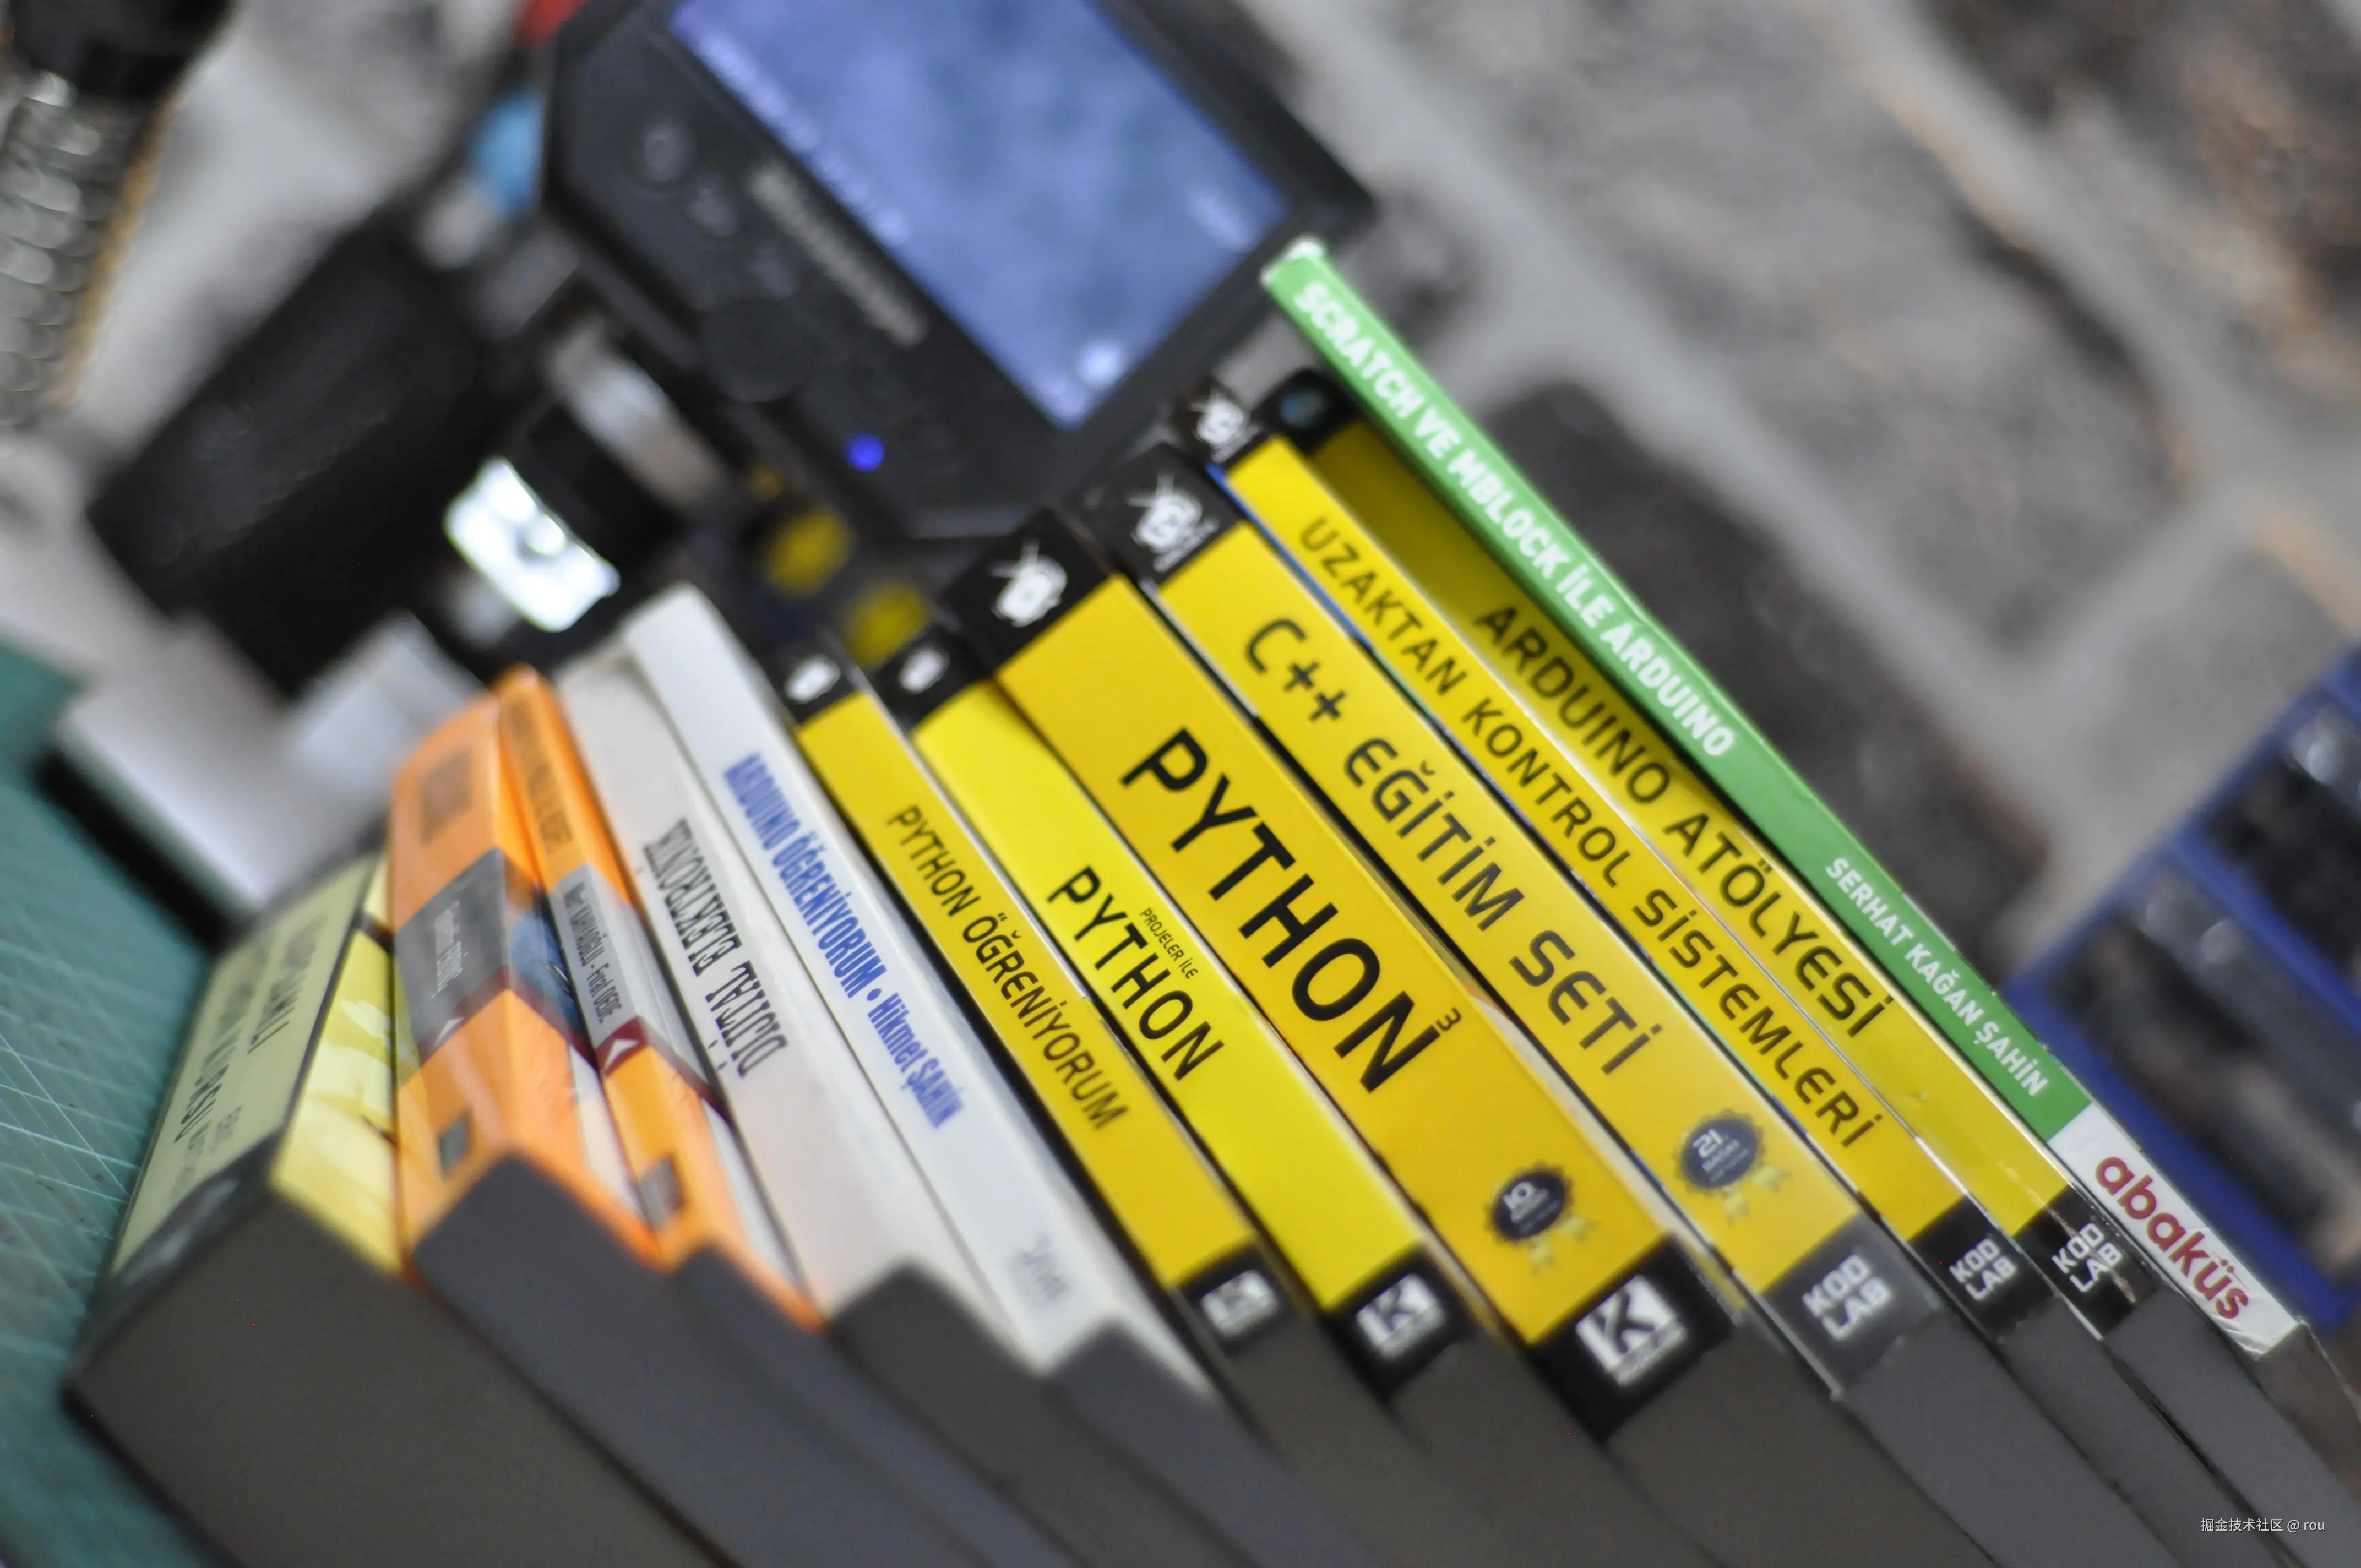
自主性提示是指:注意力受到当前目标的引导。
例如,你去图书馆寻找一本Python教材,会主动关注书名、作者等与目标相关的信息,而不一定关注最显眼的书。
这两种方式引出了神经网络中两种信息处理思路:
· 不依赖 Query 的汇聚:按照某种规则汇总输入信息。
· 依赖 Query 的注意力汇聚:根据查询目标动态决定不同信息的重要程度。
二、没有 Query,也能汇总信息吗?
可以,因为 Query 只是输入的附加品, 用来强调我们更关注哪些信息。这里需要先区分两个概念:
· Pooling(汇聚):将多个输入汇总成一个输出。
. Attention Pooling(注意力汇聚):根据 Query 与 Key 的匹配程度,对 Value 进行加权汇总。
假设有三个输入: X = 2,4,6,
最简单的汇聚方式包括:
平均汇聚(Average Pooling)、最大汇聚(Max Pooling),
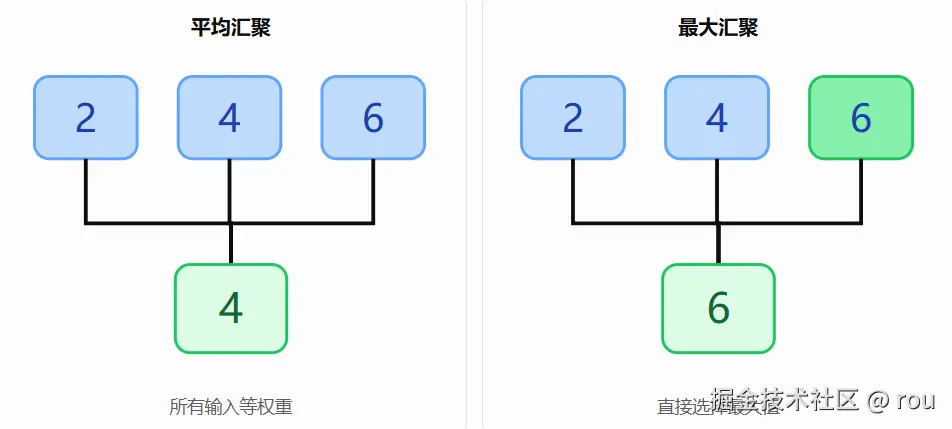
这两种方式都不需要 Query, 因为它们的汇聚规则不依赖额外的查询目标。Query 并不是必需的,因为神经网络不一定是回答人类提出的问题,它也可能只是需要对输入进行统计、压缩和特征提取。但如果我们希望模型根据不同需求,对同一组输入给予不同的关注程度,简单的平均汇聚或最大汇聚就不够灵活了。因此,引入 Query ,让汇聚过程受到查询目标的引导。
这就是从普通 Pooling 过渡到 Attention Pooling 的关键。
三、引出 Attention 的三个核心概念:Q、K、V
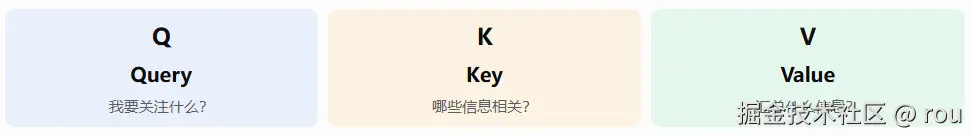
1.Query (Q): 查询向量
Query 表示当前的查询需求,用来引导模型关注与目标相关的信息。例如,我们有三个学生的成绩:
| 学生 | 数学 | 英语 |
|---|---|---|
| 小明 | 90 | 70 |
| 小红 | 60 | 95 |
| 小刚 | 80 | 85 |
现在希望重点关注数学接近 85 分的学生,并汇总他们的成绩信息,那么可以设置: q = 85, 这个 Query 表示当前希望关注数学成绩接近 85 的学生。
注意:Query 不一定是用户提出的自然语言问题。
它可以是用户问题经过编码后的向量,也可以是神经网络内部生成的查询表示(Query不一定是用户直接提供的附加信息,也可以由神经网络内部计算生成)。
2.Key (K): 用于匹配的特征
Key 用于与 Query 进行匹配,判断不同信息与查询目标的相关程度。可以把 Key 理解为标签。在这个例子中,我们使用数学成绩作为 Key: k1 = 90, k2 = 60, k3 = 80。模型通过 Q 与各个 K 的匹配程度,判断哪些学生更符合当前的查询需求。不过,真实神经网络中的 Key 通常是数值特征向量,而不一定是人类能够直接读懂的标签。
3.Value(V): 需要汇总的信息
Value 是与 Key 对应、需要被汇总的信息。在这个例子中,Key 决定模型应该关注哪些学生,Value 决定模型从这些学生身上汇总什么信息,使用学生的数学成绩和英语成绩,即成绩信息作为 Value: v1 = 90,70, v2 = 60,95, v3 = 80,85, 每个Value都是二维向量。
Key 和 Value 是一一对应的,但不要求内容相同,也不要求向量维度相同。
4.Q、K、V 的来源
Q、K、V 可以来自输入数据,也可来自神经网络内部的特征表示。
例如:
· Q 可以来自一个查询目标。
· K 可以来自输入数据中用于匹配的特征。
· V 可以来自输入数据中需要汇总的特征。
它们不一定来自知识库,也不一定来自不同的数据源。在当前学生成绩例子中, K、V 都来自输入数据,完全不需要知识库。另外,Value 并不是为了让模型额外回答关联信息。 例如,用户询问天气,模型最终回答"晴天, 适合户外运动", 其中"适合户外运动"不是 Value 专门负责生成的,而是模型后续处理信息的结果。Value 的职责只是提供需要加权汇总的特征内容。
四、Attention 的整体架构
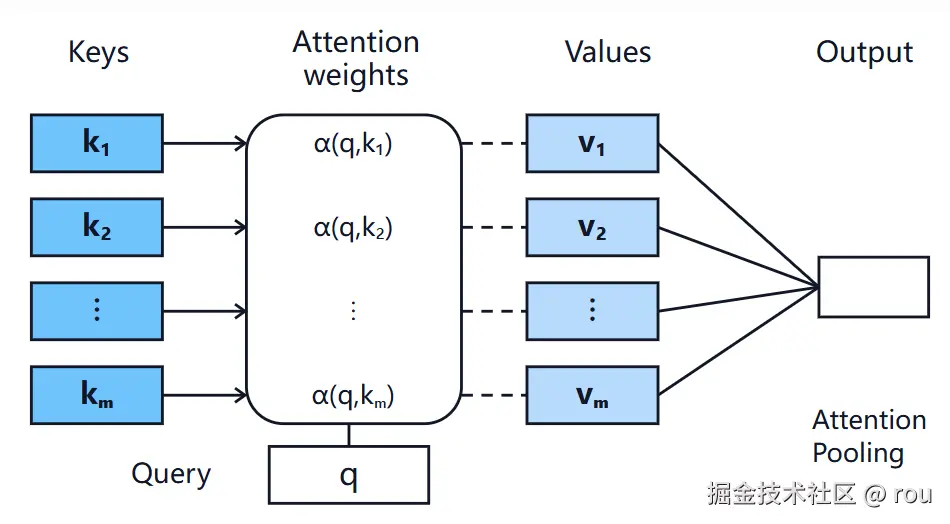
这张图展示了 Attention 的核心流程。
首先, Query q 与多个 Key:
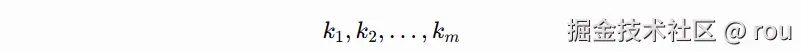
进行匹配。
然后得到对用的注意力权重:
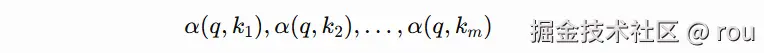
每个 Key 都对应一个 Value:
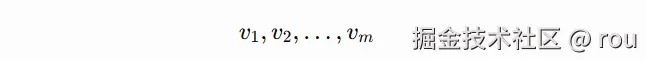
最后, Attention Pooling 根据权重对所有 Value 进行加权求和。
其核心公式是:
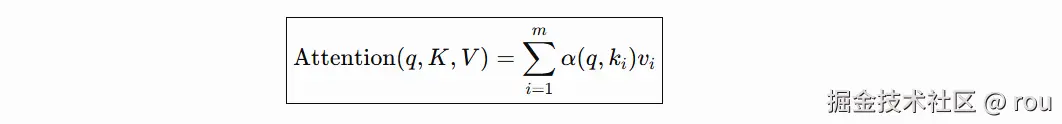
这里需要特别注意:
Attention 通常不是直接选出最匹配的一个 Value, 而是按照权重对多个 Value 进行加权汇总。
因此,最终输出往往是一个新的特征向量,而不是某个原始 Value, 也不一定直接是自然语言答案。
五、 Attention Pooling 的具体计算过程
现在结合学生成绩例子,进一步理解计算过程。
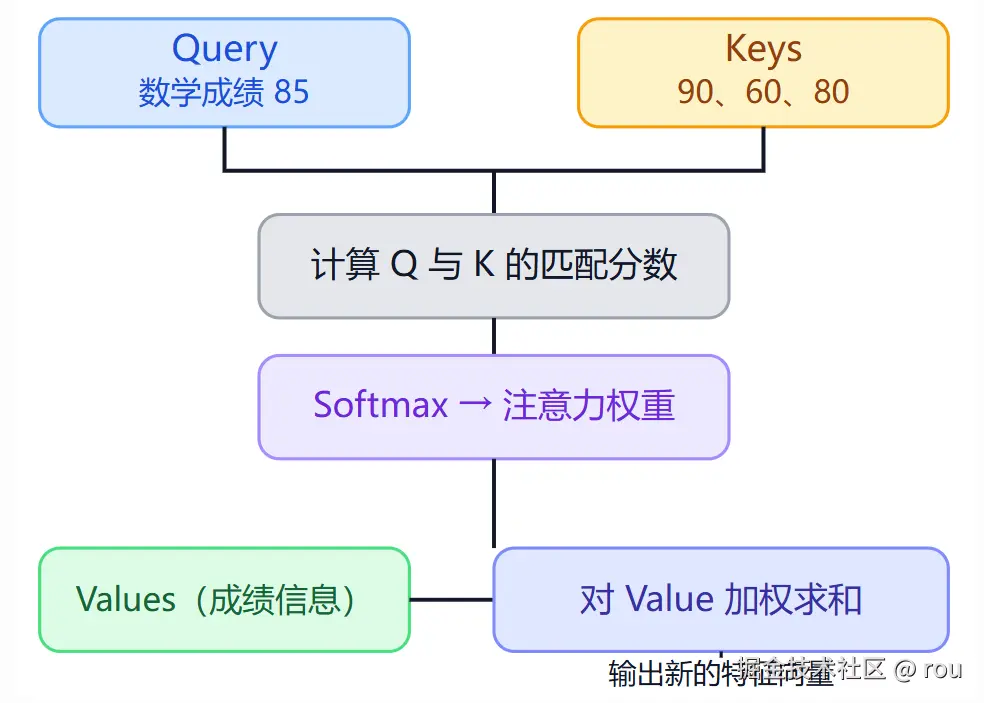
整个计算分为三个步骤。
第一步: Q 与 K 就算匹配分数
假设我们使用负距离作为评分函数:
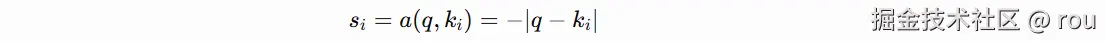
其中:
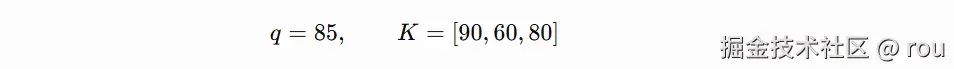
所以:
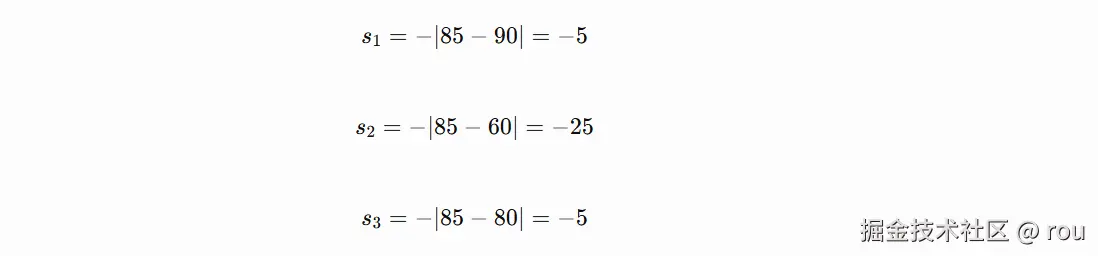
得到:
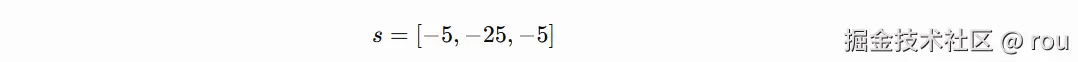
分数越高,表示匹配程度越高。注意,负距离只是为了便于理解而选用的一种评分函数。Attention并不要求必须使用这种方式。
第二步:通过 Softmax 计算注意力权重
Softmax 的作用是将匹配分数转换成非负、综合为 1 的权重。
公式:
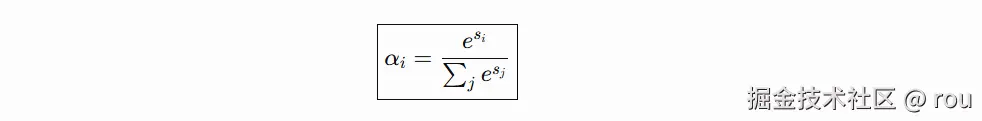
代入刚才的分数:
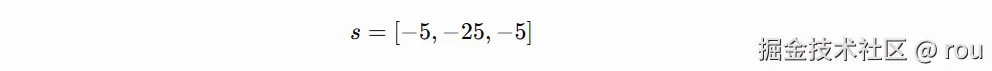
得到近似结果:
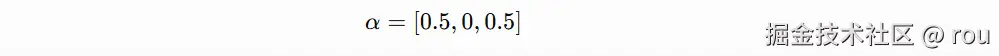
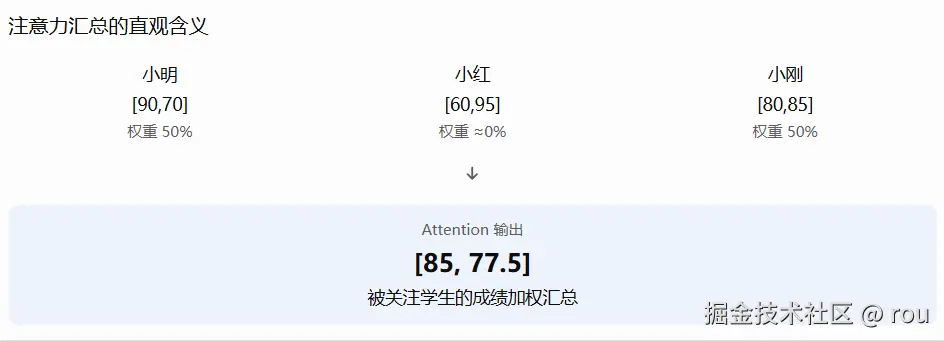
注意力权重分布(近似)
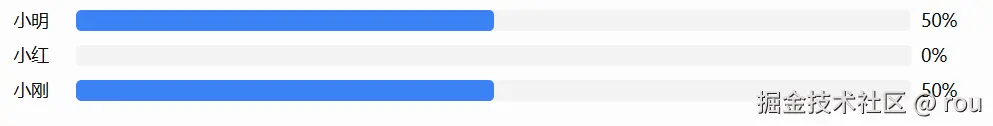
这里小红的权重并不是真正等于零,而是非常接近零。因为小明和小刚的数学成绩都距离 85 分只有 5 分,所以他们获得了更高的注意力权重。
第三步:对 Value 进行加权求和
三个 Value 分别为:
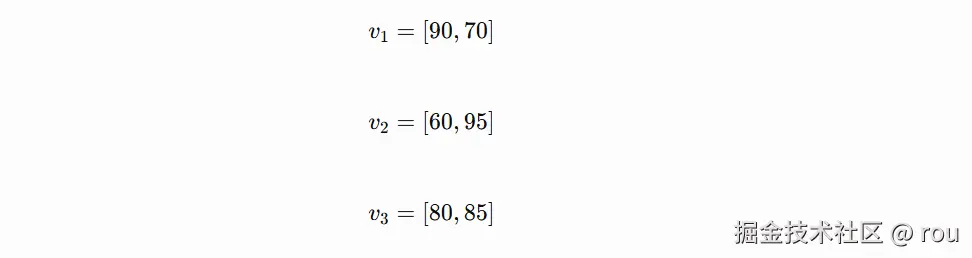
Attention 的核心公式:
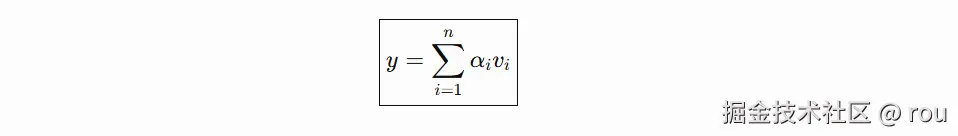
代入:
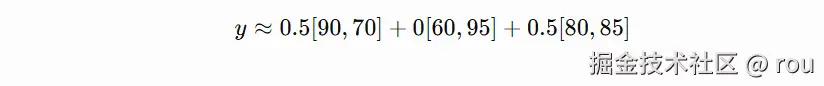
得到:
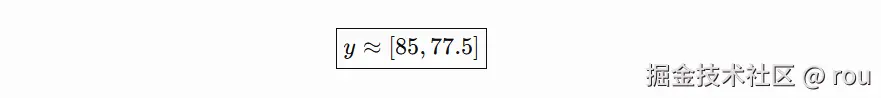
这就是 Attention Pooling 的输出。它是新的二维向量,而不是某个学生的原始成绩信息。
但是注意,实际神经网络中的输出通常不是这样直观的,这是最重要的区别。在我们的例子中,Value 的两个维度有明确的人类含义,所以输出向量的两个维度也有明确含义。但是在真正的深度学习模型中,Value 可能是:
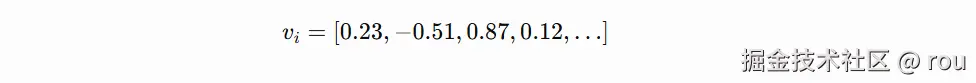
这些数值可能表示神经网络学到的复杂特征,通常不能简单地解释为某一个具体概念。Attention 对它们加权求和后,得到的也是一个新的特征向量。这个向量的作用是:把当前 Query 需要关注的信息汇总起来,供后续神经网络层继续处理 。因此,在该例中,输出可以解释为加权平均成绩;在真实神经网络中,输出通常是融合了相关信息的特征表示。
六、Attention 的权重是固定的吗?
这里需要区分三个概念:
| 内容 | 是否固定 |
|---|---|
| 加权求和数学形式 | 固定 |
| 注意力权重αi | 根据 Q、K 动态变化 |
| 评分函数中的可学习参数 | 如果存在,可以通过训练更新 |
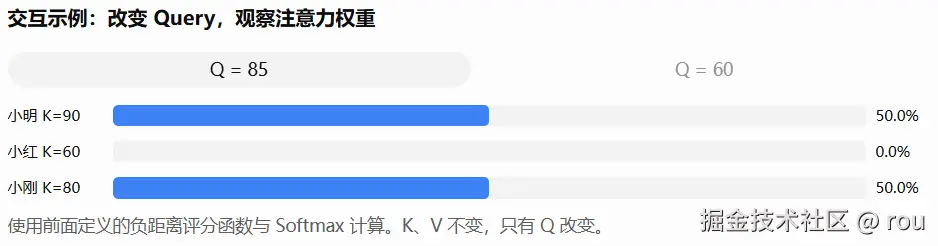
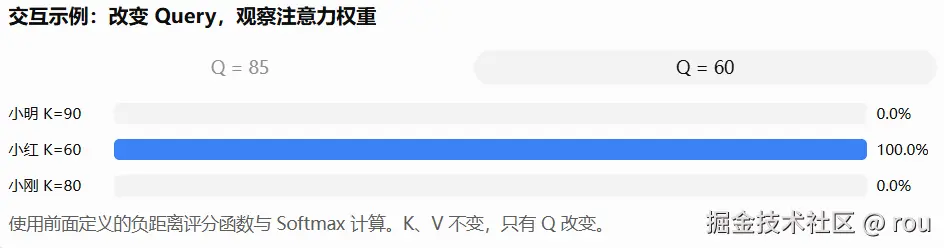
因此,Attention 的加权求和形式固定,但注意力权重可以根据 Query 和 Key 动态变化。另外,有些评分函数包含可学习参数,有些没有,所以不能说 Attention 的所有部分都是固定且不可学习的。
七、向量、矩阵计算
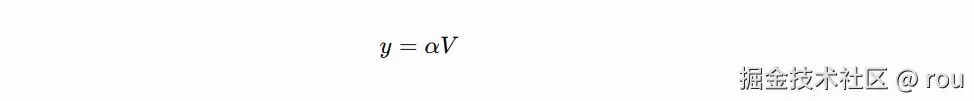
即:
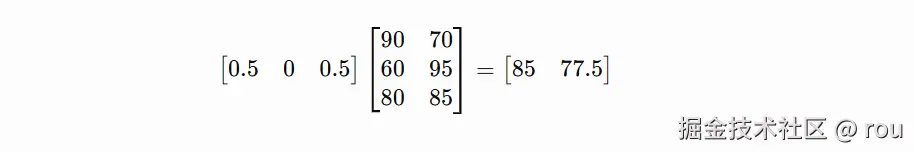
所以:
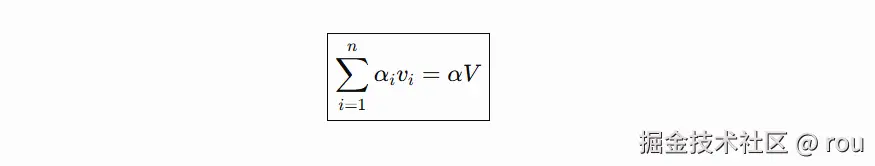
两种写法完全等价。
矩阵维度关系:
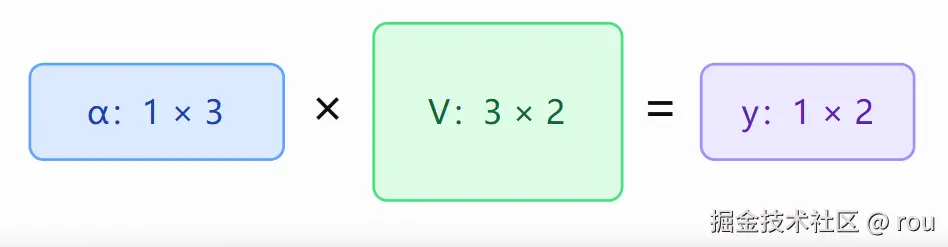
也就是说,Attention 的输出维度由 Value 的特征维度决定,而不是由 Key 的维度决定。
八、最终总结
Attention 是一种用于选择性汇总信息的机制,其思想来源于人类注意力的分配方式。人类注意力可以受到非自主性提示和自主性提示的引导。前者主要依赖输入自身的显著特征,后者则受到明确目标的引导。
在神经网络中,如果不需要根据查询目标调整信息的重要程度,可以直接只用平均汇聚或最大汇聚等操作;如果希望根据当前需求动态分配注意力,就可以引入 Query。
Attention 中有三个核心概念: Query、Key 和 Value。 Query 表示当前的查询需求, Key 用于与 Query 计算匹配程度,Value 则提供需要汇总的信息。 Key 可以类比为标签,Value 可以类比为标签对应的内容。Q、K、V 都是数值表示,它们不一定来自知识库,也可以来来自输入数据或神经网络内部的特征。
Attention 首先通过 Q 和各个 K 计算匹配分数,再将分数转换成注意力权重,最后根据这些权重对对应的 Value 向量进行加权求和,得到新的输出向量。
注意力汇聚的数学形式通常是固定的,但注意力权重会随着 Query 和 Key 的变化而动态调整;评分函数也可能包含通过训练学习的参数。
因此,Attention的核心就是:利用 Q 和 K 决定关注什么,利用 V 提供需要汇总的信息,最终得到与当前查询相关的向量表示。
核心公式:
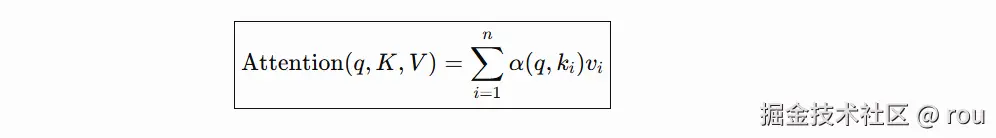
九、神经网络中的 Attention
Attention 可以出现在神经网络的不同层,而且一个模型中可以有多个 Attention 层。 但并不是所有神经网络都必须使用 Attention, 也不是所有层都需要 Attention。
一个简化的网络可能是:
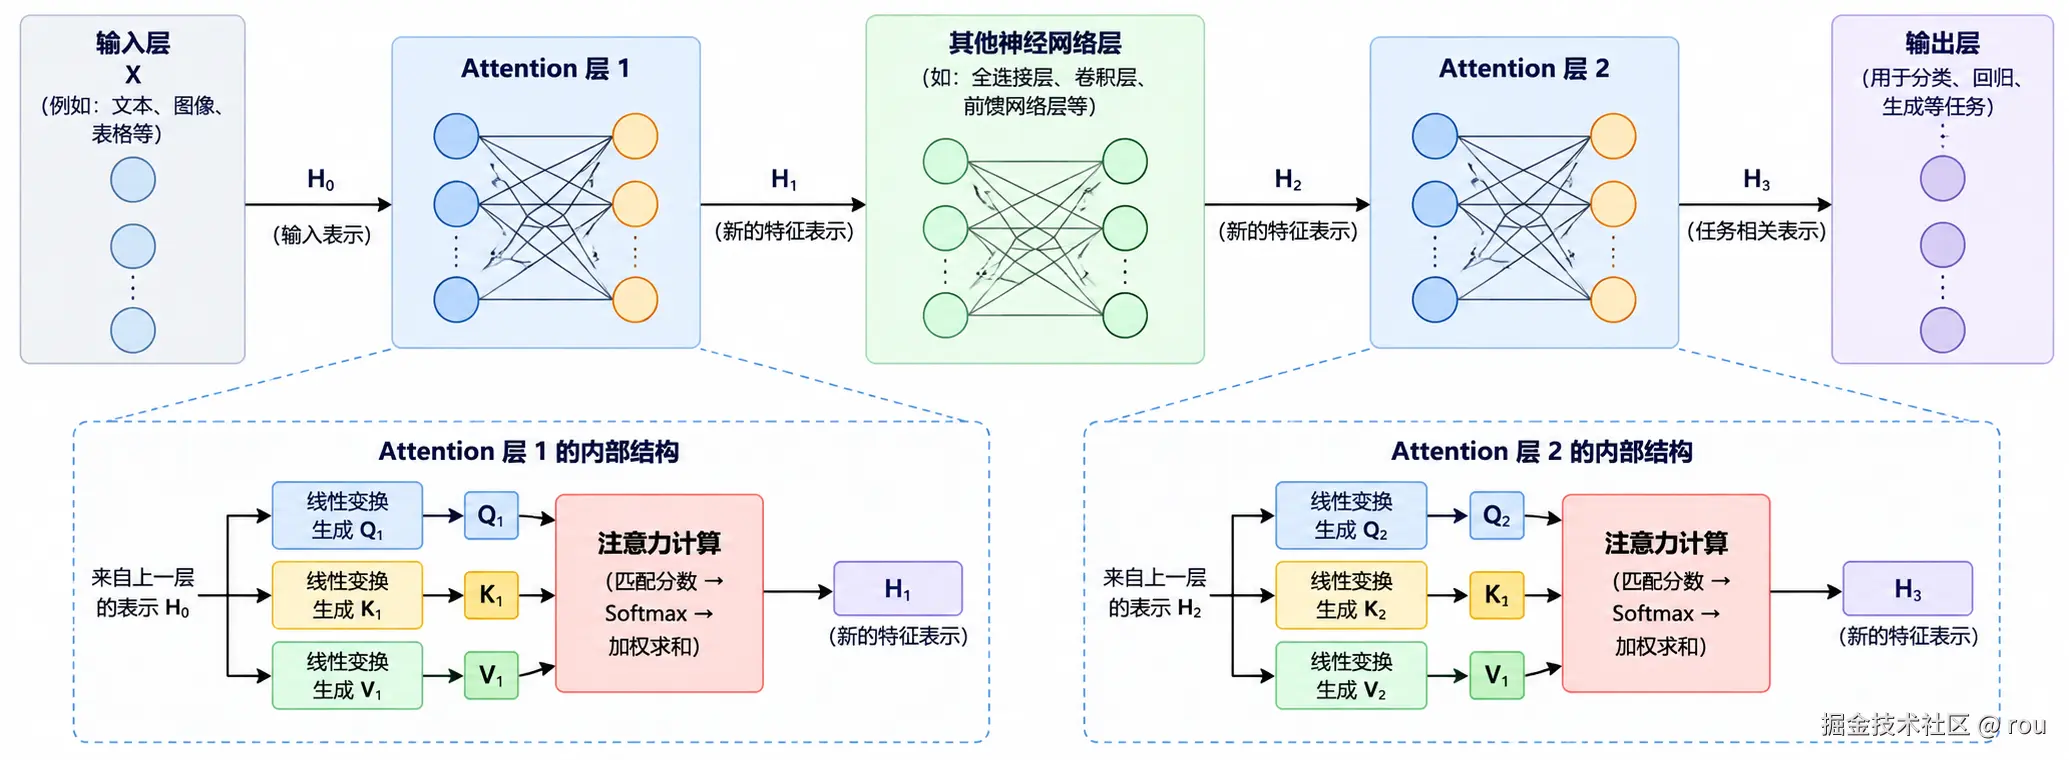
Attention 的本质不是寻找正确答案,而是根据当前查询,构造一个包含相关信息的新表示。