在智能音箱和车载助手上,用户说完一句话常常要干等两三秒才有回应,中间那段沉默让人忍不住把问题重复一遍,卡顿感几乎是语音 AI 最直接的劝退点。
大多数第一版实现是把 ASR、LLM、TTS 串成三段批处理:等整句识别完才送给模型,等模型答完才开始合成,等合成完才敢播放。每一段都要攒齐输入才能启动,串行叠加让延迟轻松突破三秒,而且播放期间麦克风被关掉,用户根本插不上话。
本文分享一套可直接落地的实时对话流水线设计:流式识别 + 增量生成 + 流式合成,配合打断状态机与延迟预算表,把端到端响应压进 800ms。
一、延迟都耗在哪:先算清一笔时间账
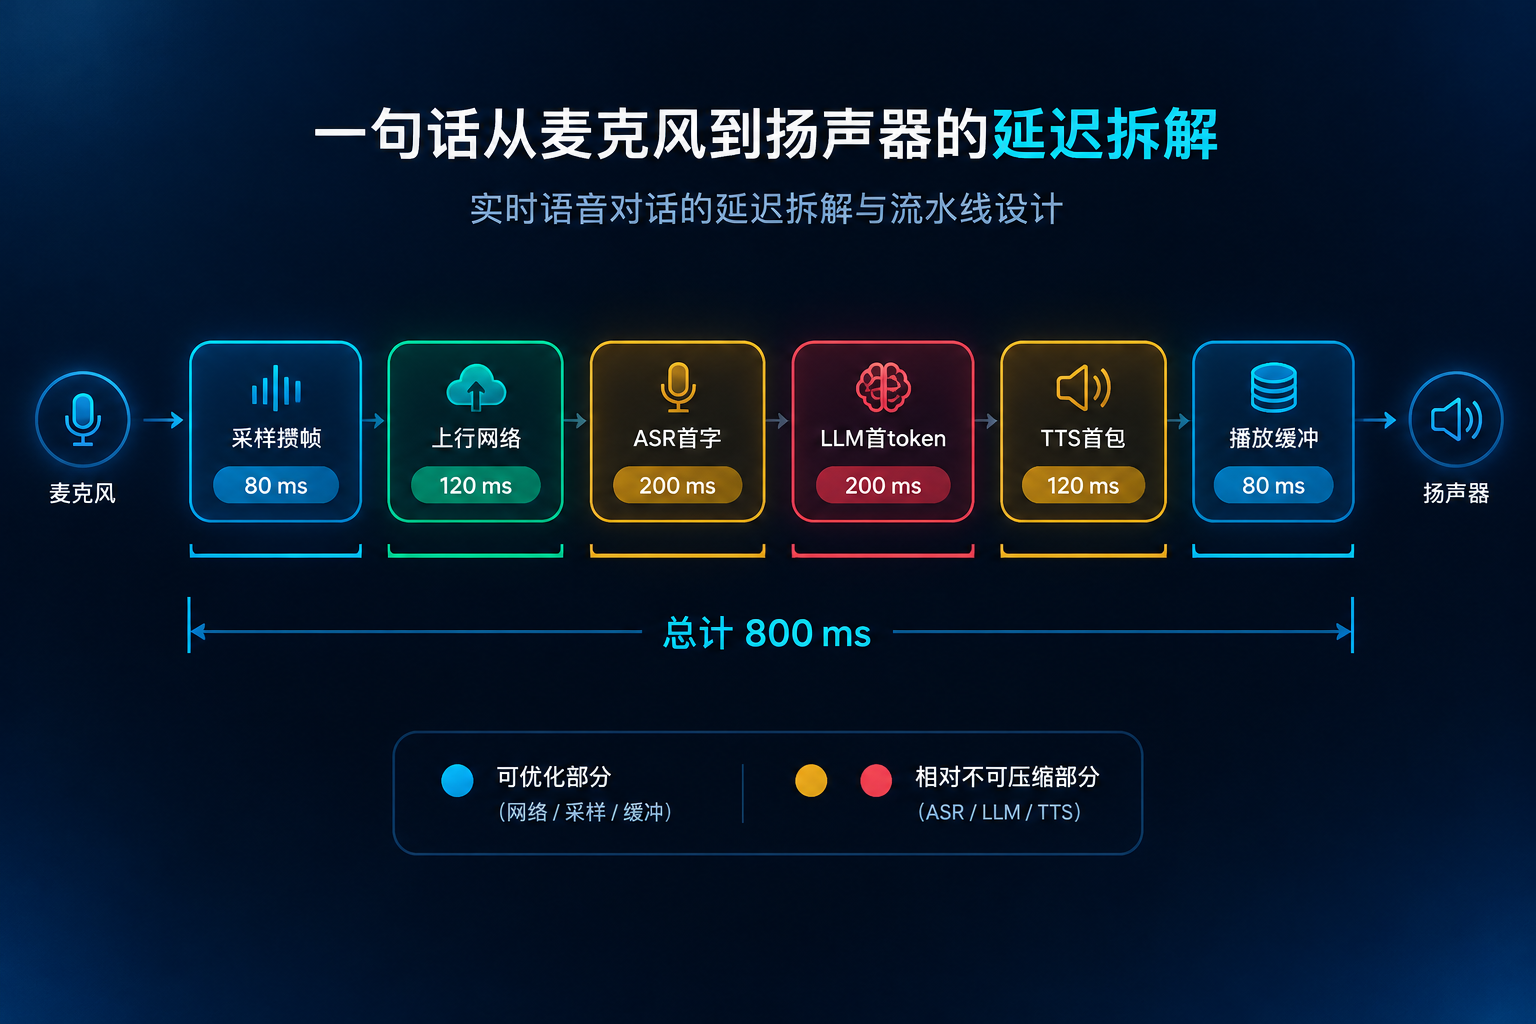
要判断系统卡不卡,先把一句话从麦克风到喇叭的路径逐段拆开:
- 采样攒帧:16kHz 单声道每 10ms 一帧,攒够 30ms 才能送 VAD,这里天然带着起步延迟。
- 四段推理:上行网络往返、ASR 首字、LLM 首 token、TTS 首包,每段各吃 100~400ms。
- 播放缓冲:为了防止卡顿,TTS 通常要攒 100ms 音频才开播,这又是实打实的一笔。
把这几笔加起来就会发现:任何一段失控,整体体验就失控,优化必须分段定量做。
核心结论: 端到端控制在 800ms 以内才「像人」,超过 1.5 秒用户就会觉得系统在发呆。
二、系统全貌:六段流水线如何接力
把整条链路摊平来看,实时语音助手由六个模块首尾相接:
| 模块 | 输入 | 输出 | 关键指标 |
|---|---|---|---|
| 音频采集 | 麦克风信号 | PCM 帧流 | 丢包率、时钟漂移 |
| VAD 端点检测 | PCM 帧流 | 语音段 / 静音段 | 误切率、尾静音阈值 |
| 流式 ASR | PCM 帧流 | 增量文本 | 首字延迟、中间结果率 |
| LLM 增量生成 | 文本流 | token 流 | 首 token 延迟 |
| 流式 TTS | 文本流 | 音频帧 | 首包延迟 |
| 播放与打断 | 音频帧 | 扬声器声音 | 打断响应时间 |
- 全程流式:每一段都必须能吐中间结果,下游才能提前开工,这是低延迟的前提。
- 打断是一等公民:播放期间采集链路不能断,任意时刻用户开口,下游都要能立刻停。
核心结论: 模块边界定义清楚,延迟才可以在每个边界上打点度量。
三、流式 ASR:帧级切分与增量识别
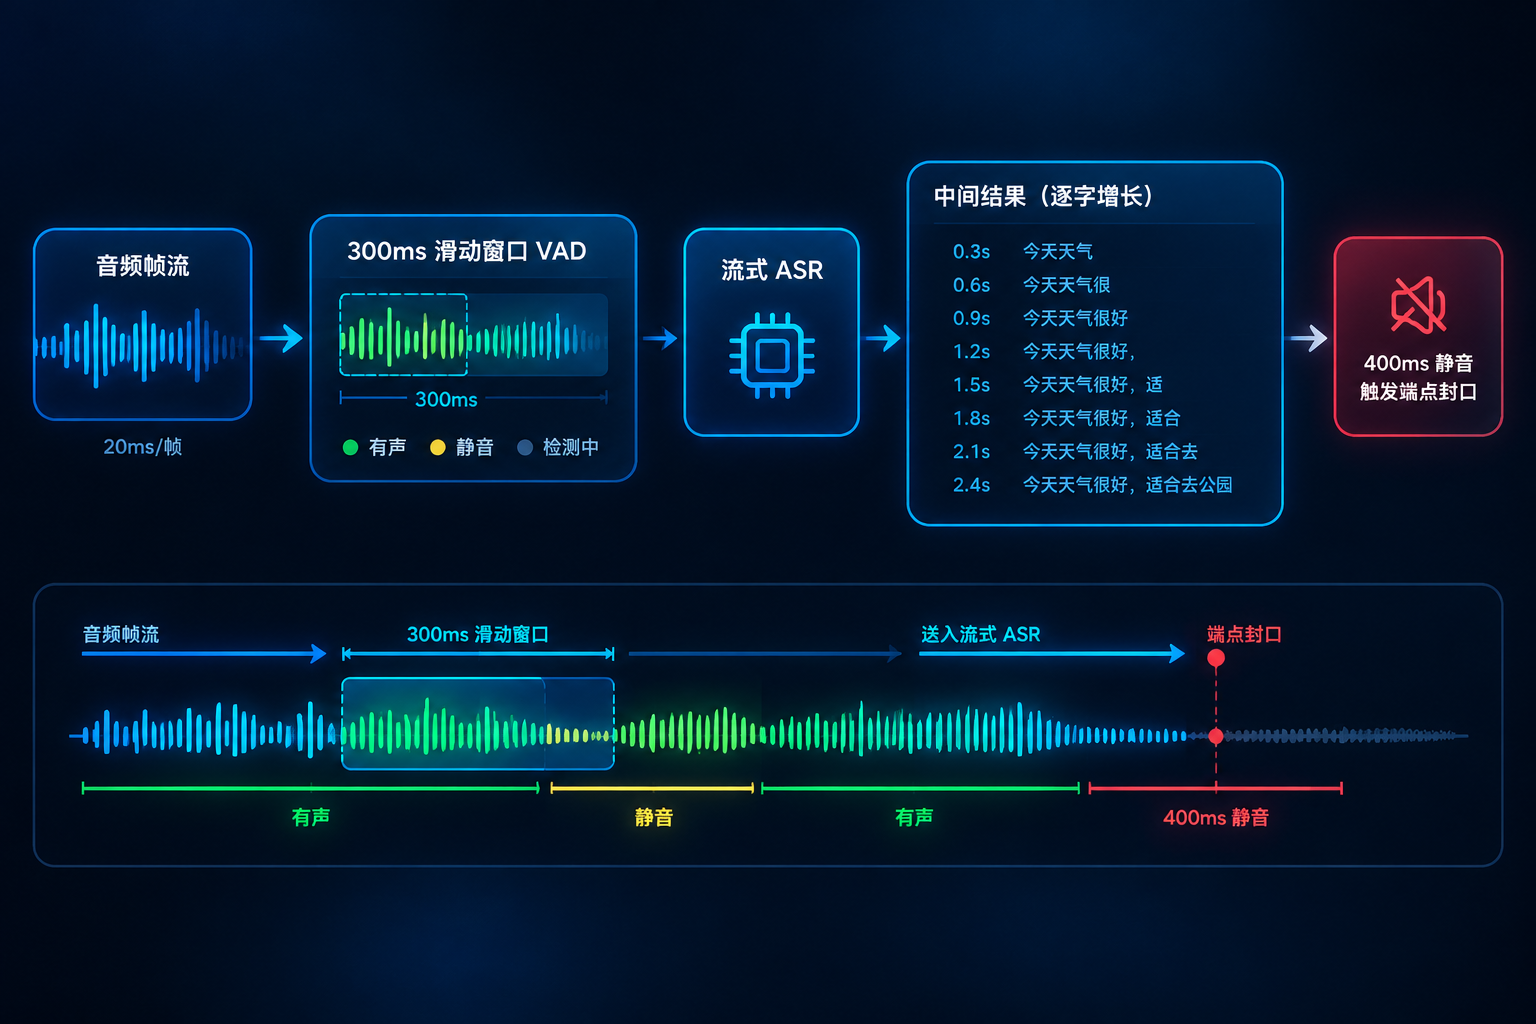
声音是连续的,识别却要按帧推进,这一步直接决定首字延迟:
python
import webrtcvad, collections

vad = webrtcvad.Vad(2)              # 0~3,越大越激进
buf = collections.deque(maxlen=15)  # 15 × 20ms = 300ms 滑窗

def feed(pcm_chunk: bytes, sample_rate=16000):
    '''按 20ms 帧喂入,返回是否检测到人声'''
    buf.append(pcm_chunk)
    if len(buf) < buf.maxlen:
        return False
    voiced = sum(vad.is_speech(f, sample_rate) for f in buf)
return voiced >= 10 # 过半帧有声才判为人声滑窗投票比单帧判断稳,可以避免空调噪声或键盘声触发假起点。
- 半句开跑:ASR 边听边吐中间结果,疑问主干一出现就可以预热下游,不必等端点封口。
- 尾静音封口:说完后保持 400~600ms 静音才认定一轮结束,太短会截断句尾。
核心结论: 首字延迟靠增量吐字,识别准确率靠尾静音兜底,两者分开调参。
四、打断控制:谁在什么时候闭嘴
用户插话时系统必须立刻让路,这需要一套明确的取消链路:
- 检测:播放期间麦克风保持采集,VAD 连续 2~3 帧有声即判为打断,先停 TTS 再清播放队列。
- 清场:丢弃 LLM 尚未消费的 token、清空合成队列,向会话注入一条 interrupt 事件。
- 接续:打断时已识别的半句话直接作为新一轮输入,避免系统把同一个问题回答两遍。
问题:打断慢 300ms,用户会觉得「它在抢话」。
治理:停播动作压到检测命中后 50ms 内完成,清场与重建分开做,避免卡住音频线程。
核心结论: 打断不是一个孤立事件,而是贯穿播放、生成、合成三层的统一取消链。
五、边听边生成:增量 LLM 与首 token
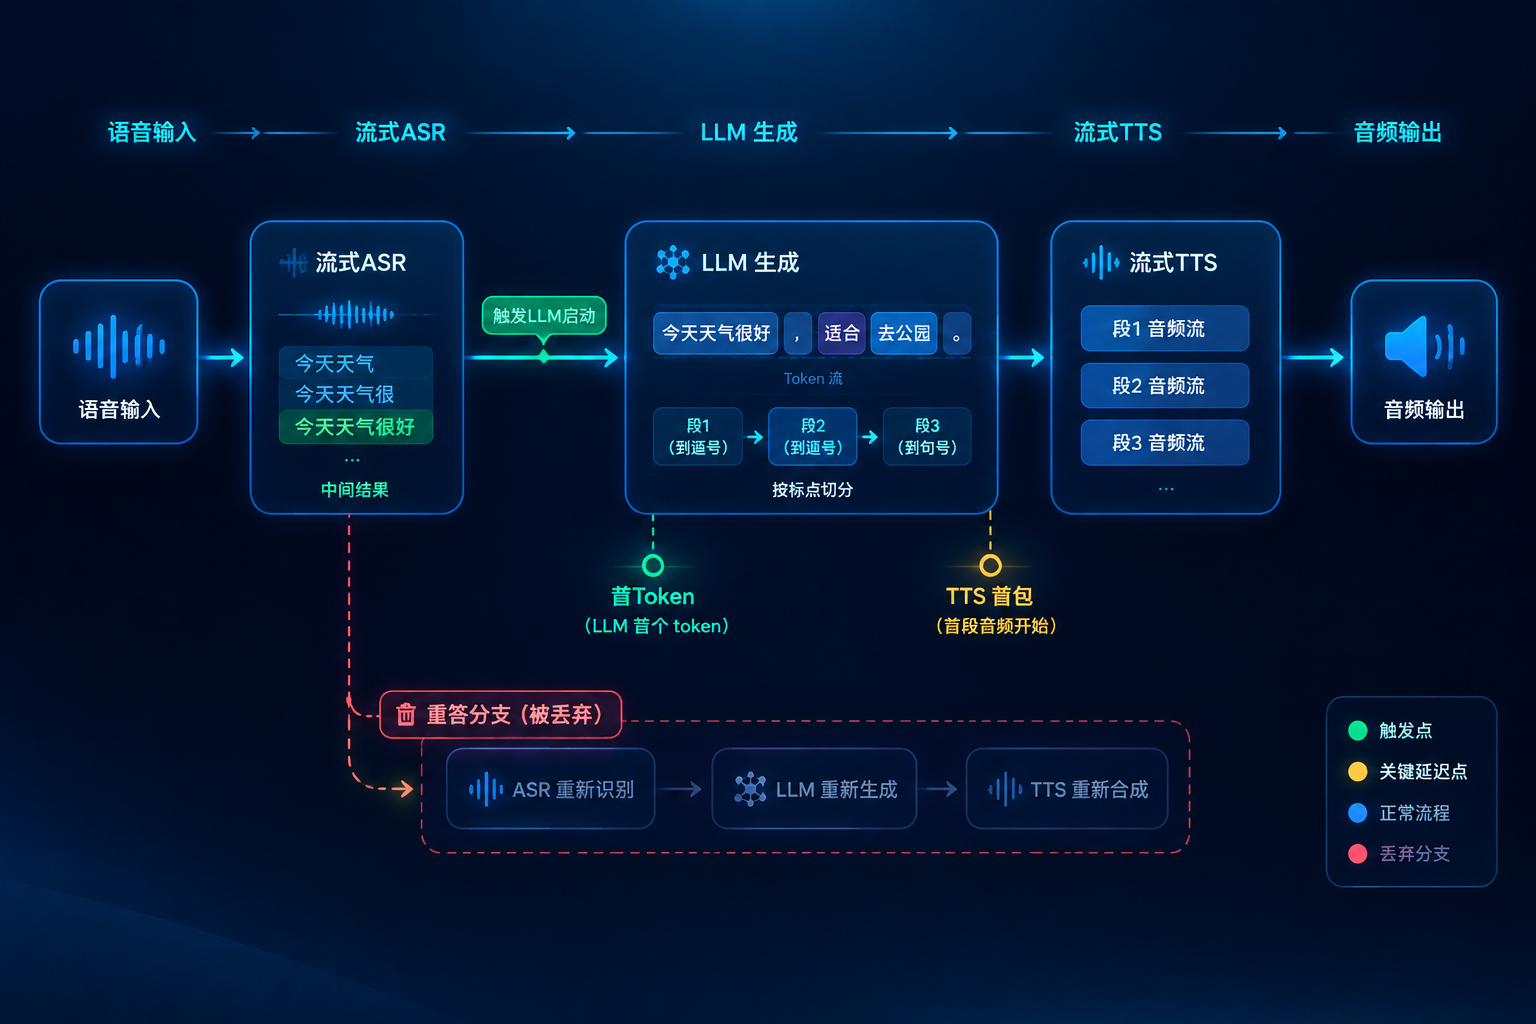
模型不必等整句话问完,配合 ASR 的中间结果可以提前起跑:
python
import openai
cli = openai.OpenAI(base_url='http://localhost:8000/v1', api_key='none')

def stream_reply(prompt):
    '''vLLM / Ollama 兼容接口,逐 token 吐出,便于边生成边送 TTS'''
    for chunk in cli.chat.completions.create(
        model='Qwen2.5-7B-Instruct',
        messages=[{'role': 'user', 'content': prompt}],
        stream=True, temperature=0.6, max_tokens=256,
    ):
        delta = chunk.choices[0].delta.content
        if delta:
            yield delta
逐 token 吐出的流式接口是全链路提速的枢纽,TTS 不必再等整段答案。
- 投机式首答:ASR 吐出问题主干就先启动生成,若后续词推翻语义则丢弃重来,代价远小于干等。
- 按句切分:token 流攒到标点就切一段送 TTS,既保自然断句又压首包延迟。
核心结论: 当首 token 延迟大于 TTS 首包延迟时,瓶颈一定在模型侧,应换量化或更小的模型。
六、流式 TTS:首包与断句的取舍
文本一到就要出声,合成侧的关键参数集中在首包和切分策略上:
| 参数 | 常见取值 | 影响 |
|---|---|---|
| 首包帧数 | 30~80 帧 | 出声快慢与首字吞字 |
| 断句粒度 | 逗号 / 句号 | 语义自然度与停顿感 |
| 输出采样率 | 24kHz | 音质与上行带宽 |
| 播放缓冲 | 100~200ms | 卡顿与延迟的取舍 |
- 先播后补:首包一到就开播,后续帧持续推入 jitter buffer,用小缓冲换低延迟。
- 禁止整段合成:等整段答案生成完再合成,会把 LLM 消耗的时间原封不动加回总延迟。
核心结论: TTS 的优化目标不是音质满分,而是在不吞字的前提下把首包压到 150ms 内。
七、延迟预算:把 800ms 拆到每一段
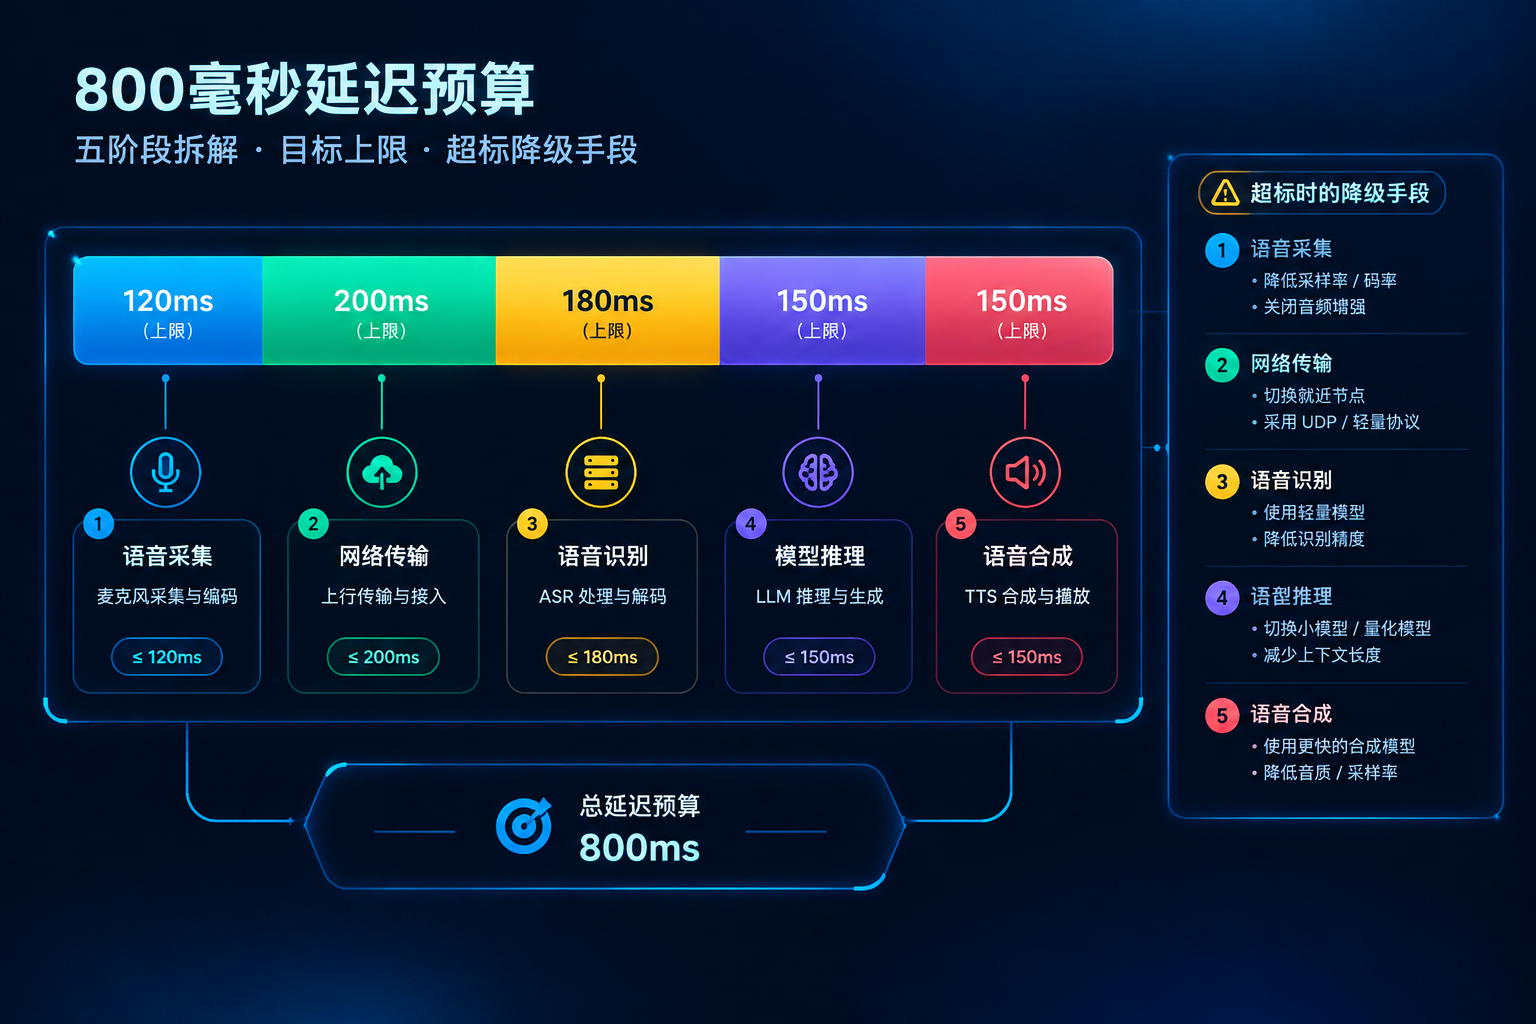
想要「像人」的响应,就必须给每一段定死上限:
| 阶段 | 目标上限 | 超标处理 |
|---|---|---|
| 采集 + VAD | ≤ 100ms | 缩小攒帧窗口 |
| ASR 首字 | ≤ 300ms | 换轻量模型或本地部署 |
| LLM 首 token | ≤ 250ms | int8 量化 + 投机解码 |
| TTS 首包 | ≤ 150ms | 换流式接口、调小首包 |
| 播放缓冲 | ≤ 100ms | 压低 jitter buffer |
- 先量再调:在每个模块边界打点,用 p95 而不是均值做判断依据。
- 超标即降级:任何一段超预算,立刻回退到本地小模型或预置话术,保住交互节奏。
核心结论: 总预算等于各段上限之和,分段治理才有抓手,笼统优化只会白费力气。
八、对话状态与轮次:谁在等谁
单段性能达标还不够,多段并发时的状态管理才是难点:
python
from enum import Enum

class State(Enum):
    LISTENING = 'listening'   # 收音,等待端点
    THINKING  = 'thinking'    # LLM 生成中
    SPEAKING  = 'speaking'    # TTS 播放中

def on_event(state, event):
    if state is State.SPEAKING and event == 'barge_in':
        return State.LISTENING       # 打断后回到听
    if state is State.LISTENING and event == 'endpoint':
        return State.THINKING        # 端点触发生成
    if state is State.THINKING and event == 'tts_first_chunk':
        return State.SPEAKING        # 首包到达即可播
return state三个状态加三个事件就能覆盖绝大多数对话场景,状态机跑在事件循环上,任何回调都不得阻塞音频线程。
- 每态都要有超时:thinking 超过 2 秒先插入「让我想想」这类填充音,掩盖等待感。
- 打断要先取消再转态:先取消下游任务,再把状态拨回 LISTENING,避免旧结果串台。
核心结论: 状态机是打断与并发的骨架,回调里一旦做同步阻塞,延迟预算立刻崩掉。
九、工程落地:部署、降级与监控
演示跑通只是起点,上线还要过并发与故障这一关:
bash
# 起一个 OpenAI 兼容的流式推理服务(单卡 24G 即可)
docker run --gpus all -p 8000:8000 vllm/vllm-openai \
  --model Qwen/Qwen2.5-7B-Instruct --max-model-len 2048

# 打点:统计流式接口的首字节耗时
curl -N http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen2.5-7B-Instruct","stream":true,"messages":[{"role":"user","content":"今天天气"}]}' \
  -w '\n首字节耗时:%{time_starttransfer}s\n'
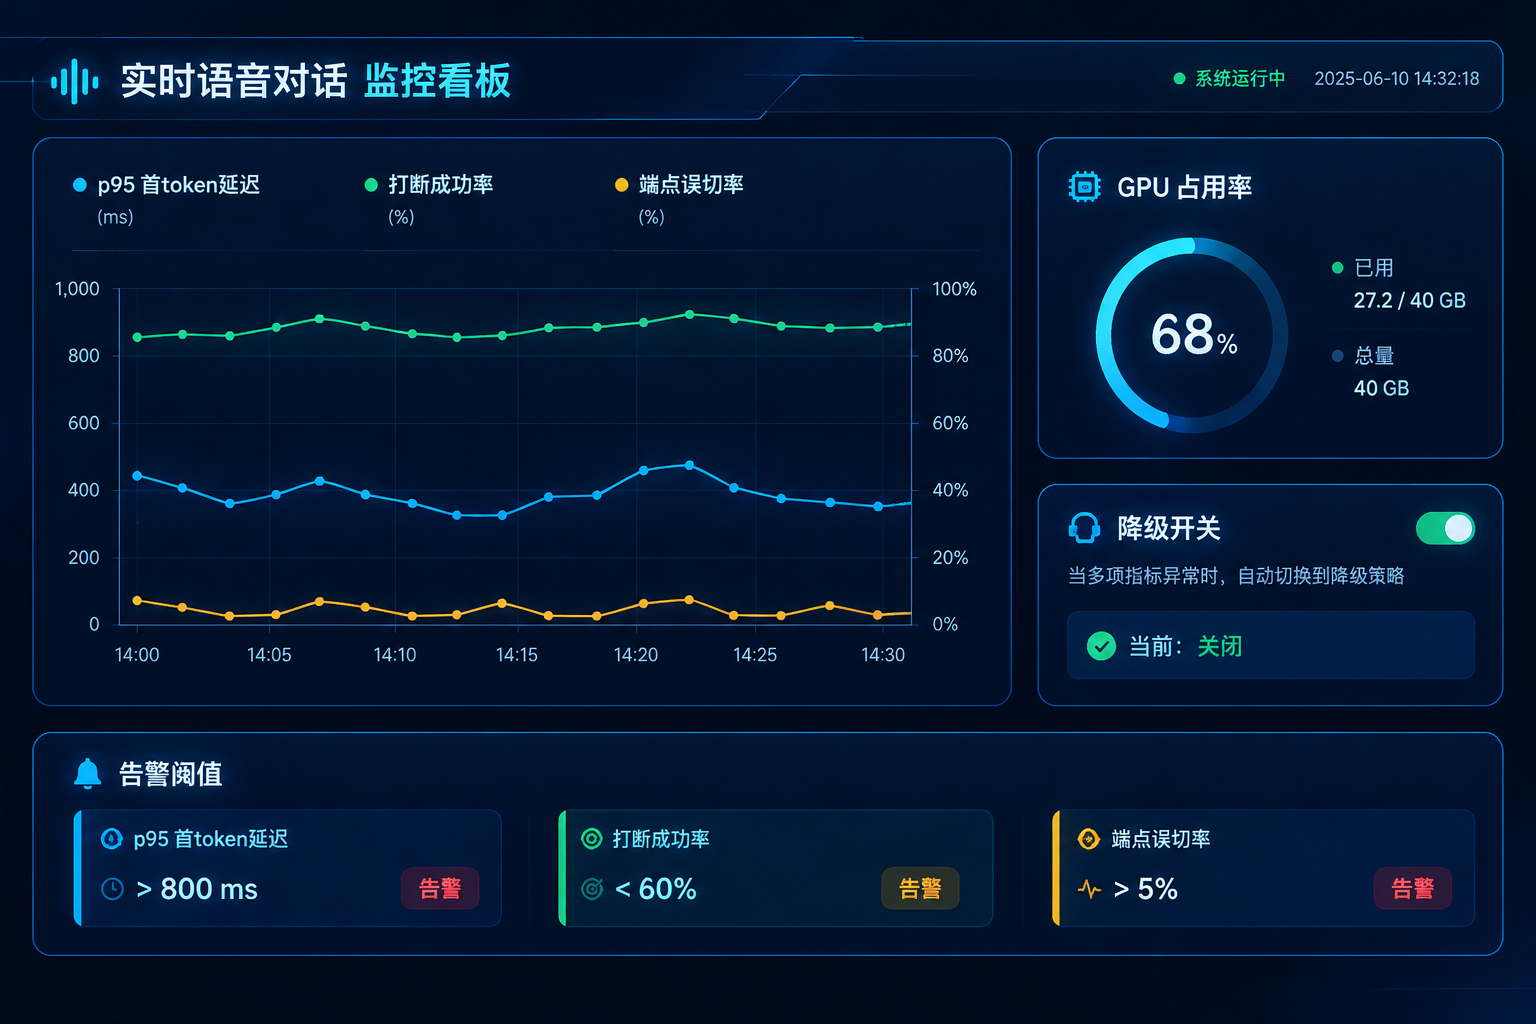
首字节耗时就是首 token 延迟的下界,压测时逐轮记录即可画出延迟分布。
- 降级链:GPU 吃紧时依次回退 int8 量化 → 本地 1.5B 小模型 → 预置话术,永远不让用户干等。
- 监控三指标:p95 首 token 延迟、打断成功率、端点误切率,三条曲线覆盖体验的主要面向。
核心结论: 没有降级预案的实时系统,等于把可用性押在最闲的那一张 GPU 上。
十、排错清单:常见症状与对应动作
线上出了问题,先按症状对表,再考虑动架构:
| 症状 | 可能原因 | 处理动作 |
|---|---|---|
| 出声慢但识别快 | TTS 首包过大 | 调小首包、换流式接口 |
| 系统老是抢话 | 尾静音阈值太短 | 提到 500ms 并加最小静音帧 |
| 中途突然重答 | 输出截断后整体重试 | 限制 max_tokens 并保留已播内容 |
| 打断完全没反应 | 播放时关了麦克风 | 打断期间保持采集链路开启 |
- 看分布不看均值:均值会掩盖偶发卡顿,p95 和 p99 才是用户的真实感受。
- 先换参再换架构:多数「架构问题」其实是尾静音、首包、缓冲三个参数没调好。
核心结论: 症状到动作的映射表,是实时语音系统最省时间的运维资产。
结语
实时语音对话的难度不在任何单一模型,而在于把采集、端点检测、识别、生成、合成、播放六段串成一条能随时被打断的流式链路,并为每一段定死延迟上限。分段打点、按预算治理、超限即降级,这三件事做完,「边听边答」就从玄学变成了可验证的工程。
从今天起,你可以先给自己现有的助手测一条端到端时间轴,找到最贵的那一段,再按文中的参数表逐个收窄。
低延迟不是调出来的,是按预算一段一段算出来的。