论文:GTR: Gated Token Recurrence for Efficient Dense Prediction
机构:滴滴国际业务集团、Intellindust AI Lab、中科院自动化所、港科大(广州)
一、背景
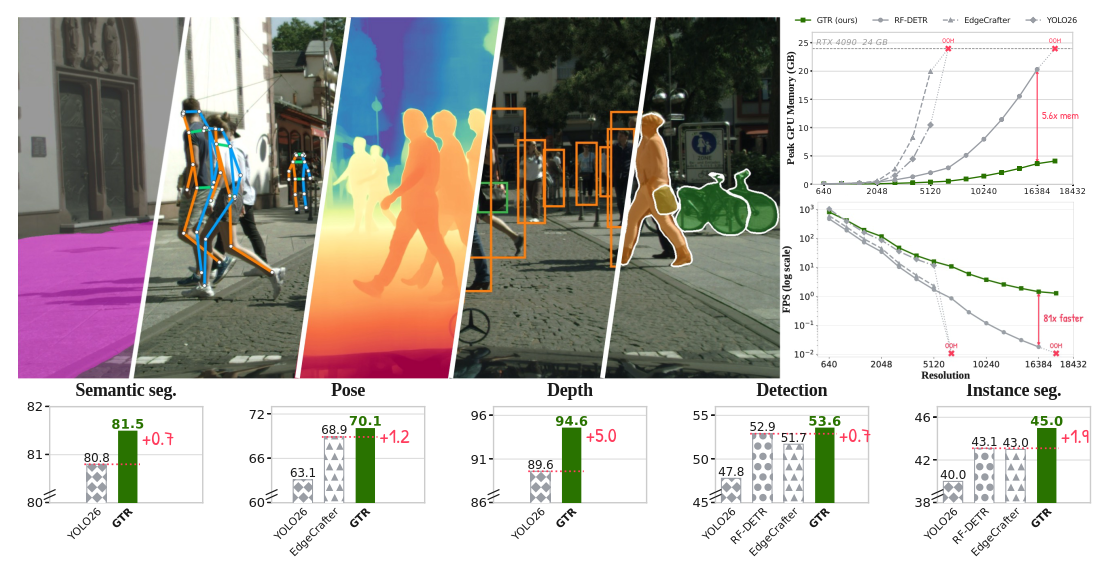
稠密预测(Dense Prediction)是计算机视觉的核心大类,包含目标检测、实例分割、语义分割、人体姿态估计、旋转目标检测、单目深度估计六大任务,自动驾驶、机器人、AR、3D重建全部依赖这套技术。
传统Vision Transformer依靠Softmax全局自注意力 获取全局上下文,但它的计算复杂度是token数量平方级。
- 图片分辨率越高,计算量、显存占用爆炸式上涨;
- 高分辨率图像在车载、嵌入式边缘硬件运行时,延迟居高不下;
- 很多方案为了速度,只能降低输入分辨率,牺牲小物体、细节识别精度。
线性注意力、递归状态空间模型(Mamba等)提供了解决思路,但现存方案仍存在短板:要么效果打折扣,蒸馏流程复杂,很难同时适配多任务,边缘硬件部署优化难度大。
GTR(Gated Token Recurrence,门控Token递归)应运而生:完全抛弃全局Softmax注意力,使用门控线性注意力GLA,实现线性复杂度,一套骨干网络,支持6种稠密视觉任务,在车载硬件上实现毫秒级推理,兼顾精度、速度、显存效率。
二、GTR核心技术创新
1. 门控Token递归主干网络
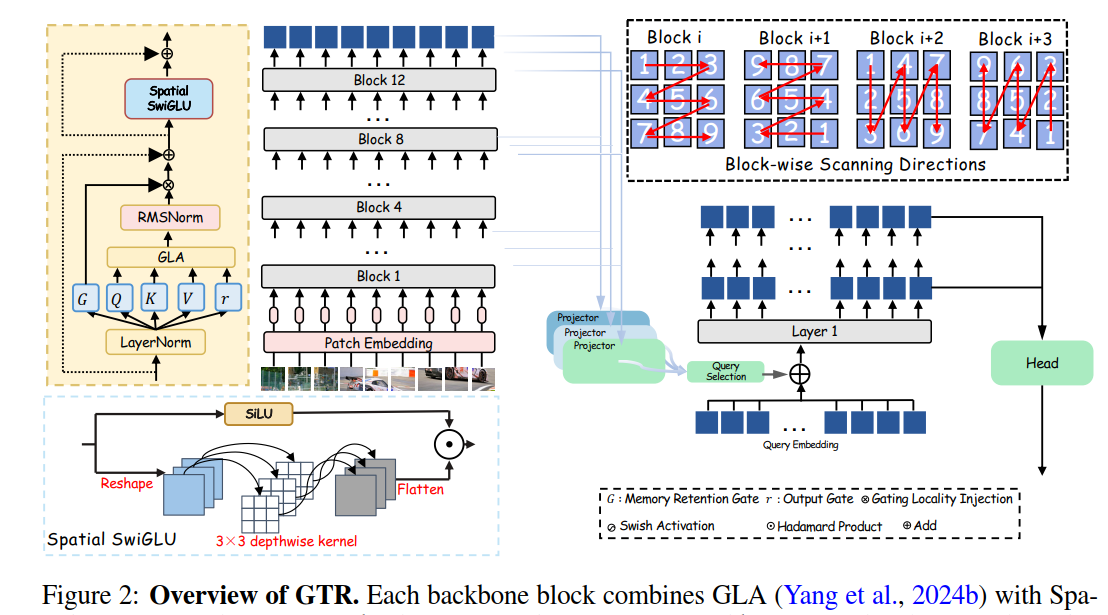
GTR主干一共12层,全程维持固定stride‑16的patch网格,不做分层窗口切分。两大核心模块配合,同时搞定全局长距离依赖+局部细节特征:
- 四方向交替扫描的门控线性注意力GLA
每一个block只执行一个方向的序列扫描,12个块循环切换4个扫描方向:从左→右、右→左、上→下、下→上。通过递归状态累积整张图全局信息,计算复杂度随token数量线性增长,而不是平方增长。
简单理解:模型轮流从四个方向"扫视整张图片",逐步把全图信息聚合起来,不需要传统注意力计算两两之间相关性。
- Spatial‑SwiGLU空间增强模块(关键)
用3×3深度卷积嵌入SwiGLU前馈网络,做局部邻域特征混合,完全抛弃可学习位置编码。消融实验证实:局部空间混合模块远比位置编码重要;如果去掉该模块,精度直接暴跌接近10个点。
骨干网络输出第4、8、12层的特征,构建轻量化多尺度特征金字塔,接入DETR风格解码器,就可以适配不同下游任务。GTR提供S/M/L/X四种尺寸,参数从12.1M到46.5M,方便不同算力平台选型。
2.极简蒸馏策略:仅对齐最后一层特征
GTR选用DINOv3作为教师模型。和其他复杂蒸馏方案不同,GTR只对齐教师与学生网络的最后一层patch特征,仅使用一个线性投影 + 平方L2损失,不需要中间层监督、不需要mask预测,蒸馏流程极度简单。
消融对比:
- 从零训练:COCO检测AP仅31.1;
- ViT‑Linearizer多阶段蒸馏:50.0;
- ViT‑AdaLA多层对齐蒸馏:48.2;
- GTR仅最后一层对齐:50.7,效果最优,实现"少即是多"。
通俗讲:不用强迫学生模仿老师每一层思考过程,只要求学生最终输出的特征和老师对齐,就能学到强大表征,训练成本大幅降低。
3. 面向硬件的分块CUDA算子
原生GLA算子在高token数时速度不理想,作者专门开发分块(chunk‑wise)CUDA算子:
- 所有块内摘要并行计算,仅边界状态做轻量串行扫描;
- 在RTX4090测试,1600个token时速度比FLA‑v0.5.0快4倍;16384 token高分辨率场景加速可达6.4倍;
- 训练依旧使用原生FLA算子,推理启用定制算子,不损失精度,纯粹优化运行效率。
三、实验对比验证
1. 目标检测(COCO数据集)
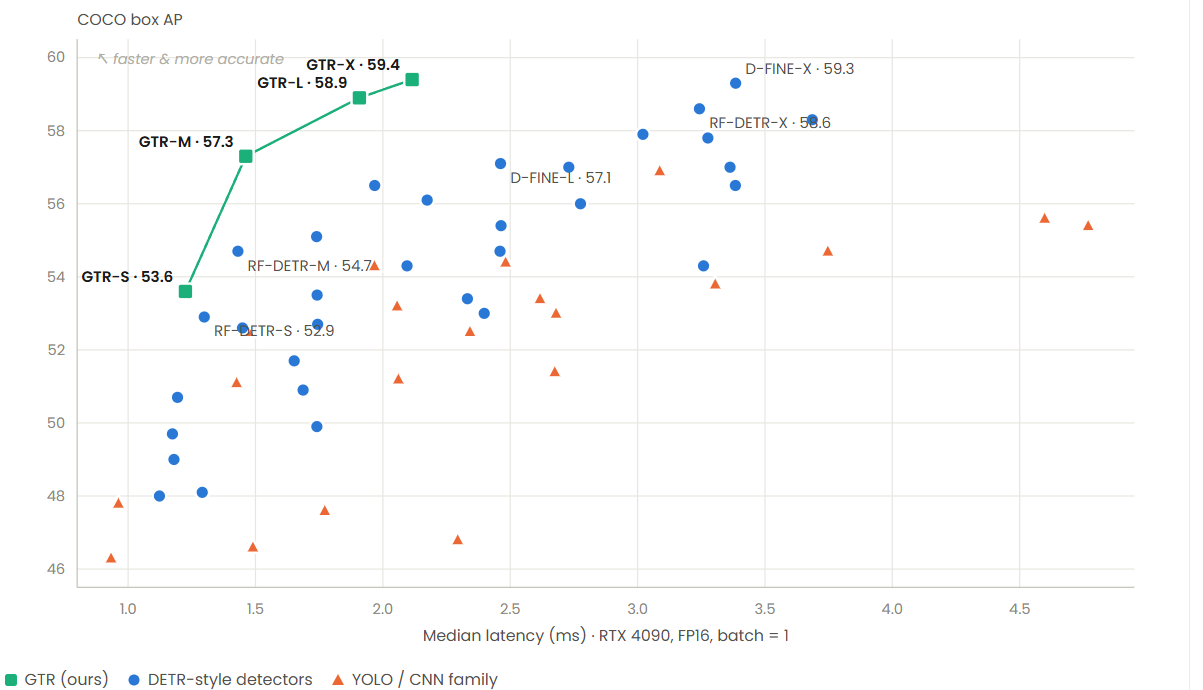
经过Objects365预训练:
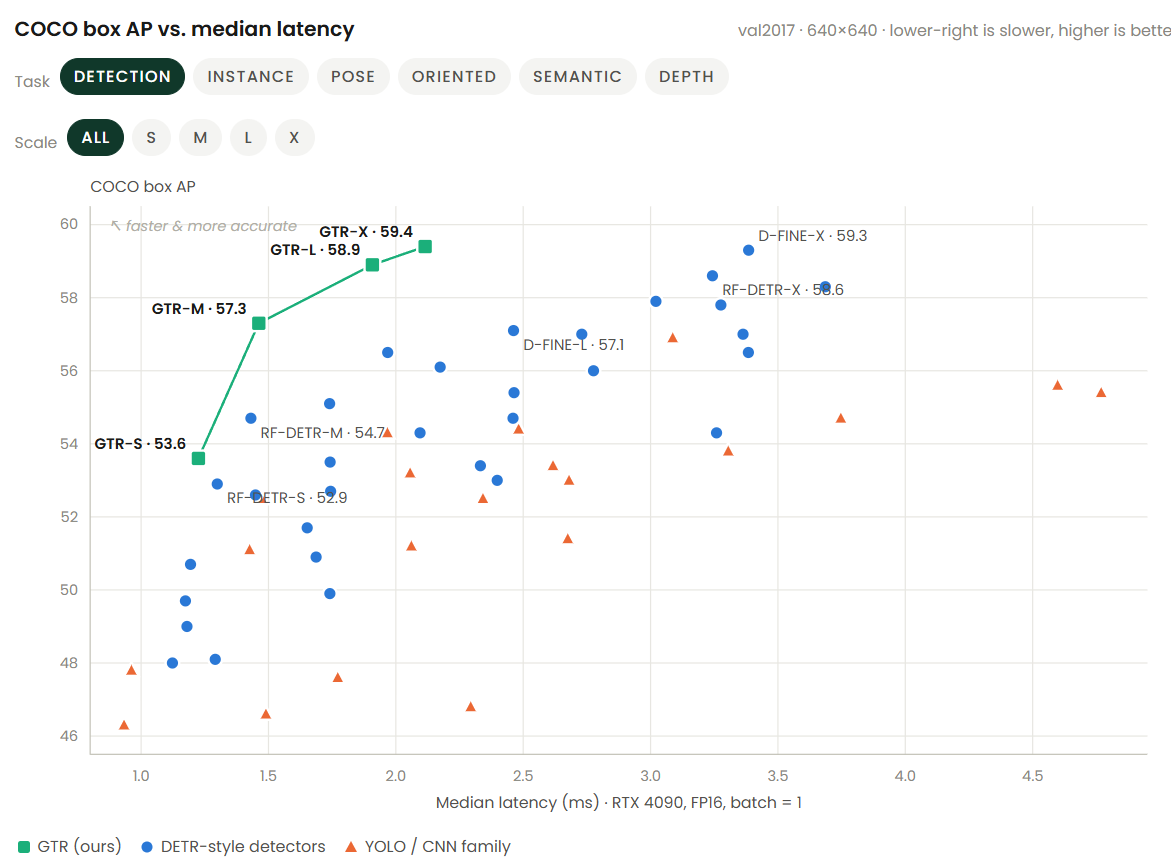
- GTR‑S:AP53.6;GTR‑M:57.3;GTR‑L:58.9;GTR‑X:59.4;
- RTX4090 FP16编译推理,GTR‑L单图延迟仅1.908ms,兼顾高精度与极低延迟。
高分辨率扩展性极强:GTR‑S从640²提升至1280²输入,小物体AP从36.4提升至42.4;token数量翻4倍,延迟仅提升2.06倍,显存增长平缓。传统Transformer注意力方案延迟、显存会暴涨数倍。
重点发现:把3个GLA块替换回传统softmax注意力,精度几乎没有提升,但是延迟上涨约10%。证明在这套框架中,softmax注意力属于"负收益",不需要它。
2. 一套主干迁移六大稠密任务
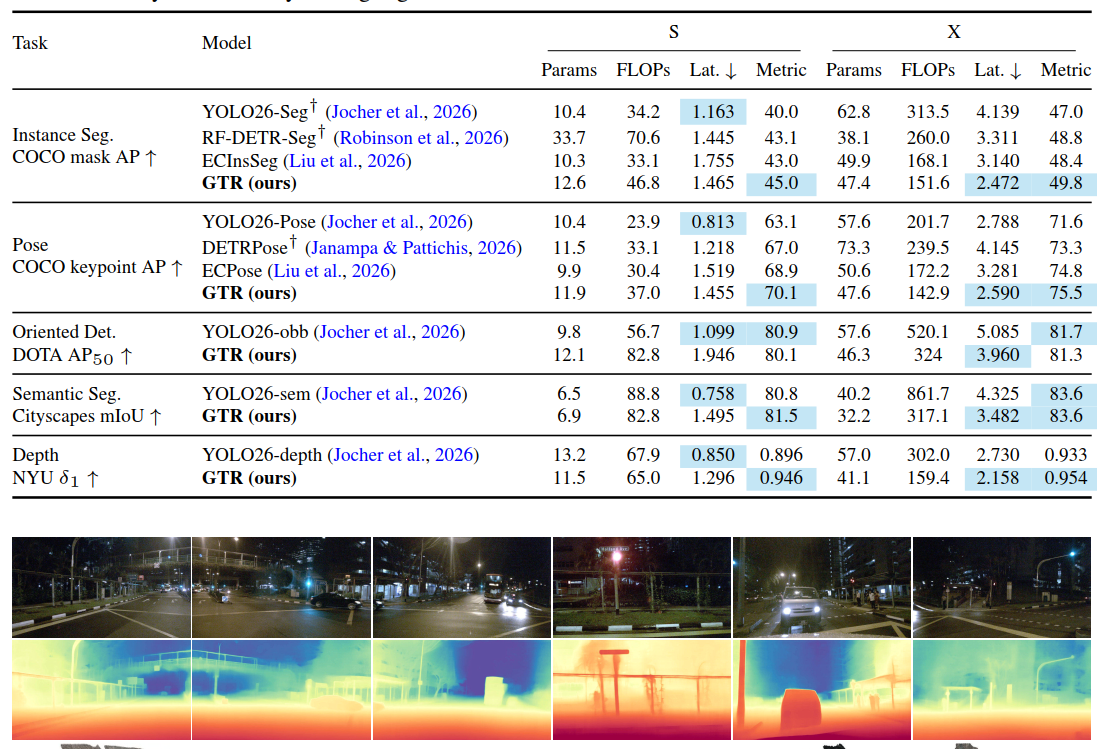
同一个GTR骨干,只更换任务头,不用改动主干结构,完成全部6类任务评测:
-
目标检测;
-
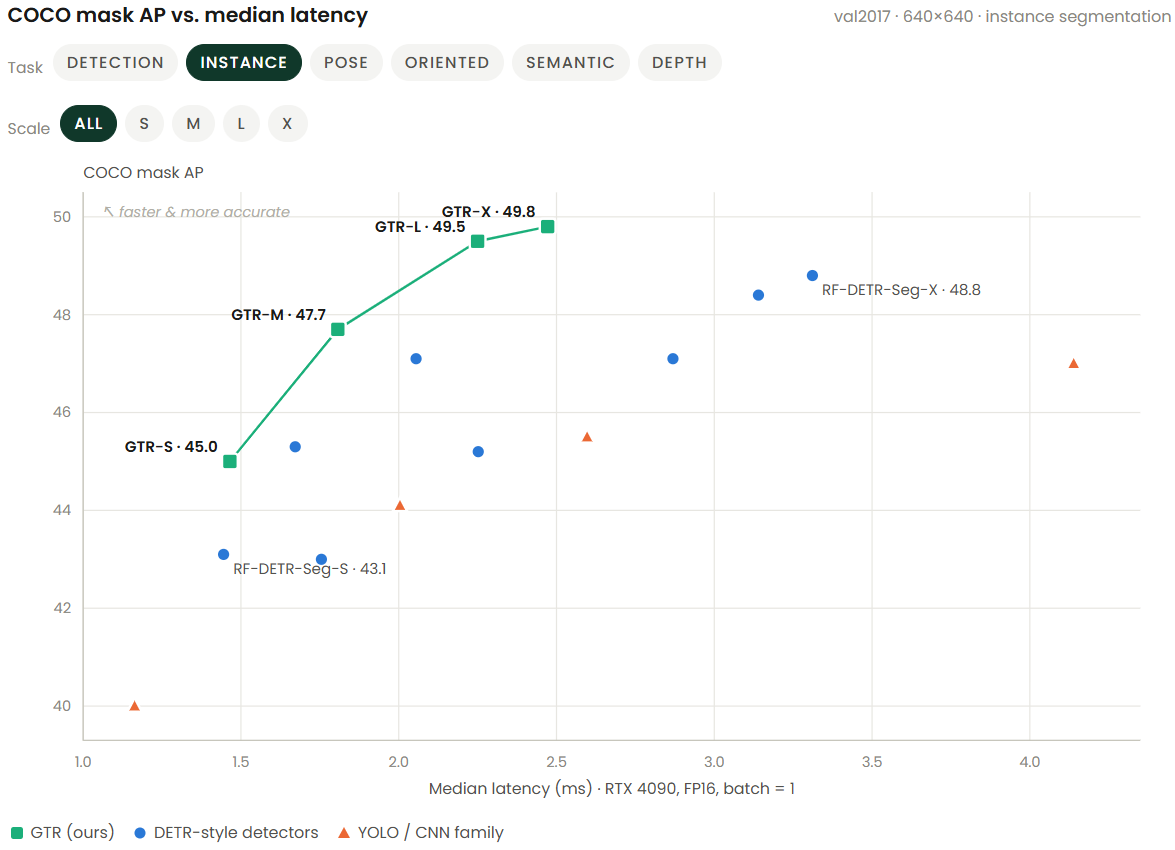
实例分割;
-
人体姿态估计;
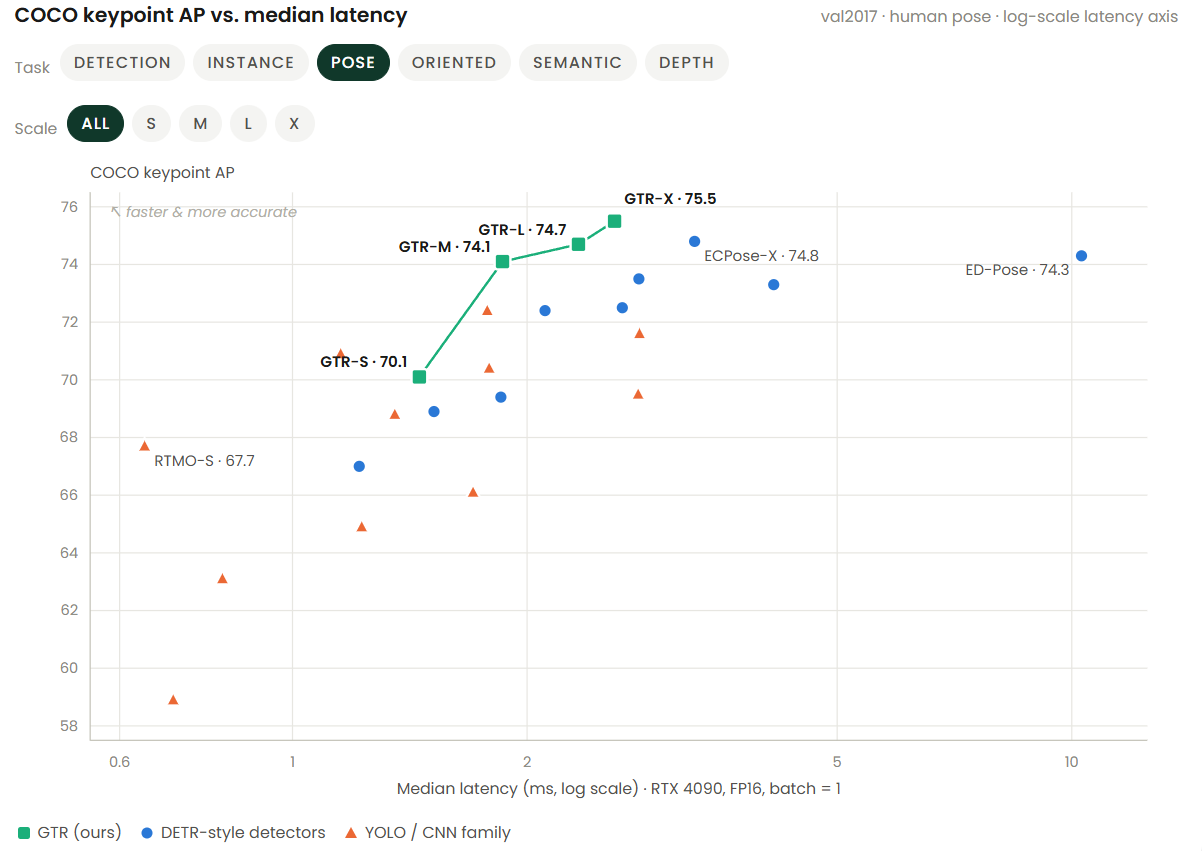
-
旋转目标检测(遥感图像);
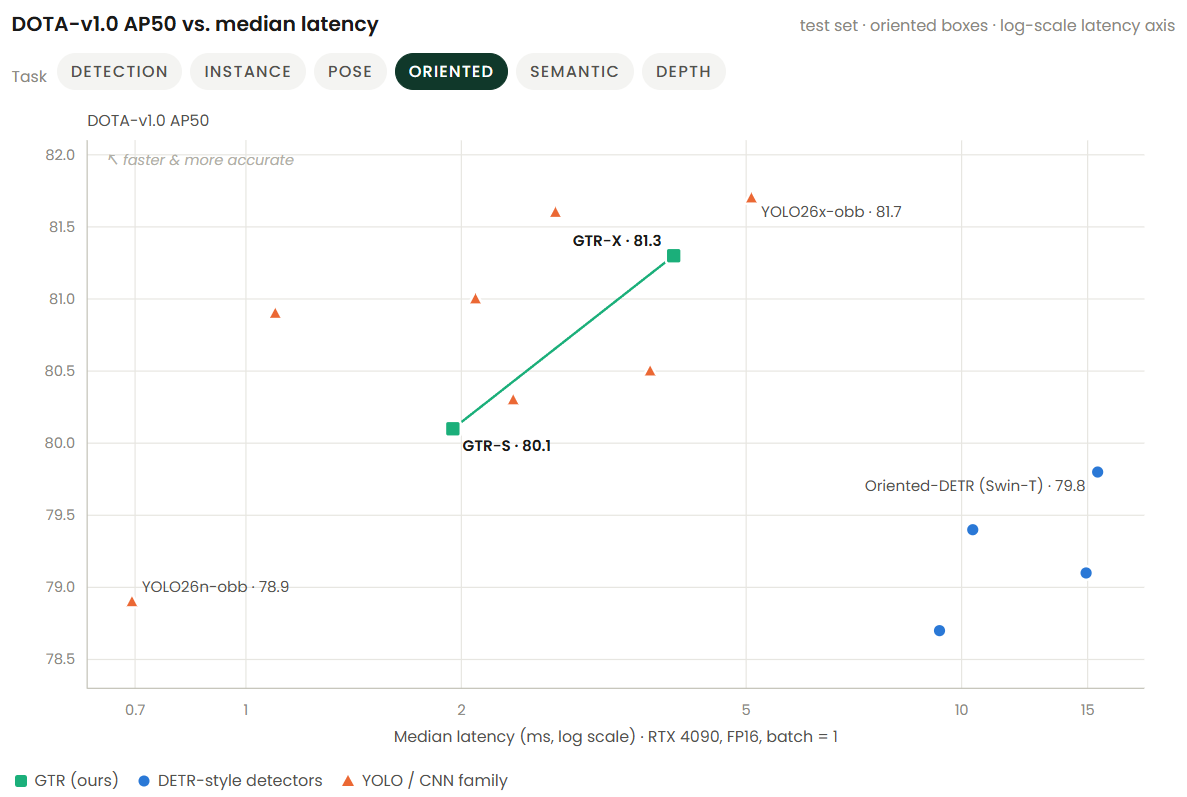
-
语义分割;
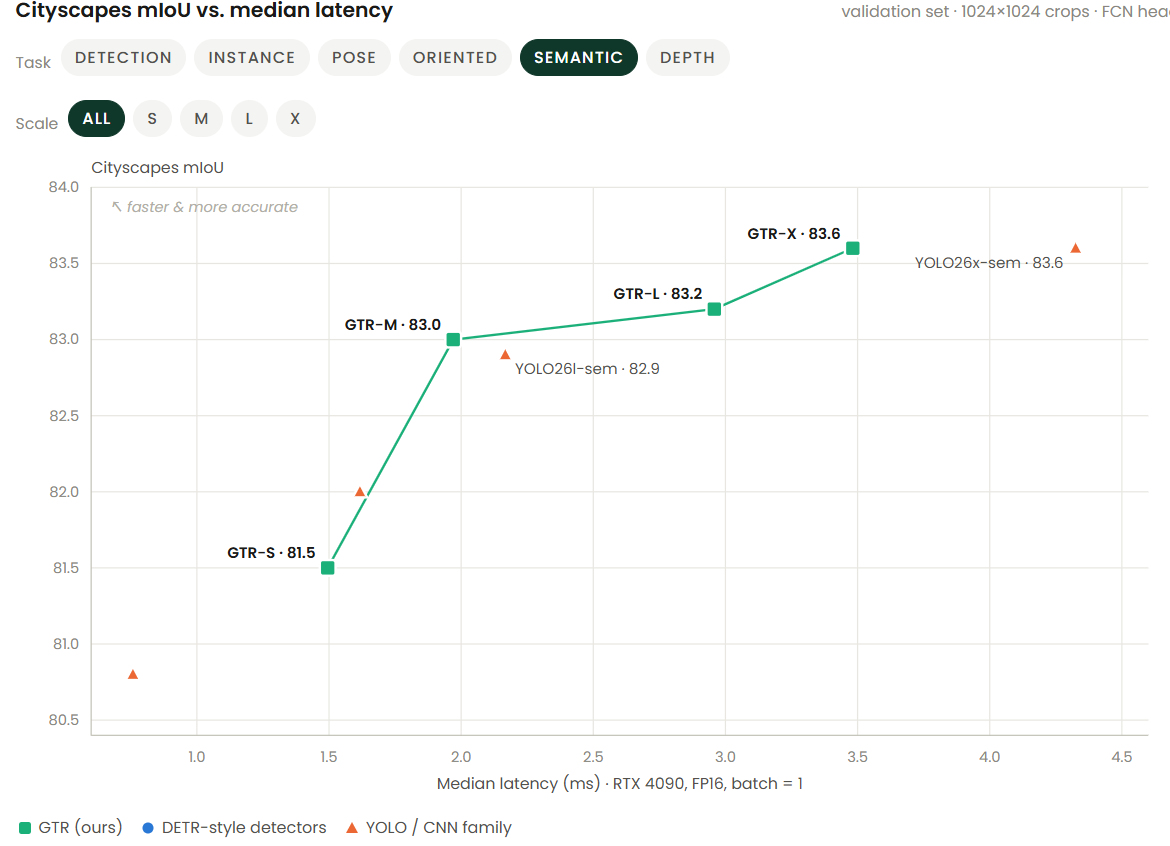
-
单目深度估计 :室内/室外场景零样本深度预测,可以做多视图3D场景重建。
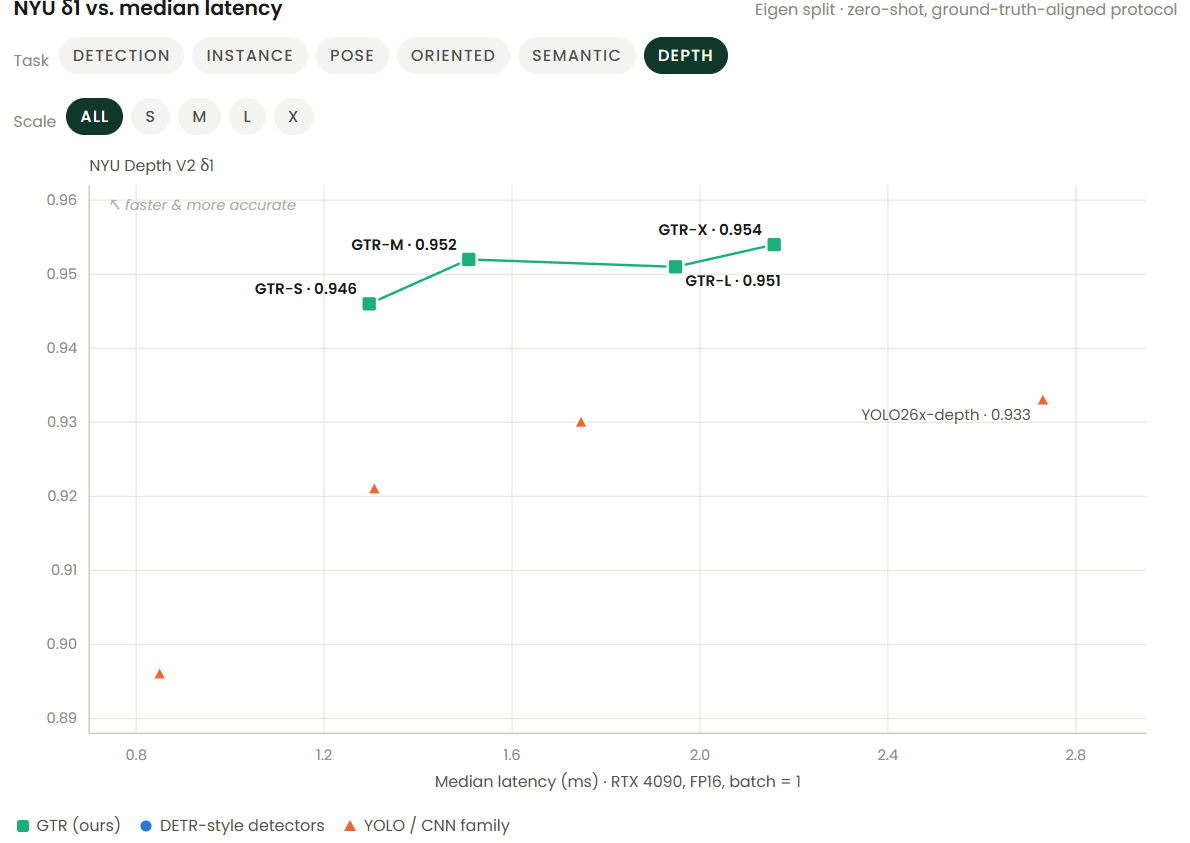
3. 车载边缘硬件 DRIVE AGX Thor TensorRT部署
全部模型完成TensorRT部署,FP16推理,单张图片推理中位数延迟 2.282 ~ 8.769ms,推理输出与PyTorch原始输出余弦相似度≥0.9989,精度几乎无损。
- GTR‑S检测任务仅2.282ms;
- 大分辨率旋转目标检测(1024×1024)最大延迟8.769ms;
- 深度估计GTR‑S仅2.675ms。
这意味着在车载自动驾驶芯片,高分辨率输入条件下,6类复杂视觉任务都可以做到实时运行。
四、对比同类工作,现实落地价值
- 多任务统一骨干:自动驾驶设备经常需要同时跑检测、分割、姿态、深度。以往需要训练、存储、加载多个独立模型;GTR只需要一份主干权重,更换任务头,节省存储、内存开销,对车载/机器人嵌入式设备非常友好。
- 高分辨率友好:安防、遥感、车载需要处理大分辨率图片,GTR线性复杂度,分辨率提升不会造成算力爆炸,可以保留小目标细节。
- 蒸馏简单,训练成本低:不需要复杂多层对齐,降低科研与工业调参成本。
- 硬件友好,算子原生适配TensorRT,不需要自定义特殊算子,工业产品落地门槛低。
五、局限与未来方向
- 目前重点面向稠密预测任务;文本‑图像跨模态等其他任务还未验证;
- 递归扫描机制是因果式聚合,依赖Spatial‑SwiGLU弥补局部交互;局部模块失效会带来性能断崖下跌;
- 视频时序方向还未充分探索,未来可以拓展视频目标跟踪、视频深度估计等场景。
六、总结
传统Transformer依靠softmax全局注意力取得强大效果,但平方复杂度成为高分辨率、边缘部署的硬瓶颈。
GTR证明:纯递归门控线性注意力,完全可以替代softmax全局注意力。
依靠四方向交替扫描+Spatial‑SwiGLU局部混合,搭配极简的最终特征蒸馏,一个骨干网络就打通目标检测、分割、姿态、旋转检测、语义分割、单目深度估计六大稠密视觉任务。在服务器GPU上极速推理,并且可以直接部署到车载边缘芯片,毫秒级完成高分辨率稠密预测,为自动驾驶、机器人、遥感视觉提供了新的高效基础骨干选择。
论文与源码可自行获取: