企业在做数据集成的时候,习惯性地把关系型数据库里的业务表当作"数据"的全部。订单表、用户表、商品表,这些结构化数据有统一的采集工具、统一的调度平台、统一的运维手段,做起来轻车熟路。
实际上,企业拥有的数据里,文本、图像、音视频、日志文件、PDF等半结构化和非结构化数据占了数据总量的80%以上,长期没有被纳入统一的开发管理体系。这些数据分散存储在文件服务器、对象存储、FTP等不同介质里,采集方式也各不相同------结构化数据存在关系型数据库里,非结构化数据存在文件服务器或对象存储中,两类数据从存储起点就没有走同一条路径。
这种分裂不只是存储层面的问题,开发环节同样割裂。企业里通常是结构化数据走离线、实时开发平台,非结构化数据走另一套专门的算法开发平台,两边数据彼此难以互通,处理非结构化数据还需要专门的算法人员,普通数据开发人员上手门槛很高。当业务需要把一份合同PDF的内容和一张订单表关联起来分析时,往往要跨两三个系统手动倒腾,效率可想而知。
统一采集能否覆盖非结构化数据?
数据集成工具的能力边界,很大程度上决定了企业能管到多少数据资产。如果一个平台只支持关系型数据库、大数据存储这类结构化数据源,那企业实际能管理的数据资产可能不到20%。也就是说,只要数据集成环节没有把非结构化数据接进来,后面的开发、治理、应用都无从谈起。
数栈多模态数据智能中台的离线开发模块BatchWorks,是数据中台里的基座,包含全链路的数据集成、数据开发、周期调度、任务运维、监控告警等功能。面向多模态场景,平台支持非结构化数据同步和多模态数据处理,用户可以在同一工作流中混合编排SQL任务与算子任务,实现结构化与非结构化数据的协同处理和运维。
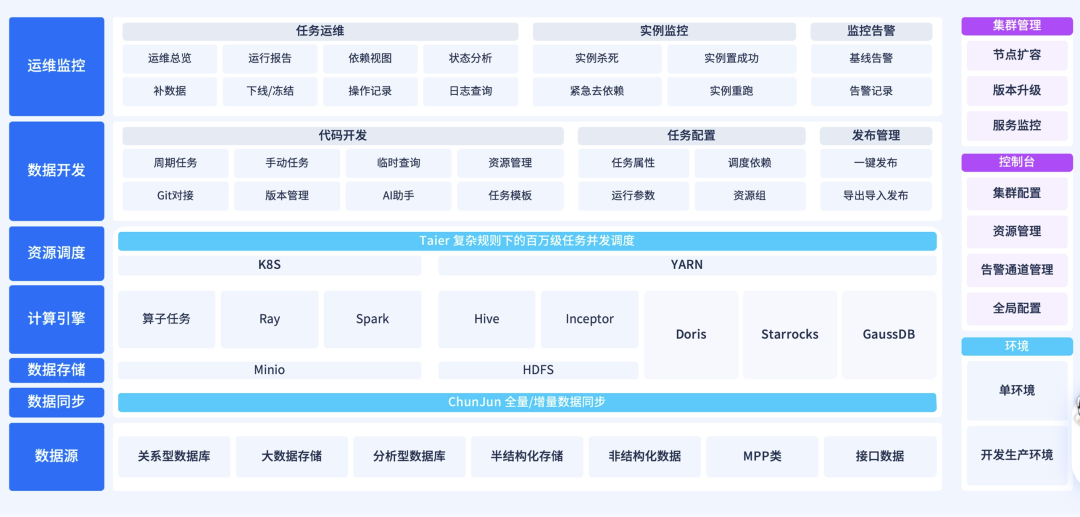
这意味着,一份文档、一张图片,可以和一张业务表走同一套采集、调度、运维流程,不需要为非结构化数据单独搭一套系统。
非结构化数据怎么接进来
在数据集成环节,BatchWorks支持MinIO、FTP等非结构化数据源接入,统一汇聚至内部对象存储,并在同步过程中完成内容解析与向量化处理。
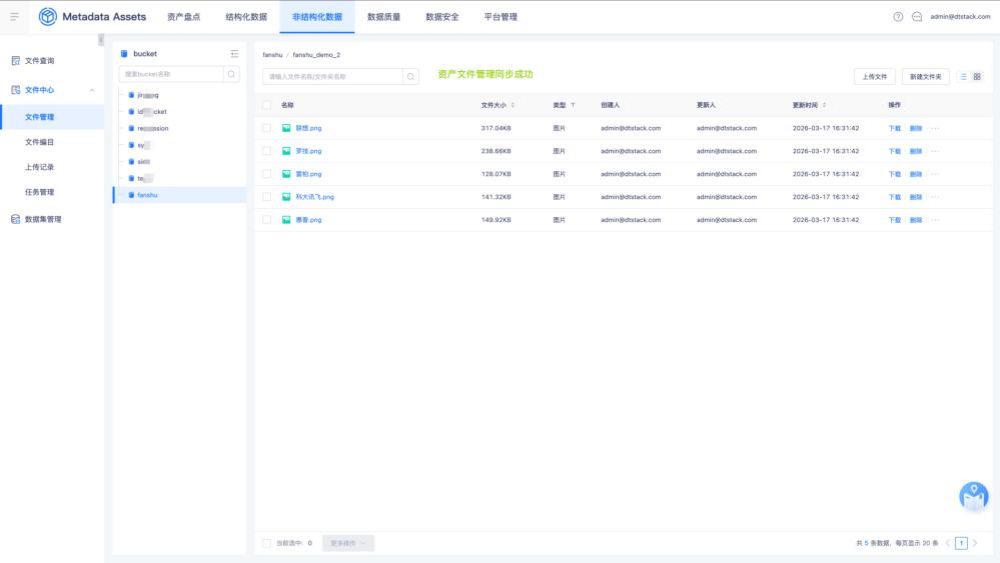
具体到操作流程,数据同步任务的配置方式和结构化数据同步基本一致:选择数据源、配置文件匹配规则(按文件名称或正则匹配)、设置是否保留历史文件版本,再进入高级配置阶段完成路径映射和文件更新策略的设定。整个配置过程走的是同一套向导式界面,不需要额外学习一套新的操作逻辑。
同步的目标端是平台内部的MinIO存储底座。离线MinIO数据同步任务完成后,非结构化数据会同步到资产文件管理模块中,更新或写入到指定的数据集里。也就是说,数据同步这一步做完,文件不是简单地"搬"到了另一个存储位置,而是同时完成了向资产目录的注册,后续可以在资产管理界面里直接查看、管理这批文件。
同步完的数据怎么处理
文档解析、图片处理、音视频转码这类操作,通常需要专门的算法能力支撑。数栈BatchWorks基于Data-Juicer框架和Daft框架构建算子任务,集成了丰富的算子库,支持对文本、图片、音视频等数据进行抽取、转换与分析,同时支持按需配置自定义算子,扩展处理能力。算子任务开发同时支持向导模式和脚本模式,向导模式下配置好的处理流程可以灵活转换成脚本模式,方便有代码能力的开发人员做进一步调整。
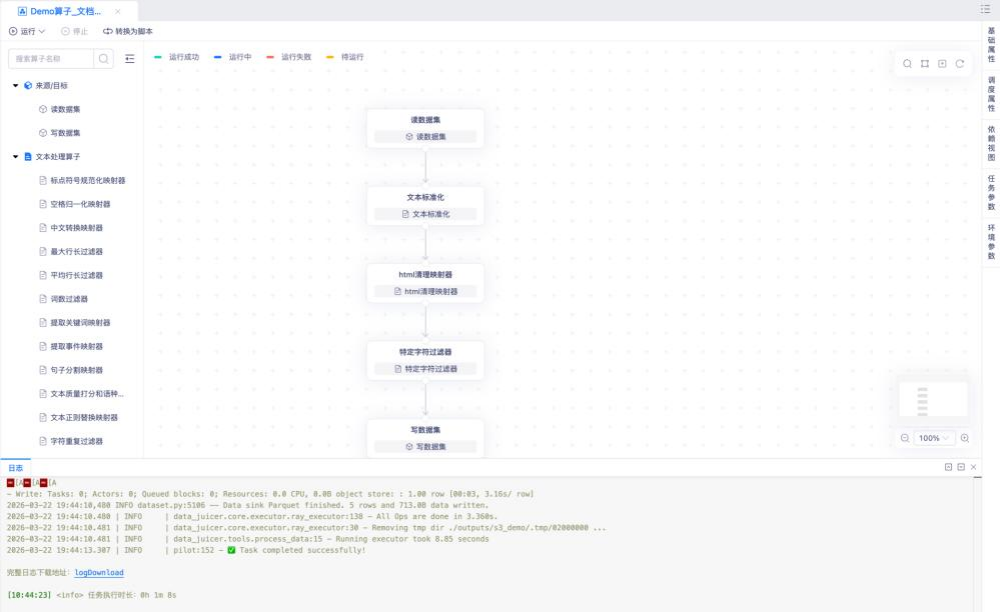
一个典型的算子处理流程,会把读数据集、文本标准化、html清理、特定字符过滤、写数据集这几个步骤串联起来,形成一条从原始文件到结构化处理结果的流水线。用户既可以用拖拽的方式把这些处理步骤组合起来,也可以直接写脚本控制整个流程。
更关键的一点是,SQL任务和算子任务可以出现在同一个工作流里。也就是说,一条业务流程里,前面几步是结构化数据的SQL清洗,中间插入非结构化数据的文档解析或图片处理算子,最后再汇总输出,整个链路不需要跳出BatchWorks这一个平台去完成。
处理完的任务怎么运维
数据处理流程能稳定跑起来,运维能力是绕不开的一环。非结构化数据处理往往涉及更复杂的计算逻辑,任务失败、超时的情况比结构化任务更容易出现,如果没有配套的运维和告警机制,问题很难被及时发现。
在任务与实例管理方面,BatchWorks支持查看算子任务的运行状态、执行日志、历史实例及运行详情,支持手动重跑、终止、补数据等操作,确保任务异常时可以快速恢复。在告警方面,平台支持配置任务失败、超时等告警规则,通过邮件、短信等方式及时通知运维人员,实现异常事件的快速响应。
这套运维体系和结构化数据任务共用同一套运维总览、周期任务管理、监控告警配置。运维人员不需要在两套运维界面之间切换,查看结构化任务的运行状态和排查算子任务的报错日志,走的是同一个入口。
处理结果沉淀下来能不能复用
数据处理不是一次性的工作。同一份文档解析逻辑、同一套图片处理算子,如果每次遇到类似需求都要重新开发一遍,成本会持续累积。
针对这个问题,平台支持自定义算子的开发、上传与复用。用户可以根据业务需求,基于Daft等分布式框架开发专属算子,上传至算子广场后,就可以在工作流中像使用内置算子一样进行编排调用。算子支持文档说明集成,方便团队内部共享使用。企业在处理非结构化数据的过程中积累的经验,可以沉淀成可复用的算子资产,避免同类型的处理逻辑被反复开发。
这套机制解决的是企业个性化数据处理场景难以被标准算子库覆盖的问题------内置算子覆盖不到的处理逻辑,团队可以自行补充,并且这些补充是可以被复用和传承的,而不是散落在某个开发人员的个人脚本里。
回过头看这条链路,外部非结构化数据通过MinIO、FTP等方式接入,同步到内部对象存储的同时完成资产注册;进入算子工作流后,可以和SQL任务混合编排,完成文本解析、图片处理等操作;处理过程由统一的任务运维和告警体系保障稳定运行;处理经验可以沉淀为自定义算子供团队复用。
非结构化数据没有被单独拎出去走一套特殊流程,而是复用了平台原本给结构化数据准备的采集、调度、运维能力,只是在数据处理环节增加了算子任务这一种任务类型。对企业来说,这意味着原有的数据开发人员不需要额外学习一整套新工具,就可以承接一部分非结构化数据处理工作,非结构化数据处理的门槛因此被拉低了一些。