前言
这一篇作为上篇,我们从最底层的冯诺依曼体系结构讲起,一步步深入到操作系统的定位、进程的本质、PCB 的内部结构、fork 创建进程的底层原理,以及非常重要的进程状态、僵尸进程和孤儿进程。下篇我们再讲进程优先级、调度算法、环境变量和虚拟地址空间。
希望这篇文章既能帮到正在学习的同学,也能方便我自己以后复习。如果有理解不对的地方,欢迎在评论区指正。
一、冯诺依曼体系结构 ------ 一切的起点
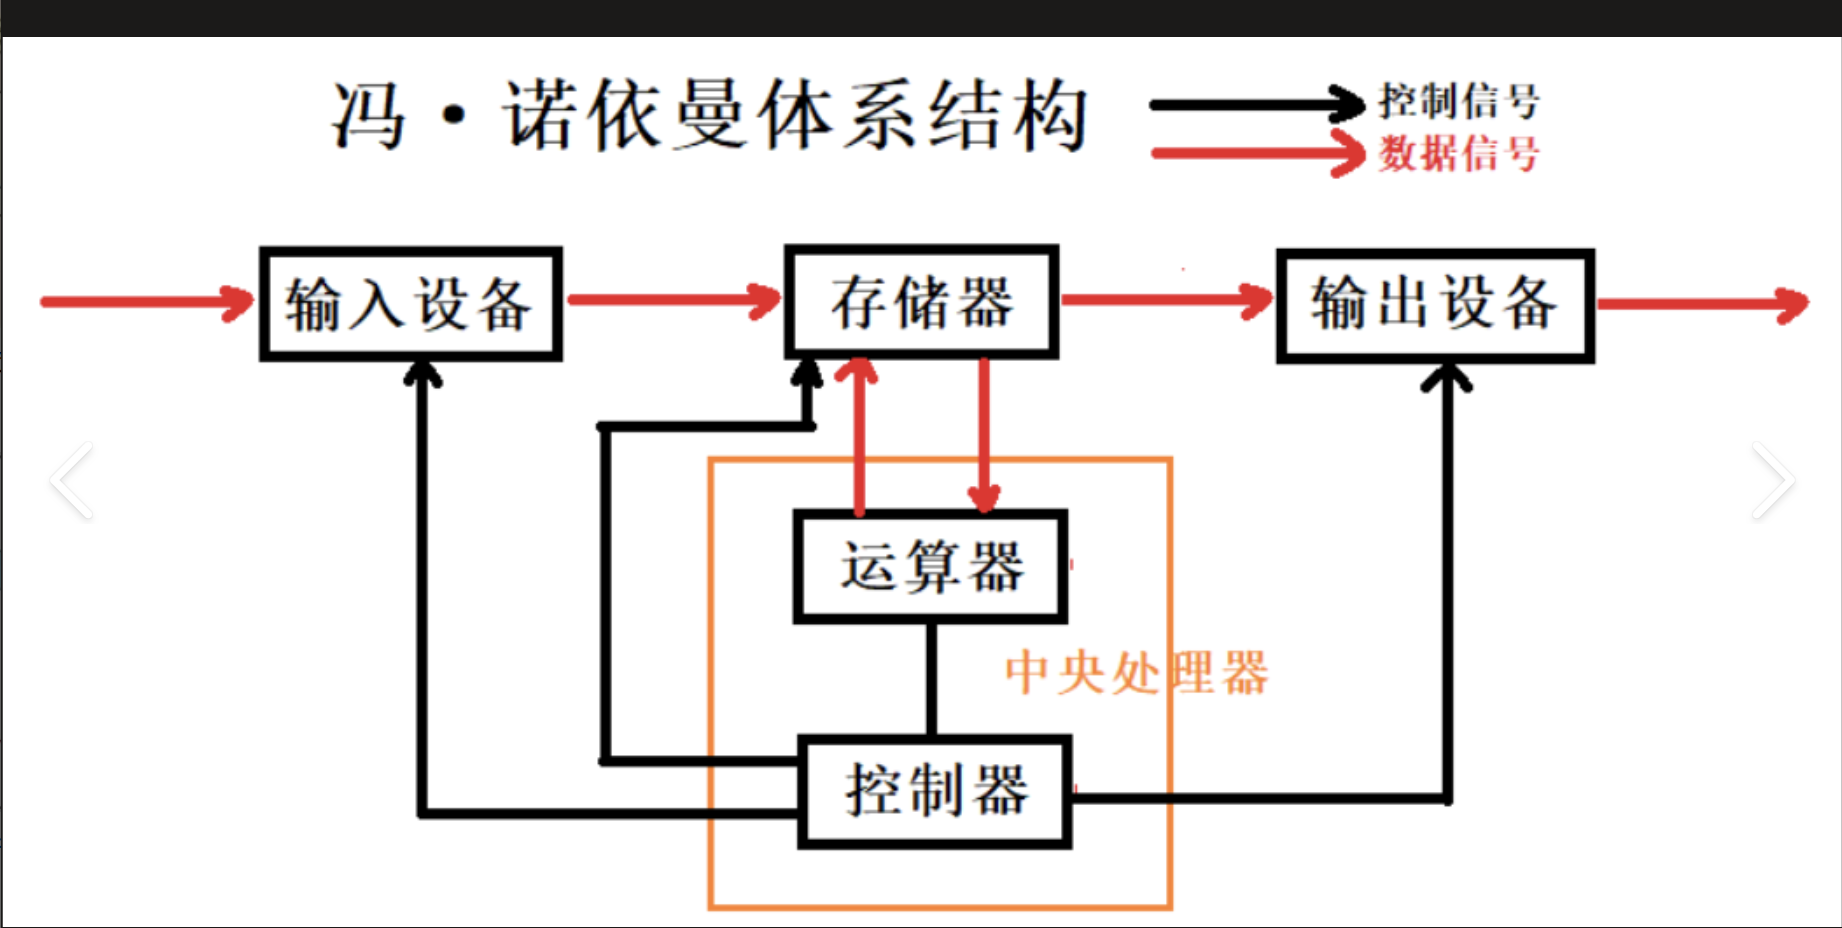
我们每天都在用电脑,笔记本也好,服务器也好,大部分都遵守冯诺依曼体系结构。但是很多人对冯诺依曼的理解只停留在 "五大部件" 这个概念上,这是远远不够的。
1.1 五大组成部分
冯诺依曼体系的计算机由以下硬件组件组成:
输入单元:键盘、鼠标、扫描仪、写字板等,负责把外部数据输入到计算机中。 中央处理器(CPU):包含运算器和控制器,是计算机的 "大脑",负责计算和控制。 存储器:这里特指内存(RAM),不是硬盘。 输出单元:显示器、打印机等,负责把计算结果输出。
这里必须强调几点,这是理解后续所有内容的基础:
第一,这里的存储器指的是内存,不是硬盘。硬盘属于外设,是输入输出设备的一种。
第二,不考虑缓存的情况下,CPU 能且只能对内存进行读写,不能直接访问外设。也就是说,CPU 想读硬盘上的数据,必须先让硬盘把数据搬到内存里,CPU 再从内存里读。CPU 想把数据显示到屏幕上,也必须先把数据写到内存,再由显卡从内存读到显存输出到显示器。
第三,外设要输入或者输出数据,也只能写入内存或者从内存中读取。
一句话总结:所有设备都只能直接和内存打交道,内存是整个系统的数据流转中心。
1.2 用数据流理解冯诺依曼 ------ 以 QQ 聊天为例
理解冯诺依曼不能停留在概念上,要深入到软件数据流的层面。我们来想一个生活中的场景:你登录 QQ,给朋友发一条消息,数据是怎么流动的?
第一步,你打开 QQ 窗口,用键盘输入 "你好"。键盘是输入设备,它把 "你好" 这两个字的编码数据通过总线写入到内存中。
第二步,CPU 从内存中读取这条消息数据,进行处理(比如加密、打包成网络数据包),处理完之后再写回内存。
第三步,网卡(也是外设)从内存中读取这个数据包,通过网络发送出去。
第四步,对方的网卡收到数据包,把数据写入到对方电脑的内存中。
第五步,对方的 CPU 从内存读取数据包,进行解密、解包,得到 "你好" 这两个字,再写回内存。
第六步,对方的显卡从内存读取这两个字的显示数据,输出到显示器上,对方就看到了你的消息。
如果是在 QQ 上发送文件呢?道理是一样的,只不过数据量更大。硬盘把文件数据读到内存,CPU 处理后,网卡从内存读走发出去。对方网卡收到写入内存,CPU 处理后写入硬盘。整个过程中,CPU 永远不直接碰硬盘或者网卡,所有数据都经过内存中转。
理解了这个数据流,你就真正理解了冯诺依曼体系,而不是死记硬背五大部件。
二、操作系统(Operator System)------ 计算机的 "大管家"
2.1 操作系统的概念
任何计算机系统都包含一个基本的程序集合,称为操作系统(OS)。笼统地理解,操作系统包括:
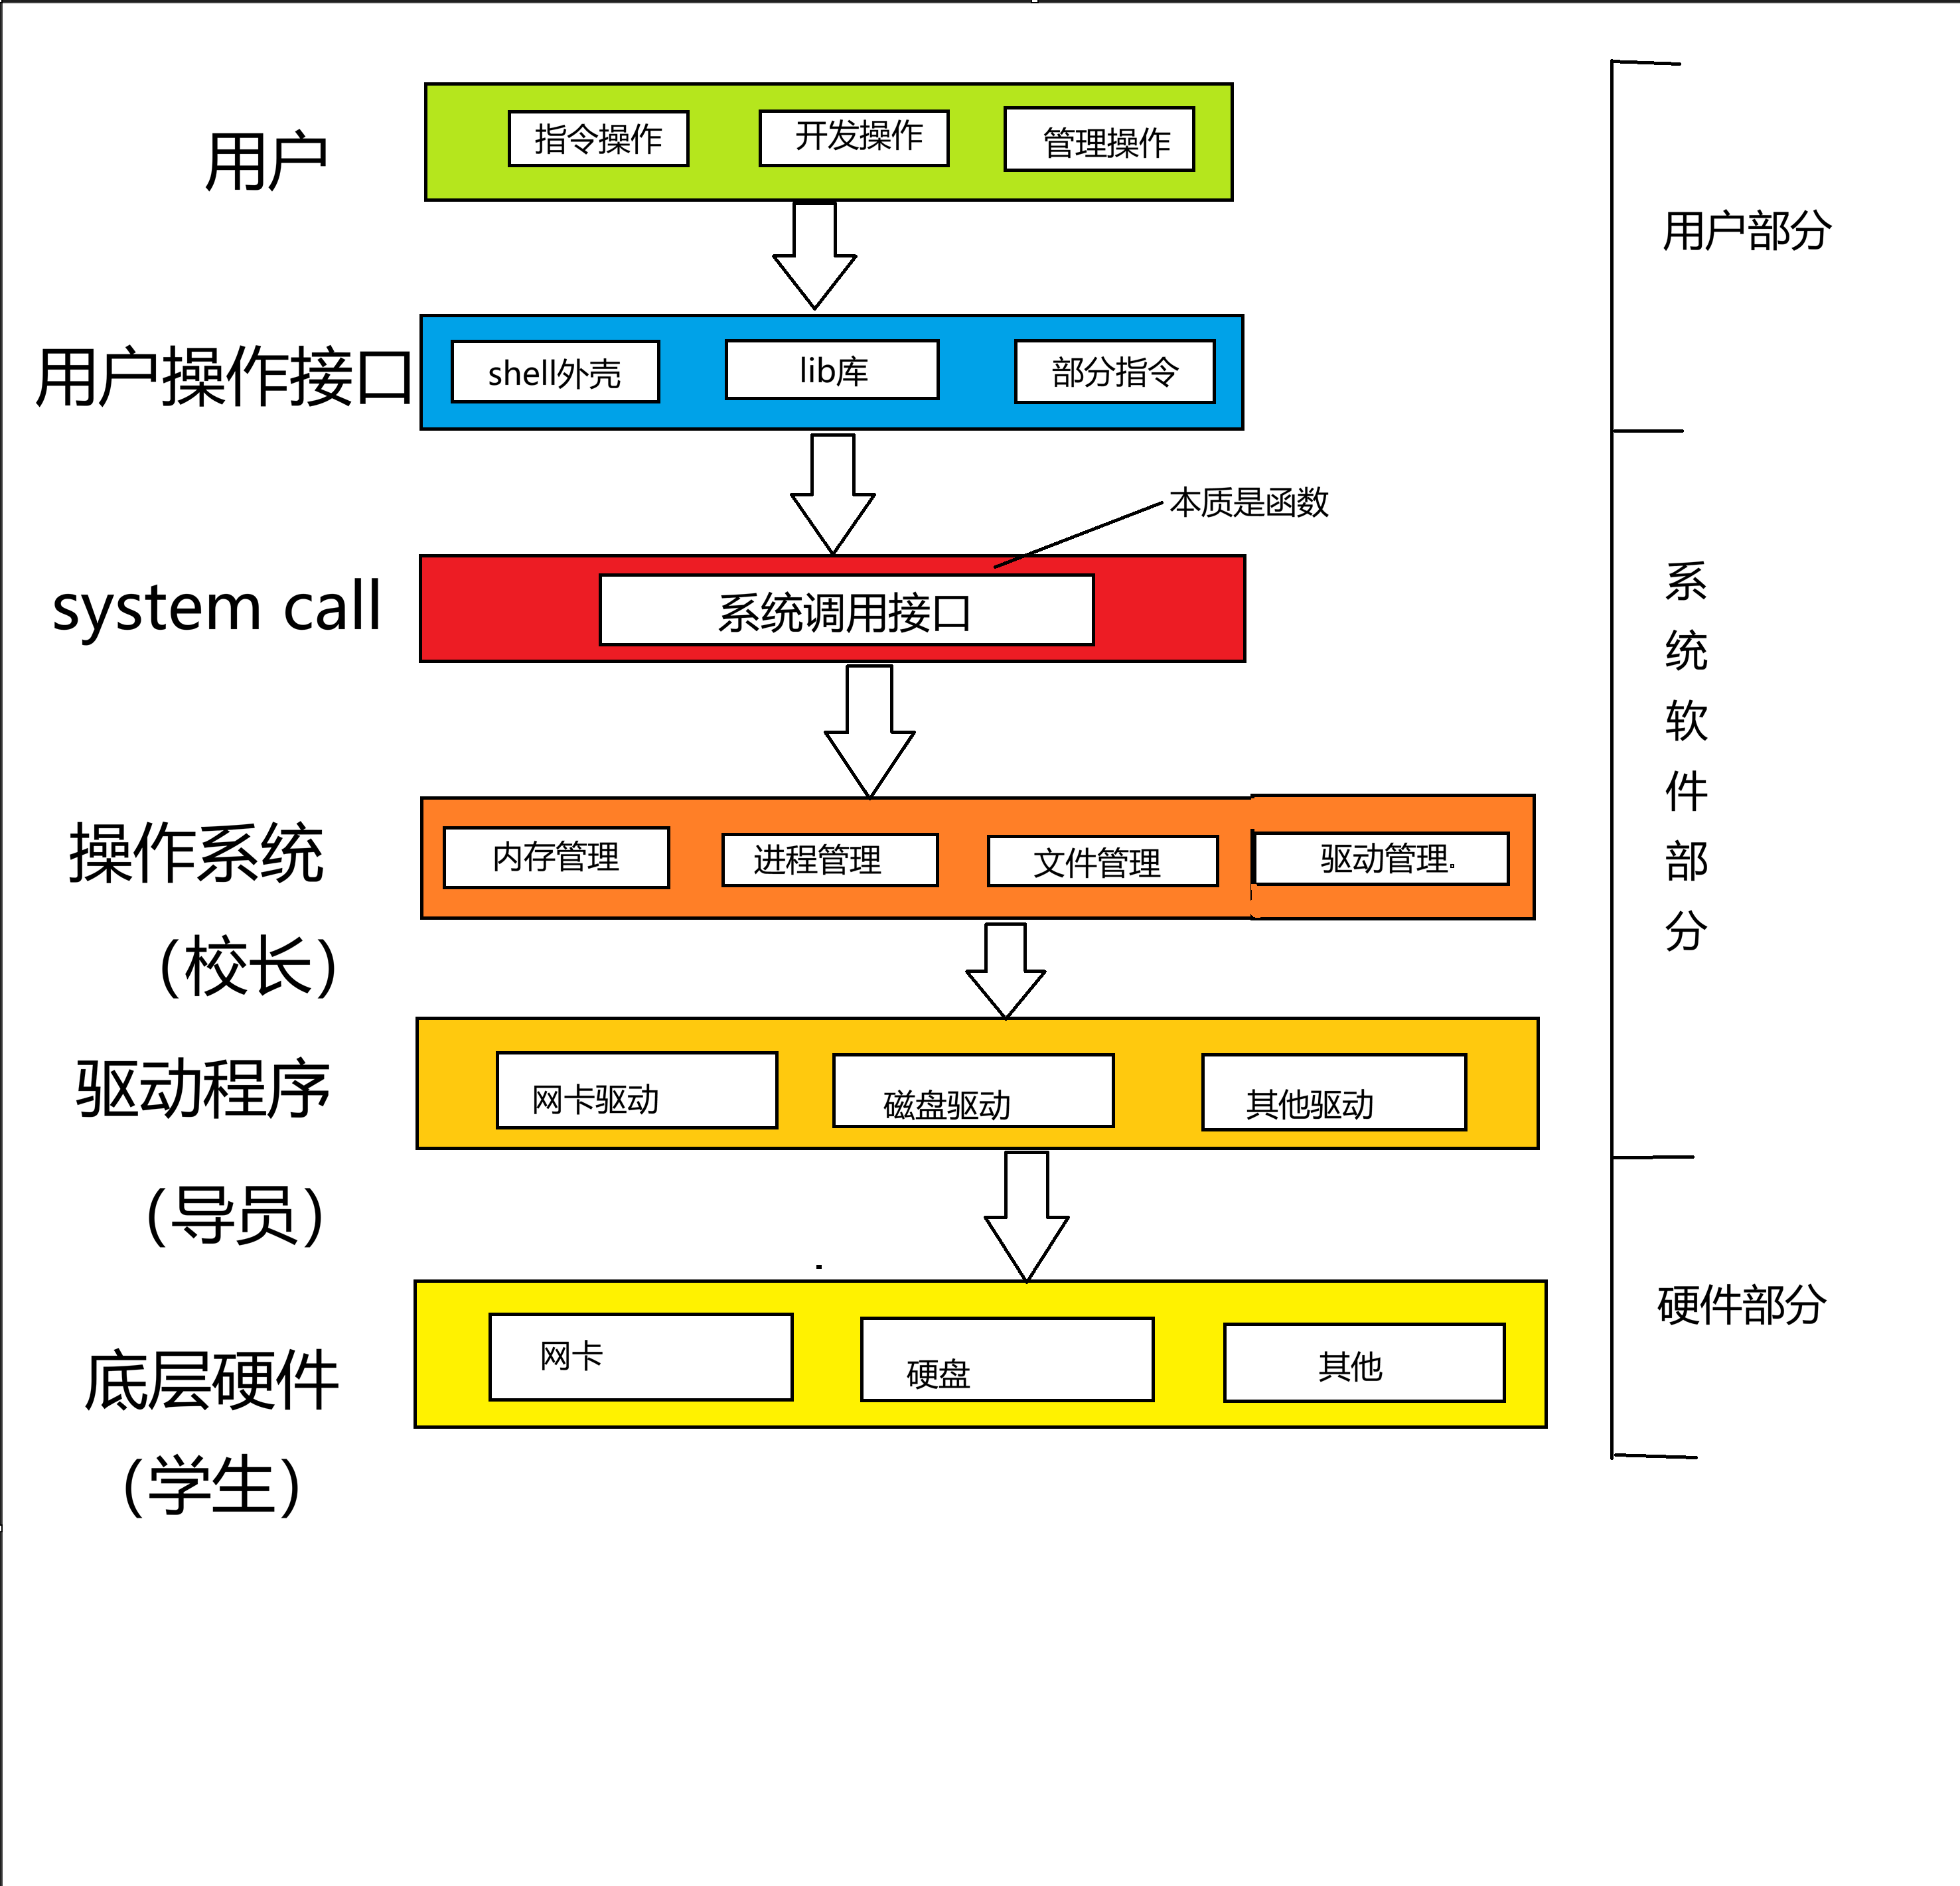
内核:进程管理、内存管理、文件管理、驱动管理。这是操作系统最核心的部分,运行在内核态。
其他程序:函数库、shell 程序等等。这些运行在用户态,为用户提供更友好的接口。
2.2 设计操作系统的目的
操作系统的设计目的可以用 "对上对下" 来概括:
对下:与硬件交互,管理所有的软硬件资源。CPU、内存、硬盘、网卡、键盘鼠标,这些硬件资源都是由操作系统统一管理和分配的。 对上:为用户程序(应用程序)提供一个良好的执行环境。应用程序不需要直接操作硬件,只需要调用操作系统提供的接口就行。
2.3 操作系统的核心功能 ------"搞管理" 的软件
在整个计算机软硬件架构中,操作系统的定位非常清晰:它就是一款纯正的 "搞管理" 的软件。
那怎么理解 "管理" 这个词呢?我们举一个生活中的例子。
假设一个学校里有校长、辅导员、学生。校长要管理全校学生,但是校长不可能认识每一个学生,也不可能直接管到每一个学生。那校长是怎么管理的呢?
第一步,描述被管理对象。学校要给每个学生建档案,档案里有姓名、学号、年龄、专业、成绩等等信息。这个档案就是对学生这个被管理对象的描述。 第二步,组织被管理对象。有了档案之后,不能把档案随便堆在仓库里,要按年级、班级、专业组织起来,比如用链表或者树状结构,这样想找某个学生的时候才能快速定位。
操作系统管理硬件也是同样的道理:
描述起来,用 struct 结构体。比如描述一个进程用 task_struct,描述一个文件用 file 结构体,描述一块内存用 page 结构体。 组织起来,用链表或其他高效的数据结构。比如所有的进程用双向链表组织起来,所有的文件用哈希表组织起来。
所以 "管理" 的本质就是:先描述,再组织。这个思想贯穿了整个操作系统的设计,后面讲进程的时候你会反复看到。
2.4 系统调用和库函数
操作系统对外会表现为一个整体,但它会暴露自己的部分接口供上层开发使用,这部分由操作系统提供的接口就叫做系统调用(system call)。
系统调用在使用上功能比较基础,对用户的要求也比较高。比如你想往屏幕上打印一句话,直接用系统调用 write 的话,你需要自己处理文件描述符、缓冲区、错误码等细节,非常麻烦。
所以有心的开发者就对部分系统调用进行了适度封装,形成了库(library)。比如 C 标准库中的 printf 函数,底层就是封装了 write 系统调用。有了库,上层用户和开发者进行二次开发就方便多了。
总结一下:系统调用是操作系统提供的最底层接口,库函数是对系统调用的封装,目的是让开发者用起来更方便。
三、进程 ------ 操作系统管理的核心对象
铺垫了这么多,终于到了我们的主角:进程。
3.1 进程的基本概念
关于进程,不同层面有不同的定义:
课本概念:程序的一个执行实例,正在执行的程序。这个定义比较好理解,你写了一个 a.out 程序,它躺在硬盘上的时候叫程序,当你运行它的时候,它就变成了一个进程。
内核观点:担当分配系统资源(CPU 时间、内存)的实体。这个定义更本质,进程是操作系统分配资源的基本单位。
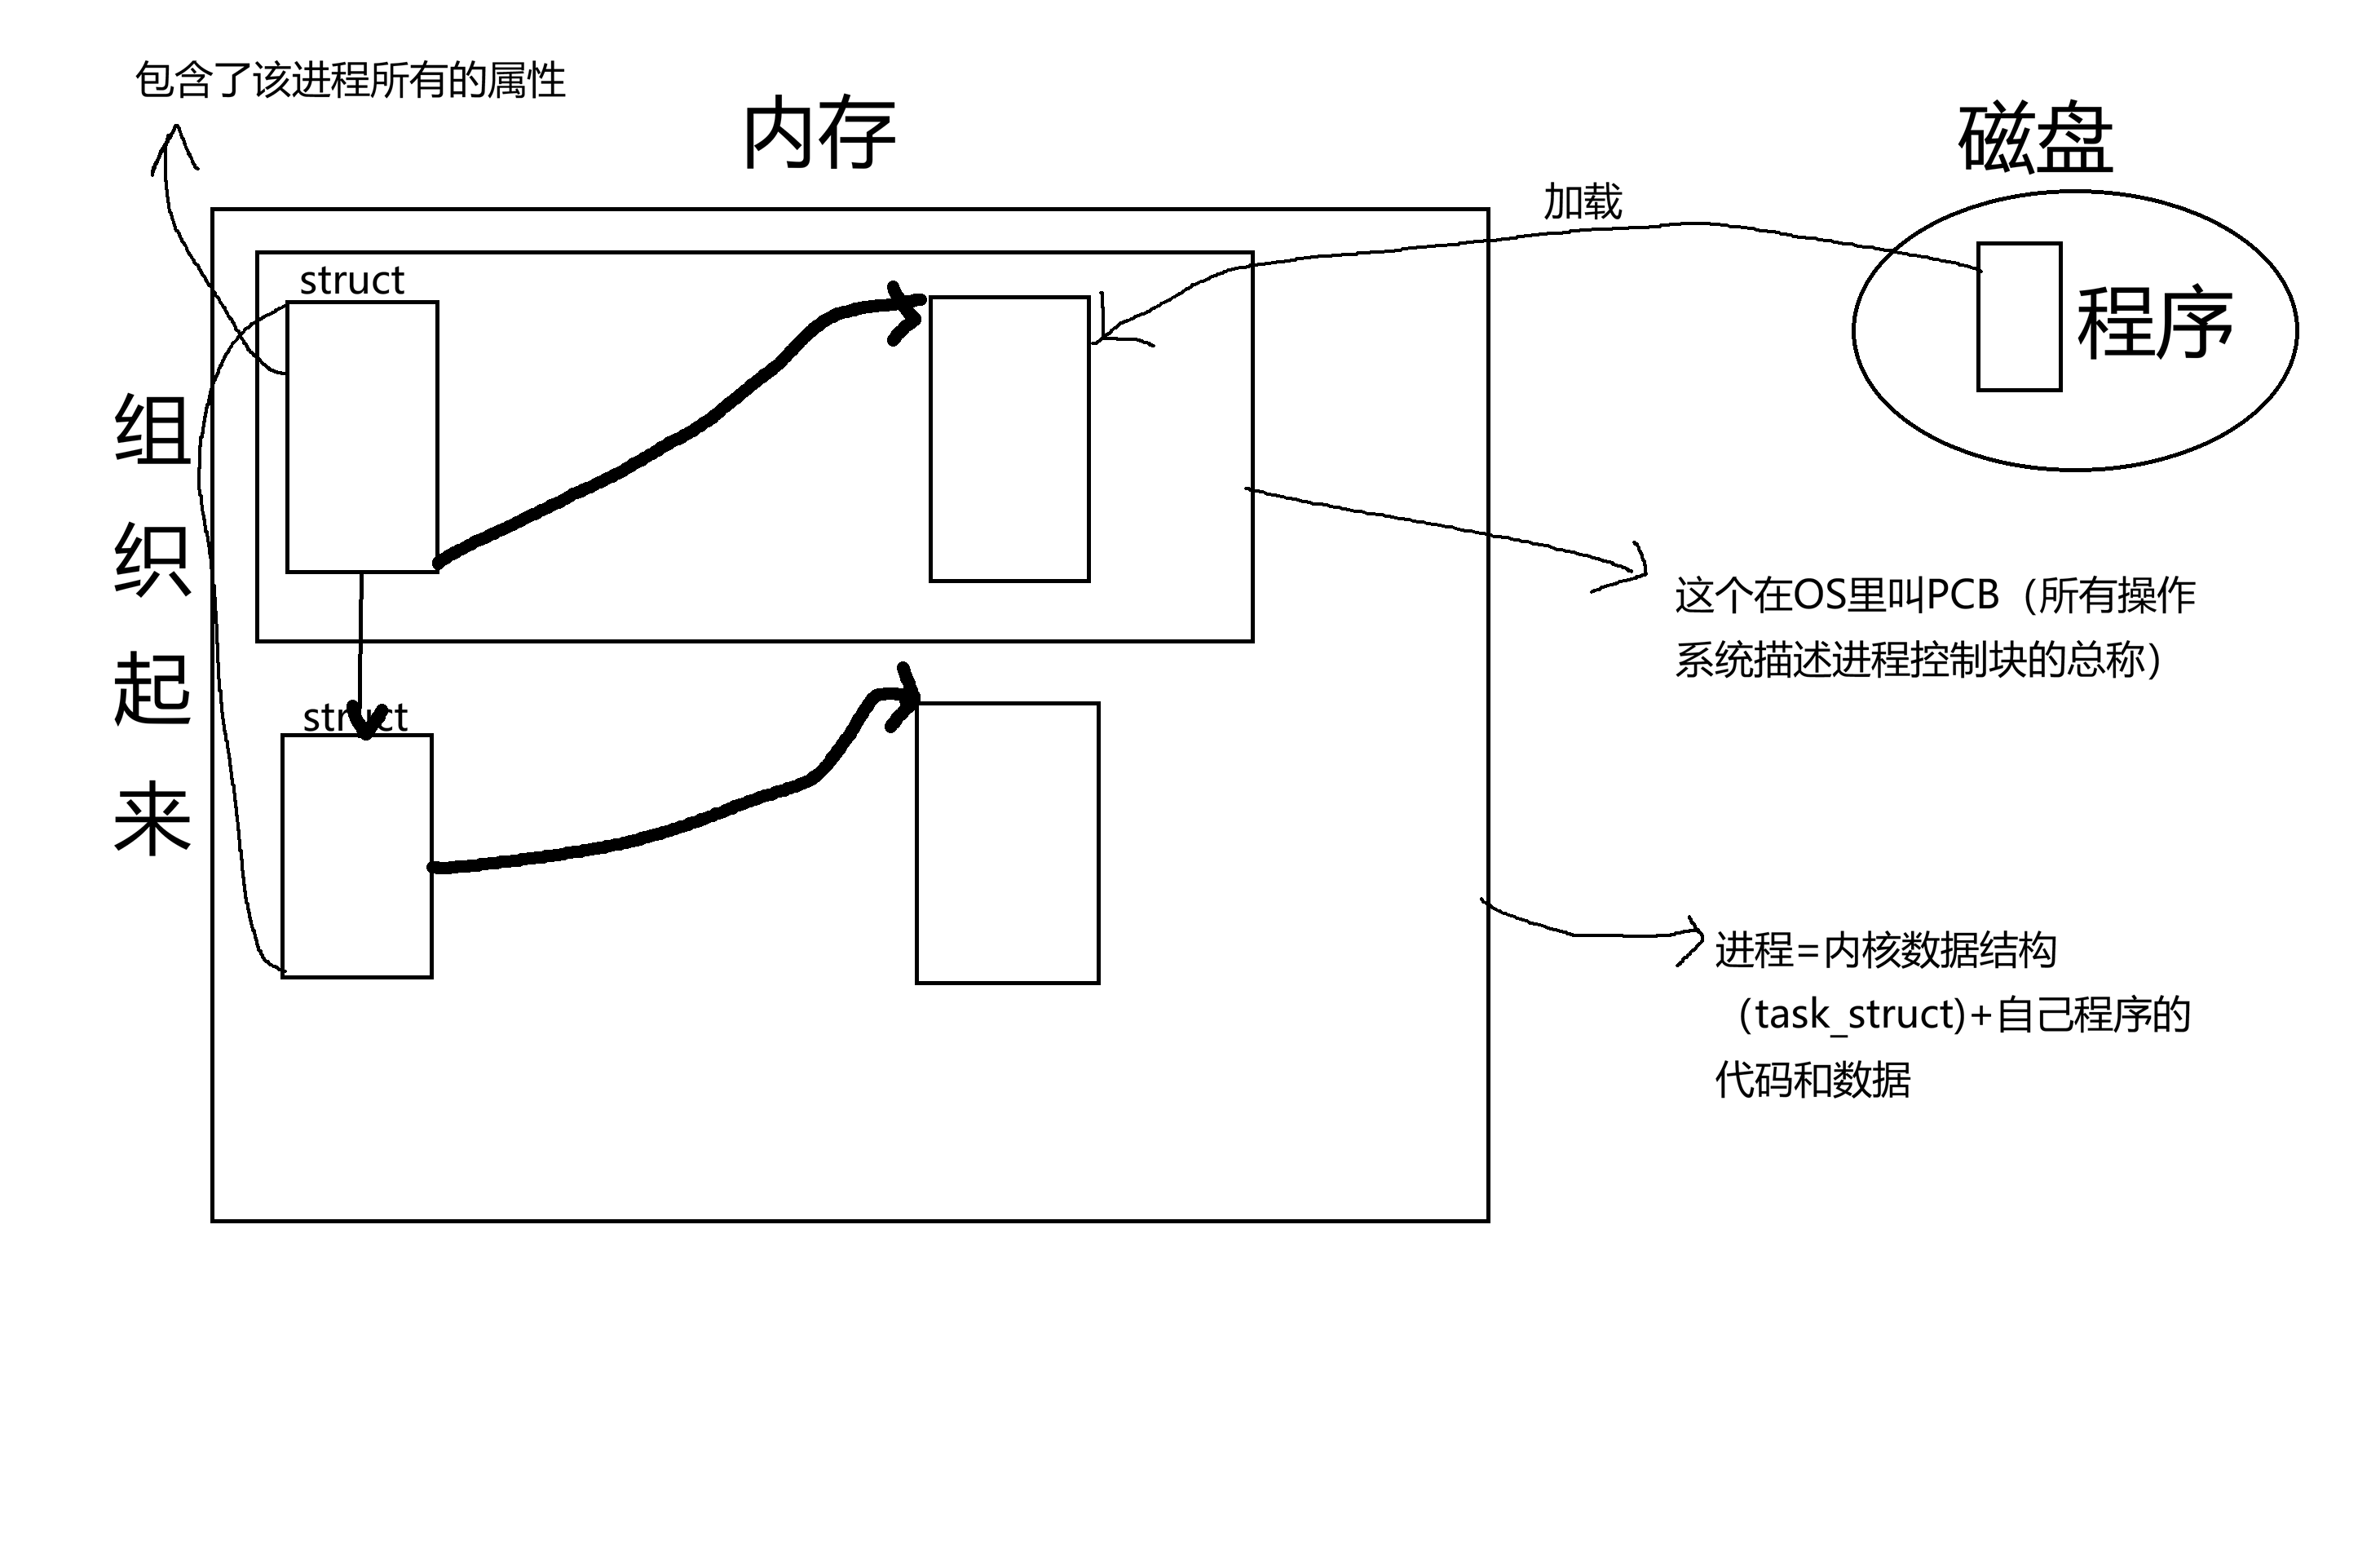
当前我们可以这样理解:进程 = 内核数据结构(task_struct) + 自己的程序代码和数据。
这个等式非常重要。一个进程不仅仅是你写的那堆代码和数据,它还包括内核为了管理这个进程而创建的 task_struct 结构体(也就是 PCB)。代码和数据存在内存中,task_struct 也存在内存中,两者合在一起才是一个完整的进程。
3.2 描述进程 ------PCB(进程控制块)
进程信息被放在一个叫做进程控制块的数据结构中,可以理解为进程属性的集合。课本上称之为 PCB(Process Control Block)。
在 Linux 操作系统下,PCB 的具体实现是 task_struct。也就是说,task_struct 是 PCB 的一种,是 Linux 内核中用来描述进程的结构体。
task_struct 是 Linux 内核的一种数据结构类型,它会被装载到 RAM(内存)里,包含着进程的所有信息。系统里每有一个进程,内核就创建一个 task_struct 对象。
3.3 task_struct 的内容分类
task_struct 里面到底装了什么?我们来分类看一下:
(1)标识符:描述本进程的唯一标识符,用来区别其他进程。就是我们常说的 PID(Process ID)。
(2)状态:任务状态、退出代码、退出信号等。进程是运行中、睡眠中、还是已经停止了,都存在这里。
(3)优先级:相对于其他进程的优先级。决定了这个进程什么时候能被 CPU 调度执行。
(4)程序计数器:程序中即将被执行的下一条指令的地址。CPU 执行完一条指令后,就从程序计数器里拿下一条指令的地址。
(5)内存指针:包括程序代码和进程相关数据的指针,还有和其他进程共享的内存块的指针。通过这些指针,进程能找到自己的代码和数据在内存中的位置。
(6)上下文数据:进程执行时处理器的寄存器中的数据。这个非常重要,后面讲进程切换的时候会详细说。简单来说,CPU 里的寄存器数量有限,当一个进程被切换下去的时候,要把当前寄存器里的值保存下来,等它再被调度上来的时候恢复回去,这样它才能继续执行。
(7)I/O 状态信息:包括显示的 I/O 请求、分配给进程的 I/O 设备和被进程使用的文件列表。比如这个进程打开了哪些文件,都记录在这里。
(8)记账信息:可能包括处理器时间总和、使用的时钟数总和、时间限制、记账号等。操作系统用这些信息来统计每个进程用了多少 CPU 时间,做负载均衡。
(9)其他信息。
这些内容我们后续会逐个深入介绍,这里先有个整体印象。
3.4 组织进程
所有运行在系统里的进程,都以 task_struct 双向链表的形式存在内核里。内核里有一个全局的链表,把所有进程的 task_struct 串起来。当操作系统需要遍历所有进程的时候,就沿着这个链表一个个找。
这就呼应了我们前面说的 "管理" 的思想:先描述(用 task_struct),再组织(用双向链表)。
 3.5 查看进程
进程的信息可以通过两种方式查看:
第一种,通过 /proc 系统文件夹查看。/proc 是一个虚拟文件系统,它里面的内容不是存在硬盘上的,而是内核动态生成的。比如要获取 PID 为 1 的进程信息,你就查看 /proc/1 这个文件夹,里面有这个进程的各种信息文件。
第二种,使用 top 和 ps 这些用户级工具。这些工具底层也是读 /proc 目录下的内容,只不过帮我们格式化输出了。
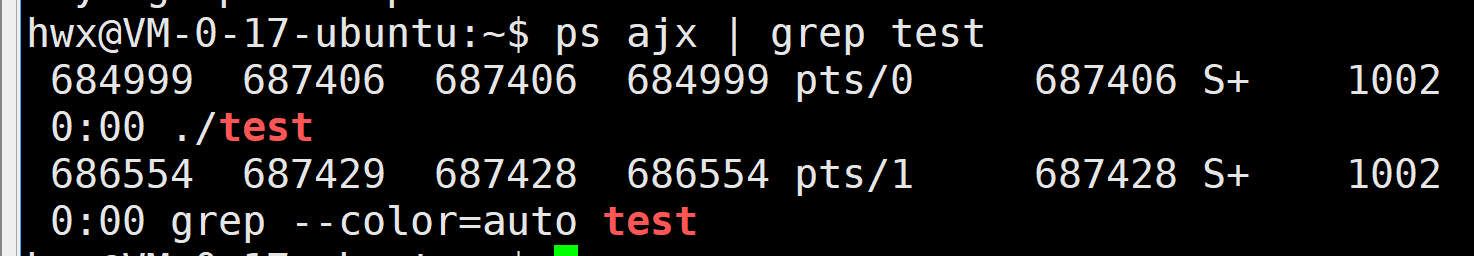
我们来写一个最简单的死循环程序,然后用 ps 命令查看它:
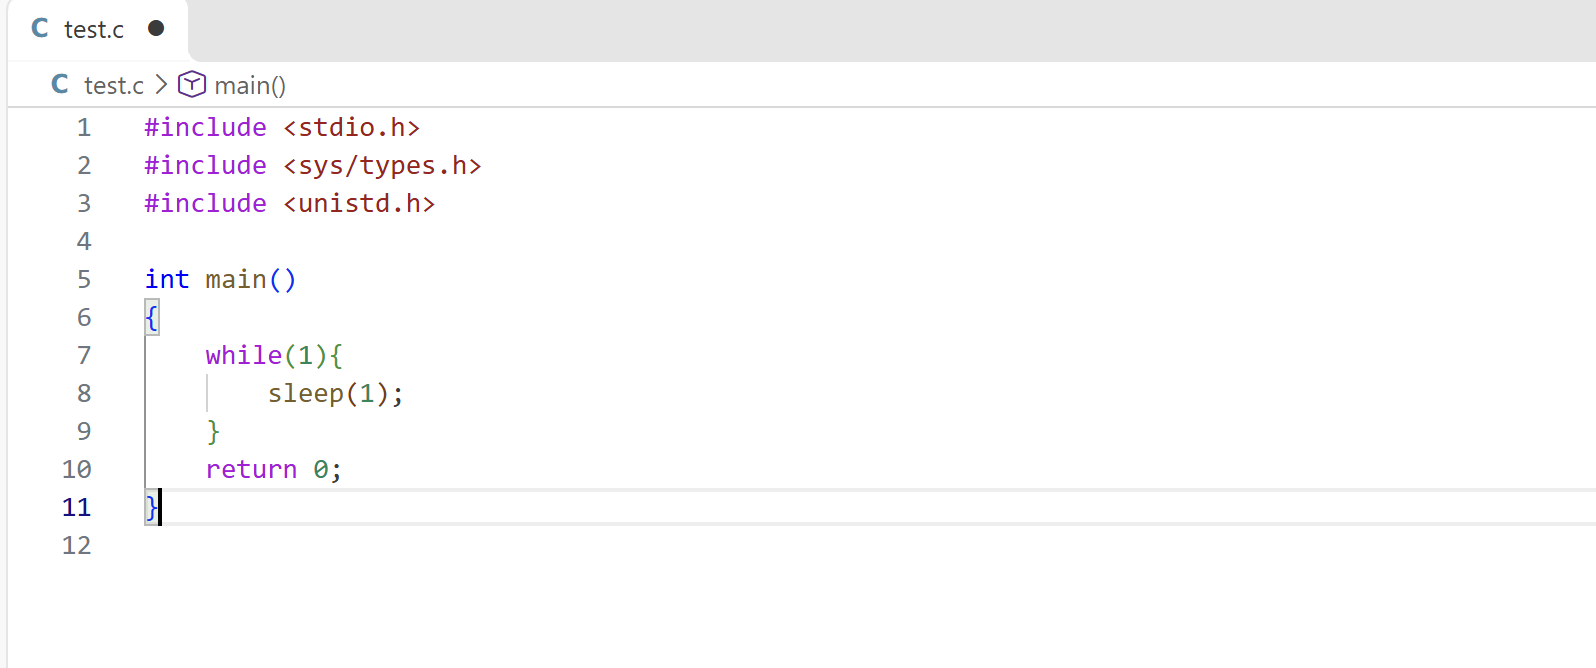
这个程序什么都不做,就是每隔一秒睡一次,永远不退出。编译运行后,在另一个终端用 ps aux | grep 程序名就能看到它了。
3.6 通过系统调用获取进程标识符
每个进程都有两个重要的 ID:进程 ID(PID)和父进程 ID(PPID)。
PID 是当前进程的唯一标识,PPID 是创建这个进程的父进程的 ID。
我们可以通过 getpid () 和 getppid () 两个系统调用来获取它们:
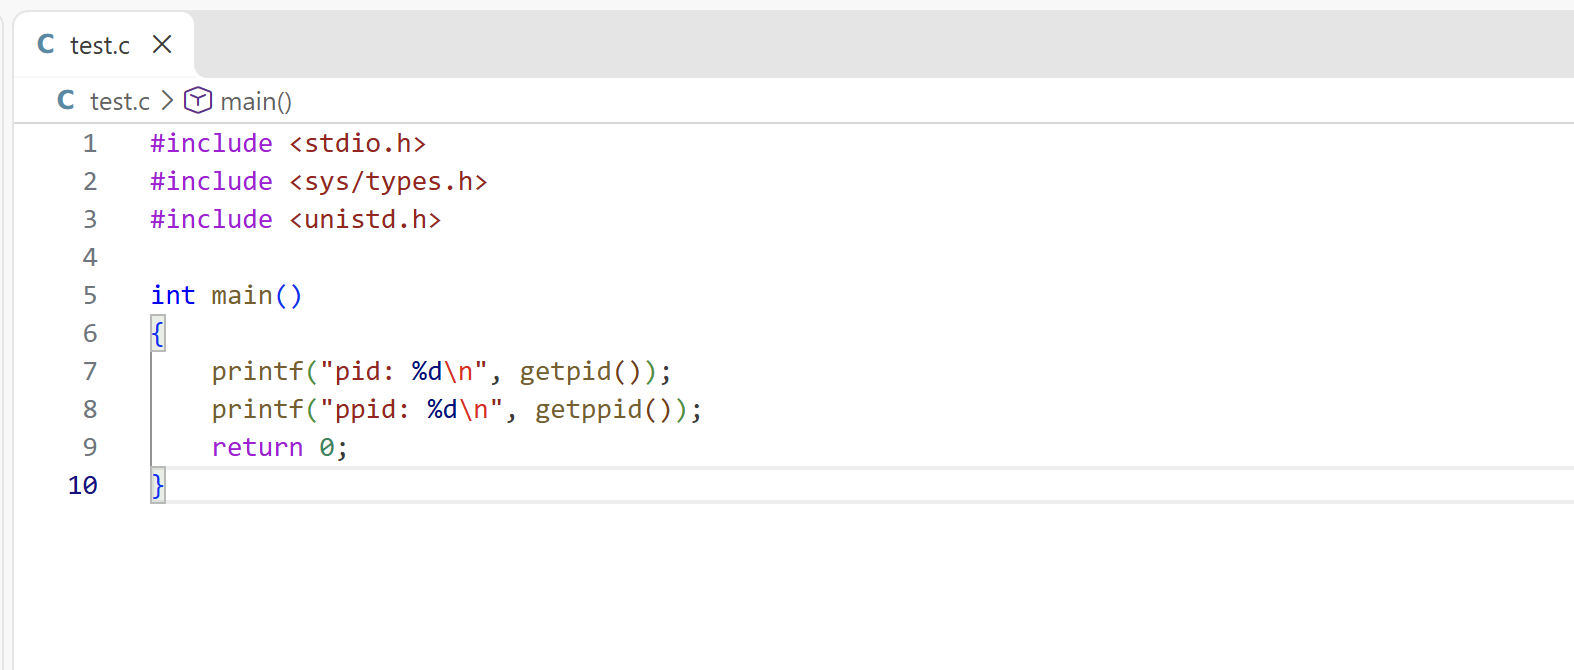
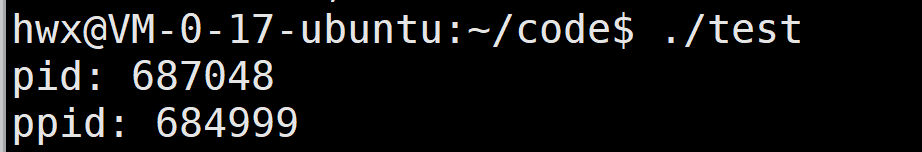
运行这个程序,你会看到当前进程的 PID 和它的父进程的 PID。如果你是在 shell 里运行的,那么 PPID 通常就是你当前 shell 的 PID。
四、fork------ 创建进程的系统调用
4.1 fork 初识
在 Linux 中,创建一个进程用的是 fork 系统调用。我们可以用 man fork 命令查看它的详细说明。
fork 函数的原型是:pid_t fork (void);
它没有参数,返回值是 pid_t 类型。但是这里有一个非常反直觉的地方:fork 有两个返回值。
什么意思呢?调用一次 fork,会返回两次。一次在父进程中返回,一次在子进程中返回。
父进程中,fork 返回子进程的 PID(一个大于 0 的数)。 子进程中,fork 返回 0。 如果 fork 失败,返回 - 1。
我们来看一段代码:
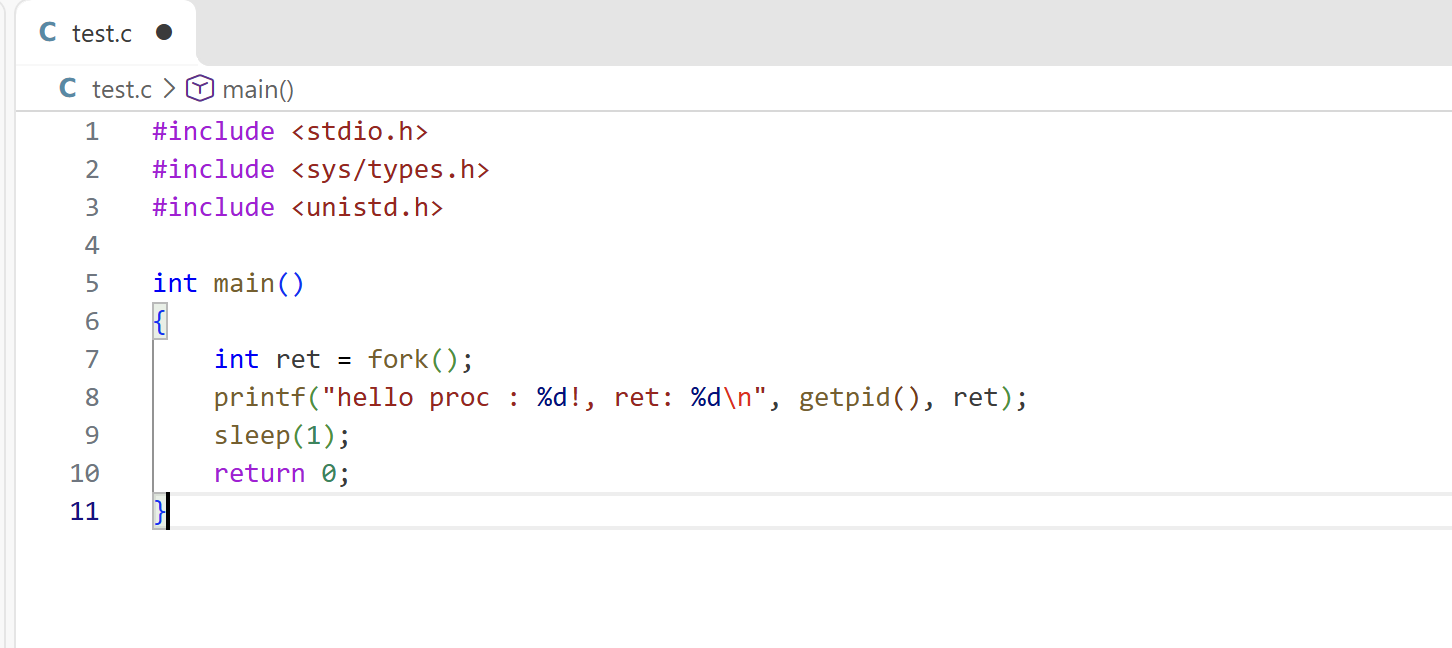
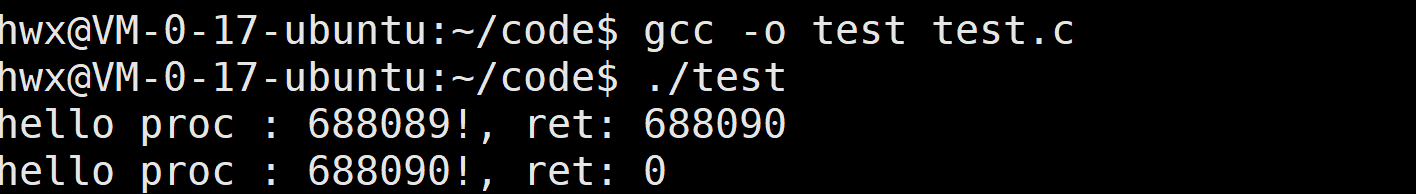
运行这段代码,你会看到两行输出:一行是父进程的 PID 和 ret(子进程的 PID),一行是子进程的 PID 和 ret(0)。
为什么会这样?因为 fork 创建了一个新的进程,这个新进程和父进程几乎一模一样,它们都会从 fork 调用之后的位置继续执行。所以 printf 会被执行两次,一次在父进程,一次在子进程。
4.2 fork 之后用 if 进行分流
既然 fork 有两个返回值,那么我们通常用 if 语句来区分父进程和子进程,让它们执行不同的代码:
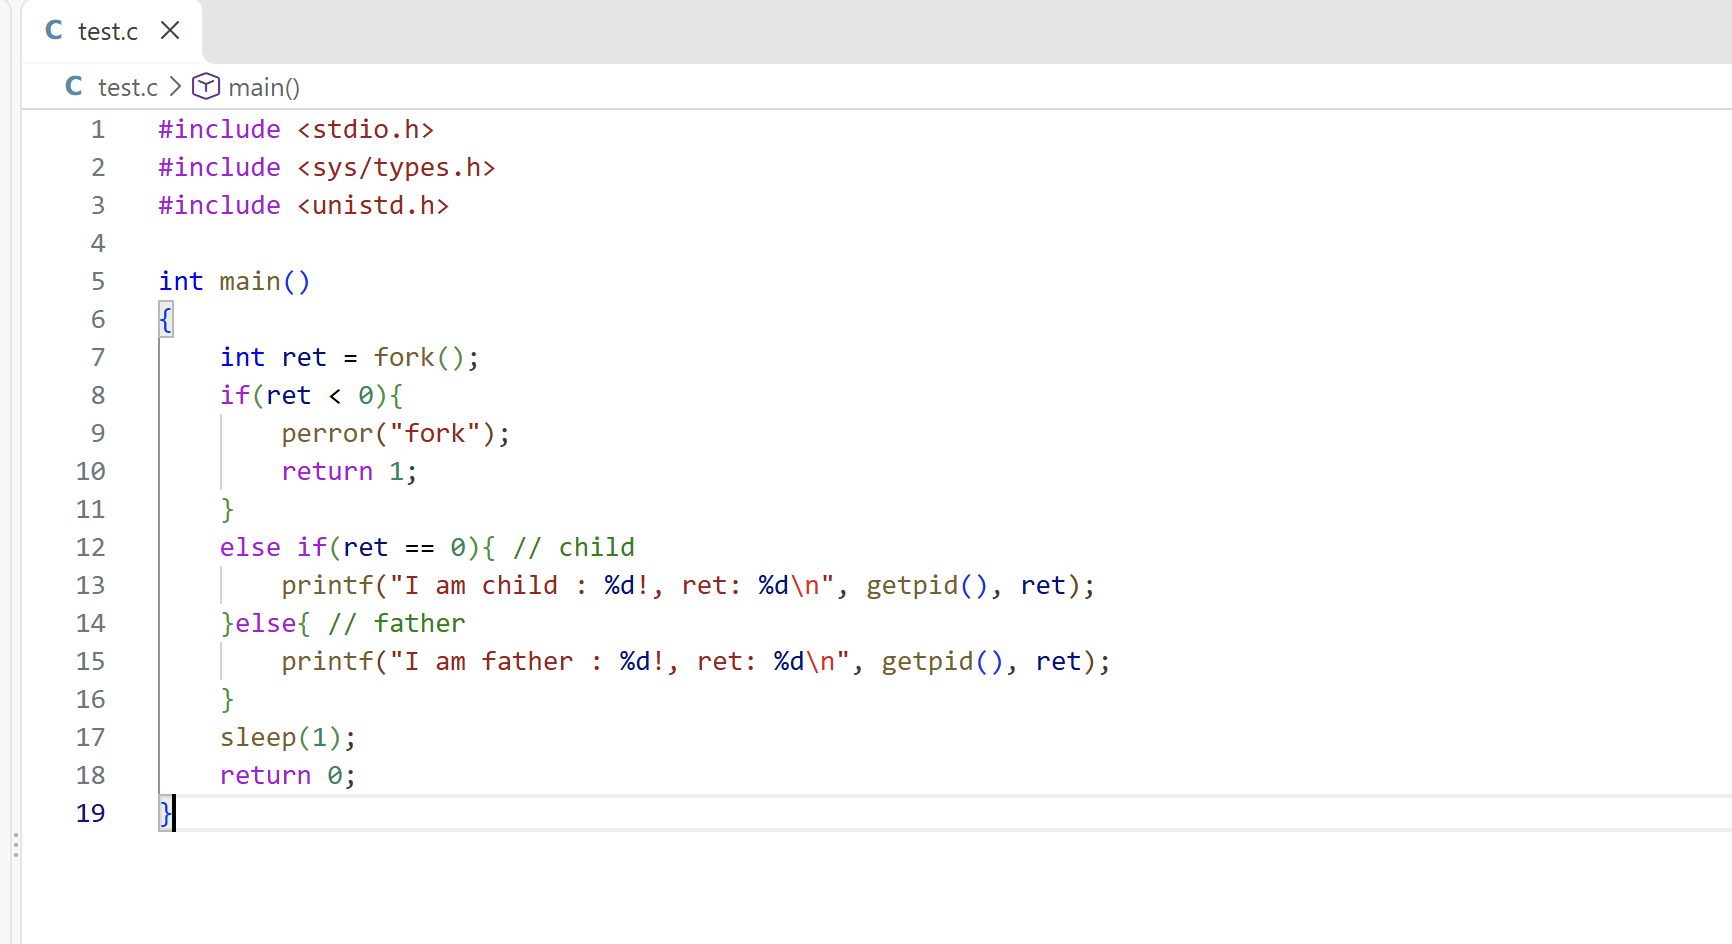
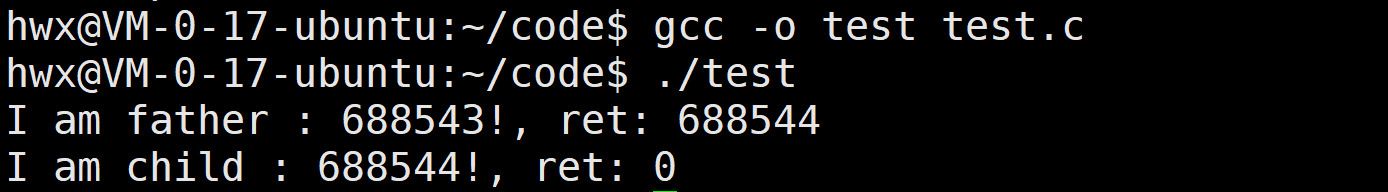
这段代码里,ret 等于 0 的时候是子进程,ret 大于 0 的时候是父进程。父子进程执行不同的 printf 语句。
4.3 三个灵魂拷问
学到这里,至少要搞明白三个问题:
第一个问题:fork 为什么会有两个返回值?
因为 fork 的本质是创建一个新进程。调用 fork 的时候,内核会做这些事情:
- 给子进程分配一个新的 PID。
- 创建子进程的 task_struct。
- 把父进程的内存空间拷贝一份给子进程(实际上是写时拷贝,后面讲)。
- 子进程的寄存器上下文设置为从 fork 返回处开始执行,返回值设为 0。
- 父进程继续执行,返回值是子进程的 PID。
所以父进程返回一次,子进程返回一次,总共两次返回。这不是一个函数返回了两个值,而是两个进程各自返回了一次。
第二个问题:两个返回值各自给父子如何返回?
父进程中返回子进程的 PID(大于 0),子进程中返回 0。这样父进程就能知道自己创建的子进程是谁,而子进程不需要知道父进程的 PID(它可以通过 getppid 获取)。
第三个问题:一个变量 ret 怎么能让 if 和 else if 同时成立?
这个问题要等学了虚拟地址空间才能完全解释清楚。简单来说,父子进程虽然 ret 变量的虚拟地址是一样的,但是它们映射到不同的物理地址。父进程的 ret 里存的是子进程的 PID,子进程的 ret 里存的是 0。所以在父进程看来 ret 大于 0,走 else 分支;在子进程看来 ret 等于 0,走 else if 分支。它们各自看到的 ret 值是不一样的,所以不存在 "一个变量同时等于两个值" 的矛盾。
4.4 父子进程的关系
fork 创建子进程后,父子进程的代码是共享的,数据各自开辟空间,私有一份(采用写时拷贝)。
代码共享是因为代码是只读的,父子进程执行的是同一份代码,不需要修改,所以共享一份就行,节省内存。
数据为什么要私有?因为进程之间是独立的,父进程修改一个变量不应该影响子进程,反之亦然。但是如果 fork 的时候就把所有数据都拷贝一份,万一子进程根本不修改这些数据,就浪费了。所以 Linux 采用了写时拷贝(Copy On Write)的策略:fork 的时候父子进程共享同一份数据,页表设置为只读。当其中一方试图修改数据的时候,触发缺页异常,内核才把这一页数据拷贝一份给修改方,这样双方就各自有了独立的副本。
这个设计非常巧妙,既保证了进程独立性,又提高了效率。
五、进程状态 ------ 一个进程的 "一生"
5.1 Linux 内核源代码怎么说
为了弄明白 "正在运行的进程" 是什么意思,我们需要知道进程的不同状态。在 Linux 内核里,进程有时候也叫做任务(task)。
下面的状态在 kernel 源代码里定义:
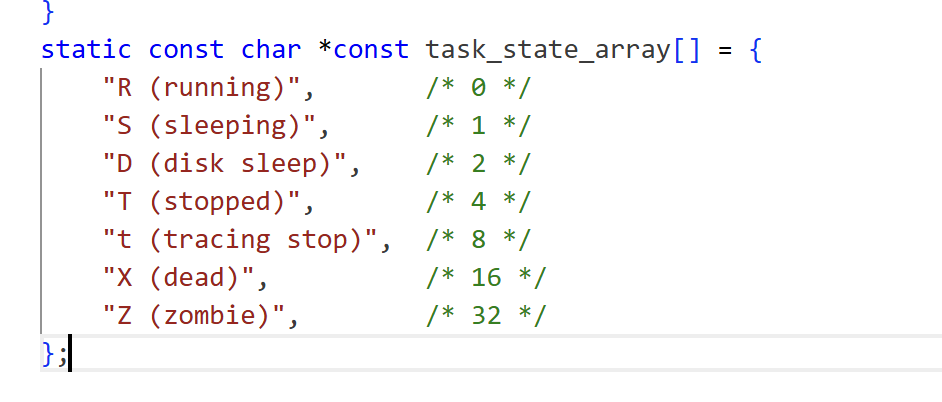
我们逐个来解释。
5.2 R 运行状态(running)
R 状态并不意味着进程一定在运行中。它表明进程要么是在运行中(正在 CPU 上执行),要么在运行队列里(等待被调度)。
也就是说,所有 "准备好了、随时可以上 CPU 运行" 的进程都是 R 状态。单核 CPU 同一时刻只能有一个进程在运行,其他 R 状态的进程都在运行队列里排队。
5.3 S 睡眠状态(sleeping)
S 状态意味着进程在等待事件完成。这里的睡眠有时候也叫做可中断睡眠(interruptible sleep)。
什么叫可中断?就是这个进程在睡眠的时候,可以被信号唤醒。比如你运行一个 sleep (100) 的程序,它会进入 S 状态,等待 100 秒。但是你可以给它发一个信号(比如 Ctrl+C 发 SIGINT),它会被唤醒,处理信号,然后退出。
我们平时看到的大部分进程都是 S 状态,因为它们大多在等待某个事件(比如等待用户输入、等待网络数据、等待磁盘 IO 完成)。
5.4 D 磁盘休眠状态(Disk sleep)
D 状态有时候也叫不可中断睡眠状态(uninterruptible sleep)。在这个状态的进程通常会等待 IO 的结束。
和 S 状态的区别是:D 状态的进程不能被信号唤醒,只能等待 IO 完成。为什么要设计这个状态?因为进程在和硬件做 IO 交互的时候,如果被信号打断,可能会导致硬件状态异常。所以在 IO 进行的关键阶段,进程进入 D 状态,保证 IO 操作不被打断。
D 状态的进程比较少见,通常在进行大量磁盘读写的时候可能会看到。kill -9 都杀不掉 D 状态的进程,因为它不响应信号,只能等 IO 完成自己醒过来。
5.5 T 停止状态(stopped)
可以通过发送 SIGSTOP 信号给进程来停止(T)进程。这个被暂停的进程可以通过发送 SIGCONT 信号让它继续运行。
T 状态和 S 状态不一样。S 状态是进程自己主动睡眠等待某个事件,T 状态是被外部信号暂停的。比如你在终端运行一个程序,按 Ctrl+Z,它就进入 T 状态,被挂起了。你可以用 fg 命令把它拉回前台继续运行,或者 bg 让它在后台运行。
5.6 t 追踪停止状态(tracing stop)
t 状态是追踪停止。当进程被调试器(比如 gdb)追踪的时候,在断点处停下来,就进入 t 状态。它和 T 状态类似,但是是由调试追踪导致的。
5.7 X 死亡状态(dead)
X 状态是死亡状态。这个状态只是一个返回状态,你不会在任务列表里看到这个状态。进程彻底消亡的时候会经过这个状态,非常短暂。
5.8 Z 僵尸状态(zombie)
Z 状态是僵尸状态,这是一个非常特殊也非常重要的状态,我们下一节独详细讲。
5.9 进程状态查看
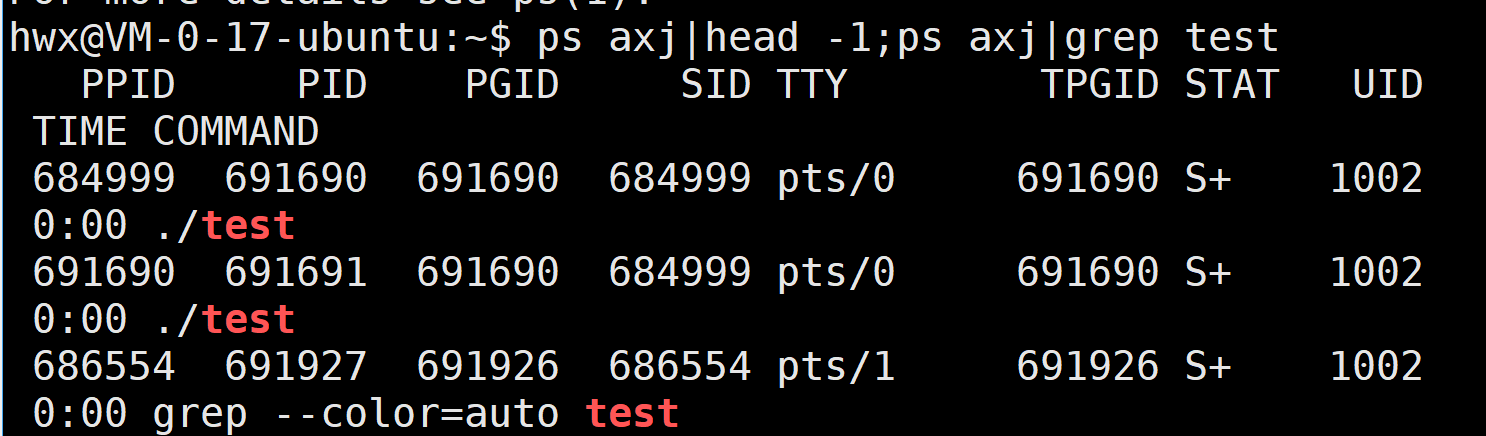
我们用 ps aux 或者 ps axj 命令来查看进程状态。这两个命令的参数含义如下:
a:显示一个终端所有的进程,包括其他用户的进程。
x:显示没有控制终端的进程,例如后台运行的守护进程。
j:显示进程归属的进程组 ID、会话 ID、父进程 ID,以及与作业控制相关的信息。
u:以用户为中心的格式显示进程信息,提供进程的详细信息,如用户、CPU 和内存使用情况等。
ps aux 输出的 STAT 列就是进程状态。你可能会看到 R+、S+、Ss 这样的组合,后面的附加字符有额外含义,比如 s 表示是会话首进程,+ 表示在前台进程组,< 表示高优先级,N 表示低优先级等等。
六、僵尸进程(Zombie)------"死不瞑目" 的进程
6.1 什么是僵尸进程
僵死状态是一个比较特殊的状态。当进程退出并且父进程(使用 wait () 系统调用)没有读取到子进程退出的返回代码时,就会产生僵尸进程。
僵尸进程会以终止状态保持在进程表中,并且一直在等待父进程读取退出状态代码。
所以,只要子进程退出,父进程还在运行,但父进程没有读取子进程状态,子进程就进入 Z 状态。
我们来写一个创建维持15秒的僵尸进程的例子:
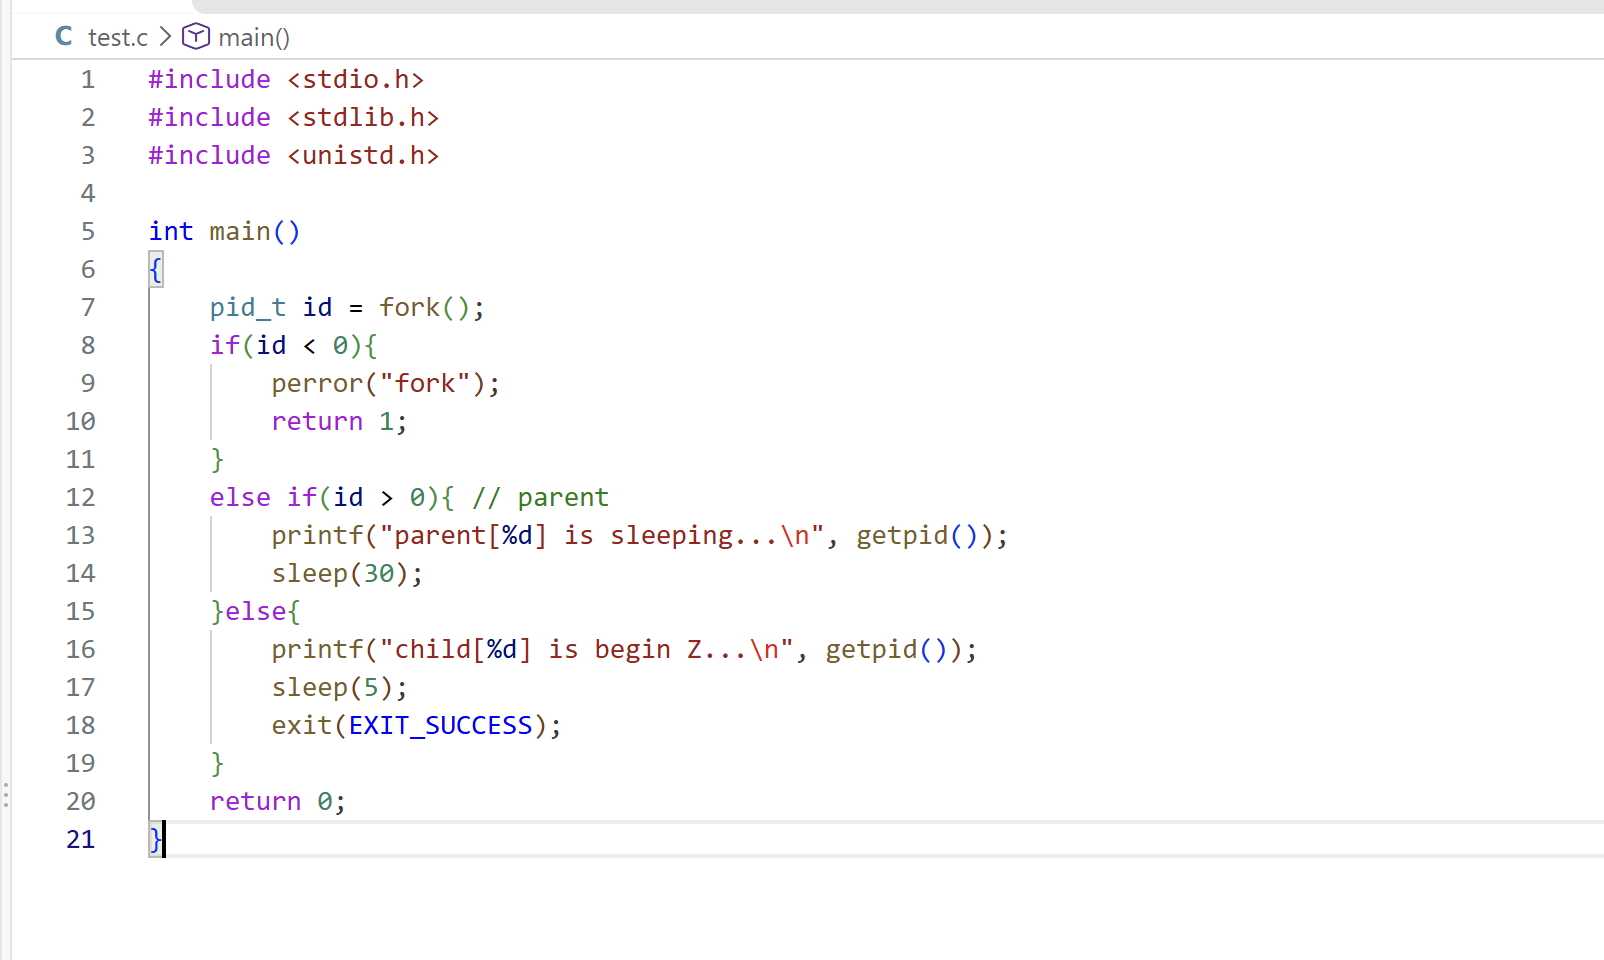
这段代码的逻辑是:父进程创建子进程后,睡眠15秒。子进程运行 5 秒后调用 exit 退出。子进程退出后,父进程还在睡眠,没有调用 wait 回收子进程,所以子进程就进入 Z 状态,一直维持到父进程醒来或者退出。
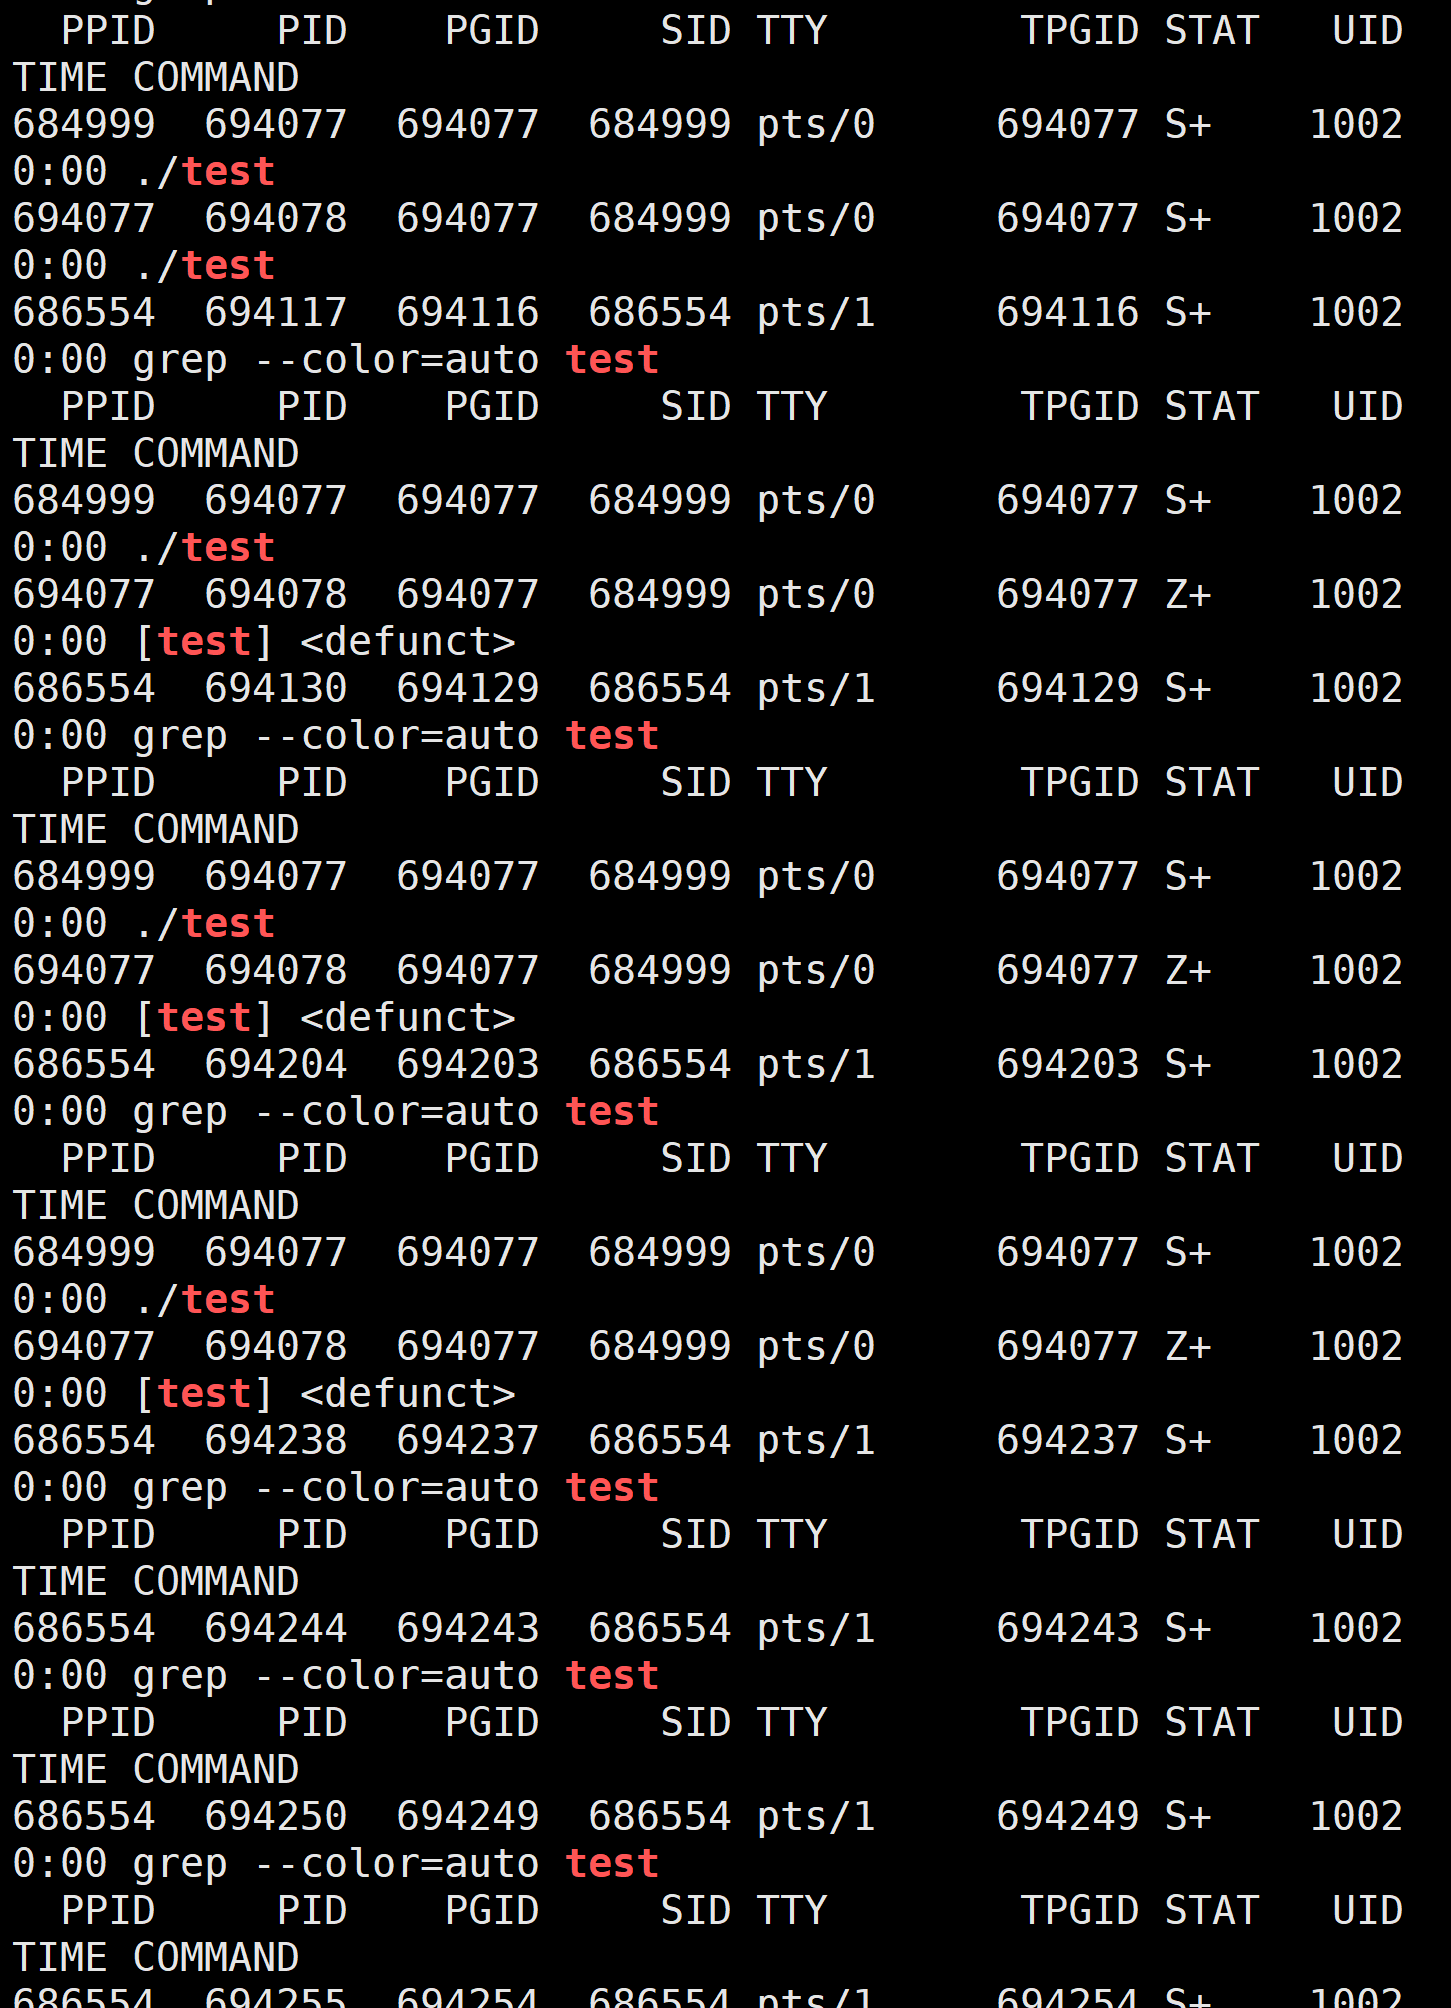
编译运行后,在另一个终端用while :; do ps axj|head -1 && ps axj|grep 程序名;sleep 1;done
监控,5 秒后你就能看到子进程的 STAT 列变成了 Z+。
6.2 僵尸进程的危害
进程的退出状态必须被维持下去,因为它要告诉关心它的进程(父进程):你交给我的任务,我办得怎么样了。可父进程如果一直不读取,那子进程就一直处于 Z 状态。
维护退出状态本身就是要用数据维护,也属于进程基本信息,所以保存在 task_struct(PCB)中。换句话说,Z 状态一直不退出,PCB 就一直要维护。
那一个父进程创建了很多子进程,就是不回收,是不是就会造成内存资源的浪费?是的!因为数据结构对象本身就要占用内存。想想 C 语言中定义一个结构体变量,是要在内存的某个位置开辟空间的。如果大量僵尸进程的 PCB 得不到释放,就会造成内存泄漏。
而且 PID 号也是有限的资源,如果僵尸进程太多,PID 号被占满,系统就无法创建新进程了。
6.3 如何避免僵尸进程
避免僵尸进程的方法主要有两种:
第一种,父进程通过 wait () 或 waitpid () 系统调用回收子进程。父进程调用 wait 后会阻塞,直到有子进程退出,然后读取子进程的退出状态,释放子进程的 PCB。
第二种,父进程先退出,这样子进程就变成了孤儿进程,被 init 进程收养,由 init 进程回收。这个我们下一节讲。
第三种,用信号处理。子进程退出时会给父进程发 SIGCHLD 信号,父进程可以注册 SIGCHLD 的信号处理函数,在处理函数里调用 waitpid 回收子进程。这样父进程不需要阻塞等待,可以继续做自己的事情。
七、孤儿进程(Orphan)------"无家可归" 的进程
7.1 什么是孤儿进程
父进程如果提前退出,那么子进程后退出,进入 Z 状态之后,该如何处理呢?
父进程先退出,子进程就称之为 "孤儿进程"。
孤儿进程被 1 号 init 进程(在较新的 Linux 发行版中是 systemd 进程)领养,当然要有 init/systemd 进程回收。
也就是说,当父进程先于子进程退出时,内核会把这个子进程的父进程设置为 init 进程(PID 为 1)。这样子进程退出的时候,init 进程会负责回收它,不会变成僵尸进程。
我们来看一段代码:
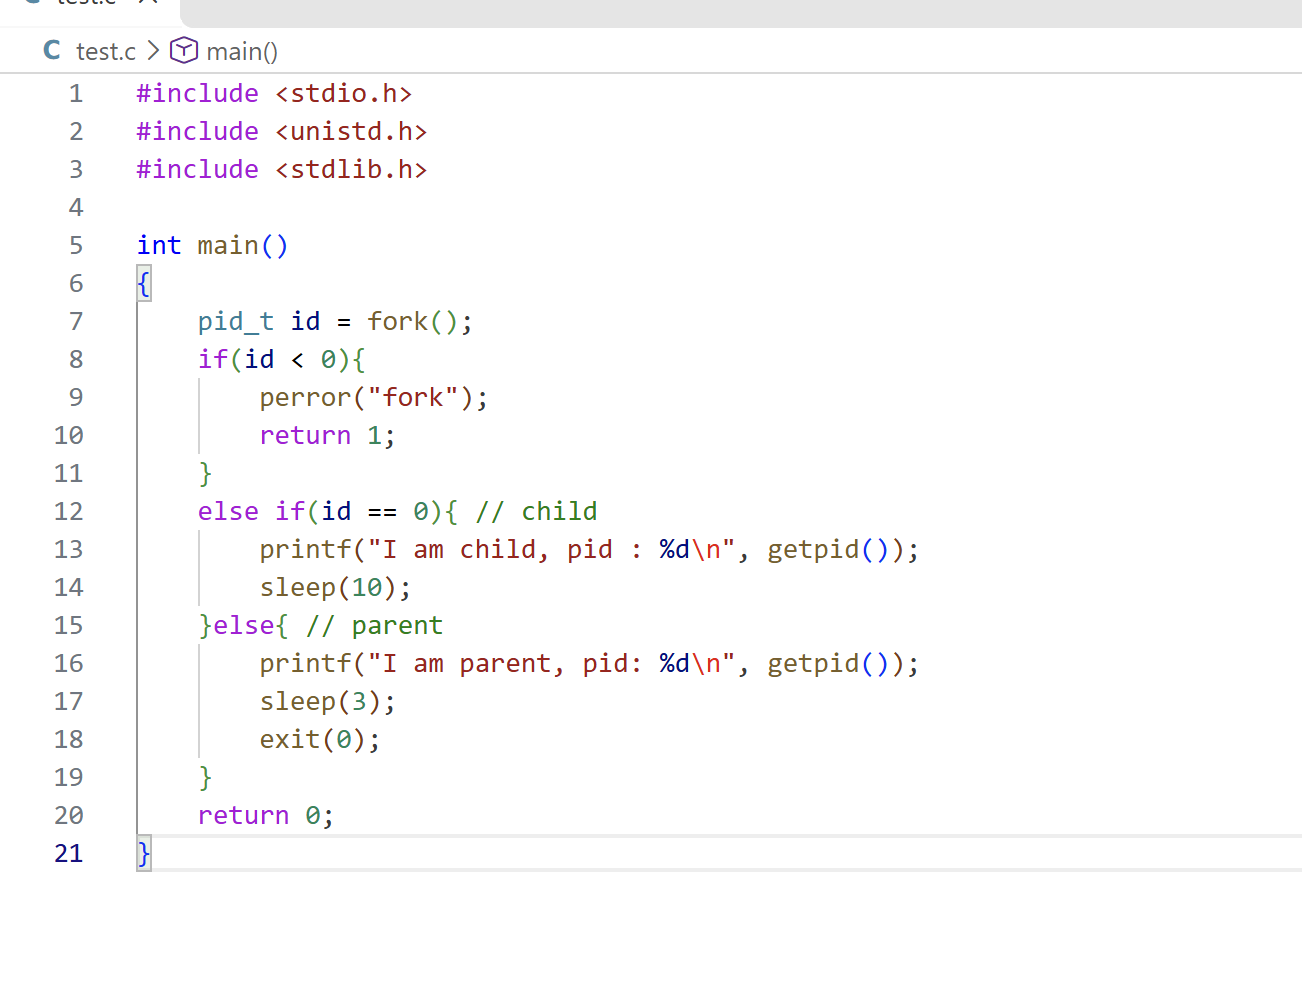
这段代码里,父进程运行 3 秒后退出,子进程运行 10 秒后退出。父进程退出后,子进程就变成了孤儿进程,被 init 收养。你可以在父进程退出后,查看子进程的 PPID,会发现它变成了 1。
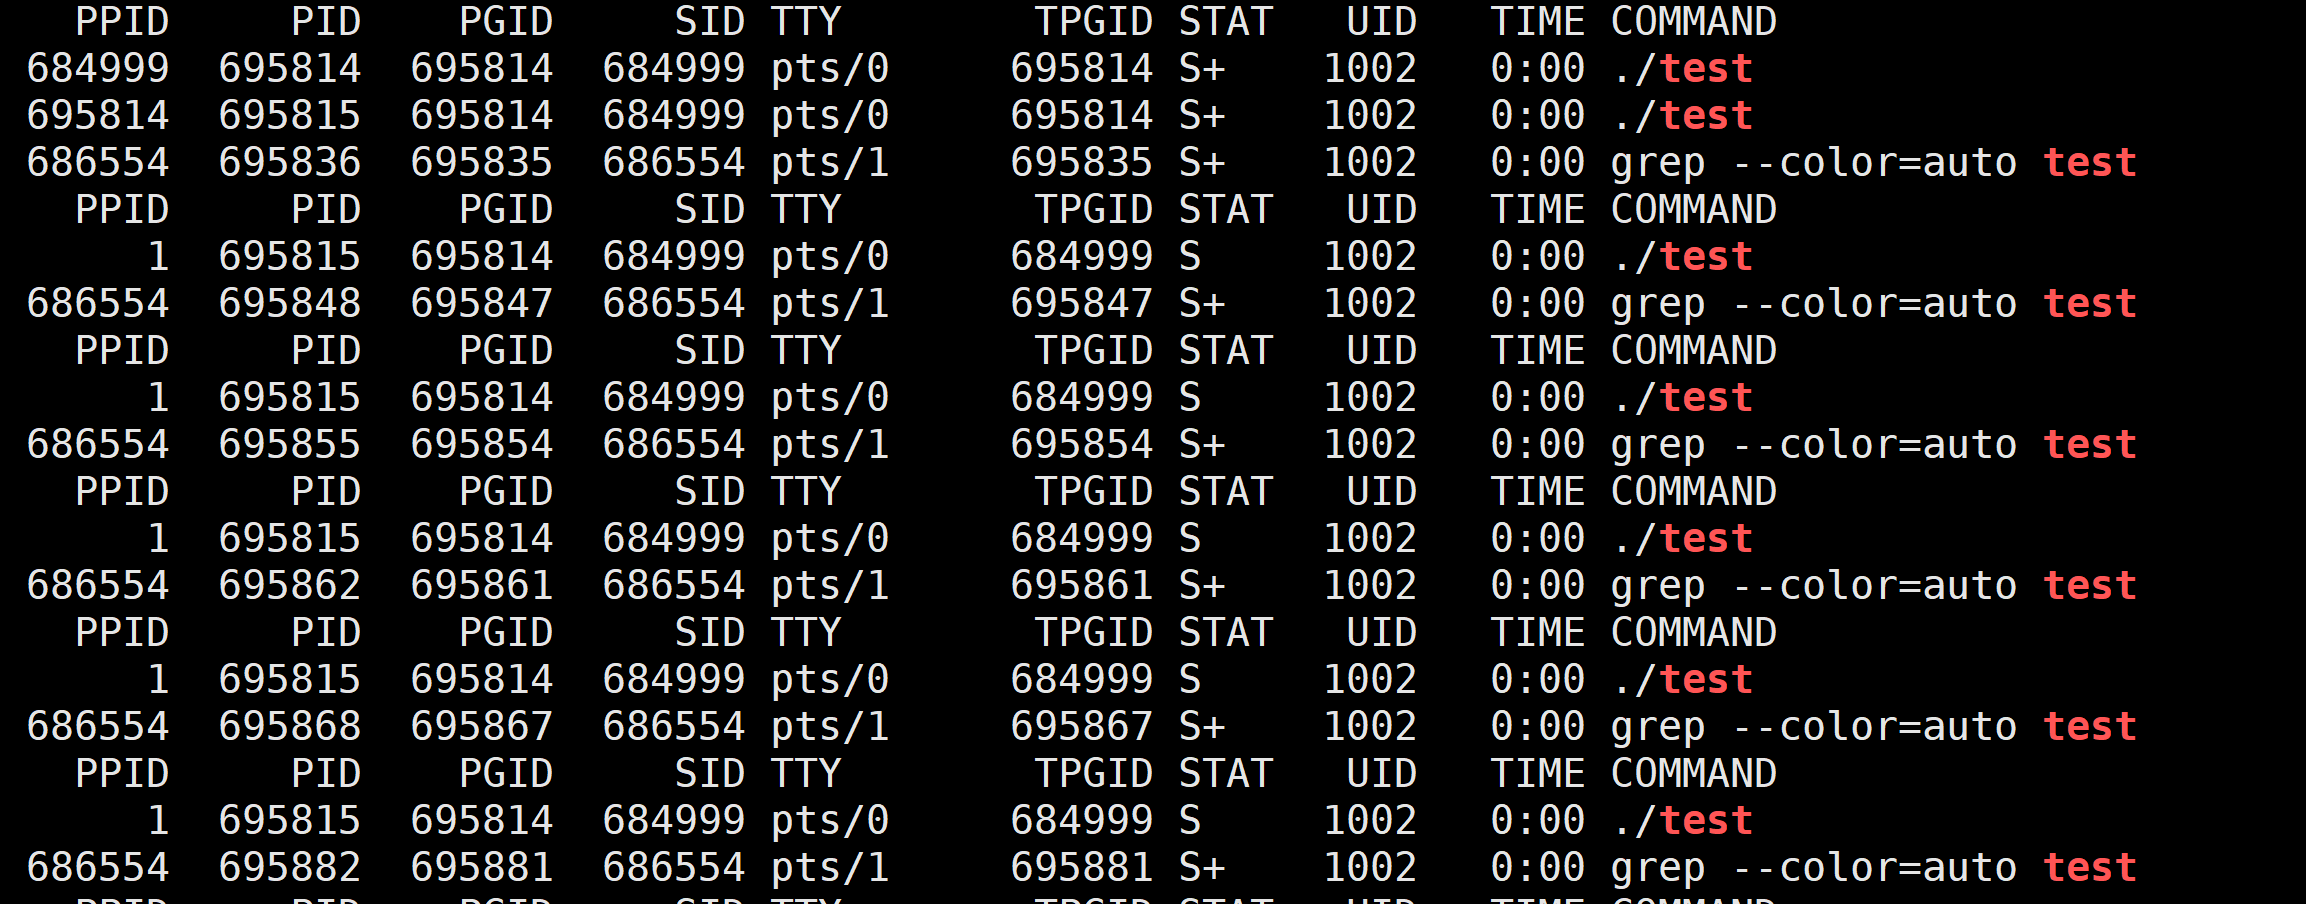
7.2 孤儿进程和僵尸进程的区别
很多同学容易把这两个概念搞混,我们来对比一下:
僵尸进程:子进程先退出,父进程还在运行但没有回收子进程。子进程的 PCB 还在,处于 Z 状态,需要父进程回收。 孤儿进程:父进程先退出,子进程还在运行。子进程被 init 收养,退出时由 init 回收,不会变成僵尸。
简单记:僵尸是 "孩子死了爹不收尸",孤儿是 "爹死了孩子还活着"。
僵尸进程是有危害的(内存泄漏),孤儿进程没有危害,因为 init 会负责回收。