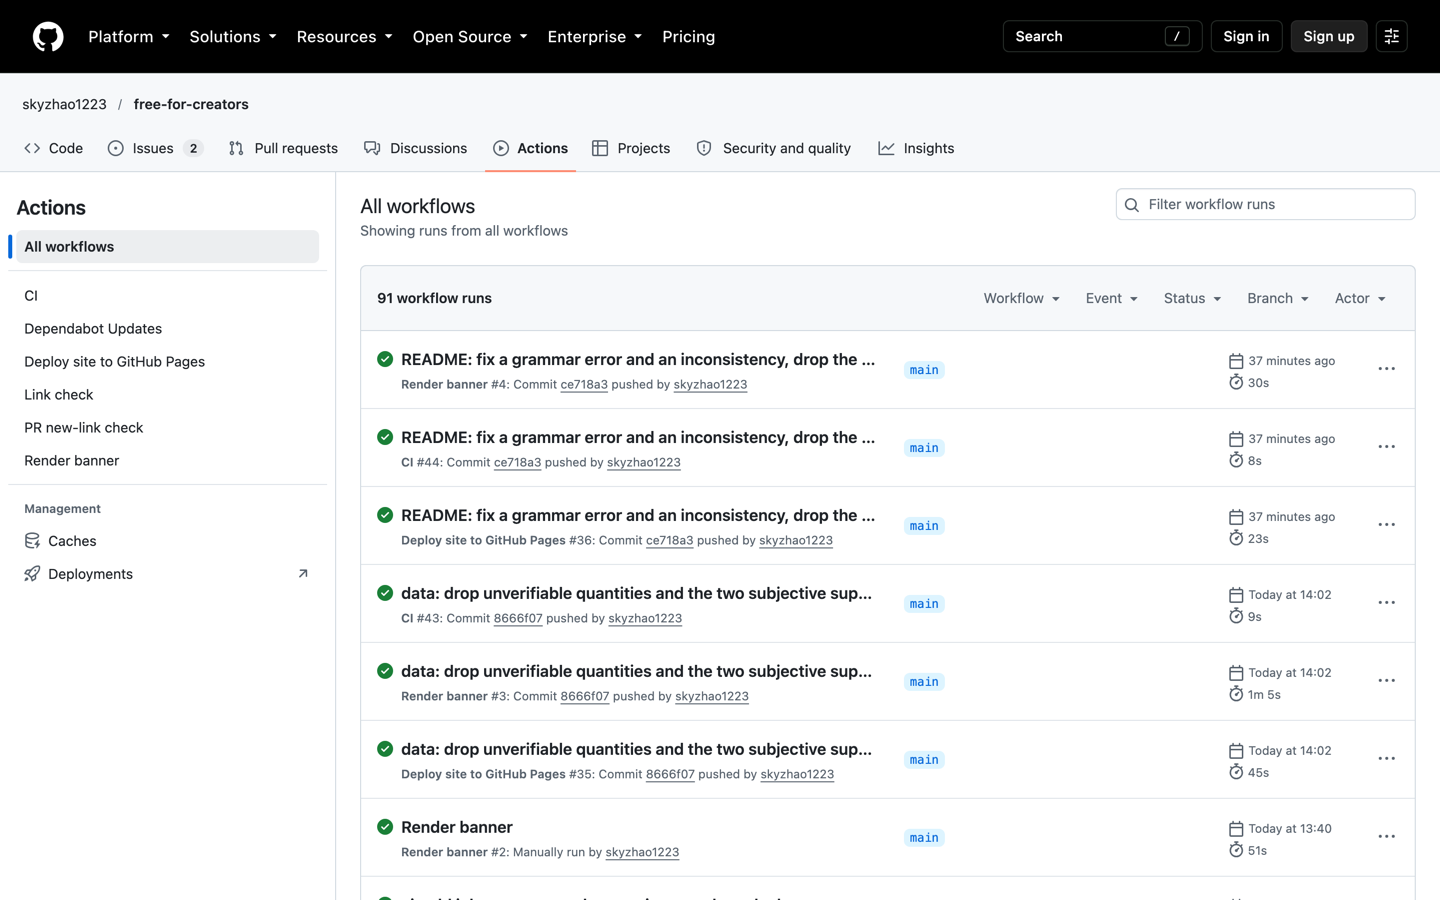
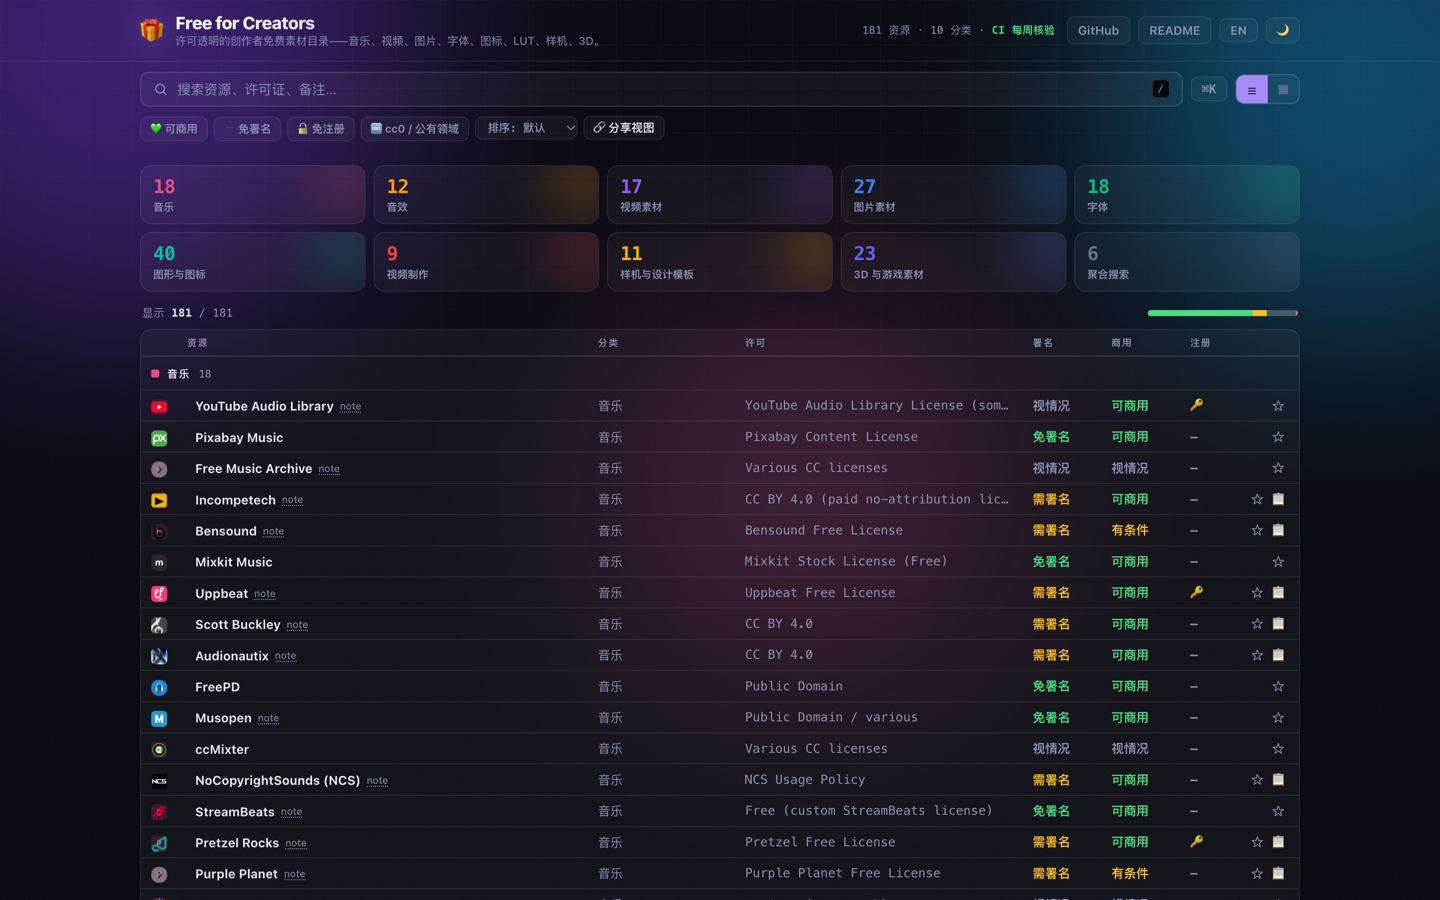
上一篇《181 个许可可核验的免费素材站》介绍了一份许可透明的创作者素材清单。这篇讲工程侧:一个清单类开源项目怎么抵抗时间------所有「自动化」都是仓库里正在跑的真实 workflow,踩坑也是真的。
一、清单类项目的三种死法
维护过 awesome-list 类项目的人都知道,敌人不是没 PR,而是时间:
- 死链。素材站倒闭、改版、换域名,一年后你收藏的清单里一半链接是 404。本仓库真删过一条:RocketStock 整个服务没了,链接检查 CI 把它揪出来直接下架。
- 许可悄悄变更。站点被收购、改名、换条款,「免费」悄悄变成「个人使用免费」。真实案例:Freepik 改名 Magnific 后,免费档的条款要重新逐条核对------这种事靠状态码根本发现不了。
- 数字精神分裂。README 说 158 个资源、横幅图上印着 148、仓库描述写着另一个数------三个「事实」各自漂移。这两个事故在本仓库都真实发生过。
对策只有一条:把所有会漂移的东西变成生成物,把所有生成物的输入收敛到唯一事实源,再用 CI 把两者钉死。
二、唯一事实源:一切从 data/*.json 生成
每个资源是 data/<分类>.json 里的一条结构化记录,字段枚举被 schema/entry.schema.json 钉死:
json
{
  "license_family": ["cc0", "permissive", "cc-by", "site-free", "mixed", "noncommercial"],
  "attribution":    ["required", "not-required", "varies"],
  "monetization":   ["allowed", "conditional", "varies", "not-allowed"],
  "signup":         ["required", "not-required", "optional", "unknown"]
}
受控枚举的价值在录入端:贡献者没法写出「大概可以商用吧」这种字段值,只能在四选一里挑;拿不准就选 varies------过度声明 allowed 是这类仓库唯一不可饶恕的错误,schema 把「保守」变成了默认路径。
在唯一事实源之上,以下东西全部是生成物:
- 中英双语 README(
build_readme.py,含每分类计数、「一眼看数据」统计); - 网站全部数据接口 + 无 JS 静态镜像
all.html(build_site.py); - 横幅图/社交预览图上的资源计数(脚本直接往 HTML 母版里 stamp 数字);
- 甚至 GitHub 仓库描述本身(
build_readme.py --description,见第五节的踩坑)。
CI 里有一条铁律检查:python scripts/build_readme.py --check------改了数据没重新生成 README?红给你看。数字从机制上不可能精神分裂。
三、每周体检:链接检查远比你想的复杂
每周一 06:00 UTC,GitHub Action 全量检查所有 URL。难点在于:状态码会说谎 。这是 linkcheck.py 里真实的判定逻辑:
text
* soft 404  --- HTTP 200,但页面自己的 <title>/<h1> 写着 "not found"  → broken
* JS 壳     --- HTTP 200,但整个 body 里既无 <title> 也无 <h1>          → blocked
              (pretzel.rocks/library 就是这样"健康"了半年,
               浏览器里实际渲染的 h1 是 "Page not found")
* 跨域重定向 --- 302 跳到另一个注册域                                  → blocked
              (freepik.com → magnific.com 这种改名必须人来复核,
               不能静默算 ok)
几个工程细节:
- GET 优先、HEAD 兜底:软 404 判定需要 body,HEAD 只能拿状态码;
- 拒连先重试再判死:偶发 connection refused 不该误杀一条资源;
- blocked ≠ broken:被 WAF 拦(403/429/验证码)的站点单独归类,不自动下架,写进报告等人裁决;
- 失败自动开 issue :workflow 用
actions/github-script找已有的link-check标签 issue 更新正文,而不是每次刷屏开新 issue。
四、PR 门禁:坏数据进不了主干
每个 PR 要过四道关:
- schema 校验 + 跨字段一致性 :
license_family: noncommercial必须配monetization: not-allowed;cc0却要求署名?直接打回。字段之间互相作证; - README 同步检查:就是第二节那条铁律;
- URL 规范化去重 :小写 scheme/host、去 www、去尾斜杠后比对------但 query 故意保留,因为真有两条资源只差一个
?type=audio(kenney.nl 案例); - 机器人查链 :PR 里新增的 URL 先被
pr_linkcheck实时检查,结果以评论形式贴回 PR,❌ 直接 block 合并。
另外有一条容易忽略的黑名单:出站 URL 禁止携带 tracking 参数 。utm_source、fbclid、aff 等 20 多个参数名在 schema 校验层直接报错------清单里的链接必须是干净的,这本身也是「可信」的一部分。
五、踩坑实录:GITHUB_TOKEN 改不了仓库元数据
仓库描述里带资源计数,数据一涨它就过期(158 vs 181 的事故现场)。于是加了个 sync-description job:push 到 main 时重新生成描述并 PATCH 回去。
第一版想当然写了:
yaml
permissions:
  contents: read
  administration: write   # ← workflow 权限里根本没有这个键
结果 CI 0 秒失败 ------连 job 都没起。教训一:GITHUB_TOKEN 的权限键是一个封闭集合(contents/issues/pages/...),仓库元数据(描述、topics)属于 Administration,是 fine-grained PAT 的领域,workflow 权限表里不存在。
第二版改成「检测漂移 + 可选 PAT + 响亮失败」:
yaml
env:
  GH_TOKEN: ${{ secrets.REPO_ADMIN_PAT || github.token }}
run: |
  want="$(python3 scripts/build_readme.py --description)"
  have="$(gh repo view "$GITHUB_REPOSITORY" --json description --jq .description)"
  [ "$want" = "$have" ] && exit 0
  # 配了 PAT:直接 PATCH;PATCH 失败说明 PAT 过期/权限不对 → exit 1(可行动的失败)
# 没配 PAT:GITHUB_TOKEN 注定改不动 → 打 ::warning 并给出一行手动修复命令,exit 0教训二:CI 失败必须「可行动」。「没配 PAT」不是推送者的错,报 error 只会让主干常红、警报疲劳;报 warning + 给出复制即用的修复命令,才是维护者友好。而「配了 PAT 但 PATCH 被拒」一定是过期或权限错------这种失败就该拦住。
六、部署产物不进 git:一个自证死锁
sitemap.xml 的 <lastmod> 来自「最后一次触及 data/ 的 commit 日期」。如果把生成物提交进 git,就会出现死锁:重新生成 sitemap 的那个 commit 本身就触及了 data/,于是提交进去的 lastmod 永远比 CI 现算的旧一格------每次数据变更都会 fail 自己的同步检查。
build_site.py 文档里那句总结值得裱起来:
A derived file whose inputs include its own commit belongs in the build, not in git.
(输入包含「它自己所在 commit」的派生文件,属于构建过程,不属于版本库。)
配套还有一个浅克隆陷阱:CI 里 git log -1 -- data/ 在 shallow clone 下会把 HEAD 谎报成唯一根 commit,lastmod 就错了------所以两个 workflow 都显式 fetch-depth: 0。
七、不确定是一等公民
signup 字段有一个合法枚举值:unknown。核验不了的(登录墙、区域屏蔽、bot 检测)如实标 ❓,并汇总成 good first issue 让社区用真实浏览器(无痕窗口)逐个核验------目前挂着 8 个站。宁可显示「不知道」,也不显示猜的:清单的信用比完整性值钱。
八、效果
- 181 条资源 · 0 死链 · 每周一自动体检,失败自动开 issue;
- README(双语)、网站、横幅计数、仓库描述全部生成,数字永远一致;
- 数据整体 CC0,结构化 JSON 随便复用。
九、链接
- 上一篇(资源清单本体 + 93 个零门槛站表格):181 个许可可核验的免费素材站
- 仓库(数据 + 全部 workflow,CC0):https://github.com/skyzhao1223/free-for-creators
- 网站:https://skyzhao1223.github.io/free-for-creators/?utm_source=csdn-tech
- Hacktoberfest 进行中:#9 核验 8 个站的注册要求、#10 自动化横幅渲染
如果这套「防腐」思路对你的清单/文档类项目有用,欢迎去仓库点个 ⭐,或者把你维护 awesome-list 的踩坑写进 Discussions。
(全文完)