本篇目标:
掌握list部分接口的实现
一.list类的底层实现
1.搭建框架
在实现 list 的各个接口之前,我们需要先确定它的底层结构:元素如何保存?节点之间如何连接?整个链表又由谁来管理?
与 vector 使用连续空间保存元素不同,list 可以通过一个个独立的节点保存元素 ,再利用指针将这些节点连接起来。本篇采用的是带头双向循环链表,下面从节点和链表两个层面搭建框架。
1.1.list_nodo类
链表中的一个节点,除了保存数据,还需要记录相邻节点的位置。因此,我们将这些信息封装到 list_node 中:
cpp
template<class T>
struct list_node
{
    list_node<T>* _next;  // 指向后一个节点
    list_node<T>* _prev;  // 指向前一个节点
    T _val;              // 保存当前节点的数据
};
将数据和连接关系封装在一起,每个节点就成为一个完整的存储单元。 后续插入元素时,只需要创建一个节点并建立连接;删除元素时,只需要断开连接并释放节点。
这里使用模板,是因为 list 需要保存不同类型的数据。例如:
cpp
list_node<int>      // 保存 int 的节点
list_node<string>   // 保存 string 的节点
_next 和 _prev 都指向相同类型的节点,因此不同节点可以依次连接成双向链表。
节点的构造函数负责初始化这三个成员:
cpp
list_node(const T& x = T())
    : _next(nullptr),
      _prev(nullptr),
      _val(x)
{ }其中,_val(x) 用传入的数据初始化节点中的元素;两个指针先初始化为空,等节点插入链表时,再设置它们的连接关系。
需要注意:创建节点和将节点连接到链表,是两个不同的过程。
1.2.list类
list_node 负责表示一个节点 ,而 list 负责管理整个链表。
例如,插入、删除、遍历以及释放所有节点,都属于整个容器的操作,因此这些接口应该放在 list 类中。
cpp
template<class T>
class list
{
    typedef list_node<T> Node;

private:
    Node* _head;
    size_t _size;        //表示有效节点的个数
};
这里通过 typedef 将 list_node<T> 简写为 Node,方便后续编写代码。_head 则保存头节点的地址,我们可以从它出发访问链表中的其他节点。
也就是说,节点负责保存元素和连接关系,list 类负责维护这些节点组成的容器。
1.3.带头节点
但是这里我们要选择带头节点的链表。
这里的"头节点"是一个额外的哨兵节点 ,它不代表用户插入的有效元素。
如果使用不带头节点的链表,空链表通常没有任何节点。此时,插入第一个节点、删除第一个节点等操作,往往需要额外处理链表入口的变化。
加入头节点后,即使没有任何有效元素,链表中也始终存在一个固定的节点。这样,空链表也具有可以操作的连接位置。
例如,在两个相邻节点之间插入新节点时,需要连接:
-
前一个节点与新节点;
-
新节点与后一个节点。
有了头节点,首尾位置也能按照相同的方式处理。 在第一个元素前面插入时,前一个节点就是头节点;在最后一个元素后面插入时,后一个节点也可以是头节点。
这让后续的插入和删除代码更加统一,减少了针对首尾位置的特殊判断。
不过,头节点只是帮助管理链表,它不能计入有效元素数量,也不能作为普通元素被访问或删除。
1.4.双向循环链表
"双向"表示每个节点既能找到后一个节点,也能找到前一个节点:
cpp
_next  // 找到后一个节点
_prev  // 找到前一个节点
这样不仅可以向后遍历,也可以向前遍历。删除一个已知位置的节点时,还能直接找到它的前驱,方便修改两侧节点的连接关系。
"循环"则表示链表首尾通过头节点连接起来:
cpp
_head->_next  // 指向第一个有效节点
_head->_prev  // 指向最后一个有效节点
对于非空链表:
cpp
第一个有效节点的 _prev 指向头节点
最后一个有效节点的 _next 指向头节点
因此,遍历完最后一个元素后,就会重新到达头节点。
循环结构让头节点同时连接链表的首尾。 我们可以通过 _head->_next 找到第一个元素,通过 _head->_prev 找到最后一个元素,方便实现头插、尾插、头删和尾删。
带头节点和循环结构并不是链表必须采用的形式,而是本篇为了统一接口实现所选择的设计。
5. 初始化
构造函数中,我们先创建头节点,再让它的两个指针都指向自身:
cpp
list()
{
    _head = new Node;
    _head->_next = _head;
    _head->_prev = _head;
    _size=0;
}
因为刚构造出的链表没有有效元素,所以头节点后面没有其他节点,前面也没有其他节点。让它指向自己,就能保持循环结构:
cpp
_head->_next == _head;
_head->_prev == _head;
这也提供了判断空链表的方法:
cpp
_head->_next == _head当我们插入第一个有效节点时,头节点的 _next 和 _prev 都会指向这个新节点,而新节点的 _next 和 _prev 都会指回头节点。
当最后一个有效节点被删除后,头节点又恢复为前后都指向自身的状态。
后续实现迭代器时,也可以让 begin() 指向 _head->_next,让 end() 指向 _head。空链表中两者指向同一个节点,自然满足 begin() == end()****。
另外,这份简化实现中的头节点也包含一个 T 类型的成员,new Node 会使用 T() 初始化它,但这个值不参与元素操作。因此,这份写法要求 T 能够默认构造;这是当前模拟实现的限制,并不是标准 list 对所有元素类型的统一要求。
至此,链表的存储框架就搭建好了。接下来,各个接口的实现,本质上就是在维护节点数据的同时,正确建立、修改或解除节点之间的连接关系。
2.push_back接口
前面我们已经搭建好了 list 的基本框架,但此时链表中只有一个头节点,还没有保存任何有效元素。接下来,就需要提供插入接口,让用户能够将数据放入链表。
其中,push_back 用于在链表尾部插入一个新元素。例如:
cpp
kong::list<int> lt;
lt.push_back(1);
lt.push_back(2);
lt.push_back(3);
执行后,链表中的有效元素依次为 1、2、3。
那么,如何找到尾部的插入位置呢?
由于我们采用的是带头双向循环链表,头节点的 _prev****就指向最后一个节点,而最后一个节点的 _next****指向头节点。 因此,尾插实际上就是把新节点插入到"原来的尾节点"和"头节点"之间。
实现时,可以先保存原来的尾节点,再创建新节点:
cpp
Node* tail = _head->_prev;
Node* newnode = new Node(x);
随后建立四处连接:
cpp
tail->_next = newnode;
newnode->_prev = tail;

newnode->_next = _head;
_head->_prev = newnode;
这样,新节点就成为了链表中最后一个有效节点,同时仍然保持双向循环结构。
如果链表为空,也可以使用相同的处理方式。 此时 tail 就是头节点,上面的操作会让头节点的 _next 和 _prev 都指向新节点,而新节点的两个指针都指回头节点,不需要额外编写空链表的插入逻辑。
由于可以直接通过 _head->_prev 找到尾节点,整个尾插过程不需要遍历链表,通常记为 O(1)。
完整代码:
cpp
void push_back(const T& x)
{
	Node* tail = _head->_prev;
    Node* newnode = new Node(x);

	tail->_next = newnode;
    newnode->_prev = tail;

    newnode->_next = _head;
    _head->_prev = newnode;

	_size++;
}
3.迭代器
实现 push_back 后,我们已经能够向链表中插入元素。那么,如何依次访问这些元素呢?
当然,我们可以从第一个节点出发,通过 _next 不断找到下一个节点。但是,如果每次遍历都要直接操作节点指针,用户就必须了解链表的内部结构,使用起来不够方便。
因此,我们需要提供迭代器,将节点指针和遍历操作封装起来,让用户能够通过熟悉的方式访问元素:
cpp
auto it = lt.begin();
while (it != lt.end())
{
    cout << *it << " ";
    ++it;
}这里,*it 用于访问当前元素,++it 用于移动到下一个元素。用户只需要操作迭代器,就能够完成遍历。
3.1 为什么不能直接使用原生指针?
对于 vector,元素存储在连续空间中,指针加一就能找到下一个元素,因此原生指针可以作为迭代器的一种实现方式。
但是,链表的不同节点不保证存储在连续空间中 。对节点指针执行 ++,并不能找到链表中的下一个节点。我们必须通过节点保存的 _next 或 _prev 指针进行移动。
所以,需要封装一个 list_iterator 类,通过运算符重载,让它具有类似指针的使用方式,而内部执行的仍然是链表节点之间的跳转。
3.2 迭代器需要保存什么?
迭代器需要知道自己当前指向哪个节点,因此只需要保存一个节点指针:
cpp
Node* _node;构造函数接收节点地址,让迭代器指向指定节点:
cpp
list_iterator(Node* node)
    : _node(node)
{ }
为了方便使用,我们仍然typedef一下:
cpp
typedef list_node<T> Node;      // 当前链表的节点类型
typedef list_iterator<T> Self;  // 当前迭代器自身的类型
3.3 如何让迭代器像指针一样使用?
接下来,通过运算符重载,将用户的操作转换成对应的节点操作:
| 用户操作 | 迭代器内部的行为 |
|---|---|
*it |
返回当前节点中的 _val |
++it |
移动到 _next,返回移动后的迭代器 |
it++ |
保存原来的迭代器,再移动到 _next,返回原来的迭代器 |
--it |
移动到 _prev,返回移动后的迭代器 |
it-- |
保存原来的迭代器,再移动到 _prev,返回原来的迭代器 |
it != other |
判断两个迭代器是否指向不同节点 |
其中,解引用运算符返回 T&,既可以读取元素,也可以通过迭代器修改元素:
cpp
*it = 10;前置和后置运算符的区别,则与内置类型保持一致:前置返回修改后的对象,后置返回修改前的副本。 后置版本中的 int 参数只是用于区分这两个重载。
3.4 遍历的起点和终点
对于带头双向循环链表,第一个有效节点是 _head->_next ,因此 begin() 应返回指向该节点的迭代器。
而头节点不保存有效元素,可以将它作为遍历结束的位置,因此 end() 返回指向 _head 的迭代器。
当迭代器经过最后一个有效节点,再执行一次 ++ 时,就会到达头节点,此时满足 it == end(),遍历结束。
如果链表为空,_head->_next 本身就是 _head,所以 begin() 与 end() 指向同一个节点,循环不会进入。
这样,我们就将链表内部的节点跳转,封装成了统一的迭代器操作,为后续的遍历以及插入、删除接口提供了基础。
cpp
template<class T>
struct list_iterator
{
public:
	typedef list_node<T> Node;
	typedef list_iterator<T> Self;
	Node* _node;
public:
	list_iterator(Node*node)
		:_node(node)
	{ }

	T& operator*()
	{
		return _node->_val;
	}
	//++it;
	Self& operator++()
	{
		_node = _node->_next;
		return *this;
	}
	//it++
	Self operator++(int)
	{
		Self tmp(*this);
		_node = _node->_next;
		return tmp;
	}
	//--it;
	Self& operator--()
	{
		_node = _node->_prev;
		return *this;
	}
	//it--
	Self operator--(int)
	{
		Self tmp(*this);
		_node = _node->_prev;
		return tmp;
	}
	bool operator!=(const Self& it)
	{
		return _node != it._node;
	}
};
在list中我们需要typedef一下,即:
cpp
typedef list_iterator<T> iterator;begin和end的实现:
cpp
iterator begin()
{
	return iterator(_head->_next);
}
iterator end()
{
	return iterator(_head);
}
4.insert接口
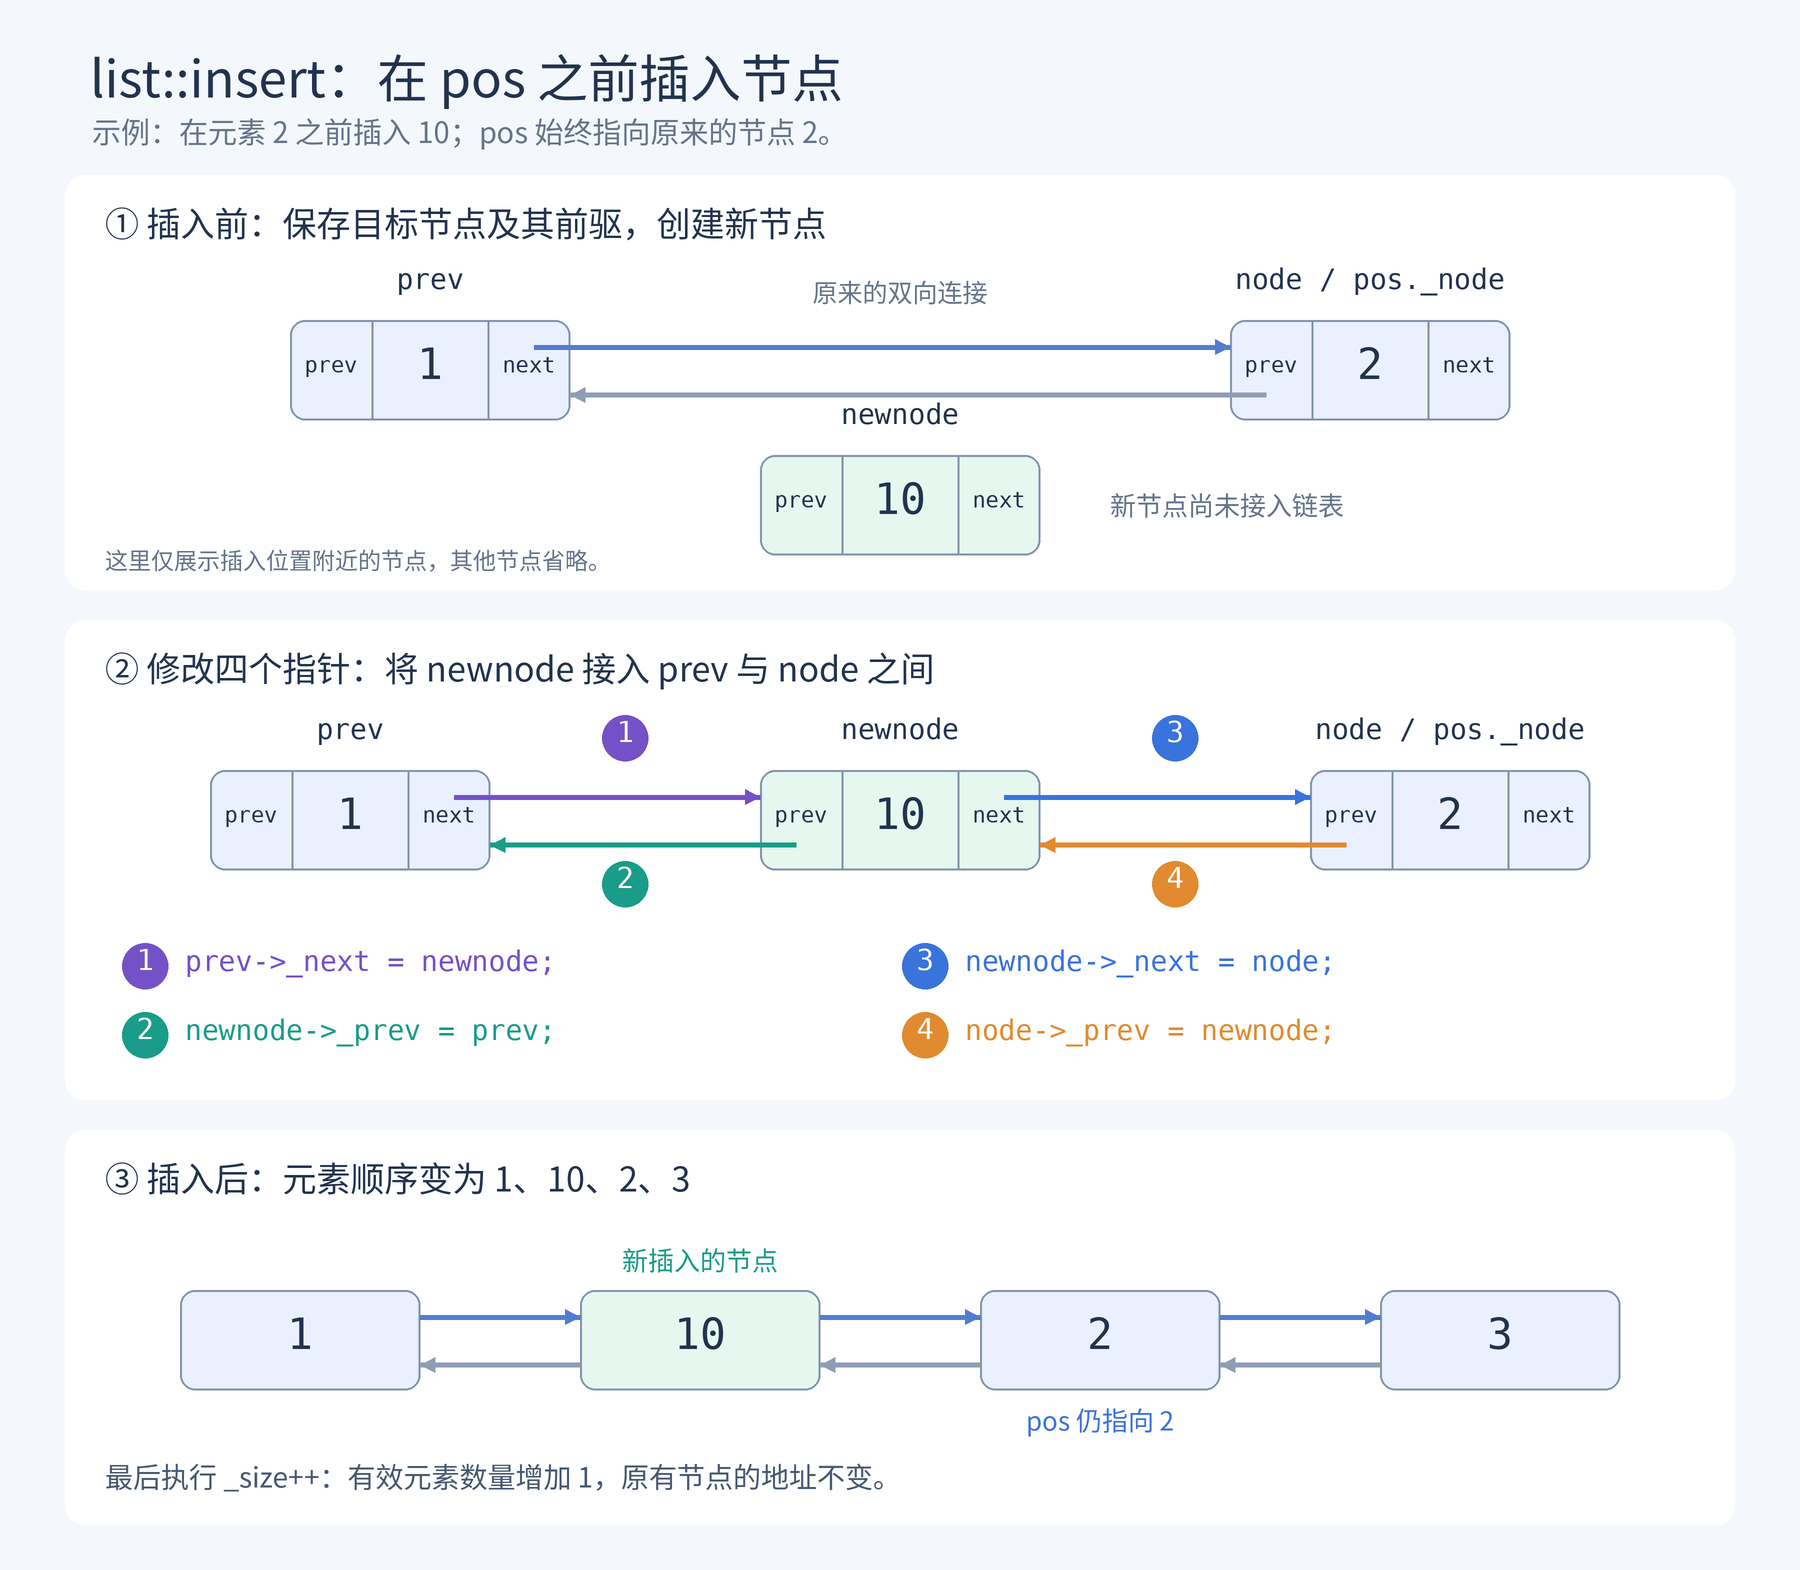
前面实现的 push_back 只能在链表尾部插入元素。如果我们想在某个元素之前插入新数据,就需要提供 insert 接口。
insert(pos, x)的作用是:在迭代器 **pos**指向的节点之前,插入一个值为 x****的新节点。 例如:
cpp
// 原来的元素:1 2 3
auto it = lt.begin();
++it;               // it 指向元素 2
lt.insert(it, 10);

// 插入后的元素:1 10 2 3
与 vector 插入时可能需要移动后续元素不同,链表只需要创建一个新节点,并修改插入位置附近的指针。
首先创建新节点,再通过迭代器找到目标节点及其前驱:
cpp
Node* newnode = new Node(x);
Node* node = pos._node;
Node* prev = node->_prev;此时,prev 和 node 原本是相邻节点,我们要将 newnode 插入它们之间。
双向链表需要同时维护前后两个方向,因此要修改四个指针:
cpp
prev->_next = newnode;  // 前驱的后继改为新节点
newnode->_prev = prev;  // 新节点的前驱指向原前驱
newnode->_next = node;  // 新节点的后继指向目标节点
node->_prev = newnode;  // 目标节点的前驱改为新节点
整个过程没有移动原来的节点,因此指向原有节点的迭代器仍然有效。
带头双向循环链表的优势,在这里就体现出来了:
-
pos == begin():在第一个元素之前插入,相当于头插。 -
pos == end():在头节点之前插入,相当于尾插。 -
链表为空时:
begin()和end()都指向头节点,仍然可以使用相同的连接方式插入第一个元素。
因此,头插、尾插以及中间插入,都可以统一使用这套逻辑。前面的 push_back 和后续的push_front也可以直接复用它:
cpp
void push_back(const T& x)
{
    insert(end(), x);
}
cpp
void push_front(const T& x)
{
	insert(begin(), x);
}
由于迭代器已经确定了插入位置,不需要遍历链表,插入操作的时间复杂度通常记为 O(1)。
完整代码:
cpp
//在pos之前插入节点
void insert(iterator pos, const T& x)
{
	Node* newnode = new Node(x);
	Node* node = pos._node;
	Node* prev = node->_prev;

	prev->_next = newnode;
	newnode->_prev = prev;
	newnode->_next = node;
	node->_prev = newnode;
	_size++;
}
流程图:
5.erase接口
5. erase 接口的引入与实现
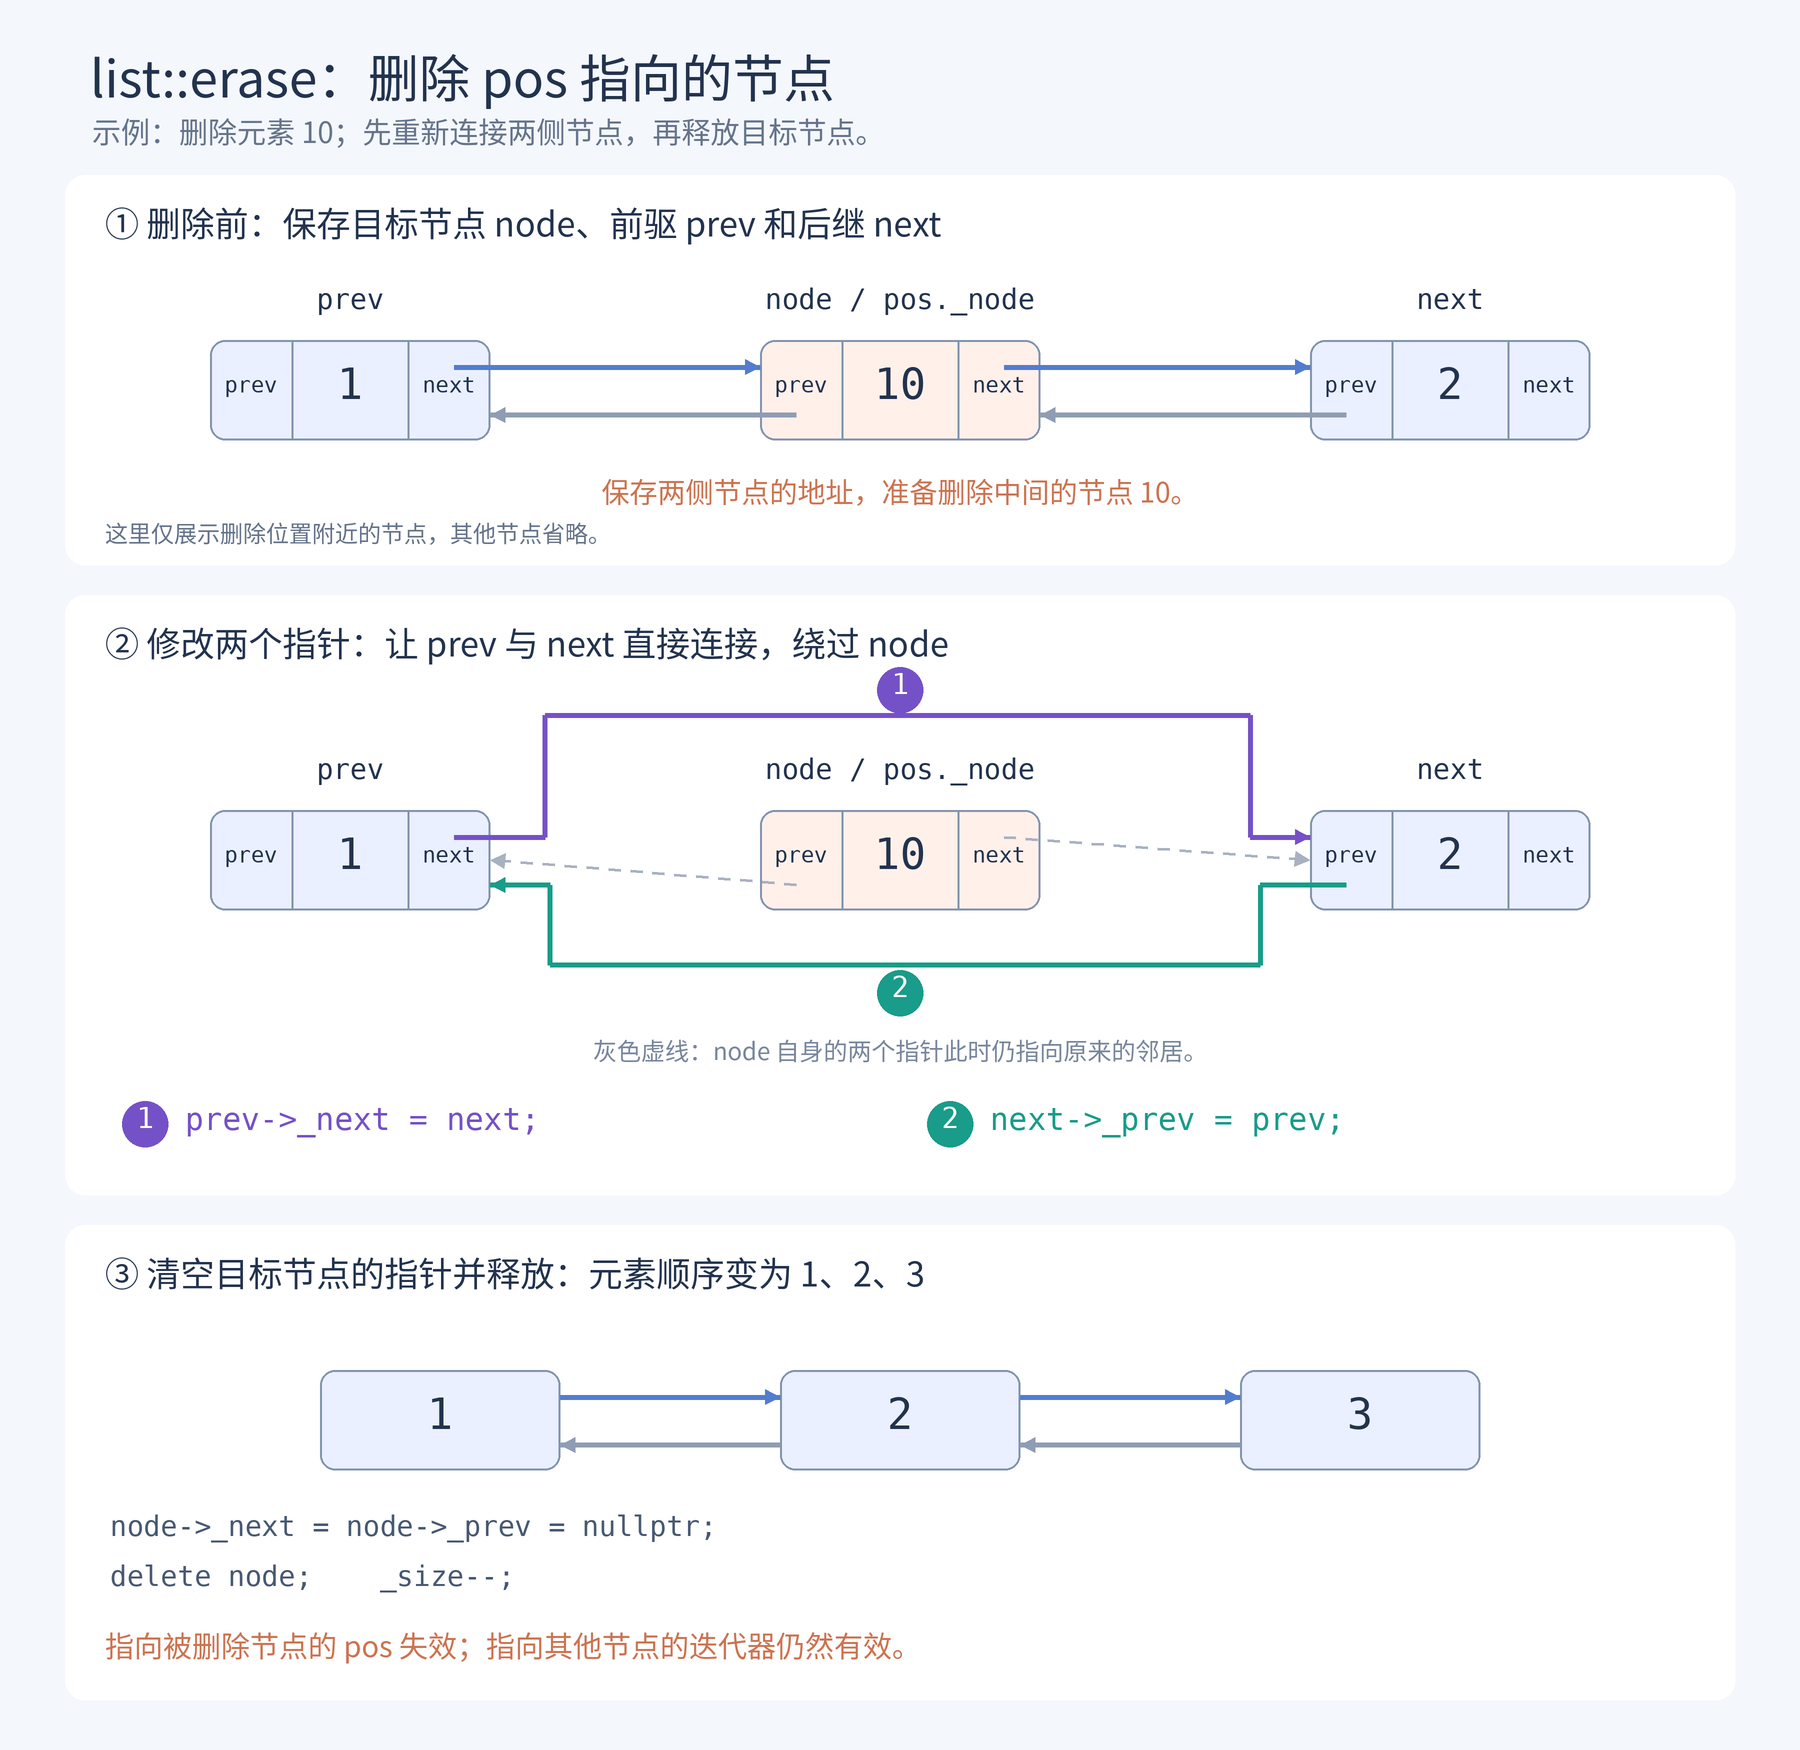
前面通过 insert,我们已经能够在指定位置插入元素。如果想删除某个位置的元素,就需要提供 erase 接口。
erase(pos)的作用是:删除迭代器 **pos**指向的节点。 例如,链表中的元素为 1、10、2、3,让 pos 指向 10,执行删除后,元素顺序就变为 1、2、3。
对于双向链表,删除节点不需要移动其他元素,只需要让目标节点的前驱和后继重新连接,再释放目标节点。
首先,判断目标节点是否为头节点:
cpp
assert(pos._node != _head);头节点负责维护链表结构,不属于有效元素,因此不能删除。这也意味着,不能将 end() 传给 erase。
接着,保存目标节点及其前后两个节点的地址:
cpp
Node* node = pos._node;
Node* prev = node->_prev;
Node* next = node->_next;
先保存这些地址,才能在释放目标节点之前,正确修改两侧节点的连接关系。
原来,prev 和 next 通过 node 连接。删除时,让它们直接连接,绕过目标节点:
cpp
prev->_next = next;
next->_prev = prev;
第一句修改向后的连接,使前驱的 _next 指向后继;第二句修改向前的连接,使后继的 _prev 指向前驱。
执行完这两句,目标节点就已经从链表的有效连接中移除了。
接下来,将目标节点内部的两个指针置空,再释放节点,最后更新元素数量:
cpp
node->_next = node->_prev = nullptr;
delete node;
_size--;
其中,置空指针是这份代码中的整理操作,真正释放节点空间的是 delete node。
需要注意,置空的是节点内部的 _next****和 _prev**,并不会将外部迭代器中的指针置空。** 节点被释放后,指向该节点的迭代器就失效了,不能再通过它访问元素或执行递增、递减操作。指向其他节点的迭代器仍然有效。
由于采用带头双向循环链表,删除首尾节点时,同样不需要额外处理:
-
删除第一个有效节点时,
prev是头节点,修改后头节点的_next指向新的第一个节点。 -
删除最后一个有效节点时,
next是头节点,修改后头节点的_prev指向新的尾节点。 -
删除唯一的有效节点时,
prev和next都是头节点,修改后头节点的两个指针重新指向自身,链表恢复为空。
因此,无论删除首节点、尾节点还是中间节点,都可以复用同一套操作。对于已经确定位置的节点,删除操作的时间复杂度通常记为 O(1)。
所以pop_back和pop_front的实现就可以复用erase了,代码如下:
cpp
void pop_back()
{
	erase(--end());
}

void pop_front()
{
	erase(begin());
}
完整代码:
cpp
void erase(iterator pos)
{
	assert(pos._node != _head);
	Node* node = pos._node;
	Node* prev = node->_prev;
	Node* next = node->_next;

	prev->_next = next;
	next->_prev = prev;
	node->_next = node->_prev = nullptr;
	delete node;
	_size--;

}
流程图:
6.构造函数
list的构造可以实现好几种,就挑比较常用的来模拟实现吧!
首先是拷贝构造,传入的参数仍然是用const修饰的,但是我们要注意,要先初始化一下*this,所以我们可以将默认构造里面的代码封装成一个函数,如下:
cpp
void empty_init()
{
	_head = new Node;
	_head->_next = _head;
	_head->_prev = _head;
	_size = 0;
}
拷贝构造函数如下:
cpp
list(const list<T>& lt)
{
	empty_init();	//先初始化
	for (auto& x : lt)
	{
		push_back(x);
	}
}
但是这里又出现了一个新的问题,那就是这传的是const修饰的lt啊,所以我们需要一个const版的迭代器,因为我们是不可以修改lt里面的值的,而普通迭代器是可以的,那么我们就自然的想到了*it应该要变成无法修改的对象,那么这个修改目前我们先不用管,等下7.迭代器的优化中会讲的。
7.迭代器的优化
7.1.const_iterator
通过上面的认识,我们意识到了需要一个const版的迭代器,那么实现起来也是很简单,就需要在迭代器中的赋值重载*的返回值变为const T&,代码如下:
cpp
template<class T>
struct const_list_iterator
{
public:
	typedef list_node<T> Node;
	typedef const_list_iterator<T> Self;
	Node* _node;
public:
	const_list_iterator(Node* node)
		:_node(node)
	{
	}

	const T& operator*()
	{
		return _node->_val;
	}
	//++it;
	Self& operator++()
	{
		_node = _node->_next;
		return *this;
	}
	//it++
	Self operator++(int)
	{
		Self tmp(*this);
		_node = _node->_next;
		return tmp;
	}
	//--it;
	Self& operator--()
	{
		_node = _node->_prev;
		return *this;
	}
	//it--
	Self operator--(int)
	{
		Self tmp(*this);
		_node = _node->_prev;
		return tmp;
	}
	bool operator!=(const Self& it)
	{
		return _node != it._node;
	}
};
然后typedef一下:
cpp
typedef const_list_node<T> const_iterator;
cpp
const_iterator begin() const
{
	return const_iterator(_head->_next);
}
const_iterator end() const
{
	return const_iterator(_head);
}
此时上面的拷贝构造的问题解决了,但是我们看这个const_iterator和iterator的重复是不是太多了?那么有没有更好的办法优化一下呢?有的,代码如下:
cpp
template<class T,class Ref,class Ptr>
struct list_iterator
{
public:
	typedef list_node<T> Node;
	typedef list_iterator<T,Ref,Ptr> Self;
	Node* _node;
public:
	list_iterator(Node* node)
		:_node(node)
	{
	}

	Ref operator*()
	{
		return _node->_val;
	}
	Ptr operator->()
	{
		return &_node->_val;
	}
	//++it;
	Self& operator++()
	{
		_node = _node->_next;
		return *this;
	}
	//it++
	Self operator++(int)
	{
		Self tmp(*this);
		_node = _node->_next;
		return tmp;
	}
	//--it;
	Self& operator--()
	{
		_node = _node->_prev;
		return *this;
	}
	//it--
	Self operator--(int)
	{
		Self tmp(*this);
		_node = _node->_prev;
		return tmp;
	}
	bool operator!=(const Self& it)
	{
		return _node != it._node;
	}
	bool operator==(const Self& it)
	{
		return _node == it._node;
	}
};
7.2.三参数优化
我们将原来的单个模板参数扩展为三个:
cpp
template<class T, class Ref, class Ptr>
struct list_iterator三个参数分别负责:
| 模板参数 | 作用 |
|---|---|
T |
确定节点中保存的元素类型 |
Ref |
确定解引用时返回的引用类型 |
Ptr |
确定 operator-> 返回的指针类型 |
接着,在 list 类中定义两种迭代器:
cpp
typedef list_iterator<T, T&, T*> iterator;
typedef list_iterator<T, const T&, const T*> const_iterator;
这样,两种迭代器的区别就体现在模板实参上:
| 迭代器类型 | *it 返回类型 |
it.operator->() 返回类型 |
|---|---|---|
iterator |
T& |
T* |
const_iterator |
const T& |
const T* |
只需要实现一个类模板,就能复用遍历逻辑,同时控制元素是否允许被修改。
解引用运算符不再固定返回 T&,而是返回模板参数 Ref:
cpp
Ref operator*()
{
    return _node->_val;
}实例化普通迭代器时,Ref 是 T&,可以修改元素;实例化 const 迭代器时,Ref 是 const T&,只能读取元素。
这里限制的是对元素的修改 ,const 迭代器本身仍然可以移动 ,例如执行 ++it,继续访问下一个节点。
如果链表中保存的是自定义类型,用户往往需要访问元素的成员。例如,元素类型中包含成员 x,可以写:
cpp
(*it).x;为了让迭代器更像指针,也能直接写成:
cpp
it->x;我们需要重载 operator->:
Ptr operator->()
{
    return &_node->_val;
}
这里返回的是节点中数据的地址,而不是节点本身的地址。 因为用户要访问的是元素的成员,而不是链表节点的 _next、_prev。
对于当前实现,it->x 最终会通过返回的数据指针访问成员,可以理解为:
cpp
it.operator->()->x;同样,通过 Ptr 控制返回类型,普通迭代器返回 T*,const 迭代器返回 const T*,从而保持两种迭代器一致的访问权限。
有了两种迭代器,list 就可以分别提供普通版本和 const 版本的 begin()、end():
cpp
iterator begin()
{
    return iterator(_head->_next);
}

iterator end()
{
    return iterator(_head);
}

const_iterator begin() const
{
    return const_iterator(_head->_next);
}

const_iterator end() const
{
    return const_iterator(_head);
}
普通对象调用非 const 版本,获得可以修改元素的迭代器;const 对象调用 const 版本,获得只能读取元素的迭代器。
这里能够构成重载,是因为成员函数末尾的 const****不同,并不是因为返回类型不同。
通过这样的设计,节点之间的移动方式保持一致,而元素的读写权限由 Ref 和 Ptr 决定,避免了分别实现两套迭代器所造成的代码重复。
8.clear接口
clear 接口用于删除链表中的所有有效节点,保留头节点。我们可以遍历链表,逐个调用 erase,但下面这种写法存在问题:
cpp
void clear()
{
    auto it = begin();
    while (it != end())
    {
        erase(it);
        it++;
    }
}可是这里我们要思考一下:这段代码会触发迭代器失效吗?
答案是会的。 调用 erase(it) 后,it 指向的节点已经被释放,但 it 仍然保存着原来的地址。此时再执行 it++,就需要访问已经释放的节点中的 _next,因此会产生未定义行为。
那么,删除当前节点后,如何让迭代器继续指向下一个有效节点呢?
这就需要将 erase****的返回值修改为 iterator**,返回指向被删除节点后继的迭代器** 。我们已经在删除前保存了后继节点的地址 next,因此修改后的代码如下:
cpp
iterator erase(iterator pos)
{
    assert(pos._node != _head);
    Node* node = pos._node;
    Node* prev = node->_prev;
    Node* next = node->_next;

    prev->_next = next;
    next->_prev = prev;
    node->_next = node->_prev = nullptr;
    delete node;
    _size--;

    return iterator(next);
}这样,clear 就可以接收 erase 返回的有效迭代器,继续删除后面的节点:
cpp
void clear()
{
    auto it = begin();
    while (it != end())
    {
        it = erase(it);
    }
}
这里不需要再执行 it++****,因为 erase****返回的迭代器已经指向下一个节点。 删除最后一个有效节点后,返回的迭代器指向头节点,也就是 end(),循环自然结束。
有了clear接口后,我们的析构函数就可以直接调用clear了,但是我们的带头节点要 记得释放,代码如下:
cpp
~list()
{
	clear();
	delete _head;
	_head = nullptr;
}
9.operator=接口
这个赋值重载我们可以用现代写法,先写个swa函数,如下:
cpp
void swap(list<T>& lt)
{
	std::swap(_head, lt._head);
	std::swap(_size, lt._size);
}
然后operator=代码如下:
cpp
list<T> operator=(list<T> lt)
{
	swap(lt);
	return *this;
}附加个打印代码:
cpp
template<class Container>
void print(Container& lt)
{
	for (auto& x : lt)
	{
		cout << x << " ";
	}
	cout << endl;
}
10.测试代码
cpp
void test_list1()
{
	list<int> lt1;
	lt1.push_back(1);
	lt1.push_back(2);
	lt1.push_back(3);
	lt1.push_back(4);
	lt1.push_back(5);
	lt1.push_back(6);
	print(lt1);
}
void test_list2()
{
	list<int> lt1;
	lt1.push_back(1);
	lt1.push_back(2);
	lt1.push_back(3);
	lt1.push_back(4);
	lt1.push_back(5);
	lt1.push_back(6);
	auto it = lt1.end();
	lt1.insert(it, 12);
	print(lt1);
	lt1.push_front(45);
	lt1.push_front(46);
	lt1.push_front(47);
	lt1.push_front(48);
	print(lt1);
}
void test_list3()
{
	list<int> lt1;
	lt1.push_back(1);
	lt1.push_back(2);
	lt1.push_back(3);
	lt1.push_back(4);
	lt1.push_back(5);
	lt1.push_back(6);
	auto it = lt1.begin();
	print(lt1);
	lt1.erase(it);
	lt1.pop_front();
	lt1.pop_back();
	print(lt1);
	lt1.clear();
	print(lt1);
}
void test_list4()
{
	list<int> lt1;
	lt1.push_back(1);
	lt1.push_back(4);
	lt1.push_back(3);
	lt1.push_back(7);
	lt1.push_back(8);
	print(lt1);
	list<int> lt2(lt1);
	lt2.push_front(103);
	print(lt2);
	list<int> lt3;
	lt3 = lt2;
	print(lt3);
	list<int> lt4 = { 1,2,3,4,5,6,7,8,9 };
	print(lt4);
	const list<int> lt5(lt4);
	print(lt5);
}
总结:
本篇使用带头双向循环链表模拟实现了 list,通过哨兵节点统一处理空链表及首尾位置的插入、删除。迭代器将节点跳转封装成类似指针的操作,并借助模板参数复用普通迭代器与 const 迭代器的实现。删除节点后,对应迭代器会失效,因此让 erase 返回后继迭代器,便于继续遍历并实现 clear。最后,通过逐个复制元素实现深拷贝,结合 clear、析构函数和拷贝交换赋值,完成链表资源的管理。