在滚动发布、机房缩容、宿主机维护这些日常操作里,停机那一两秒最容易出事故:请求被派到正在关闭的实例、TCP 连接悬在半空、下游资源被提前释放导致回源报错。日志里常见的现象是「重启后偶发 502」,却很难说清是哪一层出的问题。
常规做法往往只有「先杀进程再 sleep 几秒」,或者干脆依赖操作系统默认的 TCP keepalive。问题是:进程退出顺序靠 shell 拍脑袋,内核 keepalive 默认要 2 小时才首次探测,负载均衡在摘流前仍持续转发------三层各管一段,谁都没兜住中间的空窗期。
本文分享一套可直接落地的资源关闭方案:分层闸门 + 内核 keepalive 调优 + 负载均衡排水,三者用一份统一的超时预算串起来。
一、停机瞬间的三类故障:为什么会越关越乱
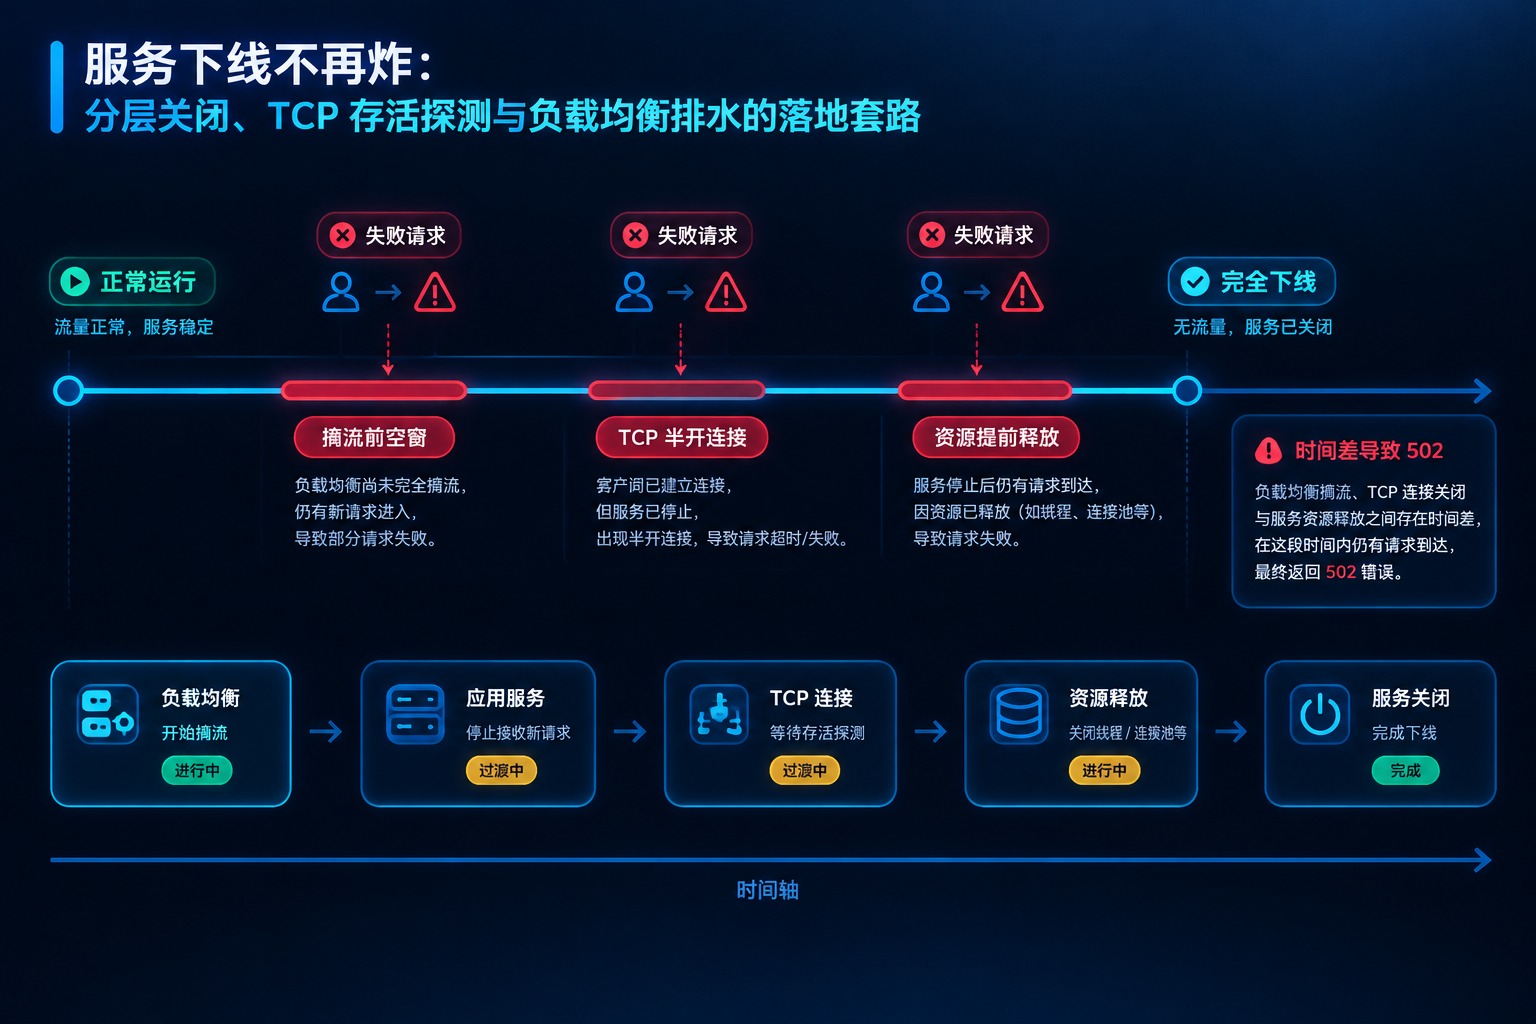
先把事故现场看清楚:故障集中发生在三个时间窗口。
- 摘流前的空窗:负载均衡还没把实例标记为不可用,新连接照常派发,而服务端已经开始释放端口,客户端拿到的是一个「能连上但没人应答」的连接。
- 关闭中的半开:对端认为连接仍然存活,本端内核却已回收 socket,请求静默超时,监控上只表现为一条挂住的长连接,没有任何报错。
核心结论: 事故几乎都发生在「探测信号」与「关闭动作」之间的时间差里,谁先把这段时间抹平,谁就稳。
二、分层关闭体系:把资源切成四层闸门
关闭不是一刀切,而是按依赖方向切成四层依次放闸:
| 层级 | 典型资源 | 关闭动作 | 建议上限 |
|---|---|---|---|
| L4 接入层 | LB 后端、端口 | 标记 down、摘除实例 | 3s |
| L3 连接层 | 长连接、会话 | 停止 accept、存量排空 | 15s |
| L2 应用层 | 定时任务、协程池 | 拒绝新任务、等待返回 | 10s |
| L1 资源层 | 连接池、句柄、线程池 | 归还并关闭 | 3s |
- 先关入口:L4 一旦放闸,外部流量就再也进不来,后面三层才有安静的环境收尾。
- 后放资源:连接池、数据库会话这类共享资源最后关,避免应用层还在跑的请求撞上「连接已关闭」。
核心结论: 顺序反了,就是把请求打到一个只剩空壳的进程上。
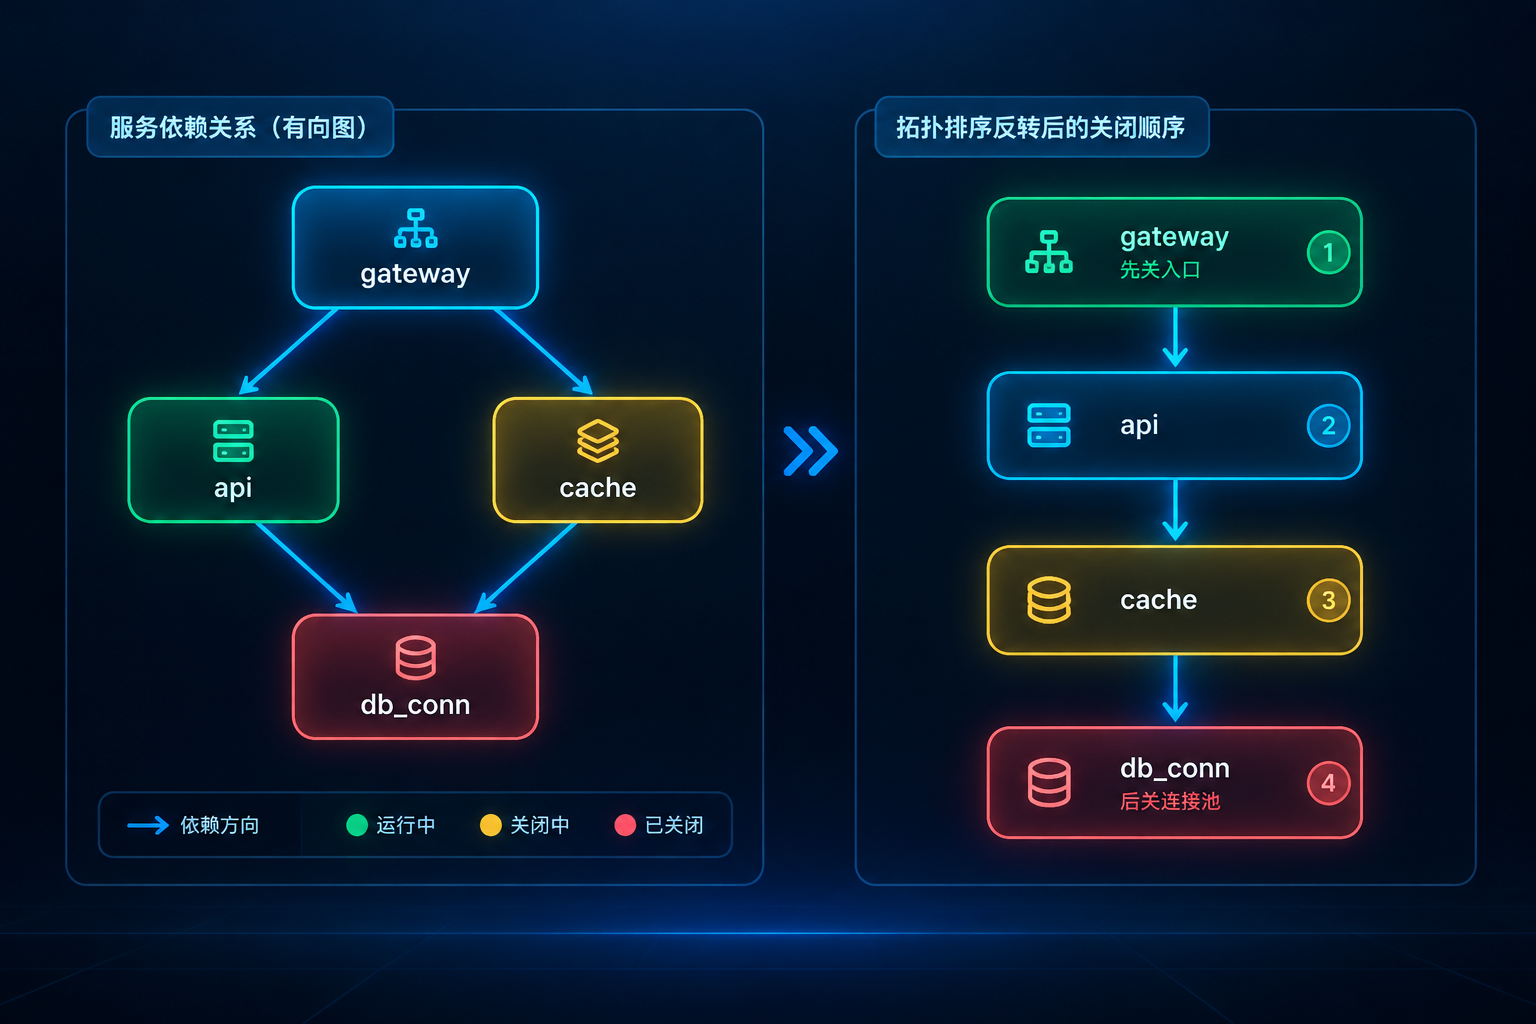
三、关闭顺序编排:用依赖图生成停机脚本
顺序不该靠人记,先声明依赖,再让程序算出拓扑序:
python
# 依赖图 → 拓扑排序 → 生成关闭顺序,结果可直接写进 stop.sh
graph = {'gateway': ['api'], 'api': ['cache', 'db_conn'], 'cache': ['db_conn']}
order, seen = [], set()

def visit(node, stack=()):
    if node in seen:
        return
    if node in stack:
        raise SystemError('依赖成环: ' + node)
    for dep in graph.get(node, []):
        visit(dep, stack + (node,))
    seen.add(node)
    order.append(node)

for name in graph:
    visit(name)
for res in reversed(order):   # 反转后:入口最先关,共享连接最后关
print('close ' + res)- 声明式依赖:新增一个中间件只需往图里加一条边,停机脚本不用改。
- 环检测兜底:依赖写成环时直接抛错,避免停到一半卡死。
核心结论: 输出顺序为 gateway → api → cache → db_conn,正好对应「先入口、后资源」。
四、TCP 存活探测:内核参数这样调才有效
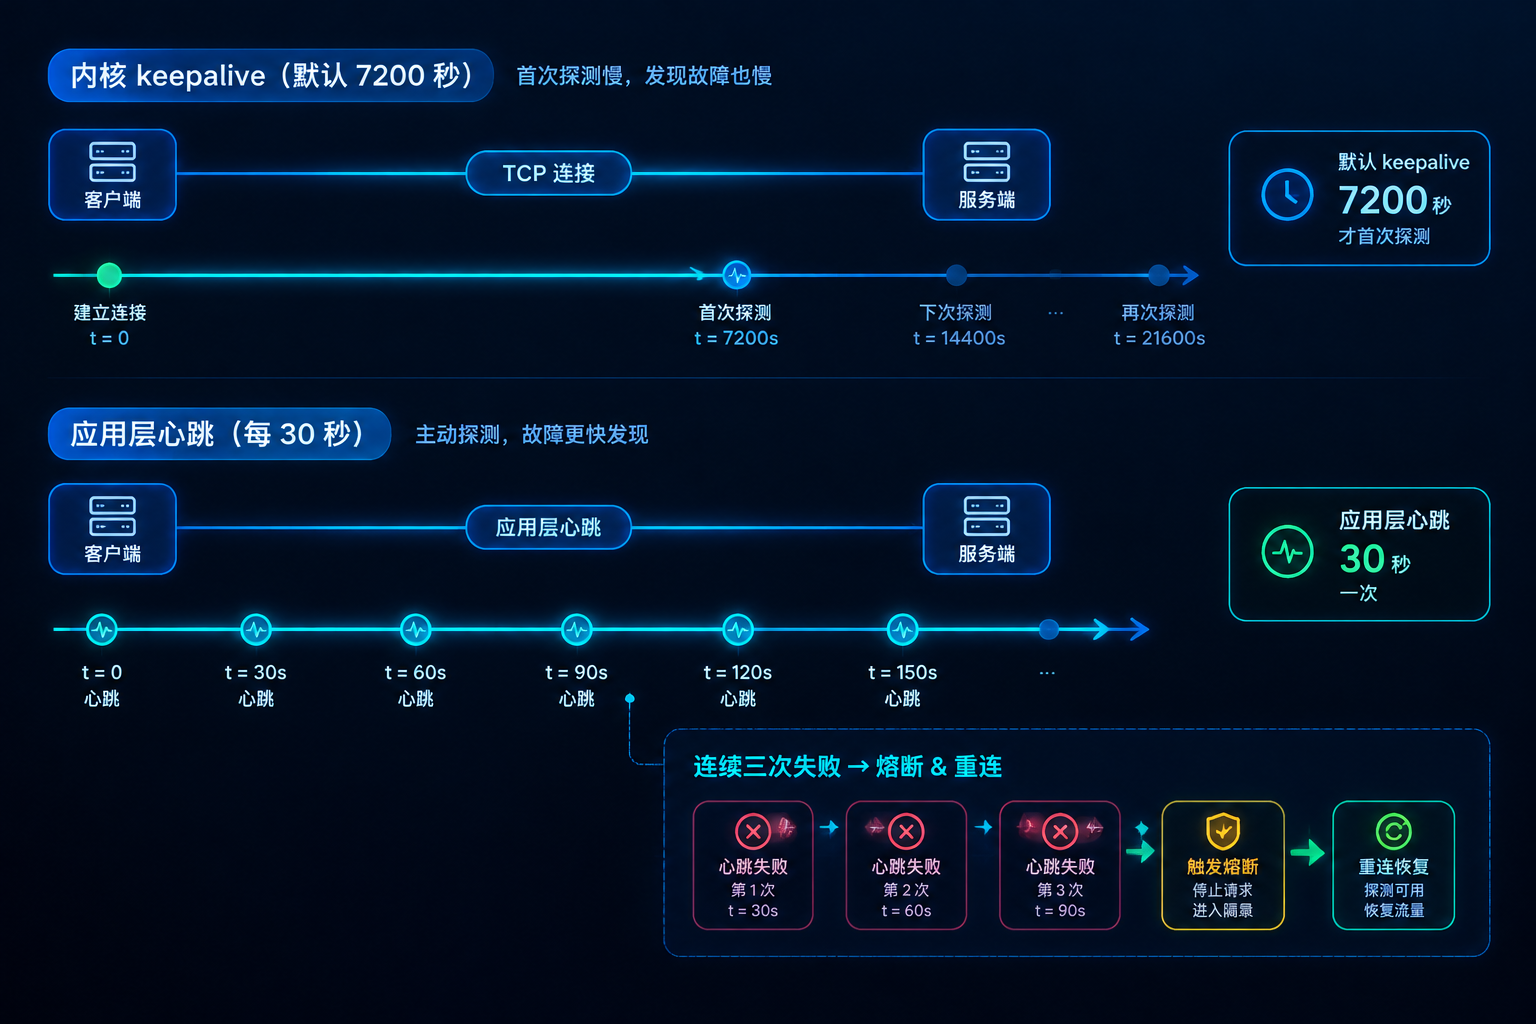
动代码之前,先确认内核到底多久发一次探测包:
bash
# 查看并调整内核 TCP keepalive,需 root 权限
cat /proc/sys/net/ipv4/tcp_keepalive_time      # 默认 7200 秒
sysctl -w net.ipv4.tcp_keepalive_time=30 \
        net.ipv4.tcp_keepalive_intvl=10 \
        net.ipv4.tcp_keepalive_probes=3
ss -to state established | head -5 # 观察 timer:(keepalive)- 默认值不可用 :
tcp_keepalive_time=7200意味着两小时内核一声不吭,半开连接会一直占着资源。 - 判死时间要会算:30 + 10×3 = 60 秒,这是内核认定连接已死的最短时间,必须写进超时预算。
核心结论: keepalive 解决的是「连接该不该回收」,它不解决「请求该不该转发」。
五、心跳兜底:应用层不能只信内核探测
内核只看包在不在,看不懂业务还活着没有:
js
// 应用层心跳:30 秒一跳,连续 3 跳失败即判定连接不可用
const probe = (conn) => new Promise((res) => {
  const t = setTimeout(() => res(false), 5000);
  conn.ping(() => { clearTimeout(t); res(true); });
});

async function alive(conn) {
  let miss = 0;
  while (miss < 3) {
    if (!(await probe(conn))) miss++; else miss = 0;
    await new Promise(r => setTimeout(r, 30000));
  }
  return false;   // 触发重连与熔断,把故障挡在业务外
}- 探测语义不同:内核 keepalive 只验 TCP 三次握手的存量状态,心跳能验证进程是否还在处理请求。
- 失败要联动:连续 3 次超时应触发重连与熔断,而不是无限重试同一条僵死连接。
核心结论: 内核查连通,心跳查存活,两层都过才算连接真的可用。
六、负载均衡探活:健康检查阈值怎么定
探活参数决定了实例多久被摘、多久回来:
| 探测项 | 建议值 | 说明 |
|---|---|---|
| check interval | 2s | 间隔过大会拖慢摘流 |
| rise / fall | 2 / 3 | 连续 2 次成功上线,3 次失败下线 |
| timeout | 1s | 探测超时即计一次失败 |
| check path | /healthz | 只反映进程存活,不带下游依赖 |
- 判定时间要可算:fall=3、interval=2s、timeout=1s,最坏 6 秒内实例一定被摘,这个数字必须小于排空窗口。
- 健康接口要瘦 :
/healthz里查数据库会让下游抖动误伤全部实例,形成雪崩。
核心结论: 摘流速度 = fall × interval,先算出这个值,再倒推其他层的预算。
七、摘流与排水:平滑下线的完整链路
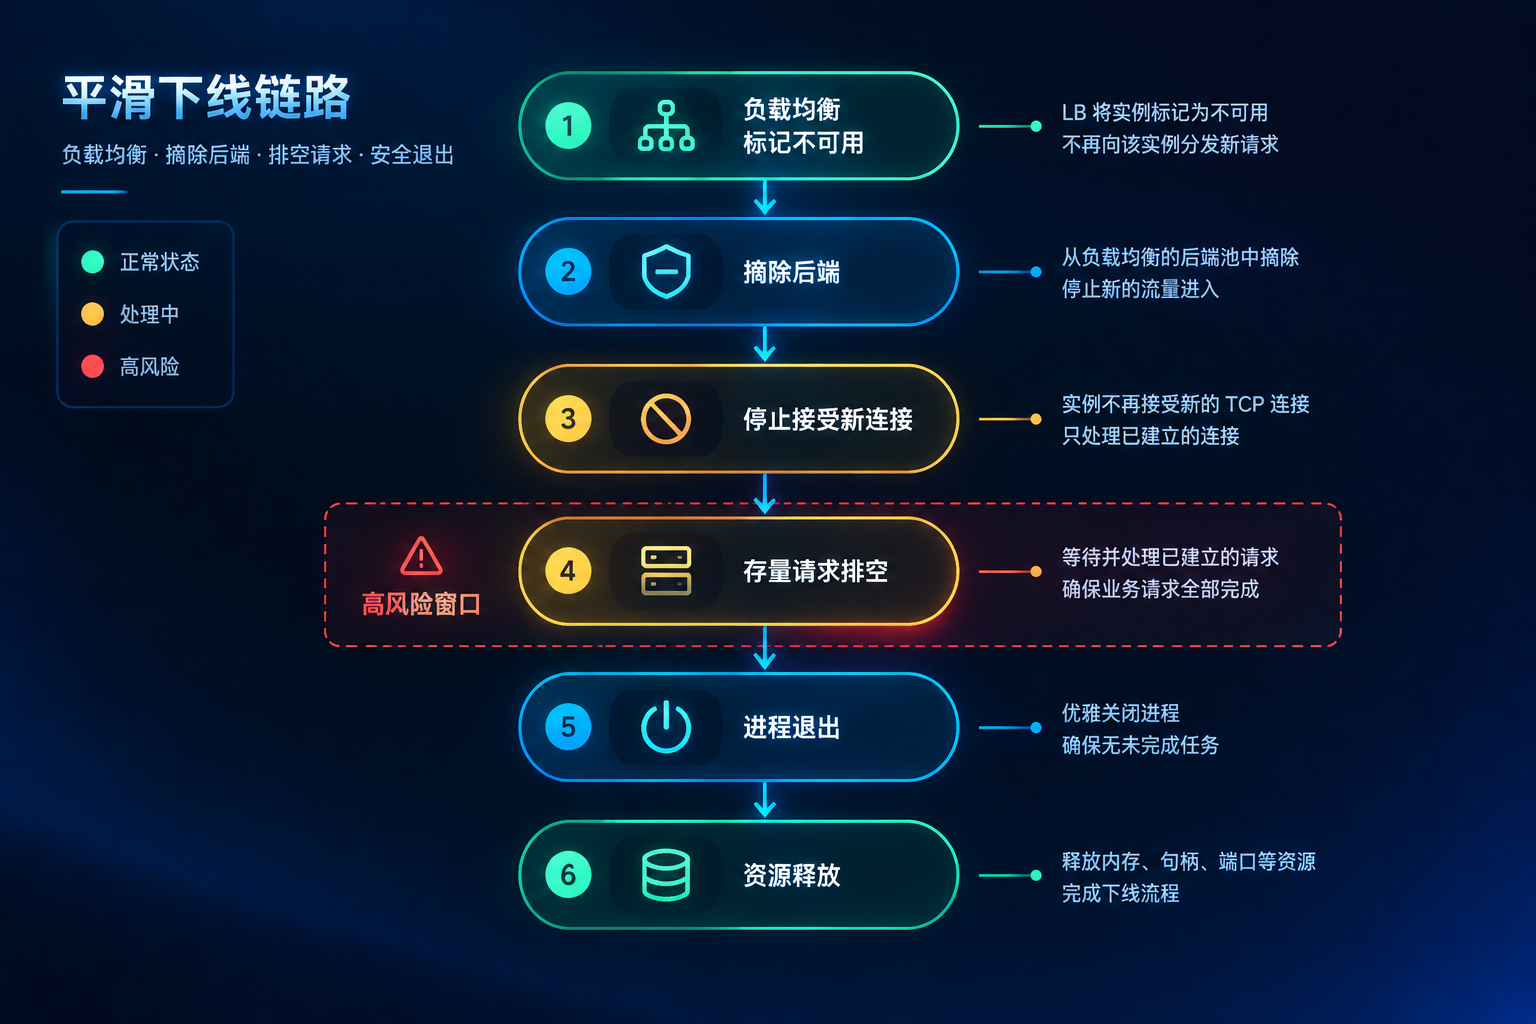
真正无损的下线是一条固定链路:
标记不可用 → 摘除后端 → 停止接新连接 → 排空存量请求 → 进程退出 → 释放资源
下面这份 nginx 配置展示了「让健康检查先失败、再给存量请求留出口」的写法:
nginx
# 摘流 + 排水:先让 LB 判失败,再让存量请求跑完
server {
    listen 8080;
    location /ready  { return 503; }      # 下线时置位,健康检查转不可用
    location / {
        proxy_pass http://app;
        proxy_connect_timeout 2s;
        proxy_read_timeout 30s;
        keepalive_timeout 30s;            # 与排水窗口对齐,别提前断连
    }
}- 先翻转就绪位 :把
/ready置为 503 后,LB 在下一轮探活即摘除后端,新请求不再进入。 - 再等存量跑完 :
keepalive_timeout必须大于最长请求耗时,否则排水还没结束连接就被掐断。
核心结论: 摘流和排水是两个动作,中间那段等待时间才是 502 的高发区。
八、超时预算:让每层等待时间互相对齐
各层超时必须写在一张表上,否则必然互相踩:
| 环节 | 建议预算 | 对齐关系 |
|---|---|---|
| LB 摘流生效 | 3s | 大于探活失败判定(约 3 次探测) |
| 存量请求排空 | 15s | 大于业务 P99 耗时 + 2s 余量 |
| TCP keepalive 判死 | 60s | time=30 + intvl=10 × probes=3 |
| 进程强制退出兜底 | 30s | 大于排空窗口,小于发布平台等待 |
- 小的等大的:摘流必须快于排空开始,排空必须快于强制杀进程,顺序乱了就会掐断在途请求。
- 留一个兜底 :排空超时后由
SIGTERM超时升级到SIGKILL,保证停机不会无限挂起。
核心结论: 预算不写进表格,就一定会被各层的默认值打散。
九、故障演练:证明服务真的关干净了
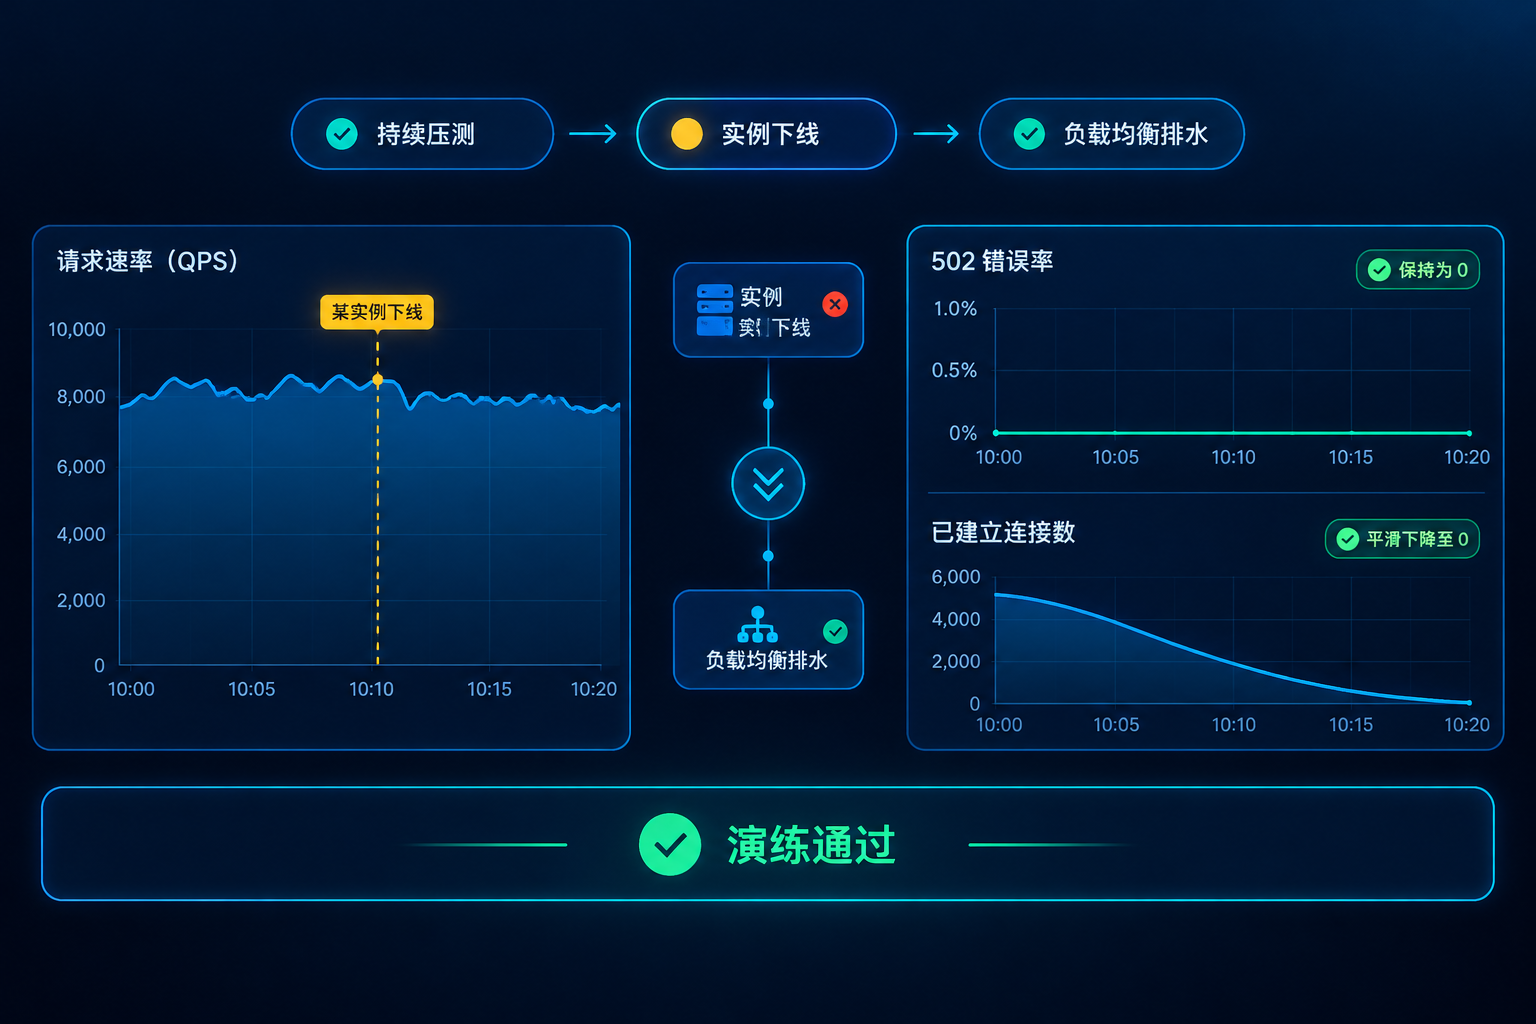
关完不算完,要用命令验证空窗确实消失了:
bash
# 摘流后各跑一次,确认新请求被挡、存量连接归零
curl -s -o /dev/null -w '%{http_code}\n' http://lb/api/ping   # 应返回 503
ss -tn state established '( sport = :8080 )' | tail -n +2 | wc -l- 双指标对照 :HTTP 状态码看「新流量进不来」,
ss连接数看「旧连接走干净」,两者同时达标才算通过。 - 混入真实流量:演练时保持压测不断流,只有持续请求才能暴露那几秒的空窗。
核心结论: 验收标准是 502 数量为零且连接数归零,而不是「脚本执行成功」。
十、排错对照:从现象反推是哪层出问题
遇到下线抖动,先按现象对号入座:
- 问题:重启瞬间出现成片 502 :通常是摘流没生效,LB 还在转发。治理:把
/ready翻转提前到SIGTERM之前,并压短探活 interval。 - 问题:连接挂住 60 秒才断:这是 keepalive 判死时间,说明应用心跳没做。治理:补应用层 ping,把失败阈值收敛到 3 跳内。
- 问题:请求打到一半被掐断 :排空窗口小于请求耗时。治理:延长
keepalive_timeout,并把 P99 写进预算表。 - 问题:重启后偶发下游报错:连接池被提前关闭。治理:把 L1 资源层挪到拓扑序最后。
核心结论: 现象对应层级,层级对应参数,改参数之前先确认是哪一层失守。
结语
分层关闭解决的是「谁先谁后」,keepalive 与心跳解决的是「连接算不算活着」,负载均衡摘流与排水解决的是「流量还往不往里送」。三者各自都只是半成品,只有用同一份超时预算把它们串起来,停机才会从一次**变成一次可预测的操作。
把依赖图、内核参数、探活阈值和排空窗口固化进版本库,每次发布都在验证这套体系,事故率会肉眼可见地下降。
先摘流、再排空、最后放资源,中间每一秒都有人看管。