一、Django 自带的那套后台,本来就长得像审批页
一个后台系统里的审批界面,剥到底就是三样东西:一张待办列表、两个按钮(同意/驳回)、一个发起表单。
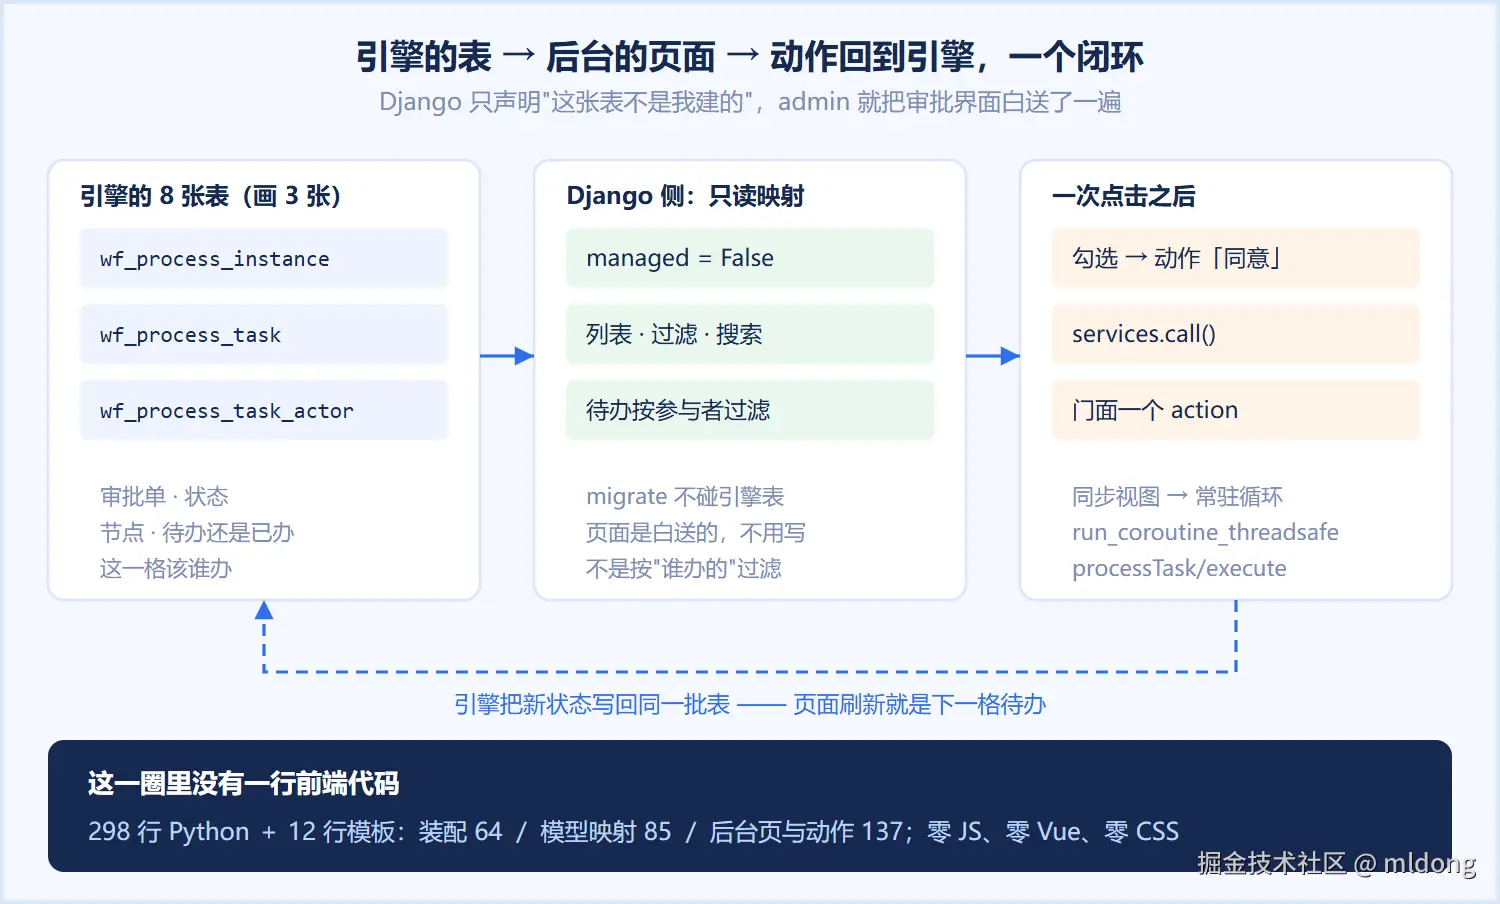
而 Django 的 admin 干的就是这件事------你给它一个 Model,它自动配好列表页、详情页、字段过滤、搜索框、分页、权限校验,还有一套"勾选若干行 → 执行一个动作"的批量操作机制。
于是有一个很自然的想法:如果审批流的状态本来就躺在数据库表里,那 admin 是不是直接就能批单子?
答案是可以。这次做的东西一共 298 行 Python,写了一个 django.contrib.admin 的注册文件,跑出来的界面长这样:
- 侧栏三个入口:流程模板、审批单、审批任务
- 审批任务页勾一条,动作选"同意",单子就往下走一个节点
- 全程零 JS、零 Vue、零 CSS,一行前端代码都没写
这篇讲它是怎么接起来的、账是多少、以及接的时候会撞上的三处门槛。
二、先把账摆出来:装包、建表、行数
装包。 干净虚拟环境里两行:
bash
pip install "django>=5,<6" jeeflow一共装进来 5 个包:
| 包 | 谁带来的 |
|---|---|
| Django | 你要的 |
| asgiref | Django 依赖 |
| sqlparse | Django 依赖 |
| tzdata | Django 依赖 |
| jeeflow | 你要的 |
数据库驱动(asyncpg 或 aiomysql)另算,那是你本来就要装的。引擎侧一个传递依赖都没有 ------它的依赖声明里只有 extras(jeeflow[mysql]、jeeflow[postgres]),不点名就不装。发布物本体 153,586 字节。
建表。 引擎发一份建表 SQL,跑完是 8 张 wf_process_* 表:
定义 / 实例 / 任务 / 任务参与者 / 抄送
设计稿 / 设计历史 / 委托这次集成自己只加了 1 张表 (存设计器导出的 JSON,见第四节),其余全是引擎那 8 张。引擎不碰你的业务表,你的表引擎也不碰------两边靠一个 business_no 字段挂接。
行数。 这是全篇最该给读者的一栏账:
| 文件 | 行数 | 干什么 |
|---|---|---|
wf/services.py |
64 | 引擎装配 + 同步↔异步桥 |
wf/models.py |
85 | 1 张自有表 + 3 张引擎表的只读映射 |
wf/admin.py |
137 | 三个后台页 + 四个动作 |
| 两个 admin 模板块 | 12 | 发起页与列表页按钮 |
| 合计 | 298 |
一句口径交代:这个 298 行不含站内信监听。之前数过 13 个框架的接入量,最大的一块正是消息监听(各壳 206~752 行),这篇把它省了,所以不能拿 298 直接去和那批数比大小。
三、五步接完
第 1 步:建库,导引擎的表
新建一个库,把引擎带的建表 SQL 跑一遍。Python 引擎的 MySQL 和 PostgreSQL 两份脚本都提供,列定义与其余七门语言逐字一致。
第 2 步:装配引擎,顺手把异步那道坎过了
jeeflow 的 Python 版是全异步的(async def + asyncpg/aiomysql),而 Django 的视图是同步的。桥要自己搭:
python
_loop = asyncio.new_event_loop()
threading.Thread(target=_loop.run_forever,
                 daemon=True, name="jeeflow").start()

def call(action, args=None):
    if _facade is None:
        asyncio.run_coroutine_threadsafe(_build(), _loop).result(15)
    return asyncio.run_coroutine_threadsafe(
        _facade.flow(action, args or {}), _loop
).result(20)要点是一条常驻事件循环 :连接池是绑在循环上的,每次调用现开一个 asyncio.run() 会把池子废在旧循环里。同步侧只认这一个 call() 入口。
装配本身是三行:
python
adapter = PostgresAdapter(pool)
repo = JdbcRepository(adapter, TsIDGenerator())
engine = EngineImpl(repo, AuthUserProvider(),
                    TsIDGenerator(), DefaultExpressionEvaluator())
facade = JeeflowFacade(engine, repo, ext_repo)
AuthUserProvider 是引擎唯一的"要问人"的口子------它拿着一个参与者标识来回查姓名。这里直接查 Django 自己的 auth_user 表,username 当参与者标识,first_name 当显示名。组织数据不用重灌一套,这是接现成后台时最省事的一处。
第 3 步:把引擎的表映射成后台页面
这一步是全篇的关键,也是"零前端"的来处。引擎的表已经在那儿了,Django 只要声明"这张表不是我管的":
python
class Task(models.Model):
    id = models.BigIntegerField(primary_key=True, editable=False)
    process_instance_id = models.BigIntegerField("审批单")
    display_name = models.CharField("节点名称", max_length=100)
    task_state = models.IntegerField("状态")
    operator = models.CharField("办理人", max_length=64, null=True)

    class Meta:
        managed = False          # Django 不建表、不迁移它
        db_table = "wf_process_task"
managed = False 意味着 migrate 不会碰它,Django 只当它是个可读可查的数据源。注册进 admin,一个能过滤、能搜索、能批量操作的"审批任务"页就出来了。
待办列表有个过滤条件必须自己写清楚:
python
def get_queryset(self, request):
    qs = super().get_queryset(request).filter(task_state=10)
    mine = TaskActor.objects.filter(
        actor_id=request.user.username
    ).values("process_task_id")
    return qs.filter(id__in=mine)
不能按任务行的 operator 过滤。 那一列记的是"谁办的",任务还在待办时它是空的;"该谁办"存在参与者表里。这是所有审批系统共有的一处,跟用哪个引擎无关,但很容易在这里踩一次。
第 4 步:贴一段 JSON,点一下发布
流程定义从哪来?用现成的钉钉风格设计器画一条,导出那段 JSON。
在库里加一张自己的表 wf_flow_template,字段就是「流程标识、流程名称、JSON 文本」,注册进 admin 后加一个动作:
python
@admin.action(description="发布到引擎(deploy)")
def publish(self, request, queryset):
    for tpl in queryset:
        res = services.call("processDefine/deploy", {
            "content": tpl.content,
            "operator": request.user.username,
        })
于是"改流程"这件事在后台里就是一次勾选加一次点击。同名再发布会自动进版本:第一次 version=0,第二次 version=1,在跑的单据不受影响。
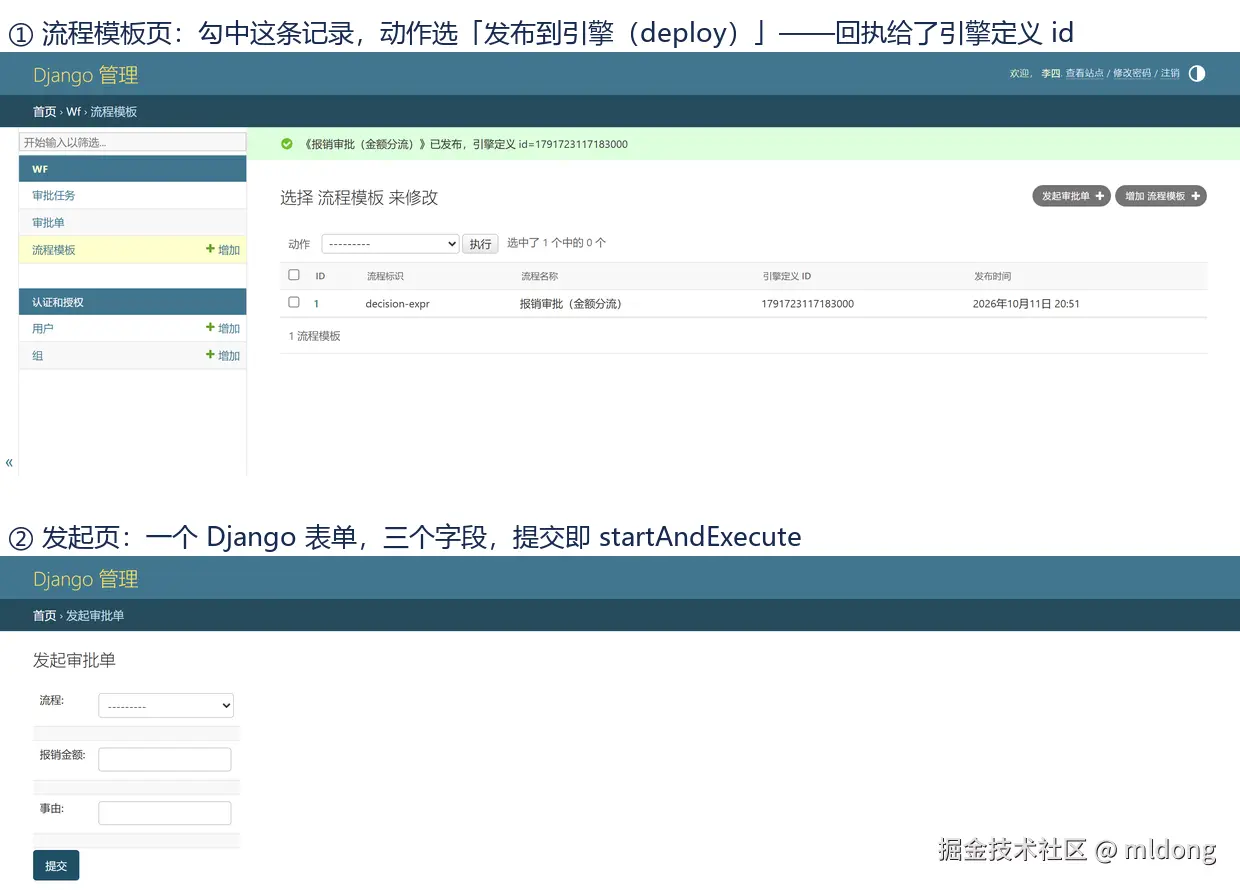
发起页更短:一个 Django 表单(流程、金额、事由三个字段),提交时调一次 processInstance/startAndExecute。
第 5 步:换三个账号,看单子怎么走
发布完流程,用不同账号登录同一个后台,就能看到单子在不同人手里流动。
四、分流是被算出来的,不是画死的
流程画的是:发起申请 → 填写报销单 → 决策「金额 > 1000?」→ 经理审批 / 总监审批 → 结束。
真机跑两张单:
| 发起金额 | 停在谁那格 | 后台里看到的 |
|---|---|---|
| 6666 | 王五(经理) | 一行「经理审批」 |
| 666 | 赵六(总监) | 一行「总监审批」 |
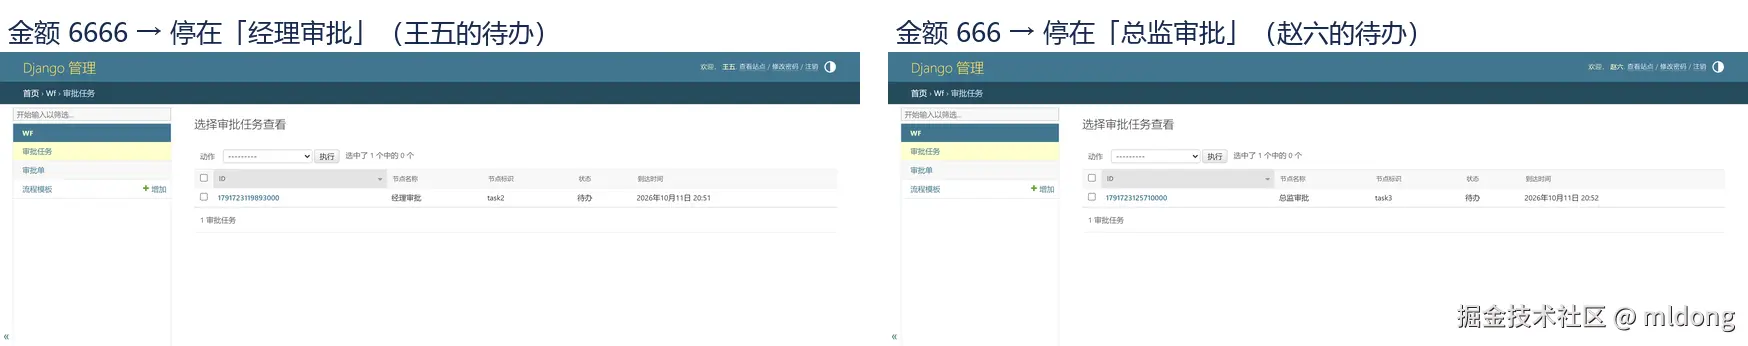
三处值得说的行为:
决策边的表达式不用配求值器。 引擎自带一个能算 字段 运算符 数值 的默认件,amount > 1000 这种直接吃;要接自己的规则引擎,实现那个表达式接口换上即可。
申请节点不用自己点。 发起走的是 startAndExecute:引擎建好实例后,把"发起申请"这一格当场按申请人办完,所以张三提交完,李四的待办里出现的直接是"填写报销单"。这是 applicant 约定的那套语义(第 6 篇专门讲过它为什么这么设计)。
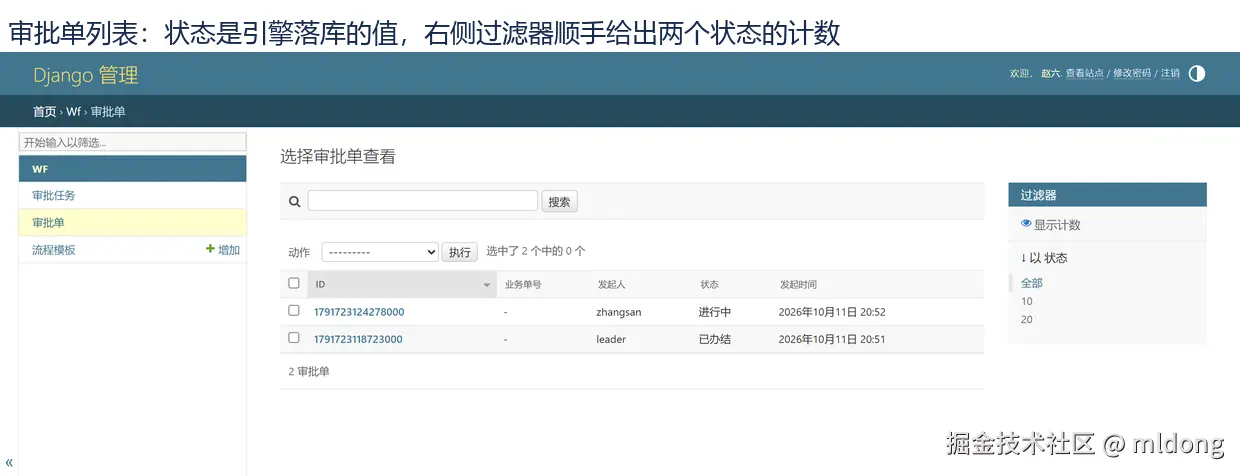
办结状态是真的落库了。 审批单列表页给的是实例状态,不是页面自己算的:6666 那张走到 已办结,666 那张还挂在 进行中,右侧过滤器顺手给出两个状态的计数。
五、接的时候的三处门槛
1. Django 5 的数据库版本线
Django 5.x 连 MySQL 会先问一句版本,不够新直接拒:
swift
NotSupportedError: MySQL 8.0.11 or later is required
(found 5.7.31)
我这台开发机上的 MySQL 正好是 5.7,所以这次改走 PostgreSQL 16。两个选择都成立,只是要提前知道:Django 侧的数据库版本要求,和引擎侧支持的数据库,得取交集。引擎这边 MySQL 与 PostgreSQL 都有仓储实现,所以换库不换代码,只换连接参数和一个适配器类名。
2. 同步视图与异步门面之间要一条桥
第二节那段常驻事件循环就是它。三个细节值得单独点出来:
- 别在同步视图里对协程直接
asyncio.run()------连接池绑在创建它的循环上; - 桥要带超时(示例里
result(15)/result(20)),否则引擎侧卡住会把整个 worker 挂住; - 多进程部署(gunicorn 多 worker)时,每个进程各一条循环、各一个池,互不共享 socket,这是这套写法天然成立的部分。
3. is_staff 不等于能看待办
Django admin 的权限是模型级的。给审批人打上 is_staff 只让他登得进后台,打开"审批任务"页会直接 403。要么给这三个模型配上查看权限(一个权限组解决),要么用现成的权限包。审批人的可见范围由引擎按参与者算,页面级权限只管他能不能进这个页,两层不要混。
六、这套形状适合谁
适合:内部系统、中后台工具、给已有 Django 项目补审批。这类场景的共同点是没有前端排期,但有一套现成的 admin,用户对"列表 + 动作按钮"的交互本来就很熟。这条路上,加审批流的成本是一个 app、298 行、零前端页面。
不太适合:要给业务用户露出的正式审批中心。那种场景该上真正的审批前端------流程设计器、发起页表单联动、审批页意见与流程图高亮、移动端,这些 admin 给不了,也不该由 admin 给。
还有一处诚实边界:这篇的发起页把表单字段写成了「金额、事由」两个输入框,真实项目里表单是配在流程节点上的(引擎侧有 form_key 与变量前缀约定),要做的是按节点上配的表单动态渲染------那部分在带前端的方案里是现成的,在纯 admin 方案里得自己写一个字段到控件的映射。
参考资料
- jeeflow Java 参考实现与各语言引擎:github.com/jeeflow-ec(各语言同名仓库)
- 文档站与规范:jeeflow-doc.mldong.com
- 开源演示站(八语言在线体验):jeeflow-demo.mldong.com
- 集成演示站(十三套框架后端):jeeflow-pro.mldong.com
- 钉钉风格流程设计器 npm 包:mldong-flow-designer-dingtalk
- 系列往篇:《给若依加审批流,不用 Flowable》《一套审批流要写多少代码:13 个框架的接入 diff》《一条审批流的数据库账》《"applicant" 契约:退回发起人的闭环设计》