单机 Redis 突然宕机怎么办?内存放不下全部数据怎么办?
Replication(主从复制)、Sentinel(哨兵) 和 Redis Cluster(集群)。
它们不是三个同级、互相替代的功能。先记住核心区别:主从复制负责复制数据,Sentinel 在主从复制的基础上实现自动故障转移,Cluster 通过分片突破单主节点的容量和写入瓶颈,同时内置故障转移能力。
1. 为什么需要从单机 Redis 发展到多个节点?
一台 Redis 即使处理命令很快,也存在三个问题:第一,进程或机器宕机后服务不可用;第二,内存容量受到单机限制;第三,写请求集中在一个主节点,不能无限横向扩展。
注意这是三个不同问题:数据冗余、高可用和数据分片,并不是一回事。 一台主节点有两台副本,可以缓解读压力并保存冗余数据,但主节点的写入压力和主数据集容量仍然集中在一个分片上。
2. 什么是主从复制?
Replication 指把主节点(Master)的数据变化传播给一个或多个从节点(Replica),让它们尽量保持相同的数据集。
常见部署是一主多从:客户端把写请求发送给 Master,Master 执行命令后将相应变化传播给 Replica。Replica 默认是只读的,应用可以按需把部分读请求路由到副本。
这里的"读写分离"不是 Redis 收到一个 GET 就自动随机分配到某台从节点,而是客户端、连接池或代理需要负责路由。如果应用始终连接 Master,增加副本也不会自动分担这部分读流量。
最简单的从节点配置如下:
conf
replicaof 192.168.1.10 6379也可以在从节点上执行:
bash
REPLICAOF 192.168.1.10 6379
INFO replication
INFO replication 可以查看角色、复制状态和偏移量等信息。
3. 为什么说 Redis 主从复制默认是异步的?
例如客户端执行:
bash
SET order:1001 paidMaster 执行成功后可以先回复客户端,再继续向 Replica 传播复制流,而不必等待所有副本都处理完成。
text
客户端 → Master:SET order:1001 paid
                   ↓
              Master 执行
                   ├──→ 回复客户端
└──→ 异步传播给 Replica这样延迟较低,但会出现主从复制延迟:Master 已有新值,Replica 可能暂时还是旧值。因此从节点读并不天然保证"读到刚刚写入的数据"。
更严重的是,如果 Master 收到写入并回复成功、复制尚未到达副本就突然宕机,故障转移后这次写入可能丢失。
Redis 有 WAIT、min-replicas-to-write 等机制可以降低风险,但 WAIT 只是在给定条件下等待副本确认,不会把 Redis 主从复制变成严格的强一致事务提交协议。这一点在分布式锁和订单等场景尤其重要。
4. 第一次连接时,主从怎么同步?
假设 Replica 是新搭建的,里面没有 Master 的完整数据。它不能只接收接下来发生的新写入,否则历史数据就丢了。
这时会进行全量同步(Full Resynchronization)。典型步骤如下:
text
Replica 与 Master 建立复制连接
        ↓
尝试 PSYNC
        ↓
无法增量同步,进入全量同步
        ↓
Master 生成 RDB 快照
        ↓
把 RDB 传给 Replica
        ↓
Replica 加载快照
        ↓
Master 继续发送快照期间积累的写命令
        ↓
两者进入持续复制状态
这里我们可以和前一篇的 RDB 持久化联系起来:RDB 不只是备份文件,也可以用于主从全量复制。 某些配置还支持 Diskless Replication,由子进程直接把快照流发送到网络,减少中间落盘。
此外,全量同步过程中 Master 仍可以服务请求,但 RDB 生成、网络传输、Replica 加载数据都可能带来资源压力。对于大实例,这并不是一个零成本操作。
5. 每次断线重连都要全量同步吗?
不需要。Redis 支持部分重同步(Partial Resynchronization),通常也叫增量同步。
关键在于三个概念:Replication ID、Replication Offset 和 Replication Backlog。
Replication ID:标识一条数据复制历史,主从共享同一历史时可以判断彼此是否来自同一数据流。Offset:复制流处理到的位置,不是第几条命令,而是复制流的字节位置。Backlog:Master 保存最近一段复制流的缓冲区,便于给短暂掉线的 Replica 补发缺失数据。
假设 Replica 已经处理到 Offset 1000,而 Master 到了 1300。断线重连时,Replica 带着之前的复制 ID 和 Offset 请求 PSYNC。如果 Master 的 Backlog 还保留相应区间,并且复制历史匹配,就可以只补发缺失部分。
text
Replica:我上次同步到 Offset = 1000
Master:我现在到了 Offset = 1300
        ↓
检查 Replication ID 与 Backlog
        ↓
可以增量同步 → 只补发缺失的复制流
不能增量同步 → 重新进行全量同步
所以 Backlog 不是无限历史记录。如果网络断开太久、写入过多导致所需复制流被覆盖,或者复制历史不匹配,就可能回退到全量同步。
6. 主从复制已经有多个副本,为什么还需要 Sentinel?
因为单纯的主从复制不负责自动选出新的 Master。
假设 Master 宕机,虽然 Replica 还保存着数据,但应用仍然连接旧 Master,就会发现写入失败。必须有人判断故障、挑选新 Master、让其他 Replica 改为跟随它、让客户端知道新地址。
如果完全靠管理员手工执行,就会产生很长的故障恢复时间。因此 Redis 提供了 Sentinel,也就是哨兵机制。
7. 什么是 Sentinel?
Sentinel 是独立运行的监控与协调进程,为非 Cluster 的 Redis 主从部署提供高可用能力。
它主要负责监控、通知、自动故障转移和为客户端提供当前 Master 的地址信息。
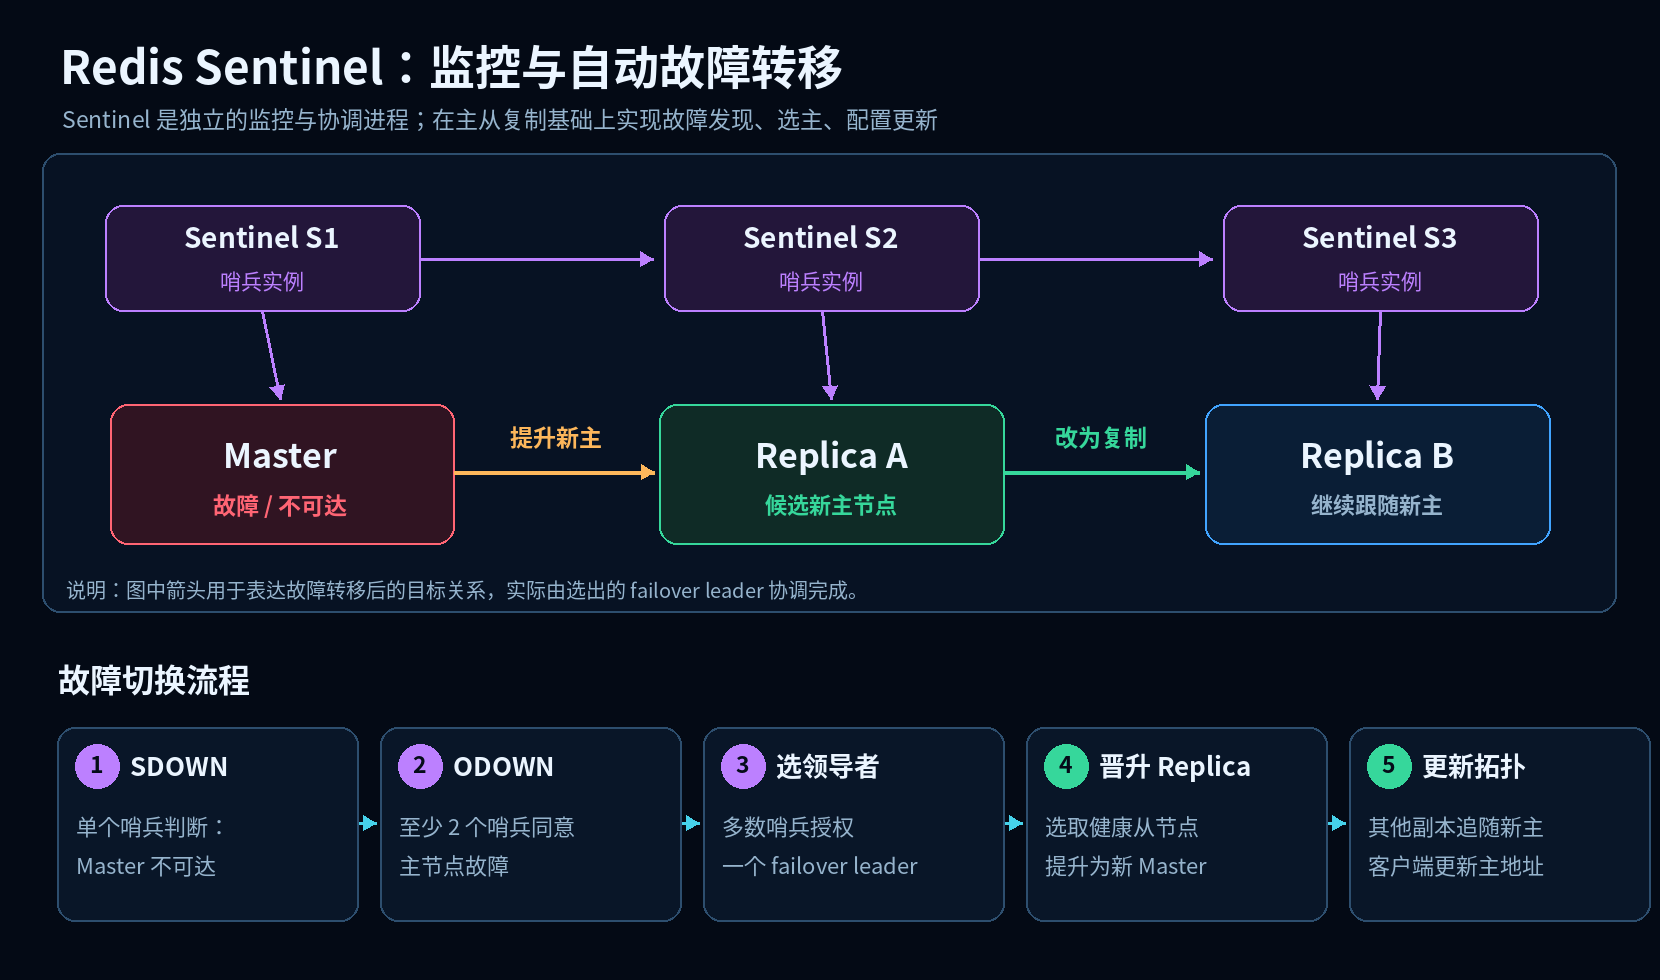
典型拓扑为:一台 Master、两台 Replica,再部署三个 Sentinel 进程。Sentinel 进程并不存放业务 Key;它们监控 Redis 节点并互相协调。生产环境尽量分散部署 Sentinel,避免三个哨兵和 Master 一起因单台机器故障而失效。
8. Sentinel 怎么发现 Master 宕机?
这里需要分清 SDOWN 和 ODOWN,这是面试高频问题,也是最容易混的地方。
SDOWN(Subjectively Down,主观下线):某个 Sentinel 在规定时间内没有收到 Master 的有效响应,于是自己认为 Master 不可达。这只是单个哨兵的判断,不代表其他哨兵也这么认为。
ODOWN(Objectively Down,客观下线) :该 Sentinel 与其他 Sentinel 交换判断结果,达到配置的 quorum 数量后,认为 Master 客观下线。
例如有三个 Sentinel,配置 quorum=2:
text
S1:我认为 Master 下线了(SDOWN)
S2:我也认为 Master 下线了(SDOWN)
S3:暂时还没判定
              ↓
       满足 quorum = 2
              ↓
           ODOWN
但一定不要把 quorum=2 和"完成故障转移只需要随便两个哨兵"画等号。ODOWN 的故障判定阈值与 failover leader 的授权是两件事:启动实际故障转移还需要 Sentinel 多数派授权,具体要求不低于相关 quorum 限制。在三个哨兵的例子里,多数派也是两个。
9. 故障转移到底经过哪几步?
可以分成五步理解。
第一步,多个 Sentinel 判断 Master 不可达,达到 ODOWN 条件。
第二步,Sentinel 通过投票,授权其中一个实例成为本轮故障转移的 failover leader。这里选出的是负责协调切换的哨兵,不是直接把它变成 Redis 主节点。
第三步,leader 从可用 Replica 中挑选合适的新 Master。选择会考虑 replica-priority、与原 Master 断开连接的时长、复制偏移量等因素,而不是单纯随机选一台。
第四步,对选中的 Replica 执行提升主节点的操作,例如 REPLICAOF NO ONE,让它独立成为 Master。
第五步,让其他 Replica 改为复制新 Master,并把最新主节点配置传播给 Sentinel 和客户端。旧 Master 如果之后恢复,通常会被重新配置成新 Master 的 Replica。
这里的客户端也必须支持 Sentinel 感知:应用不是永远写死 192.168.1.10:6379,而是使用支持 Sentinel 的客户端发现并连接当前 Master。
例如手动查询:
bash
redis-cli -p 26379 SENTINEL get-master-addr-by-name mymaster这条命令返回的是当前 Master 的地址,Sentinel 自己并不处理普通的业务 GET/SET 请求。
10. Sentinel 的配置长什么样?
简化的 sentinel.conf 示例:
conf
port 26379
sentinel monitor mymaster 192.168.1.10 6379 2
sentinel down-after-milliseconds mymaster 5000
sentinel failover-timeout mymaster 60000
mymaster 是要监控的主从集合名称;最后的 2 是 ODOWN 所需的 quorum;down-after-milliseconds 控制单个 Sentinel 判断不可达的时间阈值。
这是解释参数的示例,不是一套完整生产配置。认证、网络地址、实例分布、持久化和监控仍需单独配置。
11. 什么是 Redis 脑裂?为什么 Sentinel 也可能丢数据?
假设 Master A 没有真正停止运行,只是与 Sentinel 集群以及 Replica 发生了网络隔离。
text
网络分区①:旧 Master A + 部分客户端

网络分区②:Sentinel 多数派 + Replica B
Sentinel 可能认为 A 已经故障,并把 B 提升为新 Master。此时如果旧 A 仍能接收部分客户端写入,就可能短暂出现两个节点都对某些客户端表现为 Master 的情况,通常称为脑裂。
网络恢复后,旧 A 可能被重新配置为 B 的 Replica。由于 Redis 复制默认是异步的,旧 A 隔离期间接受的某些写入就可能丢失。
因此不能认为:有了 Sentinel,就可以保证所有已收到成功响应的写入绝不丢失。 Sentinel 解决的是自动故障转移,不是严格强一致性。
可以使用 min-replicas-to-write 与 min-replicas-max-lag 降低某些网络分区下旧 Master 继续接受写入的风险,但它们也不等于绝对不丢数据的同步提交协议。
12. 为什么 Sentinel 解决不了单机容量瓶颈?
因为一主两从的三个节点,逻辑上仍然保存同一份完整数据集。
text
Master:用户 1~100 万
Replica A:用户 1~100 万
Replica B:用户 1~100 万
增加 Replica,主要增加的是冗余副本和可供路由的读取能力,而不是把用户数据真正拆成多个互不相同的分片。写入仍然集中在一个 Master,单主节点的内存上限也没有因增加 Replica 而真正扩大。
如果需求变成"数据量和写入压力大到一台 Master 承担不了",就需要 Redis Cluster。
13. 什么是 Redis Cluster?
Redis Cluster 是 Redis 的原生分布式分片方案。
它同时解决两类问题:把不同 Key 分散到不同 Master 以横向扩展容量和写入吞吐;为每个分片配置 Replica,并通过集群机制完成必要的自动故障转移。
最常见的演示拓扑是三个 Master,各自有一个 Replica,合计六个 Redis 数据节点。
注意图中的数字只是一个合法的槽位分配示例,并不表示所有集群都必须恰好用三台 Master 或按图上的边界划分。
14. 为什么 Redis Cluster 要引入 16384 个哈希槽?
Redis Cluster 不采用简单的"Key 哈希后对 Master 数量取模"。它在 Key 与 Master 之间增加了一层逻辑单位:Hash Slot(哈希槽)。
槽号范围是 0~16383,共 16384 个槽。普通 Key 的槽计算方式为:
text
HASH_SLOT = CRC16(key) mod 16384例如,一个三主节点的集群可以这样分配:
text
Master A:0 ~ 5460
Master B:5461 ~ 10922
Master C:10923 ~ 16383
客户端对 user:1001 计算出槽号后,就可以找到负责该槽的 Master,向它发送命令。
为什么不直接对节点数量取模?因为节点数量会变。假如从三台 Master 扩容到四台,直接改变取模的除数,可能使大量 Key 的映射发生变化;引入固定数量的槽后,只需要在节点之间重新分配槽及相应 Key,路由规则本身不变。
因此 16384 是逻辑槽数,不是必须部署 16384 台 Redis,也不是只能存 16384 个 Key。 每个槽里可以有很多 Key,一个 Master 也可以持有很多槽。
15. Cluster 扩容时,数据怎么迁移?
假设已有 Master A、B、C,现在加入 Master D。
系统可以把部分槽从 A、B、C 迁移给 D,同时迁移这些槽中的 Keys。
text
扩容前:
A → 槽 0~5460
B → 槽 5461~10922
C → 槽 10923~16383

扩容后(示意):
A / B / C → 各自保留部分槽
D         → 接收一部分迁移来的槽
迁槽过程中,源节点和目标节点会处于 MIGRATING、IMPORTING 等状态。应用不能假设迁槽是瞬间完成的,客户端还需要正确处理临时重定向。
所以 Redis Cluster 的扩缩容通常不要求为了移动槽而把整个集群完全停止,但迁移仍可能带来网络、CPU 和延迟开销。
16. MOVED 和 ASK 分别是什么意思?
如果客户端把请求发送给了错误的 Redis Cluster 节点,Redis 可能返回重定向信息。
MOVED 表示:这个槽现在应该由另一个节点负责。 客户端应向正确的节点重试,并更新自己的槽位路由信息。
ASK 主要出现在槽迁移期间 :这个请求需要临时交给目标节点处理,但不代表槽的最终归属已经正式切换。客户端通常要先发送 ASKING,再重试本次命令,而不是立即永久修改槽位映射。
text
MOVED:稳定归属已经变了 → 更新路由
ASK:槽正在迁移 → 临时重定向本次请求这也是为什么开发中需要使用支持 Redis Cluster 的客户端 ,而不是随便连一个节点,自己用普通 redis-cli 命令循环重试。
17. 什么是 Hash Tag?为什么有些多 Key 操作会报 CROSSSLOT?
假设有两个 Key:
text
order:1001:info
order:1001:items
它们独立计算哈希槽后,很可能落在不同槽里。Redis Cluster 中,一些多 Key 命令、Lua 脚本和事务要求所涉及的 Keys 能在同一槽中执行;如果位于不同槽,可能返回 CROSSSLOT 错误。
解决某些同槽需求的方法是 Hash Tag,即在 Key 中用 {} 指定参与哈希的部分:
text
order:{1001}:info
order:{1001}:items
这两个 Key 都按 1001 计算槽,因此被分到同一个 Hash Slot。
可以通过以下命令验证:
bash
CLUSTER KEYSLOT order:{1001}:info
CLUSTER KEYSLOT order:{1001}:items
但不能把所有 Key 都加上同一个 Hash Tag,否则大量数据会集中到一个槽、一个 Master,反而失去分片意义。Hash Tag 是有针对性地解决同槽操作,不是所有 Key 都应该使用的命名规则。
18. Cluster 需要 Sentinel 吗?
通常不需要。 Redis Cluster 自己就具备集群成员信息传播、节点故障检测和副本提升的机制。
Sentinel 的典型服务对象是非 Cluster 主从架构;Cluster 的 Master 负责不同槽,各自有 Replica,某个 Master 故障时可在满足集群选举与可用性条件的情况下由对应 Replica 接替。
但这不代表 Cluster 在任何故障下都能正常服务。比如部分 Master 没有可用 Replica、集群失去必要的多数派,或者槽覆盖配置要求得不到满足时,集群可能部分或全部不可用。
同样,Cluster 内的复制默认仍是异步的,因此故障切换后也有最近写入丢失的可能。
19. 开发时如何连接和查看集群?
连接 Redis Cluster,需要使用 Cluster-aware 客户端。在命令行里可以使用 redis-cli -c 自动处理常见的重定向:
bash
redis-cli -c -h 127.0.0.1 -p 7000查看基本状态:
bash
CLUSTER INFO
CLUSTER NODES
CLUSTER SLOTS
CLUSTER KEYSLOT user:1001
其中 CLUSTER NODES 可以查看节点角色、拓扑和负责槽位,CLUSTER KEYSLOT 可以查看指定 Key 的槽号。
如果在本地已经分别启动并正确配置了六个可互通的集群节点,也可以使用 redis-cli --cluster create ... --cluster-replicas 1 来初始化测试集群。这个命令不是"启动六个 Redis 进程",而是组织已经启动的节点形成 Cluster;生产环境还需要认证、网络、持久化、监控和故障域配置。
20. 三者到底怎么选?
| 方案 | 数据布局 | 自动故障转移 | 写入横向扩容 | 主要解决什么问题 |
|---|---|---|---|---|
| 主从复制 | 一份完整数据,多份副本 | 单独使用不提供 | 不支持 | 冗余备份、读扩展 |
| Sentinel + 主从 | 一份完整数据,多份副本 | 支持 | 不支持 | 单分片高可用 |
| Redis Cluster | 不同 Master 负责不同槽,每分片可有副本 | 内置支持 | 支持 | 分片扩容 + 高可用 |
如果业务数据量不大,只是希望 Redis 主节点故障时自动恢复,可优先考虑 Sentinel + 主从复制。
如果数据集容量或写入压力已经超过单主节点能力,需要真正把数据分到多个 Master,就考虑 Redis Cluster。
如果 Redis 只是开发环境的一层可重建缓存,单实例也可能足够。架构并不是节点越多越好,多节点会额外增加复制延迟、运维、故障切换和数据一致性问题。
21. 最容易混淆的几个地方
第一,主从复制不等于自动故障转移。 复制解决"其他节点有副本",不负责自动决定"故障时谁来接管"。
第二,Sentinel 不是 Redis Cluster。 Sentinel 不把业务 Key 分散到不同主节点,也不负责让单个数据集按槽进行水平分片。
第三,主从复制默认不是强一致同步。 Master 返回写入成功时,Replica 可能尚未收到相应变化;故障切换可能丢失最近的数据。
第四,SDOWN 和 ODOWN 不是一个概念。 前者是单个 Sentinel 的判断,后者需要达到故障判定 quorum;实际 failover 还需要多数哨兵授权。
第五,Cluster 里不是"每个 Master 都有全部数据"。 不同 Master 负责不同槽,每个 Master 的 Replica 才复制自己所属分片的数据。
第六,16384 个槽不等于 16384 台 Redis。 哈希槽是逻辑分片单位;扩容主要迁移槽及其中的 Keys。
第七,Hash Tag 不是越多越好。 用同一个 Tag 让太多 Key 集中到同一槽,可能引发热点或容量倾斜。