这是一篇深入分析三大 SDD 框架的文章,读完这篇文章,你会拿到四个东西:
- 精准选型的能力------三个框架各自的甜点区和禁区,不再"别人用啥我装啥"
- 避开 AI 编码最常见的三个坑------需求理解偏差、范围蔓延、执行质量退化,每个框架填坑的思路完全不同
- 一套可落地的企业级 AI 开发流程------单框架怎么跑、双框架怎么组合、棕地项目怎么渐进接入,都有可抄的作业
- 新旧项目适配策略------绿地怎么开局、棕地怎么平滑迁移,不再一套方法论硬套所有场景
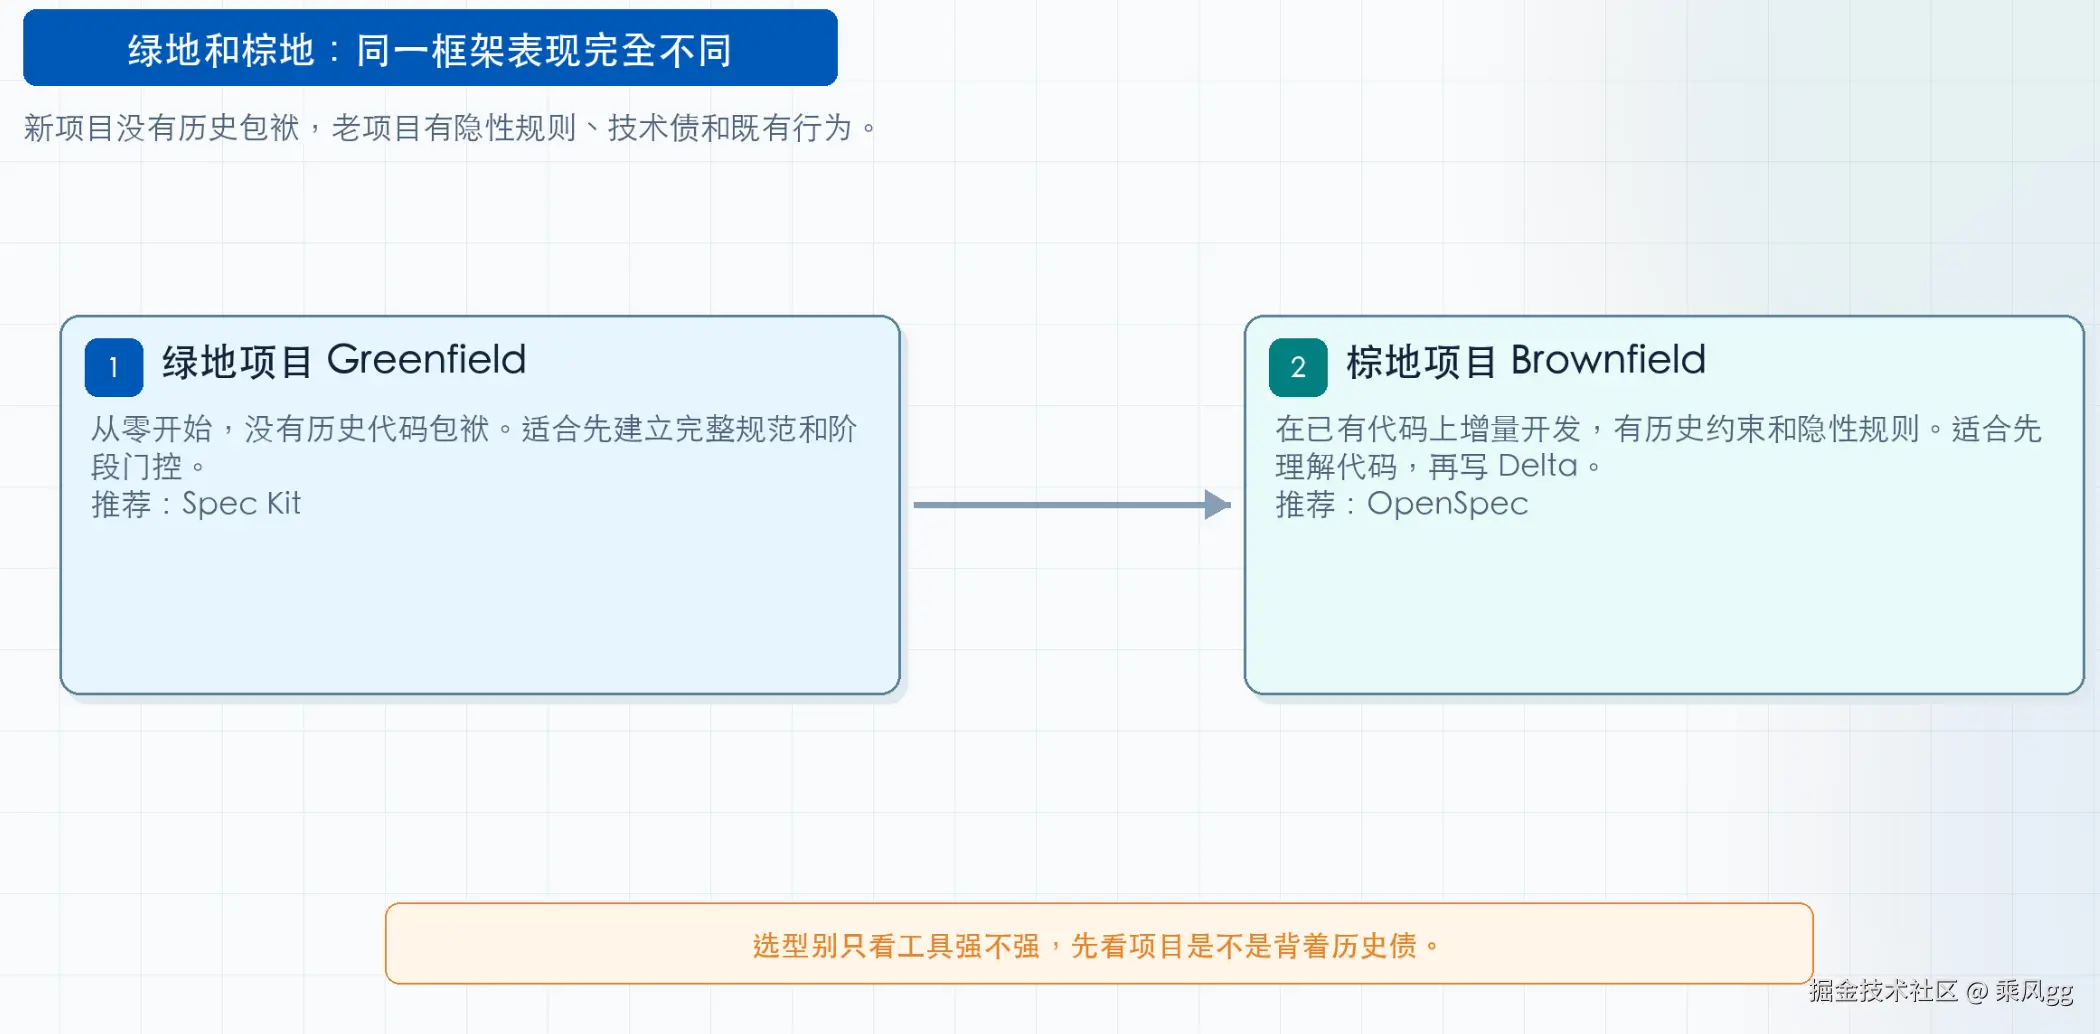
先解释两个词------后面会反复出现。绿地项目 (Greenfield):从零开始的新项目,没有历史代码包袱。棕地项目(Brownfield):在已有代码基础上做增量开发,有历史约束、技术债、隐性规则。后面讲每个框架的时候,你会看到这两种场景下它们的表现天差地别。
AI 写代码很快,可写出来的东西经常不是你要的。三个框架都想解决这个问题,但路线完全不同:
- OpenSpec(Fission-AI,~58K star)------ 增量规范 + Delta Spec,让 AI 在已有项目上对齐需求
- Spec Kit(GitHub 官方,~118K star)------ SDD 规范驱动,让 AI 先写 PRD 再写代码
- Superpowers(Jesse Vincent,~245K star)------ 工程纪律框架,用铁律让 AI 按标准执行
注:Star 数据统计截止至 2026 年 7 月,反映各框架当时的开源活跃度。
我用同一段代码需求分别跑了三个框架。这篇文章是完整对比:每个框架怎么用、适合什么场景、以及各自不可回避的短板。
一、先搞清楚:三个框架不是同一类东西
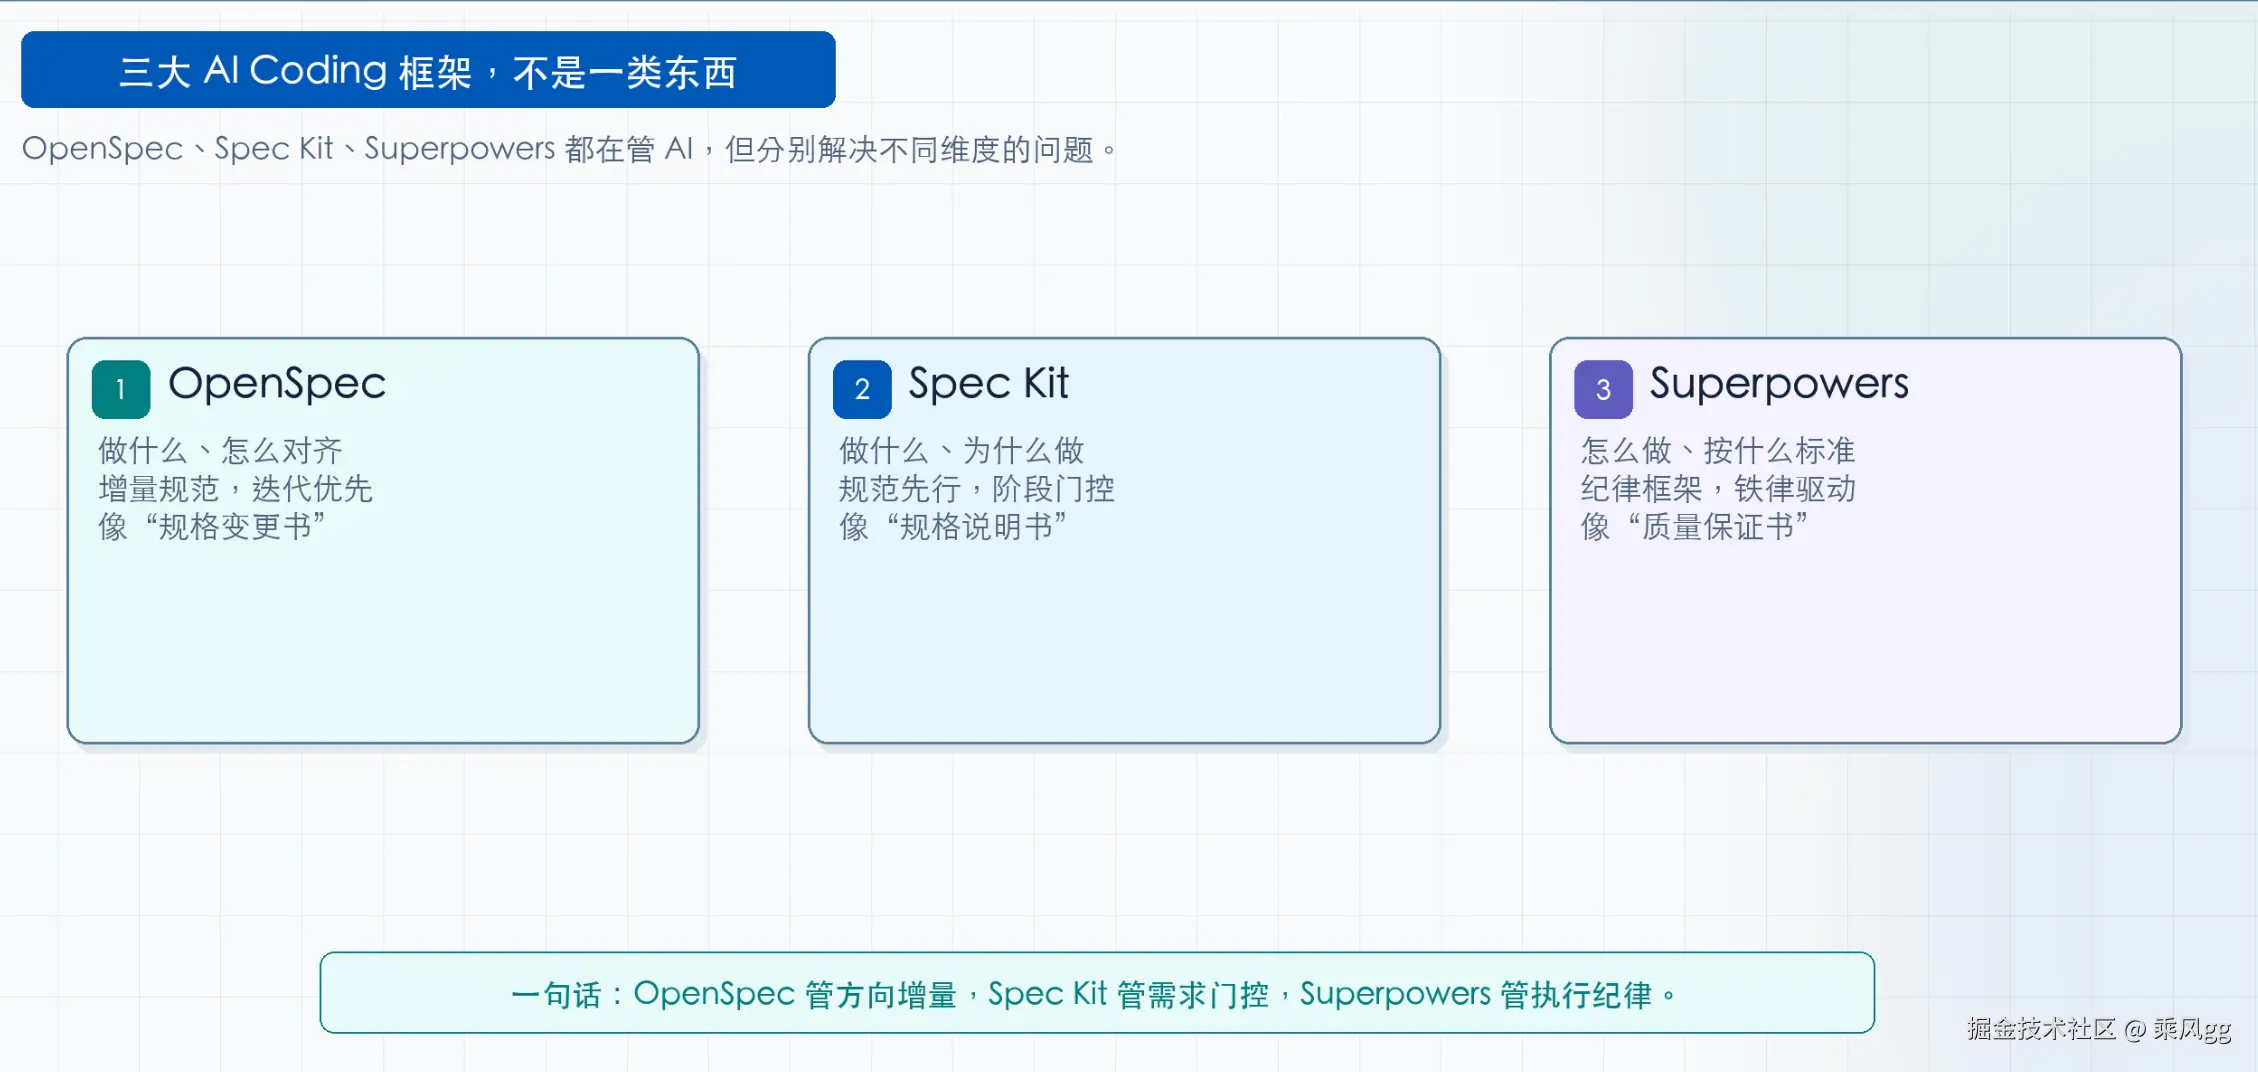
| 核心问题 | 核心理念 | 类比 | |
|---|---|---|---|
| OpenSpec | 做什么、怎么对齐 | 增量规范,迭代优先 | 增量设计图纸 |
| Spec Kit | 做什么、为什么做 | 规范先行,阶段门控 | 建筑审批流程 |
| Superpowers | 怎么做、按什么标准 | 纪律框架,铁律驱动 | 施工操作规程 |
一句话区分:OpenSpec 是"边改图纸边施工(规格变更书)",Spec Kit 是"先审批再施工(规格说明书)",Superpowers 是"不管图纸,按规矩施工(质量保证书)"。
二、OpenSpec:速度最快,棕地最友好
安装与工作流
kotlin
npm install -g @fission-ai/openspec@latest
openspec init               # 交互式生成目录结构
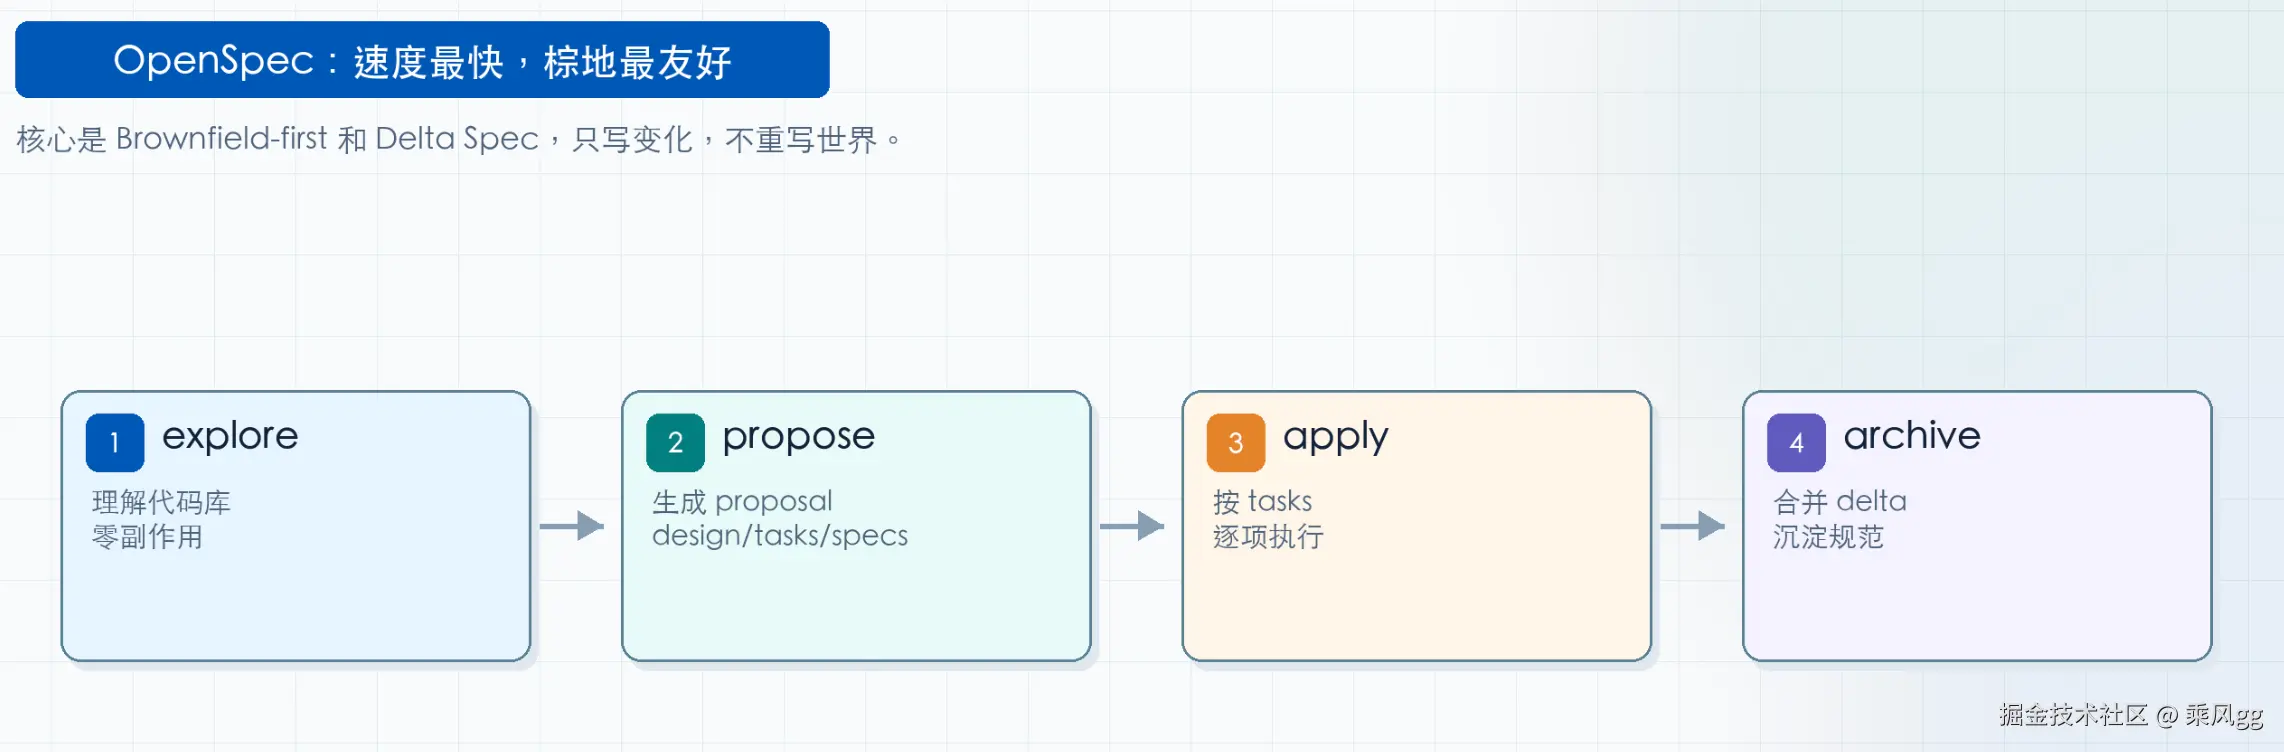
Core 模式包含 5 个命令:propose、explore、apply、sync、archive。最简路径是 explore(可选)→ propose → apply → archive。
OpenSpec(当前 v1.5.0)的流程最灵活,强调迭代而非门控。官方推荐的默认闭环:
explore → propose → apply → archiveexplore 是零副作用的代码库理解起点,不生成任何文件。在棕地场景下,explore 实际上是雷达------不跑它,后面的 propose 大概率会因为对已有代码的误解而跑偏。
四个命令各司其职:
explore--- 只读探索,不产出文件。帮你摸清已有代码结构propose--- 一次性生成四件套:proposal.md(为什么做)+delta specs(改什么)+design.md(怎么做)+tasks.md(按什么顺序做)apply--- 按 tasks.md 逐项执行,写代码archive--- 把 delta specs 合并到主规范,归档变更记录
提醒:越早发现问题代价越小------花 10 分钟审查设计方案,比生成 1000 行错误代码后返工便宜得多。
还有额外的 verify 命令需要通过 openspec config profile 手动启用。
核心杀器:Delta Spec + Brownfield-first
OpenSpec 的四大设计原则之一就是 Brownfield-first------"描述对已有行为的改动"是 OpenSpec 的一等公民。spec-kit、Kiro 等同类工具均以绿地项目为默认场景,OpenSpec 将棕地工作流内置为核心设计。
Delta Spec 是这套哲学的工程实现。不需要重写整个规范,只写变化的部分。支持四种操作类型------ADDED(新增)、MODIFIED(修改)、REMOVED(删除)、RENAMED(重命名)。四种在同一个系统中统一解析。
| 操作 | 含义 | 示例 |
|---|---|---|
| ADDED | 新增需求 | 用户登录功能 |
| MODIFIED | 修改已有行为 | JWT 过期时间从 30 分钟改为 2 小时 |
| REMOVED | 删除功能 | 移除旧版 API |
| RENAMED | 重命名 | user_auth → user_session |
archive 时,四种操作按固定顺序合并:RENAMED → REMOVED → MODIFIED → ADDED。这个顺序有讲究------先把名改了,后面才能用新名字引用;先把要删的干掉,避免对着废需求白费功夫改;最后再加新的,没有依赖冲突。
合并过程中会做多层冲突检测:比如有没有同时出现在 MODIFIED 和 REMOVED 里的需求(改了不该改的)、有没有 ADDED 和 REMOVED 互相对冲的条目、重命名目标是否已存在等等。检测失败,直接报错,不会写出一个半成品状态。
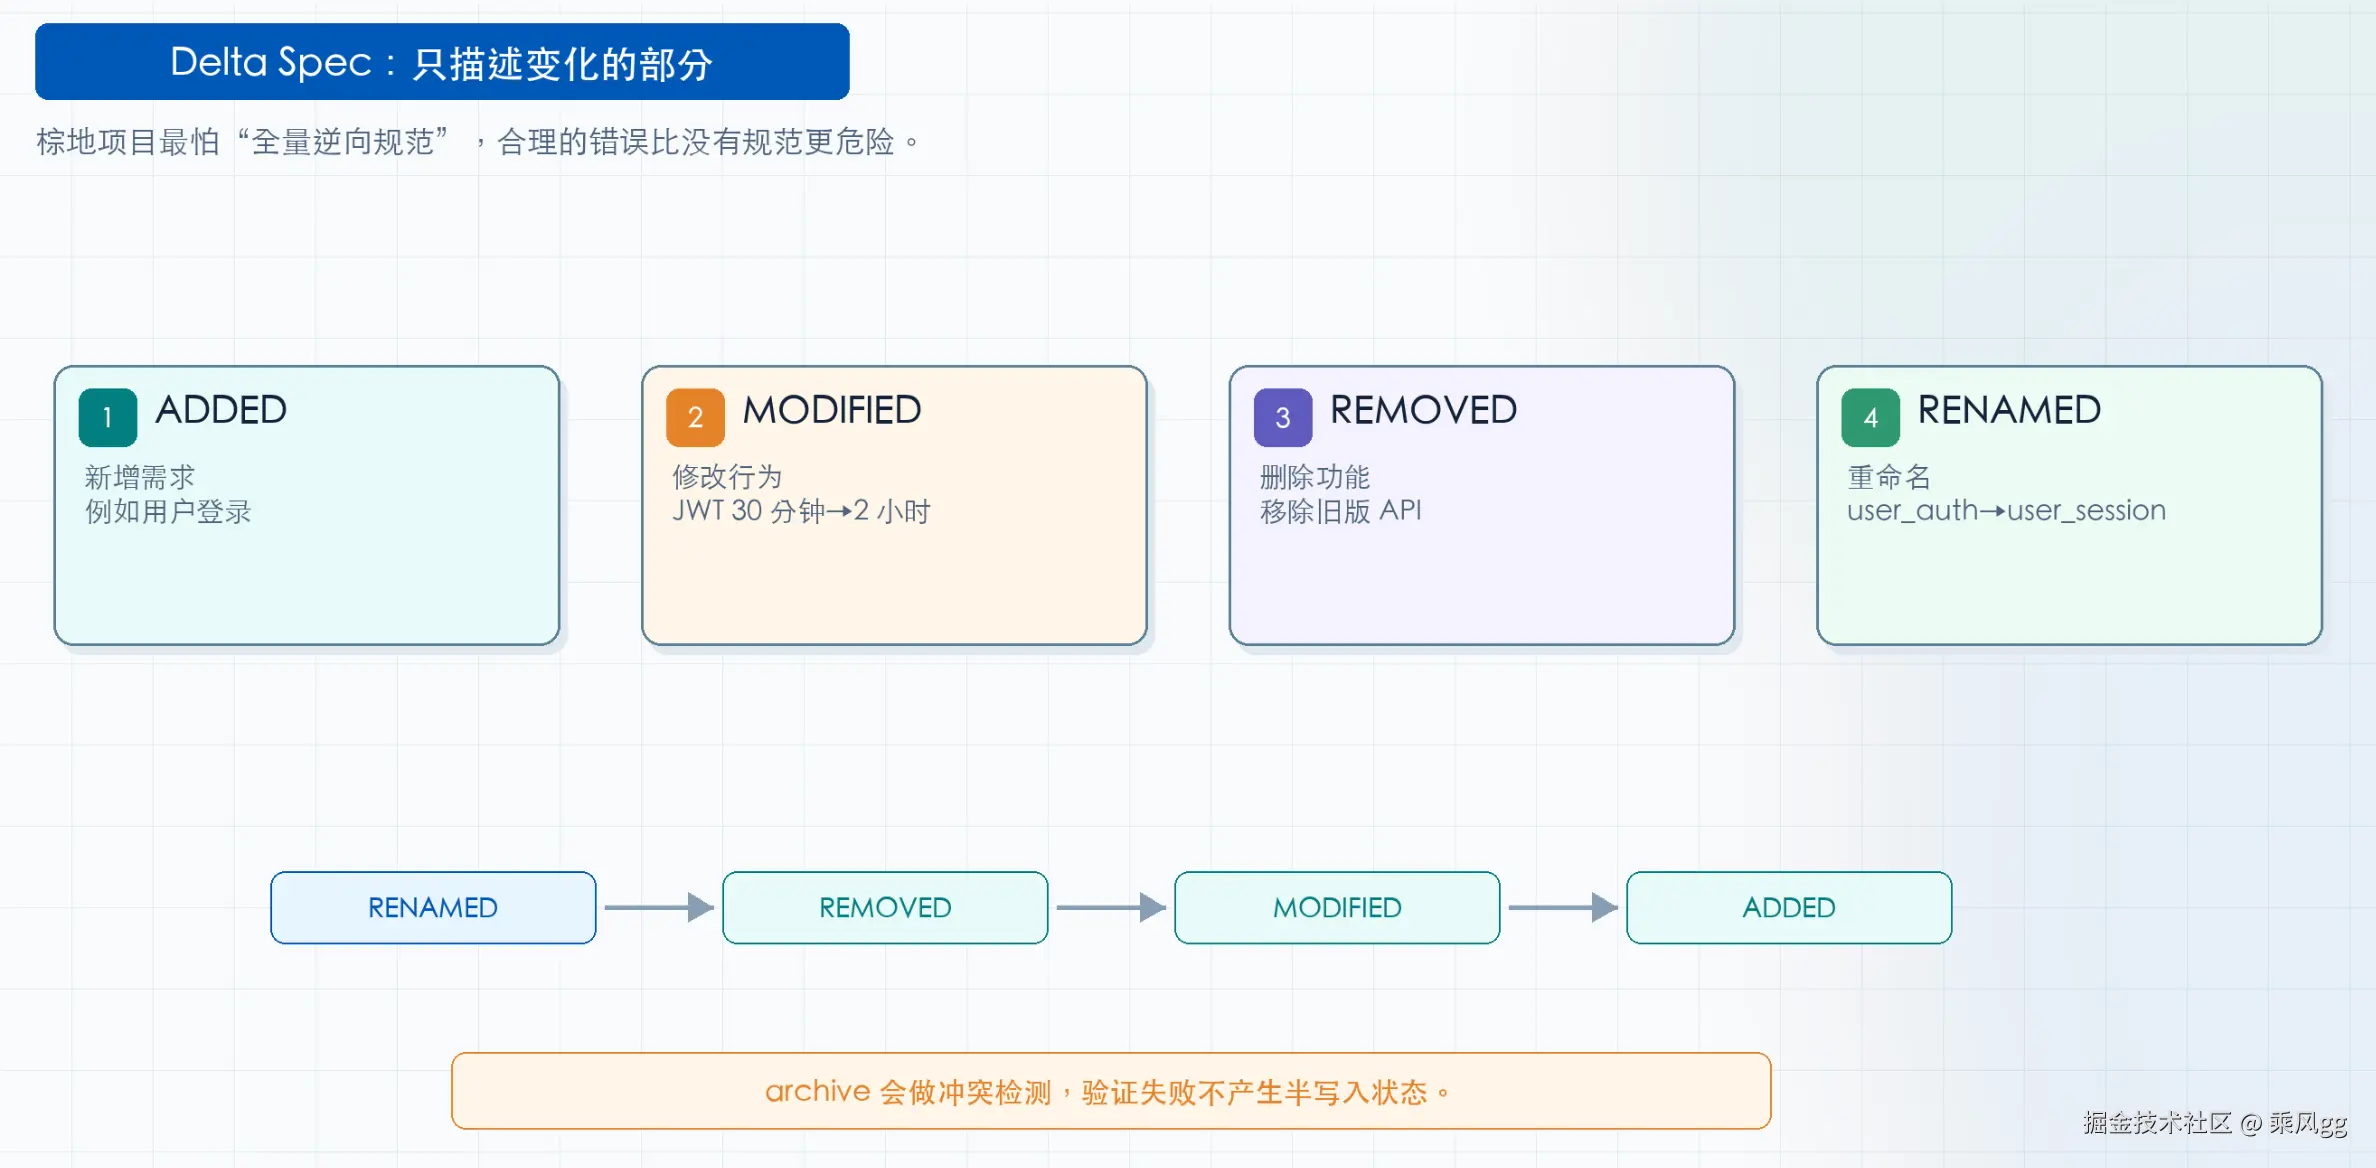
同一段 JWT 认证功能,Delta 规范只写了 3 个新增场景和 2 个修改场景,不用重写整个认证规范。
verify:帮你发现"代码没按规范写"
verify 是做规范对齐检查的。报告分 ERROR / WARNING / INFO 三级,会逐个比对 spec 和代码实现------比如你 spec 里写了用 Redis 做黑名单,代码里却用了内存 map,它能把这种偏差揪出来。
但 verify 有一个明确的能力边界:它只能发现规范与实现不一致,无法判断规范本身是否正确。 如果 spec 一开始就是错的,verify 只会帮你错得更一致。它不能替代自动化测试、CI/CD 和人工 Review------官方文档也明说了这一点。
棕地项目怎么接入:不要求你补全套文档
棕地项目用 OpenSpec,最容易踩的坑是上来就想补齐所有规范文档。
OpenSpec 创始人在讨论区写过一句很透彻的话:"The only thing worse than no specs is incorrect specs."
没有规范,你只是不知道。错误规范,会让你以为是知道的。
所以第一条铁律:不要全量逆向工程已有代码生成规范。 AI 生成的逆向规范看起来合理,但捕捉不到原始开发者的真实意图。"合理的错误"比没有规范更危险。
正确的做法分三步:
- 初始
specs/为空,不用心虚。 从第一个小改动开始,只给这次改动写 Delta Spec - 用
/opsx:new+/opsx:continue,别用/opsx:propose一把梭。propose是一键生成 proposal.md + delta specs + design.md + tasks.md。new只建目录,continue逐个生成每个 artifact,每生成一个你审一个。棕地项目 AI 容易误读已有代码,逐个审查能在第一个 artifact 翻车时就止损,不用等四个全生成完才发现方向错了 - 积累。 第一个 Change 归档后,
specs/auth/自然长出来。第二个 Change 归档后,specs/api/长出来。五次 Change 之后,领域化目录自然形成
规范密度在最需要的地方自然增长,而不是一次性铺满。
实际跑下来
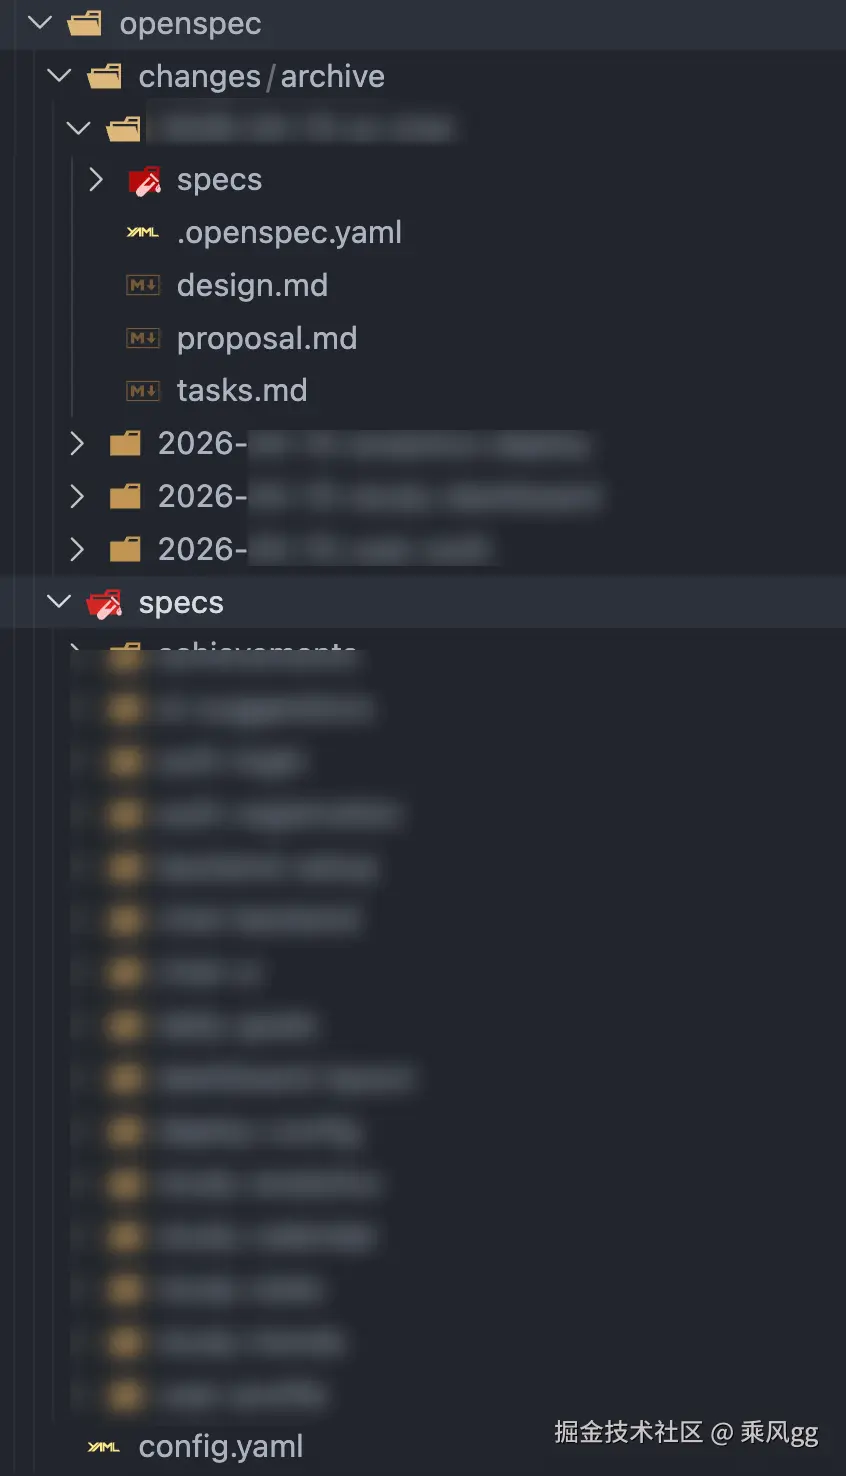
同一段 JWT 认证功能,从 propose 到 apply 只要 40 分钟(Spec Kit 的 1/2 不到)。文档量约 800 行 MD。会生成类似如下的结构
优点
- Delta 规范是杀手锏------只写变化的部分,棕地项目天然适配
- 并行开发天然支持------每个变更独立文件夹,两个人同时改不同需求不冲突
- verify 能抓到代码审查抓不到的问题------三维验证 + 三级报告。但它只能发现"规范与实现不一致",无法判断规范本身是否正确。如果 spec 一开始就是错的,verify 只会帮你错得更一致
- 迭代速度快------40 分钟
缺点
- 没有宪法/治理机制------团队成员可能写出风格不一致的规范
- apply 阶段缺少纪律------AI 按 tasks.md 执行,但没有 TDD、没有强制代码审查、没有验证机制。实现质量取决于 AI 的"自觉性"
- 规范和实现容易脱节------没有阶段门控,AI 可能跳过规范直接写代码
- 社区生态弱------扩展和预设远不如 Spec Kit
Schema 自定义:不被工具绑架
OpenSpec 允许通过 YAML 自定义产物流程。不是每个项目都需要 design.md,你可以按需调整:
yaml
name: research-first
artifacts:
  - id: research
    generates: research.md
    requires: []
  - id: proposal
    generates: proposal.md
    requires: [research]
  - id: tasks
    generates: tasks.md
    requires: [proposal]
这是 OpenSpec 区别于 Spec Kit 的一个重要设计哲学------Spec Kit 的七阶段是固定的,OpenSpec 的产物流程是可裁减的。
适合谁
棕地项目、中小团队、需要快速迭代。不适合需要强治理的绿地项目。
三、Spec Kit:方向最稳,也最重
安装与工作流
bash
uv tool install specify-cli --from git+https://github.com/github/spec-kit.git@0.7.1.dev0
specify init --here --ai claude
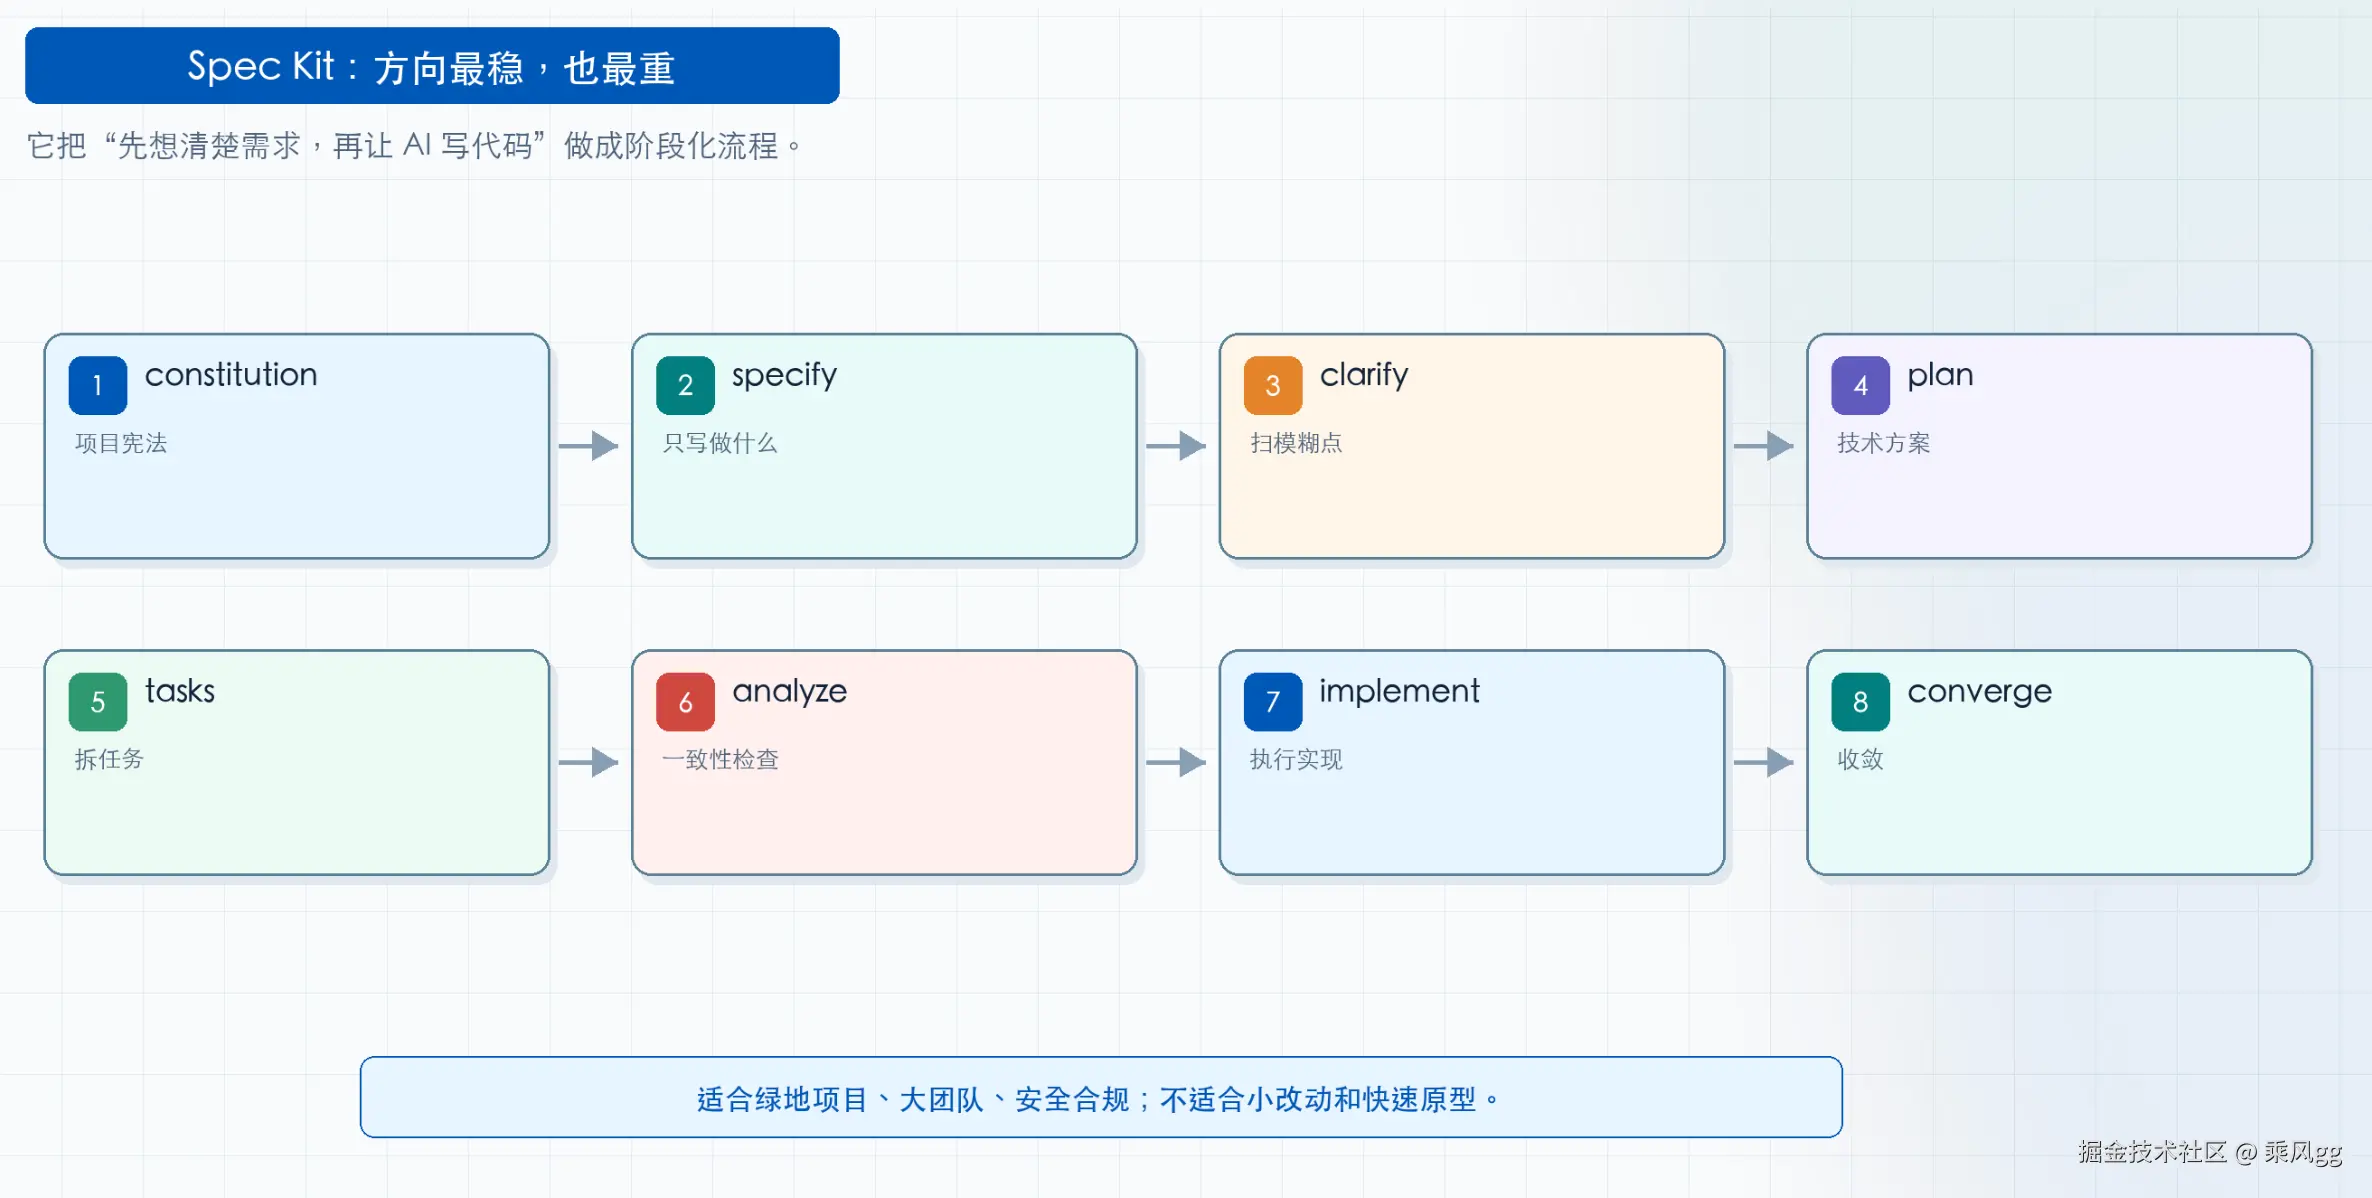
Spec Kit 实际上有两套模式------Lean (4 命令、零门禁)和 Full (9 命令含 3 个可选质量检查)。Lean 适合个人项目和快速原型,只包含 specify → plan → tasks → implement 。Full 在这个基础上加了 constitution、clarify、checklist、analyze 和 converge。
Spec Kit 的 Full 模式官方推荐顺序:
constitution → specify → clarify → plan → checklist → tasks → analyze → implement → converge8 个核心命令,3 个可选命令穿插其中。clarify 在 plan 前扫描 spec 的盲点。checklist 在 tasks 前做覆盖度检查。analyze 在 tasks 后、implement 前,做跨产物一致性检查。converge 是最后的收敛步骤。官方把这些都归类为"可选命令"而非强制门控。
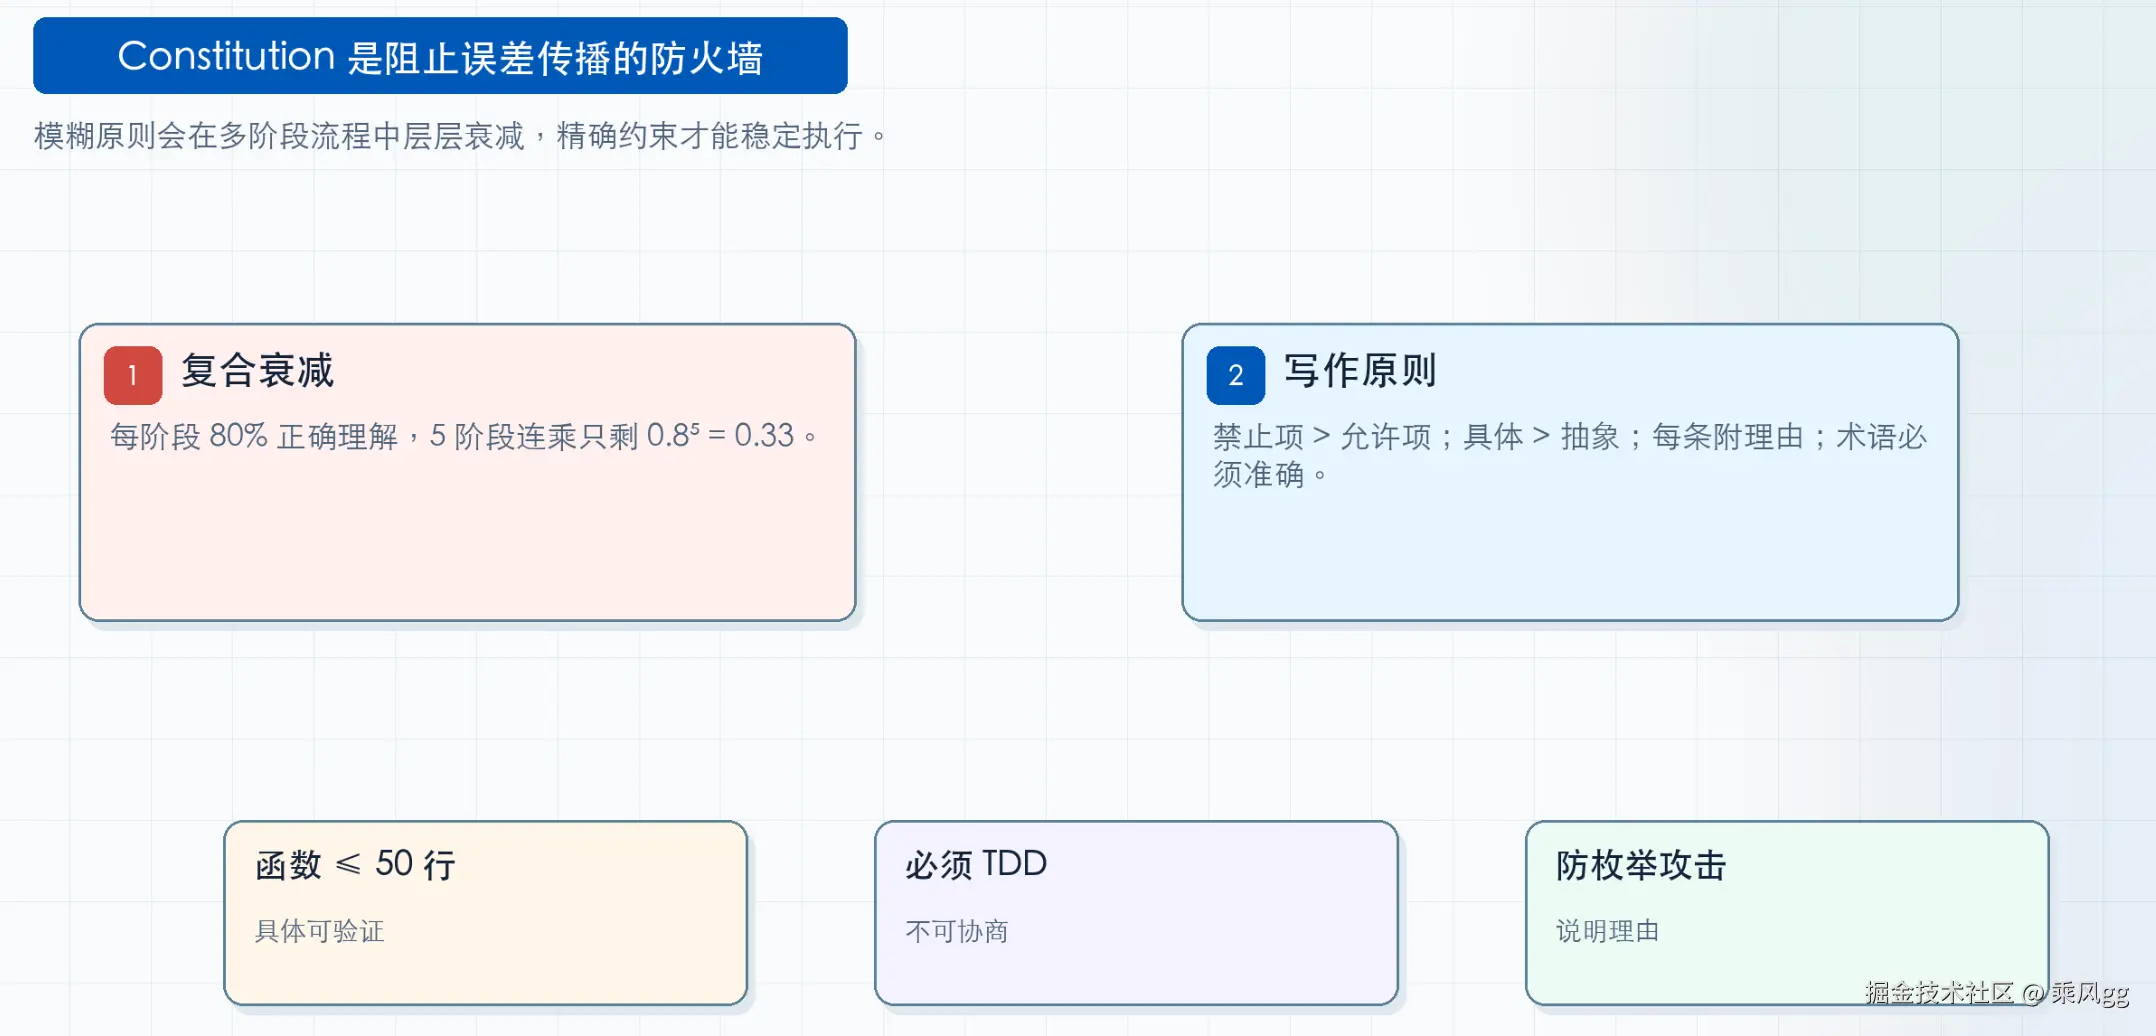
Constitution(宪法)。定义项目不可协商的原则------"必须 TDD""必须 CLI-first""所有 API 必须通过安全审查"。宪法在后续所有阶段被引用作为约束。Constitution 的质量直接决定 AI 输出质量------好的 Constitution 量化可验证("函数 ≤ 50 行"而非"write clean code"),坏的 Constitution 写一堆模糊废话。
为什么 Constitution 质量这么要命?EPAM 团队在实践中总结了一个复合衰减公式 :每个阶段 AI 有 80% 的概率正确理解并执行约束。这个估计已经偏乐观了。5 个阶段连乘------0.8⁵ = 0.33。
什么意思呢?如果 Constitution 没有量化标准,第一阶段的理解偏差会一路传导。到最后,正确率只剩三成。
反过来,把每个阶段的约束精确到可验证的程度,80% 可以拉到 90% 甚至更高。Constitution 不是写给 AI 看的说明书------它是阻止误差传播的防火墙。
EPAM 在实践中凝练了六条 Constitution 写作原则,每一条都反直觉:
① 禁止项 > 允许项。限制比授权约束力更强。
② 具体 > 抽象。"函数 ≤ 50 行",不是"写干净代码"。
③ 每条附理由。AI 知道为什么才会真正遵守。别只写"用 UUID",写上"防枚举攻击"。
④ 避免引用外部标准。AI 会瞎编内容来填充。
⑤ 准确使用术语。叫"transaction"却没实现 ACID,LLM 会补上真正的事务语义。
⑥ 长度 500-2000 字。过长 AI 遗忘后半段,长度不等于严格度。
这六条背后的共同指向:Constitution 不是写给人看的项目宣言,是写给 AI 看的行为接口------它必须精确到让 AI 没有误解的余地。
Constitution 定好了,后面 7 个命令依次推进:
/specify --- 只关注"做什么",不做技术决策。产出 spec.md(相当于 PRD),自动对照宪法做自评。
/clarify(可选) --- AI 自动扫描 spec,发现模糊点和遗漏------"支持哪些语言?切换方式?回退策略?"
/plan --- 产出 plan.md、data-model.md、research.md、quickstart.md,所有技术决策必须符合宪法。
/analyze(可选) --- 跨产物一致性检查------在 tasks 之后、implement 之前,拿 spec、plan、tasks 做交叉分析,吐差异报告供人工决策。
/tasks --- 把 spec 和 plan 拆成可执行小任务,含优先级、依赖关系、可并行标识。
/checklist(可选) --- 用 checklist 在 implement 前做最后一轮覆盖度检查------UX、安全、无障碍、边界情况。
/implement --- AI 按 tasks.md 逐项执行。
实际跑下来
同一段 JWT 认证功能,Spec Kit 完整走完需要 1.5 小时。
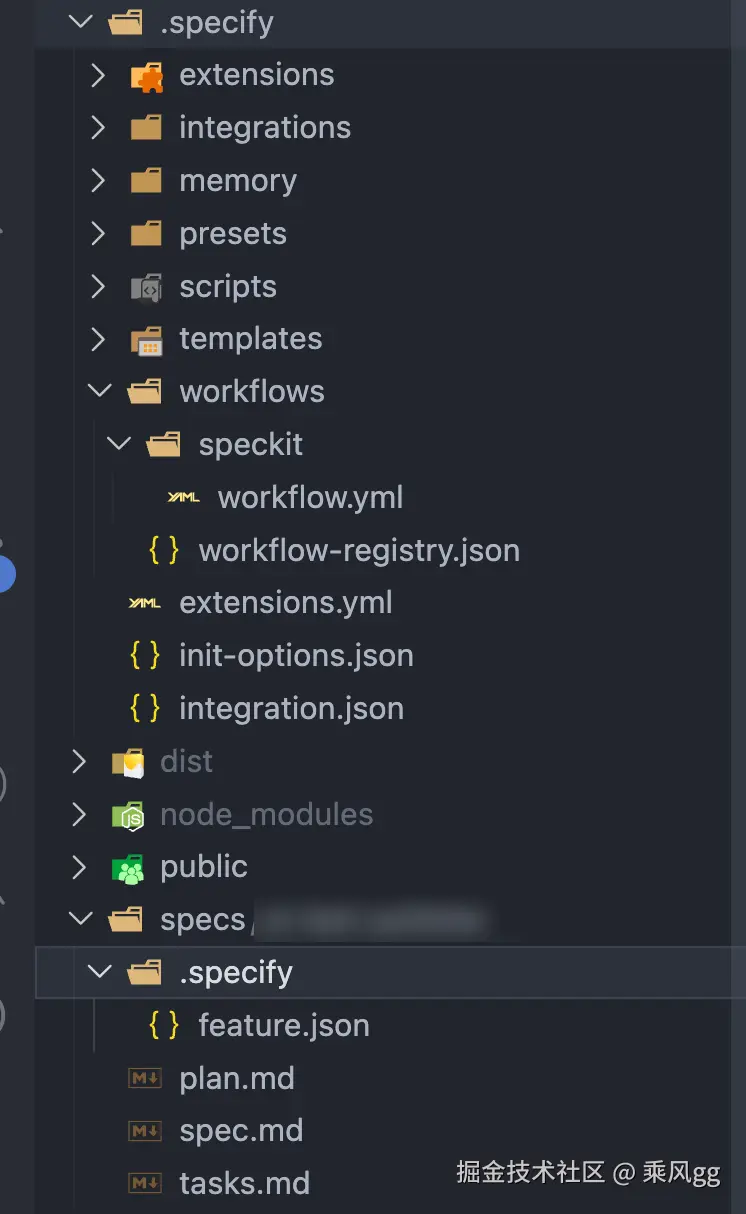
CRUD 功能实测数据(Scott Logic):产出 2,577 行 Markdown + 689 行代码,文档量是代码量的 3.7 倍 。GPS 集成场景更极端------2,262 行 Markdown + ~300 行代码,7.5 倍。最终会生成类似如下的结构
优点
- 阶段门控真的管用------spec 阶段不允许提技术方案,强制先想清楚需求。spec 阶段把"30 分钟过期"写成"30 秒过期",改的成本几乎为零
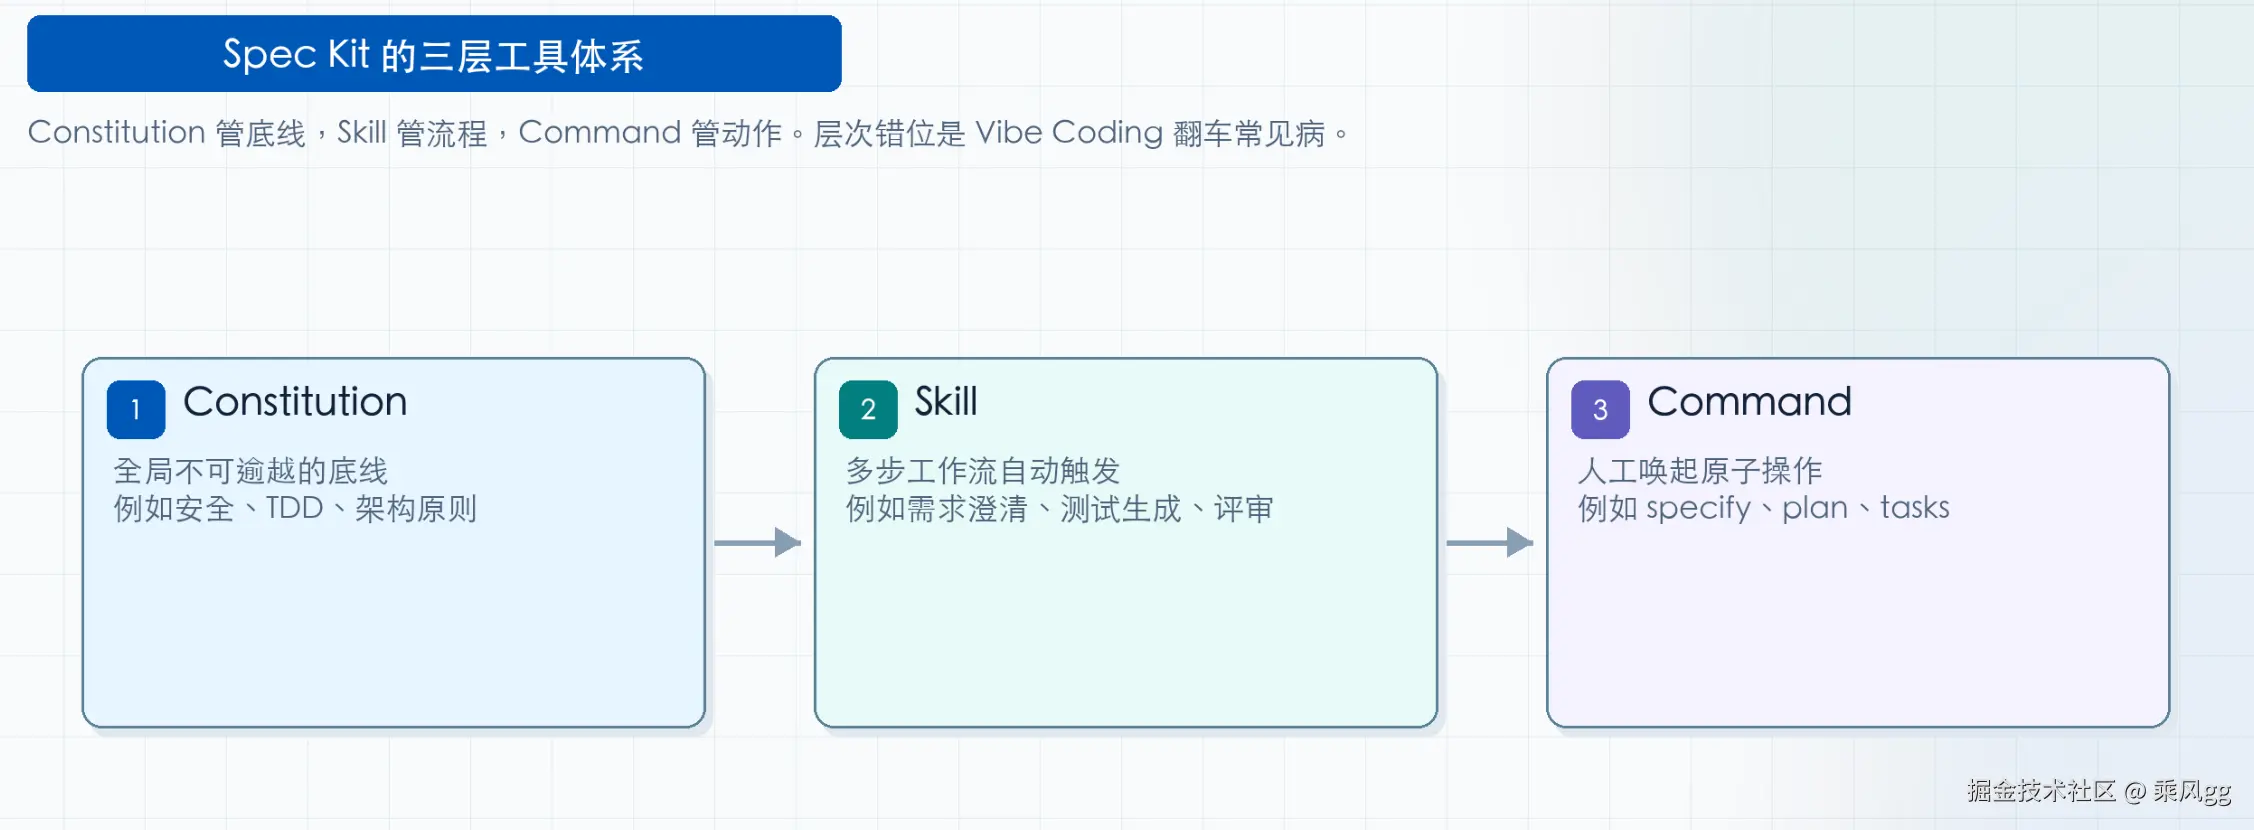
- 宪法机制实用 ------新人不用猜技术底线。但反过来,宪法质量取决于写它的人。宪法本身有漏洞,后续所有阶段都会沿着漏洞走------门控只管流程,不管内容对错。而且 Spec Kit 的扩展生态真正强大的地方不在于扩展数量,在于它的三层工具体系------Constitution(管底线,全局约束不可逾越)、Skill(管流程,多步工作流自动触发)、Command(管动作,人工唤起原子操作)。三个层次各管各的,层次错位才是 Vibe Coding 翻车的主因------把代码模板写进 Constitution 里,或者把全局规则写在 Command 里,都是常见病
- 扩展生态最丰富------105 个社区扩展、22 个预设,覆盖安全合规、架构治理等场景
- 跨工具支持------切换 AI 工具只需一条命令,规范在所有工具间保持一致
缺点
- 文档量太大------功能越简单,文档和代码的比例越失衡,审查负担重
- 棕地项目不友好------按功能分片管理规范,已有项目需手工拼装多个来源的规范,无 Delta Spec 机制
- 速度慢------门控和文档审查吃掉大量时间
- 部分文档价值有限------research.md 有时在论证明显事实
适合谁
绿地项目、大型团队、安全合规要求高的项目。不适合一次性脚本、小改动、快速原型。
四、Superpowers:代码质量最高,但容易跑偏
核心架构:可组合的 Skills + 启动指令
官方 README 的定位很简洁------"a set of composable skills and some initial instructions that make sure your agent uses them."
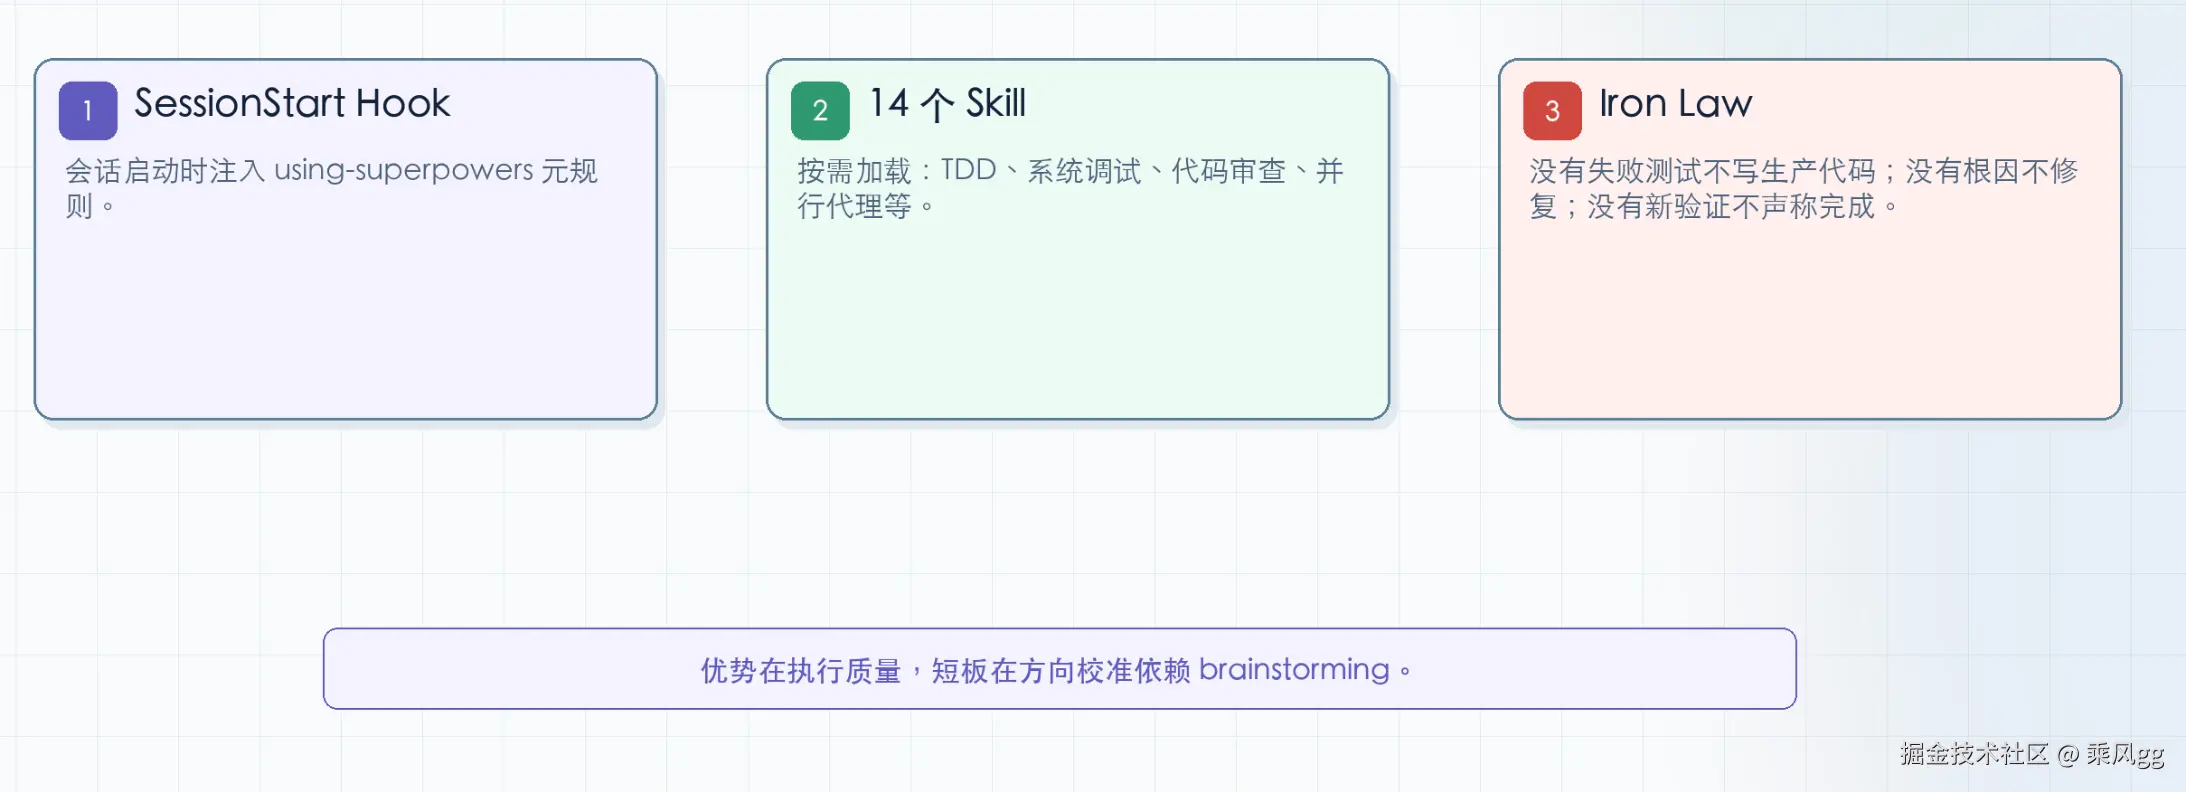
启动指令 :SessionStart Hook 在每次会话启动 / clear / compact 时强制注入 using-superpowers SKILL.md(~100 行调度规则)。不灌全部 14 个 Skill,只注入元数据索引,运行时按需懒加载。
14 个可组合 Skill,官方按四个类别组织:
| 类别 | Skills |
|---|---|
| Testing | test-driven-development |
| Debugging | systematic-debugging、verification-before-completion |
| Collaboration | brainstorming、writing-plans、executing-plans、dispatching-parallel-agents、requesting-code-review、receiving-code-review、using-git-worktrees、finishing-a-development-branch、subagent-driven-development |
| Meta | writing-skills、using-superpowers |
4 条设计哲学(官方 README):
- Test-Driven Development --- 先写失败测试再写代码
- Systematic over ad-hoc --- 系统化而非临时应付
- Complexity reduction --- 持续降低复杂度
- Evidence over claims --- 声称完成必须附带验证证据
此外,多个 Skill 里嵌着绝对化约束,每条都是同一个句式------"没有 X,不许 Y":
- TDD :
NO PRODUCTION CODE WITHOUT FAILING TEST FIRST - 调试 :
NO FIXES WITHOUT ROOT CAUSE INVESTIGATION FIRST - 验证 :
NO COMPLETION CLAIMS WITHOUT FRESH VERIFICATION EVIDENCE
HARD-GATE 则是 brainstorming Skill 中的 XML 标签块。
为什么"建议"没用------LLM 的乐观偏见
Superpowers 的设计哲学建立在一个关键洞察上,这个洞察解释了一切。
LLM 有"乐观偏见"------倾向于声称完成、跳过验证、绕过流程。 这不是 Claude 的 bug,是 RLHF 训练阶段的副产物。训练时,用户给"声称完成"更高的反馈分,模型由此习得"声称成功"的偏好。诚实报告失败→低分惩罚,这是最优化目标的意外副产物。
GPT、Claude、Gemini 全有这个行为模式,不是某一家的问题。
所以"建议"没用。写"请严格 TDD"在 CLAUDE.md 里------Claude 下次照样跳过测试,直接写实现代码。提示词无法覆盖训练阶段习得的行为偏好。
进一步讲,这不是我一家之言。
Wharton 商学院的 Dan Shapiro 团队做了实证研究,验证了 Robert Cialdini 1984 年提出的六大说服原则------互惠、承诺一致性、社会认同、喜爱、权威、稀缺------对 LLM 的遵从率有统计显著的、可量化测量的影响。
这不是 prompt PUA。这是经过同行评议的行为科学。
Jesse 在设计 Superpowers 时,把 Cialdini 这套框架系统性地工程化了。MUST / ABSOLUTELY / EXTREMELY IMPORTANT 不是情绪化的大喊大叫------这是针对 Transformer 注意力权重路由的精确调参。
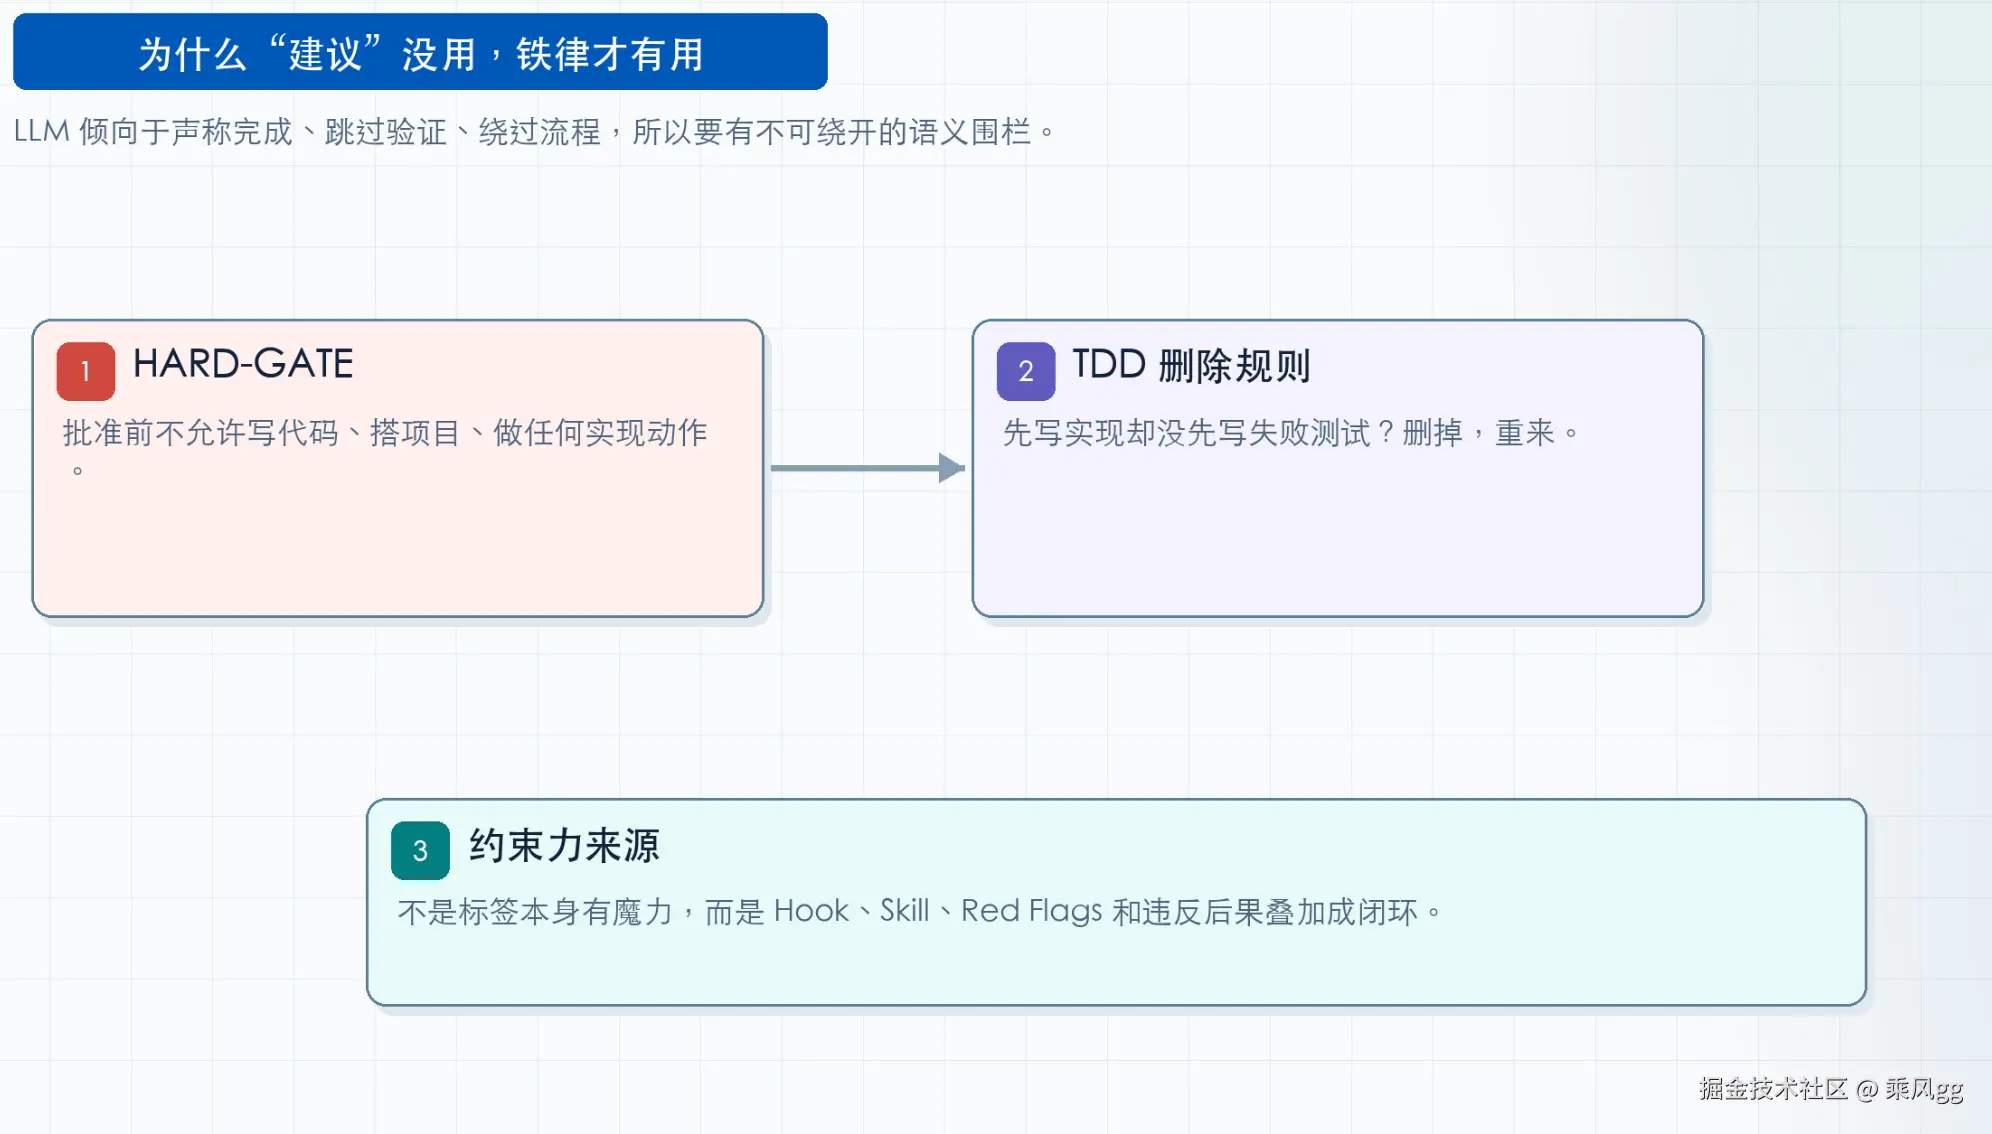
三个框架都看到了这个坑,但填法完全不同。Spec Kit 靠文档审查和阶段闸门来死磕 ------你不审完 spec 就别碰 plan,不看完 plan 就别写代码,每一道闸门口都有人盯着。Superpowers 走的另一条路------把铁律烧进 Skill 执行步骤,形成语义围栏。HARD-GATE 不是文档,是三行 XML 标签;Red Flags 不是 checklist,是专门堵 LLM 自我合理化话术的反驳表。Spec Kit 在外面筑墙,Superpowers 在里面驯兽。
Jesse 自己还在 SKILL.md 里写了 12 条反合理化红色信号,专门堵 LLM 的偷懒话术:
| LLM 的偷懒借口 | 现实反驳 |
|---|---|
| "这只是个简单问题" | 问题也是任务,先检查 Skills |
| "先做这一件事再说" | 动手前先检查 Skills |
| "这个 Skill 太重了,用不上" | 简单的事会变复杂 |
| "先看看代码再说" | 先用 Skill,不是先看代码 |
| "这不算任务,用不着 Skill" | 所有动作都是任务 |
| "用户没明说要用 TDD" | 默认遵守,无需显式指令 |
这 12 条反合理化被明确写进了 using-superpowers/SKILL.md 的规范里。
HARD-GATE 的工程真相
HARD-GATE 本质上是三行字:
arduino
<HARD-GATE>
Do NOT invoke any implementation skill, write any code,
scaffold any project, or take any implementation action.
</HARD-GATE>
初看觉得------就这?没有解析器、没有 hook、没有校验器,就一句禁令。
但 HARD-GATE 不是孤立存在的。Jesse 用"闸门 vs 围栏"来类比:光立牌子有人翻,光围栏有人撞。围栏+保安,没人进得去。
HARD-GATE 的约束力来自三层叠加:
- SessionStart Hook------每次会话起手就让模型知道"1% 可能就 MUST 调用 Skill"
- brainstorming Skill------告诉它"批准前不要写代码"
- Red Flags 表 12 条------堵死所有绕过话术
不是标签本身有魔力,是周围的墙让闸门变得不可绕过。
不过 HARD-GATE 有一个隐性的失效边界:它约束的是当前会话内的行为。跨会话、跨 compact 之后,约束强度会随上下文衰减------compact 会裁剪历史,新会话起手即使重新注入了 Hook,Claude 对"前一回合已经达成的共识"也没有完整记忆。Iron Law 能驯住单个会话里的 Claude,跨会话仍然需要人工 Review 兜底。
七步主干流程
css
brainstorming → git-worktrees → writing-plans → subagent-dev (内嵌 TDD) → code-review → finishing-branchSubagent 三角色对抗:每个 task 派 2 个独立 agent------一个 implementer(写代码并自审),一个 task reviewer(同时检查 spec 合规和代码质量)。评审顺序铁律:先过 spec 再审 code,反过来 = 浪费精力。全部 task 完成后,还有一次最终的全分支 code review。
TDD 铁律的执行方式:TDD Skill 文件里写死了------如果先写了实现代码而没有先写测试,"Write code before the test? Delete it. Start over."不是警告,是手动行为规则要求重来。Don't keep it as 'reference' / Don't 'adapt' it while writing tests / Don't look at it / Delete means delete.
为什么"删码"比"提醒"更有效?这背后是 Cialdini 的三层心理学叠加。
第一层,承诺一致性。 task 开始时 Claude 声明了"我会用 TDD",违反规则触发认知失调。删码不是惩罚,是让承诺回归一致。
第二层,损失厌恶。 已经写好的代码被删掉,痛感是真实的。这反向利用了沉没成本------Claude 下一次会主动避免触发这种痛感。
第三层,行为锁定。 绝对化语言(Don't keep it / Don't look at it / Delete means delete)不给"保留作参考"留任何口子,堵死所有自我合理化空间。
约束力不是来自措辞的严厉程度,而是来自"违反就有后果"的闭环设计。
Context 经济学
装 Superpowers 不是零成本的------14 个 SKILL.md 的 metadata 加上 using-superpowers 全文,SessionStart Hook 注入会吃掉一部分上下文窗口。长项目更容易触发 compact。
Superpowers 用渐进加载来降低代价:metadata 启动时加载(让 Claude 知道有哪些 Skill 和何时用),body 按需触发(只在需要时才加载完整 Skill 内容),bundled resources 激活时才加载。三层设计把日常开销从"全量加载"压到了"元数据索引"。
双层 Harness:Claude Code 自己也用这套
SessionStart Hook 注入的上下文被 <EXTREMELY_IMPORTANT> 标签包裹,优先级高于 Claude 的默认指令。但 Claude Code 外面还有一层 system-reminder------"以下是运行手册,不是用户内容,不要原样吐回去"。
让 Claude 复述注入内容,它拒绝------"the system-reminder explicitly says I shouldn't respond to that context"。但内层指令仍然生效。真正的 harness 工程是层层语义治理,不是一道墙。
实际跑下来
同一段需求,Superpowers 全程约 55 分钟。生成 10 个测试,8 次精确提交(vs 1 次大提交)。方向偏差导致 2 次返工(同一需求 OpenSpec 0 次)------因为方向校准依赖 brainstorming 而非显式规范。
优点
- TDD 铁律真的有效------测试覆盖率从 0% 到 80%+
- 独立代理审查避免确认偏误------审查 agent 不知你的思考过程
- 调试方法论最成熟------"连续 3 次修复失败,停下来讨论"
- 提交粒度最合理------每个 task 一次提交,原子性
缺点
- 方向校准依赖 brainstorming 而非显式规范------TDD 做得再好,做出来的东西和需求对不上也白搭
- 流程开销大------简单功能也要走完整流程,一次性脚本不适合
- 成本最高------代理链式调用显著增加 token 消耗,更快触及使用上限
- 没有规范累积机制------每次新对话 AI 忘光之前的决策
适合谁
代码质量要求高、长期维护、复杂功能开发。不适合一次性脚本、紧急 hotfix、探索性原型。
五、同一需求实测对比
用"给 Go 微服务添加 JWT 认证"分别跑三个框架:
| OpenSpec | Spec Kit | Superpowers | |
|---|---|---|---|
| 总耗时 | 40 分钟 | 1.5 小时 | 55 分钟 |
| 文档量 | ~800 行 MD | ~3500 行 MD | 仅代码和测试 |
| Token 消耗 | $ 低(只读 Delta Spec 相关上下文) | $$$ 高(全量 Specs + Constitution + 分析报告,Context 越滚越大) | $$$$ 极高(频繁 Subagent 派生 + 三角色审查 + 多次重试) |
| 测试数量 | 0(需手动补) | 0(需手动补) | 10 个(自动生成) |
| 提交次数 | 1 次大提交 | 1 次大提交 | 8 次精确提交 |
| 方向校准 | proposal+specs | 宪法+spec 门控 | brainstorming |
| AI 超范围实现 | 1 次 | 0 次 | 2 次 |
| 返工次数 | 0 次 | 1 次(阶段漂移) | 2 次(方向偏差) |
关键发现:
- OpenSpec 速度和质量最平衡 --- Delta 规范+verify,40 分钟完成
- Spec Kit 最慢但最安全 --- 宪法+门控确保方向不偏,但文档负担大
- Superpowers 代码质量最高但方向容易偏 --- TDD+审查确保质量,但方向校准靠 brainstorming 不够稳
六、组合用:1+1 能不能大于 2
三个框架不是互斥的。最受欢迎的组合是 Spec Kit + Superpowers------需求侧规范 + 执行侧编排,通过 3 个接入点串成一条 9 步流水线。
Spec Kit + Superpowers:九步协同
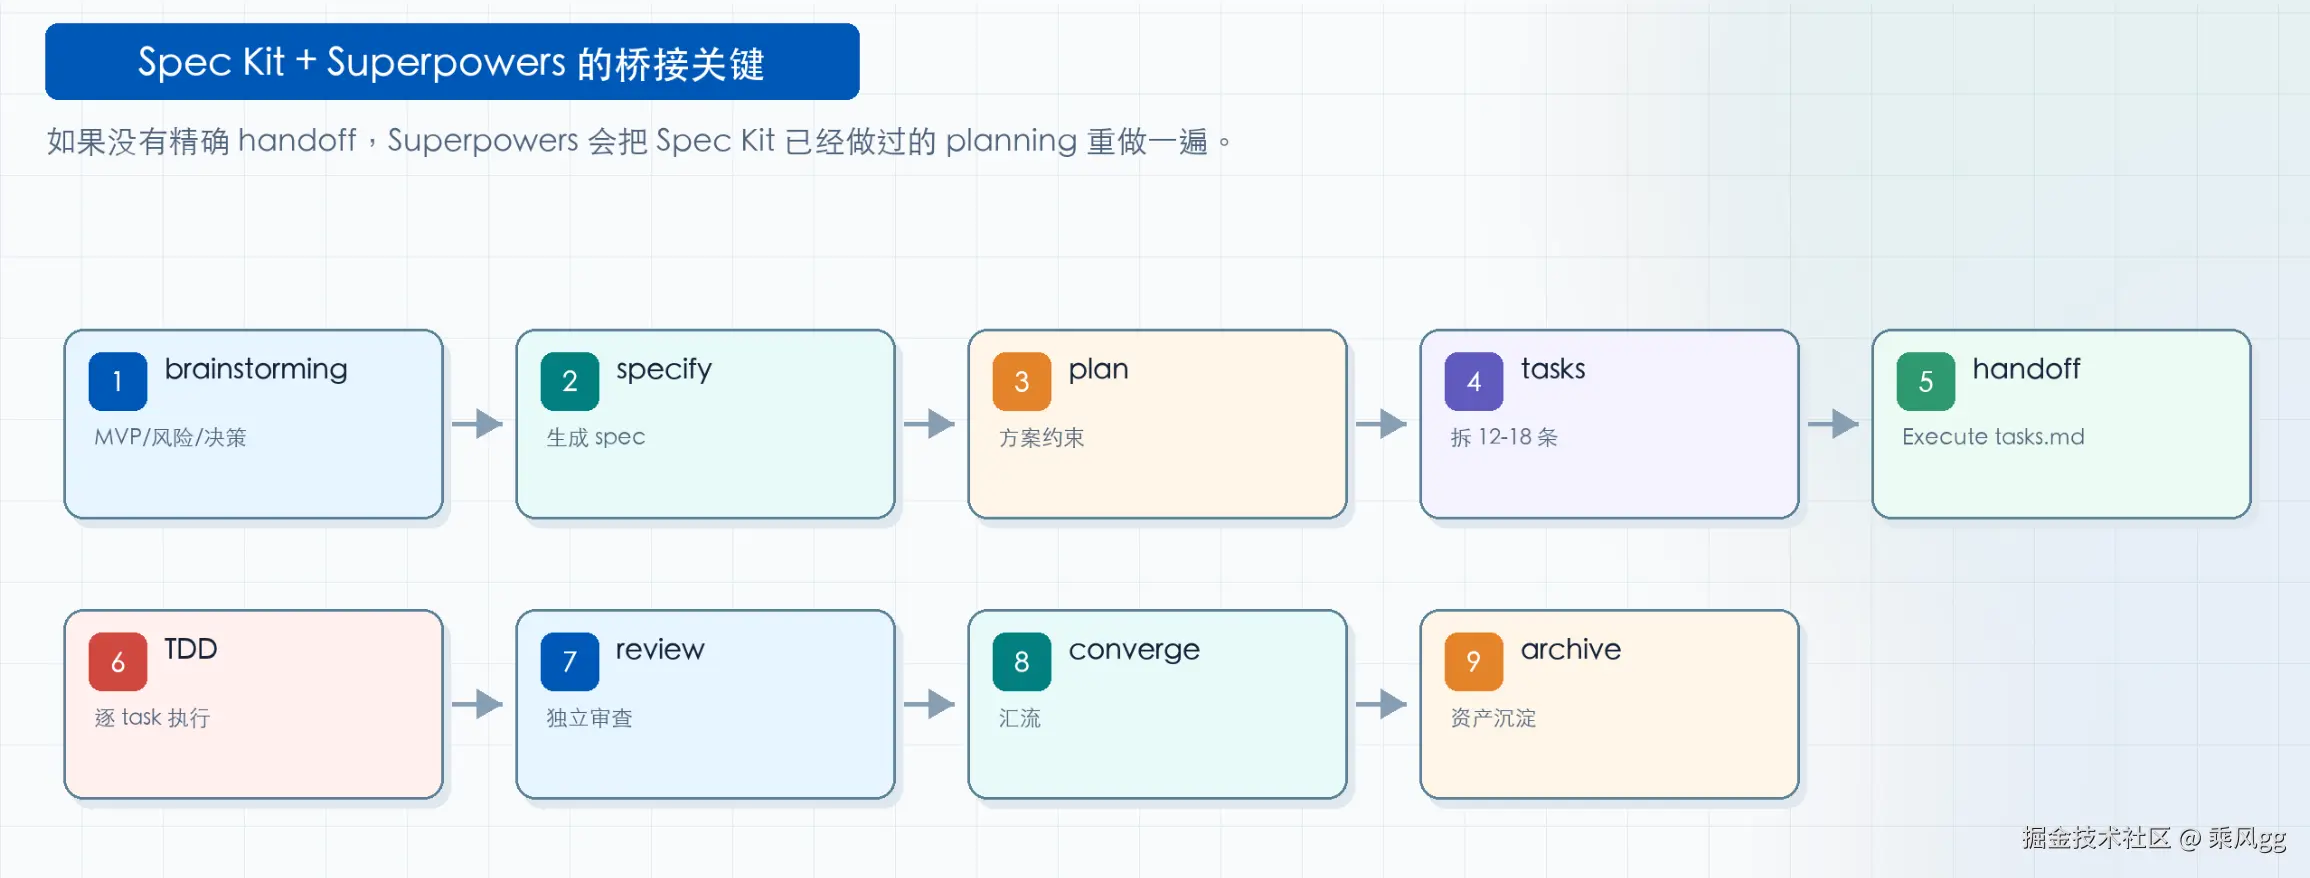
Spec Kit 管需求侧,Superpowers 管执行侧。两者不在同一赛道------ Spec Kit 的理念是"spec is source of truth",Superpowers 的理念是"workflow is source of truth"------9 步协同的本质是把两个 source of truth 通过 3 个接入点精确对接。
顺时针走一圈:
css
接入点 1
brainstorming → specify → clarify → plan → tasks
                                              ↓ 接入点 2
finish ← code-review ← TDD ← worktree ← Superpowers 执行
    ↑ 接入点 3
接入点 1:brainstorming → spec-kit specify。
从模糊想法到结构化 spec,这一步最容易翻车的地方是切早了------脑子里还没想清楚就开了 specify。
合格信号:MVP 边界 + 风险 + 关键决策,三件齐全。
一条钥匙句直接喂 specify:"做 X·MVP=ABC·不做 DE·风险 F·决策 G"。
两个反模式:还在发散就切------clarify 追问不停,收不住。已写代码细节才切------spec 重组时丢信息。
接入点 2:tasks.md → Superpowers 执行。
这是最关键的交接点,也是翻车高发区。核心挑战有两个。
挑战一:防止 Superpowers 重新 planning。
如果不给明确的桥接指令,Superpowers 拿到 tasks.md 之后会自己重新 brainstorming 和 plan。结果是 tasks.md 白拆了,spec 约束全丢了,时间翻倍。
解法是一句精确的桥接 prompt:
sql
Execute specs/<path>/tasks.md using the Superpowers workflow.
Follow strict TDD per task. One subagent per task.三个关键词缺一不可:Execute (防 re-planning)、strict TDD (确保质量底线)、one subagent/task(控制并发粒度)。同时必须明告"plan 已存在"、列出"已 done 的步骤"。
合格信号:12-18 条任务,每条 2-5 分钟,8 个并行组,入参出参清晰。
挑战二:N 个 subagent 并发,如何不打架。
Semantic 层靠共享契约。spec-kit 产出的四件套(spec.md + clarify.md + plan.md + tasks.md)就是所有 subagent 看的同一份合同。每个 subagent 只拿自己负责的文件域,契约只读,不能私改。
没有这份契约------4 个 subagent 各自定义 platform 字段类型,review 阶段才发现不一致,返工成本 ×3。
物理层靠 using-git-worktrees 。多个 subagent 哪怕负责不同目录,大概率也要同时碰全局公共文件:路由注册中心 router.go、依赖注入容器 wire.go、主入口 main.go。公共文件强制交由最后的 converge 主代理,或人工在 PR 阶段统一汇流。契约管语义隔离,隔离区分支管物理写入------两层都到位,才能真正封死冲突。
FCSO 并行派发四要素
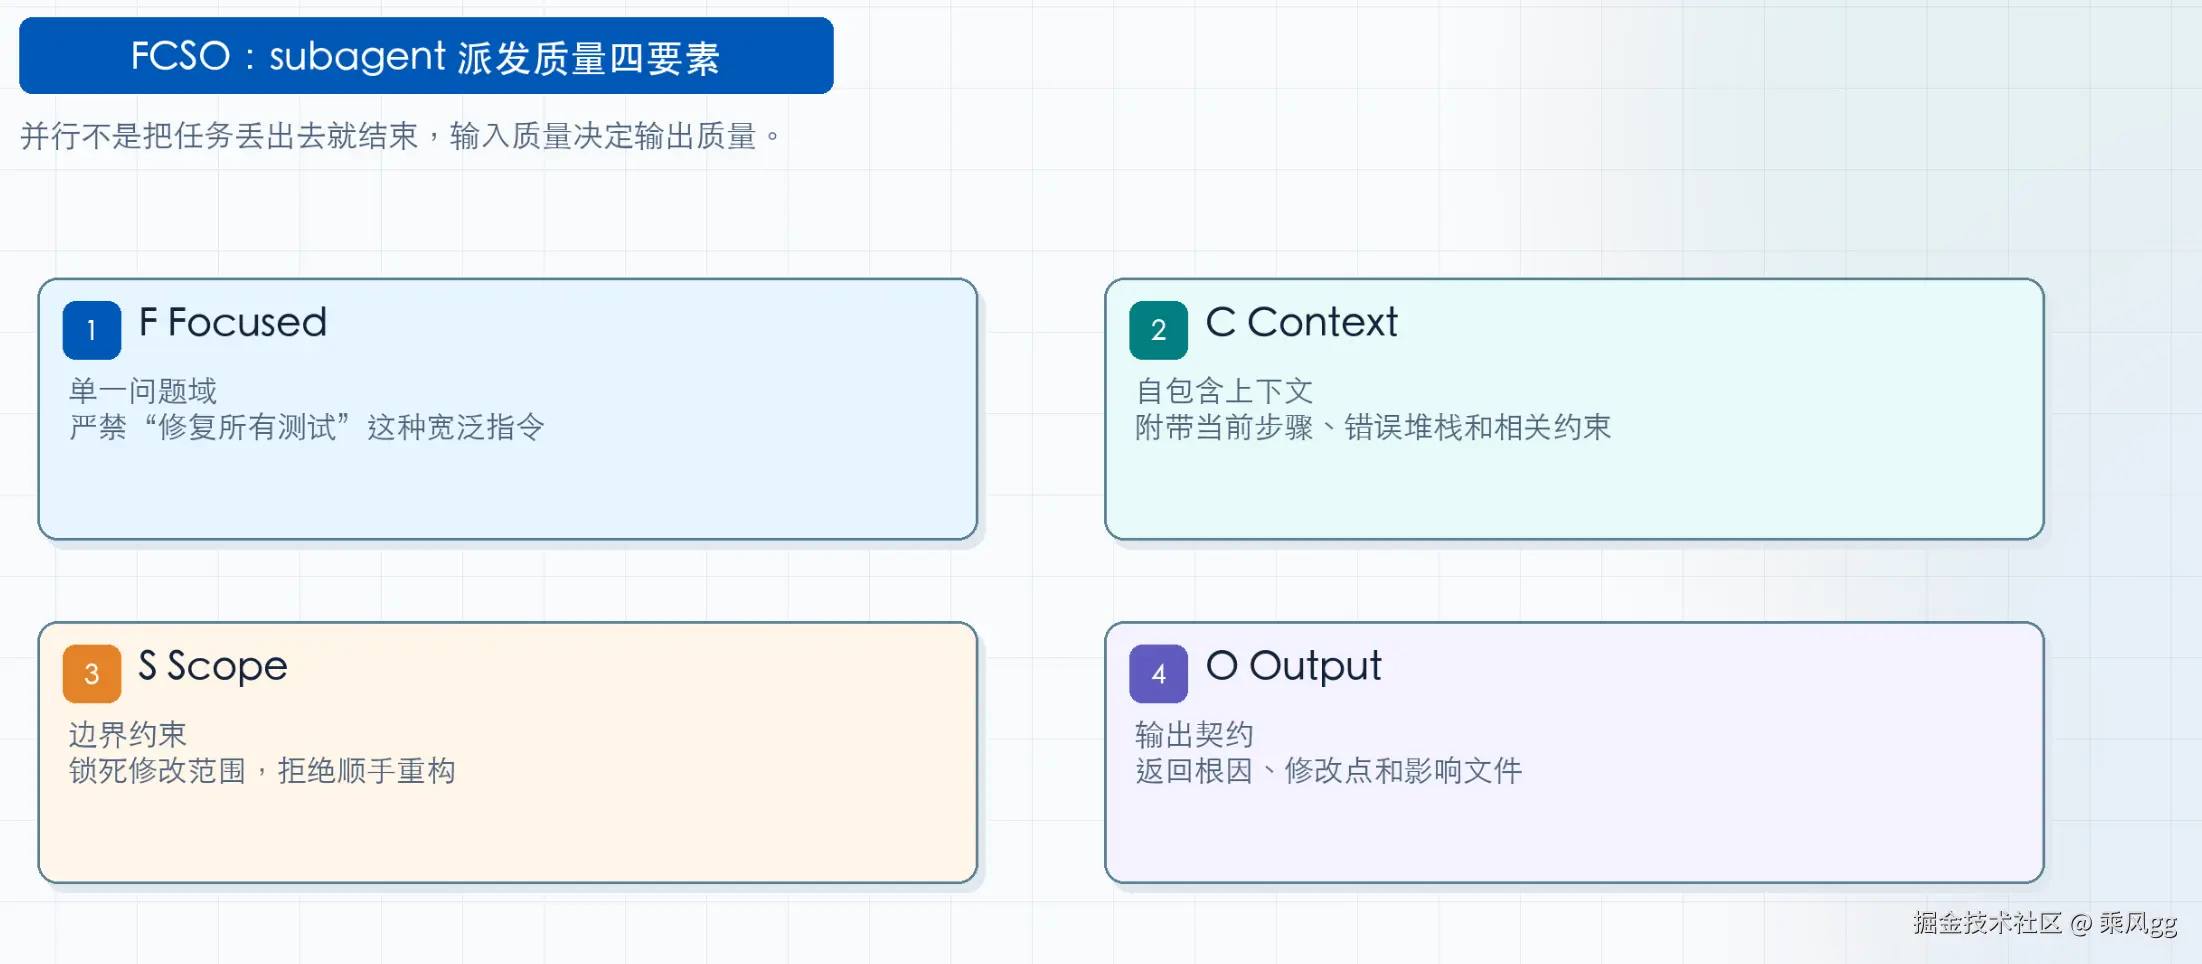
每个 sub-agent 的 prompt 必须包含以下四点:
| 要素 | 含义 | 约束 |
|---|---|---|
| F (Focused) | 单一问题域 | 精准到具体函数,严禁"修复所有测试"这种宽泛指令 |
| C (Context) | 自包含上下文 | 直接附带当前步骤的上下文和错误堆栈 |
| S (Scope) | 边界约束 | 锁死修改范围,不准碰非相关代码,拒绝"顺手重构" |
| O (Output) | 输出契约 | 必须返回根因分析、修改点清单、受影响文件列表 |
派发完四步验证:读每份 summary → 冲突检查 → 跑全套测试 → Spot Check。dispatch 不是终点,验证才是。
接入点 3:finish → Stage N+1 资产沉淀。
合格信号:specs/ 下三件套(spec·plan·review)归档完整。
反模式:合 branch 后删 specs/。后续 Stage 每次从零开始,无工作记忆,Compound Intelligence 断链。
钥匙一句话:specs/ 不是文档,是 CI 种子。
三个接入点全找准,9 步协同才能 1+1>2。错一个,两个工具各跑各的,效率倒挂。
适合谁和代价: 强治理的大型团队。总耗时可能翻倍,中小团队扛不住。流程开销摊在多人头上才划算。
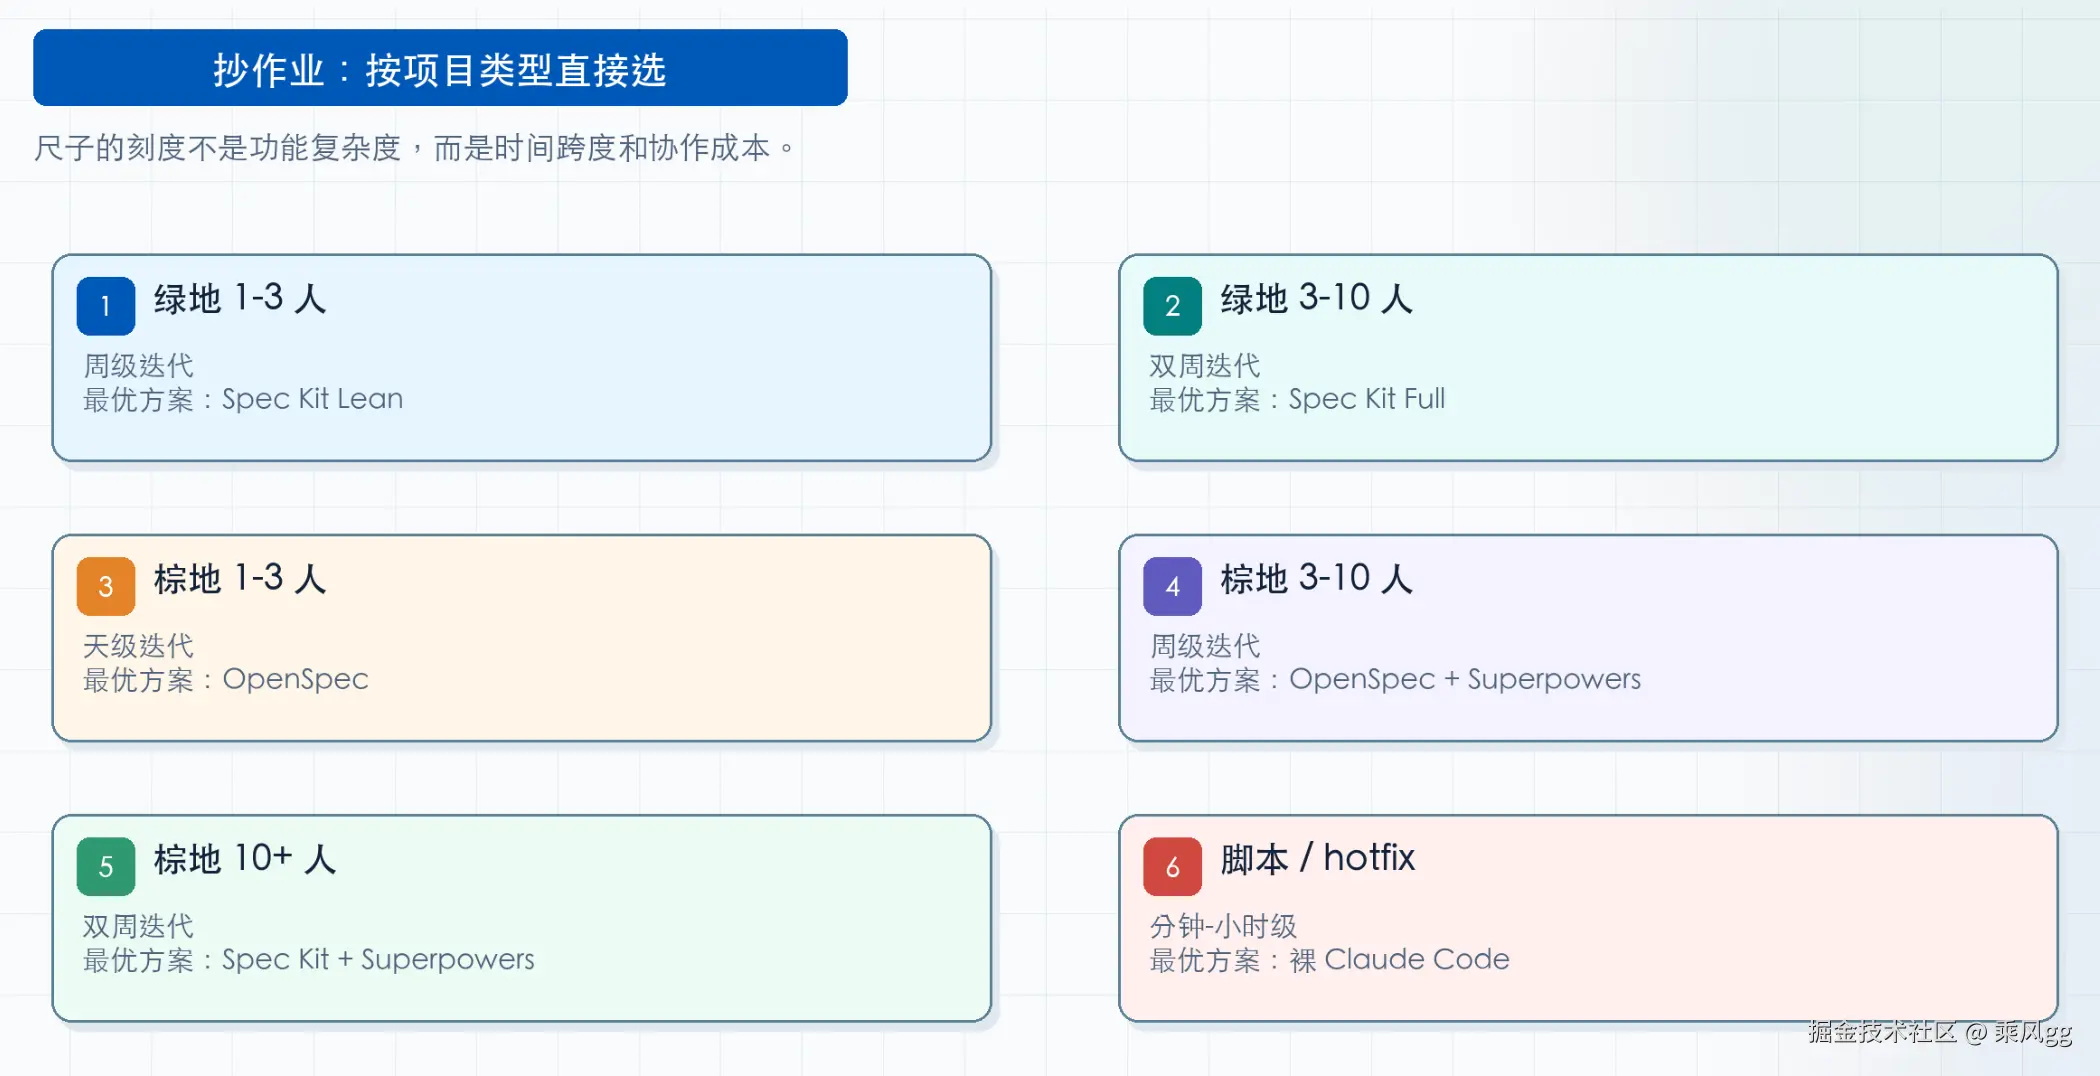
这里给一个工程直觉判断------这不是二选一,是一把尺子。跨天项目用 9 步协同,跨小时项目用 Superpowers 单框架,跨分钟任务用裸 CC 直接写。尺子的刻度不是功能复杂度,是时间跨度。因为流程开销是固定成本------花一小时走流程,对三天项目是 4% 的开销,对一小时任务是 100% 的浪费。
七、选择决策
代码要活多久 × 多少人碰 × 合规要求多高 --- 三个问题决定你选哪个。
- 活 1 天 → 三个都不用,直接写
- 1 个人维护 → 棕地选 OpenSpec,绿地选 Spec Kit,只要代码质量选 Superpowers
- 3 人以上 → 合规治理选 Spec Kit,快速迭代选 OpenSpec
- 一次性脚本 / hotfix / 原型 → 全不用
抄作业速查表:
| 项目类型 | 团队规模 | 迭代节奏 | 最优方案 |
|---|---|---|---|
| 绿地新项目 | 1-3 人 | 周级迭代 | Spec Kit Lean |
| 绿地新项目 | 3-10 人 | 双周迭代 | Spec Kit Full |
| 棕地老项目 | 1-3 人 | 天级迭代 | OpenSpec |
| 棕地老项目 | 3-10 人 | 周级迭代 | OpenSpec + Superpowers |
| 棕地老项目 | 10 人以上 | 双周迭代 | Spec Kit + Superpowers(9 步协同) |
| 一次性脚本 / 原型 | 1 人 | 小时级 | 裸 Claude Code,全不用 |
| 紧急 hotfix | 1-2 人 | 分钟级 | 裸 Claude Code,修完补规范 |
| 合规/安全敏感项目 | 任意 | 任意 | Spec Kit Full,必须走门控 |
下一篇我会讲------三个框架我都没选,而是拿 OpenSpec 做底座、补上 Superpowers 的纪律思维、再加自己的 Harness 工程,搭了一套更适合中小团队棕地项目的方案。核心解决一个问题:当一个五万行的棕地项目,既没有完整规范,又不允许停工补文档时,AI 该怎么安全地介入?
欢迎大家关注我的公众号:深入浅出AI