大家好,欢迎来到 huangjin007_ 的博客
⭐ 个人主页:huangjin007_
🔥 文章收录专栏:Linux 内功修炼手册(系统篇)
总会有一些坚持
能从冰封的土地里
培育出十万朵怒放的蔷薇
Linux 系统篇(二十八) ------ Ext2块组结构,inode与文件寻址原理
文章目录
- [Linux 系统篇(二十八) ------ Ext2块组结构,inode与文件寻址原理](#Linux 系统篇(二十八) —— Ext2块组结构,inode与文件寻址原理)
-
- [1. Ext2文件系统的宏观认识](#1. Ext2文件系统的宏观认识)
- [2. 深入理解Block Group(块组)与内部构成](#2. 深入理解Block Group(块组)与内部构成)
-
- [2.1 擦除与覆盖:块位图(Block Bitmap)的诞生](#2.1 擦除与覆盖:块位图(Block Bitmap)的诞生)
- [2.2 找回文件的困难:inode与inode表(Inode Table)的诞生](#2.2 找回文件的困难:inode与inode表(Inode Table)的诞生)
- [2.3 再次优化:inode位图(Inode Bitmap)的诞生](#2.3 再次优化:inode位图(Inode Bitmap)的诞生)
- [2.4 记录管理者的归属:块组描述符(GDT)的诞生](#2.4 记录管理者的归属:块组描述符(GDT)的诞生)
- [2.5 统筹全局:超级块(Super Block)的诞生](#2.5 统筹全局:超级块(Super Block)的诞生)
- [2.6 梳理核心流程:一个文件的完整写入生命周期](#2.6 梳理核心流程:一个文件的完整写入生命周期)
- [2.7 Data Block 数据区](#2.7 Data Block 数据区)
- [3. 核心机制:inode与Data Block的映射](#3. 核心机制:inode与Data Block的映射)
-
- [3.1 初步尝试:直接记录(12个直接块指针)](#3.1 初步尝试:直接记录(12个直接块指针))
- [3.2 遇到问题:如何容纳大文件?(多级间接块指针的诞生)](#3.2 遇到问题:如何容纳大文件?(多级间接块指针的诞生))
- [3.3 融会贯通:源码中的inode结构体](#3.3 融会贯通:源码中的inode结构体)
- [3.4 思考:知道inode号,究竟意味着什么?](#3.4 思考:知道inode号,究竟意味着什么?)
- [4. 目录与文件名:打破"目录"的认知壁垒](#4. 目录与文件名:打破“目录”的认知壁垒)
- [5. 路径解析与路径缓存(dentry)](#5. 路径解析与路径缓存(dentry))
-
- [5.1 路径解析](#5.1 路径解析)
- [5.2 问题:极度频繁的磁盘IO](#5.2 问题:极度频繁的磁盘IO)
- [5.3 内存里的目录树:dentry结构体](#5.3 内存里的目录树:dentry结构体)
- [5.4 核心总结](#5.4 核心总结)
- [6. 挂载分区(Mount)](#6. 挂载分区(Mount))
-
- [6.1 实操演示mount挂载镜像文件](#6.1 实操演示mount挂载镜像文件)
- [6.2 挂载核心结论](#6.2 挂载核心结论)
- [7. 软硬连接](#7. 软硬连接)
-
- [7.1 硬链接(Hard Link)](#7.1 硬链接(Hard Link))
- [7.2 深入了解:目录也有硬链接吗?](#7.2 深入了解:目录也有硬链接吗?)
- [7.3 为什么禁止用户给目录建硬链接?(环路问题)](#7.3 为什么禁止用户给目录建硬链接?(环路问题))
- [7.4 软链接(Symbolic Link)](#7.4 软链接(Symbolic Link))
- [7.5 文件三个时间戳](#7.5 文件三个时间戳)
- [7.6 核心对比与总结](#7.6 核心对比与总结)
- 结语:
1. Ext2文件系统的宏观认识
如果我们想在硬盘中存储文件,不能直接往裸磁盘里写数据,必须先把磁盘分区格式化 为某一种文件系统,之后操作系统才知道如何组织、管理磁盘上的文件。文件系统本质的目标,就是帮我们把杂乱的磁盘扇区,有序管理起来,存放文件内容、文件属性。
在Linux 系统中,最常见的是 ext2 系列的文件系统。其早期版本为 ext2,后来又发展出 ext3 和 ext4。ext3 和 ext4 虽然对 ext2 进行了增强,但是其核心设计并没有发生变化,我们仍是以较老的 ext2 作为讲解对象。
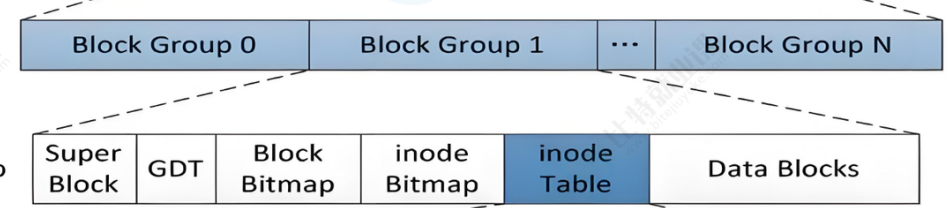
ext2会把一个磁盘分区,切分成若干个大小完全相同的块组(Block Group)。只要能管理一个分区就能管理所有分区,也就能管理所有磁盘文件。只要弄懂单个块组如何管理,就能理解整个分区,进而理解整块磁盘的文件管理逻辑。
这里要单独提启动块(Boot Block / Boot Sector):
- 大小固定为1KB,是PC硬件标准规定的。
- 存放分区引导、启动相关信息,任何文件系统都不能修改启动块。
- 启动块之后的空间,才是ext2文件系统真正开始的位置。
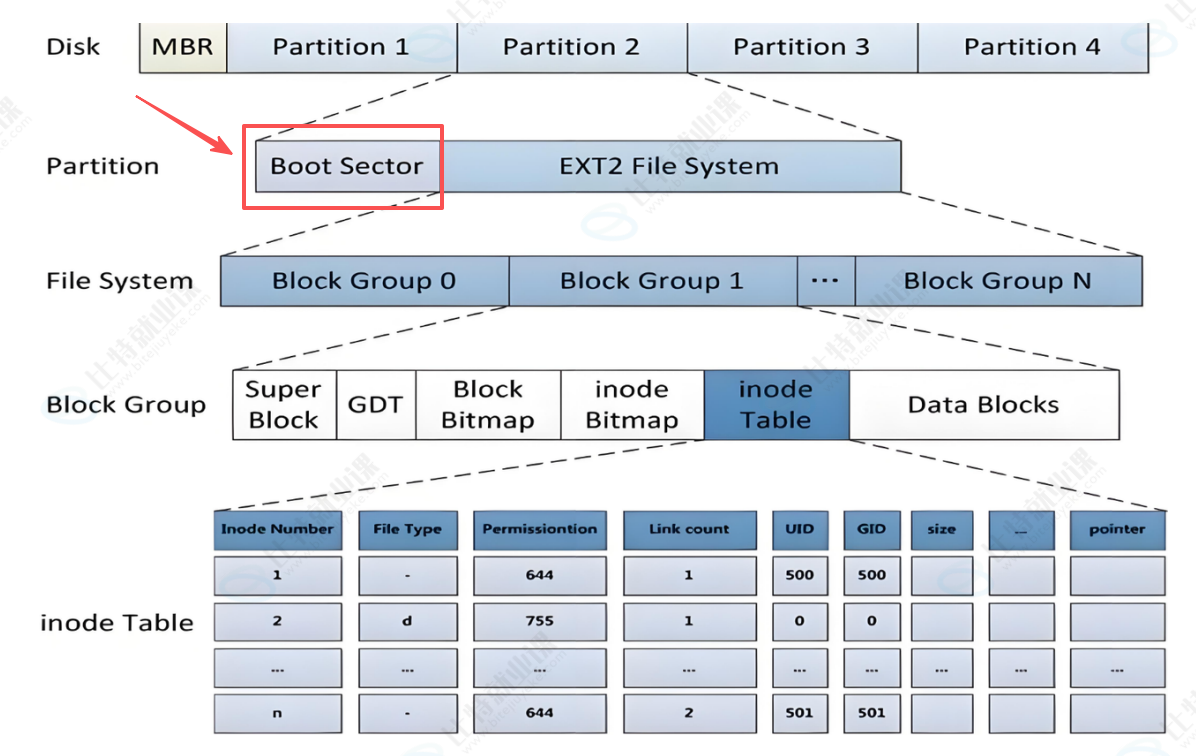
类比理解:把磁盘分区想象成一座大型写字楼,启动块就是大楼大门的门禁。大楼内部被划分成一个个独立的单元房间,每一个单元房间就是一个Block Group,每个单元内部都配备一套完整的管理台账,独立管理自己内部资源。
2. 深入理解Block Group(块组)与内部构成
我们已经知道了分区格式化后会被划分为一个个固定大小的块(Block),所有的磁盘读写都以块为单位。现在,我们抛开那些生涩的概念,顺着"发现问题、解决问题"的思路,一步步推导出EXT2文件系统的完整物理布局。
2.1 擦除与覆盖:块位图(Block Bitmap)的诞生
假设我们有一块刚格式化好的空白磁盘,里面被划分成了无数个大小相同的块。现在我们要存入一个文件。如果随意分配空间,把文件的数据写进了一个之前已存有其他文件的块中,就会发生覆盖,导致原文件损坏。所以,我们得有一个"账本",记录每个块有没有被使用。
为了节省空间,这个"账本"极其精简,它就是块位图(Block Bitmap) :本质是一串二进制bit,一个bit对应一个Data Block。bit=0代表空闲,bit=1代表占用。新建文件需要磁盘空间时,操作系统扫描块位图寻找值为0的bit,分配对应block并标记为1;删除文件释放空间,把对应bit重新置0。位图本身也占用磁盘block,且只管理当前块组内的数据块。
2.2 找回文件的困难:inode与inode表(Inode Table)的诞生
数据成功写入后,我们尝试去读取刚才的文件。此时遇到了大问题:我们怎么知道文件被存到了哪些块里?我们不仅需要知道文件占用了哪些块,还需要知道文件的大小、创建时间、权限等属性。因此,我们需要一个专门的结构体来记录这些信息,这就是inode(索引节点)。
我们将磁盘上所有的inode集中起来存放,就形成了inode表(Inode Table) 。每一个文件(普通文件、目录、软链接)都会独占一个inode。那么我们怎么用代码来描述这个inode呢?在磁盘上,它对应的是 ext2_inode 结构体:
c
struct ext2_inode {
    __le16 i_mode;        /* 文件类型+权限 */
    __le32 i_size;        /* 文件字节大小 */
    __le32 i_atime;       /* 最后访问时间 */
    __le32 i_mtime;       /* 文件内容修改时间 */
    __le16 i_links_count; /* 硬链接计数 */
    __le32 i_block[EXT2_N_BLOCKS];/* 15个块指针,核心! */
    // ... 其他时间戳、UID、GID等字段
};在这个结构体中,记录文件大小、时间等属性一目了然。重点提醒:inode编号是以分区为单位进行全局编号的,inode不可以跨分区。ext2的inode大小一般是128字节或256字节。
2.3 再次优化:inode位图(Inode Bitmap)的诞生
既然数据块的分配需要块位图来管理,那么inode本身也是有限的磁盘资源,分配和回收同样需要管理。类比块位图的设计,我们引入inode位图(Inode Bitmap) 。它的逻辑完全一致:1个bit对应1个inode,0代表空闲,1代表已占用。新建文件时,先在inode位图中找空闲bit分配inode。
2.4 记录管理者的归属:块组描述符(GDT)的诞生
此时我们回头看一下:块位图、inode位图、inode表,它们本质上也是数据,也需要占用磁盘块!我们怎么知道它们分别被放在了哪几个块里?
这时就需要一个"上层领导"来记录这些元数据的位置,这就是GDT(Group Descriptor Table,块组描述符表) 。每一个ext2_group_desc结构体描述一个块组,我们来看看它的源码:
c
struct ext2_group_desc
{
    __le32 bg_block_bitmap;        /* 块位图所在block编号 */
    __le32 bg_inode_bitmap;        /* inode位图所在block编号 */
    __le32 bg_inode_table;         /* inode表起始block编号 */
    __le16 bg_free_blocks_count;   /* 当前块组空闲block数目 */
    __le16 bg_free_inodes_count;   /* 当前块组空闲inode数目 */
    __le16 bg_used_dirs_count;     /* 当前块组里面目录文件总数 */
    // ... 预留填充
};
通过这个结构体,我们完美地记录了"块位图放在哪个块、inode位图在哪、inode表从哪个块开始"这些关键信息,同样,GDT信息也会在多个块组做备份,防止元数据损坏。
2.5 统筹全局:超级块(Super Block)的诞生
现在,单个块组的元数据管理已经闭环了。但随着分区容量的增大,分区会被划分成多个块组。为了微调性能,我们还需要一个全局的视角来把控整个分区:比如整个分区一共多少个块、多少个inode?全局还有多少空闲资源?最近一次挂载和写入是什么时候?
于是,我们在每个块组的开头,引入了超级块(Super Block)。它存放整个文件系统全局的描述信息,对应的源码结构体非常庞大,但核心字段很清晰:
c
struct ext2_super_block {
    __le32 s_inodes_count;         /* Inodes总数 */
    __le32 s_blocks_count;         /* Blocks总数 */
    __le32 s_free_blocks_count;    /* 当前空闲block数量 */
    __le32 s_free_inodes_count;    /* 当前空闲inode数量 */
    __le32 s_log_block_size;       /* block大小,以2的幂表示 */
    __le32 s_mtime;                /* 最近挂载时间 */
    __le32 s_wtime;                /* 最近写入时间 */
    __le16 s_magic;                /* 魔数,用来识别是不是ext2文件系统 */
    // ... 其他全局描述字段
};
考点 :注意里面的
s_magic魔数。操作系统挂载分区时读取魔数,判断这个分区是哪种文件系统,内核不识别则不兼容。
核心备份机制:超级块数据损坏,操作系统将无法识别这个分区的文件系统,分区内所有文件都无法访问。为了防止磁盘局部扇区损坏导致文件系统直接报废,超级块会在多个块组头部保留备份。第一个块组必须存在超级块,其余块组可选择备份,所有副本内容同步一致。
2.6 梳理核心流程:一个文件的完整写入生命周期
现在,我们顺着刚才的自下而上的设计,完整梳理一遍一个文件写入的完整流程:
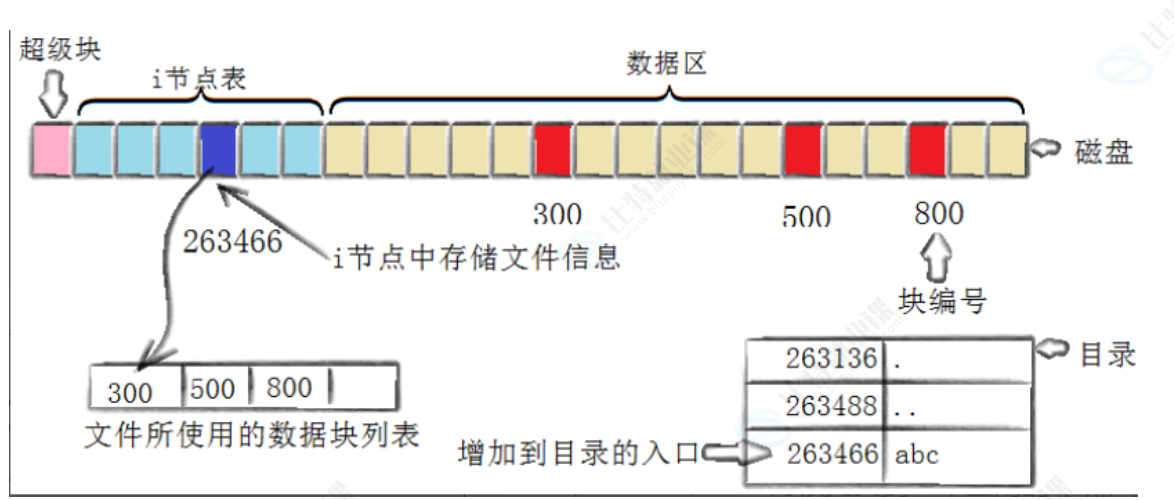
- 查全局 :系统先查看超级块,看里面有没有空闲的inode和空闲的数据块。发现有,可以进行分配。
- 定位元数据 :根据超级块的信息,去GDT(块组描述符表) 中找到对应块组的元数据信息(比如位图、inode表具体在哪个块)。
- 分配inode :去inode位图中找到一个空闲的表项(如263466),把文件的基本属性(类型、权限、时间等)填好。注意:此时文件大小和数据所在块的信息先空着。
- 分配数据块 :去块位图中找到空闲块(比如300、500、800),将用户缓冲区的数据写入这三块磁盘。
- 回填inode :写完数据后,回到inode表 中,把文件大小以及数据块的位置(300, 500, 800)填入
i_block数组。- 更新元信息 :同步更新inode位图 (标记该inode已使用)、块位图(标记数据块已分配)。
- 更新全局 :更新超级块,将空闲inode数和空闲块数减1。
- 添加目录入口 :当前目录本身也是一个目录文件,内核往当前目录的数据块里新增一条记录:
263466, abc,把文件名abc和inode号绑定在一起。
关键点:文件名不在inode里!文件名保存在目录的数据块中,inode里面没有文件名。拿到inode编号,文件的全部属性以及文件内容所在数据块编号全部获取,就可以完成文件读写。
2.7 Data Block 数据区
最后,我们来看真正存放文件内容的Data Block(数据区)。根据文件类型,存储内容情况:
- 普通文件:文件的文本、二进制数据,全部存在Data Block中。
- 目录文件 :目录也是文件!目录的数据块里面存放一条条
文件名 <--> inode号的映射条目。ls -l看到的权限、大小、所有者,保存在对应文件自己的inode里面;目录里面仅仅保存名字和inode的映射。
至此,EXT2块组的全部物理构成与核心运转逻辑,就在我们一步步的推导中完美闭环了。
3. 核心机制:inode与Data Block的映射
在上一节,我们通过层层递进,知道了inode是文件的"身份证",负责记录属性和数据块位置。但现在一个很现实的问题摆在我们面前:文件有大有小,inode里的空间是有限的,它到底是怎么把成百上千个数据块给统领起来的?
3.1 初步尝试:直接记录(12个直接块指针)
假设我们刚刚写入了一个小文件,它只占用了几个数据块。最简单、最直观的设计就是:直接在inode里面留出位置,把存放文件内容的数据块编号直接记下来。
在EXT2中,inode结构体里有一个i_block数组,它的前12个元素就是干这个的,被称为12个直接块指针。对于小文件来说,直接通过这12个指针就能定位到所有数据块,不需要任何中间跳转,访问速度最快。
3.2 遇到问题:如何容纳大文件?(多级间接块指针的诞生)
但问题是,文件不可能永远这么小。如果文件很大,超过了12个数据块怎么办?如果我们为了容纳更多的块号,就把inode结构体无限扩容,那inode本身就会变得极其庞大,这对磁盘空间和读取效率都是灾难。
既然不能让inode自己变大,我们就得换个思路:拿一个数据块出来,不存文件内容,专门存其他数据块的编号,把它变成一个"索引块"。
于是,i_block数组的第13个指针派上了用场,它指向一个索引块,索引块里全是一个个数据块的编号。这就是1个一级间接块指针。有了它,寻址能力瞬间提升了几十倍。
那如果文件更大呢?很简单,套娃。
- 第14个指针指向一个索引块,这个索引块里存的指针又指向下一个索引块,直到找到最终的数据块。这就是1个二级间接块指针。
- 第15个指针更是重量级,层层嵌套,这就是1个三级间接块指针,足以支撑超大文件的存储。
通过这"12个直接指针 + 1个一级间接 + 1个二级间接 + 1个三级间接"的巧妙设计,内核完美兼顾了"小文件读写极快"和"支持超大文件"两个需求。
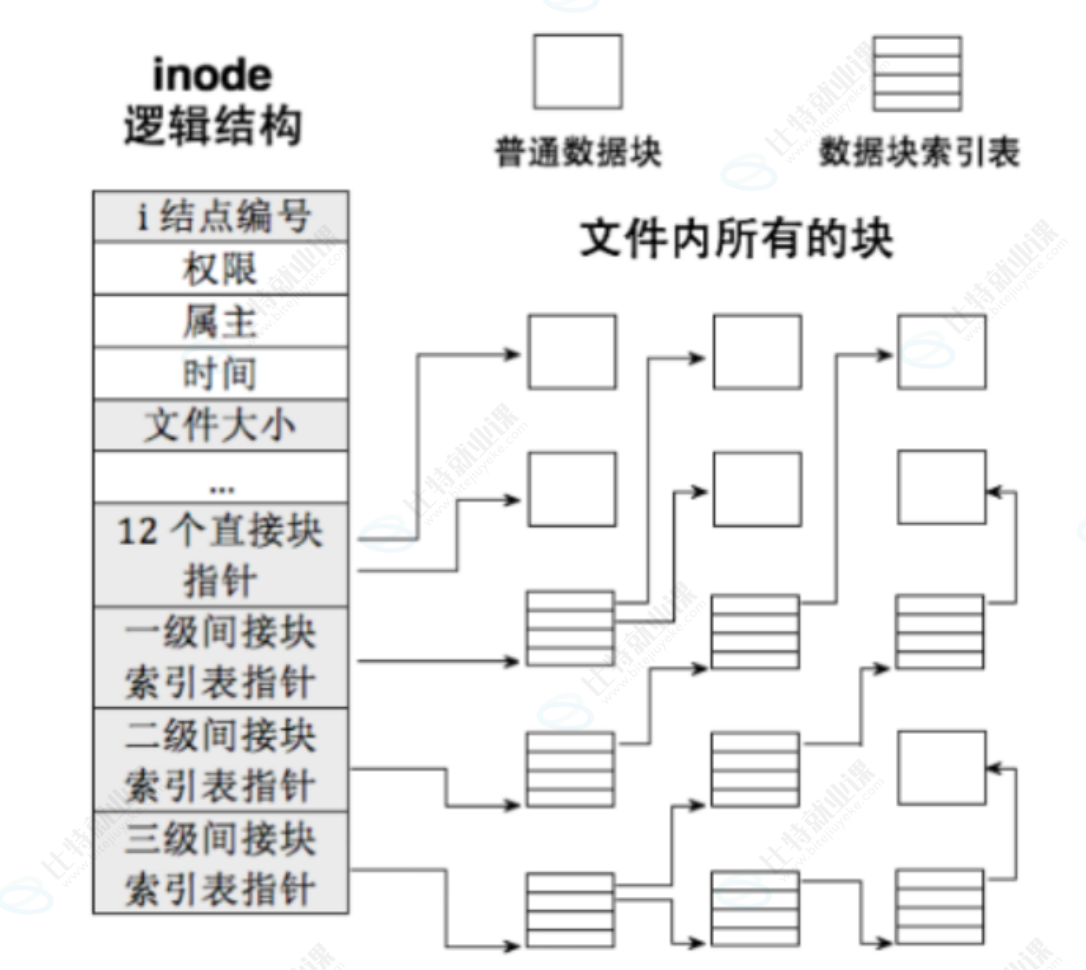
3.3 融会贯通:源码中的inode结构体
正是基于这套映射逻辑,内核设计了ext2_inode结构体。我们来看看它的真面目:
c
struct ext2_inode {
    __le16 i_mode;        /* 文件类型+权限 */
    __le16 i_uid;         /* 属主UID低16位 */
    __le32 i_size;        /* 文件字节大小 */
    __le32 i_atime;       /* 最后访问时间 */
    __le32 i_ctime;       /* 创建/属性修改时间 */
    __le32 i_mtime;       /* 文件内容修改时间 */
    __le32 i_dtime;       /* 文件删除时间 */
    __le16 i_gid;         /* 属组GID低16位 */
    __le16 i_links_count; /* 硬链接计数 */
    __le32 i_blocks;      /* 文件占用block数量 */
    __le32 i_flags;       /* 文件标志位 */
    // ... 操作系统相关字段
    __le32 i_block[EXT2_N_BLOCKS];/* 15个块指针,核心! */
    // ... 其他字段
};总结:inode记录文件属性,i_block数组找到文件所有数据块。文件 = 属性(inode) + 内容(datablock)。
3.4 思考:知道inode号,究竟意味着什么?
知道inode号的情况下,对文件进行增、删、查、改是在做什么?
当我们彻底理顺了磁盘布局和映射机制,这个问题的答案就跃然纸上了:
- 格式化分区的本质:对分区划分块组,在每个块组写入超级块、GDT、位图、inode表等元数据。这一堆管理信息,合起来就是文件系统。
- 拿到inode编号:就可以在当前分区,算出这个inode属于哪一个块组,再定位到inode table里面对应的inode条目。
- 一旦拿到inode:文件的全部属性,以及文件内容所在数据块编号全部获取,直接完成文件读写。
4. 目录与文件名:打破"目录"的认知壁垒
问题:我们操作文件,输入的永远是文件名,从来不会输入inode号,操作系统怎么通过文件名找到inode?
核心答案 :目录本身也是文件,磁盘上不存在单独的"目录对象",磁盘只存储文件:属性 + 内容。目录文件的内容,就是一张表,每一条记录:文件名 + 对应inode编号。
当执行 ls 命令读取目录,本质就是读取目录文件的数据块,遍历里面一条条映射。我们写一段C语言代码,调用系统调用readdir,自己读取目录条目,验证这个原理:
c
// readdir.c
#include <stdio.h>
#include <string.h>
#include <stdlib.h>
#include <dirent.h>
#include <sys/types.h>
#include <unistd.h>

int main(int argc, char *argv[]) {
    if (argc != 2) { exit(EXIT_FAILURE); }
    DIR *dir = opendir(argv[1]);
    if (!dir) { perror("opendir"); exit(EXIT_FAILURE); }
    struct dirent *entry;
    while ((entry = readdir(dir)) != NULL) {
        if (strcmp(entry->d_name, ".") == 0 || strcmp(entry->d_name, "..") == 0) continue;
        printf("Filename: %s, Inode: %lu\n", entry->d_name, (unsigned long)entry->d_ino);
    }
    closedir(dir);
    return 0;
}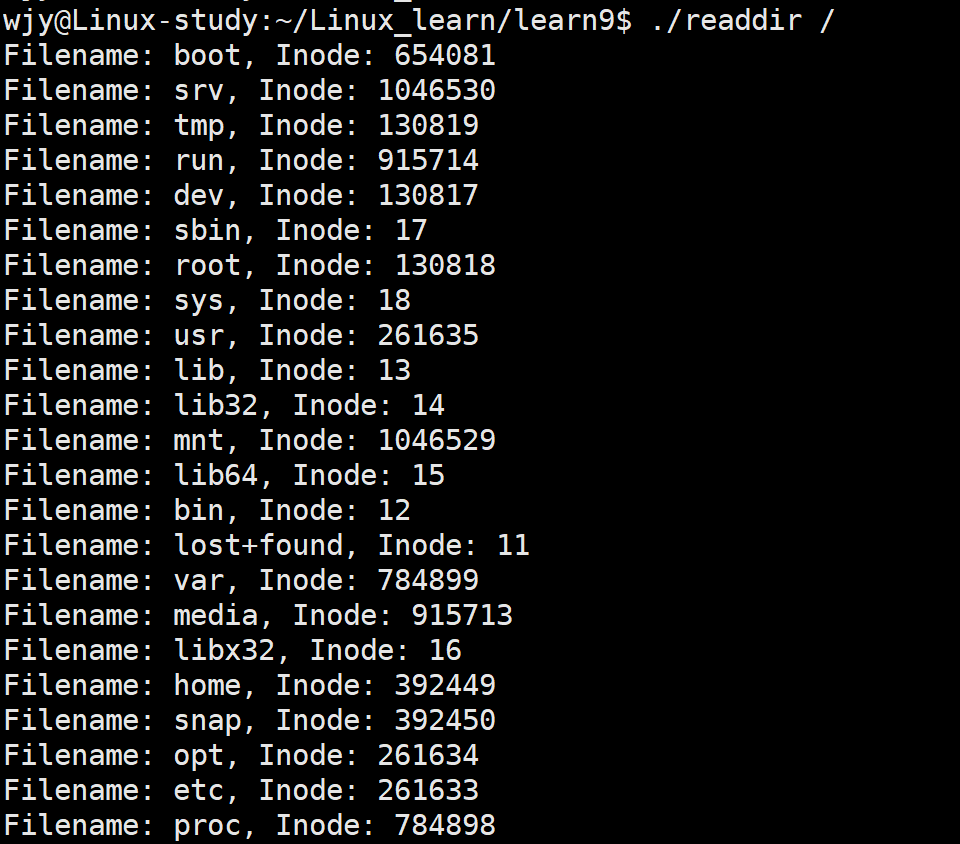
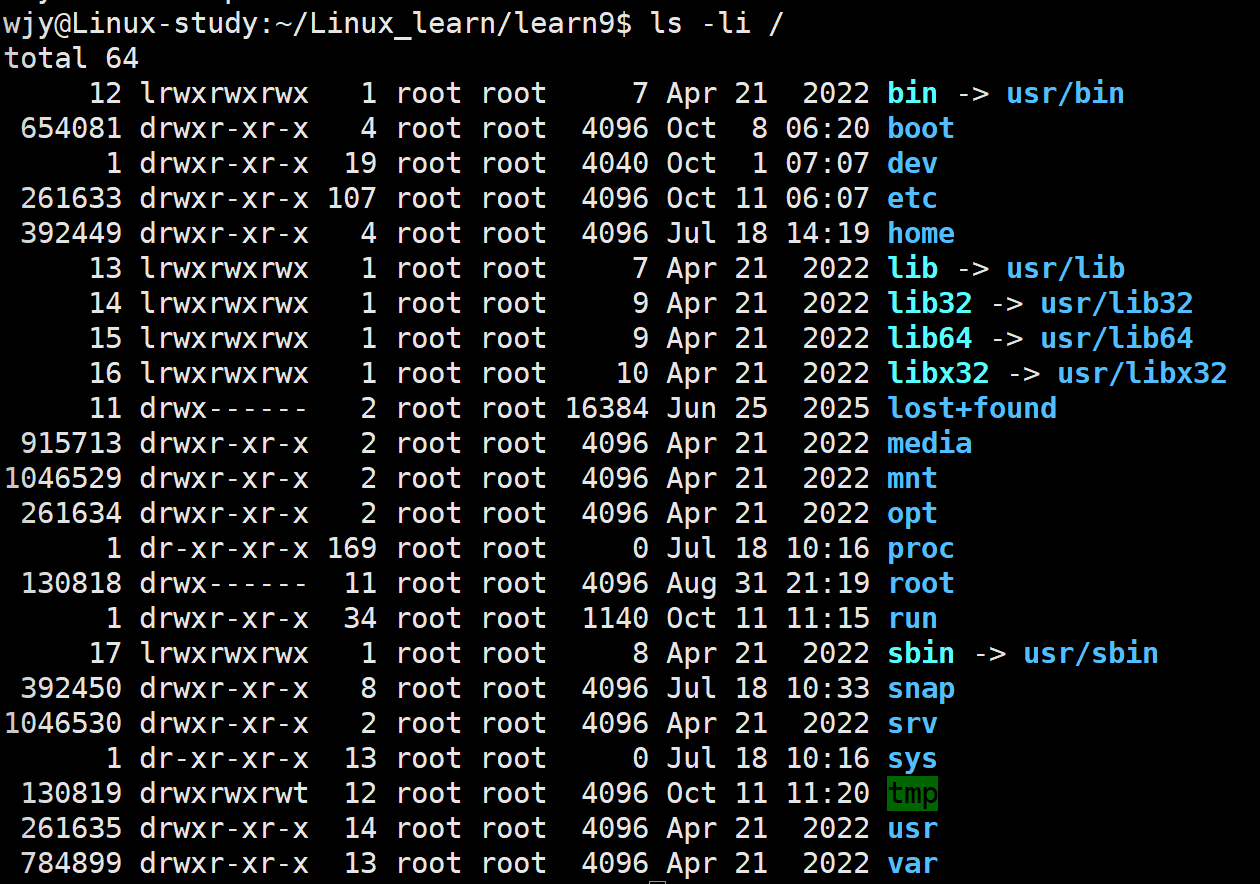
运行结果和 ls -li / 的结果完全对应。由此得到核心结论:访问文件的流程,是打开目标所在目录文件,读取目录内的映射表,通过文件名拿到inode号,再拿着inode去读取文件本身的属性和数据块。
5. 路径解析与路径缓存(dentry)
我们知道访问文件必须拿到它的inode,而文件名和inode的映射关系保存在目录的数据块里。那么,如果我们要访问一个很深的路径,比如 /home/wjy/code/test/test.c,系统是怎么一步步找到它的inode的呢?
5.1 路径解析
我们来看一下完整的绝对路径 /home/wjy/code/test/test.c。系统会从最左侧开始,逐层向右解析:
- 从根目录
/开始:根目录的inode是系统开机时就固定已知的,不需要查找,直接拿到。- 读取根目录内容 :在根目录的数据块中找到
home对应的inode。- 打开 home 目录 :读取 home 目录的数据块,找到
wjy对应的inode。- 打开 wjy 目录 :找到
code...- 打开 test 目录 :最终找到
test.c,拿到它的inode,完成路径解析。
这个过程本质上是一个递归:想要打开一个目录,就必须知道它的上级目录,一直追溯到根目录 /。这也是为什么 访问文件必须要有路径(目录+文件名) 的根本原因。
思考 :路径究竟是谁提供的?
其实,你输入的指令(如
ls、cat)本质是进程在访问文件,而进程有自己的CWD(当前工作目录)。进程提供路径字符串交给内核,根目录固定已知,整个Linux树状文件系统,就是操作系统与用户一起构建出来的。
5.2 问题:极度频繁的磁盘IO
虽然逻辑上完美闭环了,但我们在实际体验中会发现:如果每次访问一个深层文件,都要从根目录开始一层层读取磁盘上的目录文件,那将产生大量的磁盘I/O,性能极其低下。尤其是当我们在代码里反复读写同一个文件时,这种开销是灾难性的。
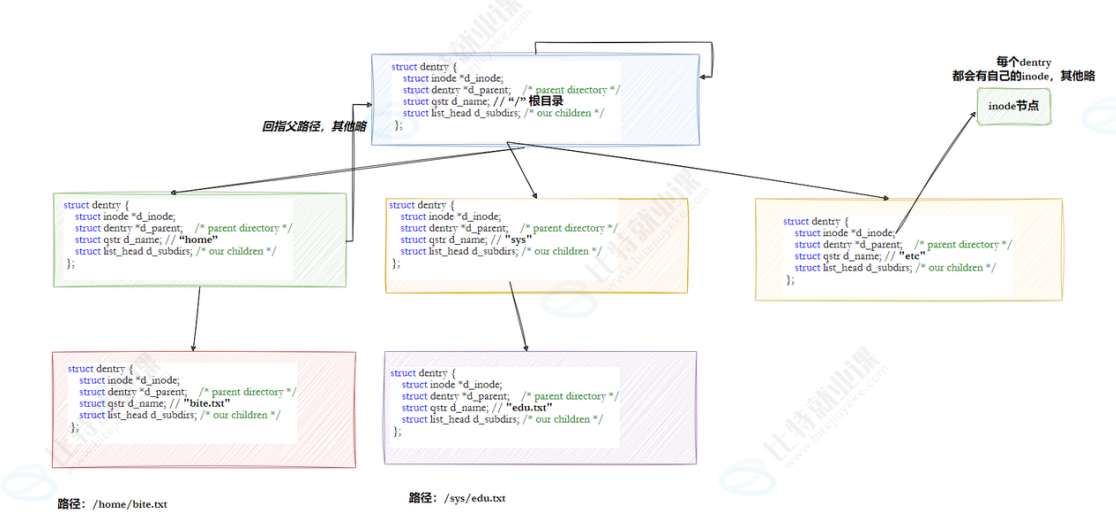
既然磁盘读取这么慢,我们能不能把解析过的路径记在内存里? 当然可以!Linux内核引入了dentry(目录项缓存),在内存中维护一棵目录树,把曾经解析过的目录条目缓存起来,减少磁盘访问。
5.3 内存里的目录树:dentry结构体
既然要在内存里建树,我们就得定义一个结构体来描述树的节点,这就是 struct dentry。
为了解决"怎么建树"、"怎么快速找"、"怎么回收内存"、"怎么指向真实文件"等一系列问题,内核工程师们设计了极其精妙的字段。
c
struct dentry {
    atomic_t d_count;                 /* 引用计数 */
    unsigned int d_flags;             /* 标志位 */
    spinlock_t d_lock;                /* 自旋锁,保护dentry */
    struct inode *d_inode;            /* 指向这个目录项对应的inode,NULL代表负缓存 */
    struct hlist_node d_hash;         /* 哈希链表,快速查找dentry */
    struct dentry *d_parent;          /* 父目录的dentry,指向树的上一层 */
    struct qstr d_name;               /* 目录项名字 */
    struct list_head d_lru;           /* LRU链表,用于淘汰长期不用的缓存 */
    union {
        struct list_head d_child;     /* 子目录链表,挂在父目录的d_subdirs下 */
        struct rcu_head d_rcu;
    } d_u;
    struct list_head d_subdirs;       /* 子目录集合,指向树的所有下层节点 */
    struct list_head d_alias;         /* inode别名链表 */
    // ... 其他字段
    int d_mounted;                    /* 是否挂载点 */
    unsigned char d_iname[DNAME_INLINE_LEN_MIN]; /* 短名字直接存结构体内部 */
};
仔细看上面这段源码,它完美解答了我们在内存中建树遇到的四大难题:
- 怎么建树? 靠
d_parent(指向父节点)和d_subdirs(指向子节点链表),这就串起了一棵双向的内存目录树。- 怎么快速定位? 靠
d_hash(哈希链表),把dentry挂在哈希表里,实现O(1)级查找。- 内存不够怎么办? 靠
d_lru(最近最少使用链表),当内存紧张时,LRU算法淘汰掉那些很久没用的dentry缓存。- 怎么找到真实数据? 靠
d_inode,直接指向该文件在磁盘上的inode(如果是负缓存则指向NULL,表示文件不存在)。
5.4 核心总结
有了 dentry 缓存,打开文件时,内核优先在 dentry 缓存树里检索路径,找到直接拿到 inode;缓存不存在,才去磁盘读取目录,生成新 dentry 加入缓存。
考点:
- Q:磁盘上有没有真实的"目录树"?
- A:没有。磁盘只保存一个个独立文件(属性+数据),目录树是内核在内存里面,通过dentry结构体构建出来的逻辑树。
- Q:每次打开文件,都要从根目录开始读磁盘解析路径吗?
- A:逻辑上是从根目录解析,但内核会缓存已经访问过的目录项(dentry),优先在内存缓存查找,缓存命中就不用读磁盘。
- Q:dentry缓存会持久化到磁盘吗?
- A:绝对不会!dentry只是内存缓存,重启之后缓存全部消失,磁盘上不会保存dentry。它的生命周期完全由内存管理和系统运行状态决定。
6. 挂载分区(Mount)
我们已经掌握:在单个分区内部,可以通过inode找到文件,通过目录文件解析文件名。但是一台Linux可以有多个磁盘分区,而inode编号不能跨分区,不同分区inode可以重复。内核如何区分当前路径属于哪一个分区?答案就是挂载(mount)。
6.1 实操演示mount挂载镜像文件
我们用dd创建虚拟磁盘镜像,模拟分区,完成格式化、挂载、卸载。
bash
# 1. 生成5M大小镜像文件,模拟一块磁盘分区
$ dd if=/dev/zero of=./disk.img bs=1M count=5
# 2. 把镜像格式化为ext4文件系统(原理和ext2一致)
$ mkfs.ext4 disk.img
# 3. 创建空目录,作为挂载点
$ mkdir /mnt/mydisk
# 4. 挂载镜像到/mnt/mydisk
$ sudo mount -t ext4 ./disk.img /mnt/mydisk/
# 5. 查看挂载信息,此时能看到 /dev/loop0 挂载在 /mnt/mydisk
$ df -h
/dev/loop0 4.7M 24K 4.4M 1% /mnt/mydisk
# 6. 卸载分区
$ sudo umount /mnt/mydisk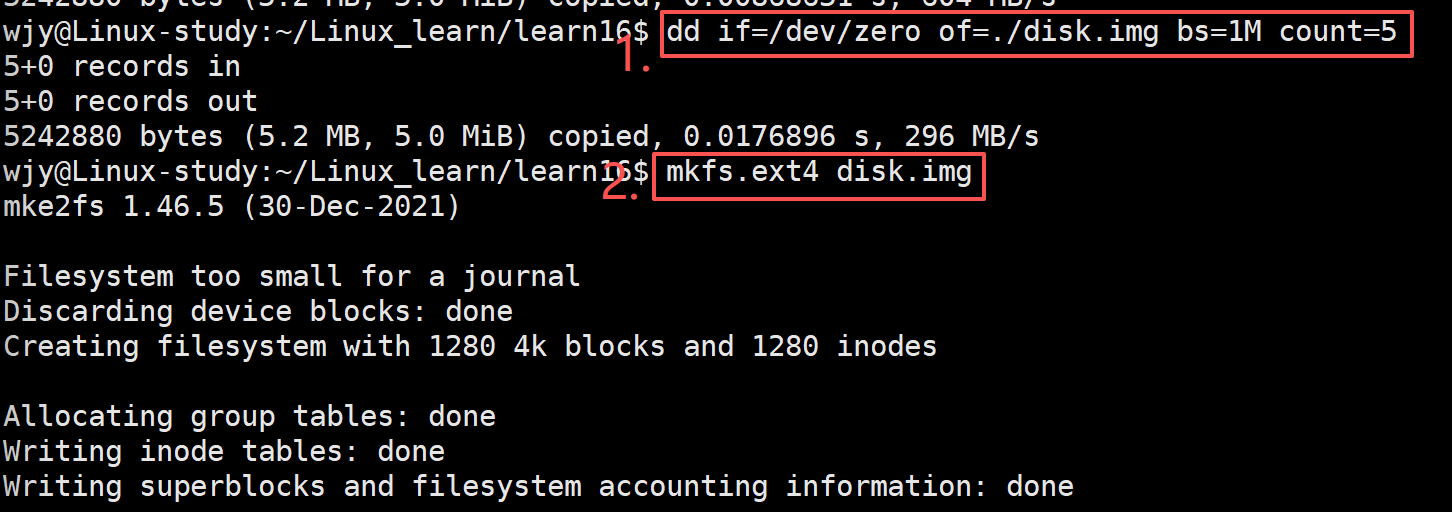
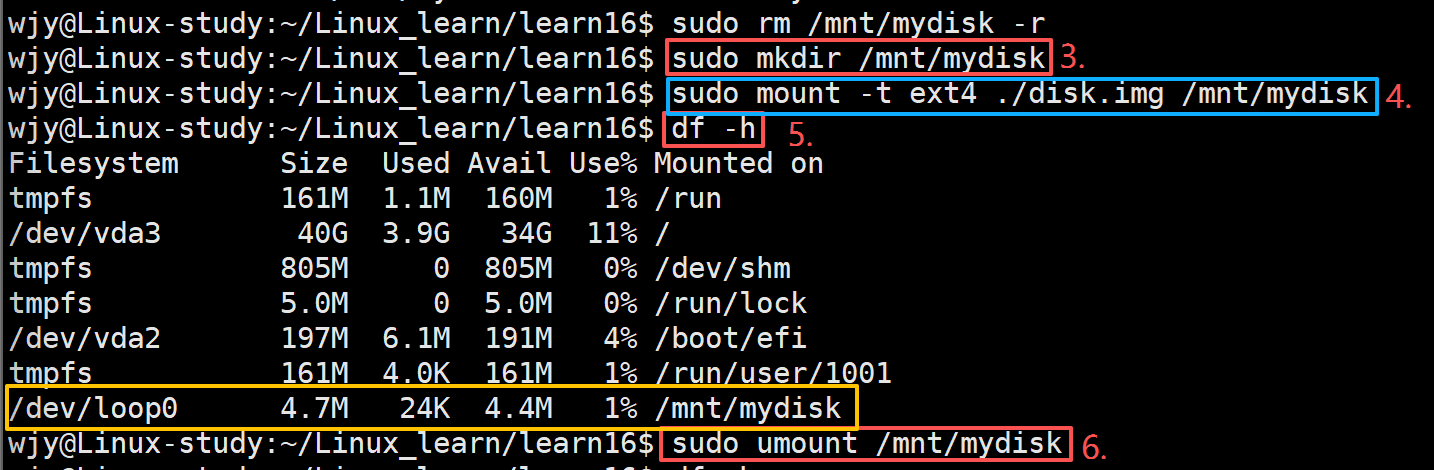
这里出现 /dev/loop0,是loop回环设备:loop设备是伪块设备,可以把普通文件当做一块磁盘块设备使用。我们的disk.img只是普通文件,通过loop设备,内核可以像操作物理硬盘分区一样读写这个镜像,ISO镜像挂载也是同样原理。
6.2 挂载核心结论
- 分区写入文件系统,不能直接使用,必须和目录做关联,也就是挂载。
- 内核解析路径的时候,根据路径前缀判断这个路径属于哪个挂载点,就知道当前访问的是哪一个分区,这样就可以区分不同分区的inode,解决inode跨分区冲突的问题。
理解:把独立的分区文件系统,嫁接在根目录树的某个空节点上,让多个磁盘分区合并成一棵统一的目录树,给用户使用。
7. 软硬连接
磁盘定位文件靠的是inode,文件名只是目录数据块里的一个映射条目。既然这样,我们能不能让多个文件名,映射到同一个inode上呢?或者,我们能不能给一个文件起个别名?基于这个思考,Linux引入了软链接和硬链接的机制。
7.1 硬链接(Hard Link)
假设我们有一个文件 abc,想要再给它起个名字叫 def,我们可以使用 ln abc def 命令。
bash
[root@localhost linux]# ln abc def
[root@localhost linux]# ls -li abc def
263466 abc
263466 def 我们发现,abc 和 def 的 inode 编号竟然完全一样!这说明,硬链接本质上并不是一个新文件,它只是当前目录的数据块里,新增了一条"别名 -> 目标inode"的映射关系。它们共享了同一个inode和数据块。
这就带来了一个问题:如果删除其中一个名字,文件数据会被删掉吗?答案是不会。因为内核在inode结构体里,专门设计了一个计数器 i_links_count 来记录这个inode被多少个文件名关联着。
c
struct ext2_inode {
    // ...
    __le16 i_links_count; /* 硬链接计数,核心! */
    // ...
};
当我们执行 rm 删除文件时,底层经历了三个严谨的步骤:
- 在目录文件中,删除这条"文件名-inode"的映射条目。
- 将该inode的硬链接计数
i_links_count -= 1。- 只有当减完的链接计数等于0时,内核才会真正释放inode和对应的数据块,磁盘空间才会真正回收。
7.2 深入了解:目录也有硬链接吗?
既然硬链接这么好用,我们能不能给目录也创建一个硬链接呢?我们尝试执行 ln dir hard,系统直接报错:hard link not allowed for directory。
为什么不允许?
我们不妨先看看系统自己是怎么做的。实际上,系统在创建目录时,就已经默认应用了硬链接机制。当我们执行 mkdir dir,默认情况下,这个空目录的硬链接数就是 2。
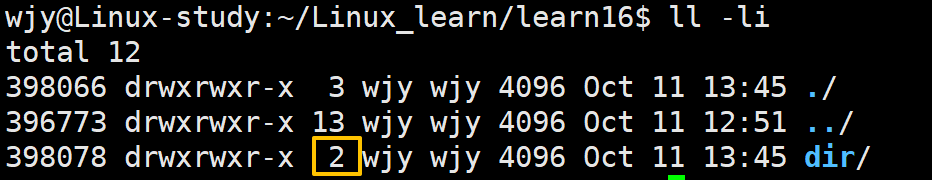
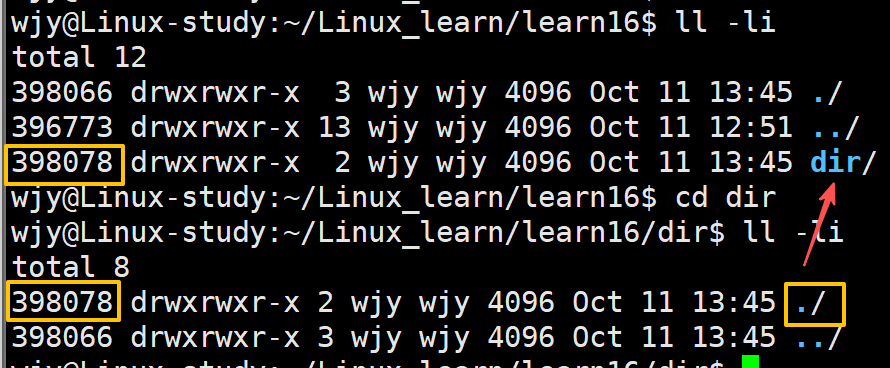
为什么是2?因为:
- 父目录里有一个名字
dir,指向inode 398078。- 进入
dir后,里面默认生成的隐藏目录.(当前目录),也指向inode 398078。
所以,任何一个目录内部的.,本质上都是对当前目录的硬链接。
如果我们在 dir 下再新建一个子目录 hello,父目录 dir 的硬链接数会变成 3 。
因为进入新建立的子目录 hello 后,默认生成的隐藏目录 ..(上一级目录),会自动指向父目录 dir 的inode。因此,一个目录的硬链接数 = 2 + 该目录下的子目录个数。
7.3 为什么禁止用户给目录建硬链接?(环路问题)
虽然系统自己用了 . 和 ..,但为什么严禁普通用户给目录建硬链接?因为Linux的文件系统结构是一棵多叉树 。如果允许用户给目录建立硬链接,就会在目录结构中形成环路(Loop)。
如果A目录硬链接到B目录,B目录又硬链接回A目录,当系统执行路径查找、计算目录大小,或者执行BFS/DFS(广度/深度优先搜索)遍历时,就会陷入死循环,导致系统崩溃。
而 . 和 .. 虽然是硬链接,但它们是系统定死的、内核层级有特殊豁免机制的存在。底层遍历算法遇到它们会自动跳过,因此不会引发环路问题。普通用户一旦手动创建,系统就会直接拦截。
7.4 软链接(Symbolic Link)
既然硬链接不能给目录用,跨分区也不能用,那我想在桌面上放一个深层目录的"快捷方式"怎么办?Linux给出了软链接(符号链接)方案。
使用 ln -s abc abc.s,我们创建了一个软链接。用 ls -li 观察:
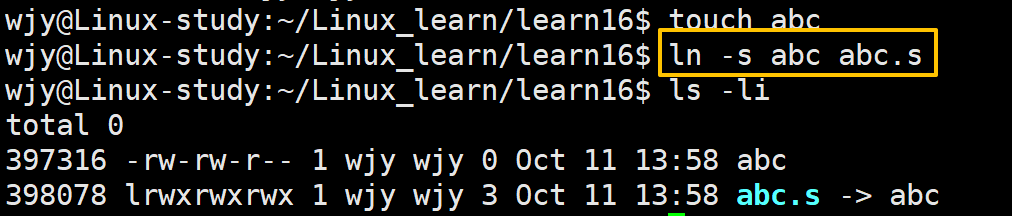
abc.s 的inode号是全新的,权限位以 l 开头,表示它是独立的新文件。它的数据块里保存的不是文件内容,而是目标文件的路径字符串。
这就完美解释了为什么软链接可以指向目录:当系统算法在进行DFS遍历时,碰到软链接,只会把它当成一个普通的"快捷方式"文件处理,它不会自动深入去遍历软链接所指向的目标目录。
当然,软链接也有它的代价:如果删除了源文件 abc,软链接 abc.s 依然存在,但指向了一个不存在的路径,变成了失效的悬空链接。
7.5 文件三个时间戳
在梳理软硬链接时,必须搞清楚文件的三个时间戳):
- Access(atime):最后一次读取文件内容的时间。
- Modify(mtime) :文件内容被修改的最后时间。
- Change(ctime) :文件属性(权限、硬链接计数等元数据)修改的最后时间。
细节提示 :硬链接增加或删除时,文件内容没变(mtime不变),但
i_links_count变了,所以ctime会更新。
7.6 核心对比与总结
| 特性 | 硬链接 | 软链接 |
|---|---|---|
| 本质 | 文件名与目标文件inode的映射关系 | 独立文件,内容为目标文件的路径 |
| inode | 与目标文件相同 | 与目标文件不同 |
| 链接数 | 增加(i_links_count) |
不增加 |
| 跨分区 | 不支持 | 支持 |
| 目录 | 不支持(易形成环路) | 支持 |
| 源文件删除 | 文件依然存在(直到链接数为0) | 文件失效(悬空链接) |
| 用途 | . 和 .. 目录、文件备份 |
类似快捷方式、软件版本管理(如 python -> python3) |
结语:
今天的内容到这里就结束了,希望你能有所收获~
干货整理到手抖,觉得有用的话,赏个三连回回血?__(:ᗤ」ㄥ)_ _