目录
[2.BERT Tokenizer](#2.BERT Tokenizer)
[3.1.MLM Task](#3.1.MLM Task)
[3.2.NSP Task](#3.2.NSP Task)
扩展阅读:https://kexue.fm/archives/8747
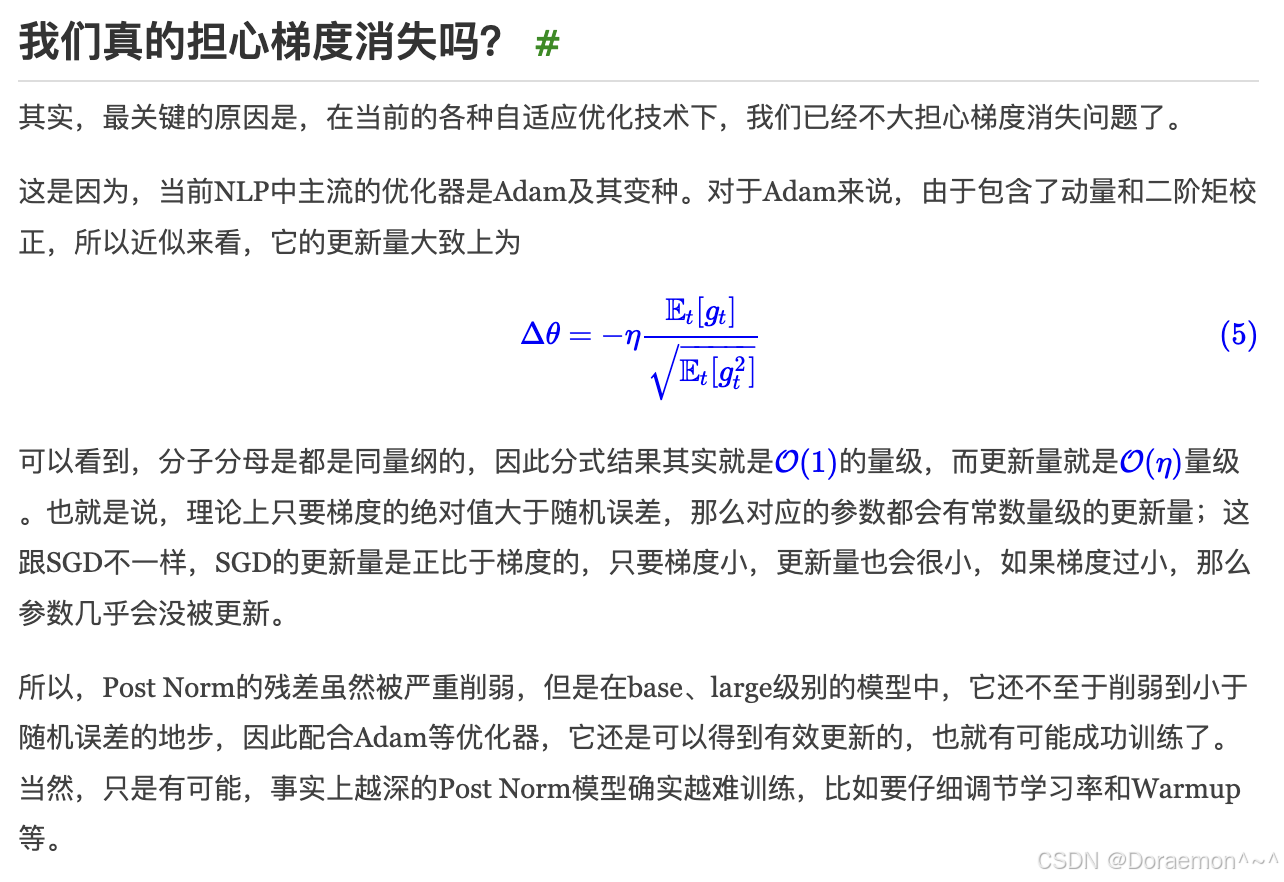
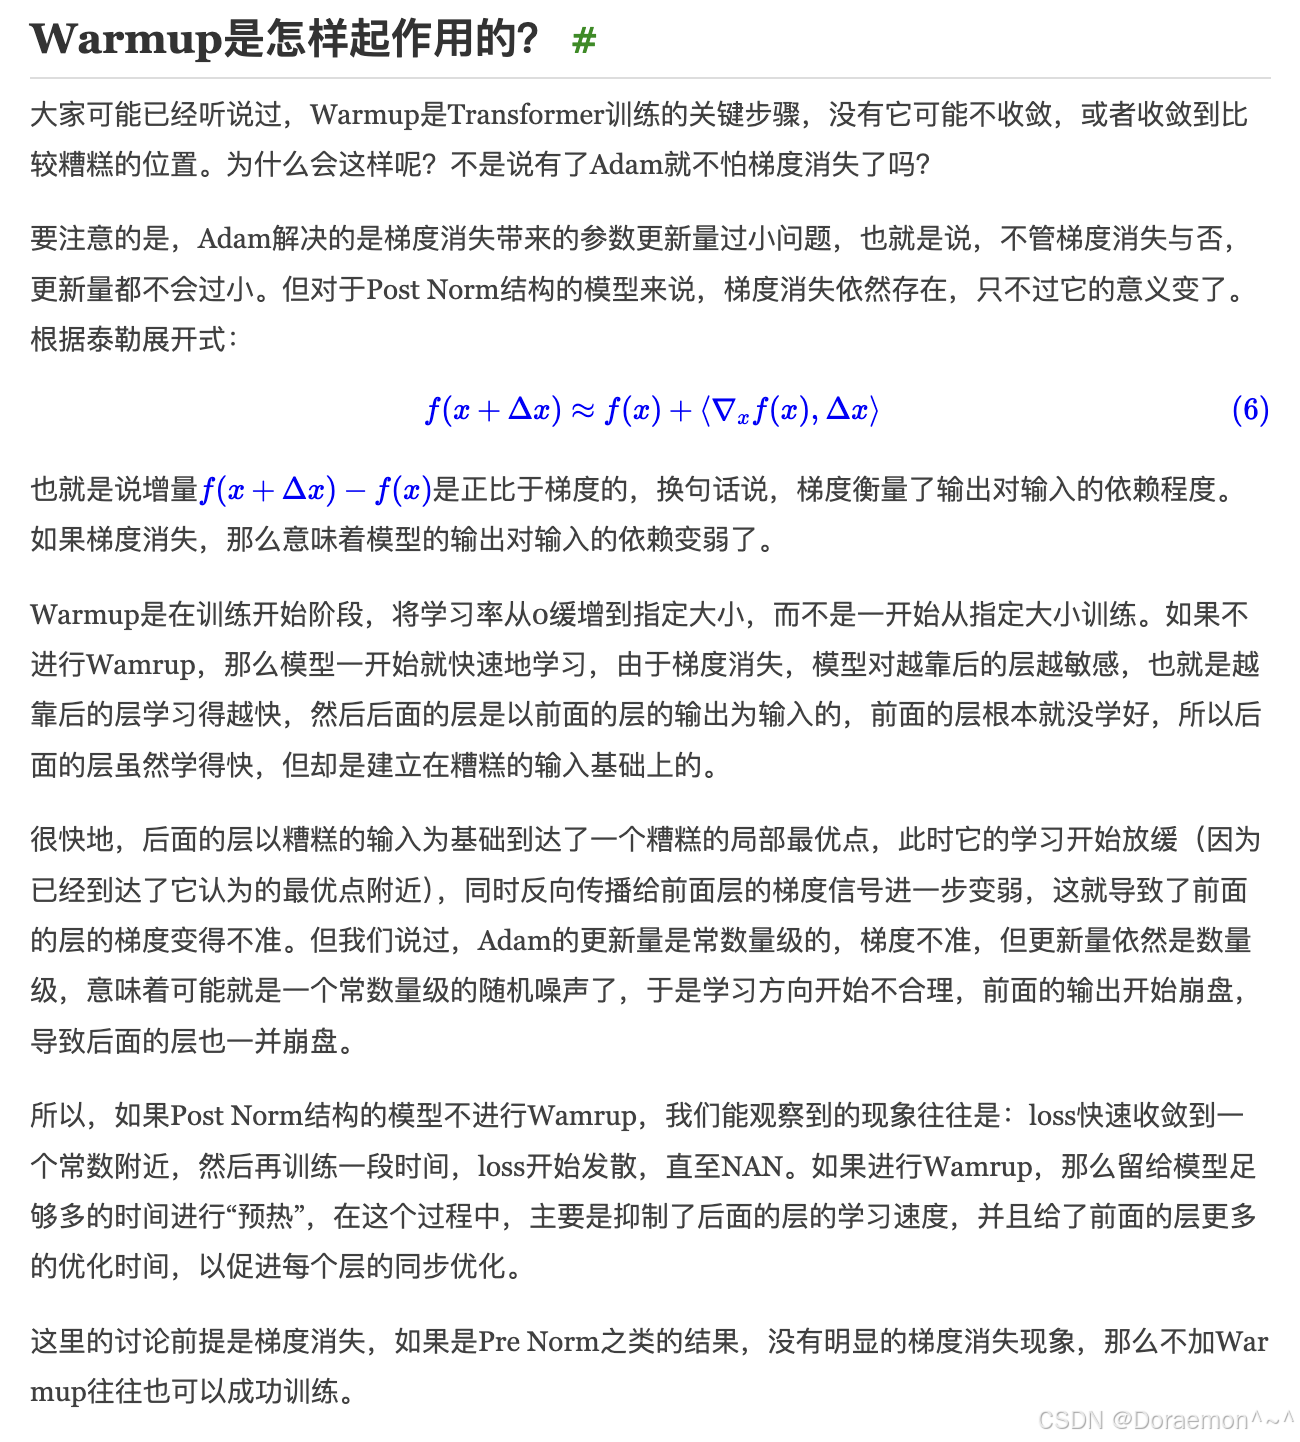
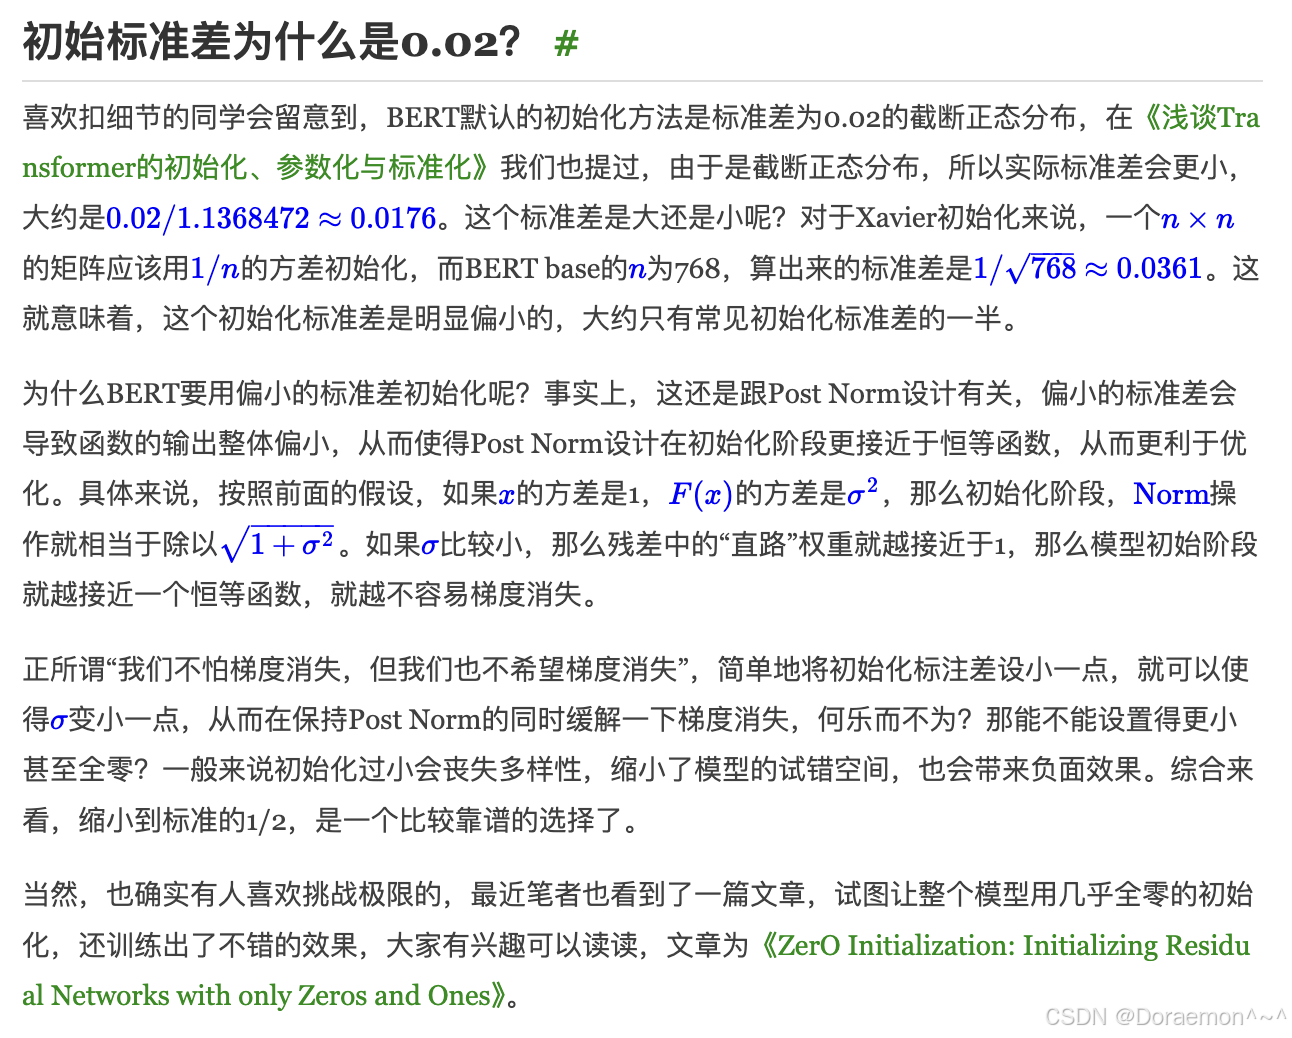
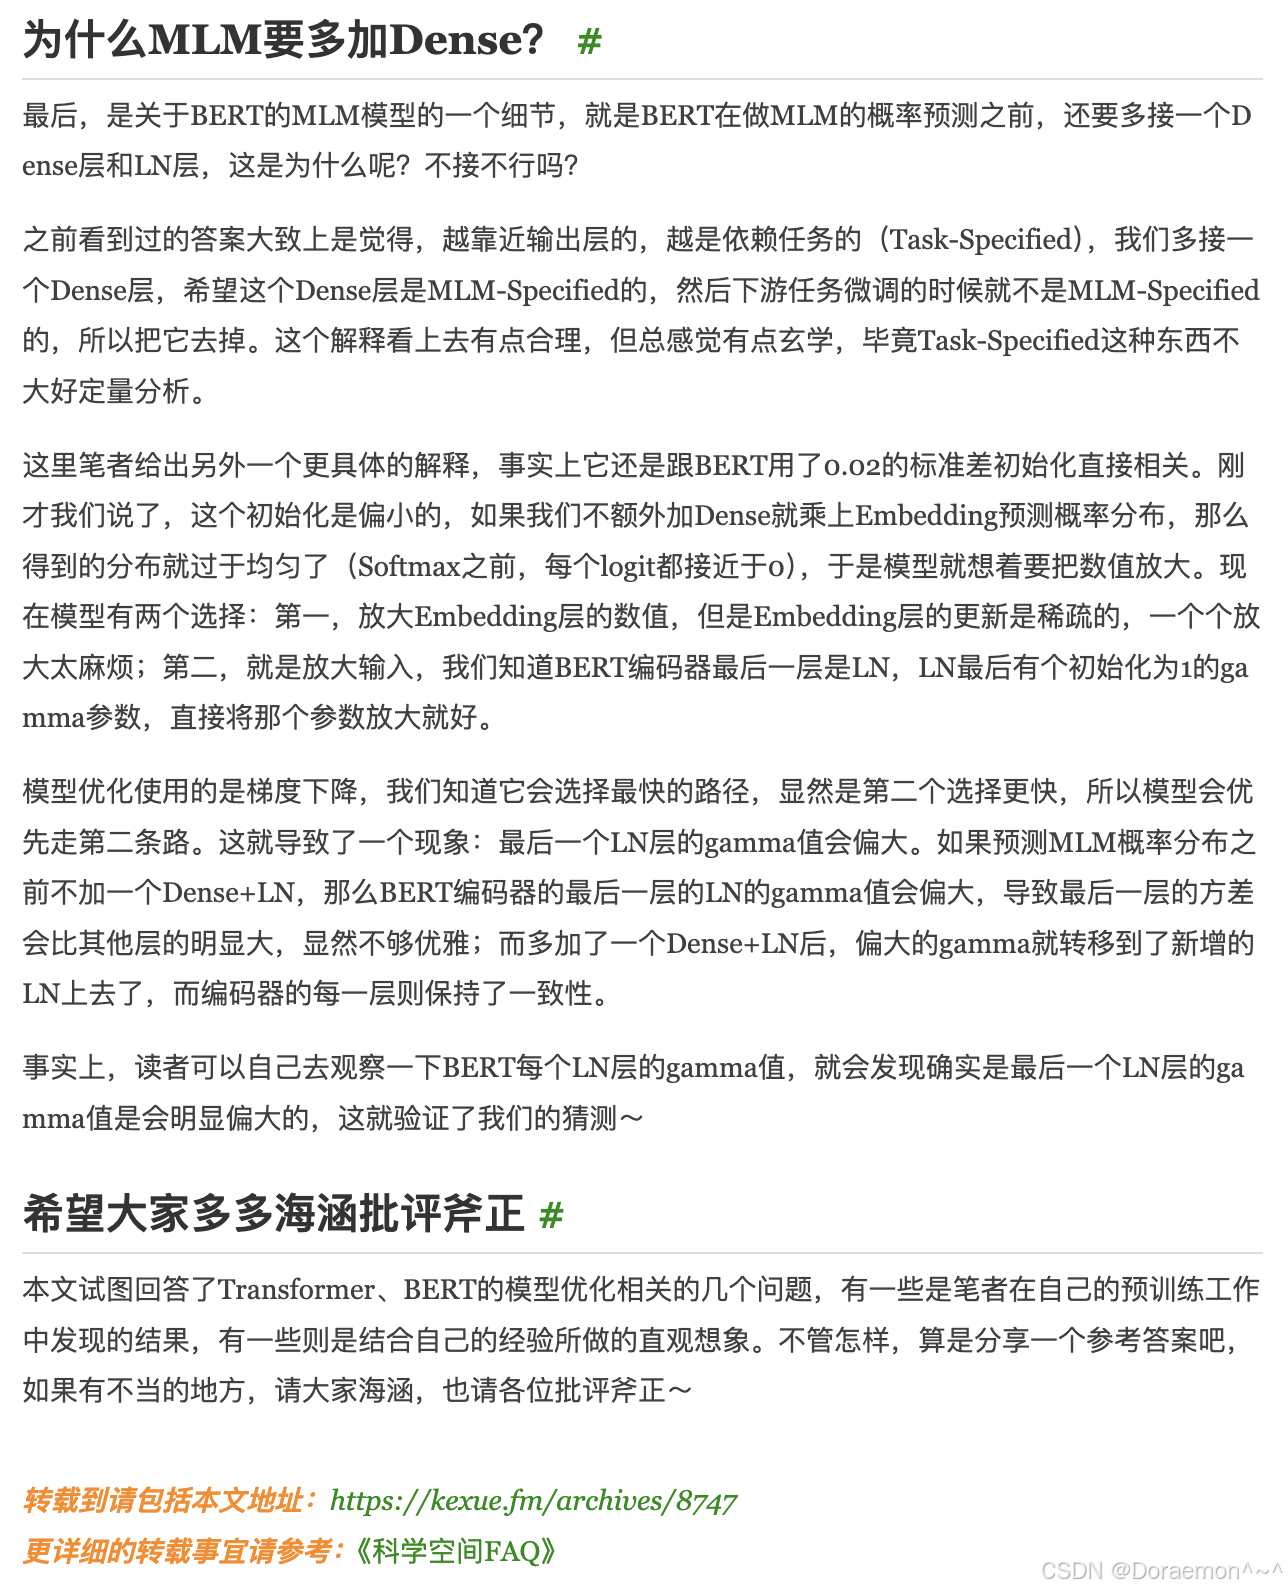
论文:https://arxiv.org/pdf/1810.04805
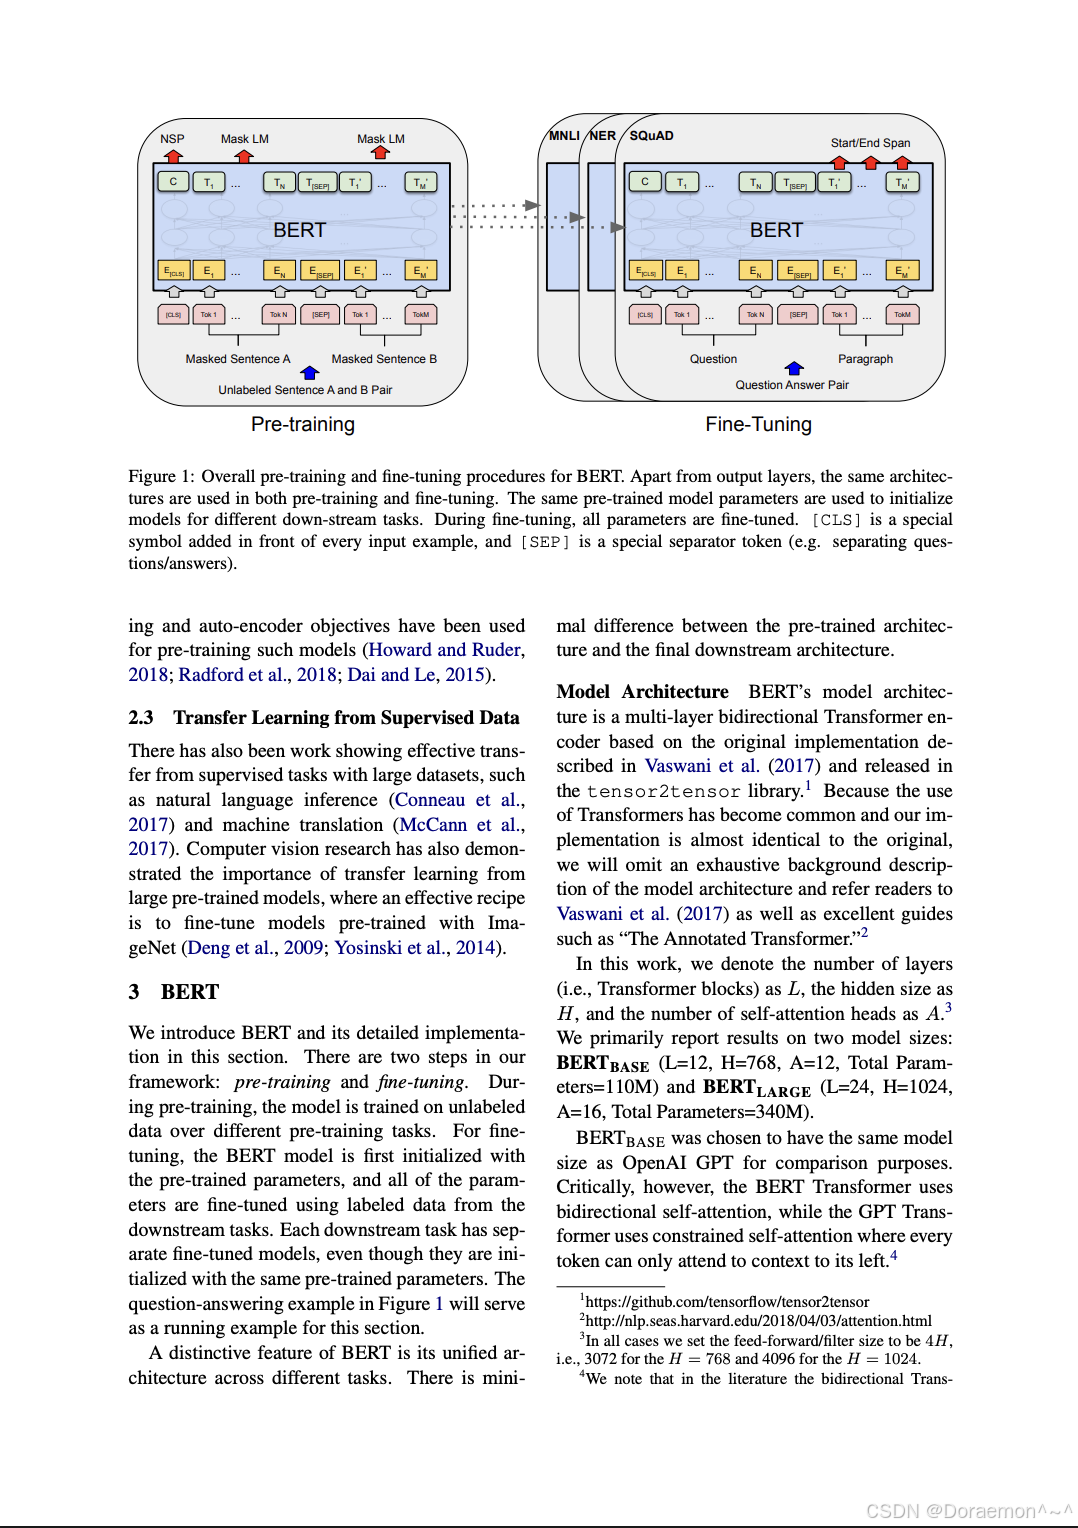
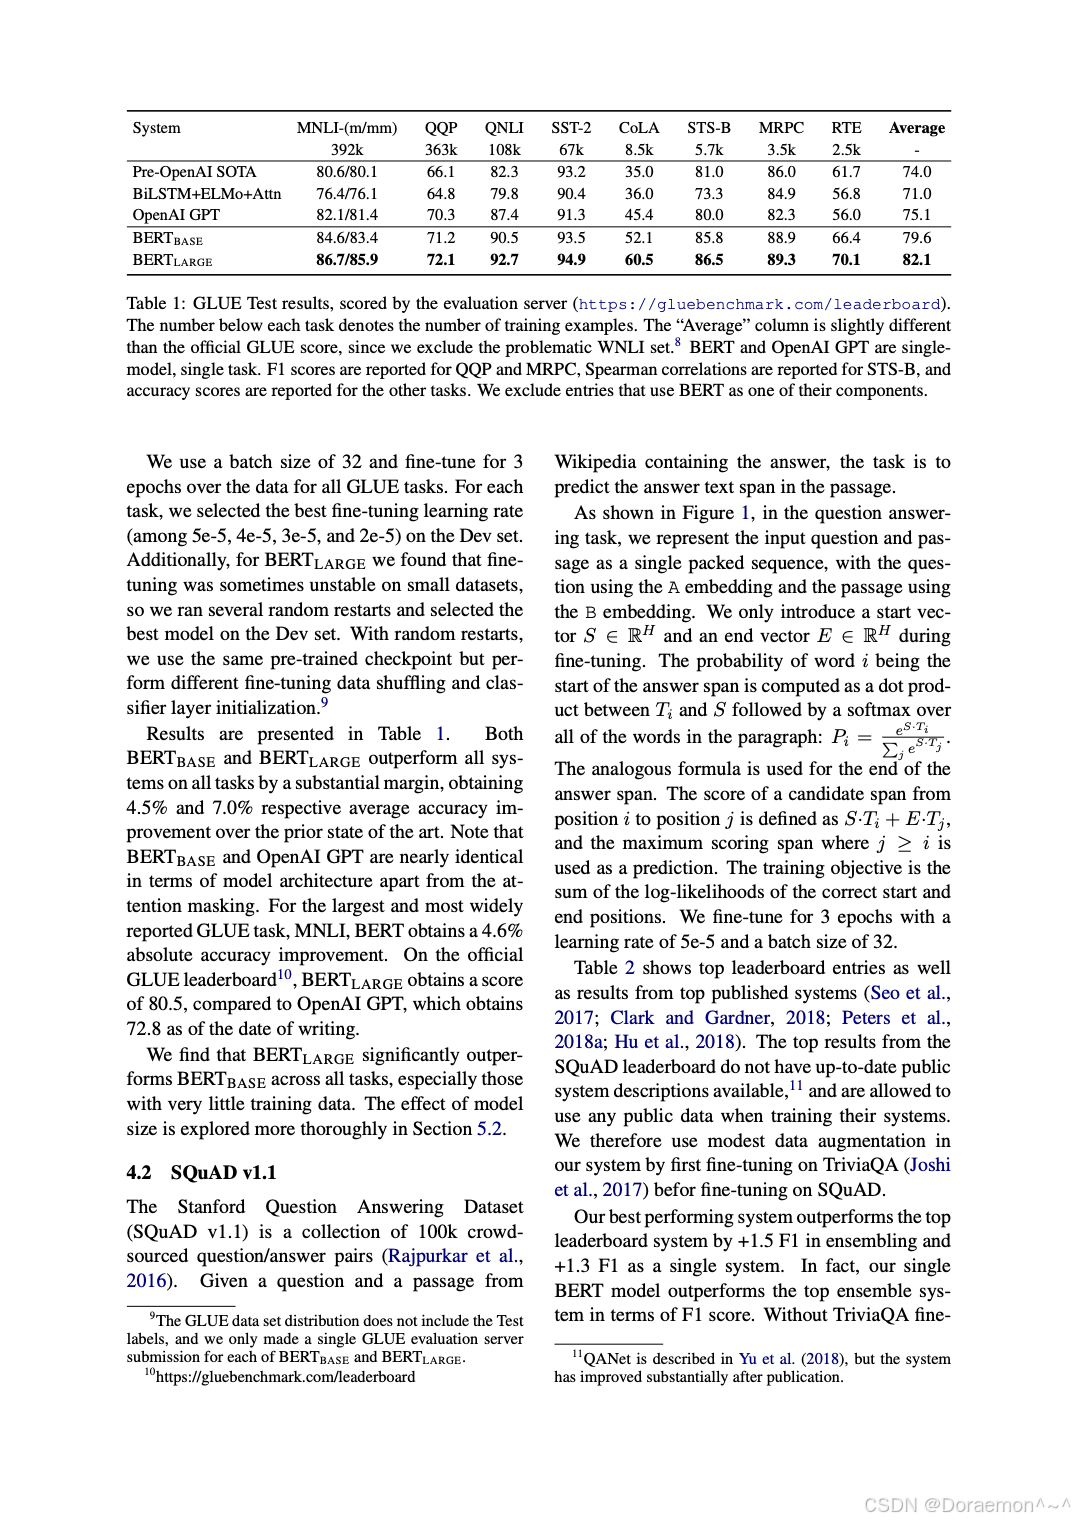
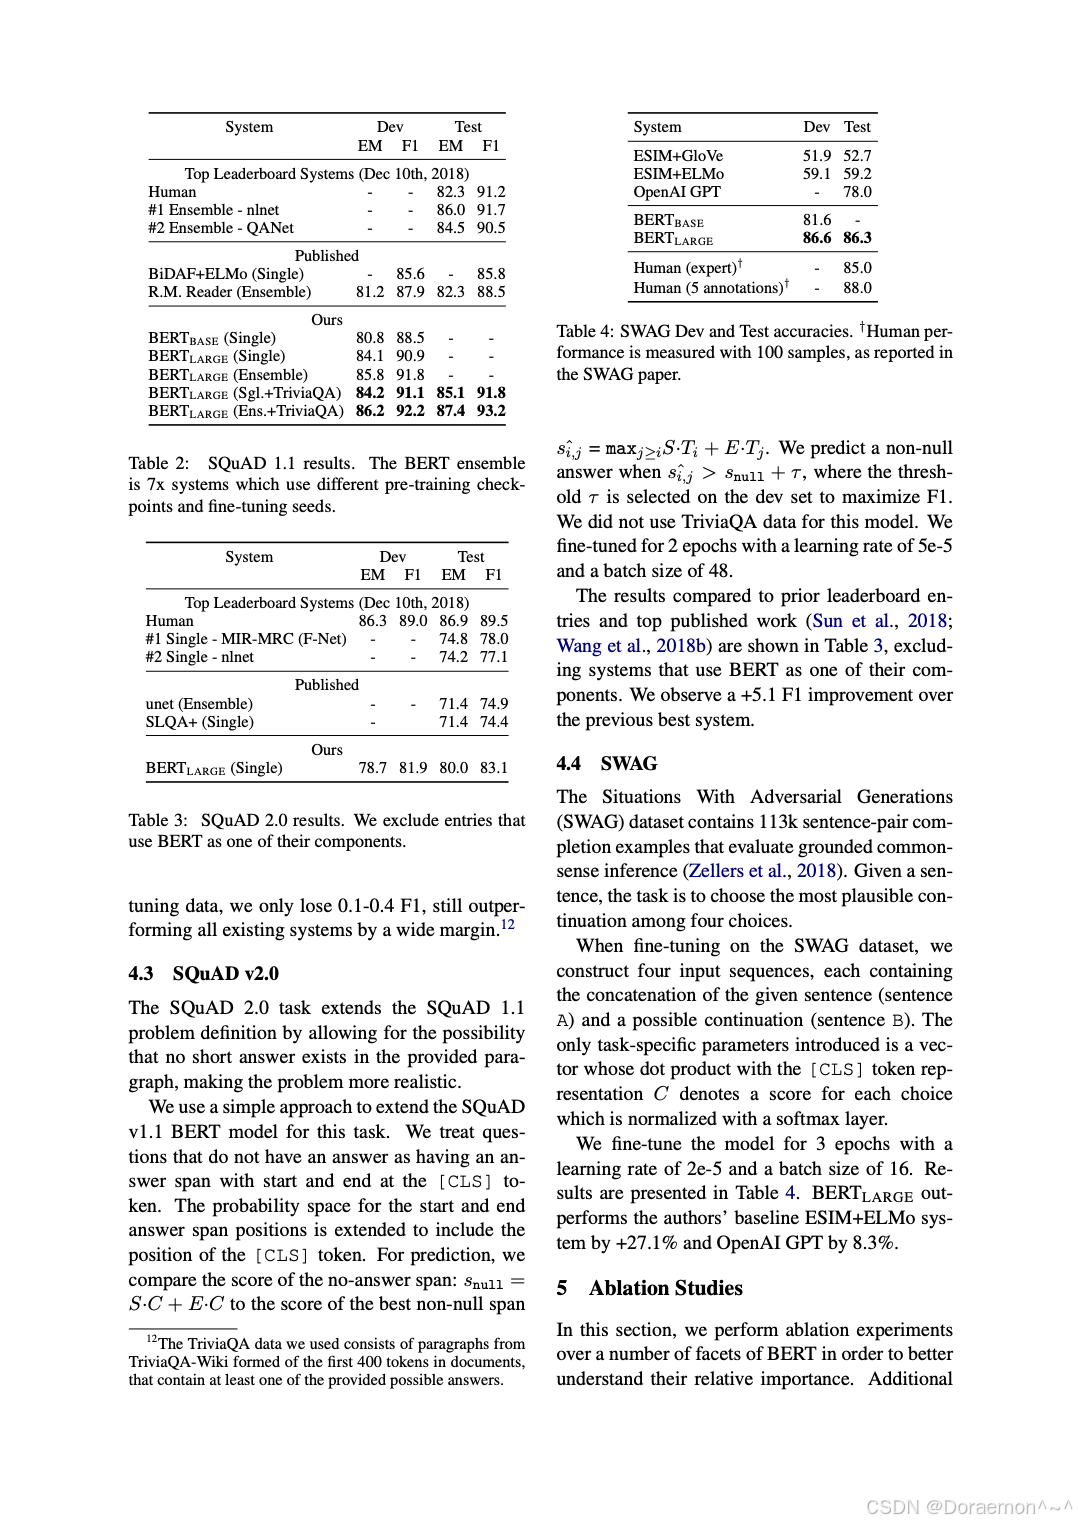
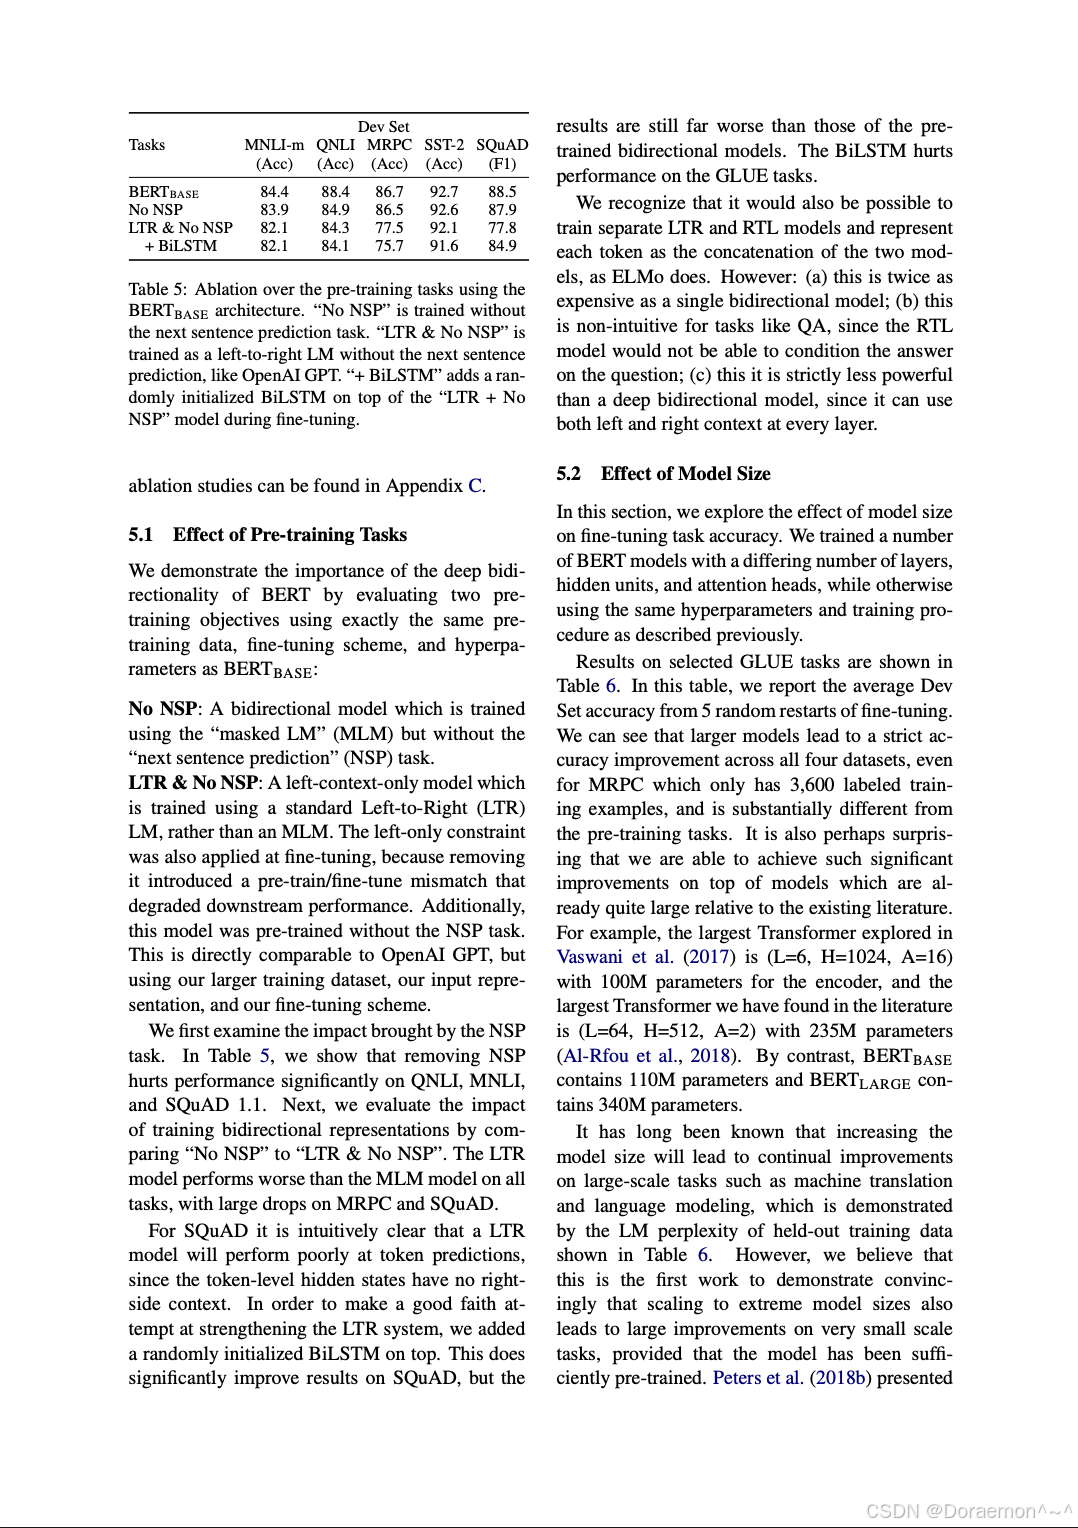
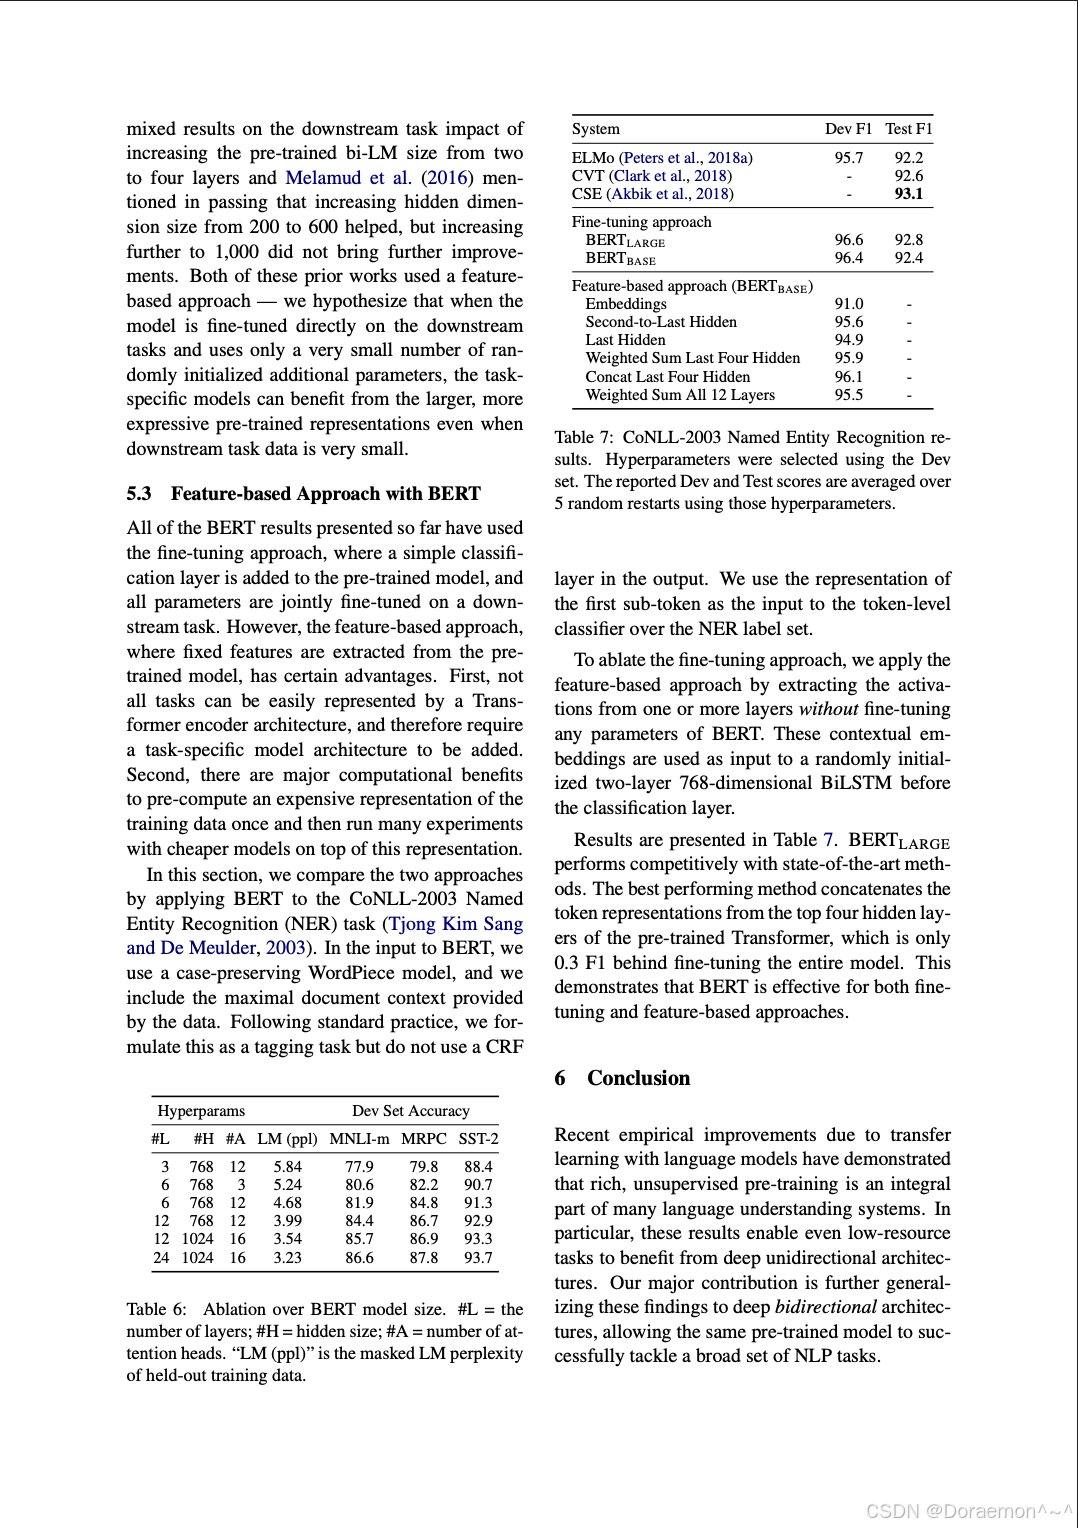
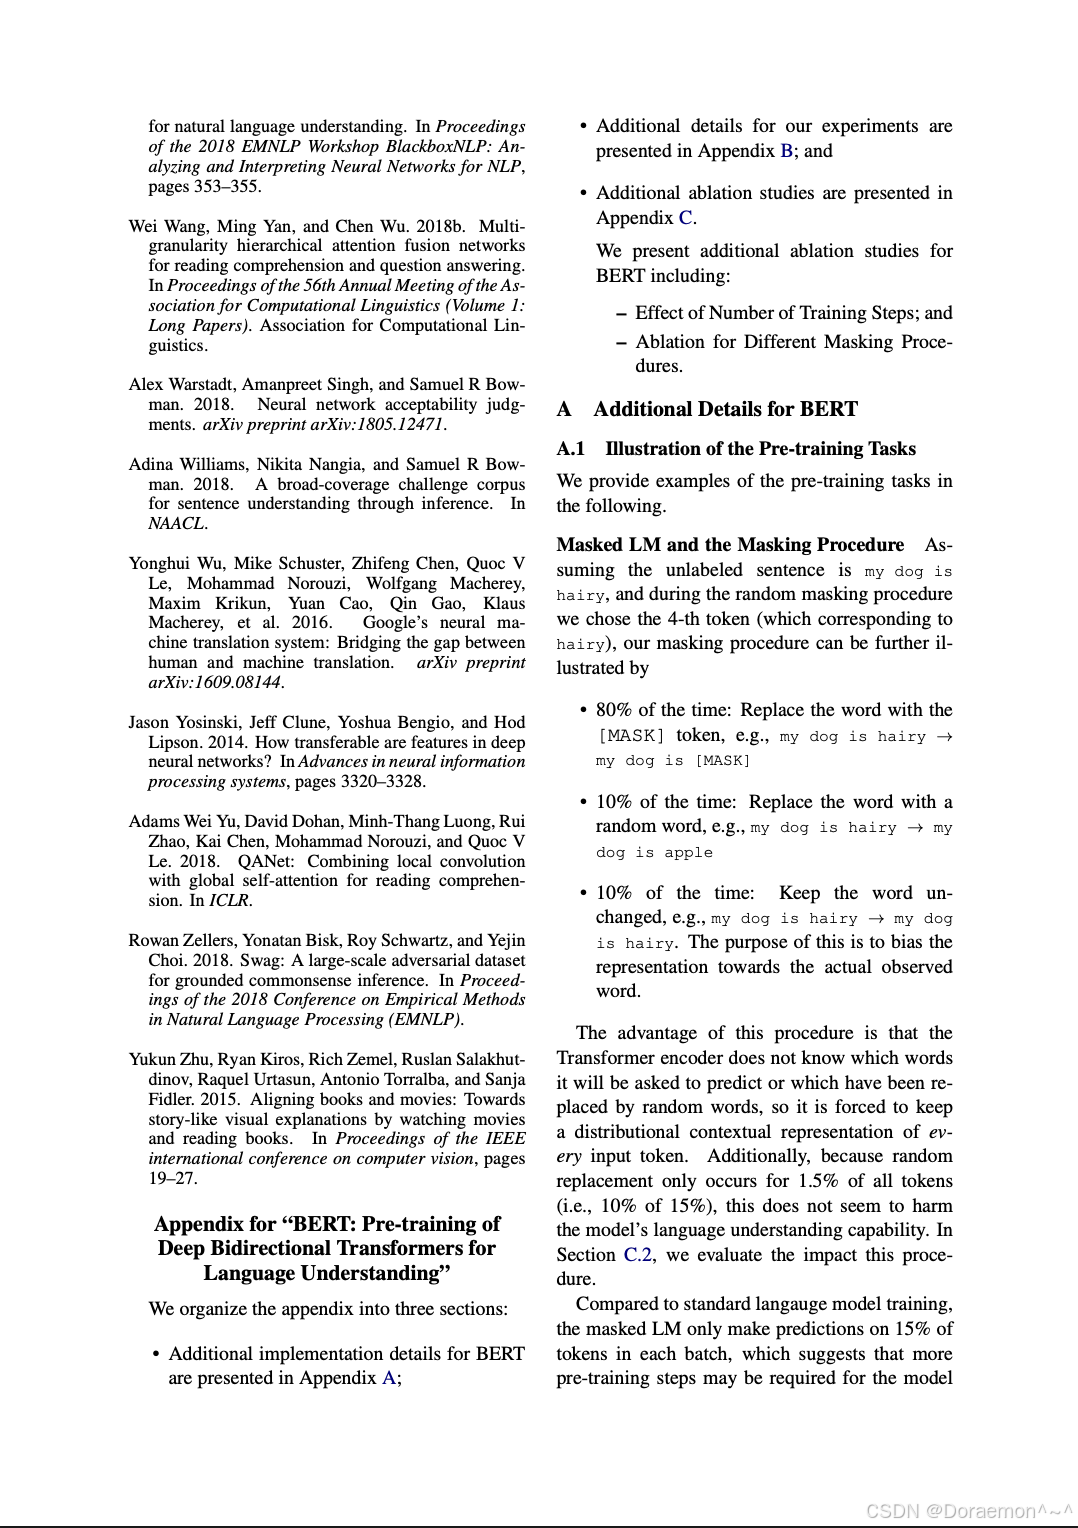
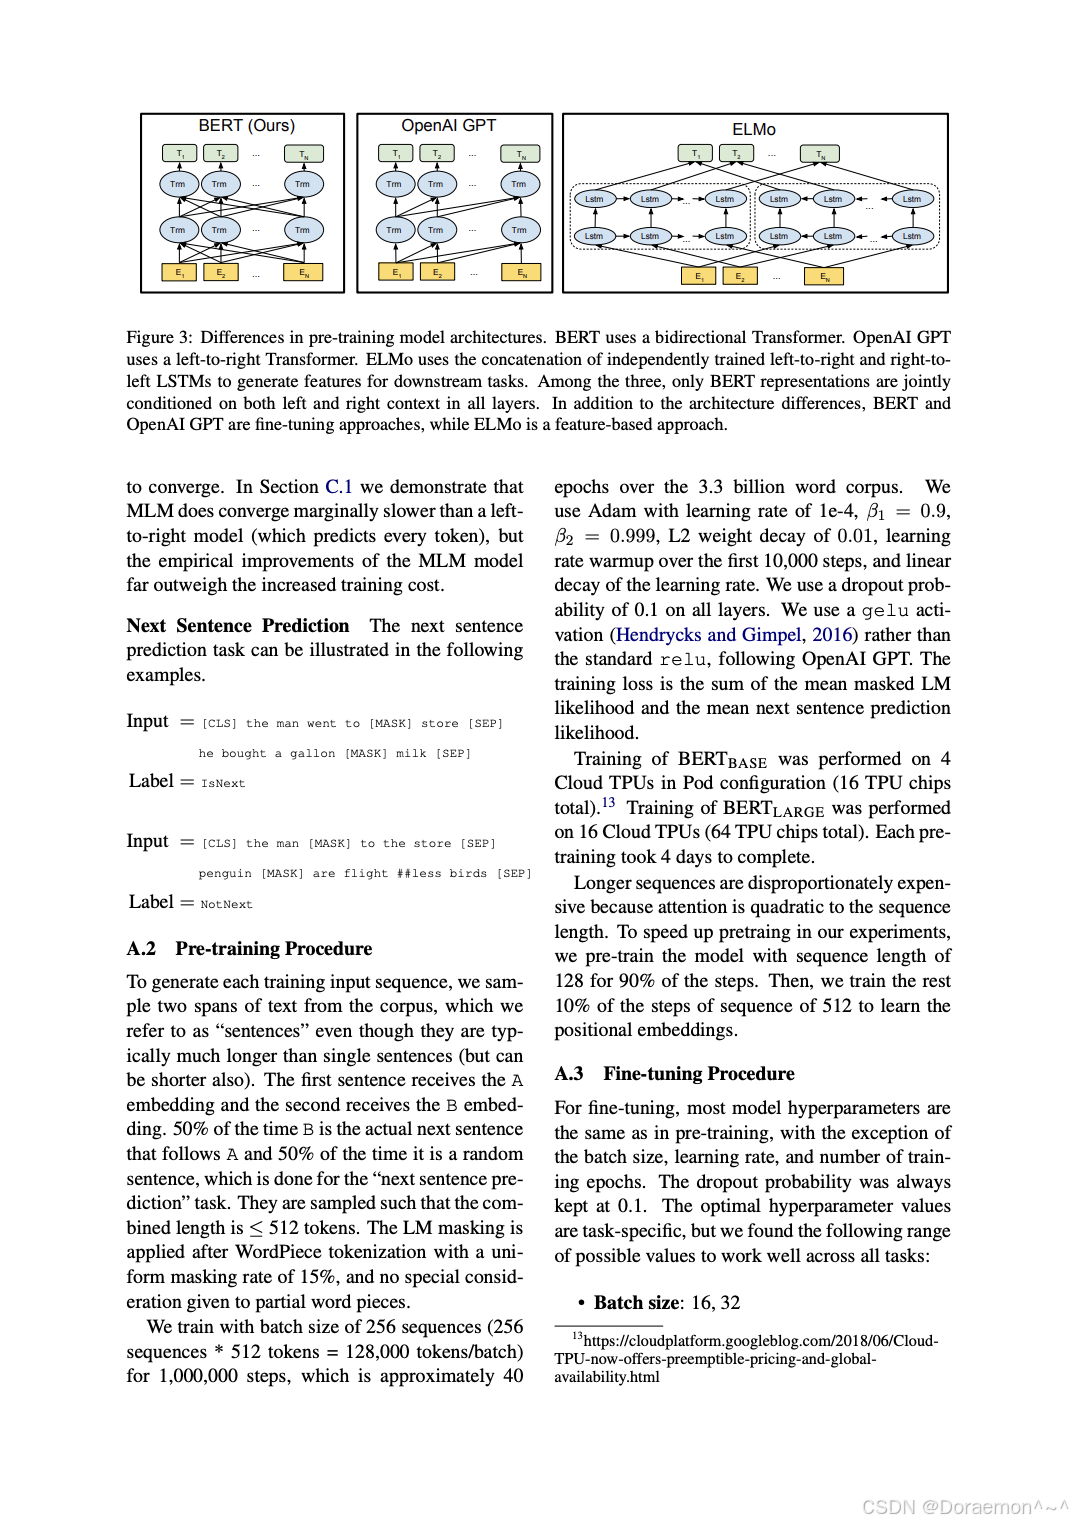
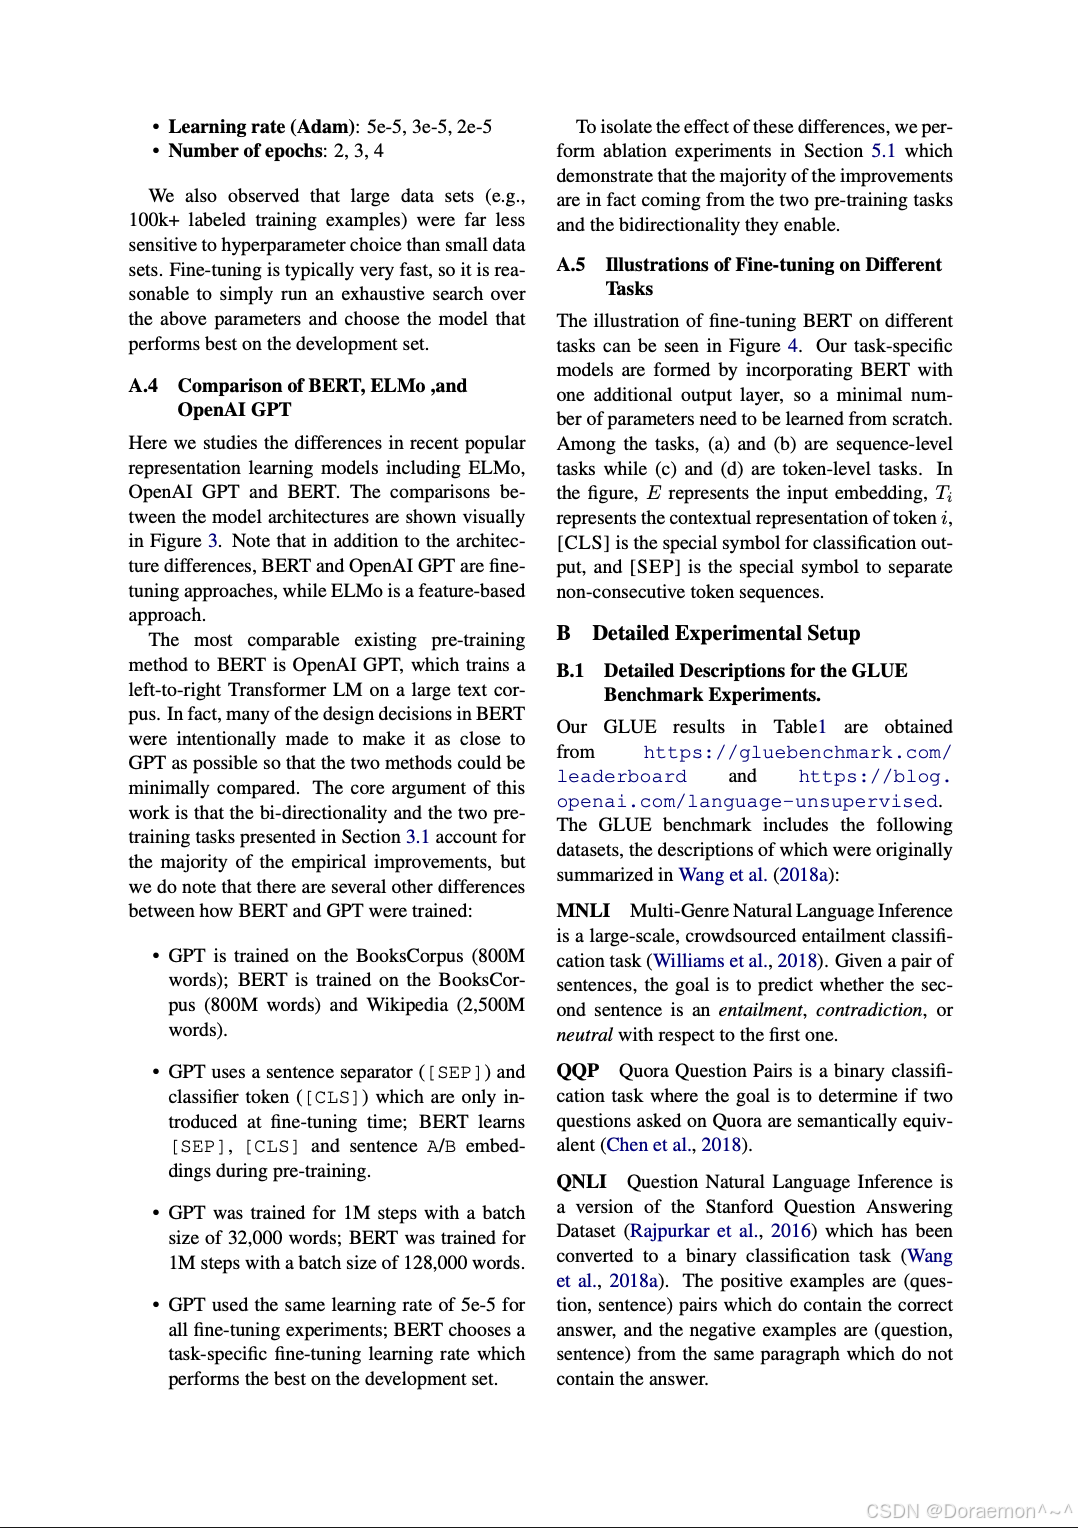
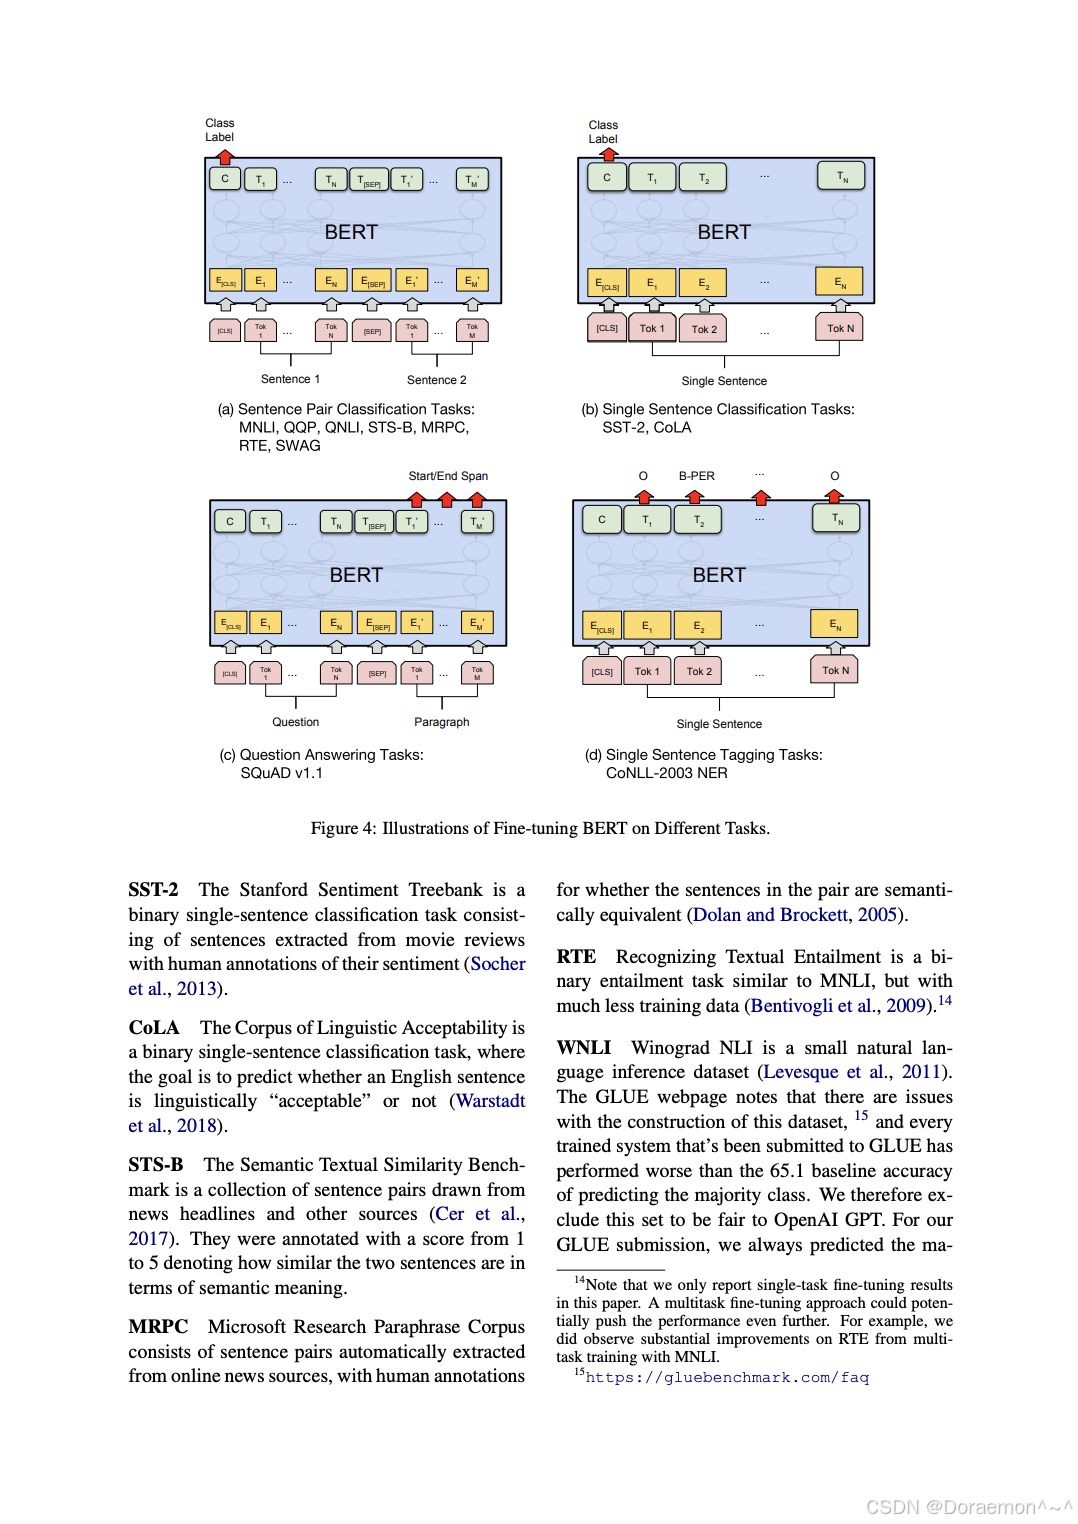
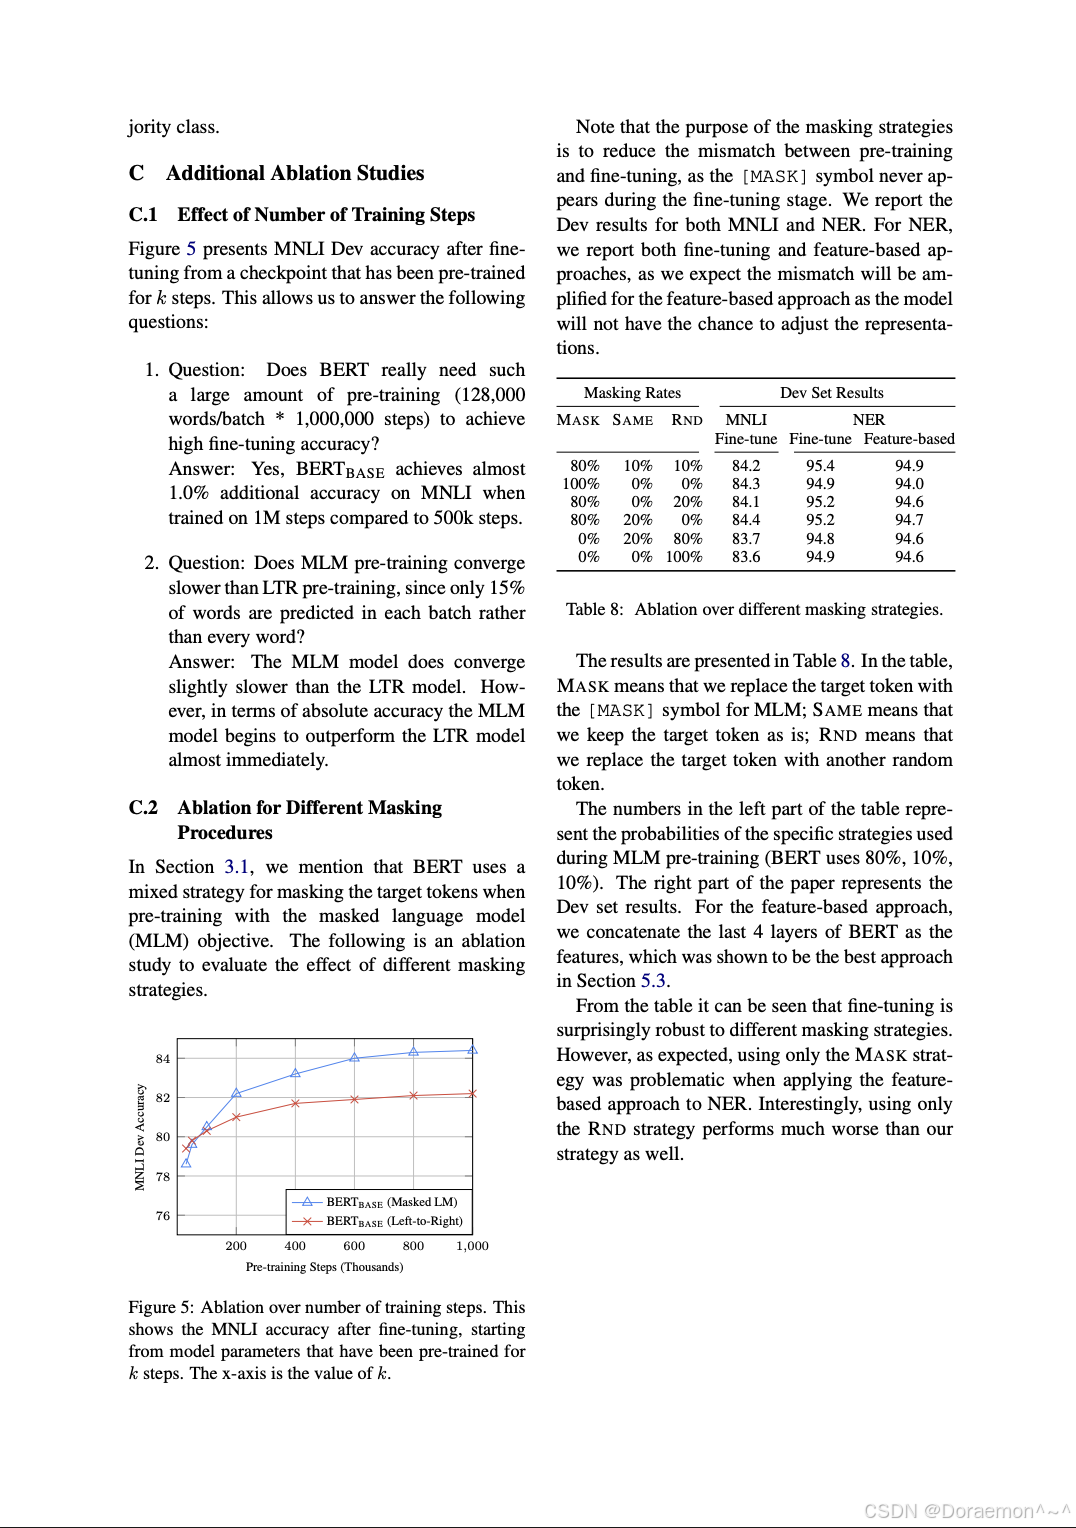
BERT (Bidirectional Encoder Representations from Transformers) 是一种Encoder-Only架构的预训练模型,它的出现标志着深度学习攻克了语义理解的堡垒。在进行了大规模的预训练之后,BERT学习到了非常好的语义表征(特征)。在预训练模型(特征)的基础上,继续通过微调训练下游任务的模型 (文本分类、命名实体识别、阅读理解等)。通过"预训练+微调"的,只需要相对少量的微调训练数据(千条的量级)就可以得到非常好的下游任务的效果。
BERT一经推出,迅速占领了各种自然语言理解 (NLU) 榜单的榜首位置,但在自然语言生成 (NLG) 方面还没有突破。
1.模型架构
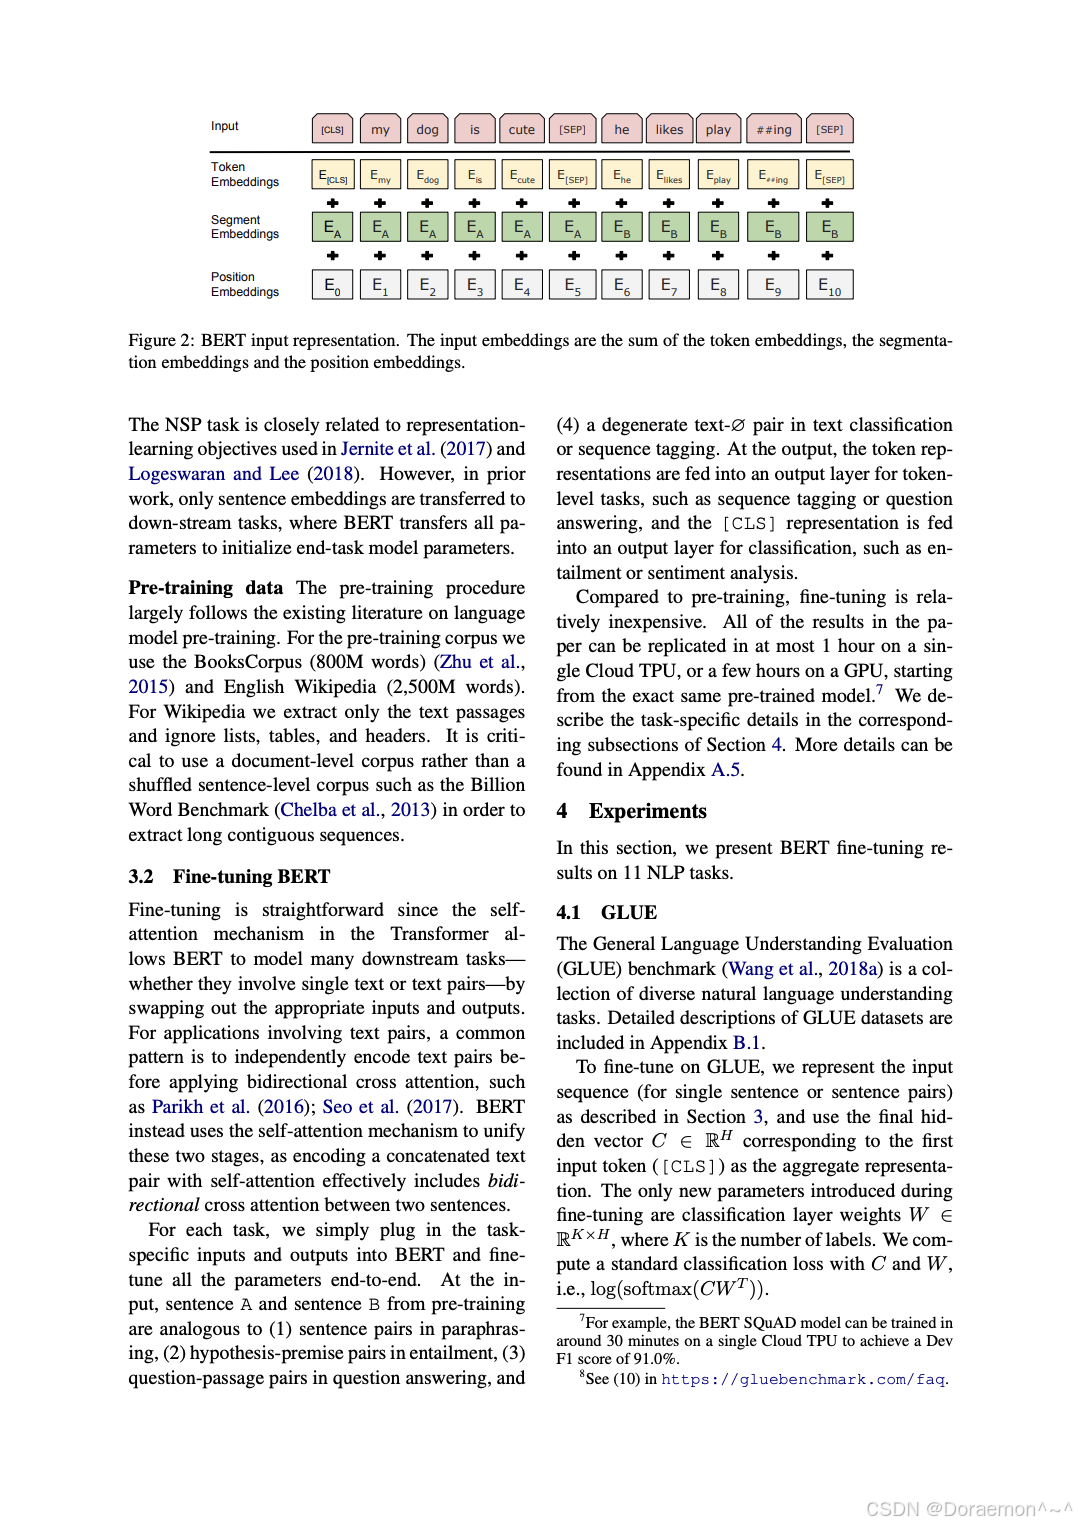
BERT模型架构是Encoder-Only Transformer,模型输入可以是一个句子或多个句子。在对文本进行了分词 (Tokenization) 之后,第一个句子的token之前会被插入一个特殊token "CLS",用于表示这一段文本的特征。在每个句子的尾部会插入另外一个特殊token "SEP",用于分割句子。
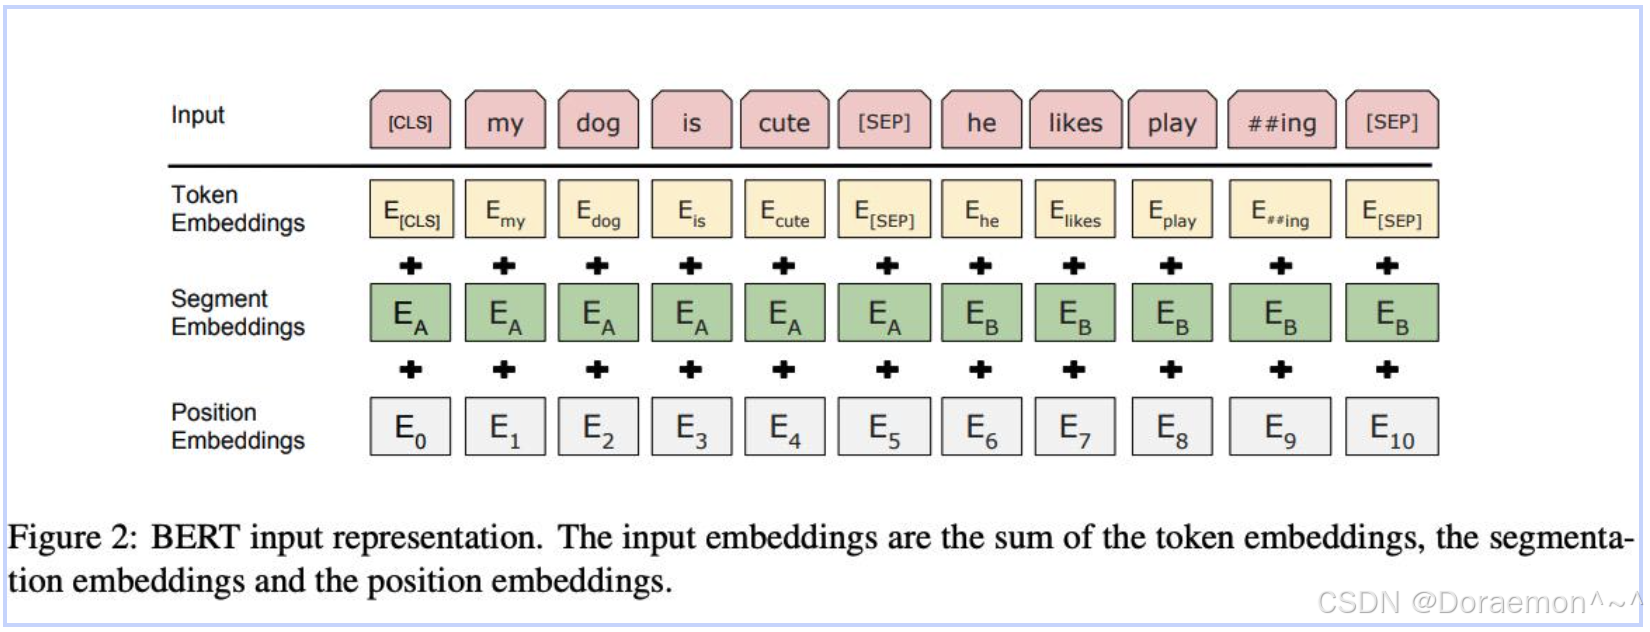
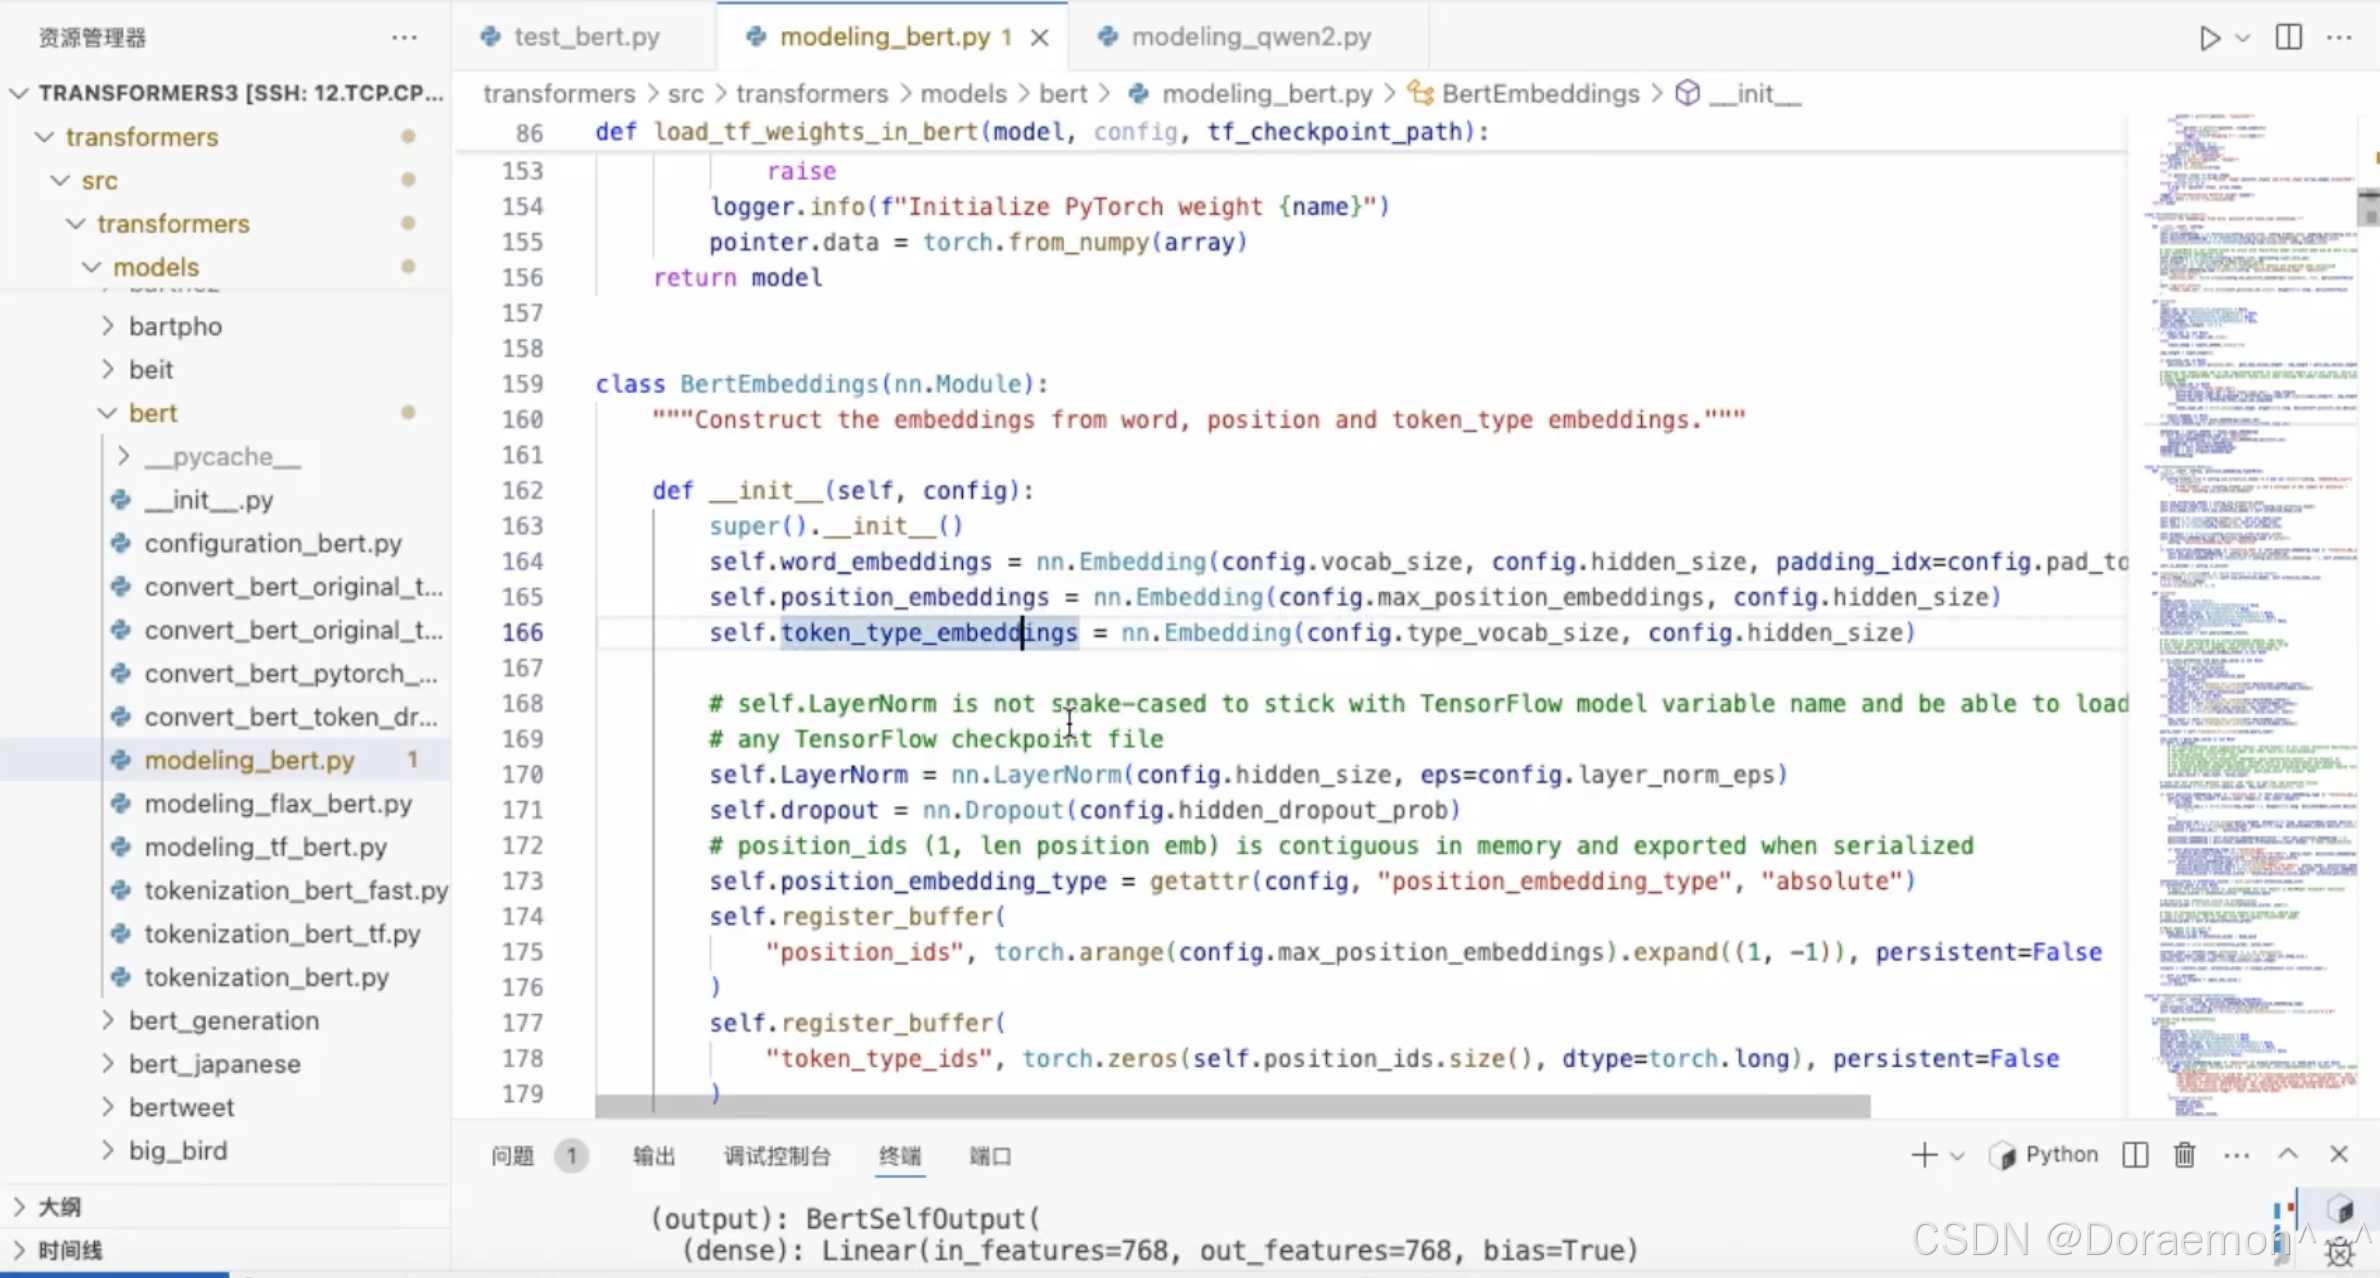
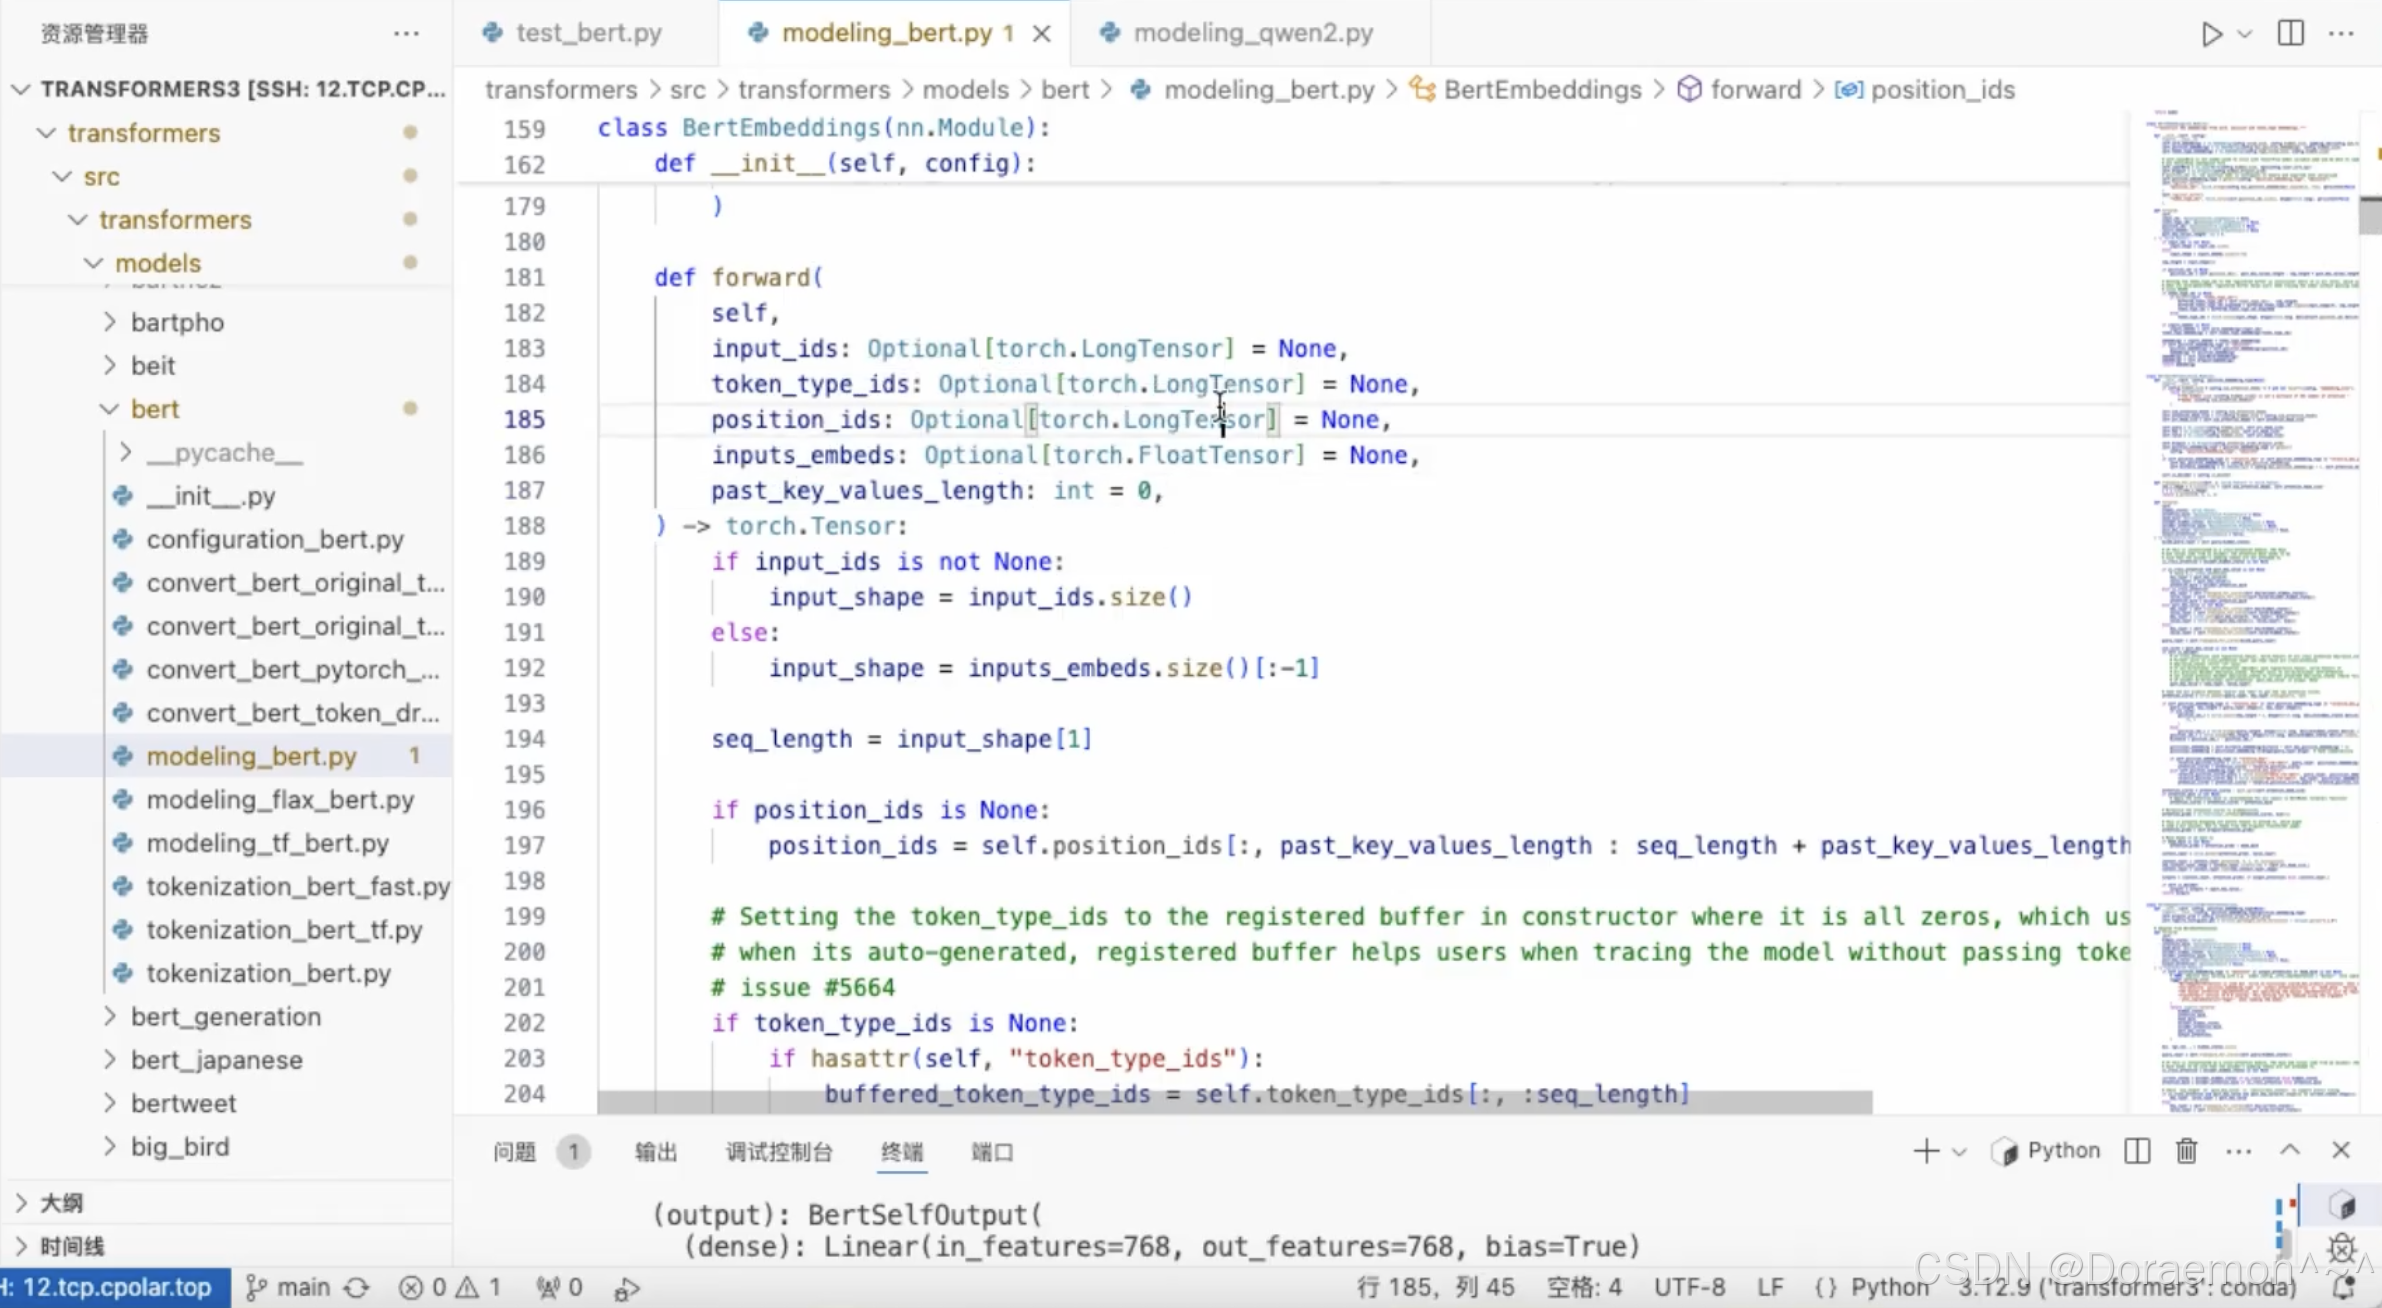
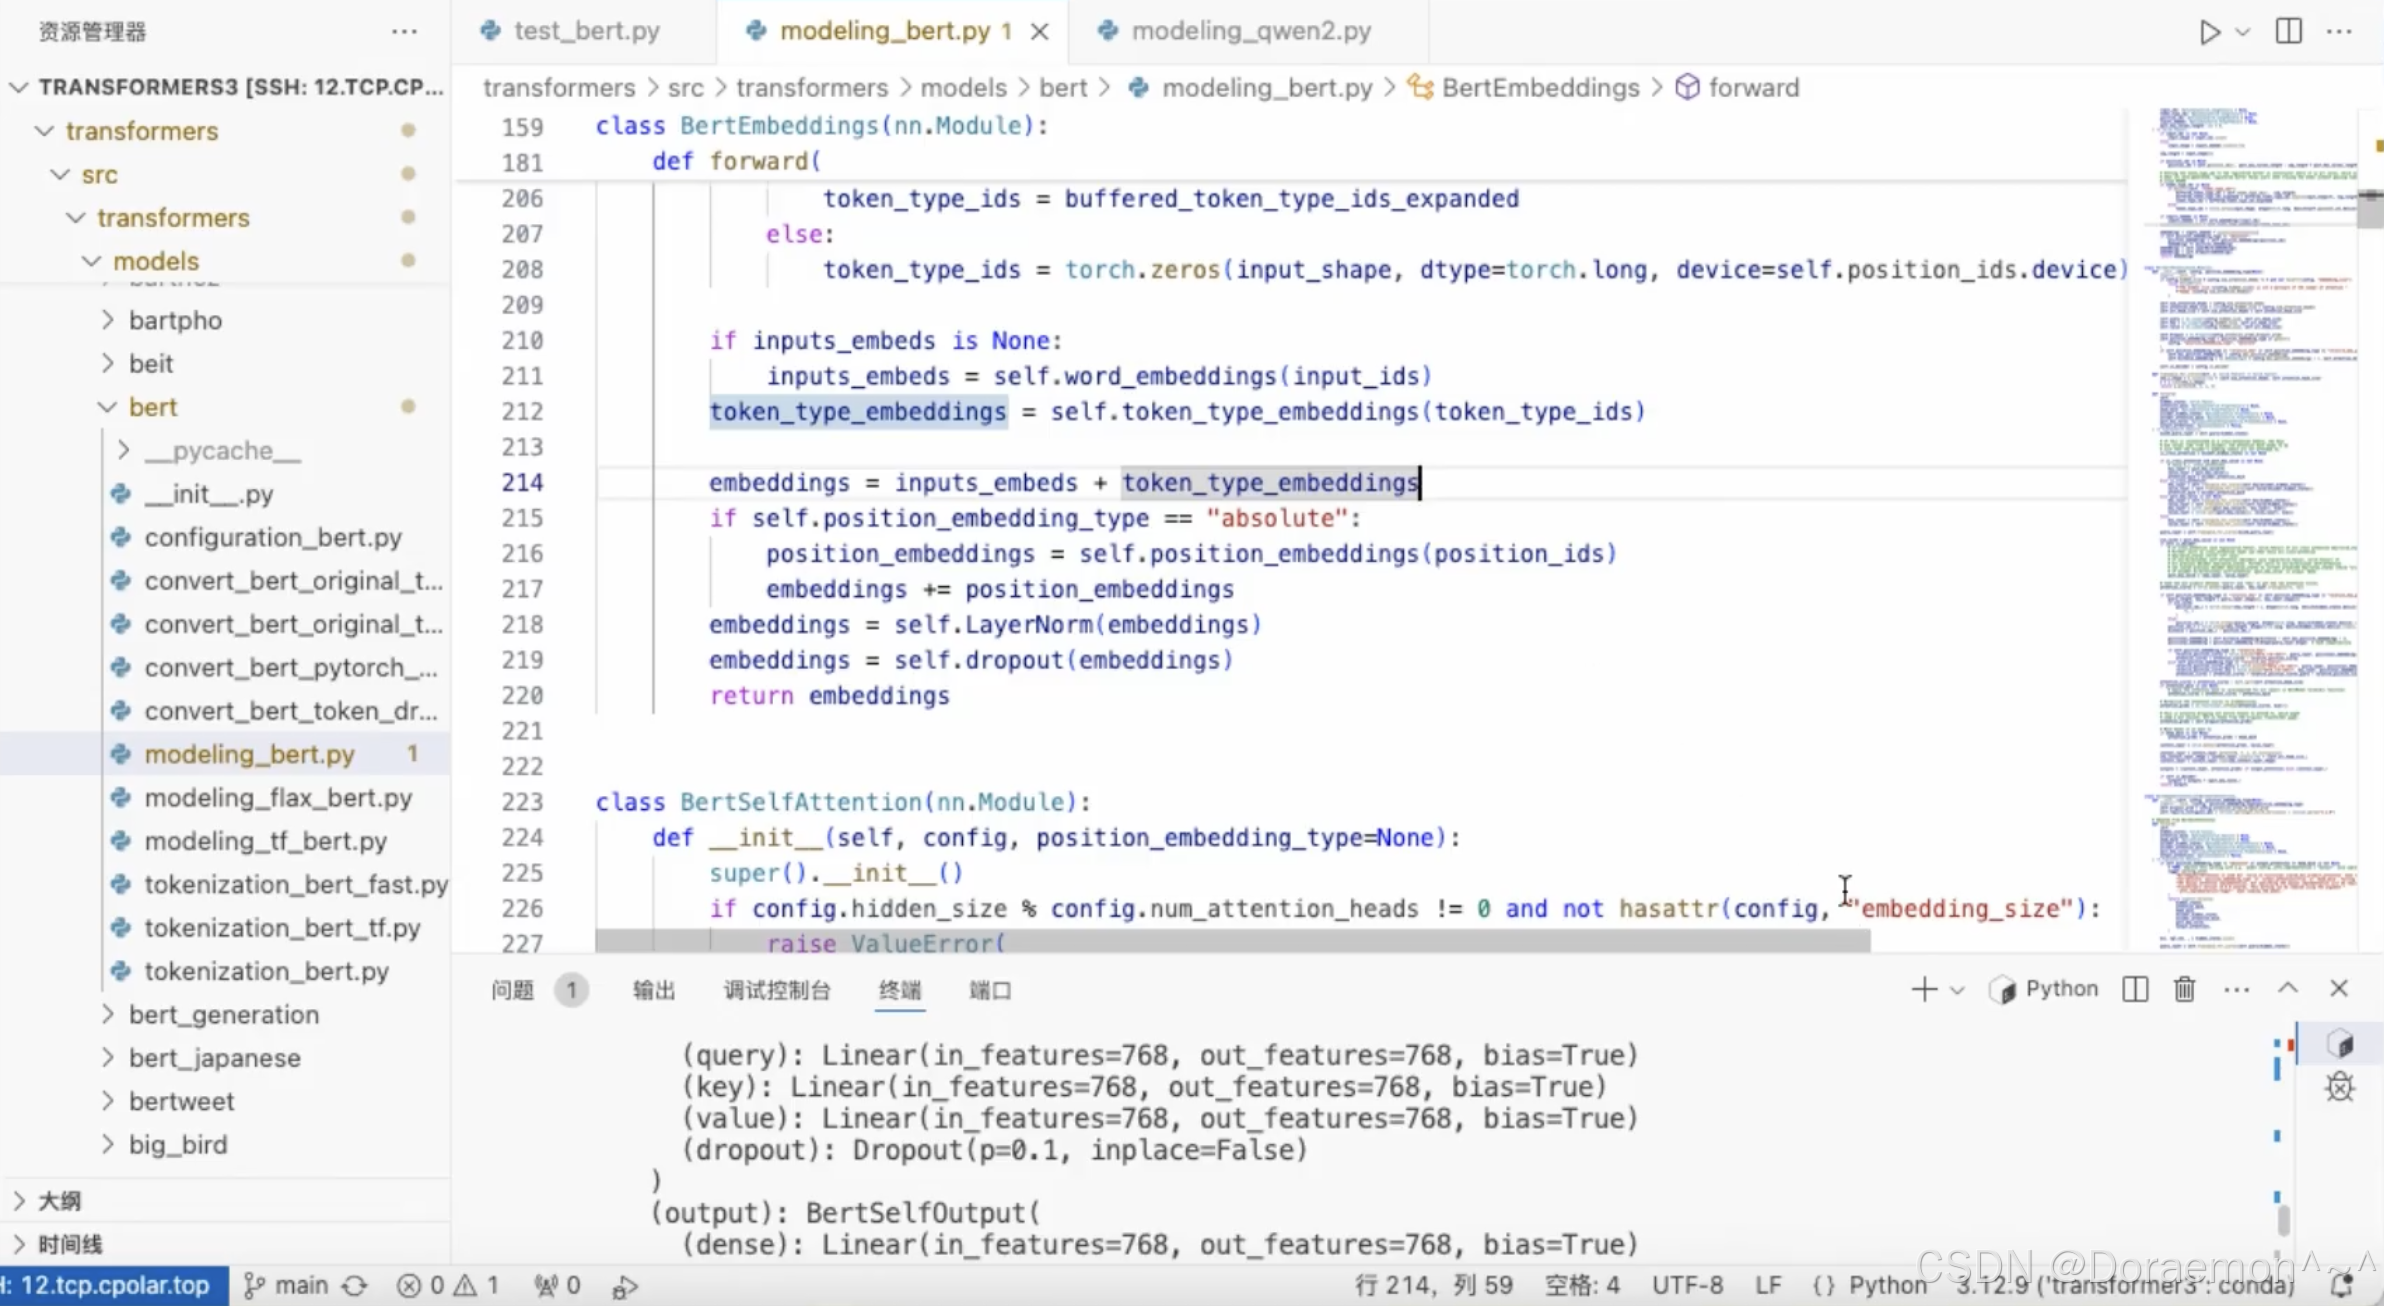
BERT的输入特征由三个分量相加得到:
-
Token Embedding:每个token都训练一个嵌入向量 (Embedding Vector),表示token的内容特征。
-
Segment Embeddings:每个句子被赋予一个segment id,同样训练嵌入向量。
-
Position Embeddings: 每个token在输入中的位置也被表示为嵌入向量。BERT的位置编码基于学习的,在0~MaxLength之间的每个整数id,对应一个可学习的嵌入向量。
以上三种嵌入向量是等长的。对于每个位置,三个向量的和即为BERT编码器的输入。
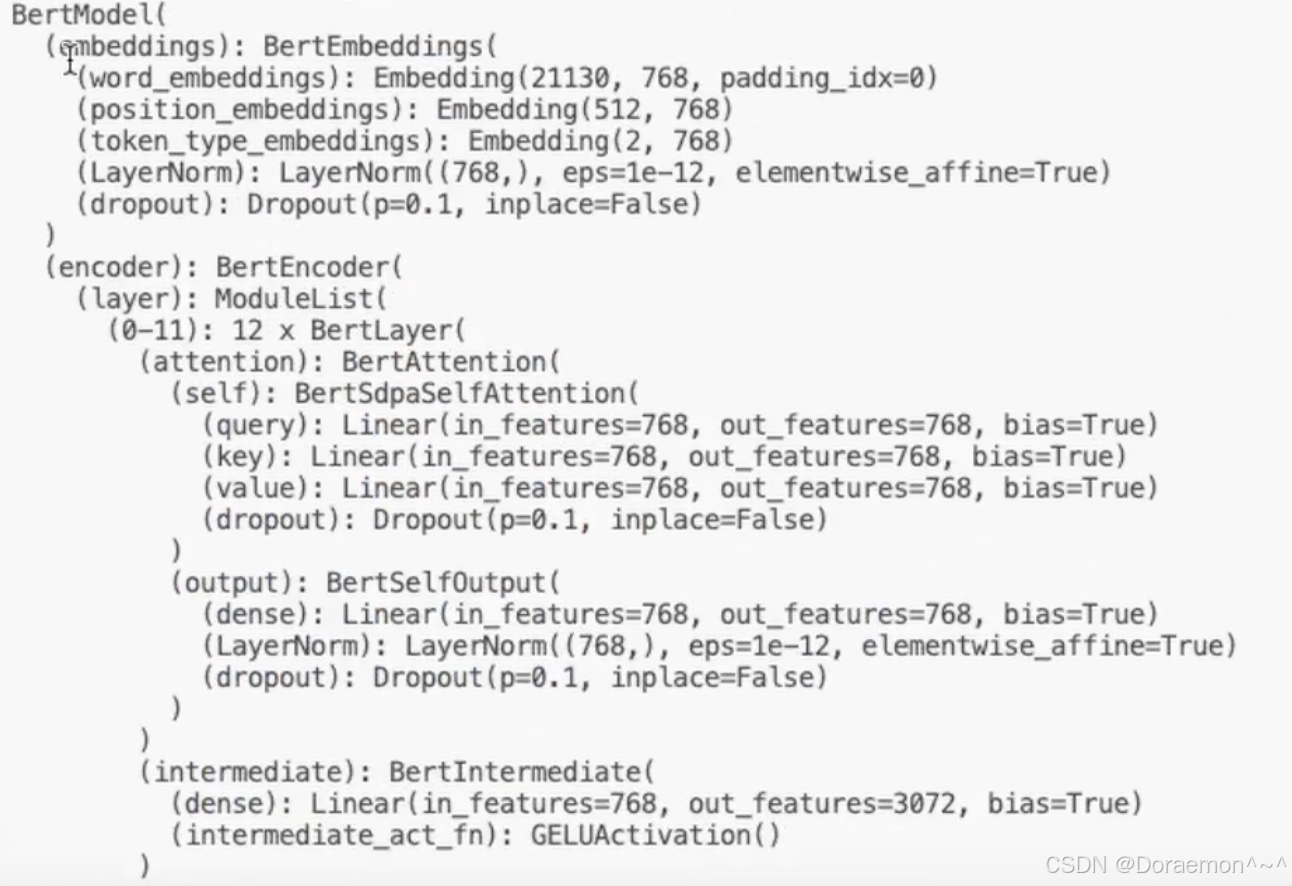
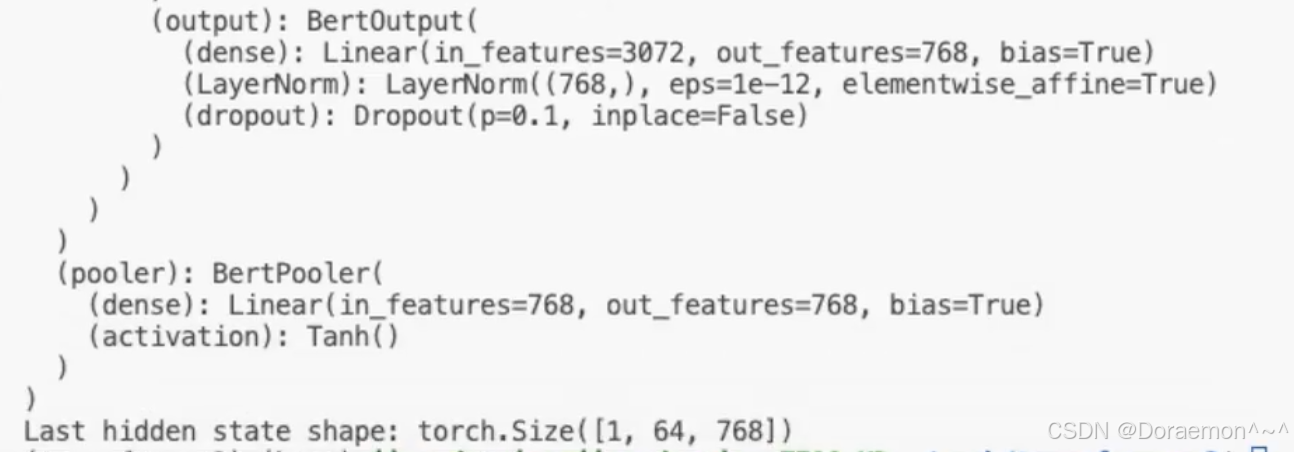
BERT的模型架构即为Transformer Encoder。BERT训练了不同大小的预训练模型,它们的架构和参数量分别为:
-
BERT Base:12 Transformer Encoder Blocks,隐藏层特征向量的长度为768,12个自注意力头,参数量为110M (1.1亿)。
-
BERT Large:24 Transformer Encoder Blocks, 隐藏层特征向量的长度为1024,16个自注意力头,参数量为340M (3.4亿)。
2.BERT Tokenizer
BERT Tokenizer (分词器) 所输出token的粒度是小于词的。对于中文,每个汉字作为一个token;对于英文,BERT采用的是WordPiece Embeddings,一种基于子词 (subword) 的表示方法,vocab大小为30k (3万)。
采用子词表示的原因是:英文中的词频分布非常长尾,有大量平时不常使用的词。如果在vocab中加入长尾词,就会使得模型复杂度迅速增大,容易导致过拟合的情况;如果忽略长尾词,又会提高未登录词 (Ouf-of-Vocabulary, 简写为OOV) 出现的概率。将文本拆分为子词可以很好地解决这个问题。
WordPiece tokenizer将文本切分为subword,为了能从token sequence没有歧义地恢复出原文本,定义一个特殊的字符表示词边界。以下是一个将文本切分为WordPiece序列的例子。

WordPiece选取subword的算法是数据驱动的,需要准备一个训练语料库,并确定期望的subword vocab的大小。先将单词拆分为最小单元,比如英文中26个字母再加上各种符号,这些作为初始词表。之后逐步合并当前vocab中的子词。假设句子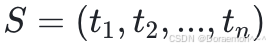 由n个子词组成,且假设各个子词的出现是独立的 (当然这个假设和实际不符,是提高提高计算效率而作出的简化),那么句子S的对数似然概率可以表示为:
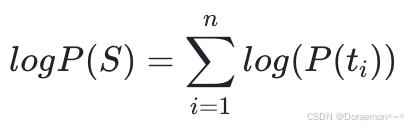
如果我们将相邻的两个子词 和
 相合并,合并后产生的子词为
 ,那么此时句子S对数似然概率的变化为:
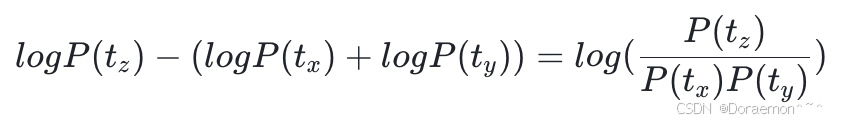
WordPiece取增益最大的子词进行合并,即将添加到vocab中。如果合并之后,在训练语料中不在出现或了,则将其从vocab中删除。算法不断地选择增益最大的相邻子词对进行合并,直到vocab的大小达到预期为止。
3.预训练任务
BERT最大的贡献就是证明了通过预训练,可以学习出"普适"的语义特征,因此对于各种特定的下游任务,只需要进行简单微调就能得到理想的效果。预训练任务的设计需要同时满足以下要求:
-
训练数据和训练标注容易获得。
-
训练任务依赖语义特征的学习。
BERT设计了两种预训练任务,即Masked Language Model (MLM) 和 Next Sentence Prediction (NSP),分别用于学习token级和句子级的语义。
3.1.MLM Task
很多语言模型都是单向的,Left-to-Right占多数 (Left-to-Right和Autoregressive是一个意思,都是用过去预测未来)。在Left-to-Right LM中,每个token都只能"看到"它之前位置的tokens,Left-to-Right LM的损失函数为:
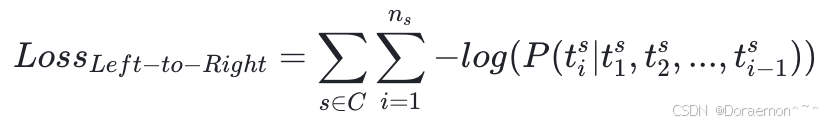
直觉上来说,单向语言模型的建模能力应该不如双向的,因此BERT希望采用双向的语言模型任务,即基于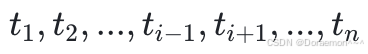 来预测
 。但由于双向上下文建模,每个token实际上都能"看到"的信息,这样就会出现"自己预测自己"的问题。
BERT随机选取一些token (15%的比例) 作为预测目标。为了避免"自己预测自己"的问题,目标token所在的位置会被替换为"MASK"。"MASK"会代替原token与句子里的其他token进行交互 (self-attention的过程),在经过FFN的变换,最后计算得到最后一个隐藏层的特征表示,这个特征表示再用于预测当前位置的token。
MLM任务的损失函数为:
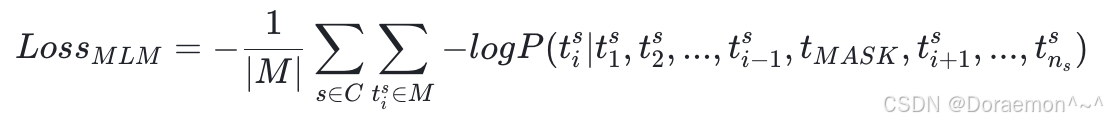
在实际训练中,BERT随机选择15%的token进行预测。在这15%的token中,又随机选择其中的10%随机替换为其他token,10%保持不变,80%替换为"MASK"。据说这样做是为了减少预训练和微调时模型输入的不一致性 (微调时模型输入的都是正常句子),但也有研究结果显示这样做和直接替换为"MASK"区别不大。
token预测被建模为一个多分类任务,类别数等于vocab的长度,输出层的每个节点代表一个特定的token,输出层激活函数为Softmax,损失函数为交叉熵。
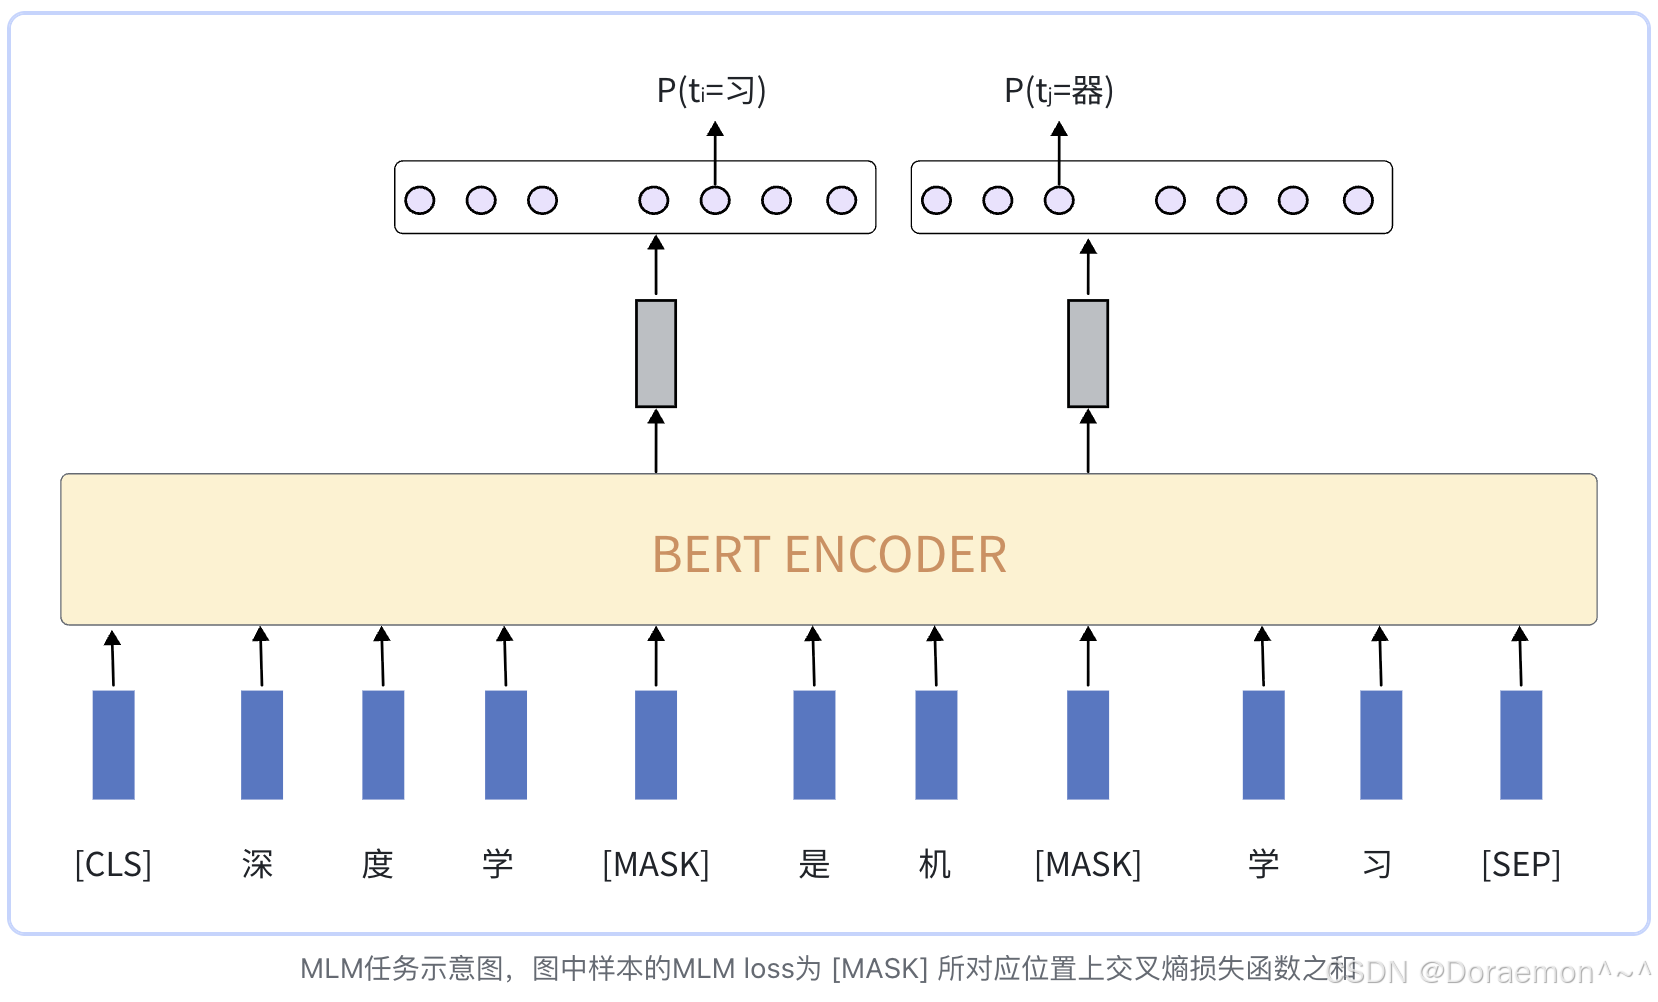
输出层 和输入层的参数共享
MLM 任务在预测token时,输出层节点数与输入层Token Embedding的数量是相同的,Bert对其进行了参数共享。输出层的每个节点对应于一个token,与其连接的权重与该token的embedding vector参数是共享的,不过Embedding层的参数会乘以一个大小为 的缩放系数,使得Token Embedding相对于Segment Embedding和Positional Embedding在幅度上占据优势。
标签平滑
MLM任务的损失函数是交叉熵。交叉熵损失函数度量了分类任务的目标分布与模型预测的类别分布之间的差距。目标分布一般是一个one-hot vector,此时交叉熵等同于负对数似然概率函数。
在预测token时,目标类别是基于训练样本中的实际文本来设置的。我们来比较下边两个句子:
句子1:  这  朵  花  是  红  的  。
句子2:  这  朵  花  是  黄  的  。
如果我们将句子进行随机MASK,输入到模型的token序列为:
这 朵 花 是 MASK 的 。
那么,对于句子1,预测目标是"红",而"黄"所对应的概率输出目标为0;对于句子1,预测目标是"黄",那么"黄"所对应的概率输出目标为1。这种情况对于参数优化是不好的,因为预测值无论靠近哪一边,都会引起另外一边非常大的损失值 (对数函数的输入接近0时,输出接近负无穷)。
标签平滑的方法非常简单:将目标token的概率 (1.0)中分出一小部分概率,并将其平均分到每一个预测token上。
例如,假如类别数为5(当然实际不可能这么小),目标类别在向量中的序号为2,那么原本的目标分布为:(0.0, 0.0, 1.0, 0.0, 0.0)。标签平滑从1.0分出一小部分概率(例如0.1),将其均分到每一个类别上,那么目标分布将变为 (0.02, 0.02, 0.92, 0.02, 0.02)。如果模型预测的概率分布为 (0.05, 0.1, 0.75, 0.05, 0.05),那么损失函数计算为:
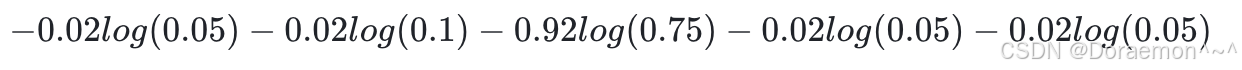
当预测目标不唯一 (或带有噪音)的情况下,标签平滑能够提高模型训练的效果。
3.2.NSP Task
NSP (Next Sentence Prediction) 将一对句子作为输入,预测这两个句子是否为文本中连续的两个句子,是一个二分类任务(若两个句子是文本中连续出现的,则NSP标签是1;若两个句子不是文本中连续出现的,则NSP标签是0)。由于在实际文本中衔接的两个句子,在语义上具有相关性,因此NSP任务主要是为了学习句子级的语义特征。
MLM和NSP任务的损失函数加在一起,就是BERT预训练的总损失函数。输入的文本为经过MASK的两个句子,MASK的比例为15%,NSP任务的正负样本比例为1:1。
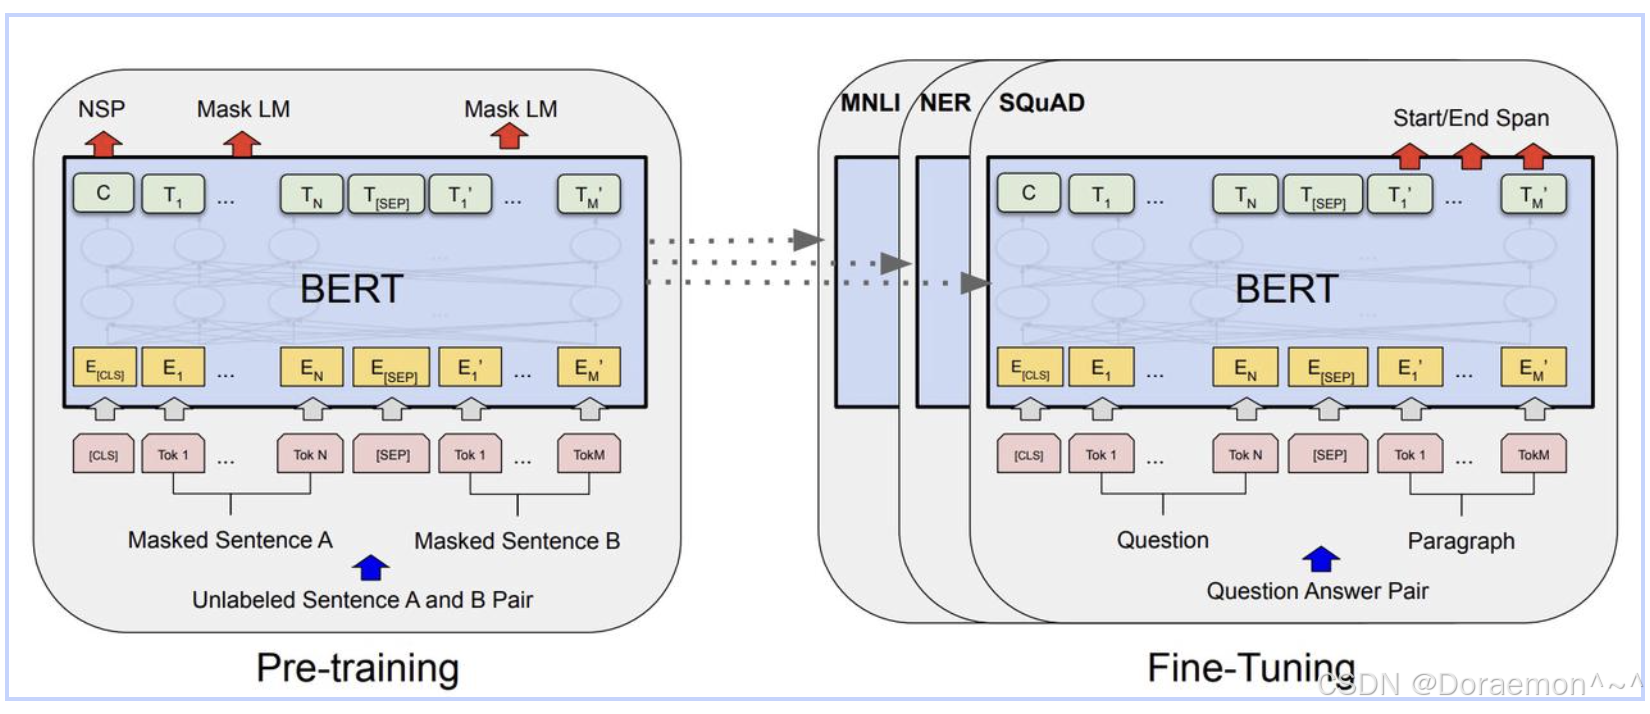
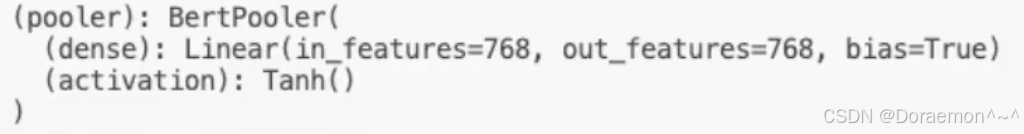
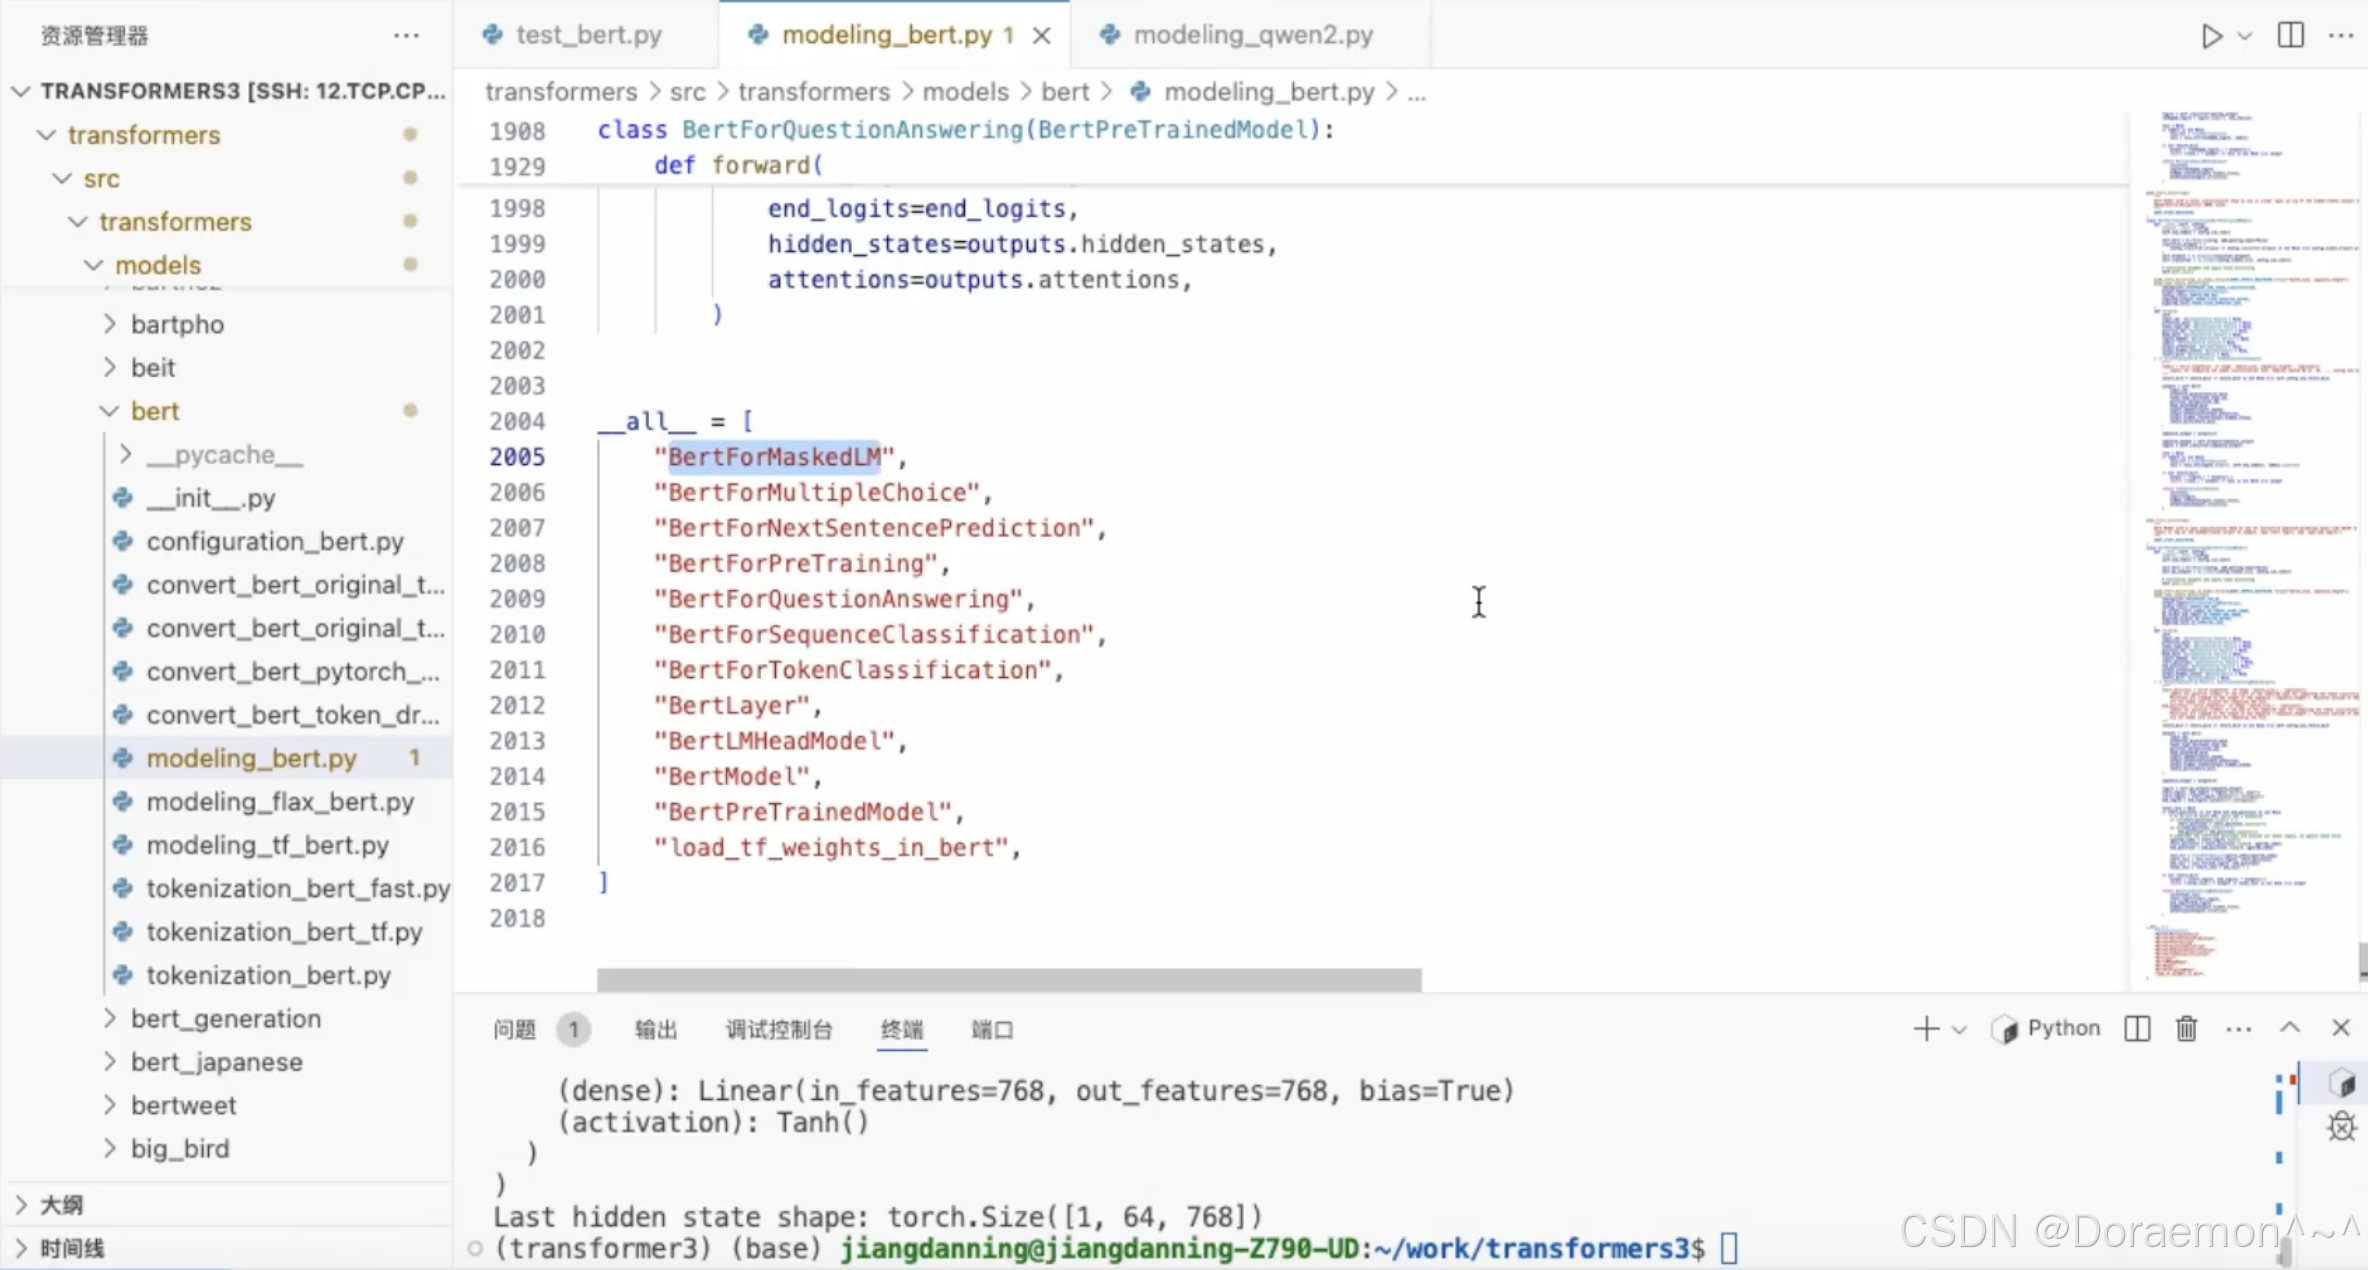
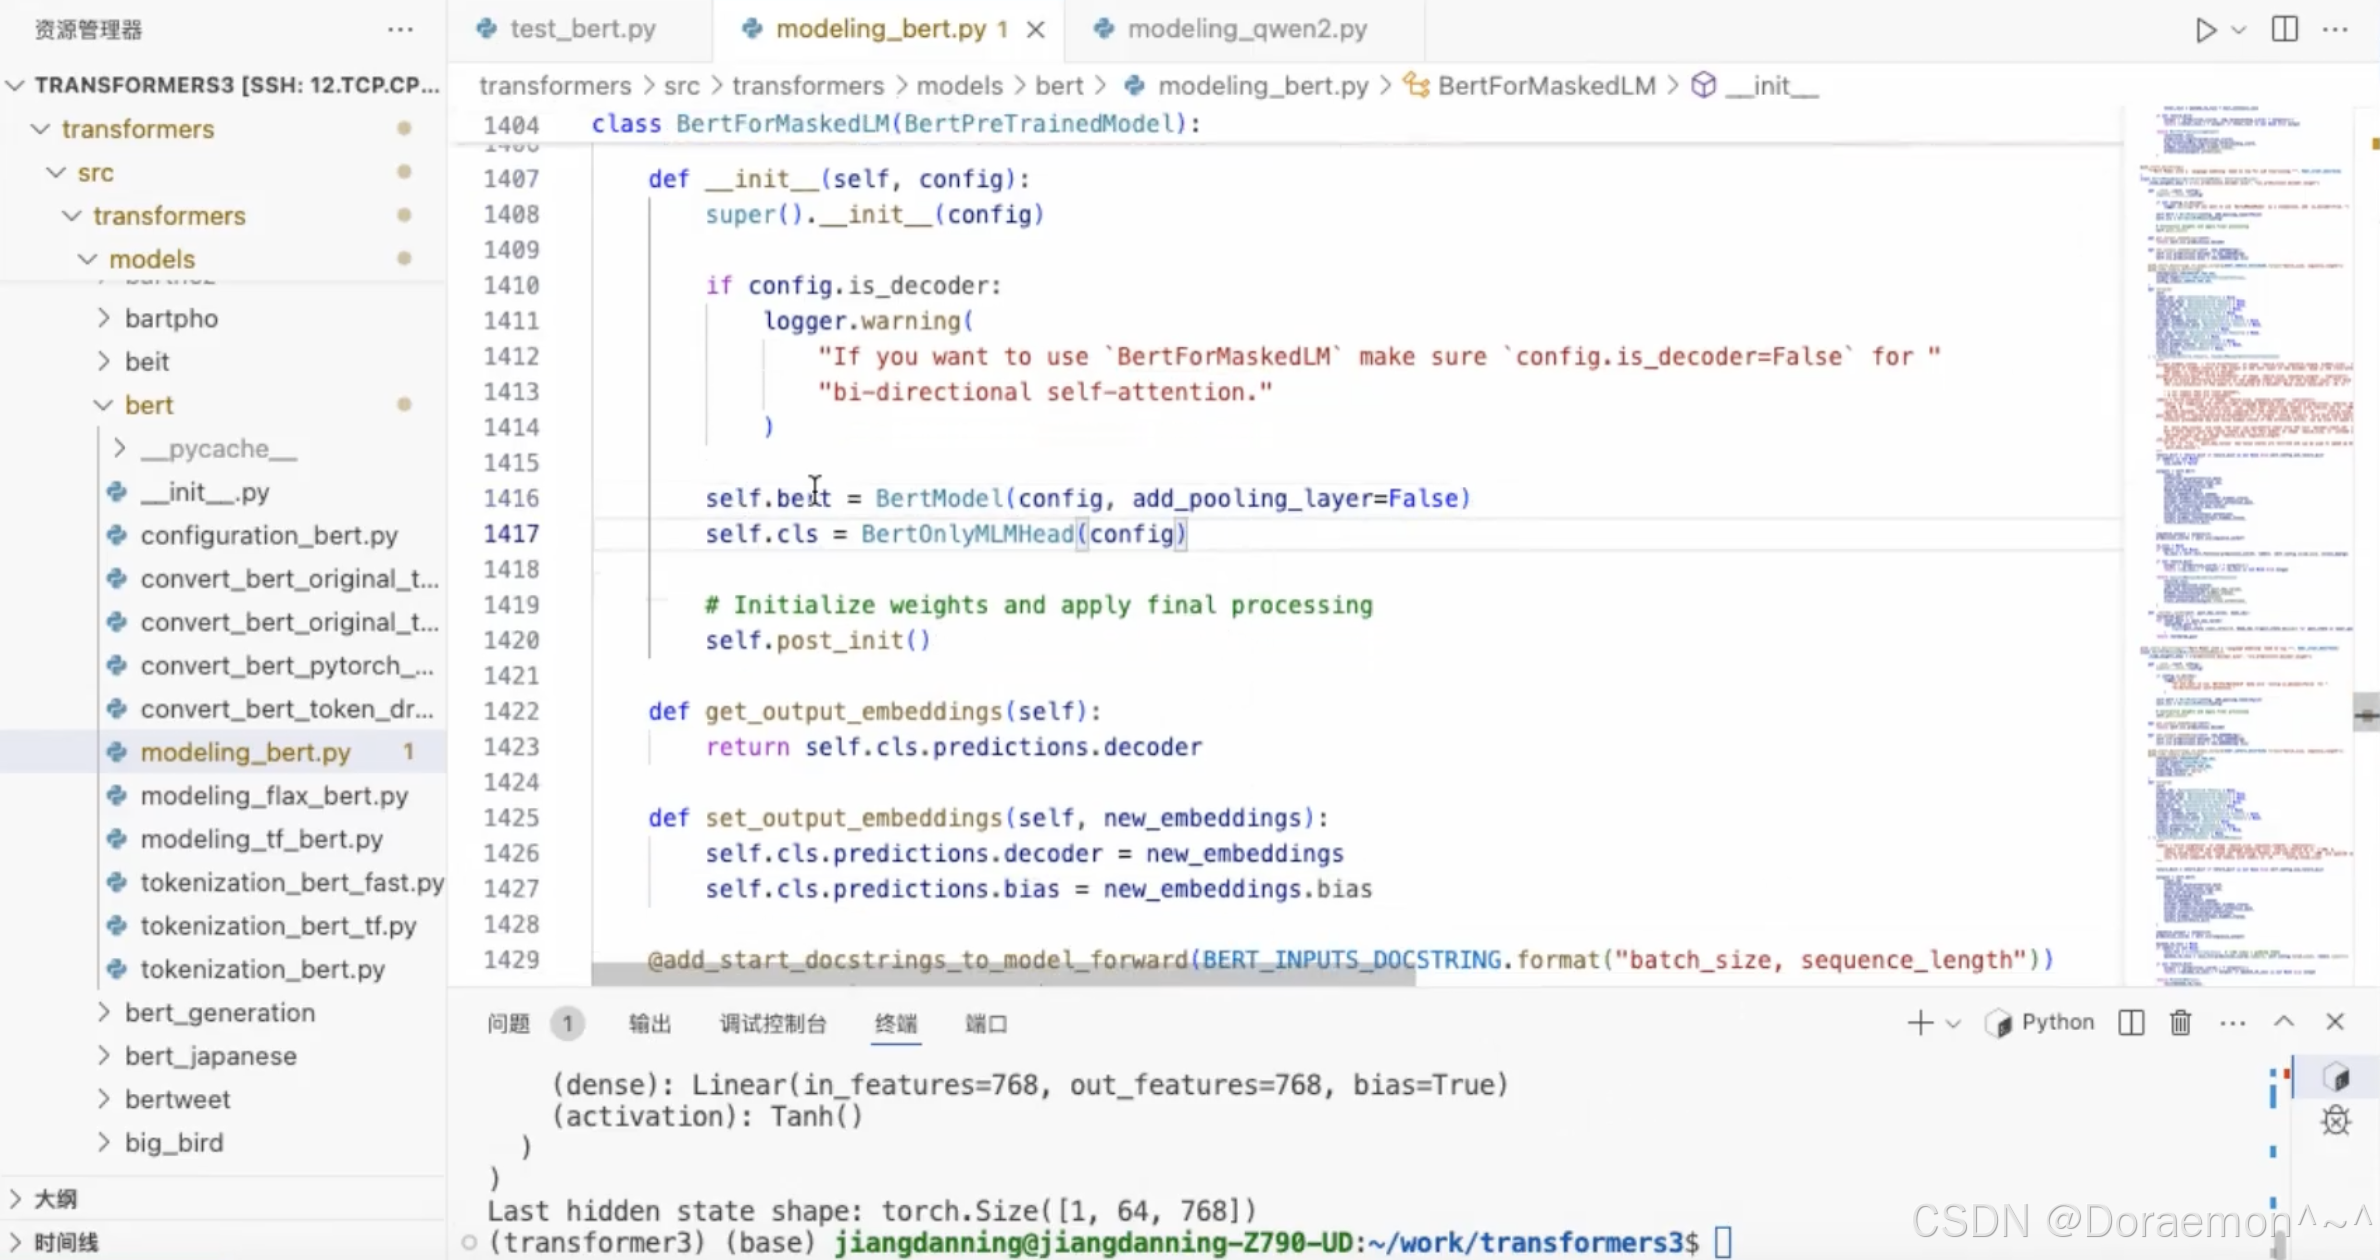
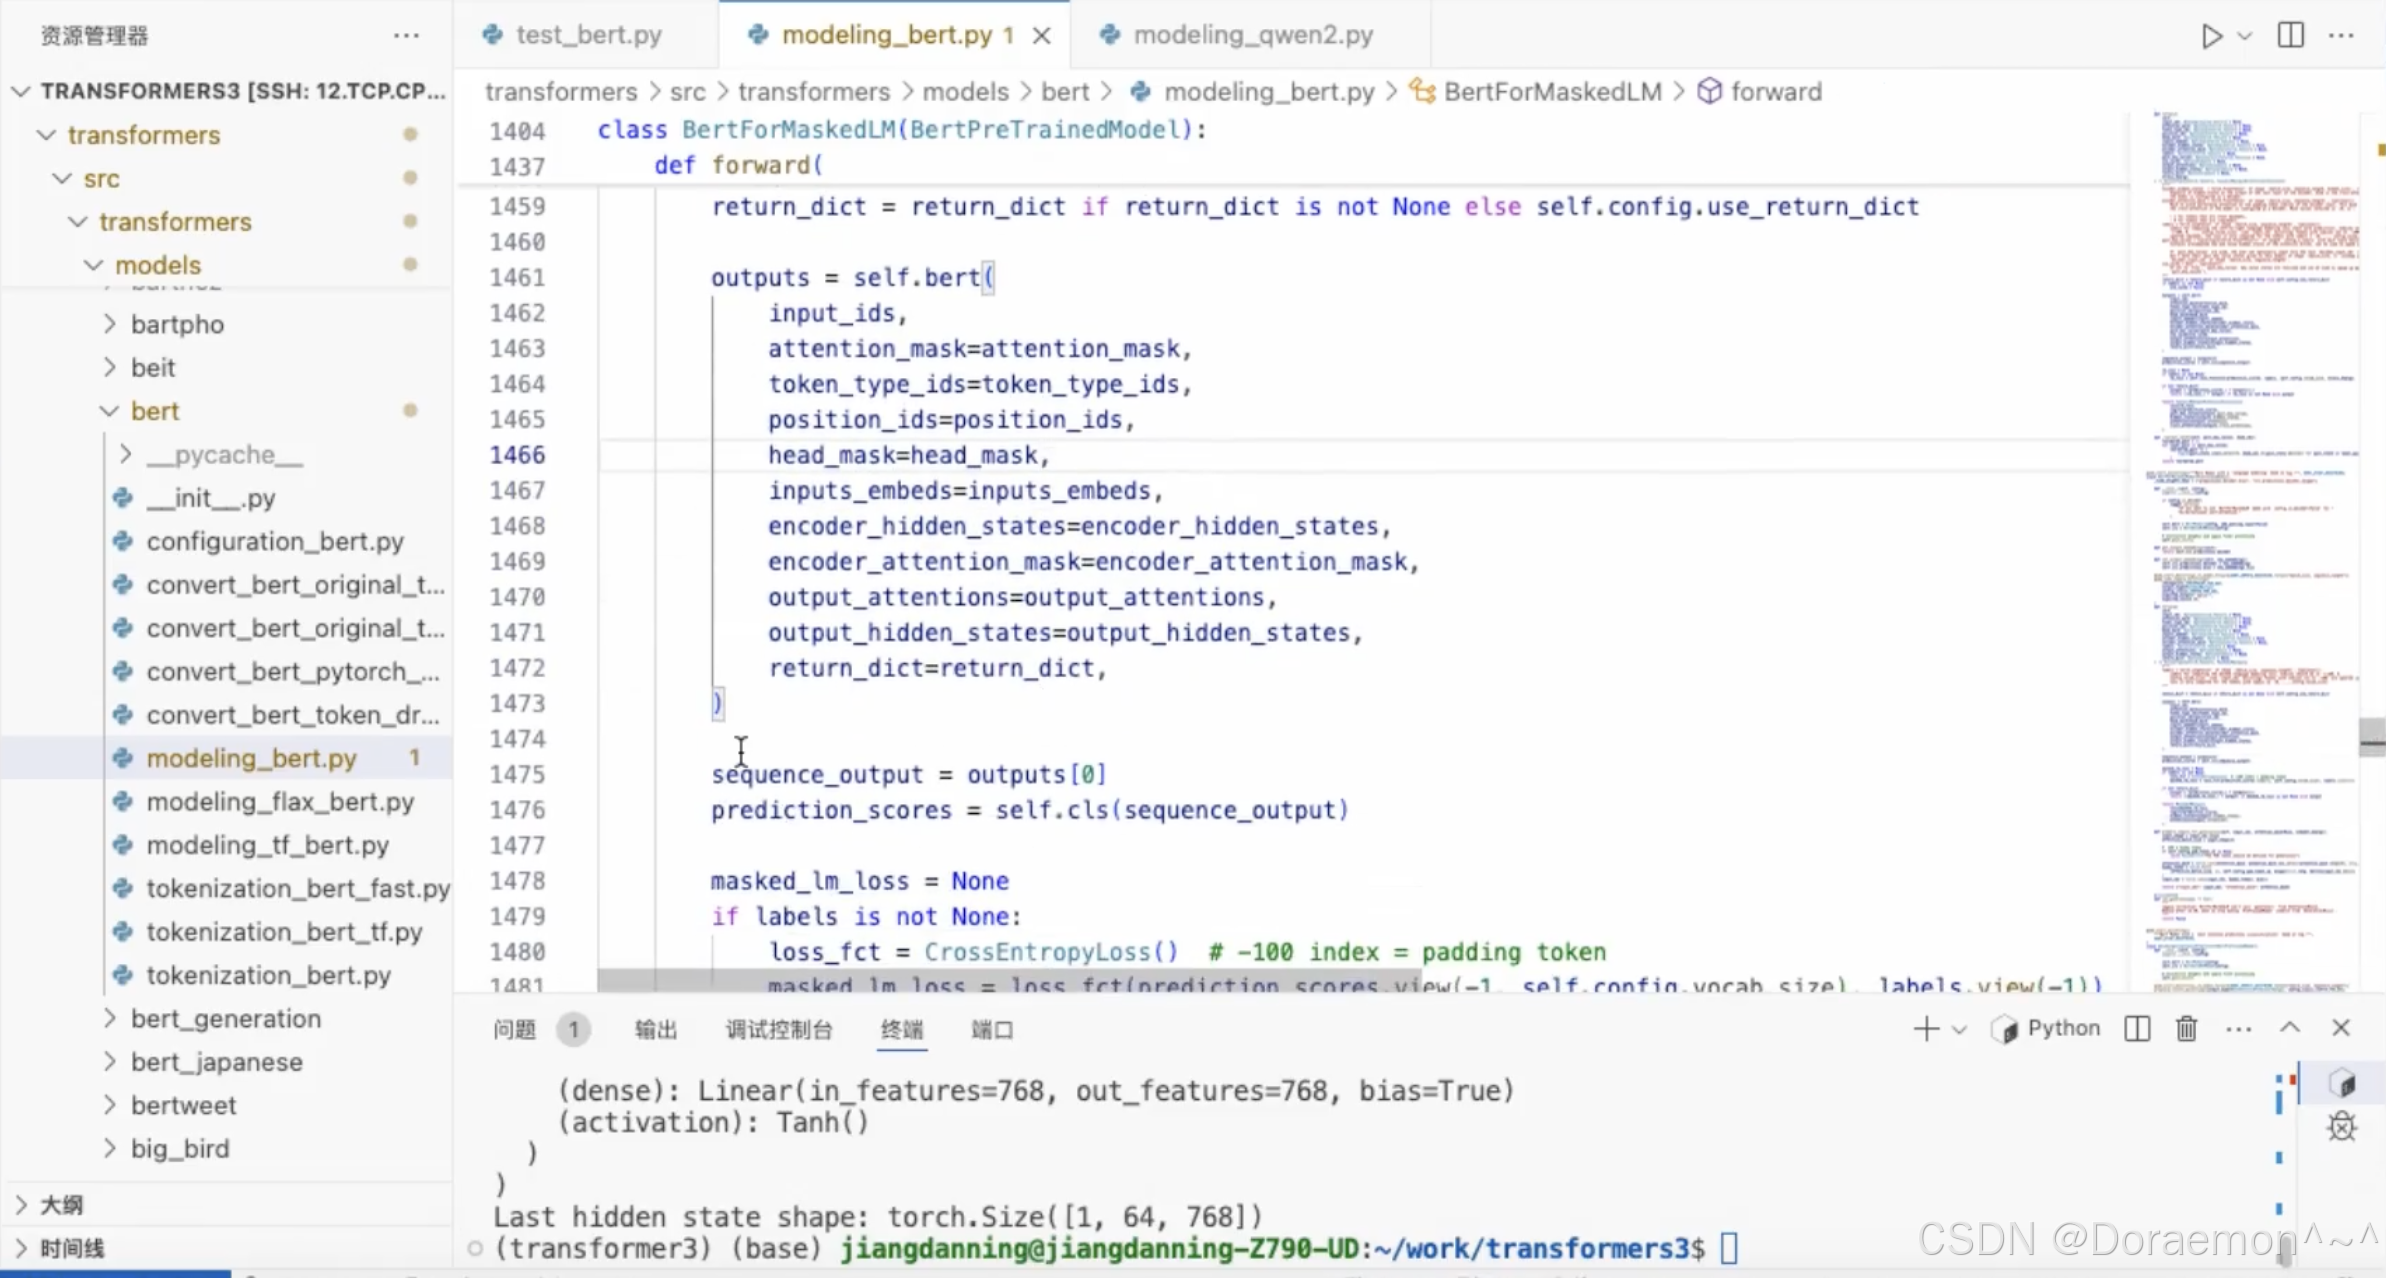
BertPooler 的输出,就是 BERT 做 NSP(Next Sentence Prediction,下一句预测)任务分类头的输入。
3.3.动态学习率
学习率是深度学习训练超参数,需要预先指定。动态学习率是指训练过程中的学习率不是固定不变的,而是随着training steps (迭代步数) 的增加进行调整。一般地,在训练初期需要较大的学习率加速收敛,而在训练后期需要较小的学习率来避免在极小点附近震荡。因此我们需要设置一个初始学习率,然后在训练过程中逐步衰减这个学习率。
常用的学习率衰减策略有以下几种:
1、基于步长的衰减 (StepLR):每隔一定的迭代步数,将学习率乘以一个衰减系数 (gamma),例如:
python
import torch
import torch.optim as optim

# 定义优化器
optimizer = optim.Adam(model.parameters(), lr=0.01)

# 定义学习率调度器
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=100, gamma=0.5)

# 训练过程
for epoch in range(epochs):
    for batch_x, batch_y in dataloader:
        optimizer.zero_grad()
        train(...)
        optimizer.step()
        scheduler.step()  # 动态调整学习率, shceduler内部的step计数器+1,
                          # 根据新的step为optimizer设置学习率
思考:如果要按epoch数调整学习率该如何设置?
2、线性衰减 (Linear Decay)
学习率从初始值initial_lr线性降低到一个较小的终值end_lr(甚至接近0),第t个step的学习率计算公式如下:
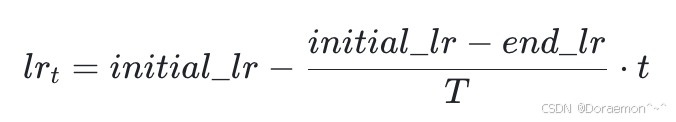
其中T为总的迭代步数。
python
import torch.optim as optim
from torch.optim.lr_scheduler import LambdaLR

optimizer = optim.Adam(model.parameters(), lr=0.001)

# 定义线性衰减函数
def linear_decay(t, total_steps, initial_lr, end_lr=1e-5):
    return (1 - t / total_steps) * initial_lr + (t / total_steps) * end_lr

scheduler = LambdaLR(
    optimizer,
    lr_lambda=lambda t: linear_decay(t, total_steps=1000, initial_lr=0.001, end_lr=1e-5)
)

# 每个batch后调用 scheduler.step()
3、余弦退火 (Cosine Annealing)
学习率按余弦函数周期性调整,公式:
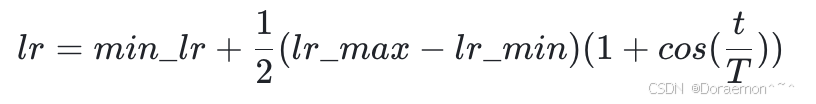
其中T为周期长度,t为当前步数。由于余弦函数的周期性,如果t超出了T,学习率会被重置到初始学习率的水平。
可以直接使用torch.nn.lr_scheduler.CosineAnnealingLR
python
scheduler = CosineAnnealingLR(optimizer, T_max=50, eta_min=1e-6)学习率 的预热 (Warm-Up)
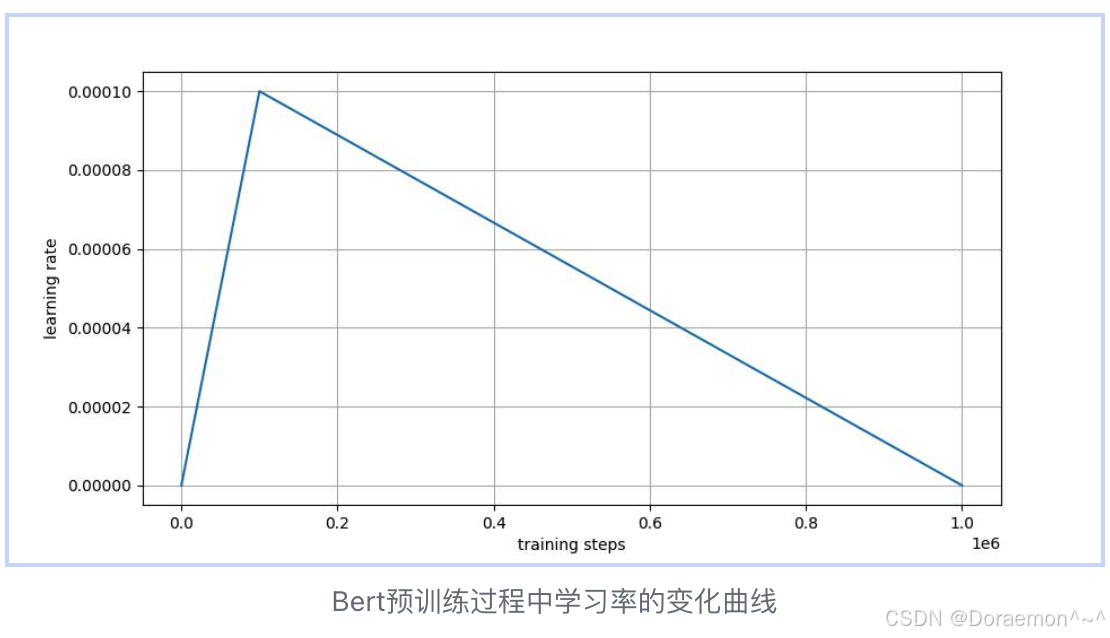
不过,当模型参数是随机初始化时,在训练开始时就使用较大的学习率,可能会导致训练的不稳定。在预训练模型的训练过程中,研发人员发现在训练开始时使用较小的学习率,随着训练的进行,学习率逐渐增加到预设的初始学习率,然后再按照学习率衰减的策略进行调整。
BERT的预训练过程使用了线性Warmup,即学习率从0线性增加到预设的学习率 (细节在原论文附录A.2中)。在前10%的训练steps中,学习率从0按迭代步数线性增加到预设的学习率;之后再线性逐渐衰减到0。这个过程中的学习率变化曲线如下图所示。
4.各种类Bert模型
除了google发布的Bert系列模型之外,还有很多Transformer Encoder-Only架构的预训练模型,它们也被统称为"类Bert模型"。这些模型的架构相似,都用Transformer Encoder来计算特征,用CLS位置上的特征来表征整个文本。但各个公司(组织)预训练的数据和预训练任务不同,在网络结构上也会存在微小的不同。
1、RoBERTa (A Robustly Optimized BERT Pretraining Approach, paper: https://arxiv.org/pdf/1907.11692),是由FaceBook发布的一种类BERT模型,主要优化有:
- 使用了更大的训练数据集 (Wikipedia, Common Crawl, OpenWebText, BooksCorpus等),总数据量达到了160GB,远大于BERT的训练数据量 (16GB)。
- 采用了动态掩码策略,每次训练时随机选择掩码单词。增加了训练任务的多样性。
- 去掉了NSP这个预训练任务,RoBERTa的实验表明NSP任务没有太大用处。
- 更大的微批大小 (2K ~ 8K),而Bert预训练的微批大小为256。这相当于提高了模型训练的数据吞吐量,对提高模型效果有明显影响。
- RoBERTa-wwm (whole word masking)是一种RoBERTa的改进模型,掩码是针对词的,即一次可能会mask多个token。这种训练方式能够促使模型更好地学习上下文特征。
2、DistillBERT (paper: https://arxiv.org/pdf/1910.01108) 是一种通过知识蒸馏技术从原始BERT模型中提取知识的方法,旨在创建一个更小、更快的模型,同时保留原BERT模型的大部分效果方面的性能。DistillBERT蒸馏算法的要点:
-
层数减半与初始化:DistillBERT将BERT的层数减半,并从教师模型的层中初始化学生模型层的参数。
-
蒸馏函数的设计:包括交叉熵损失和向量相似度损失。交叉熵损失用于衡量教师模型和学生模型输出概率分布之间的差异,而向量相似度损失则用于对齐两个模型输出的隐藏向量。
DistillBERT适合在资源有限的设备上运行,例如普通的笔记本电脑或手机。但似乎没有官方的DistillBERT中文模型。
3、BGE系列:专注于Sentence Embedding的预训练模型,是由智源研究院开源的系列模型 (Github project: https://github.com/FlagOpen/FlagEmbedding)。
此外还有在通用预训练模型的基础上,进一步用垂直领域数据(例如:金融,医疗,中医等等)训练的垂域大模型,在此就不列举了。
5.下游任务
BERT的贡献在于证明了预训练+微调的学习范式的先进性。业务中的算法工程师一般不会从头进行预训练,而是直接利用预训练模型。预训练模型的权重文件编码了语义特征,因此,使用预训练模型初始化参数,能够极大减小下游任务所需要的训练数据量,加快收敛速度。
接下来我们来学习如何基于BERT预训练模型完成下游任务。BERT的下游任务大多是各种分类任务,包括序列分类和序列标注任务。
5.1.文本分类
模型的输入是一段文本 (一个"句子"),输出为一个类别标签。使用CLS位置上的输出 (最后一层隐藏层的输出)作为分类特征。常见的文本分类任务有:
- 意图识别:在对话系统中,将用户可能的输入预先划分为有限个"意图",每个意图就是一个类别。在服务过程中,识别出用户的意图之后,就会将对用户输入的处理流程分发到对应的模块中。
- 情感分析 (Sentiment Analysis):识别用户评论的情感"极性",如正向、负向和中性等,这些标签可以作为后续商品推荐的特征(以及理由)、业务分析、风险管理以及舆情监控的数据。
- 新闻分类:将新闻根据领域打上类别标签,作为内容推荐的特征等等。
- 企业内部的文档分类:根据产品线、业务线、流程等标签进行分类,作为文档管理、搜索等应用的特征。
5.2.文本关系分类
文本关系分类任务的输入是一对文本(即两个"句子"),通常是二分类任务。这一对"句子"在不同的应用里会有不同的定义。
- 搜索:第一个"句子"是用户query (或问题),第二个"句子"是候选文档(或文段)。如果两者是相关的,则标签为1,否则标签为0。
- FAQ:两个"句子"均为question,判断它们是否是同一个问题,如果是同一个问题,则可以调取预先写好的回答。
- 语义相似度:判断两段文本的语义是否相同或相似 (具体定义取决于应用场景),可以用于语义去重。
文本关系分类有两种方式:
- 将每个文本分别编码,即将它们分别输入BERT (每次输入一个文本),分别取CLS位置的输出作为它们的特征表示 (表征),再通过计算这两个向量之间的余弦相似度判断它们的语义关系。
- 同时将一对文本输入BERT,格式为 CLS sentence1 SEP sentence2 SEP,取CLS位置的输出作为文本关系分类的特征。
5.3.序列标注
文本中的每个token分别进行分类,MLM、NER (命名实体识别) 都是序列标注任务。分类特征就是对应token位置上的输出,输出层参数一般在各个位置之间是共享的。
5.4.多任务学习
我们已经知道,神经网络的隐藏层是特征学习器。在隐藏层(编码器)学习好特征之后,只需要一个简单的输出层就能很好地完成学习任务。
很多不同的自然语言处理任务,它们都会依赖语义特征。因此在同一套编码器之上,可以同时连接多个任务的输出层,而隐藏层(编码器)的参数是共享的。多个任务的损失函数也会加到总损失中 (total_loss),通过调用total_loss.backward()计算所有参数的梯度,进行参数更新。
预训练通常都是多任务学习,例如BERT就同时对MLM和NSP两个任务进行学习,ERNIE的预训练任务更是多达几十种。在下游任务中,意图识别和填槽 (抽象为序列标注任务)也是很典型的多任务学习。