Java 模板导出 PDF 实战全攻略:从选型到落地,生产环境踩过的坑都在这了
电子合同、财务对账单、发票凭证......几乎每个企业级项目都绕不开 PDF 导出。但真正上手做,中文字体乱码、表格分页断裂、大文件 OOM、授权协议踩雷,一个比一个酸爽。这篇把方案选型、核心代码、生产踩坑、性能调优一次讲透,所有代码都经过线上验证,拿走就能用。
一、动手之前:先花 30 秒把边界问清楚
实际开发中我们经常会遇到这样的情况:业务方一句"给我加个 PDF 导出",你吭哧吭哧写完,对方来一句"我要的是带骑缝章的合同,还得能批量导十万条"。返工返到怀疑人生。
所以接到需求别急着写代码,先问清楚这几件事------每一条都直接决定架构走向:
| 要确认的问题 | 为什么要问 | 典型结论 |
|---|---|---|
| 同步导出还是异步? | 决定要不要任务中心、要不要 OSS | 大文件必须异步 |
| 页数 / 数据量级? | 10 页和 10 万行,架构完全不同 | 大批量要分片渲染 + 合并 |
| 模板谁来改?改完要不要重启? | 决定模板要不要在线托管 + 版本化 | 运营自助改 → 存 DB/OSS |
| 要页眉页脚、页码、水印、签章吗? | 决定渲染引擎能力要求 | @page + running element |
| 中文 / 生僻字多不多? | 字体是 90% 的坑源 | 思源 / Noto 内嵌 + 子集化 |
| 有合规归档要求吗? | PDF/A、只读、防篡改 | 加密 + 权限控制 |
一句话定调整套方案:模板引擎产出 HTML → HTML 渲染成 PDF → 落对象存储 → 异步任务交付 。真正难的不是"生成",而是字体、分页、体积、性能、幂等、安全这六件事。
二、选型:没有银弹,只有匹配
PDF 导出的方案一抓一大把,选错路线事倍功半。我把主流方案都趟过一遍,直接给结论:
| 方案 | 模板形态 | 样式还原度 | 部署负担 | 授权风险 | 适合场景 |
|---|---|---|---|---|---|
| HTML 模板渲染 ⭐ | HTML + CSS(FreeMarker / Thymeleaf + openhtmltopdf / Flying Saucer) | 中~高(看引擎) | 低(纯 JVM) | 无 | 对账单、合同、报告,版式常改 |
| PDF 表单填充 | AcroForm 设计稿(iText / OpenPDF / PDFBox) | 高(原稿保真) | 低 | 看库 | 版式固定的证书、票据、发票 |
| Word 模板转 PDF | .docx(poi-tl / docx4j + LibreOffice) | 依赖 Word 排版 | 高(要挂转换进程) | 低 | 业务人员坚持用 Word 维护 |
| 报表引擎 | JRXML 设计器(JasperReports) | 高 | 中 | 低 | 专业级超复杂统计报表 |
| 无头浏览器 | 完整 HTML 页面(Playwright / Chrome Headless) | 极高 | 高 | 低 | 要还原运营活动页那种现代页面 |
| iText 7 / PDFBox 手绘 | 纯代码 | 极高 | 低 | iText 注意 AGPL | 精细控制 PDF 底层、后处理 |
我的选型决策树长这样:
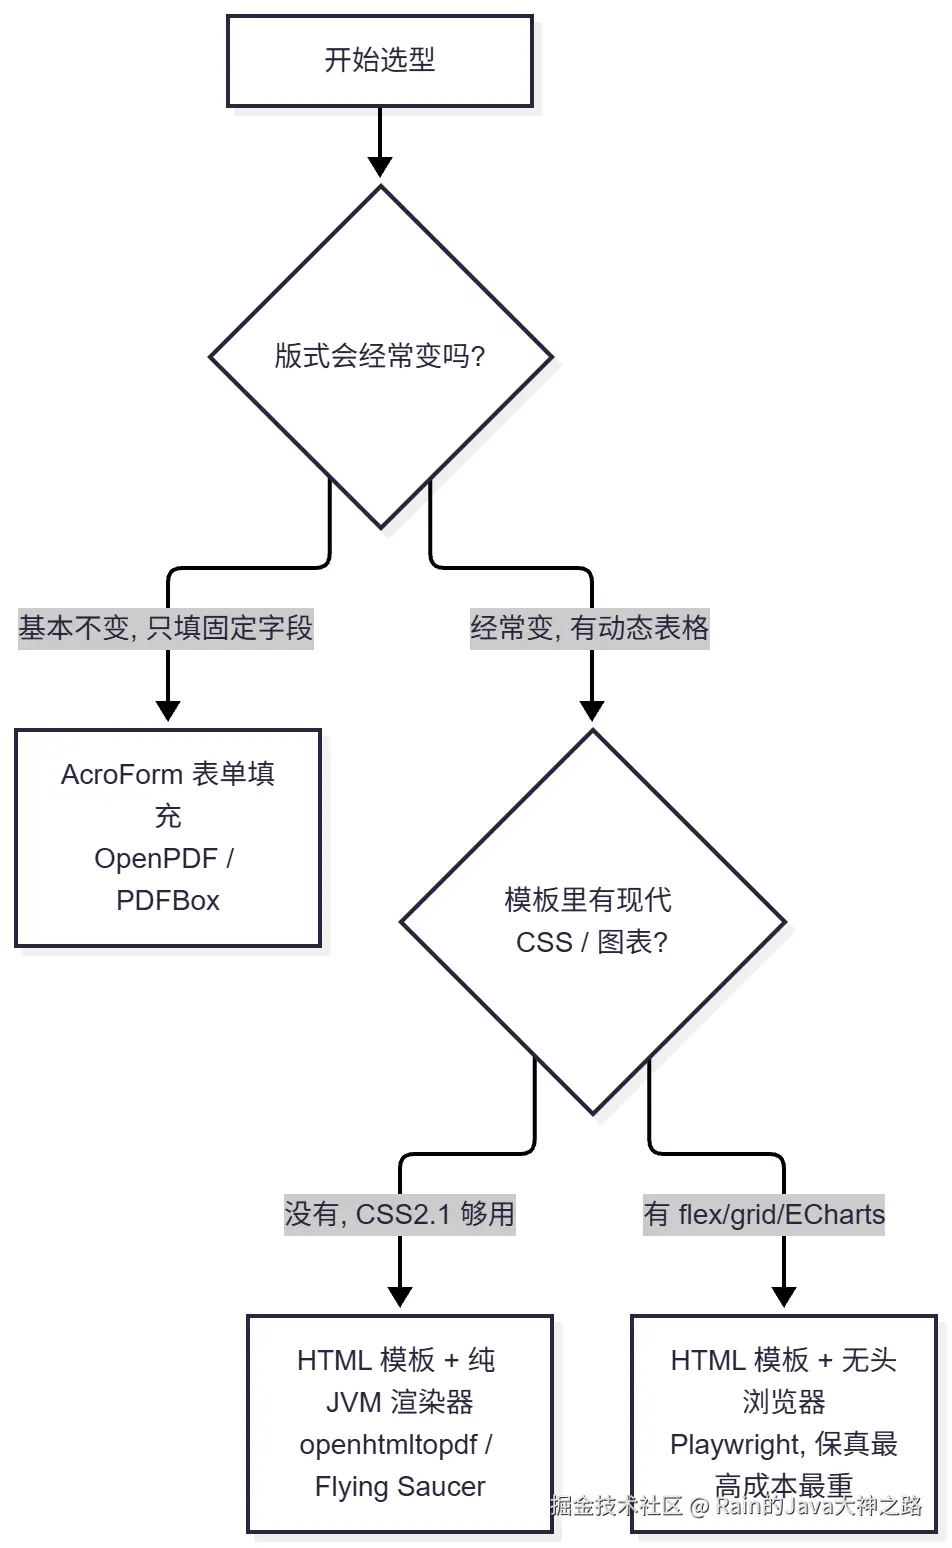
选型的原则不是找最强的库,而是找和页面复杂度匹配的引擎。 拿轻引擎硬套复杂页面,排查成本比一开始就上重引擎更高。我线上主力是
FreeMarker/Thymeleaf + openhtmltopdf(纯 JVM、Apache 2.0、无外部进程),发票凭证这类格式固定、QPS 高的场景走OpenPDF + AcroForm兜底,只有"要还原活动页"才切 Playwright。
许可证这个雷必须先排掉,很多团队都在这里翻过车:
- iText 5+ 是 AGPL/商业双授权,闭源商用要买授权,法务评估很麻烦;
- openhtmltopdf 底层是 PDFBox,Apache 2.0,可以放心商用;
- OpenPDF 是 iText 4 的 LGPL/MPL 分叉,商用基本无忧;Flying Saucer 是 LGPL;
- wkhtmltopdf 已于 2023 年归档停更 ,而且它是外部二进制,fork 子进程高并发会留僵尸进程、
/tmp堆积,别再新引入; - 中文字体选 Noto Sans CJK / 思源黑体(Apache 2.0 / OFL),别用带版权的宋体。
最终我落地的技术栈:Spring Boot + FreeMarker(或 Thymeleaf)+ openhtmltopdf(PDFBox),三条理由:
- 可预览:渲染出的 HTML 直接丢浏览器就能看出 80% 版式,不用每次生成 PDF 再开阅读器------这一步能省掉 80% 的反复调试时间;
- 可协作:模板就是普通 HTML,前端/业务能自己调样式,后端只管数据模型,改样式不发版;
- 部署轻:纯 Java 一个 jar,不装 Office、不装二进制、不起子进程,容器化最省心。
三、整体架构:核心就六个字------模板、数据、渲染,三者解耦
不管选哪条路线,核心设计思想只有一句话:模板与数据完全解耦。
- 模板归模板:HTML 写,外置成文件(甚至存 DB),改样式不用改 Java、不用发版;
- 数据归数据 :Java 只做一件事------把业务数据组装成
Map/ DTO,绝不在代码里画坐标; - 渲染归渲染:模板引擎渲染出 HTML,再交给 PDF 渲染引擎转成字节流。
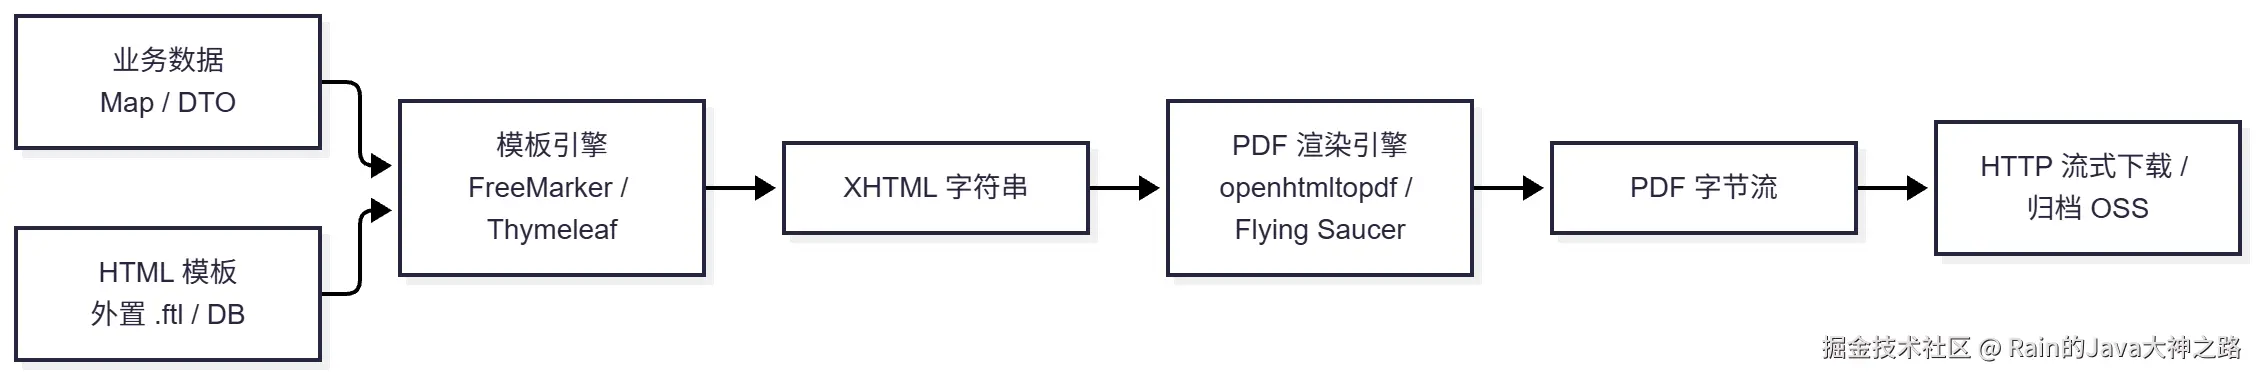
工程上再往上套一层分层结构,保证可维护性:
- 接入层
ExportController:限流、鉴权、幂等 Key、参数校验; - 编排层
ExportTaskService:任务状态机INIT → RENDERING → UPLOAD → DONE; - 数据层
DataAssembler:领域对象 → 模板 DTO、数据快照、脱敏; - 模板层 模板引擎 + 模板仓储(Git/DB 版本化);
- 渲染层 openhtmltopdf / Flying Saucer;
- 存储层 OSS/S3 + 预签名 URL + 生命周期清理。
关键设计点:HTML 渲染和 PDF 生成全程内存流式处理,不落盘,零临时文件残留 ;模板文件放 resources/templates/ 下;字体文件打进 jar 包,彻底屏蔽服务器环境差异。
四、核心代码:四个模块,逐段讲透
4.1 Maven 依赖
xml
<!-- 模板引擎,FreeMarker / Thymeleaf 二选一 -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-freemarker</artifactId>
</dependency>

<!-- openhtmltopdf:基于 PDFBox,Apache 2.0 -->
<dependency>
    <groupId>com.openhtmltopdf</groupId>
    <artifactId>openhtmltopdf-core</artifactId>
    <version>1.0.10</version>
</dependency>
<dependency>
    <groupId>com.openhtmltopdf</groupId>
    <artifactId>openhtmltopdf-pdfbox</artifactId>
    <version>1.0.10</version>
</dependency>

<!-- 老项目也可以走 Flying Saucer 路线 -->
<dependency>
    <groupId>org.xhtmlrenderer</groupId>
    <artifactId>flying-saucer-pdf-openpdf</artifactId>
    <version>9.1.22</version>
</dependency>
<dependency>
    <groupId>com.github.librepdf</groupId>
    <artifactId>openpdf</artifactId>
    <version>1.3.30</version>
</dependency>
4.2 字体注册:最容易踩的坑在 Fat Jar
⚠️ 坑点预警 :Fat Jar 里
ResourceUtils.getFile("classpath:/fonts/x.ttf")会直接抛FileNotFoundException,因为资源在 jar 包内不是真实文件。所以启动时把它复制到临时目录,拿到真实绝对路径再注册。
java
@Slf4j
public final class FontRegistry {

    private static final String CLASSPATH_FONT = "/fonts/NotoSansCJKsc-Regular.otf";
    private static final String FAMILY = "Noto Sans CJK SC";
    private static volatile File fontFile;

    /** 应用启动时调用一次即可;字体解析开销大,绝不能放在每次请求里 */
    public static synchronized void init() {
        if (fontFile != null) return;
        try (InputStream in = FontRegistry.class.getResourceAsStream(CLASSPATH_FONT)) {
            if (in == null) throw new IllegalStateException("字体资源不存在: " + CLASSPATH_FONT);
            File tmp = File.createTempFile("pdf-font-", ".otf");
            tmp.deleteOnExit();
            Files.copy(in, tmp.toPath(), StandardCopyOption.REPLACE_EXISTING);
            fontFile = tmp;
            log.info("PDF 字体就绪: {} -> {}", CLASSPATH_FONT, tmp.getAbsolutePath());
        } catch (IOException e) {
            throw new IllegalStateException("字体初始化失败,中文将渲染为方块", e);
        }
    }

    public static File file()    { return fontFile; }
    public static String family() { return FAMILY; }
}
openhtmltopdf 也支持直接从流注册(不落盘):
java
builder.useFont(() -> getClass().getResourceAsStream("/fonts/SourceHanSansCN-Regular.ttf"), "SourceHanSans");字体文件放进 src/main/resources/fonts/,不管部署到 Windows 还是 Linux,字体永远跟着 jar 包走,零环境依赖。 本机正常、Docker 里全方块的灵异问题,根因就是镜像里没装 fontconfig 和中文字体------要么字体打进 jar,要么 Dockerfile 里 apt install fonts-noto-cjk。
4.3 导出服务:渲染主逻辑
java
@Slf4j
@Service
@RequiredArgsConstructor
public class PdfExportService {

    /** Freemarker Configuration 线程安全且内部已缓存编译后的 Template,必须单例 */
    private final freemarker.template.Configuration freemarkerCfg;

    /** 🛡️ 模板名白名单:防路径穿越(../../etc/passwd.ftl 之类) */
    private static final Set<String> ALLOWED_TEMPLATES =
            Set.of("statement.ftl", "contract.ftl", "monthly_report.ftl");

    public byte[] export(String tplName, Map<String, Object> model) {
        if (!ALLOWED_TEMPLATES.contains(tplName)) {
            throw new IllegalArgumentException("非法模板名: " + tplName);
        }
        String xhtml = renderTemplate(tplName, model);   // ① 模板 → XHTML
        return renderPdf(xhtml);                         // ② XHTML → PDF
    }

    /** ① 模板渲染:Template 走 Freemarker 内部缓存,这里只做数据绑定 */
    private String renderTemplate(String tplName, Map<String, Object> model) {
        try (StringWriter writer = new StringWriter(8192)) {
            freemarkerCfg.getTemplate(tplName, "UTF-8").process(model, writer);
            // ⚠️ 关键:openhtmltopdf 只认"格式良好的 XML",HTML5 的 <br> <img> 必须自闭合
            return Jsoup.parse(writer.toString())
                        .outputSettings(new Document.OutputSettings()
                                .syntax(Document.OutputSettings.Syntax.xml))
                        .html();
        } catch (Exception e) {
            throw new PdfExportException("模板渲染失败: " + tplName, e);
        }
    }

    /** ② PDF 渲染:每次请求新建 builder(轻量),字体/模板这些重资产全部复用 */
    private byte[] renderPdf(String xhtml) {
        try (ByteArrayOutputStream out = new ByteArrayOutputStream(64 * 1024)) {
            PdfRendererBuilder builder = new PdfRendererBuilder();
            builder.useFastMode();                        // 关掉抗锯齿等美化,吞吐优先
            builder.useSVG();
            builder.useFont(FontRegistry.file(), FontRegistry.family());
            builder.useUriStreamFactory(new SafeUriStreamFactory()); // 🛡️ 只放行白名单协议
            builder.withHtmlContent(xhtml, null);         // baseUrl=null,杜绝相对路径读数据
            builder.toStream(out);
            builder.run();
            return out.toByteArray();
        } catch (Exception e) {
            throw new PdfExportException("PDF 渲染失败", e);
        }
    }
}
这里藏着两个"该省省、该花花"的亮点:
🌟 亮点 1:重资产缓存,轻对象重建。
Configuration和字体对象是不可变/线程安全的,放心单例缓存------这是性能关键;但PdfRendererBuilder、ITextRenderer持有当前文档的布局状态,共享会导致内容串页、偶发字体丢失,必须每请求新建。
🌟 亮点 2:Jsoup 归一化 XHTML。 HTML5 的<br>、<img>不是合法 XML,渲染器会抛SAXParseException直接 500。用 Jsoup 以 XML 语法规范化后再渲染,一行代码挡住一类线上事故。
如果是 Thymeleaf + Flying Saucer 的老项目,核心代码等价于:
java
// 模板引擎单例,内部缓存预编译模板,避免重复解析
private static final TemplateEngine TEMPLATE_ENGINE = new TemplateEngine();

ITextRenderer renderer = new ITextRenderer();
// 嵌入中文字体:IDENTITY_H 编码 + EMBEDDED 内嵌,任何机器打开都不缺字
renderer.getFontResolver().addFont("fonts/SourceHanSansCN-Normal.ttf",
        BaseFont.IDENTITY_H, BaseFont.EMBEDDED);
renderer.setDocumentFromString(htmlContent);
renderer.layout();
renderer.createPDF(outputStream);
Flying Saucer 路线还有个进阶优化值得说:字体解析器可以全局共享 。字体文件动辄 20~50MB,每次导出都 addFont 会把 CPU 打满------
java
// ⭐ 字体解析器全局共享,实测导出耗时降 60%+
private static final ITextFontResolver SHARED_FONT_RESOLVER = buildFontResolver();

private static ITextFontResolver buildFontResolver() {
    SharedContext ctx = new SharedContext();
    ITextFontResolver resolver = new ITextFontResolver(ctx);
    ctx.setFontResolver(resolver);
    resolver.addFont("/fonts/NotoSansSC-Regular.otf", BaseFont.IDENTITY_H, BaseFont.EMBEDDED);
    return resolver;
}

public byte[] render(String html, String baseUri) {
    // 注意:ITextRenderer 非线程安全,必须每次 new,但字体解析器可复用
    ITextRenderer renderer = new ITextRenderer(20f, 96, SHARED_FONT_RESOLVER);
    renderer.setDocumentFromString(html, baseUri);
    renderer.layout();
    renderer.createPDF(out);
    return out.toByteArray();
}
另外 BaseFont.createFont 有磁盘 IO 开销,也可以用 ConcurrentHashMap 做一层缓存;ttc 集合字体记得用 "/fonts/simsun.ttc,0" 这种"逗号+索引"的写法取子字体。数据量大时可以用 NOT_EMBEDDED 省体积,代价是换台没装字体的机器打开可能缺字------权衡着来。
4.4 Controller:流式下载
java
@GetMapping("/pdf/statement/{orderNo}")
public ResponseEntity<byte[]> download(@PathVariable String orderNo) {
    StatementDTO dto = statementService.load(orderNo);
    Map<String, Object> model = Map.of(
            "dto", dto,
            "items", dto.getItems(),
            "generatedAt", LocalDateTime.now()
    );

    byte[] pdf = pdfExportService.export("statement.ftl", model);

    HttpHeaders headers = new HttpHeaders();
    headers.setContentType(MediaType.APPLICATION_PDF);
    headers.setContentDisposition(ContentDisposition.attachment()
            .filename("对账单-" + orderNo + ".pdf", StandardCharsets.UTF_8) // ✅ 中文文件名走 UTF-8
            .build());
    headers.setContentLength(pdf.length);
    return new ResponseEntity<>(pdf, headers, HttpStatus.OK);
}
如果是 Servlet 裸写,注意两个细节:Content-Type 设 application/pdf;中文文件名用 URLEncoder.encode(name, UTF_8) 并写成 filename*=UTF-8''xxx,或者转 ISO-8859-1------不然用户下载下来文件名一堆乱码。
4.5 模板:中文 + 分页 + 页码一次讲全
html
<!DOCTYPE html>
<html xmlns="http://www.w3.org/1999/xhtml" lang="zh-CN">
<head>
  <meta charset="UTF-8"/>
  <style>
    /* ===== 页面尺寸 / 边距 / 页脚页码(@page 边距框) ===== */
    @page {
      size: A4;
      margin: 18mm 14mm 20mm 14mm;
      @bottom-center {
        content: "第 " counter(page) " 页 / 共 " counter(pages) " 页";
        font-family: "Noto Sans CJK SC"; font-size: 9px; color: #888;
      }
      @top-right { content: element(company-logo); }   /* 运行元素:每页固定页眉 */
    }
    #hdr { position: running(company-logo); font-size: 10px; color: #666; }

    /* ===== 全文统一中文字体,杜绝 fallback 到 Helvetica 变方块 ===== */
    body, table, td, th { font-family: "Noto Sans CJK SC", serif; font-size: 12px; }

    /* ===== 🌟 表格跨页神器:-fs-table-paginate 让表头自动重复 ===== */
    table { width: 100%; border-collapse: collapse; -fs-table-paginate: paginate; }
    thead { display: table-header-group; }    /* 每页重复表头 */
    tfoot { display: table-footer-group; }    /* 每页重复合计行 */
    tr    { page-break-inside: avoid; }       /* 🚫 单行不被从中间劈开 */

    h2 { page-break-after: avoid; }           /* 标题不落单 */
    .section { page-break-before: always; }   /* 章节/签章页强制换页 */
  </style>
</head>
<body>
  <div id="hdr">XX 银行 · 电子对账单</div>
  <h2>对账单:${dto.orderNo!""}</h2>
  <table>
    <thead><tr><th>日期</th><th>摘要</th><th>金额(元)</th></tr></thead>
    <tbody>
      <#list items as it>
        <tr><td>${it.date?string("yyyy-MM-dd")}</td><td>${it.summary}</td>
            <td style="text-align:right">${it.amount?string("0.00")}</td></tr>
      </#list>
    </tbody>
    <tfoot><tr><td colspan="2">合计</td><td>${dto.total?string("0.00")}</td></tr></tfoot>
  </table>
</body>
</html>两个内行细节:counter(page)/counter(pages) 是页码,position: running() 是每页重复的运行元素。如果用的 Flying Saucer(它 @page 边距框支持不完整),就改用 ITextRenderer.setListener(PDFCreationListener) 在 onClose 里拿 PdfWriter.getDirectContent() 统一加盖页码。
能力边界要主动交代 :openhtmltopdf / Flying Saucer 支持 CSS 2.1 全部 + 部分 CSS 3、@page 边距框、SVG、-fs- 私有属性;但不支持 flex / grid、JS 执行、异步加载 。所以我会在模板设计阶段就用 CI Lint 卡住:扫模板目录,命中 display:flex|display:grid 就告警,把问题挡在上线前。
4.6 兜底路线:AcroForm 表单填充
版式死固定、只填几个值的场景(发票、凭证、证书),HTML 方案的样式渲染反而是负担。PDF 表单直接填字段,性能比 HTML 方案高 3~5 倍:
java
public void fillPdfForm(String templatePath, Map<String, String> fieldData,
                        OutputStream outputStream) throws Exception {
    // 生产建议模板预加载缓存(ConcurrentHashMap),避免重复磁盘 IO
    PdfReader reader = new PdfReader(templatePath);
    PdfStamper stamper = new PdfStamper(reader, outputStream);
    AcroFields form = stamper.getAcroFields();

    // 配置中文字体,解决表单中文乱码
    BaseFont font = BaseFont.createFont("classpath:fonts/simsun.ttc,0",
            BaseFont.IDENTITY_H, BaseFont.NOT_EMBEDDED);
    form.addSubstitutionFont(font);

    for (Map.Entry<String, String> entry : fieldData.entrySet()) {
        form.setField(entry.getKey(), entry.getValue());
    }

    // 🌟 表单扁平化:导出后不可编辑,文件体积减少 30%+
    stamper.setFormFlattening(true);
    stamper.close();
    reader.close();
}
五、生产踩坑实录:11 个高频问题一次讲透
这部分是真正的分水岭,我按"现象 → 根因 → 方案"整理成一张表,建议收藏:
| # | 难点 | 现象 | 根因 | 解决方案 |
|---|---|---|---|---|
| 1 | 中文乱码/方块 | PDF 里中文变 □□□ | 默认字体 Helvetica 无 CJK 字形且未嵌入 | Noto/思源字体,useFont() 显式注册 + 强制嵌入,字体随包发布 |
| 2 | 容器里字体丢失 | 本机正常,Docker 里全方块 | 镜像没装 fontconfig/中文字体 | 字体打进 jar,或 Dockerfile 装 fonts-noto-cjk |
| 3 | CSS 不生效 | flex/grid 排版整个错乱 | 引擎只支持 CSS 2.1 为主 | 模板禁用 flex/grid,用 table/float 布局;CI Lint 拦截;必要时换 Playwright |
| 4 | 表格跨页断裂 | 数据行被拦腰截断、表头丢失 | 未启用分页表头规则 | -fs-table-paginate: paginate + thead{display:table-header-group} + tr{page-break-inside:avoid} |
| 5 | 页码/页眉页脚 | 每页都要带页码和公司名 | 普通 HTML 只渲染一次 | @page 边距框 + counter(page) + running();Flying Saucer 用 PDFCreationListener;再不行 PDFBox 逐页盖章 |
| 6 | 图片不显示/模糊 | logo 丢失、打印发虚 | 渲染器不认 classpath/相对路径;DPI 不足 | 图片转 Base64 内嵌最稳妥;或自定义 UriStreamFactory 映射 classpath;用 300DPI 高清图 + object-fit: contain |
| 7 | HTML 解析报错 | SAXParseException 直接 500 |
未自闭合,非合法 XML |
Jsoup 以 XML 语法规范化后再渲染 |
| 8 | 大文档 OOM/超时 | 2000 行报表接口 500 或 OOM | 全量数据驻留内存 + 同步阻塞 | 游标/分页查询 + 分片渲染 + 流式写临时文件 + 异步导出落 OSS |
| 9 | 并发不安全 | 偶发字体丢失、内容串页 | 把 Renderer 当单例共享 | 模板/字体等不可变资源才复用,Renderer 每请求新建 |
| 10 | 安全风险 🛡️ | ../../ 读文件、模板注外链 |
模板名来自用户、渲染器可发外网请求 | 模板名白名单;UriStreamFactory 只放行 classpath:;model 值 HTML 转义(${x?html});禁 XXE |
| 11 | 电子签章/水印 | 合同要盖章、报告要防伪 | HTML 层做不了图层叠加 | PDF 后处理:PDFBox 叠加水印;签章走 CA 数字签名(PKCS#7 + 时间戳,DocMDP 权限控制) |
挑三个最容易被追问的展开讲讲:
① 中文乱码的三步闭环。 机制上就三处断裂点:字形供给缺失 (默认字体无 CJK 映射)→ 字体注册失效 (useFont 没调用或路径错)→ 编码与嵌入不匹配 (只设 Identity-H 却没真嵌入字形数据)。所以修复必须是闭环:选可商用 Unicode 字体 → 确保字体可被 classloader 访问并落盘 → 显式注册并强制嵌入。少任何一步,换个 Linux 容器就复现。
② 分页控制的三个"咒语" :tr { page-break-inside: avoid; } 行内不断页;h2 { page-break-after: avoid; } 标题不落单;.section { page-break-before: always; } 章节强制新页。如果表格极长,还可以在模板里用 <#list> 的 ?counter 每隔 N 条手动插入分页符 <div style="page-break-after: always;"></div>。
③ 图表怎么办? ECharts 在纯 JVM 渲染器里画不出来------走 JFreeChart 或 ECharts 服务端渲染成 PNG,再 Base64 内嵌进模板。
六、大数据量:异步导出 + 分片合并,这是标配
对账单 2000 行时同步接口就容易顶到网关超时(10s/30s)。生产上我会拆成"同步小文档 + 异步大文档"两条路:
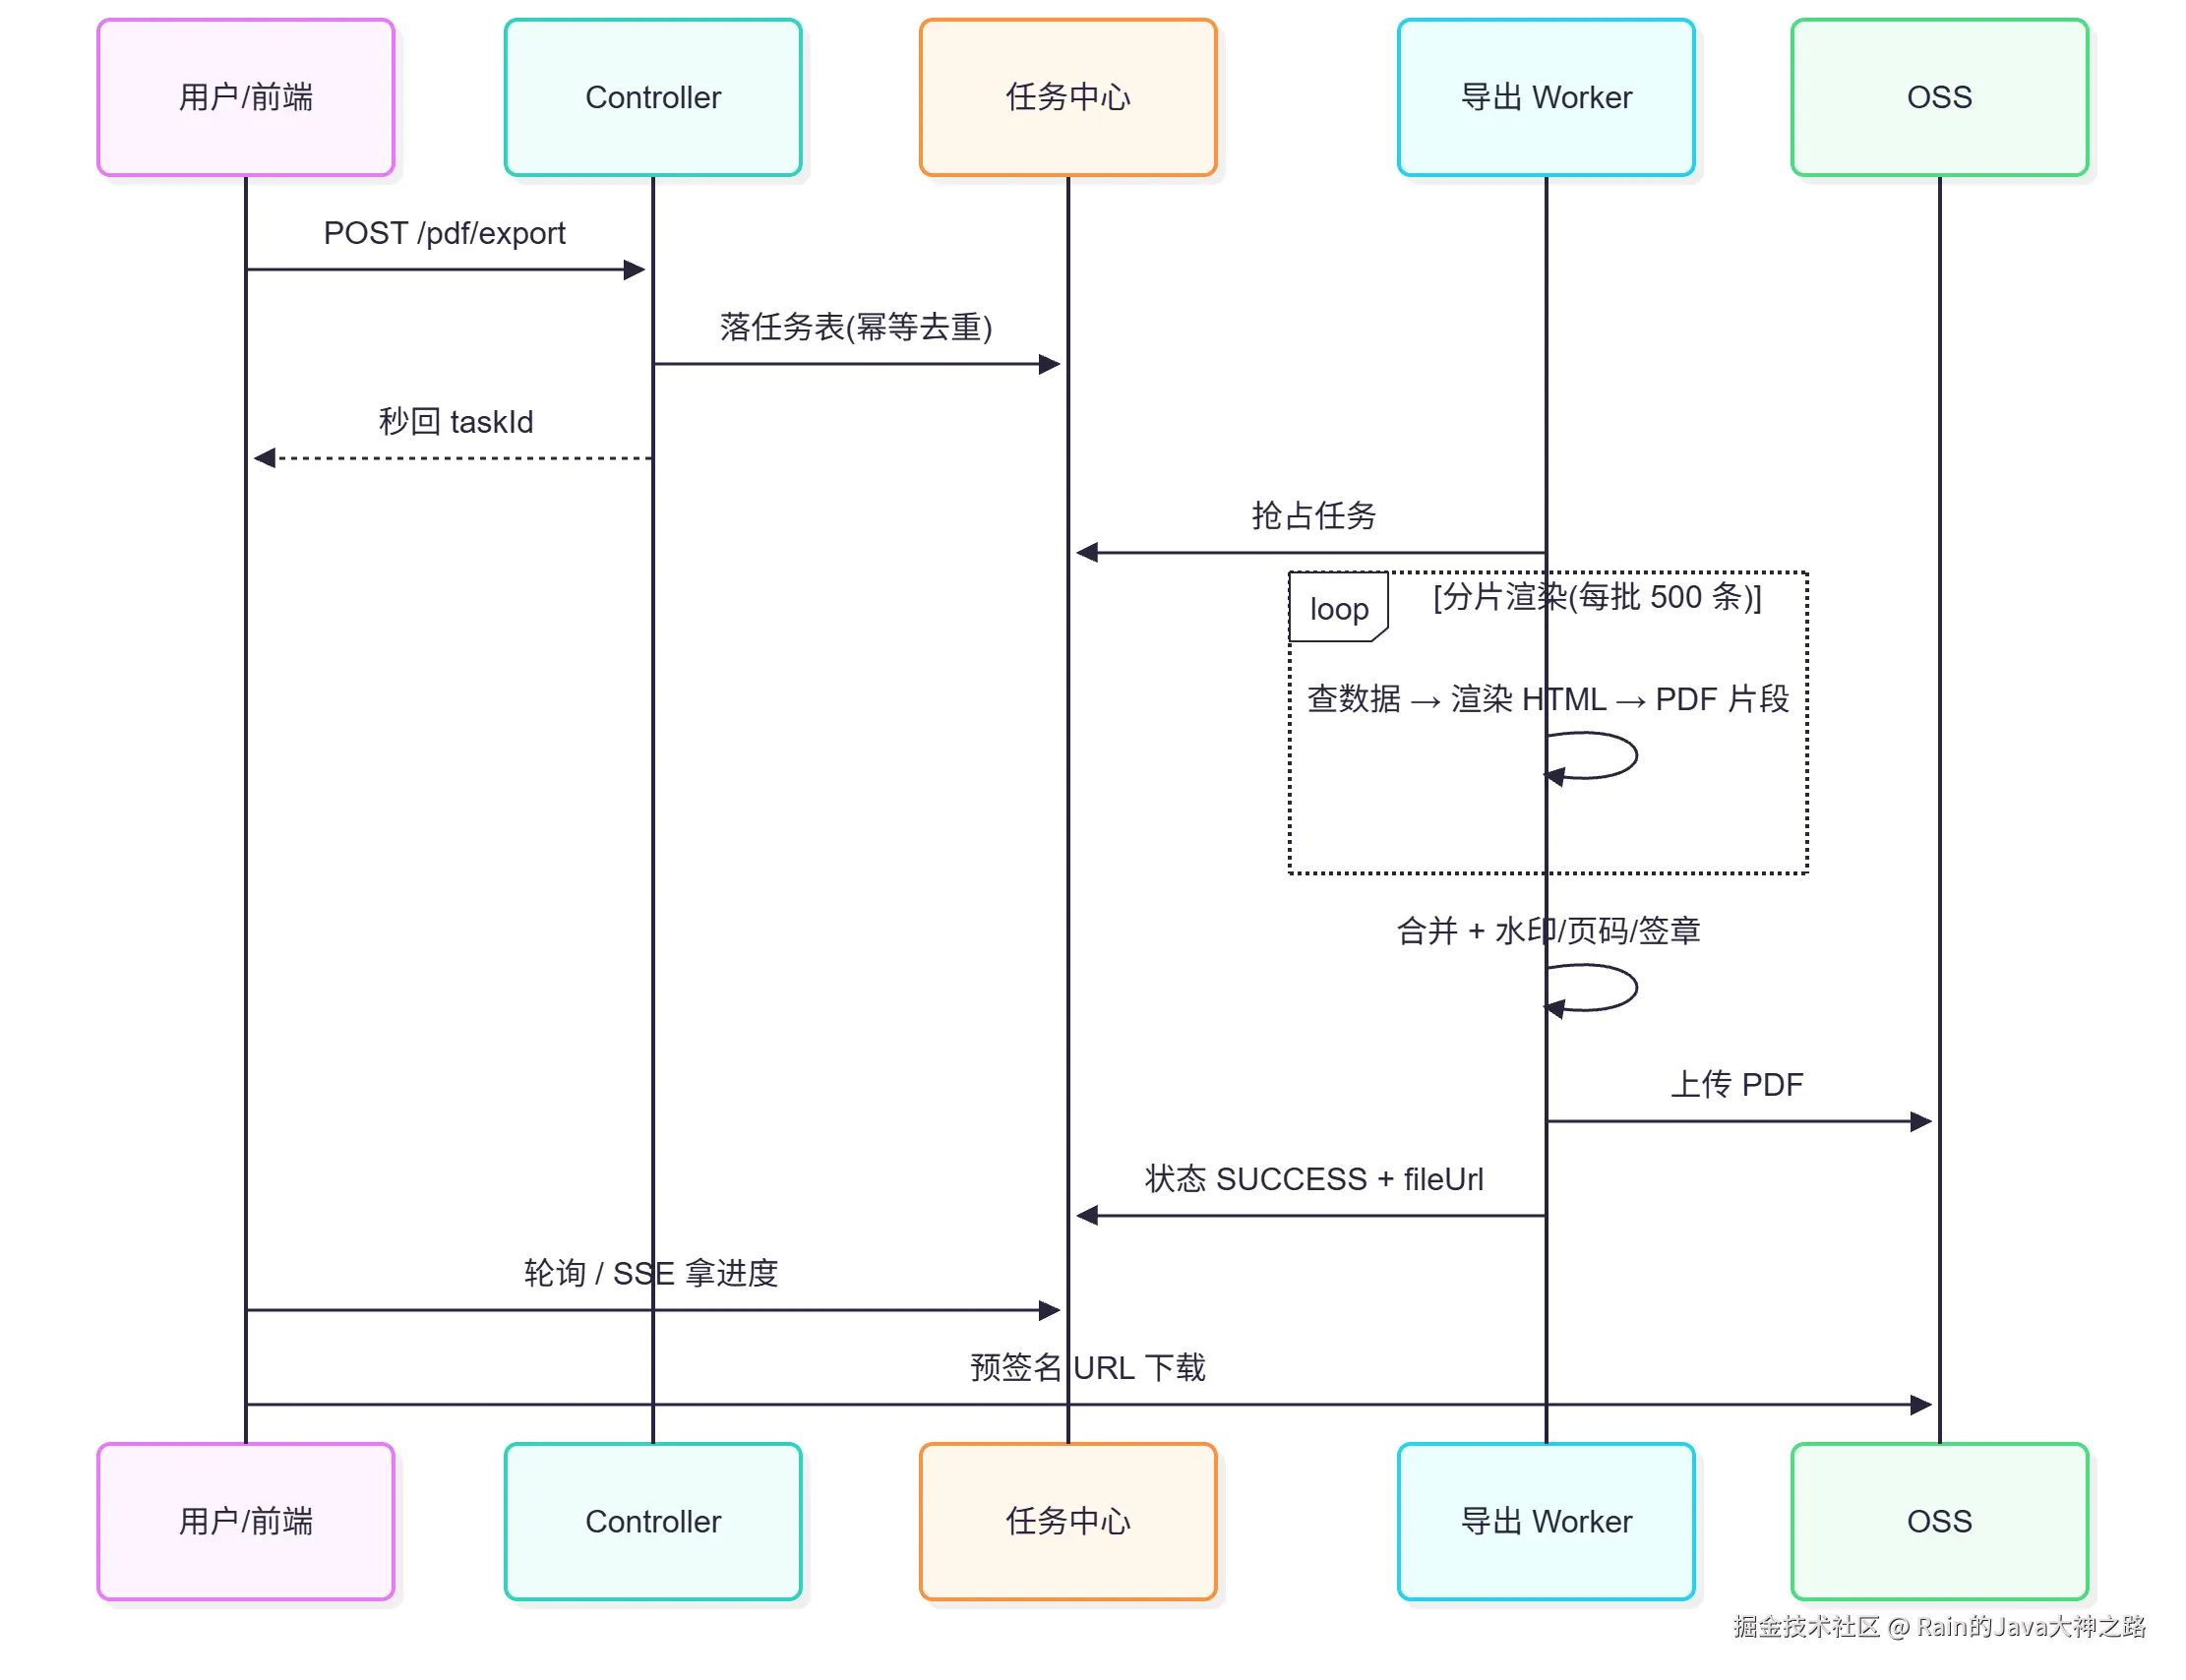
6.1 提交任务:异步化 + 幂等去重
java
@PostMapping("/exports")
public R<ExportTaskVO> submit(@RequestBody @Valid ExportCmd cmd) {
    // 幂等键 = 模板 + 模板版本 + 参数指纹;同参数重复点击直接复用上次结果
    String bizKey = DigestUtils.sha256Hex(
        cmd.getTemplateCode() + "#" + cmd.getTemplateVersion() + "#" + cmd.getParamsJson());

    ExportTask cached = taskRepo.findAvailable(bizKey);
    if (cached != null) return R.ok(ExportTaskVO.of(cached));  // 🧠 命中即返回,不重复烧 CPU

    ExportTask task = taskRepo.save(ExportTask.init(cmd, bizKey, UserContext.uid()));
    exportExecutor.execute(() -> exportPipeline.run(task.getId())); // 异步,接口 50ms 返回
    return R.ok(ExportTaskVO.of(task));
}
🌟 幂等 + 结果缓存 :
hash(模板版本 + 参数摘要)做 key,用户狂点"导出"也直接返回同一份文件,能省掉 90% 的重复渲染。
6.2 分片渲染 + 合并:内存恒定
java
// ⭐⭐⭐ 永远不要把 10 万条数据一次性塞进一个 DOM
List<Path> parts = chunks.parallelStream()
        .map(c -> renderer.render(templateEngine.process(tpl, model(c)), baseUri))
        .toList();

try (PDDocument out = new PDDocument()) {
    PDFMergerUtility merger = new PDFMergerUtility();
    for (Path p : parts) {
        merger.appendDocument(out, Loader.loadPDF(p.toFile()));
    }
    // 🔑 用磁盘缓冲,几百 MB 也不 OOM
    merger.mergeDocuments(MemoryUsageSetting.setupTempFileOnly());
    out.save(target);
}
OpenPDF 路线可以用 PdfCopy 边渲染边追加,效果一样------直接追加页对象,不进 Java 堆 。实测 10 万条数据,内存恒定在 200MB 以内。渲染大文档时也可以落临时文件流式写(Files.createTempFile + BufferedOutputStream),别用 byte[] 撑爆堆。
6.3 线程池:把 CPU 密集的活关进笼子
java
ThreadPoolExecutor EXPORT_POOL = new ThreadPoolExecutor(
        Runtime.getRuntime().availableProcessors(),
        Runtime.getRuntime().availableProcessors() * 2,
        60, TimeUnit.SECONDS,
        new LinkedBlockingQueue<>(200),
        new ThreadFactoryBuilder().setNameFormat("pdf-export-%d").build(),
new ThreadPoolExecutor.CallerRunsPolicy()); // 满了反压,快速失败,别把服务拖垮三个原则:独立线程池,绝不与业务线程池共用;队列有界 + 显式拒绝策略;再用 Semaphore(并发 ≈ 2 × CPU 核数)兜住渲染并发。再往上还可以做:单用户/单租户限流(Redis + 令牌桶)、Sentinel 熔断降级、导出服务独立微服务隔离部署、非紧急报表用 MQ 延迟消息放到凌晨低谷期执行。
MQ 消费端也很直白:
java
@RabbitListener(queues = "pdf.export.queue")
public void onMessage(ExportMsg msg) {
    exportTaskService.markRunning(msg.taskId());
    byte[] pdf = pdfExportService.export(msg.template(), msg.model());
    String url = ossClient.upload("pdf/" + msg.taskId() + ".pdf", pdf);
    exportTaskService.markDone(msg.taskId(), url);   // 含 24h 过期清理
}
七、后处理:水印、页码、签章,合规三件套
HTML 层做不了的事,交给 PDFBox 后处理。页码 + 斜向平铺水印的完整实现:
java
public void stamp(byte[] src, OutputStream out, String watermark) throws Exception {
    try (PDDocument doc = PDDocument.load(src)) {
        PDFont font = PDType0Font.load(doc, Files.newInputStream(Paths.get(FONT_PATH)));
        int total = doc.getNumberOfPages();
        float pageW = doc.getPage(0).getMediaBox().getWidth();

        for (int i = 0; i < total; i++) {
            PDPage page = doc.getPage(i);
            try (PDPageContentStream cs = new PDPageContentStream(doc, page,
                    PDPageContentStream.AppendMode.APPEND, true, true)) {

                // 页脚页码
                cs.beginText();
                cs.setFont(font, 10);
                cs.newLineAtOffset(pageW / 2 - 22, 18);
                cs.showText("第 " + (i + 1) + " 页 / 共 " + total + " 页");
                cs.endText();

                // 斜向平铺水印(透明度用 ExtGState)
                PDExtendedGraphicsState gs = new PDExtendedGraphicsState();
                gs.setNonStrokingAlphaConstant(0.12f);   // 12% 透明度
                cs.setGraphicsStateParameters(gs);
                cs.beginText();
                cs.setFont(font, 42);
                cs.setTextMatrix(Matrix.getRotateInstance(Math.toRadians(45), 120, 300));
                cs.showText(watermark);
                cs.endText();
            }
        }
        doc.save(out);
    }
}
iText 路线则可以用 PdfPageEventHelper 在 onEndPage 里往 getDirectContentUnder() 画布上写字,PdfGState.setFillOpacity(0.1f) 控制半透明;PdfStamper 还能设置打开密码、禁止编辑/打印/复制权限。合规要求高的场景,数字签名走 BouncyCastle + CA(PKCS#7 + 时间戳),用 DocMDP 做权限控制。盖章位置对不准的话,记住坐标一律用 pt/mm 绝对定位,最好配个模板可视化编辑器预览。
企业级还有两个刚需别忘:动态水印 (叠加用户名 + 时间戳,防截图泄露溯源)和操作审计(记录每次导出的操作人、时间、文件摘要)。
八、安全与工程化:拉开差距的部分
很多人能跑出 Demo,但下面这几件事做了,才敢说"上过生产"。
1. 模板沙箱。 模板本质是用户可控的代码,等同于 SQL 注入面:
java
cfg.setNewBuiltinClassResolver(TemplateClassResolver.SAFER_RESOLVER); // 禁 ?new,防 RCE
cfg.setAPIBuiltinEnabled(false); // 禁 ?api,防反射打穿再叠加三道闸:模板名白名单(拒绝拼接路径)、UriStreamFactory 协议白名单(只允许 classpath:,禁 file:// 和外部 http)、model 数据 HTML 转义(${x?html})。模板里有富文本的,用 jsoup 白名单清洗(只保留 p/table/img/span 等),外链图片下载后本地化,防 SSRF 和线上图片失效。
2. 数据快照。 用户导出的对账单,过两天数据变了再导一份对不上,锅就是你的。导出时存 template_version + data_version + params_hash,版本号写进页脚,重放历史 PDF 就用旧模板渲染------可回溯。
3. 模板治理。 几十套模板怎么管?三层:模板文件版本化(Git 管理 .ftl)+ 元数据表(模板名、版本、状态、适用业务、字段清单)+ 发布走灰度。运行时按 templateKey + version 加载,改动后平滑 reload。"改样式不发版"和"可回溯"两个诉求都满足。
4. PDF 怎么测? 三层:① 快照测试 ------固定输入,对渲染结果做页数/文本/关键坐标断言(文本用 PDFBox 抽取);② 模板冒烟 ------每个模板跑一遍最小数据保证不抛异常;③ 视觉回归------渲染成 PNG 做图像 diff(阈值容忍抗锯齿差异)。再加一个"字体加载自检"的健康检查接口。
5. 可观测性。 导出链路埋点,记录每个任务的耗时、数据量、成功率,接 Prometheus + Grafana。某类模板转换耗时突然增加,能第一时间告警。线上排版防翻车再加两道:golden PDF 回归测试 + 灰度 1% + 页数/耗时/体积阈值告警。
6. 交付安全。 OSS 下载链接用带签名的临时 URL(15 分钟过期,一次性),防止链接被恶意抓取;文件配生命周期规则自动过期清理,本地临时文件 finally 删除,别把磁盘打爆。
九、性能实测:数据要报口径
空口说优化没用,贴一组实测(JDK 17 / 4C8G / 单文档 A4 30 页带表格):
| 环节 | 优化前 | 优化后 | 主要手段 |
|---|---|---|---|
| 模板渲染 | ~35 ms | ~8 ms | Template 缓存(避免每次编译) |
| 字体解析 | ~280 ms | ~0 ms(命中缓存) | 字体只解析一次 + 落盘复用 |
| PDF 渲染 | ~1.2 s | ~0.6 s | useFastMode() + 去抗锯齿 |
| 端到端 P99 | ~2.0 s | ~0.8 s | 上述 + 限流防抖动 |
另外字体子集化(subset=true,只打包用到的字形)能把 10MB 的字体压到几十 KB,配合图片压缩和共享资源字典,文件体积能砍掉一大半。
十、高频追问:这几个问题一定会被问(或被业务问)
Q:10 万行明细也用 PDF 导? 先反问业务。PDF 是"版式文档",适合合同/票据/对账单;10 万行明细本质是数据,应该导 Excel(EasyExcel 流式写入)。如果非要 PDF,就分片 + 合并 + 进度条,并且前端提示"导出较慢"。
Q:要导出 100 万份怎么办? 任务拆成 MQ 消息 → 消费端并行渲染(信号量限流)→ 分片合并/逐个落 OSS → 完成后站内信/邮件通知 → 定时清理过期文件。渲染是无状态水平扩展的,瓶颈在 CPU,扩消费者实例就行。
Q:为什么不先导出 Word 再用 LibreOffice 转? 三个问题:依赖外部进程并发一高就排队;字体/分页漂移,线上和本地不一样;运维成本高。Word 适合"用户还要编辑"的场景,PDF 适合"最终交付、防篡改"的场景。
Q:为什么不用 JasperReports? 模板是 XML,改个样式要程序员上手;HTML 模板业务方和前端自己能调,团队效率 > 单点性能。除非是真正复杂的企业级分组图表报表。
Q:前端打印(window.print)行不行? 跨浏览器差异大、分页页眉页脚不可控、要用户手动操作,批量生成根本没法做。
Q:高并发怎么保证不挂? 三层隔离:线程池隔离(不占 Web 容器线程);队列有界 + 拒绝策略(满了快速失败返回"系统繁忙");单用户/单租户限流 + 熔断降级,再配合服务独立部署物理隔离。
十一、收尾:一张表记住所有核心决策
| 维度 | 推荐做法 |
|---|---|
| 方案选型 | 样式多变 → HTML 路线(openhtmltopdf);格式固定高并发 → AcroForm 表单;高保真现代页面 → Playwright |
| 授权合规 | 避开 iText AGPL,选 Apache 2.0 / LGPL 组件;字体用 Noto/思源 |
| 中文问题 | 字体放 classpath 打进 jar,显式注册 + 强制嵌入,零环境依赖 |
| 分页控制 | page-break-inside: avoid + thead 重复 + -fs-table-paginate |
| 内存管理 | 全程流式,不落盘;大数据量分片渲染 + 磁盘缓冲合并 + 异步 + OSS |
| 性能优化 | 模板/字体缓存,useFastMode(),独立线程池 + 信号量限流 |
| 安全 | 模板沙箱 + 白名单 + 转义;签名 URL;动态水印 + 权限加密 + 操作审计 |
| 工程化 | 数据快照 + 模板版本化 + 幂等缓存 + 冒烟/视觉回归 + 监控告警 |
最后说句掏心窝的:导出 PDF 不是"调个 API",是一个带状态机的异步渲染服务------把 CPU 密集的活关进笼子,把不可控的模板沙箱化,把不可逆的数据拍成快照。剩下的功夫,全在字体、分页、内存和安全这四座大山上。
觉得有用就点个「赞」和「在看」,转发给正在被 PDF 折磨的同事。关注我不迷路,后面还会更新 EasyExcel 大数据导出和电子签章落地的实战篇。
留个互动话题:你在做 PDF 导出时踩过最狠的坑是什么?中文乱码、OOM 还是分页?评论区聊聊,我挑几个典型问题下篇专门拆解。