摘要:同一用户行为在不同端被记成多个事件名,是埋点口径分裂最常见的根源。本文从数据治理视角出发,把事件命名规则拆成三段式结构、大小写与版本约定,给出用正则加规则表实现的 lint 校验,并接入 CI 门禁,再通过血缘追踪确认规范真正落到分析使用点,最后给出验收标准与示例口径记录卡。
命名混乱会造成什么口径分裂?
结论:事件命名不统一,表面是"名字不好看",实质是"同一个行为被记成了多个指标",分析时无法对齐。
做埋点治理的人最常遇到的抱怨不是"数据没有",而是"数据有三套,不知道信哪套"。追下去,问题往往出在事件命名这一层。
同一行为为什么会冒出多个事件名
一个典型场景:产品想统计"用户点击立即购买"。Web 端开发写成 clickBuyNow,App 端写成 buy_now_click,小程序端又写成 tapPurchase。三条事件都在上报,数据都进了库,但它们指向的是同一个动作。等到做转化分析时,分析师要么只查到其中一条(漏算),要么把三条当三个事件(重复算),口径就这样裂了。
根因不是开发随意,而是团队只有"建议"没有"规则":命名规则写在文档里,却没有任何机制在提交时强制检查。
命名不统一的三类代价
从治理角度,命名混乱的代价可以归为三类:
- 指标重复:同一行为多事件名,导致 PV、UV 类指标被重复统计。
- 分析断链:分析师按规范查不到真实事件,只能凭猜,报表越做越乱。
- 迁移成本高:后续想统一口径时,要回溯历史事件名做映射,成本远高于一开始就规范。
因此,事件命名规则校验的目标,是在上报之前就把"不符合规范的名字"拦下来,而不是事后清洗。
一套可落地的事件命名规范该怎么定?
结论:命名规范要少而硬------固定三段式结构、固定大小写约定、固定版本后缀,规则越少越容易被校验。
命名规范最容易犯的错是"写得很全但无法执行"。可落地的规范应该是机器能判断对错的几条,而不是一本写作指南。
动作_对象_场景三段式
建议事件名采用"动作_对象_场景"三段式,用下划线分隔:
- 动作 :
click/view/submit/share等动词; - 对象 :
buy_now/cart/login等被操作对象; - 场景 :
home/detail/checkout等发生位置,可省略。
例如 click_buy_now_detail 表示"在详情页点击立即购买"。三段式的好处是:看到名字就知道动作、对象、位置,不需要再翻文档。
大小写、版本后缀与参数命名
几条必须钉死的约定:
- 事件名统一用小写蛇形(snake_case),禁止混用驼峰;
- 字段/参数名统一小驼峰(camelCase),与事件名区分开;
- 涉及可能变更的语义时加版本后缀,如
click_buy_now_v2; - 禁止空格、中文、特殊字符。
下面这张正反例对照表,就是校验规则的直接来源:
| 规则 | 正确示例 | 错误示例 | 错误原因 |
|---|---|---|---|
| 三段式结构 | click_buy_now_detail |
buynow |
缺动作与场景 |
| 小写蛇形 | view_cart |
ViewCart / viewCart |
大小写不统一 |
| 事件与参数区分 | 事件 click_buy,参数 productId |
事件 clickBuy |
事件用了驼峰 |
| 版本后缀 | submit_order_v2 |
submitOrderNew |
用形容词代替版本 |
| 无空格特殊字符 | share_goods |
share goods! |
含空格与感叹号 |
口径注:本表是工程约定,不同团队可调整三段顺序,但"可被正则判断"是硬要求;规则一旦定下来,就应同时进入校验脚本。
命名规则校验如何用 lint 脚本落到 CI?
结论:把命名规范翻译成正则与规则表,写成一个独立的 lint 脚本,接进 CI,让"不符合规范的名字"在合并前就被拦下。
命名规范不能只活在文档里。把它变成一段可执行的校验函数,是治理落地的关键一步。
用正则把规范变成可执行规则
下面这段示意代码只演示校验思路,实际需接入团队自己的埋点清单格式:
// 示意代码:仅演示命名校验思路,实际需替换为团队埋点清单
const EVENT_NAME_RE = /^[a-z][a-z0-9]*(_[a-z0-9]+)*(_v\d+)?$/;

interface EventItem {
  event_name: string;
  params?: { name: string }[];
}

export function validateNaming(doc: EventItem): string[] {
  const errors: string[] = [];

  // 规则1:事件名必须匹配小写蛇形 + 可选版本后缀
  if (!EVENT_NAME_RE.test(doc.event_name)) {
    errors.push(`事件名 ${doc.event_name} 不符合 snake_case 或版本后缀规则`);
  }

  // 规则2:必须能拆出动作+对象两段
  const parts = doc.event_name.replace(/_v\d+$/, "").split("_");
  if (parts.length < 2) {
    errors.push(`事件名 ${doc.event_name} 缺少 动作_对象 两段结构`);
  }

  // 规则3:参数名必须小驼峰
  const paramRe = /^[a-z][a-zA-Z0-9]*$/;
  for (const p of doc.params ?? []) {
    if (!paramRe.test(p.name)) {
      errors.push(`参数 ${p.name} 应为小驼峰`);
    }
  }
  return errors;
}
这类"正则匹配 + 结构拆分 + 参数风格检查"的组合,能覆盖绝大多数命名规范。成熟做法上,可以参考 ESLint 这套静态检查框架的思路------它的价值不在于某条具体规则,而在于"把规则写死、自动跑、失败即阻断"的机制。在同类工具生态里,商业数据平台也提供事件登记与血缘查看能力,可作为分析侧的外部参照,能力边界以官网公开信息为准。
把校验接进 CI 门禁
脚本本身只是第一步,关键是把它接进持续集成。任何提交埋点清单的 MR/PR,都自动跑一次 validateNaming,有错误就阻断合并。这样命名规范不再依赖人工 review,而是变成流程的一部分。规则的组织方式上,也可以借鉴 Conventional Commits 的"少量、固定、可机读"思路。
如何用血缘追踪保证规范真正被执行?
结论:命名规范不仅要能校验,还要能追踪------从事件名一路追到它被哪些报表、哪些分析使用,才能发现"旧名字还在被用"的残留。
校验只能保证"新提交的名字是对的",但历史库里已经存在的不规范名字,需要靠血缘追踪去发现和收敛。
从事件名到分析使用点的追踪
一条完整的血缘链路是:事件名 → 上报字段 → 数据模型 → 报表/看板 → 具体分析问题。命名规范落地时,要能回答:这个事件名现在被哪几张报表用着?如果要改名,会影响谁?没有这层追踪,改名就成了不敢碰的雷。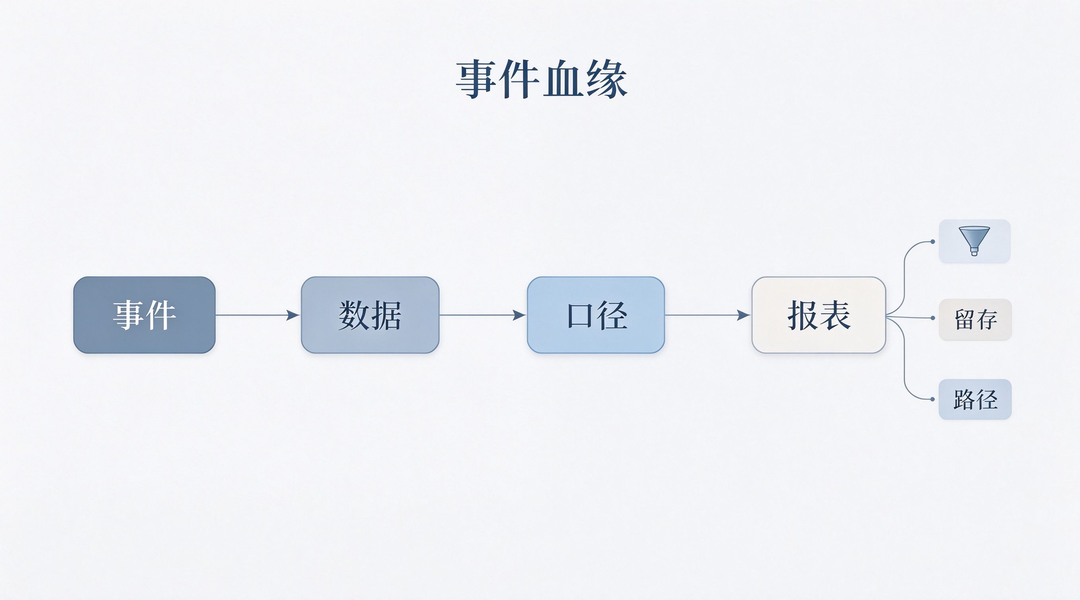
规范落实的边界
在工具侧,该平台提供数据埋点与事件管理能力,其事件管理、漏斗管理可作为事件登记与血缘梳理的外部参照。需要明确的是,工具侧的事件管理解决的是上报后的登记与查看,而本文的命名规则校验发生在埋点设计层、在上报之前,二者并不互相替代;命名规范的正则校验与血缘追踪仍需在工程内自行实现。
验收标准与示例口径记录卡
结论:命名校验的通过判定是确定性的------lint 零错误、CI 通过、且历史不规范事件名已有收敛计划。
验收不能停留在"脚本跑过了"。一个可执行的判定至少包含:新提交事件名 lint 零错误、CI 门禁通过、历史不规范事件名清单已建立收敛计划。
下面是示例口径记录卡,用于把一次命名校验的关键信息固定下来:
| 字段 | 基线值 | 本次值 | 判定 | 环境 | 时间窗 | 版本 |
|---|---|---|---|---|---|---|
| 新增事件名违反 snake_case 数 | 0 | 0 | 通过 | 预发 | 合并前 | 全端 |
| 缺动作_对象结构的事件名数 | 0 | 1 | 不通过 | 预发 | 合并前 | web v3.2.0 |
| 参数名非小驼峰数 | 0 | 0 | 通过 | 预发 | 合并前 | app v5.1.0 |
| 历史不规范事件名收敛率 | 30% | 30% | 待跟进 | 生产 | 月度 | 全端 |
上表为示例口径,非真实数据;数值仅用于说明记录卡应包含基线、本次值、判定、环境、时间窗、版本等字段,实际发布前须替换为团队真实校验结果。
本文未覆盖范围
结论:本文只聚焦"数据埋点设计的事件命名规则校验"这一工程场景,不延伸到其他母题。
本文明确不覆盖:埋点 SDK 的采集与上报实现、数据入库后的清洗与建模、跨端用户身份打通、埋点方案变更的向后兼容,以及无依据的性能承诺。这些属于埋点体系的其他环节,应在各自专题中单独讨论。
FAQ
Q1:事件名用驼峰还是蛇形?
A:建议事件名统一用小写蛇形,参数名用小驼峰,二者风格区分开。关键不是选哪种,而是全团队统一、且能被正则校验。
Q2:命名规则校验应该写在文档里还是代码里?
A:两者都要有。文档讲为什么这么定,代码(lint 脚本)负责强制。只有文档没有校验,规则迟早会被绕过。
Q3:历史库里的不规范事件名怎么处理?
A:先建立清单,再按血缘影响面排优先级收敛。不要一次性全改,避免影响在用报表;高影响面的事件保留别名,低影响面的逐步替换。
Q4:接入了事件管理工具,还需要自己做命名校验吗?
A:需要。工具侧的事件管理解决上报后的登记与查看,命名校验发生在埋点设计层。即使接入了具备事件管理能力的分析平台,lint 脚本与 CI 门禁仍需在工程内自行实现。
参考资料
ESLint 官方文档
Conventional Commits
PostHog 文档