Channel 的出站数据并不会在 write() 调用时立刻交给操作系统。在 Netty 中,write() 只是把消息压入一条内存中的队列,直到 flush() 时才批量刷出,承担这一待发送数据暂存与调度职责的正是 ChannelOutboundBuffer。它用一条 Entry 单向链表组织所有待发送消息,并用 flushedEntry、unflushedEntry、tailEntry 三个指针精确区分"已刷新待发送"与"已入队未刷新"两类数据。与此同时,它还是 Netty 背压(back-pressure)机制的载体:通过 WriteBufferWaterMark 高低水位与 totalPendingSize 待发送字节数的联动,把"写缓冲是否已满"这一内部状态转化为 channelWritabilityChanged 事件,让上层能够及时停读、避免接收速率长期压垮发送速率。理解这条"入队、刷新、批量写出、清理"的链路,是掌握 Netty 出站数据流与流量控制的关键一环。
围绕 ChannelOutboundBuffer 的"入队 → 刷新 → 转换 → 写出 → 清理"五个环节,以下几个问题将贯穿本文的源码分析主线:
- ChannelOutboundBuffer 如何用 flushedEntry、unflushedEntry、tailEntry 三个指针把一条 Entry 单向链表串起来,在同一链表里同时表达已刷新与未刷新两类数据?
- 用户调用 write() 时,消息如何先经 filterOutboundMessage 与 size() 估算,再通过 addMessage 追加到链表尾部,pendingSize 又为何要把每个 Entry 的 96 字节对象开销一并计入待发送统计?
- flush() 如何通过 addFlush 一次性把 unflushedEntry 之后的所有 Entry 标记为已刷新,setUncancellable 又如何在刷新阶段过滤掉已被取消的写入?
- nioBuffers 如何把一串已刷新的 ByteBuf 批量转换为 JDK 的 ByteBuffer\[\],其中的 maxCount、maxBytes 上限与 count 缓存如何协同实现跨写调用、分批发送?
- 高低水位 WriteBufferWaterMark(32KB/64KB)如何驱动 totalPendingSize 与 unwritable 的状态切换,fireChannelWritabilityChanged() 又如何把可写性变化转化为 Pipeline 事件进而实现背压?
本文将沿着 ChannelOutboundBuffer 的调用链路,从 Entry 链表的数据结构入手,依次分析 addMessage 入队、addFlush 刷新、nioBuffers 批量转换、removeBytes 发送清理,最后剖析高低水位流量控制的完整闭环。
一、ChannelOutboundBuffer 数据结构:Entry 单向链表与三指针追踪
1.1 三大指针与可写性字段
ChannelOutboundBuffer 是一个 final 类,仅由 AbstractChannel 内部持有,其类注释明确限定了调用约束:除 isWritable() 与用户自定义可写性相关方法外,其余方法都必须由 transport 实现方在 IO 线程内调用。要理解它的数据结构,关键是抓住一条单向链表与三个指针。
正如字段附近注释所写的那样,整条缓冲区是一条 Entry 单向链表:
java
io.netty.channel.ChannelOutboundBuffer#字段

    // 三大指针:一条 Entry 单向链表,同时表达已刷新与未刷新两类数据
    // Entry(flushedEntry) --> ... Entry(unflushedEntry) --> ... Entry(tailEntry)
    private Entry flushedEntry;      // 链表中第一个已刷新的 Entry,发送的起点
    private Entry unflushedEntry;    // 链表中第一个未刷新的 Entry,刷新/发送的分界线
    private Entry tailEntry;         // 链表尾节点,新 Entry 追加于此
    private int flushed;             // 已刷新但尚未写出的 Entry 数量

    private int nioBufferCount;      // 最近一次 nioBuffers() 转换出的数组数量
    private long nioBufferSize;      // 最近一次转换出的字节数

    private boolean inFail;          // failFlushed()/close() 的重入防护开关

    // 待发送字节总数,用 AtomicLongFieldUpdater 原子累加,保证 addMessage/removeBytes 多线程安全
    private static final AtomicLongFieldUpdater<ChannelOutboundBuffer> TOTAL_PENDING_SIZE_UPDATER =
    AtomicLongFieldUpdater.newUpdater(ChannelOutboundBuffer.class, "totalPendingSize");
    private volatile long totalPendingSize;

    // 可写性位掩码:bit0 表示高水位不可写,bit1~31 为用户自定义可写性标志
    private static final AtomicIntegerFieldUpdater<ChannelOutboundBuffer> UNWRITABLE_UPDATER =
    AtomicIntegerFieldUpdater.newUpdater(ChannelOutboundBuffer.class, "unwritable");
private volatile int unwritable;三个指针各司其职,共同把一条链切成了两个逻辑区间。flushedEntry 指向的段落是"已刷新、等待写出"的区间,unflushedEntry 到 tailEntry 之间是"已入队、尚未刷新"的区间。unflushedEntry 成了这两个区间的分水岭,addFlush 时正是通过移动它来实现区间切换。
此外还有两个容易被忽略的细节。其一,flushed 是一个计数而非指针,它记录的是已刷新区间的 Entry 个数,isEmpty() 与 size() 都直接基于它判断,避免了遍历链表的 O(n) 开销。其二,unwritable 用了一个 int 位掩码而不是布尔值,bit0 专属于高水位状态,bit1 到 bit31 则留给上层通过 setUserDefinedWritability() 自定义,isWritable() 只要发现任一位为 1 就返回 false。
1.2 Entry 单向链表与池化复用
链表的节点是 ChannelOutboundBuffer.Entry 这个静态内部类,它承载了一条待发送消息的全部元信息:
java
io.netty.channel.ChannelOutboundBuffer.Entry

    // 写缓冲区的最小存储单元,通过 Recycler 池化复用
    static final class Entry {
        private static final Recycler<Entry> RECYCLER = new Recycler<Entry>() {
            @Override
            protected Entry newObject(Handle<Entry> handle) {
                return new Entry(handle);
            }
        };

        private final EnhancedHandle<Entry> handle;
        Entry next;              // 链表后继指针
        Object msg;              // 待发送消息
        ByteBuffer[] bufs;       // 复合缓冲:多个 JDK ByteBuffer 的缓存
        ByteBuffer buf;          // 单缓冲:单个 JDK ByteBuffer 的缓存
        ChannelPromise promise;  // 关联的写入结果通知
        long progress;           // 已发送字节数,支持分批续传
        long total;              // 消息总字节数
        int pendingSize;         // 计入 totalPendingSize 的字节(含 Entry 开销)
        int count = -1;          // 可拆出的 nioBuffer 数量,-1 表示惰性计算
        boolean cancelled;       // 是否已被取消

        private Entry(Handle<Entry> handle) {
            this.handle = (EnhancedHandle<Entry>) handle;
        }

        static Entry newInstance(Object msg, int size, long total, ChannelPromise promise) {
            Entry entry = RECYCLER.get();
            entry.msg = msg;
            // 把 Entry 自身的 96 字节对象开销也计入待发送统计
            entry.pendingSize = size + CHANNEL_OUTBOUND_BUFFER_ENTRY_OVERHEAD;
            entry.total = total;
            entry.promise = promise;
            return entry;
        }
    }
Entry 的字段可归纳为三类:next/msg/promise 维系链表结构与回调关系;progress/total/pendingSize 负责发送进度与字节统计;buf/bufs/count 则是 nioBuffers 转换阶段的缓存,避免同一消息在多次写出时重复创建 JDK ByteBuffer 对象。
这里面最值得留意的是 pendingSize 的计算方式。newInstance() 里它等于传入的 size(消息本身可发送的字节数)再加上 CHANNEL_OUTBOUND_BUFFER_ENTRY_OVERHEAD,这个常量默认是 96 字节,对应一个 Entry 对象自身在 64 位 JVM 上的内存占用量。之所以要把对象开销也算进去,是因为待发送字节统计的最终目的是度量真实内存压力,如果只算消息内容而忽略海量小消息情况下 Entry 对象本身的开销,水位判定就会失真。
Entry 的生命周期管理依赖 Recycler<Entry> 对象池。newInstance() 通过 RECYCLER.get() 取实例,unguardedRecycle() 则负责清空字段并归还,二者构成"取用---归还"的闭环。在高速写场景下,频繁创建消息对象是 GC 的重要压力来源,池化让 Entry 得以反复复用,这是 Netty 在写路径上的一处关键优化。
下面这幅图把链表结构与三个指针的指向关系画了出来:
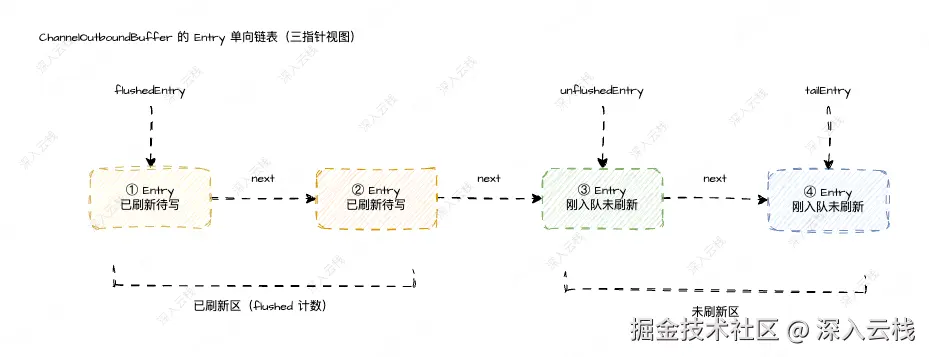
上面的链表结构清晰地展示了三个指针的边界:flushedEntry 是已刷新区间的起点,unflushedEntry 是未刷新区间的起点,而 tailEntry 总是链表尾。随着 addMessage、addFlush、remove 的交替调用,这三个指针会不断在链上移动,从而在不新建容器的情况下动态维护出两个逻辑区间。
二、消息入队:write() 到 addMessage 的链路
2.1 write() 入口:过滤与大小估算
用户调用 Channel.write() 后,经过 Pipeline 一系列出站 handler,最终会落到 AbstractChannel.AbstractUnsafe.write()。它是消息进入 ChannelOutboundBuffer 前必经的关口:
java
io.netty.channel.AbstractChannel.AbstractUnsafe#write

    // 用户 write() 的第一站:先过滤、估算,再入队
    @Override
    public final void write(Object msg, ChannelPromise promise) {
        assertEventLoop();

        ChannelOutboundBuffer outboundBuffer = this.outboundBuffer;
        if (outboundBuffer == null) {
            try {
                // Channel 已关闭,立即释放消息防止泄漏
                ReferenceCountUtil.release(msg);
            } finally {
                safeSetFailure(promise,
                newClosedChannelException(initialCloseCause, "write(Object, ChannelPromise)"));
            }
            return;
        }

        int size;
        try {
            // 过滤 transport 层不支持的消息,再估算字节大小
            msg = filterOutboundMessage(msg);
            size = pipeline.estimatorHandle().size(msg);
            if (size < 0) {
                size = 0;
            }
        } catch (Throwable t) {
            try {
                ReferenceCountUtil.release(msg);
            } finally {
                safeSetFailure(promise, t);
            }
            return;
        }

        outboundBuffer.addMessage(msg, size, promise);
    }
这段代码有两个关键点。一是 outboundBuffer == null 的判断:AbstractUnsafe.close() 在关闭时会把 outboundBuffer 置空,因此一旦为 null 就意味着 Channel 已经关闭,此时需要立即 release(msg) 释放消息、safeSetFailure 失败 promise,避免引用计数泄漏。二是 write 并不做任何真正的 IO,它只做三件事:用 filterOutboundMessage 过滤 transport 层不支持的消息类型(例如将堆内存 ByteBuf 转换为直接内存,避免 JDK 的 SocketChannel.write 对堆缓冲再创建临时直接缓冲),用 pipeline.estimatorHandle().size(msg) 估算消息字节大小,然后将消息连同估算值一并交给 addMessage。
这里出现的 MessageSizeEstimator 是 Netty 用于估算消息大小的抽象,它在无法精确判断消息大小时返回一个默认估计值,size < 0 的兜底则是把未知大小当 0 处理。
2.2 addMessage():链表尾部追加
addMessage 是入队的真正执行者:
java
io.netty.channel.ChannelOutboundBuffer#addMessage

    // 用户调用 write() 时,将消息包装成 Entry 追加到链表尾部
    public void addMessage(Object msg, int size, ChannelPromise promise) {
        // 从回收池创建 Entry,total(msg) 计算消息可发送的字节数
        Entry entry = Entry.newInstance(msg, size, total(msg), promise);
        if (tailEntry == null) {
            // 空队列:清空已刷新起点(说明此前数据都已发出)
            flushedEntry = null;
        } else {
            // 非空队列:把新 Entry 挂到当前尾节点之后
            Entry tail = tailEntry;
            tail.next = entry;
        }
        tailEntry = entry;
        if (unflushedEntry == null) {
            // 记录第一个未刷新的 Entry
            unflushedEntry = entry;
        }

        // touch 消息便于排查引用计数泄漏
        if (msg instanceof AbstractReferenceCountedByteBuf) {
            ((AbstractReferenceCountedByteBuf) msg).touch();
        } else {
            ReferenceCountUtil.touch(msg);
        }

        // 累加待发送字节,超过高水位时置不可写
        incrementPendingOutboundBytes(entry.pendingSize, false);
    }
入队逻辑遵循最朴素的尾插法:用 tailEntry.next = entry 完成链接,再把 tailEntry 自身指向新节点。有两个分支值得注意:当 tailEntry == null(即队列为空)时,代码会把 flushedEntry 置为 null,这是因为空队列意味着此前的数据已全部写出,旧的 flushedEntry 已经失效;当 unflushedEntry == null 时,说明这是当前未刷新区间的第一个 Entry,需要把 unflushedEntry 指向它。
消息入队后还会调用一次 touch。这是专门的泄漏排查机制:touch 会把调用栈信息记录到消息对象中,一旦消息因引用计数未归零而泄漏,泄漏报告里就能定位到是哪一个 write 调用留下的。
最后是 total(msg),它负责算出消息"可发送的字节数",为 Entry.total 与 progress 记录基准:
java
io.netty.channel.ChannelOutboundBuffer#total

    // 按消息类型计算"可发送字节数",无法估算的类型返回 -1
    private static long total(Object msg) {
        if (msg instanceof ByteBuf) {
            return ((ByteBuf) msg).readableBytes();
        }
        if (msg instanceof FileRegion) {
            return ((FileRegion) msg).count();
        }
        if (msg instanceof ByteBufHolder) {
            return ((ByteBufHolder) msg).content().readableBytes();
        }
        return -1;
}可以看到它针对三种类型分别取字节数:ByteBuf 取可读字节,FileRegion(用于零拷贝文件传输)取文件长度,ByteBufHolder(如 HTTP 消息体)取其内容可读字节。其余类型一律返回 -1 表示无法精确估算。
上面的入队链路可以用下面这幅时序图完整呈现:
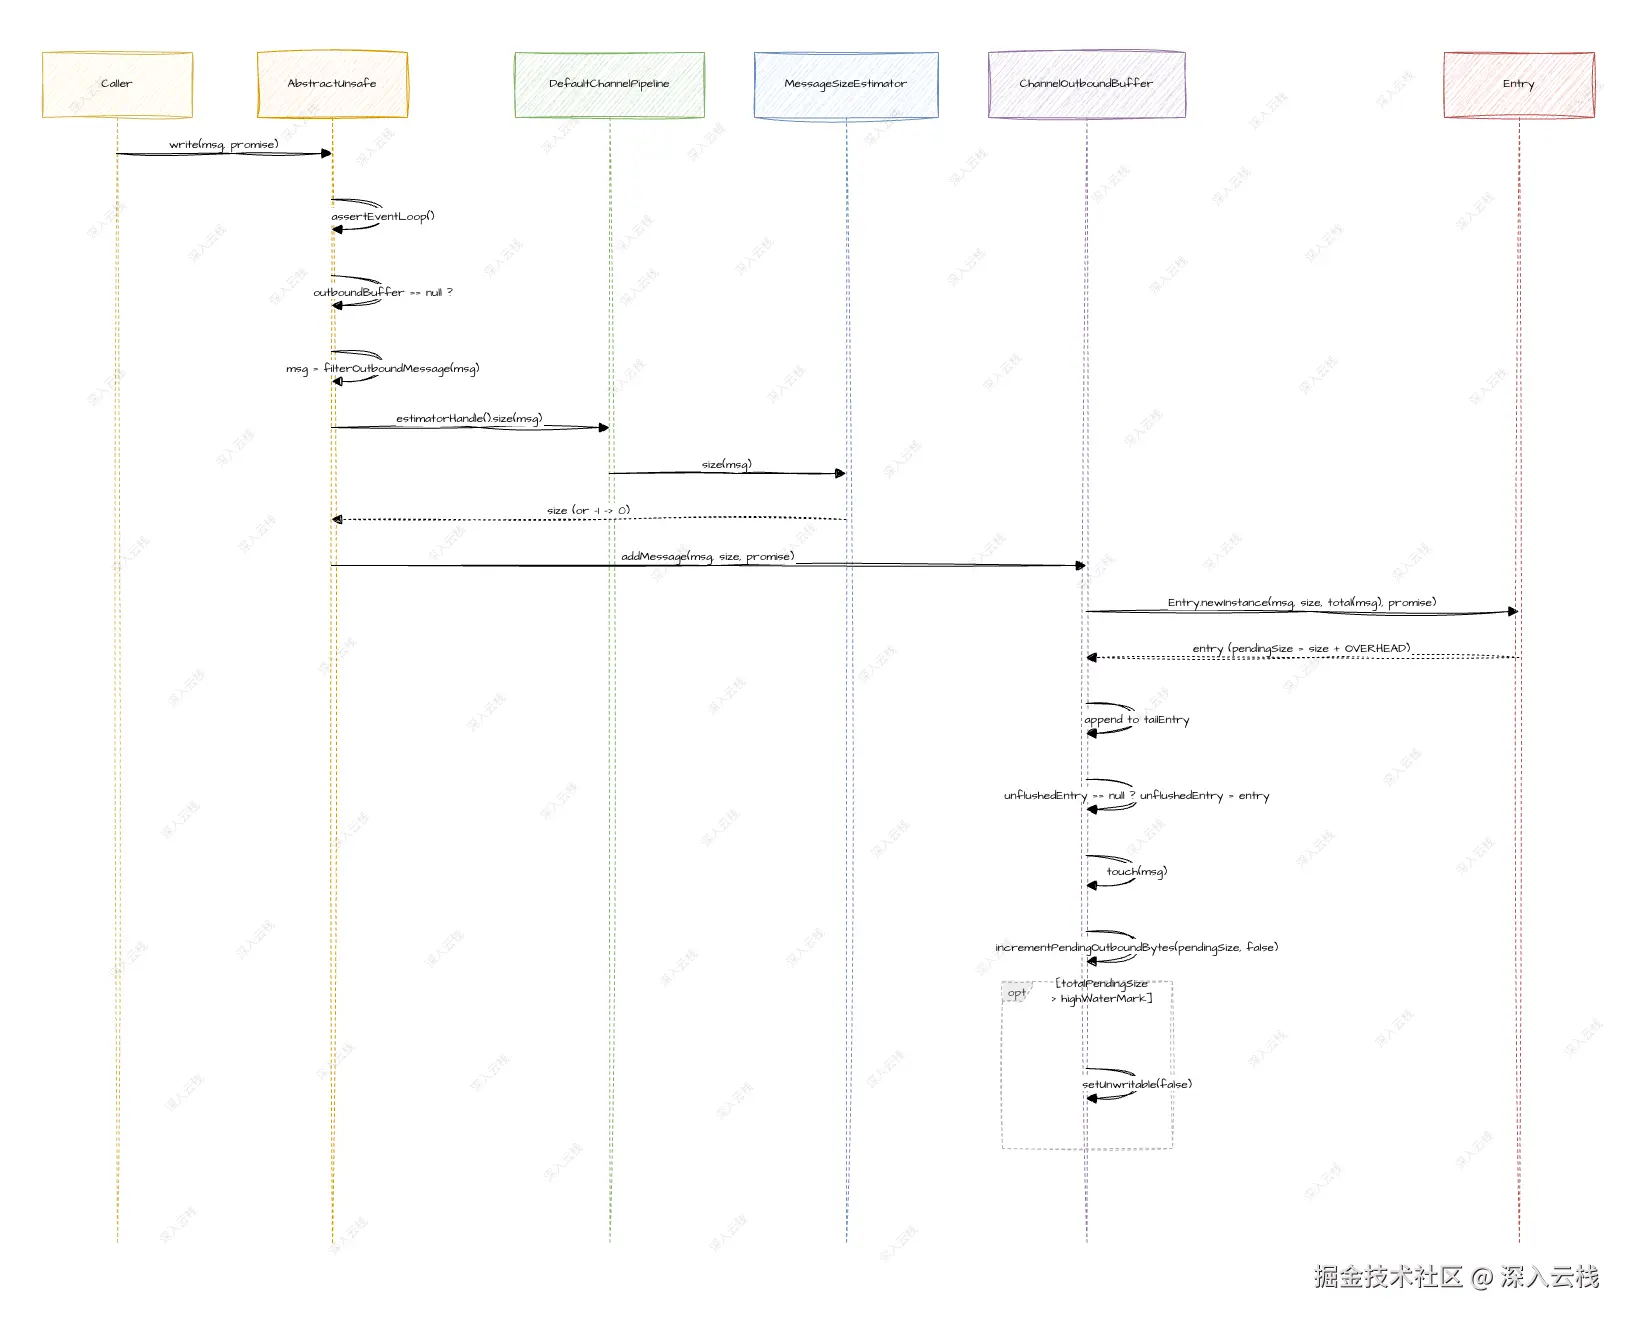
上面的时序图清晰地展示了从 write() 到消息真正挂上链表的完整链路:AbstractUnsafe.write() 先做前置处理,随后 addMessage 创建 Entry、执行尾插、touch 并累加待发送字节,若累加后越过 highWaterMark 则触发 setUnwritable。值得注意的是,此时并没有发生任何真正的网络写,消息只是安静地躺在链表里。
三、标记刷新:flush() 到 addFlush 的语义切换
3.1 flush() 与 flush0()
write() 只入队、不落盘,这是 Netty 出站路径上最重要的语义设计之一。它把"写数据"与"真正发出数据"两个动作解耦,让上层可以在一次 flush() 之前连续调用多次 write(),从而将多条消息合并成一次系统调用批量刷出,显著减少了 writev/send 这类系统调用的次数。
flush() 的入口同样在 AbstractUnsafe 中:
java
io.netty.channel.AbstractChannel.AbstractUnsafe#flush

    // 用户 flush() 的第一站:先标记刷新,再真正执行写出
    @Override
    public final void flush() {
        assertEventLoop();

        ChannelOutboundBuffer outboundBuffer = this.outboundBuffer;
        if (outboundBuffer == null) {
            return;
        }

        outboundBuffer.addFlush();
        flush0();
    }
flush() 只做两件事:先调用 addFlush 把未刷新区间整体切换为已刷新,再调用 flush0 触发真正的写出。outboundBuffer == null 时直接返回,因为 Channel 已关闭的场景下没有需要刷新的数据。
flush0 是写出前最后的把关:
java
io.netty.channel.AbstractChannel.AbstractUnsafe#flush0

    // 处理完所有前置检查后,把已刷新数据交给 transport 层循环写出
    protected void flush0() {
        if (inFlush0) {
            // 避免重入:同一线程内有 write/flush 相互回调时不重复写出
            return;
        }

        final ChannelOutboundBuffer outboundBuffer = this.outboundBuffer;
        if (outboundBuffer == null || outboundBuffer.isEmpty()) {
            return;
        }

        inFlush0 = true;

        // Channel 未激活时,所有待发送消息直接标记失败
        if (!isActive()) {
            try {
                if (!outboundBuffer.isEmpty()) {
                    if (isOpen()) {
                        outboundBuffer.failFlushed(new NotYetConnectedException(), true);
                    } else {
                        // Channel 已关闭,不再触发 channelWritabilityChanged
                        outboundBuffer.failFlushed(newClosedChannelException(initialCloseCause, "flush0()"), false);
                    }
                }
            } finally {
                inFlush0 = false;
            }
            return;
        }

        try {
            doWrite(outboundBuffer);
        } catch (Throwable t) {
            handleWriteError(t);
        } finally {
            inFlush0 = false;
        }
    }
flush0 有三个职责:一是用 inFlush0 布尔标记做重入保护,防止某个 write() 的回调间接再次触发 flush() 造成无限递归;二是对未激活的 Channel 直接把已刷新消息 failFlushed 快速失败;三是真正调用 doWrite(outboundBuffer) 把数据交给 transport 层。doWrite 属于底层 IO 下沉的范畴,本文点到为止,我们接下来把重点放回 addFlush。
3.2 addFlush():整体切换已刷新区
addFlush 是本节的核心,它完成了"未刷新"到"已刷新"的区间切换:
java
io.netty.channel.ChannelOutboundBuffer#addFlush

    // 用户调用 flush() 时,把未刷新区整体切到已刷新区
    public void addFlush() {
        Entry entry = unflushedEntry;
        if (entry != null) {
            if (flushedEntry == null) {
                // 此前没有已刷新节点,本次作为新的发送起点
                flushedEntry = entry;
            }
            do {
                flushed++;
                if (!entry.promise.setUncancellable()) {
                    // promise 已被取消:释放消息并回收统计
                    int pending = entry.cancel();
                    decrementPendingOutboundBytes(pending, false, true);
                }
                entry = entry.next;
            } while (entry != null);

            // 全部已刷新,清空未刷新起点
            unflushedEntry = null;
        }
    }
addFlush 从 unflushedEntry 出发向后遍历。如果此前 flushedEntry == null,说明这是本轮的第一批已刷新数据,需要把 flushedEntry 指向当前节点作为新的发送起点;否则说明链表头部还有上一轮未写完的数据,flushedEntry 保持不变,两批数据在链上自然衔接成一段连续的已刷新区间。
遍历过程中每走一步 flushed++ 维护计数,同时调用 promise.setUncancellable()。这个方法返回 false 意味着 promise 已被用户取消(例如写操作超时被主动取消),此时数据不能再写出,需要通过 entry.cancel() 释放消息并 decrementPendingOutboundBytes 回收字节统计:
java
io.netty.channel.ChannelOutboundBuffer.Entry#cancel

    // 取消该 Entry:释放消息,用空缓冲占位,返回回收的字节数
    int cancel() {
        if (!cancelled) {
            cancelled = true;
            int pSize = pendingSize;
            // 释放消息并替换为空缓冲,避免后续写出时用到已释放的资源
            ReferenceCountUtil.safeRelease(msg);
            msg = Unpooled.EMPTY_BUFFER;
            pendingSize = 0;
            total = 0;
            progress = 0;
            bufs = null;
            buf = null;
            return pSize;
        }
        return 0;
    }
cancel() 的巧妙之处在于它并不把 Entry 从链表中摘除,而是把 msg 替换成 Unpooled.EMPTY_BUFFER 这个空缓冲并置 cancelled = true。这样做的原因在于,链表的结构调整在 addFlush 这种高频路径上代价不菲,而一个"已取消"的占位节点在后续 nioBuffers 遍历时会因 cancelled 标记被直接跳过,语义上等同移除,却避开了指针的现场维护。这也是 Netty 用"惰性"换取性能的一个典型例子。
从 write() 到 flush() 的语义切换,可以概括为下面这幅时序图:
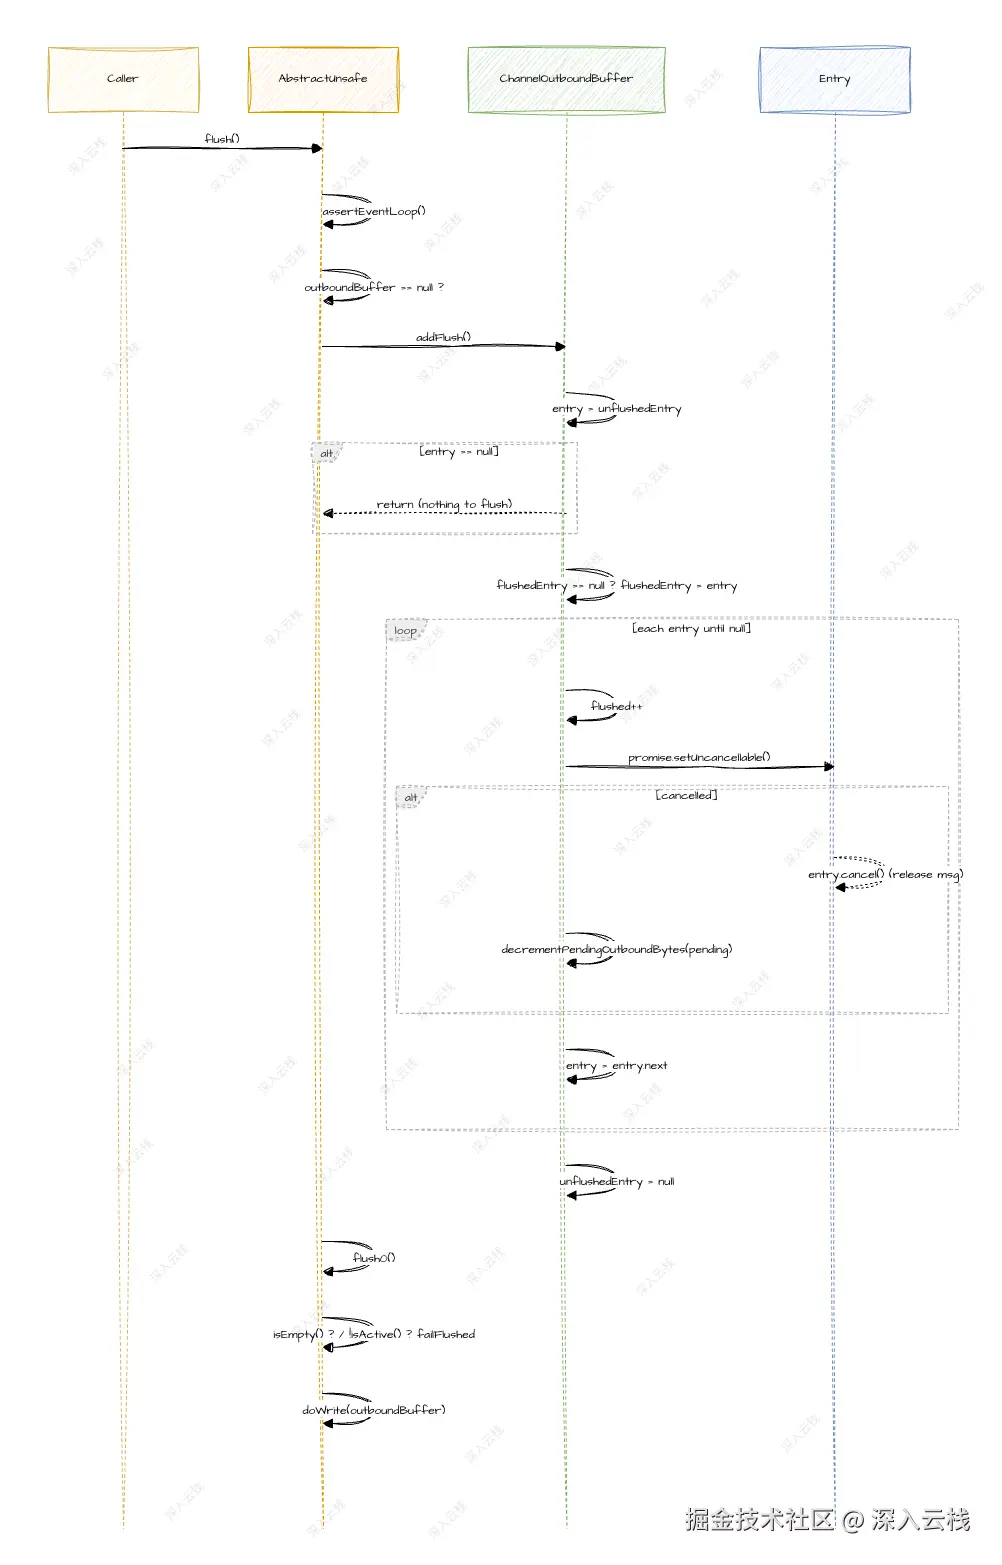
上面的时序图清晰地展示了刷新语义切换的完整过程:flush() 先经 addFlush 把 unflushedEntry 之后的整段链表并入已刷新区,同时用 setUncancellable 过滤已取消的消息,最后交给 flush0 决定是快速失败还是真正写出。
四、批量写出:nioBuffers() 的 ByteBuffer 转换
4.1 遍历转换与溢出保护
flush0 最终会调用 doWrite(outboundBuffer),而 transport 层的 doWrite 要做的第一件事,就是从 ChannelOutboundBuffer 里取出一批可以直接交给操作系统写的数据。这就是 nioBuffers 的职责:把链表中连续的、类型为 ByteBuf 的消息,批量转换为 JDK 的 ByteBuffer[],供 NIO 的 SocketChannel.write(ByteBuffer[]) 一次性 gather-write。
java
io.netty.channel.ChannelOutboundBuffer#nioBuffers

    // 把已刷新的 ByteBuf 批量转换为 JDK ByteBuffer[],供 transport 用 writev 写出
    public ByteBuffer[] nioBuffers(int maxCount, long maxBytes) {
        assert maxCount > 0;
        assert maxBytes > 0;
        long nioBufferSize = 0;
        int nioBufferCount = 0;
        final InternalThreadLocalMap threadLocalMap = InternalThreadLocalMap.get();
        ByteBuffer[] nioBuffers = NIO_BUFFERS.get(threadLocalMap);
        Entry entry = flushedEntry;
        while (isFlushedEntry(entry) && entry.msg instanceof ByteBuf) {
            if (!entry.cancelled) {
                ByteBuf buf = (ByteBuf) entry.msg;
                final int readerIndex = buf.readerIndex();
                final int readableBytes = buf.writerIndex() - readerIndex;

                if (readableBytes > 0) {
                    // maxBytes 溢出保护:避免单次 writev 超过 Integer.MAX_VALUE 触发 EINVAL
                    if (maxBytes - readableBytes < nioBufferSize && nioBufferCount != 0) {
                        break;
                    }
                    nioBufferSize += readableBytes;
                    int count = entry.count;
                    if (count == -1) {
                        // 惰性计算该消息可拆出的 buffer 数并缓存
                        entry.count = count = buf.nioBufferCount();
                    }
                    int neededSpace = min(maxCount, nioBufferCount + count);
                    if (neededSpace > nioBuffers.length) {
                        // 数组不够大,两倍扩容
                        nioBuffers = expandNioBufferArray(nioBuffers, neededSpace, nioBufferCount);
                        NIO_BUFFERS.set(threadLocalMap, nioBuffers);
                    }
                    if (count == 1) {
                        ByteBuffer nioBuf = entry.buf;
                        if (nioBuf == null) {
                            // 缓存单缓冲,避免重复创建 ByteBuffer 实例
                            entry.buf = nioBuf = buf.internalNioBuffer(readerIndex, readableBytes);
                        }
                        nioBuffers[nioBufferCount++] = nioBuf;
                    } else {
                        // 复合缓冲分支单独成方法,避免主方法过大导致无法内联
                        nioBufferCount = nioBuffers(entry, buf, nioBuffers, nioBufferCount, maxCount);
                    }
                    if (nioBufferCount >= maxCount) {
                        break;
                    }
                }
            }
            entry = entry.next;
        }
        this.nioBufferCount = nioBufferCount;
        this.nioBufferSize = nioBufferSize;

        return nioBuffers;
}遍历的终止条件很讲究:isFlushedEntry(entry) 判定 entry 非空且尚未越过 unflushedEntry,entry.msg instanceof ByteBuf 则保证返回的数组里只有 ByteBuf,一旦遇到 FileRegion 这类不支持 gather-write 的消息就立即停止,把非 ByteBuf 的消息留给 doWrite 走单条写路径处理。
maxBytes 的溢出保护是这段代码的隐藏要点。BSD 与 macOS 不允许单次 writev 写入超过 Integer.MAX_VALUE 字节,超限会返回 EINVAL 并抛 IOException;即便在 Linux 上也可能因架构不同而行为不一。因此代码在累加 nioBufferSize 前先判断 maxBytes - readableBytes < nioBufferSize,一旦超过就跳出循环,宁可少带一批也要保证一次系统调用合法。
4.2 数组复用与两倍扩容
返回的 ByteBuffer[] 并不新鲜,它来自 NIO_BUFFERS 这个 FastThreadLocal:
java
io.netty.channel.ChannelOutboundBuffer#NIO_BUFFERS

    // 线程本地复用的 ByteBuffer 数组,避免每次写出都新建数组
    private static final FastThreadLocal<ByteBuffer[]> NIO_BUFFERS = new FastThreadLocal<ByteBuffer[]>() {
        @Override
        protected ByteBuffer[] initialValue() throws Exception {
            return new ByteBuffer[1024];
        }
    };
借助 FastThreadLocal,每个 IO 线程都持有自己的一份 ByteBuffer[1024] 数组,nioBuffers 反复复用同一块缓冲区而不必每次分配。这正是类注释反复强调"返回的数组被复用、绝不能逃逸出 doWrite 调用"的原因,数组的生命周期由线程本地管理,一旦被上层缓存引用,下次写出时内容就会被覆盖。与之配套的是两个记录本次结果的方法 nioBufferCount() 与 nioBufferSize(),它们必须在 nioBuffers 之后立即调用才有意义。
当单批转换出的 buffer 数量超过当前数组长度时,expandNioBufferArray 会按两倍扩容并迁移旧数据:
java
io.netty.channel.ChannelOutboundBuffer#expandNioBufferArray

    // 数组容量不足时翻倍扩容,采用 System.arraycopy 迁移旧元素
    private static ByteBuffer[] expandNioBufferArray(ByteBuffer[] array, int neededSpace, int size) {
        int newCapacity = array.length;
        do {
            // 翻倍直到容量满足需求,参见 Netty#1890
            newCapacity <<= 1;
            if (newCapacity < 0) {
                throw new IllegalStateException();
            }
        } while (neededSpace > newCapacity);

        ByteBuffer[] newArray = new ByteBuffer[newCapacity];
        System.arraycopy(array, 0, newArray, 0, size);
        return newArray;
}这里还有一处缓存设计值得一提:count == 1 时用 entry.buf 缓存单个 JDK ByteBuffer,count > 1 时用 entry.bufs 缓存 ByteBuffer[],配合 count == -1 的惰性计算,保证同一消息在多轮部分写出的场景下不会重复调用 internalNioBuffer() 与 nioBuffers 去创建对象。
整个转换流程可以概括为下面的时序图:
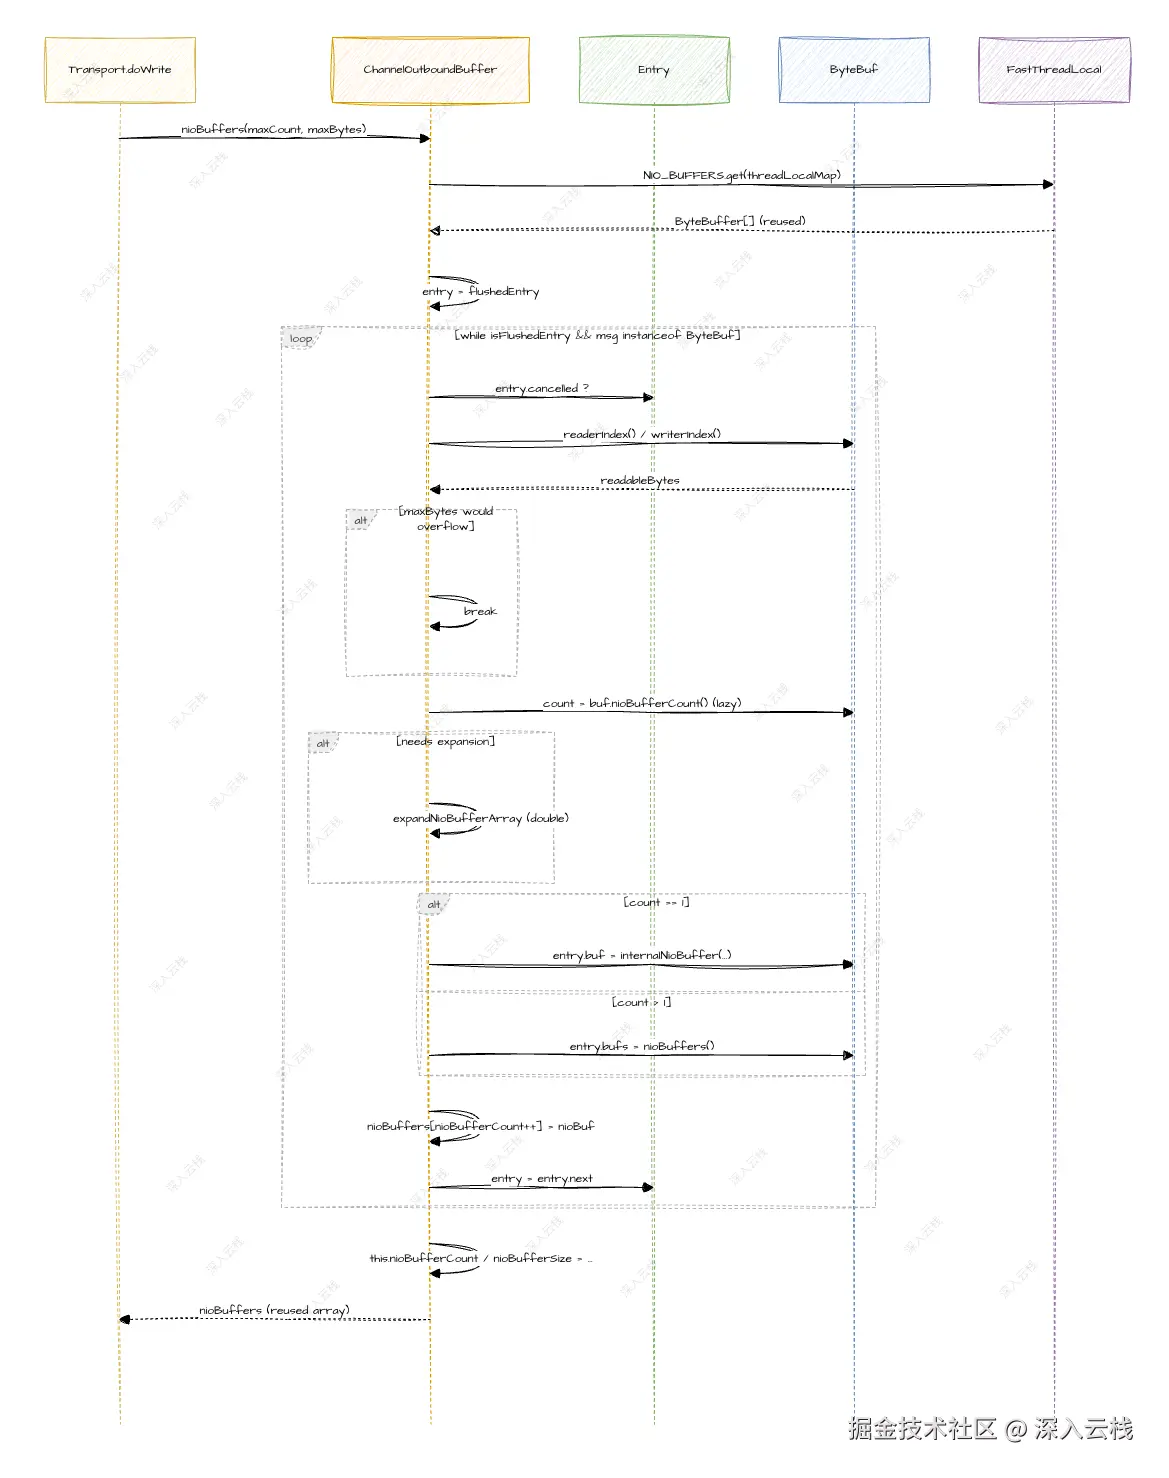
上面的时序图清晰地展示了批量转换的完整过程:doWrite 拿到线程本地的复用数组后,nioBuffers 从 flushedEntry 遍历已刷新 Entry,逐个把 ByteBuf 切成 JDK ByteBuffer,途中受 maxCount、maxBytes 双重约束,并在容量不足时两倍扩容,最终返回可直接写出的数组。
五、发送确认与清理:remove/removeBytes 的进度管理
5.1 remove() 与三指针连锁调整
doWrite 完成一次系统调用后,需要根据实际写出的字节数把已完成的 Entry 从链表中移除,并通知对应的 promise。这个职责由 remove、remove(Throwable) 与 removeBytes 三个方法分担。
remove 处理"整条消息已完全写出"的场景,既通知成功也负责释放:
java
io.netty.channel.ChannelOutboundBuffer#remove

    // 移除当前已刷新的消息,通知成功并归还回收池
    public boolean remove() {
        Entry e = flushedEntry;
        if (e == null) {
            clearNioBuffers();
            return false;
        }
        Object msg = e.msg;
        ChannelPromise promise = e.promise;
        int size = e.pendingSize;

        removeEntry(e);

        // 消息未被取消才释放、通知、扣减统计
        if (!e.cancelled) {
            if (msg instanceof AbstractReferenceCountedByteBuf) {
                try {
                    ((AbstractReferenceCountedByteBuf) msg).release();
                } catch (Throwable t) {
                    logger.warn("Failed to release a ByteBuf: {}", msg, t);
                }
            } else {
                ReferenceCountUtil.safeRelease(msg);
            }
            safeSuccess(promise);
            decrementPendingOutboundBytes(size, false, true);
        }

        // 归还回收池
        e.unguardedRecycle();
        return true;
}正确路径下,remove 依次做三件事:removeEntry(e) 调整链表指针,release + safeSuccess 释放消息并通知 promise 成功,decrementPendingOutboundBytes 扣减待发送字节统计。最后 unguardedRecycle() 把 Entry 归还对象池。失败路径则由 remove(Throwable cause) 承担,逻辑几乎一致,只是把 safeSuccess 换成 safeFail(promise, cause),用于 Channel 关闭或写出异常时批量清场。
链表指针的连锁调整封装在 removeEntry 里:
java
io.netty.channel.ChannelOutboundBuffer#removeEntry

    // 移除链首 Entry 并连锁调整三指针
    private void removeEntry(Entry e) {
        if (--flushed == 0) {
            // 已处理完所有刷新消息,清空整条链表
            flushedEntry = null;
            if (e == tailEntry) {
                tailEntry = null;
                unflushedEntry = null;
            }
        } else {
            // 还有待写消息,起点后移一格
            flushedEntry = e.next;
        }
    }
removeEntry 先把 flushed 计数减一。若减到 0,说明已刷新区间已被全部写出,此时把 flushedEntry 置 null,并且当被移除的 Entry 恰好也是 tailEntry 时,把 tailEntry 与 unflushedEntry 一并置 null,即整条链表彻底清空;否则,说明后面还有待写节点,只需把 flushedEntry 后移到 e.next 即可。
5.2 removeBytes() 与部分写出续传
真实网络写很少一次写完整批数据。SocketChannel.write(ByteBuffer[]) 可能只写出部分字节便返回,这时就需要 removeBytes 来精确推进:
java
io.netty.channel.ChannelOutboundBuffer#removeBytes

    // 发送后按实际写出字节推进 readerIndex,支持部分写出续传
    public void removeBytes(long writtenBytes) {
        for (;;) {
            Object msg = current();
            if (!(msg instanceof ByteBuf)) {
                assert writtenBytes == 0;
                break;
            }

            final ByteBuf buf = (ByteBuf) msg;
            final int readerIndex = buf.readerIndex();
            final int readableBytes = buf.writerIndex() - readerIndex;

            if (readableBytes <= writtenBytes) {
                // 该消息已全部写出,推进进度后移除
                if (writtenBytes != 0) {
                    progress(readableBytes);
                    writtenBytes -= readableBytes;
                }
                remove();
            } else { // readableBytes > writtenBytes
                // 只写出了一部分,前进 readerIndex 记为续传位置
                if (writtenBytes != 0) {
                    buf.readerIndex(readerIndex + (int) writtenBytes);
                    progress(writtenBytes);
                }
                break;
            }
        }
        clearNioBuffers();
    }
removeBytes 的核心是一个贪心循环:对每个链首消息,比较它的 readableBytes 与剩余 writtenBytes。若 readableBytes <= writtenBytes,说明这条消息已完全写出,先 progress(readableBytes) 记录进度,再扣减剩余字节并 remove 移除;若 readableBytes > writtenBytes,说明只写出了一部分,把 readerIndex 前进 writtenBytes 字节作为下次续传的起点,然后 break 结束本轮。最后 clearNioBuffers() 会把线程本地数组里已填充的元素清空,从而释放对 JDK ByteBuffer 的强引用,让它能被 GC 回收。
对于支持进度的 promise,progress 会在写出过程中持续通知:
java
io.netty.channel.ChannelOutboundBuffer#progress

    // 推进当前消息的发送进度,并向进度型 promise 传播
    public void progress(long amount) {
        Entry e = flushedEntry;
        assert e != null;
        ChannelPromise p = e.promise;
        long progress = e.progress + amount;
        e.progress = progress;
        assert p != null;
        final Class<?> promiseClass = p.getClass();
        // fast-path:跳过 O(n) 的类型判断,避免热点路径上的类型污染
        if (promiseClass == VoidChannelPromise.class || promiseClass == DefaultChannelPromise.class) {
            return;
        }
        if (p instanceof DefaultChannelProgressivePromise) {
            ((DefaultChannelProgressivePromise) p).tryProgress(progress, e.total);
        } else if (p instanceof ChannelProgressivePromise) {
            ((ChannelProgressivePromise) p).tryProgress(progress, e.total);
        }
    }
这段代码先做一次 promiseClass 的 fast-path 判断,跳过绝大多数普通 promise,再对 ChannelProgressivePromise 调用 tryProgress(progress, total) 传播进度。之所以把 VoidChannelPromise 和 DefaultChannelPromise 单列出来做类相等判断,是为了减少 instanceof 在热点路径上的类型污染开销。
下面的时序图概括了发送确认与清理的完整流程:
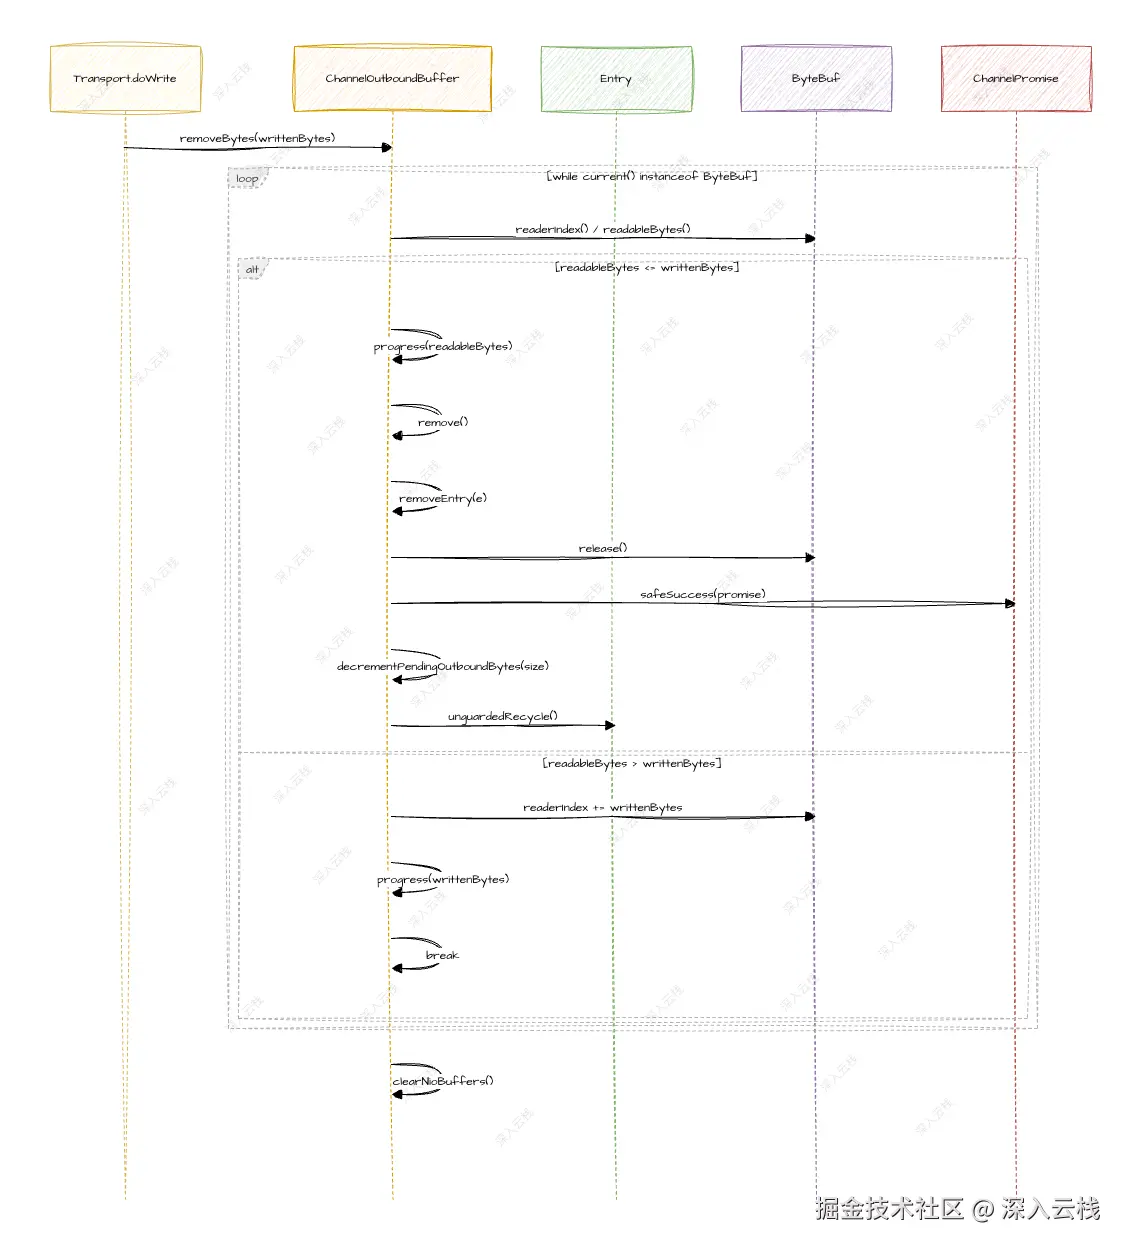
上面的时序图清晰地展示了发送完成后的清理过程:removeBytes 按实际写出字节数推进 readerIndex,完全写出的消息走 remove 释放并通知 promise,部分写出的消息只前进读取位置等待下轮续传,最后 clearNioBuffers() 释放数组引用。
六、高低水位流量控制:totalPendingSize 与可写性判定
6.1 WriteBufferWaterMark 的滞回设计
前文多次出现的 incrementPendingOutboundBytes 与 decrementPendingOutboundBytes,正是流量控制的抓手。它们的核心是维护 totalPendingSize 这一全局待发送字节计数,并与高低水位比较:
java
io.netty.channel.ChannelOutboundBuffer#incrementPendingOutboundBytes / #decrementPendingOutboundBytes

    // 累加待发送字节,超过高水位时置不可写
    private void incrementPendingOutboundBytes(long size, boolean invokeLater) {
        if (size == 0) {
            return;
        }
        long newWriteBufferSize = TOTAL_PENDING_SIZE_UPDATER.addAndGet(this, size);
        if (newWriteBufferSize > channel.config().getWriteBufferHighWaterMark()) {
            setUnwritable(invokeLater);
        }
    }

    // 扣减待发送字节,跌破低水位时恢复可写
    private void decrementPendingOutboundBytes(long size, boolean invokeLater, boolean notifyWritability) {
        if (size == 0) {
            return;
        }
        long newWriteBufferSize = TOTAL_PENDING_SIZE_UPDATER.addAndGet(this, -size);
        if (notifyWritability && newWriteBufferSize < channel.config().getWriteBufferLowWaterMark()) {
            setWritable(invokeLater);
        }
    }
这里的高低水位由 WriteBufferWaterMark 定义:
java
io.netty.channel.WriteBufferWaterMark

    // 高低水位标记:默认低水位 32KB、高水位 64KB
    public final class WriteBufferWaterMark {
        private static final int DEFAULT_LOW_WATER_MARK = 32 * 1024;
        private static final int DEFAULT_HIGH_WATER_MARK = 64 * 1024;

        public static final WriteBufferWaterMark DEFAULT =
        new WriteBufferWaterMark(DEFAULT_LOW_WATER_MARK, DEFAULT_HIGH_WATER_MARK, false);

        private final int low;
        private final int high;

        public WriteBufferWaterMark(int low, int high) {
            this(low, high, true);
        }

        // 校验高低水位合法性,high 不能小于 low
        WriteBufferWaterMark(int low, int high, boolean validate) {
            if (validate) {
                checkPositiveOrZero(low, "low");
                if (high < low) {
                    throw new IllegalArgumentException(
                    "write buffer's high water mark cannot be less than " +
                    " low water mark (" + low + "): " + high);
                }
            }
            this.low = low;
            this.high = high;
        }
}所谓滞回(hysteresis) ,是指变不可写与恢复可写用的是两个不同的阈值:待发送字节超过 high(64KB)才 setUnwritable,而恢复可写要等到字节跌破 low(32KB)才 setWritable。这两个阈值之间隔着一个 32KB 的缓冲带,字节数在这个区间内来回波动时不会触发任何状态切换,从而避免了在单一阈值附近反复横跳导致的"可写---不可写"抖动。
这两个阈值都来自 WriteBufferWaterMark.DEFAULT,它通过 DefaultChannelConfig 的 writeBufferWaterMark 字段设到每个 Channel 上,getWriteBufferHighWaterMark() 与 getWriteBufferLowWaterMark() 毫厘不差地返回 high() 与 low()。用户也可以通过 ChannelConfig.setWriteBufferWaterMark() 自定义阈值,构造器的 high < low 校验则在事前拦截了非法配置。
6.2 可写性切换与事件传播
状态切换最终落到 unwritable 这个 int 位掩码上,由 setUnwritable 与 setWritable 两个 CAS 方法完成:
java
io.netty.channel.ChannelOutboundBuffer#setWritable / #setUnwritable

    // 重新变可写:清除 bit0
    private void setWritable(boolean invokeLater) {
        for (;;) {
            final int oldValue = unwritable;
            final int newValue = oldValue & ~1;
            if (UNWRITABLE_UPDATER.compareAndSet(this, oldValue, newValue)) {
                // 仅当从"完全不可写"跨越到"完全可写"时才触发事件
                if (oldValue != 0 && newValue == 0) {
                    fireChannelWritabilityChanged(invokeLater);
                }
                break;
            }
        }
    }

    // 变不可写:置位 bit0
    private void setUnwritable(boolean invokeLater) {
        for (;;) {
            final int oldValue = unwritable;
            final int newValue = oldValue | 1;
            if (UNWRITABLE_UPDATER.compareAndSet(this, oldValue, newValue)) {
                // 仅当从"可写"跨越到"不可写"的边沿才触发事件
                if (oldValue == 0) {
                    fireChannelWritabilityChanged(invokeLater);
                }
                break;
            }
        }
    }
两个方法都用 CAS 自旋保证并发安全,但真正精妙的是事件触发条件。setUnwritable 只在 oldValue == 0(从完全可写跨越到不可写的边沿)时触发;setWritable 只在 oldValue != 0 && newValue == 0(从不可写完全回到可写)时触发。这既与前述滞回设计呼应,也避免了每次字节增减都重复派发事件。
事件的分发由 fireChannelWritabilityChanged 完成:
java
io.netty.channel.ChannelOutboundBuffer#fireChannelWritabilityChanged

    // 把可写性变化转化为 Pipeline 事件,供上层实现背压
    private void fireChannelWritabilityChanged(boolean invokeLater) {
        final ChannelPipeline pipeline = channel.pipeline();
        if (invokeLater) {
            // 异步投递:包装成任务交给 EventLoop,避免在调用栈内重入
            Runnable task = fireChannelWritabilityChangedTask;
            if (task == null) {
                fireChannelWritabilityChangedTask = task = new Runnable() {
                    @Override
                    public void run() {
                        pipeline.fireChannelWritabilityChanged();
                    }
                };
            }
            channel.eventLoop().execute(task);
        } else {
            pipeline.fireChannelWritabilityChanged();
        }
    }
invokeLater 为 true 时,事件不会在调用栈内同步派发,而是包装成 Runnable 交给 EventLoop 异步执行,并且这个任务被缓存到 fireChannelWritabilityChangedTask 字段复用。之所以需要异步投递,是因为 incrementPendingOutboundBytes(size)、decrementPendingOutboundBytes(size) 这两个公开的包级方法标注了线程安全,可能被 EventLoop 之外的线程调用(例如上层 handler 借助 DefaultChannelPipeline 的钩子追踪待发送数据),此时 Pipeline 事件必须投递回 EventLoop 线程执行。
可写性状态最终通过 isWritable()、bytesBeforeUnwritable()、bytesBeforeWritable() 三个方法暴露给上层:
java
io.netty.channel.ChannelOutboundBuffer#isWritable / #bytesBeforeUnwritable / #bytesBeforeWritable

    // 只有位掩码全 0 才是可写
    public boolean isWritable() {
        return unwritable == 0;
    }

    // 还能写多少字节才会变成不可写(+1 是因为只有越过阈值才切换)
    public long bytesBeforeUnwritable() {
        long bytes = channel.config().getWriteBufferHighWaterMark() - totalPendingSize + 1;
        return bytes > 0 && isWritable() ? bytes : 0;
    }

    // 还需排空多少字节才能恢复可写
    public long bytesBeforeWritable() {
        long bytes = totalPendingSize - channel.config().getWriteBufferLowWaterMark() + 1;
        return bytes <= 0 || isWritable() ? 0 : bytes;
    }
两个 bytesBefore* 方法都做了 +1 修正,这与"越过阈值才切换"的语义严格对应,当 totalPendingSize 恰好等于 high 时其实仍可写,还需要再多 1 字节才会越过阈值。上层据此可以预先感知水位逼近情况,在真正不可写之前平滑地降低写入速率。
把待发送字节数与水位、可写性的关系画出来,是这样一幅图:
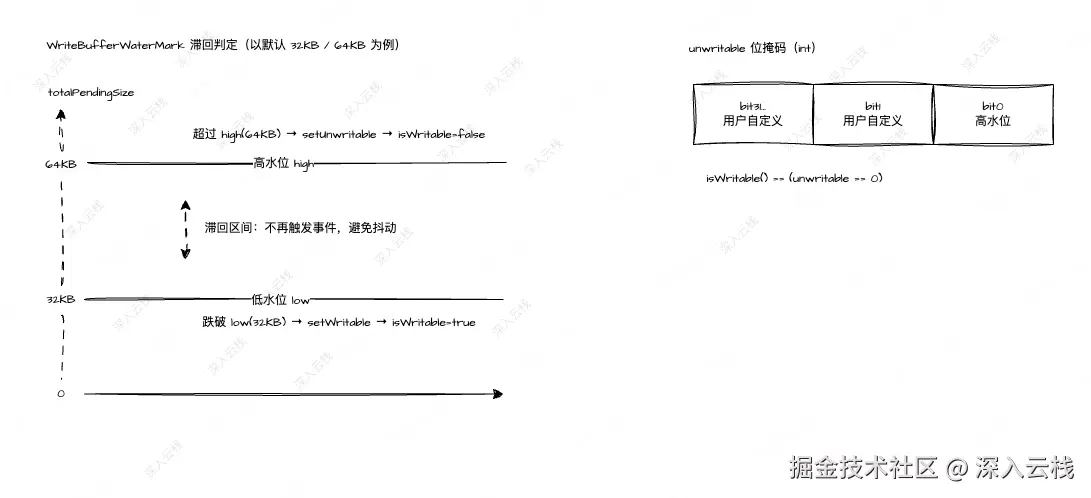
上面的水位图清晰地展示了滞回判定的两条阈值线:字节数向上越过 64KB 的 high 才变不可写,向下跌破 32KB 的 low 才恢复可写,中间 32KB 的缓冲带杜绝了状态抖动。
需要特别说明的是背压的落地方式。fireChannelWritabilityChanged 只是把一个事件沿 Pipeline 传播出去,Netty 内核并不内置 "自动停读"。上层需要在自己的 handler 中覆写 channelWritabilityChanged,当发现 Channel 不可写时调用 channel.config().setAutoRead(false) 取消 OP_READ 关注、暂停读入,待写出数据排空、Channel 恢复可写后再 setAutoRead(true) 恢复。这是一种把控制权交给上层的设计,是否停读、停读的粒度、何时恢复,都由业务自主决定。
七、整体链路串联
把前六节的内容串联起来,ChannelOutboundBuffer 的完整闭环是这样一条链路。用户 write() 时,消息经 filterOutboundMessage 与 size() 估算后由 addMessage 挂到 tailEntry;用户 flush() 时,addFlush 把 unflushedEntry 切到已刷新区,flush0 触发 doWrite;doWrite 调用 nioBuffers 获取 ByteBuffer[] 批量写出,再按实际写出字节数调用 removeBytes 推进 readerIndex、传播 progress 并 remove 清理已发完的 Entry。
这条主链路之上还并行着一条"水位流":totalPendingSize 随 addMessage 累加、随 removeBytes 扣减,与 WriteBufferWaterMark 的 high/low 比较后驱动 unwritable 位掩码切换,最终经 fireChannelWritabilityChanged 转化为 Pipeline 事件,向上层传递背压信号。把这七个环节与它们操作的关键字段整理成下表:
| 环节 | 入口方法 | 操作的三指针/字段 | 关键副作用 |
|---|---|---|---|
| 入队 | addMessage | tailEntry / unflushedEntry | pendingSize 累加 totalPendingSize |
| 刷新 | addFlush | flushedEntry / unflushedEntry | flushed++,setUncancellable 过滤取消 |
| 转换 | nioBuffers | flushedEntry 遍历 | 写 nioBufferCount / nioBufferSize |
| 写出 | doWrite(transport) | ByteBuffer\[\] | 系统调用 writev |
| 清理 | removeBytes / remove | flushedEntry 后移 | release + promise 通知 + 回收统计 |
| 背压 | increment / decrement | totalPendingSize / unwritable | 触发 channelWritabilityChanged |
纵观全貌,ChannelOutboundBuffer 的设计思想可以凝练为 "三指针单向链表 + 延迟刷新 + 滞回水位" 。flushedEntry、unflushedEntry、tailEntry 用一条链同时串起已刷新与未刷新数据,write 只入队、flush 才刷新,把多次写合并成一次批量提交;WriteBufferWaterMark 的 high/low 滞回判定则在杜绝状态抖动的同时,把内部写压力转化为上层可感知的 channelWritabilityChanged 事件,让背压机制得以优雅落地。
全文小结
本文聚焦 Netty 的写缓冲区 ChannelOutboundBuffer,从数据结构设计与高低水位流量控制两个维度,深入分析了 Entry 单向链表的组织方式、write/flush 的入队与刷新语义、nioBuffers 的批量转换以及 removeBytes 的发送清理。
在数据结构层面,ChannelOutboundBuffer 用 flushedEntry、unflushedEntry、tailEntry 三个指针把 Entry 单向链表切分为已刷新区与未刷新区,Entry 通过 Recycler 池化复用并把 96 字节对象开销计入 pendingSize。在入队与刷新层面,write() 只经 filterOutboundMessage 与 size() 估算后 addMessage 追加到链表尾,flush() 才经 addFlush 把 unflushedEntry 整体切到已刷新区并触发 flush0,setUncancellable 在刷新阶段过滤被取消的写入。在批量写出层面,nioBuffers 从 flushedEntry 遍历已刷新的 ByteBuf,用 maxCount/maxBytes 控制分批规模、用 count 惰性缓存与 entry.buf/entry.bufs 缓存避免重复创建,返回的数组由 FastThreadLocal 复用、严禁逃逸出 doWrite。在发送清理层面,removeBytes 按实际写出字节推进 readerIndex,完全写出的 Entry 通过 remove/removeEntry 释放消息、通知 promise 并归还回收池,未写出的部分由 progress 保留续传位置。在流量控制层面,totalPendingSize 随 incrementPendingOutboundBytes/decrementPendingOutboundBytes 增减,与 WriteBufferWaterMark 的 high(64KB)/low(32KB)比较后经 setUnwritable/setWritable CAS 切换 unwritable 位,并触发 fireChannelWritabilityChanged 把可写性变化传播为 Pipeline 事件,供上层据此 setAutoRead(false) 实现背压。
原创不易,如果本文对您有帮助,带来了些许灵感或启发,烦请动动小手点赞、关注、转发、收藏。这是作者持续更新的动力源泉,衷心感谢您的支持。我会尽量在工作之余,为大家带来更高品质的内容,努力保持周更。