(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群 ,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/DZRng)!
论文标题:OmniMed-Jev: Calibrating LVLM Confidence for Trustworthy Medical Multimodal Decisions via System One
论文作者:香港大学,Luyao Tang、Cheng Chen
发表时间:2026年9月30日
目录
本文要点
(1)OmniMed-Jev把医学影像上的诊断、征象有无和有序数值,写成运行时给定候选的Choice、Noul、Score,一次前向返回整份分布。底座是MedGemma-1.5-4B。
(2)点预测和同一套图像、同一套预算训出的生成基线差不多。分类平衡准确率0.6892对0.6469,论文写明这个差距过不了95%检验。
(3)差别在报出来的概率。多标签ECE从0.2981降到0.0114,可靠误差从0.1294降到0.0010,论文给出的倍数是126倍。
(4)计数是生成基线仍然领先的一项,MAE 2.1429对2.5159。论文把原因归到Score期望把极端值往中间缩。这组结果不能当临床可用的证据。
(5)文末按论文表8摘训练配置。仓库README几乎没有运行说明。
2026年9月30日,香港大学电气与电子工程系的Luyao Tang和Cheng Chen把OmniMed-Jev提交到arXiv,编号2610.00381。我核对的是v1。PDF页眉写的日期是2026年10月2日,和arXiv首次提交日差两天,下面的数字以PDF正文表格为准。
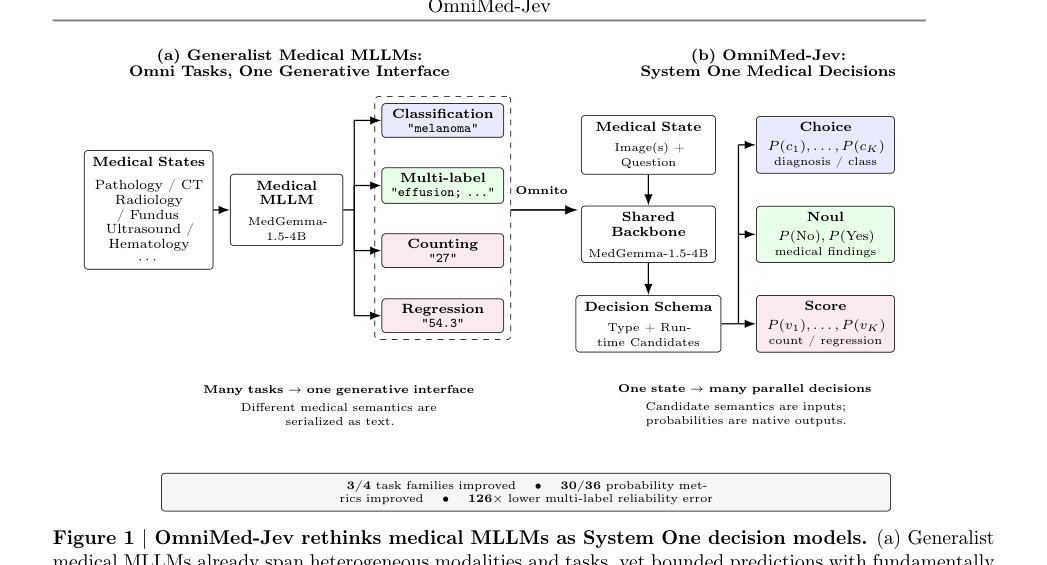
要解决的事情很具体。通用医学多模态模型已经能看病理、CT、胸片、超声和眼底。诊断、征象和计数仍写成一段话。系统读到的是下一个token出现的概率。诊断对不对的概率,模型没有直接给。
一、生成式医学模型报的是下一个token
托管版Jev是TypeSafe在2026年9月15日放出的决策模型。输入是文本state,问题类型事先声明,返回的是选项概率。三种原语叫Choice、Noul和Score。图像不进这个模型。
Yu和Yao在2026年9月22日放的Visual Jev换了做法。图像进视觉骨干,多个问题共用一段前缀,再从语言模型头读出候选token的概率。那篇评的是一般视觉基准。医学影像没进评测,校准也没写成主结论。
OmniMed-Jev借的是托管Jev的Choice、Noul、Score,对象换成医学影像。作者把同一张图上的多件事拆开。类别互斥的诊断用Choice。每条征象是否出现用Noul,胸片上的胸腔积液就是一条。细胞计数、射血分数这类有上下界的有序数用Score。候选按数值排好,位置本身就是大小,Score的候选因此保持原序,训练时不打乱。
自由文本报告和检测框这次没做。论文写明,框的坐标在他们的实现里对不准位置,两种模型都拿掉了。这套接口以后能不能表示检测框,论文没有下结论。
二、候选写进上下文,共享头读标记位置
生成模型把答案拆成一串token,概率连乘。OmniMed-Jev改成在一个数得完的候选集合上给分布,各项加起来等于1。要一个点预测时,再按固定规则从这份分布里取出一个值。
打分不看事先编好的类别编号。每个决策写成上下文里的一块,问题后面跟着候选,每个候选末尾放一个标记token,整段决策再用另一个标记收住。
图像和这段文字交错送进模型。共享打分头读取候选标记位置上的隐状态,和state表示合在一起,经过softmax,得到这个决策上的分布。
候选原文就写在上下文里,模型打分时读得到正在打分的那个选项。Choice和Noul的候选每个epoch打乱一次,只背位置,就对不上打乱后的选项。Score保持原序。生成基线用同样的训练日程,做等价的选项打乱。两边对顺序的处理保持一样,顺序就不会把对照带偏。
一张图往往带着好几项决定。胸片有一组征象,血涂片有总数,也有分类计数。接口把state编码一次,一次前向返回全部决策。生成接口要把这些事串成一句话,或者分开问。训练时标注按决策拆开,同一张图上的监督变密。没有另标一批新数据。
三种决策共用交叉熵,目标分布来自标注。训练分两段,先训决策头,再让头和低秩适配器一起训。生成基线用同一个骨干、同一套适配器配置、同样的优化步数,损失换成下一个token。
决策头有1,057,410个参数。第二阶段训练骨干2,529,778,162个参数里的39,555,202个,占1.564%。
三、十五个来源数据集,四种任务
评测集是作者自己拼的,公开榜没有用上。论文给出的理由是,通用模型可能已经在知名测试集上调过。自己划测试集,两边都占不到这个便宜。这组对照比的是输出接口。对某张榜熟不熟,在这个划分里起不了作用。
四个任务族对应三种决策,图像来自十五个来源,覆盖组织学、病理、CT、血液学、皮肤、眼科、胸片、超声和眼底。
分类把十个MedMNIST集合并成一道Choice,要分的是器官和组织。多标签对胸片征象逐条做有无判断,一张片子十四条。计数预测血涂片上的细胞数。回归预测心脏超声的左室射血分数,以及眼底照片上的一个视网膜分数。
两边用的是同一批23,558个训练state。分类、多标签、回归的留出集各200条。计数的点预测表用126条两边都打出分的样本。比较点定在第2424步,这是OmniMed-Jev验证集最好的检查点。
生成基线自己不输出候选上的分布。作者拿同一份决策块,把每个候选整段续写的对数概率加起来,再在候选集合上做归一。论文把这叫作慷慨的重建。基线用上了同样的候选和提示。用来打分的这段续写,未必是模型自己会生成的那句话。
四、点预测接近,校准拉开
先看点预测。论文写得很直,换接口以后,两边猜得准不准差不多。
| 任务族 | 指标 | 生成SFT | OmniMed-Jev | 差 |
|---|---|---|---|---|
| 分类,n=200 | 平衡准确率,越高越好 | 0.6469 | 0.6892 | +0.0422 |
| 多标签 | 宏F1,越高越好 | 0.5449 | 0.5618 | +0.0170 |
| 多标签 | 精确率 | 0.5679 | 0.5950 | +0.0271 |
| 多标签 | 召回率 | 0.5498 | 0.5602 | +0.0104 |
| 计数,n=126 | MAE,越低越好 | 2.1429 | 2.5159 | +0.3730 |
| 回归,n=200 | MAE,越低越好 | 3.3400 | 2.9488 | −0.3912 |
分类、多标签、回归的差距都过不了95%检验。多标签改成微平均,名次会对调。只有计数MAE过了这道检验,而且生成基线更低。
下面这张表是论文的主结果。每一格左边是生成SFT,右边是OmniMed-Jev。ECE、可靠误差、AURC越低越好,分辨率越高越好。生成侧用的是上面说的重建分布。这份分布是评测时拼出来的,训练目标里没有它。计数两边样本量不一样,生成侧201条,OmniMed-Jev是126条。
| 任务族 | ECE | 可靠误差 | 分辨率 | AURC |
|---|---|---|---|---|
| 分类 | 0.2589 / 0.0806 | 0.1002 / 0.0110 | 0.0938 / 0.0860 | 0.2020 / 0.1351 |
| 多标签,n=2795 | 0.2981 / 0.0114 | 0.1294 / 0.0010 | 0.0776 / 0.0102 | 0.2474 / 0.0126 |
| 计数 | 0.4204 / 0.0408 | 0.1824 / 0.0041 | 0.0000 / 0.1087 | 1.0000 / 0.3890 |
| 回归 | 0.1267 / 0.0913 | 0.0258 / 0.0205 | 0.1426 / 0.1268 | 0.2272 / 0.2280 |
这里的概率,指模型认为自己首选答案正确的概率。分类看选中的类,Noul看它判成存在的那条征象,Score看标注值。临床上疾病存不存在,论文没有用这个数去表示。
生成基线的ECE在四族上是0.26、0.30、0.42、0.13。OmniMed-Jev是0.08、0.01、0.04、0.09。论文写的降幅是3倍到26倍。
可靠误差和分辨率要分开看。可靠误差看报出来的数像不像概率。分辨率看排序能不能把对的和错的分开。生成基线在分类、多标签和计数上,可靠误差大于分辨率。排序还有点用,报出来的数字却把正确率说高了。OmniMed-Jev把分类、计数、多标签的可靠误差大约分别降到原来的1/9、1/44、1/126。分类和回归的分辨率仍和基线接近。
多标签是这套接口拉开差距最大的地方。十四条征象彼此独立,可靠误差从0.1294降到0.0010,选择性风险曲线下面积从0.2474降到0.0126,大约20倍。排序变平了,分辨率0.0102,基线是0.0776。回归的校准从0.1267降到0.0913。选择性行为几乎没变,AURC是0.2280,基线是0.2272。
计数那条AURC等于1.0,论文单独解释过。重建分布在126条计数上,一次都没把概率质量放在标注值上,曲线是一条误差为1的平线。作者把这读成大网格上的重建失败。生成模型会不会给计数排序,他们没有拿这条曲线下结论。
推理时可以改候选,不用重新训练。打乱顺序后,分类top-1一致率0.90,计数0.42,回归0.67。候选只剩两个时,准确率0.87,随机猜是0.50。拿掉标注里的正确候选以后,模型改选一个像样的次选,比例0.88。
五、计数是生成基线仍领先的一项
计数的标注是一个整数。OmniMed-Jev在有序网格上给分布,再折成期望。生成基线直接输出这个整数,点估计更接近标注。整套点预测里,只有这一项过了95%检验,而且利于生成基线。
作者把原因归到期望。拿不准的高端数值,会被拉向格子中间。论文把这写成当前Score实现上的假设,并写明整套任务里,只有计数这一族的点预测被这个期望拉差了。机制落在折期望这一步。改掉这一步的折法,点估计就有机会拉回来。论文没有把这写成接口改不了的上限。
论文附录和讨论还写了一处混在一起的对照。决策拆开以后,OmniMed-Jev每张图拿到的监督更密。决策头又是多出来的可训练模块。测到的是这套决策建模的具体实现。接口本身、更密的监督、额外的头,这三项在结果里分不开。
这些概率来自回顾性评估。前瞻的临床队列,论文没有做。按论文的说法,结果支持的是所评任务里报出的置信度开始有意义。临床能不能用,这组实验还撑不住。
六、本地部署与推理实践
代码在github.com/lytang63/OmniMed-Jev。我打开仓库时,README只有论文标题一行,没有安装和推理命令。下面按论文表8摘两边共用的训练配置。max_length是唯一跟着接口变的一项。OmniMed-Jev要把一个state上的全部决策塞进一条序列,最长决策块2,707个token,1,024装不下。
text
backbone: models/medgemma-1.5-4b-it
quant: 4-bit NF4, double quant, bf16 compute
lora: rank 16, alpha 16, dropout 0.05, all-linear, vision tower included
lr: 2e-4, linear, warmup 111 steps
optim: paged_adamw_8bit, weight decay 0, grad clip 0.3
batch: 8 x 4 = 32
epochs: 5, total steps 3685, eval checkpoint 2424
max_length: 1024 generative, 3072 OmniMed-Jev
seed: 42
两份模型分开训,各用一张A800。生成基线墙钟46,280秒,约12.86小时。OmniMed-Jev是50,204秒,约13.95小时。表9只给了OmniMed-Jev第二阶段的峰值显存,17.18GB。生成侧的峰值,论文写成未报告。最终训练损失分别是0.5805和0.7807。两个损失的目标不同,这两个数不能直接比大小。
推理时候选写在输入里。Choice和Noul可以换顺序,可以收成短名单,也可以拿掉正确项。Score的格子顺序不能动,位置就是数值。
七、总结与思考
作者自己下的判断是,点预测没有拉开差距,报出来的数更像概率。多标签上可靠误差大约降到原来的1/126,这个数比分类准确率多出来的0.04更值得记住。0.04过不了95%检验。
和托管Jev比,差别在输入。Jev只收文本。OmniMed-Jev让图像进MedGemma的视觉塔,决策头读候选标记上的隐状态。读出发生在模型内部。官方API上的三种原语调用,这篇没有用。
和2026年9月22日的Visual Jev比,差别在任务和读出方式。Visual Jev留着语言模型头,多个问题共享一段视觉前缀,要的是速度。OmniMed-Jev为了医学校准,单独训了一个共享头。作者也写明,这个头、更密的监督和接口缠在一起,结果拆不开。
我把它当成一次校准实验来读。上临床的诊断模型,这组结果还不够。计数那一族已经说明,整数折成网格上的期望以后,点估计会变差。检测框和自由文本报告,这次的接口还表达不了。
参考链接
- 论文原文 arXiv 2610.00381 v1,PDF见 arxiv.org/pdf/2610.00381,2026年9月
- 代码 lytang63/OmniMed-Jev
- 底座模型卡 google/medgemma-1.5-4b-it
- 作者对照的决策接口,TypeSafe博客 Introducing System One models and Jev,2026年9月15日
- 共享视觉前缀的前作 Visual Jev,arXiv 2609.25845,2026年9月22日