深度学习为什么好?

我们之前讨论机器学习时遇到两个无法解决的问题:

当模型复杂度越复杂时(function越多),这样loss会越小,但是理想和现实的效果会变得越来越大(训练集和验证集的效果变大)。

而当模型变得简单,理想和现实的差距会变小,但是loss也会变大
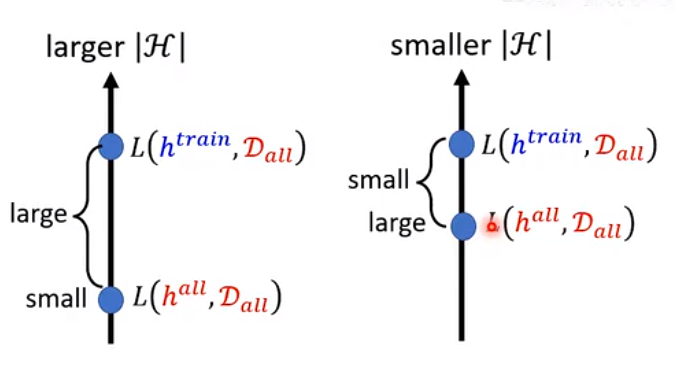
如何做到loss很低而且理想和现实很接近呢?模型不过于复杂而且loss也低
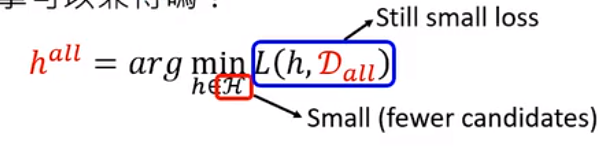
我们知道叠的层数越多模型复杂度越大 ,训练的效果越好,loss越小,同时我们的数据量规模如果足够大,也可以缩小理想和现实之间的差距,所以大部分认为如果有大资料更适用于深度学习
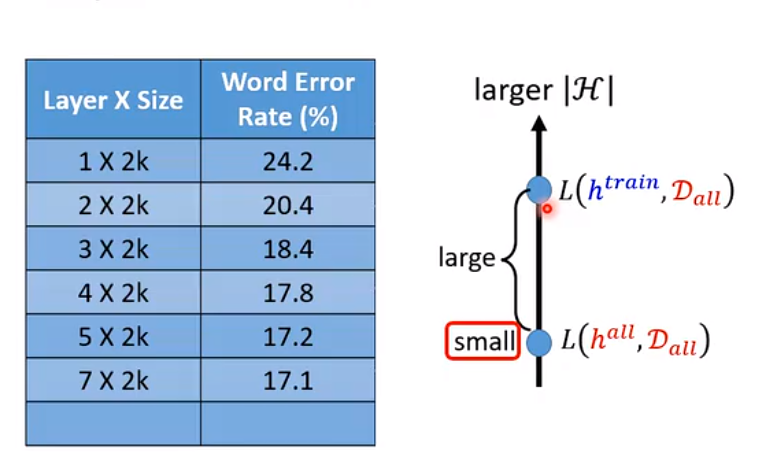
那为什么选择深度学习,还不选择纵向复杂度更高的模型呢?
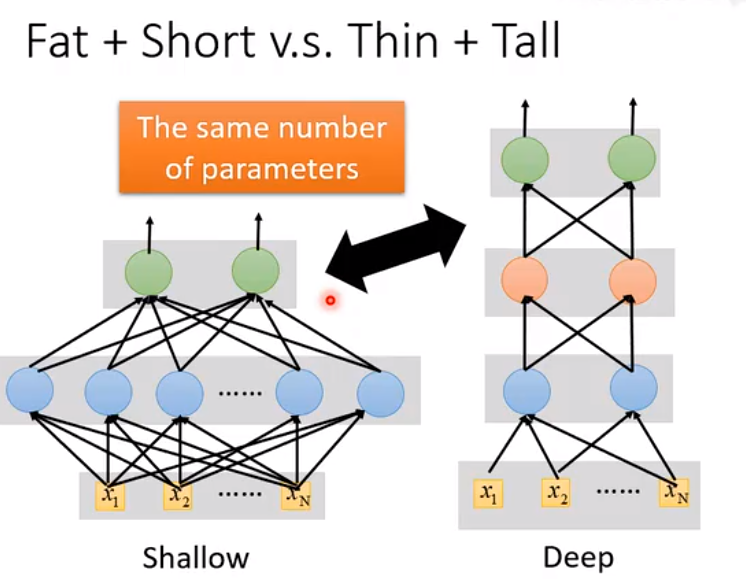
下面的表格可以看出,同样的数量级别下,深度方向的复杂度提升效果更好
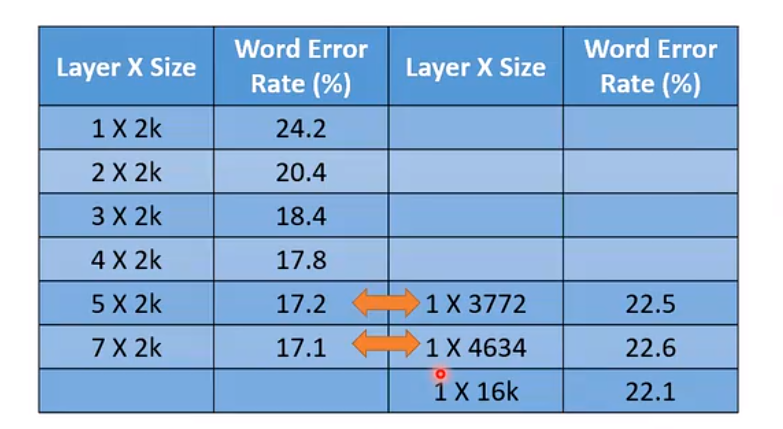
另一个对比方法是,如果横向增加模型复杂度,他增加的参数数量是比纵向增加更多

deep learning并不容易产生过拟合,需要的参数并不算多

增加深度会发生什么事情呢?

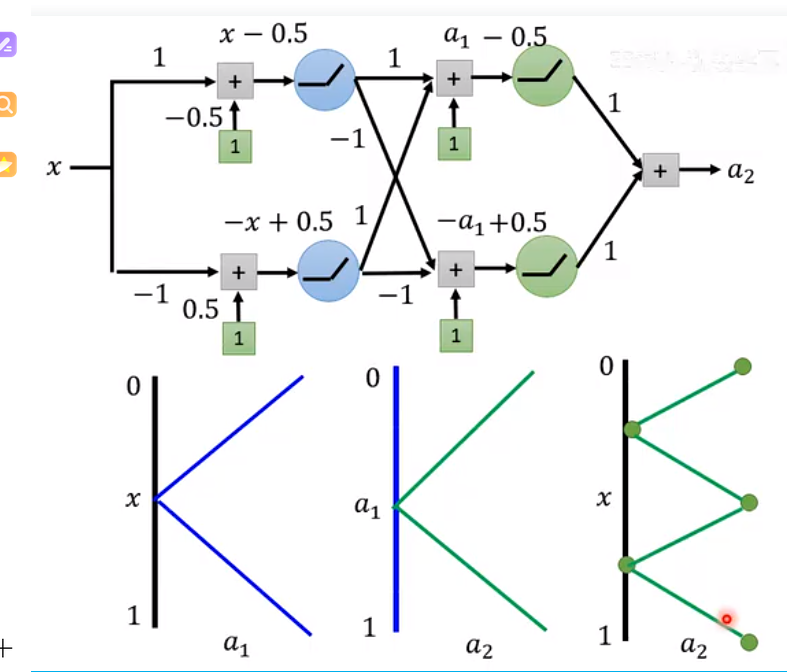
下面用一个简单的RELU函数组合进行解释:

x-a1的图像和a1-a2的图像是一样的,x由0到0.5时,a1由1变为0,a1由1变为0时,a2由1变为0又变为1,由此得到图像
由此类推:
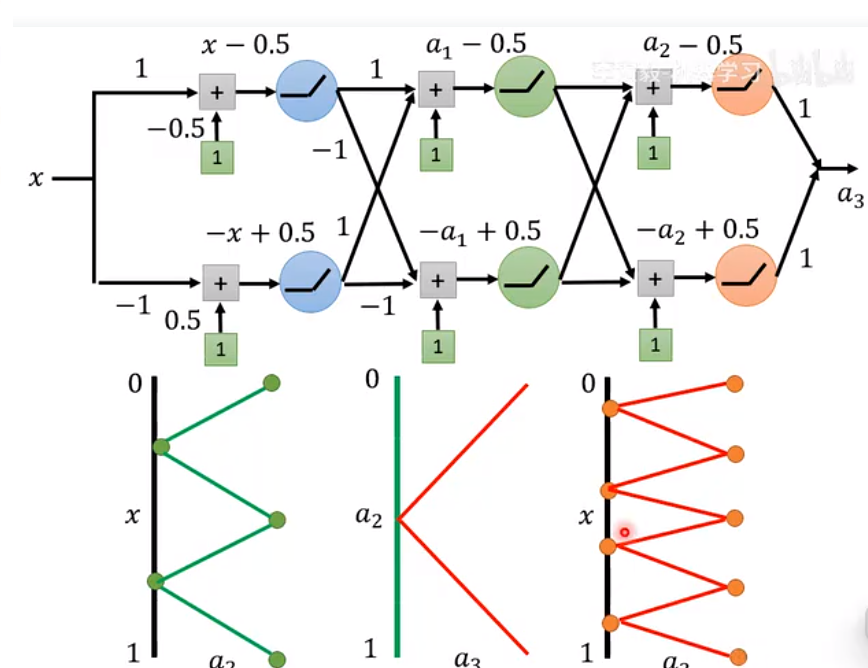
所以要产生一个同样的function,deep 模型需要2K个neuron,而shallow需要2^K次方个neuron
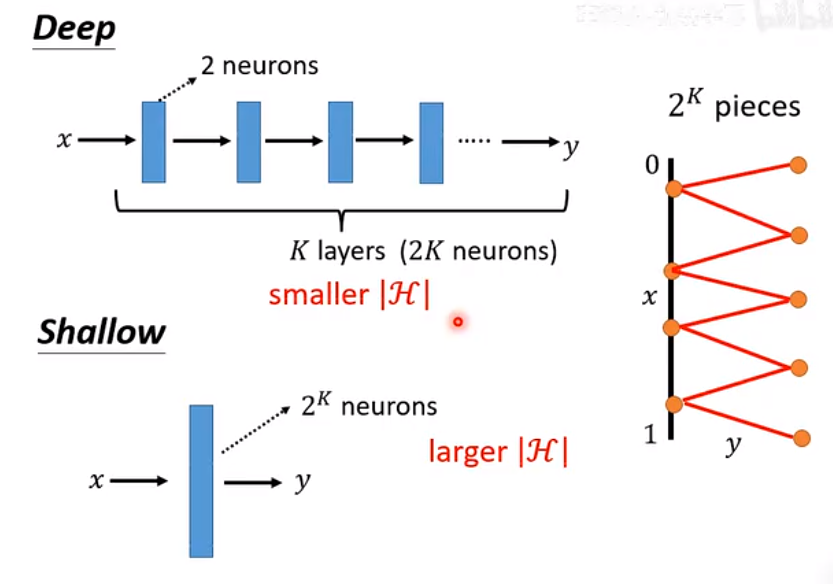
复杂的模型更容易overfitting,所以我们需要的function是复杂且有规律的,更适合使用deep learning,例如语音,影像问题,深度学习的效果非常好

所以深度学习为什么好?

在比较少的参数情况下得到比较好的效果

相关推荐
黑十4 小时前
PyTorch 报 “no CUDA GPUs are available“ 怎么办?3 步排查
服务器·网络·人工智能·pytorch·python
明月_清风4 小时前
用自然语言操控真机:Google Artemis 移动端 AI Agent 上手与实践
人工智能·后端
没落之王4 小时前
三易五行看宋朝的三界确立
大数据·人工智能·算法
ZhengEnCi4 小时前
正样本几万、负样本个位数:极端类别不平衡下怎么训模型(全文可跑)
深度学习
miofly4 小时前
DeepSeek 开源 Super-agent 架构:AI 主动发现 Bug 并提交 PR
人工智能
kyrie_sakura4 小时前
大模型学习20 大模型学习 - LangChain3 - Agents
人工智能·学习·langchain
zhangfeng11334 小时前
2026 书生国智科探挑战赛暨飞翔杯 AI Agent/Skills 开发大赛全景介绍
人工智能
DevMemo5 小时前
2026 AI外呼系统技术选型:全链路延迟预算与集成成本实测,10个品牌的架构真相
人工智能·架构
ZhuoAIStage5 小时前
契约与闸门打架该改谁?用 AI 智能体 preflight 把配置漂移挡在发版前——以舞台工艺审图专家包闸门冲突为例
人工智能·闸门·舞台工艺·配置漂移·专家包·preflight
Flynn Liang5 小时前
大模型怎么自己调函数?Spring AI 2.0 Tool Calling 自动循环原理 + 完整时序图
java·人工智能·spring·agent·函数调用·springai·toolcalling