Hive 源码导读(三):都是 SELECT,为什么有的查询不需要 YARN?
上一篇,订单查询已经从 Beeline 到达了 Driver。
我们先查了十条订单,结果很快返回;接着想知道当天已支付的订单一共多少钱,写了一条聚合 SQL。这次,日志里出现了 MR Job。
都是 SELECT,为什么一条直接出结果,另一条要安排计算任务?
答案藏在执行计划里。Hive 接收到 SQL 后,要先把"你想做什么"翻译成"具体怎样做",再决定由谁执行。
本文基于 Hive 3.1.2、Hadoop 3.2.1,MR on YARN 。SQL 使用系列实验表。下文计划形状为解释性示意,实际 Stage 编号和算子组合以本机
EXPLAIN为准。
一、今天把需求升级一下
第一条查询只看订单明细:
sql
SELECT order_id, amount, status
FROM csdn_hive_lab.orders_raw
WHERE dt='2026-10-09'
LIMIT 10;
第二条要统计不同状态的订单金额:
sql
SELECT status, SUM(amount) AS total_amount
FROM csdn_hive_lab.orders_raw
WHERE dt='2026-10-09'
GROUP BY status;
对六行实验数据来说,手工也能算出来。但 Hive 不能只凭 SQL 字符数安排工作;它要识别过滤、分组、聚合以及读写对象,再生成对应执行计划。
二、先审需求,再写施工单
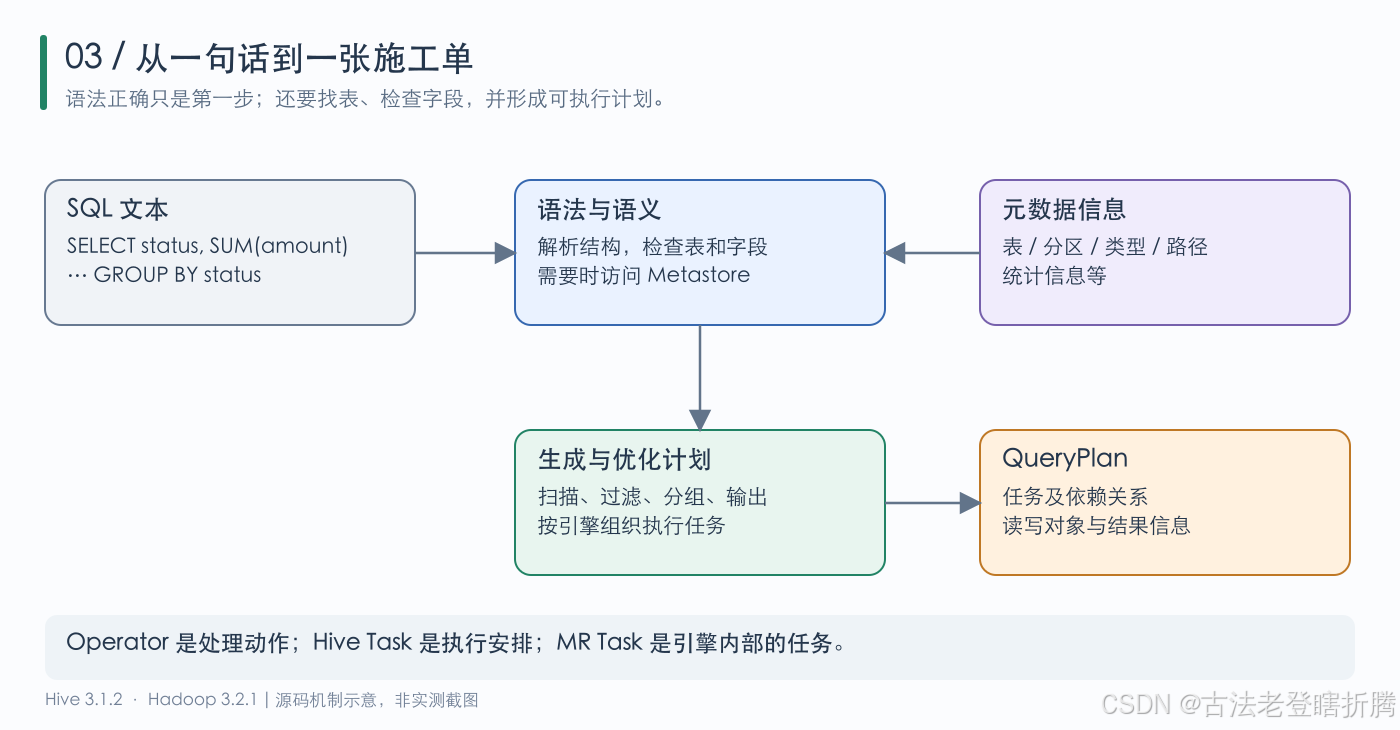
可以把编译理解为给需求写施工单,主要分成几件事:
| 阶段 | 用订单查询解释 | 能发现的问题 |
|---|---|---|
| 语法分析 | 认出 SELECT、FROM、WHERE 等结构 | 括号、关键字或语法位置不对 |
| 语义分析 | 找订单表,检查 amount 是否存在、能否求和 | 表不存在、字段不存在、类型不合适 |
| 生成和优化计划 | 安排读取、过滤、分组和输出 | 是否可以少读分区、少传字段、改变算子组织 |
| 形成执行任务 | 为当前引擎组织能够执行的工作 | 用哪些 Hive Task,任务怎样依赖 |
AST 就是语法分析得到的树形结构。初学时不用记它每一种节点,只要知道:Hive 已经把字符串变成了能继续分析的结构。
语义分析为什么要访问 Metastore?因为光看 SQL,编译器不知道 orders_raw 里面有什么字段、哪些分区存在、文件按什么格式保存。
没有 Application,却在访问 Metastore,一点也不矛盾。它可能还在准备施工单。
三、源码不用一口气追到底
第一轮阅读,可以沿着这几个位置走:
text
Driver.compile()
  → 语法解析相关入口(ParseUtils / ParseDriver)
  → SemanticAnalyzerFactory 选择分析器
  → 语义分析、优化与任务生成
  → QueryPlan
实际编译流程包含权限检查、Hook、统计信息、优化器与不同语句分支。这里保留的是理解方向所需的骨架,并不是完整调用栈。
SemanticAnalyzer 会处理查询的语义和计划。TaskCompiler 及其引擎相关实现,则帮助把计划组织成可执行的任务。读源码时,先观察计划输入和输出发生了什么变化,再深入某一种优化。
例如 WHERE dt='2026-10-09' 提供了明确的分区条件。它的价值是让系统有机会只访问这一天对应的分区。至于读取阶段是否又做了其他过滤,要继续看计划和存储格式。
四、Operator、Hive Task、MR Task 别混在一起
这三个名字都与"干活"有关,却不在同一层。
| 名字 | 可以怎样理解 | 例子 |
|---|---|---|
| Operator | 一项数据处理动作 | 扫描、过滤、选择字段、分组 |
| Hive Task | Hive 安排的执行单元 | MR 任务、DDL 任务、MoveTask |
| MR Task | 一个 MR Job 内部的计算任务 | 某个 Map Task、Reduce Task |
所以 EXPLAIN 里出现一个 Stage,不代表只启动一个进程;一段 Map 算子树,也不是说集群上只能有一个 Map Task。
可以把 Operator 理解为施工动作,Hive Task 理解为一项施工安排,MR Task 则是引擎真正拆出去执行的工作。
五、FetchTask 为什么能省掉一次分布式提交
SimpleFetchOptimizer 的工作,是检查某些简单查询能否直接转成 FetchTask。
读 transform() 和 optimize(),重点看两个判断:算子树能不能直接读取,相关阈值条件是否满足。下面是依据源码整理的伪代码:
java
// 解释性伪代码:省略具体类型与分支。
if (queryCanUseFetch && operatorTreeCanUseFetch && thresholdAllows) {
    plan.setFetchTask(createFetchTask());
}
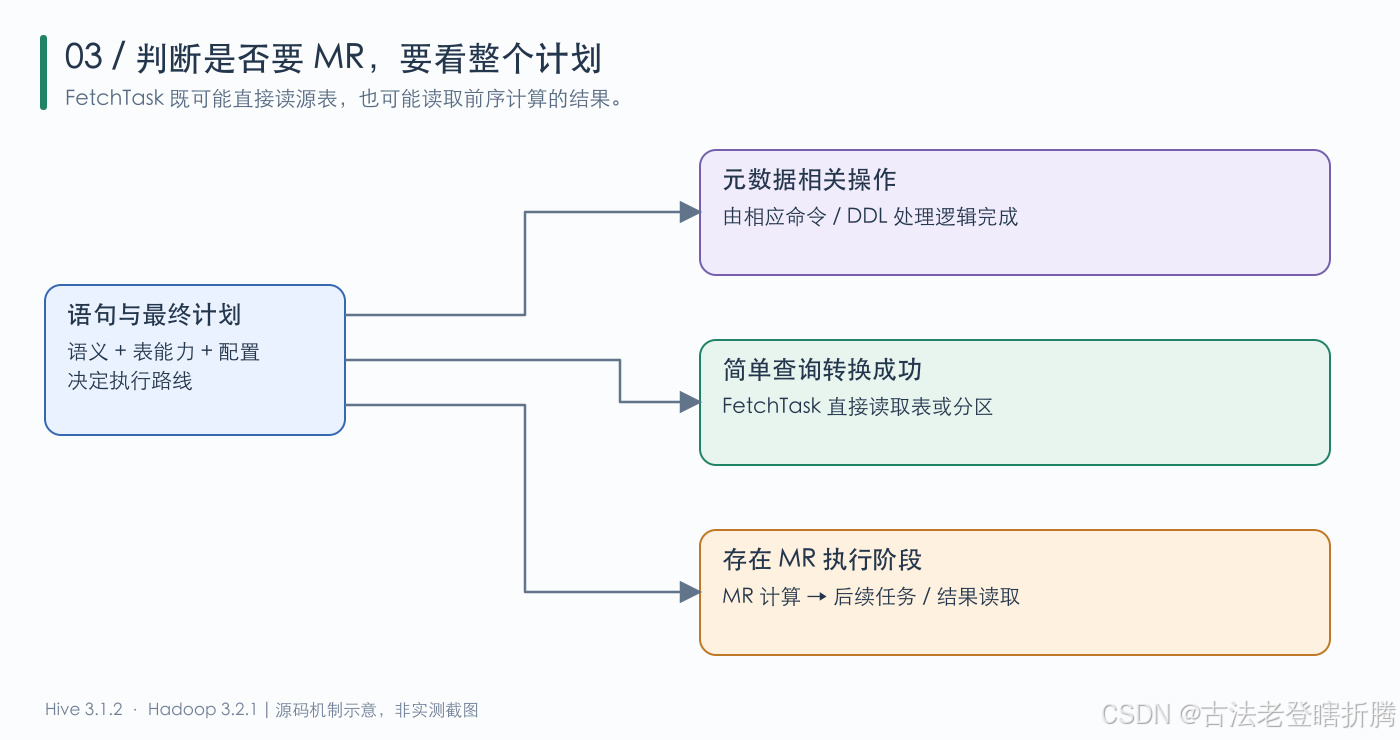
转换成功后,HS2 可以在这个执行路径上直接读表或分区的数据。开头那条"指定分区、选择几个字段、LIMIT 10"的查询,就是适合观察这种优化的小案例。
但不能把它记成"带 LIMIT 就不走 MR"。连接、聚合、表的能力、优化规则和配置都会影响结果。
反过来,计划里有 Fetch Operator,也不表示从来没有分布式计算:MR 结果返回客户端时同样可能需要 FetchTask。要看整个计划有没有 MR 阶段,以及 FetchTask 读的是源表还是前序结果。
六、让同一条 SQL 换一次执行路线
先在实验会话里确认引擎与运行方式:
sql
SET hive.execution.engine=mr;
SET mapreduce.framework.name;
SET hive.exec.mode.local.auto=false;
SET hive.fetch.task.conversion;
mapreduce.framework.name 应来自已正确配置的环境,并显示为 yarn。只设置 Hive 的 mr,不能替代 Hadoop 客户端的完整配置。
先打开简单查询转换,查看计划:
sql
SET hive.fetch.task.conversion=more;

EXPLAIN
SELECT order_id, amount, status
FROM csdn_hive_lab.orders_raw
WHERE dt='2026-10-09'
LIMIT 10;
再关闭转换,查看同一条查询:
sql
SET hive.fetch.task.conversion=none;

EXPLAIN
SELECT order_id, amount, status
FROM csdn_hive_lab.orders_raw
WHERE dt='2026-10-09'
LIMIT 10;
我们要比较的是 MR 阶段、算子树和读取位置,而不是要求两份输出必须出现固定的 Stage 编号。EXPLAIN 自己通常只生成计划,并不会替你执行这条业务查询;要观察提交行为,还要执行相应的 SELECT。
完成对比后,把 hive.fetch.task.conversion 恢复到实验前记录的值。别把为了观察路径而调整的参数顺手带进其他任务。
七、先学会看三样东西就够了
一份很长的计划,第一遍只看:
- 从哪里读:源表、目标分区、扫描条件是否符合预期。
- 中间做什么:有没有分组、Reduce Output、连接等需要关注的算子。
- 任务怎样接起来:有哪些 Stage、依赖关系如何、最终结果由谁输出。
对于订单按状态求和,可以先把逻辑理解成:
text
读指定日期的订单
  → 按 status 组织分组
  → 对 amount 求和
  → 输出各状态金额
是否存在 Map 端局部聚合、多少个 Reduce,以及最终 Stage 形状,都交给具体执行计划回答。别把"GROUP BY 永远恰好一个固定样子的 MR"当成规则。
八、没有 Application 时,多想一步
| 证据 | 更合理的下一步 |
|---|---|
| 最终计划不需要 MR | 沿元数据或直接读取路径查看完成状态 |
| 计划包含 MR,但日志仍在编译 | 查看元数据访问、编译耗时与相关等待 |
| 已编译,正在申请锁 | 检查锁对象、持有者与等待状态 |
| 已进入 Job 提交,却暂时没有应用 | 检查提交准备、HDFS staging、客户端与 RM 通信 |
最后两行先在这里留个位置。锁会在第五篇展开;下一篇,我们先陪着已经生成的 MR 工作单,走到 YARN 门口。
本篇关键源码位置
- Driver.java:编译与 QueryPlan。
ParseDriver、SemanticAnalyzerFactory、SemanticAnalyzer:解析与分析。TaskCompiler、MapReduceCompiler:引擎任务生成。- SimpleFetchOptimizer.java:Fetch 转换条件。
FetchTask、HiveConf:直接读取与相关配置。