背景
向量检索的选型评估长期停留在 k=10 / k=100 这个区间 ------ 无论是公开榜单、厂商白皮书还是多数基准报告,覆盖的都是"找最相似的几十条"这类典型在线查询。但随着召回 + 精排两阶段架构在推荐、搜索、RAG 中成为主流,向量层的职责已经发生变化:它不再是"直接给出答案",而是要一次性吐出数十万至百万级候选集,交给下游模型做精排。叠加大规模去重聚类、亿级库离线语义挖掘、风控近邻普查等场景,Large TopK 已经从"小众需求"变成了硬指标。
为什么 Large TopK 是一道硬门槛
越来越多的真实业务场景需要向量引擎具有大范围召回能力,比如:
-
召回 + 精排两阶段架构 ------ 向量召回层要一次吐出几十万甚至上百万候选,交给下游 CTR 预测模型
-
大规模去重与聚类 ------ 相似图片/文本聚簇,单次查询需要拿到整个簇
-
离线数据挖掘与标注 ------ 从亿级库里一次性捞出某个语义邻域的全部样本
-
合规与风控排查 ------ 对一个可疑样本做全库范围的近邻普查
这些场景的共同点是:k 不是几十,而是几十万到千万级。阿里云 Milvus 通过在容量型索引基础上通过算法优化,可以基于同一份索引支持千万级别 Topk 的查询,查询性能和召回率领先业内产品。开源VectorDBBench 也新增了对这个场景的 benchmark 覆盖, 在此基础上我们通过 VectorDBBench 提供的 Performance768D100M 数据集 进行 Topk1百万的 benchmark 测试,对比了其他主流向量搜索引擎的 TopK 能力天花板,Topk1百万查询的 p99 latency 和 recall,在不同维度上证明阿里云 Milvus 容量型索引在 large topk 场景实际搜索性能处于行业领先水平。
TopK 能力天花板:1,000 万,领先 2 ~ 1000 倍
各引擎实测能稳定返回结果的最大 k 值
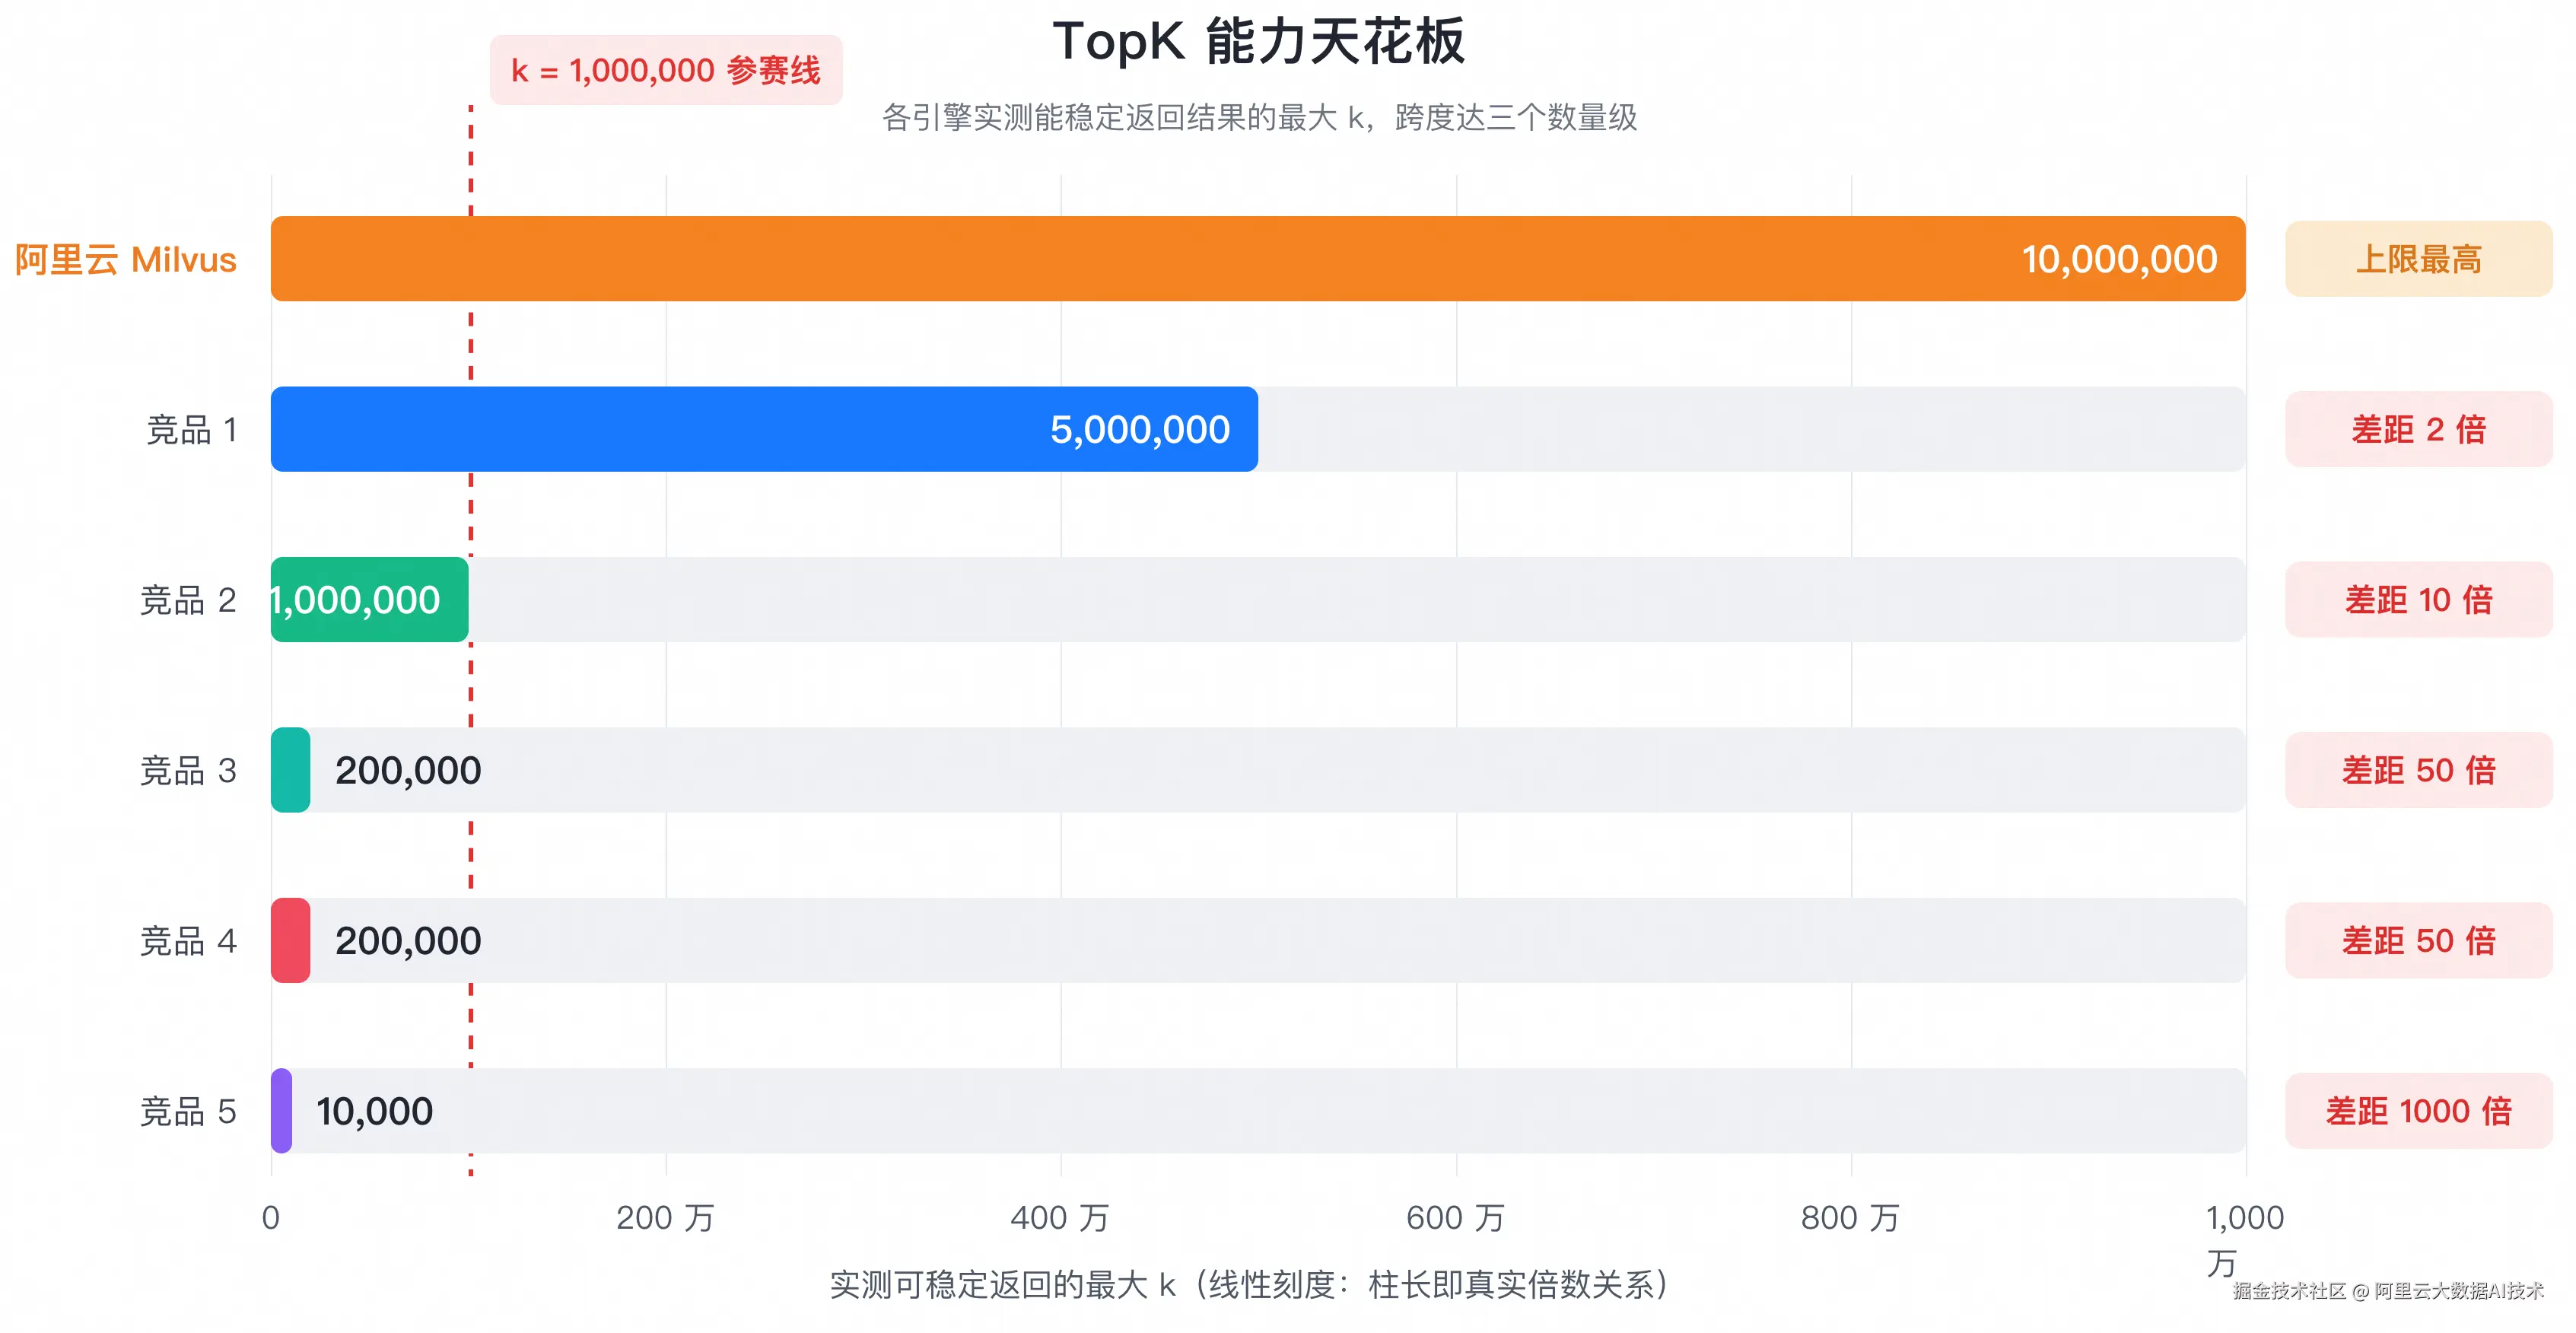
阿里云 Milvus 的上限是 1,000 万 ------ 相当于在 1 亿条的库里一次性召回全库的 10%,并且在上限处能完整返回全部 1,000 万条结果,不缩水。
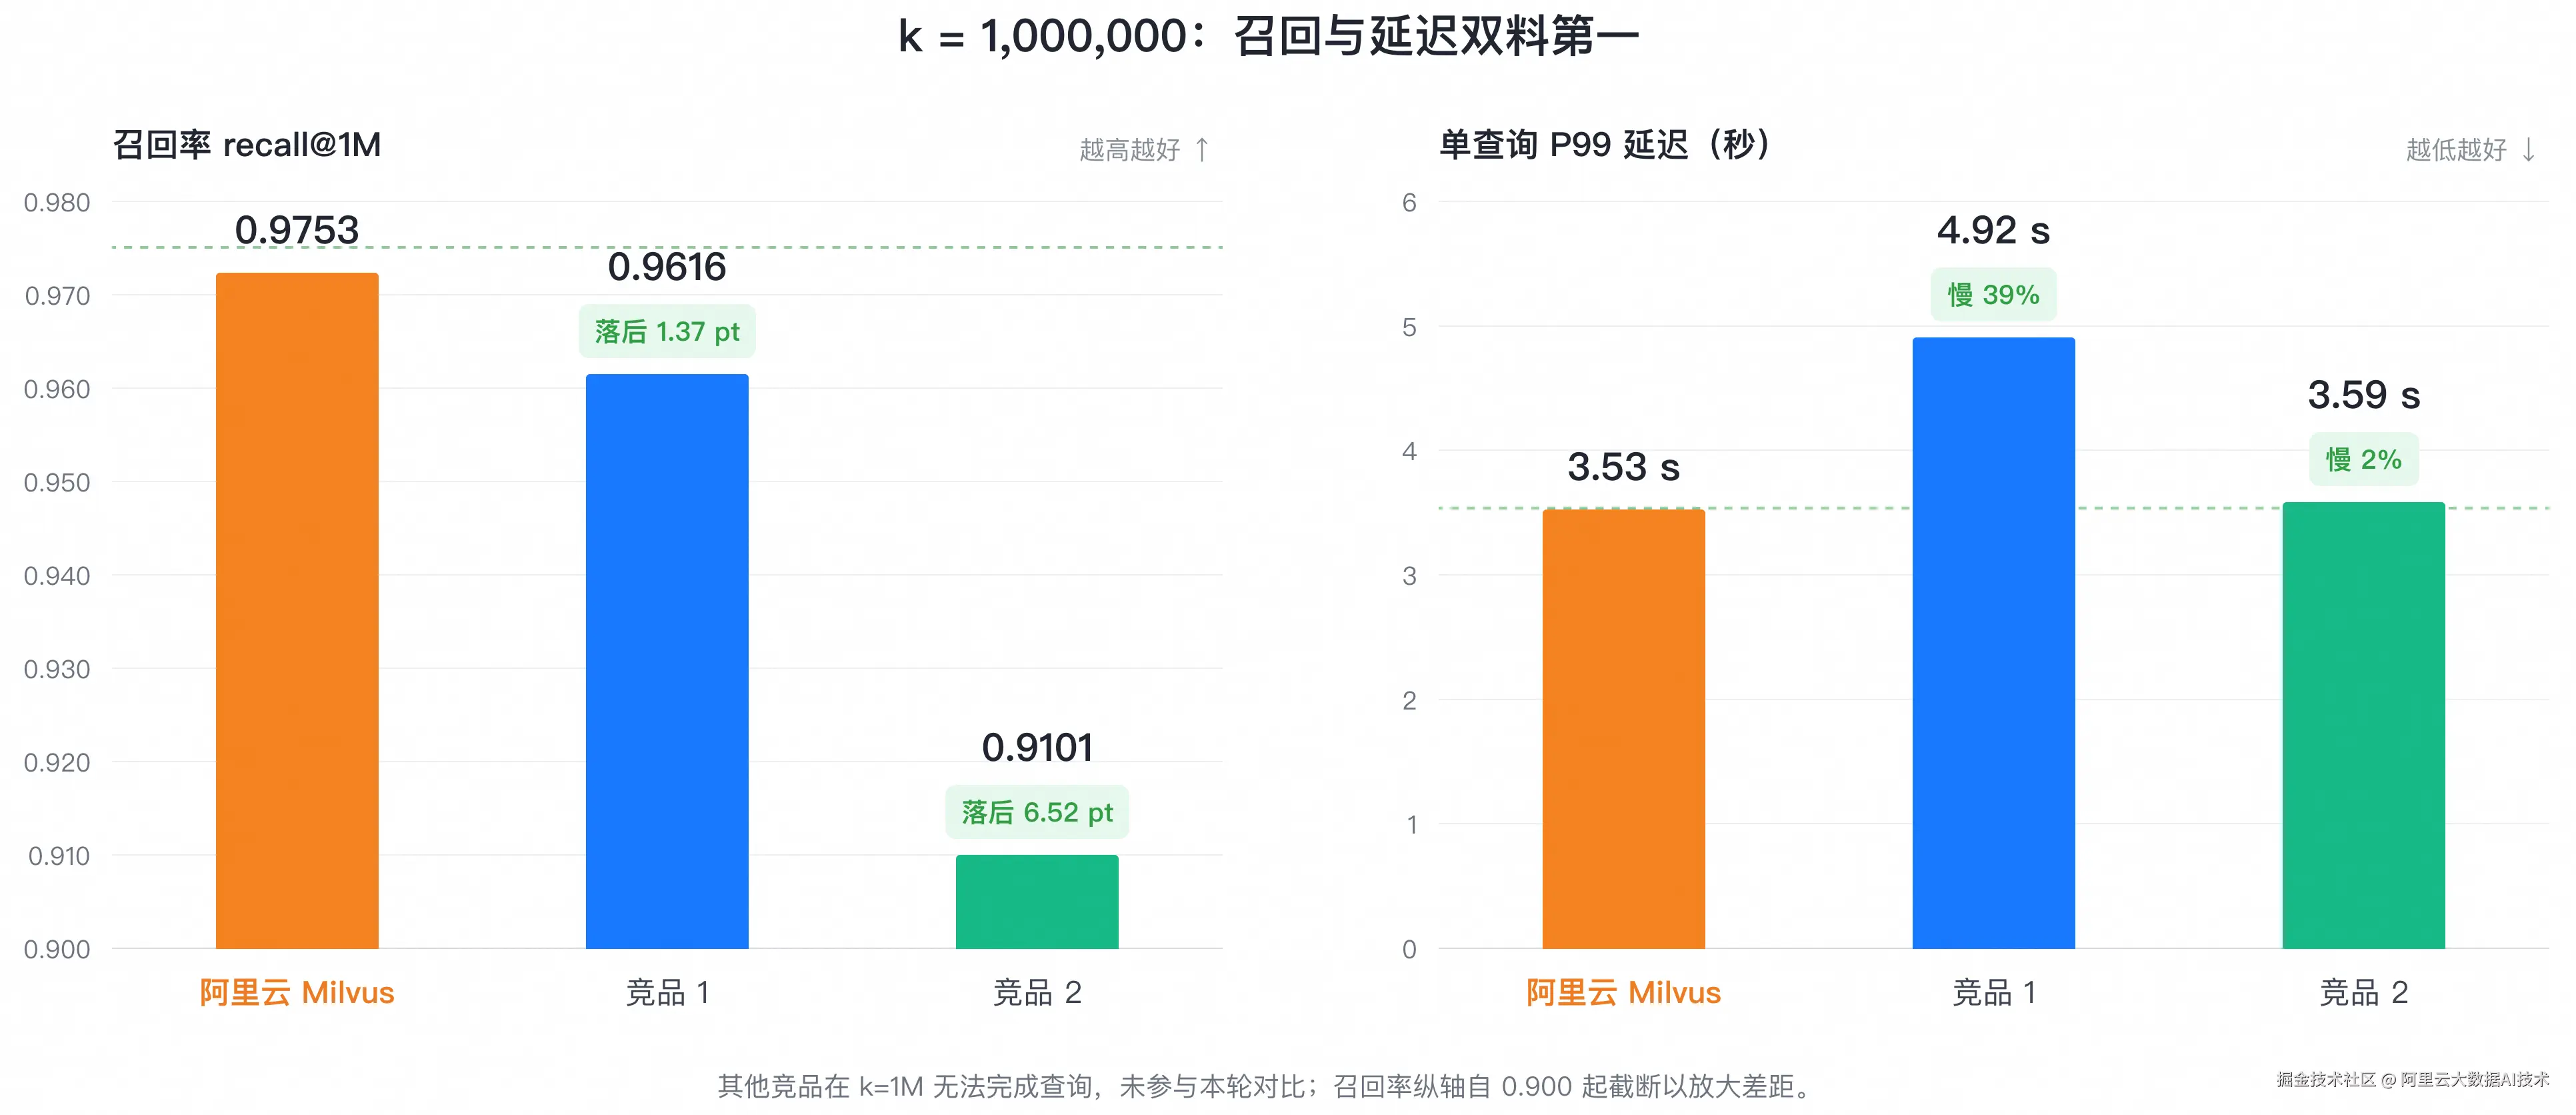
k=100 万:召回与延迟双料第一
在 k=1M 这个只有三家能跑的擂台上,阿里云 Milvus 在两个维度上同时领先(单线程串行测试):
-
召回率最多领先 6.52 个百分点 ------ 在百万级结果集上,6.52pt 意味着多找回约 6.5 万条正确近邻,对下游精排模型的效果影响是实打实的
-
P99 延迟最高低 28% ------ 3.53 s vs 4.92 s
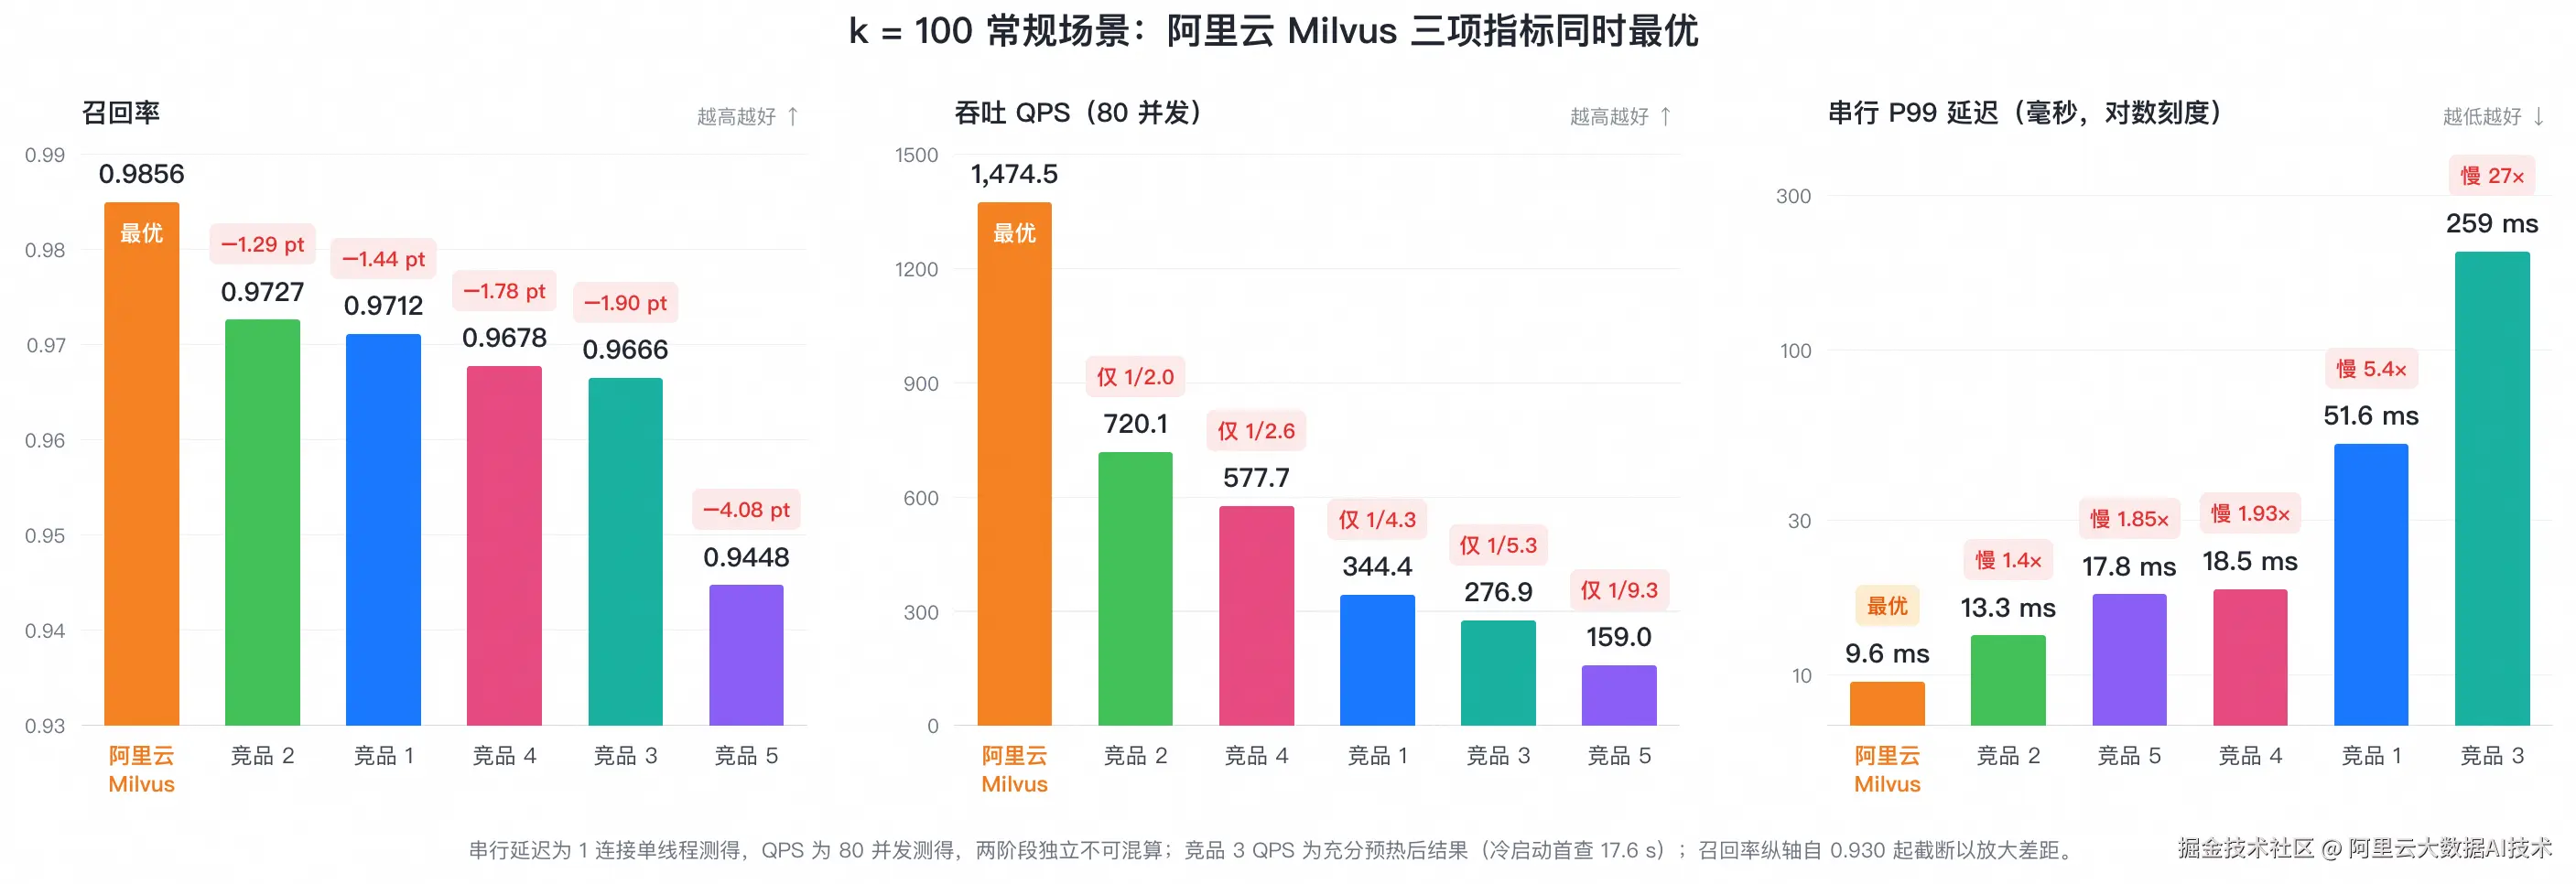
k=100:不是"牺牲小 topk 换大 topk"
一个合理的疑问是:阿里云 Milvus 的 Large TopK 优势,是不是靠牺牲常规小 k 场景换来的?
实测数据给出了否定答案 ------ 在 k=100 的常规场景下,阿里云 Milvus 依然三项指标全优:
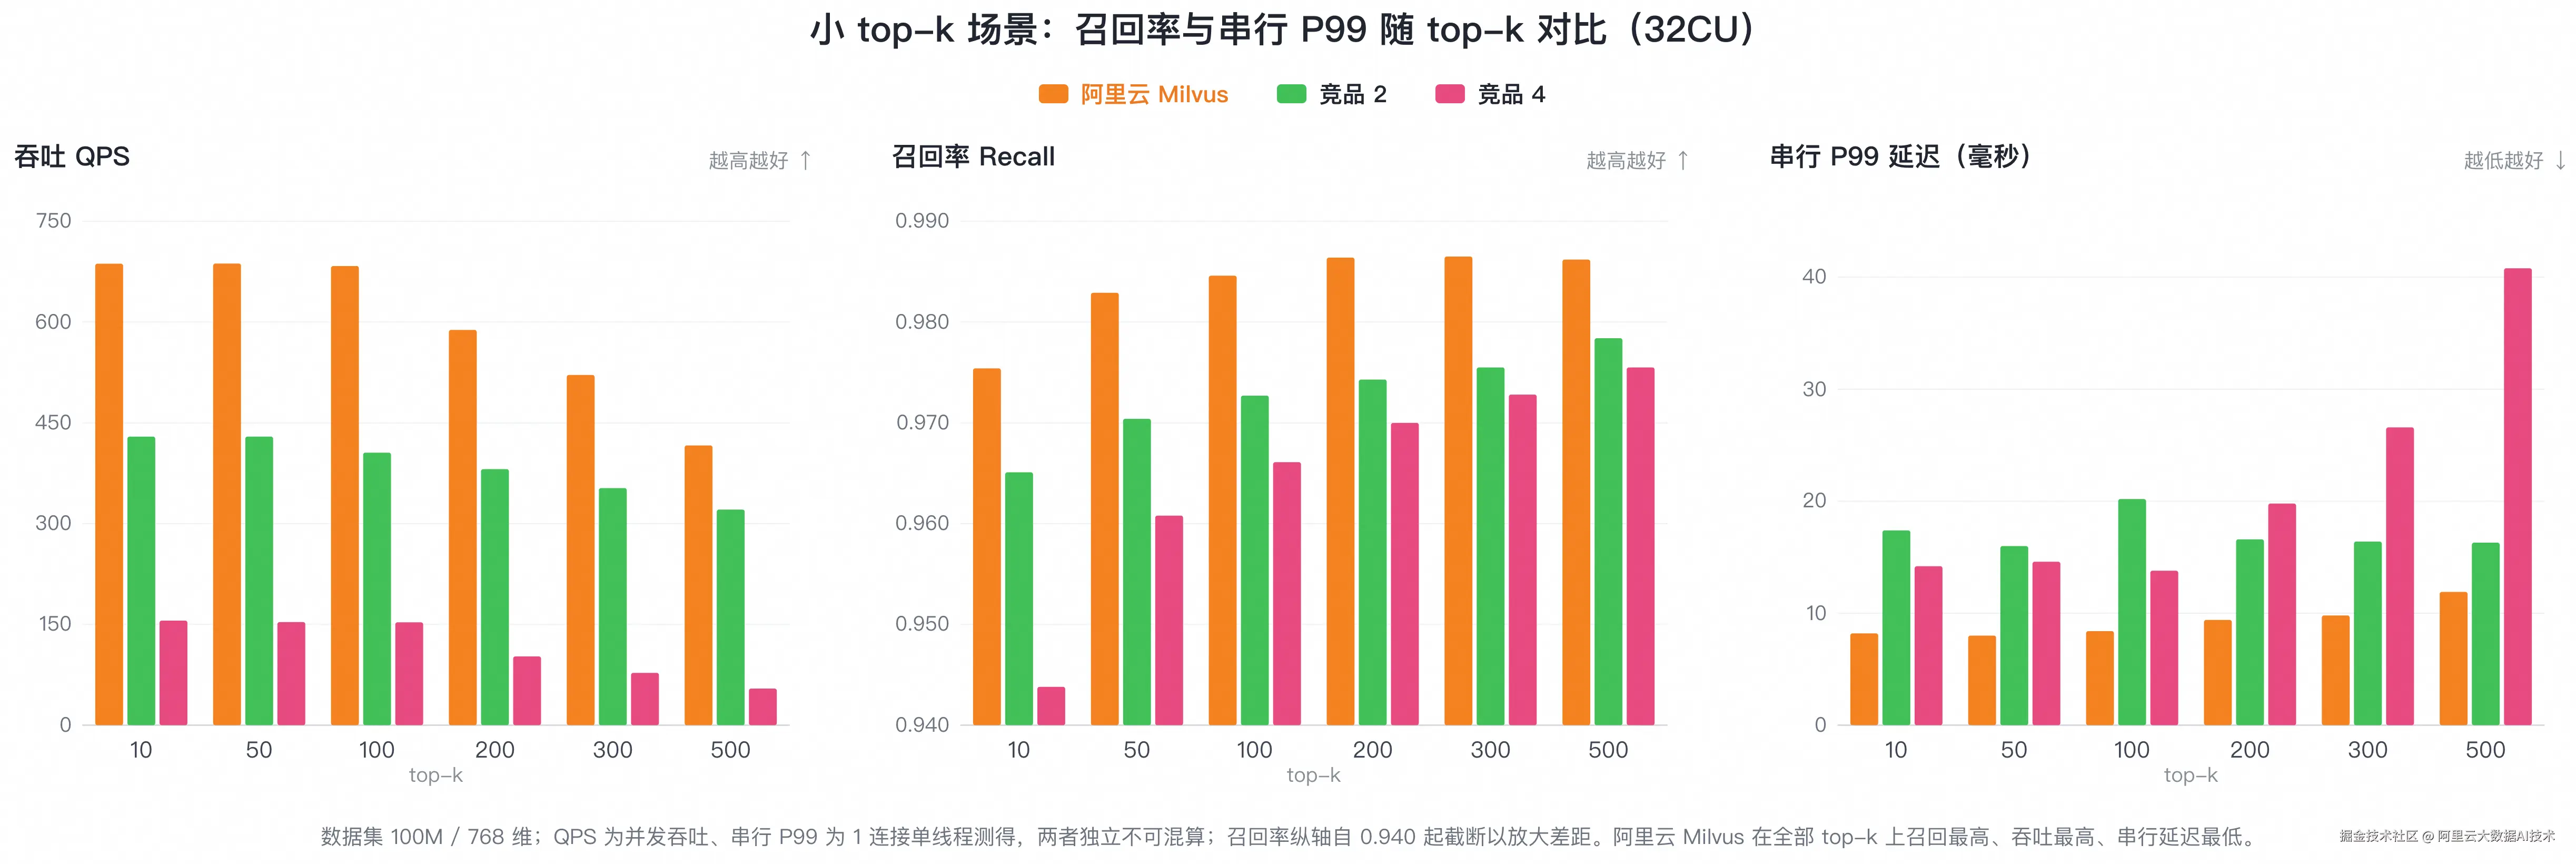
规格最小:性能依然各项第一
由于各个引擎的容量型索引和压缩算法不同,所以以上结果在对比测试时所需要的最小运行资源是不同的。为了对齐计算资源,统一采用 128CU 计算资源作为测试基准,获得公正的结果对比。当然 128CU 不是Performance768D100M数据集最小的运行资源,在实际测试中阿里云 Milvus及个别竞品可以在最小32CU资源的前提下完成性能测试,不能完成测试的竞品不再图标里展示,在此资源下阿里云 Milvus依然在 Top1 百万和小 Topk 场景各方面均是最优。 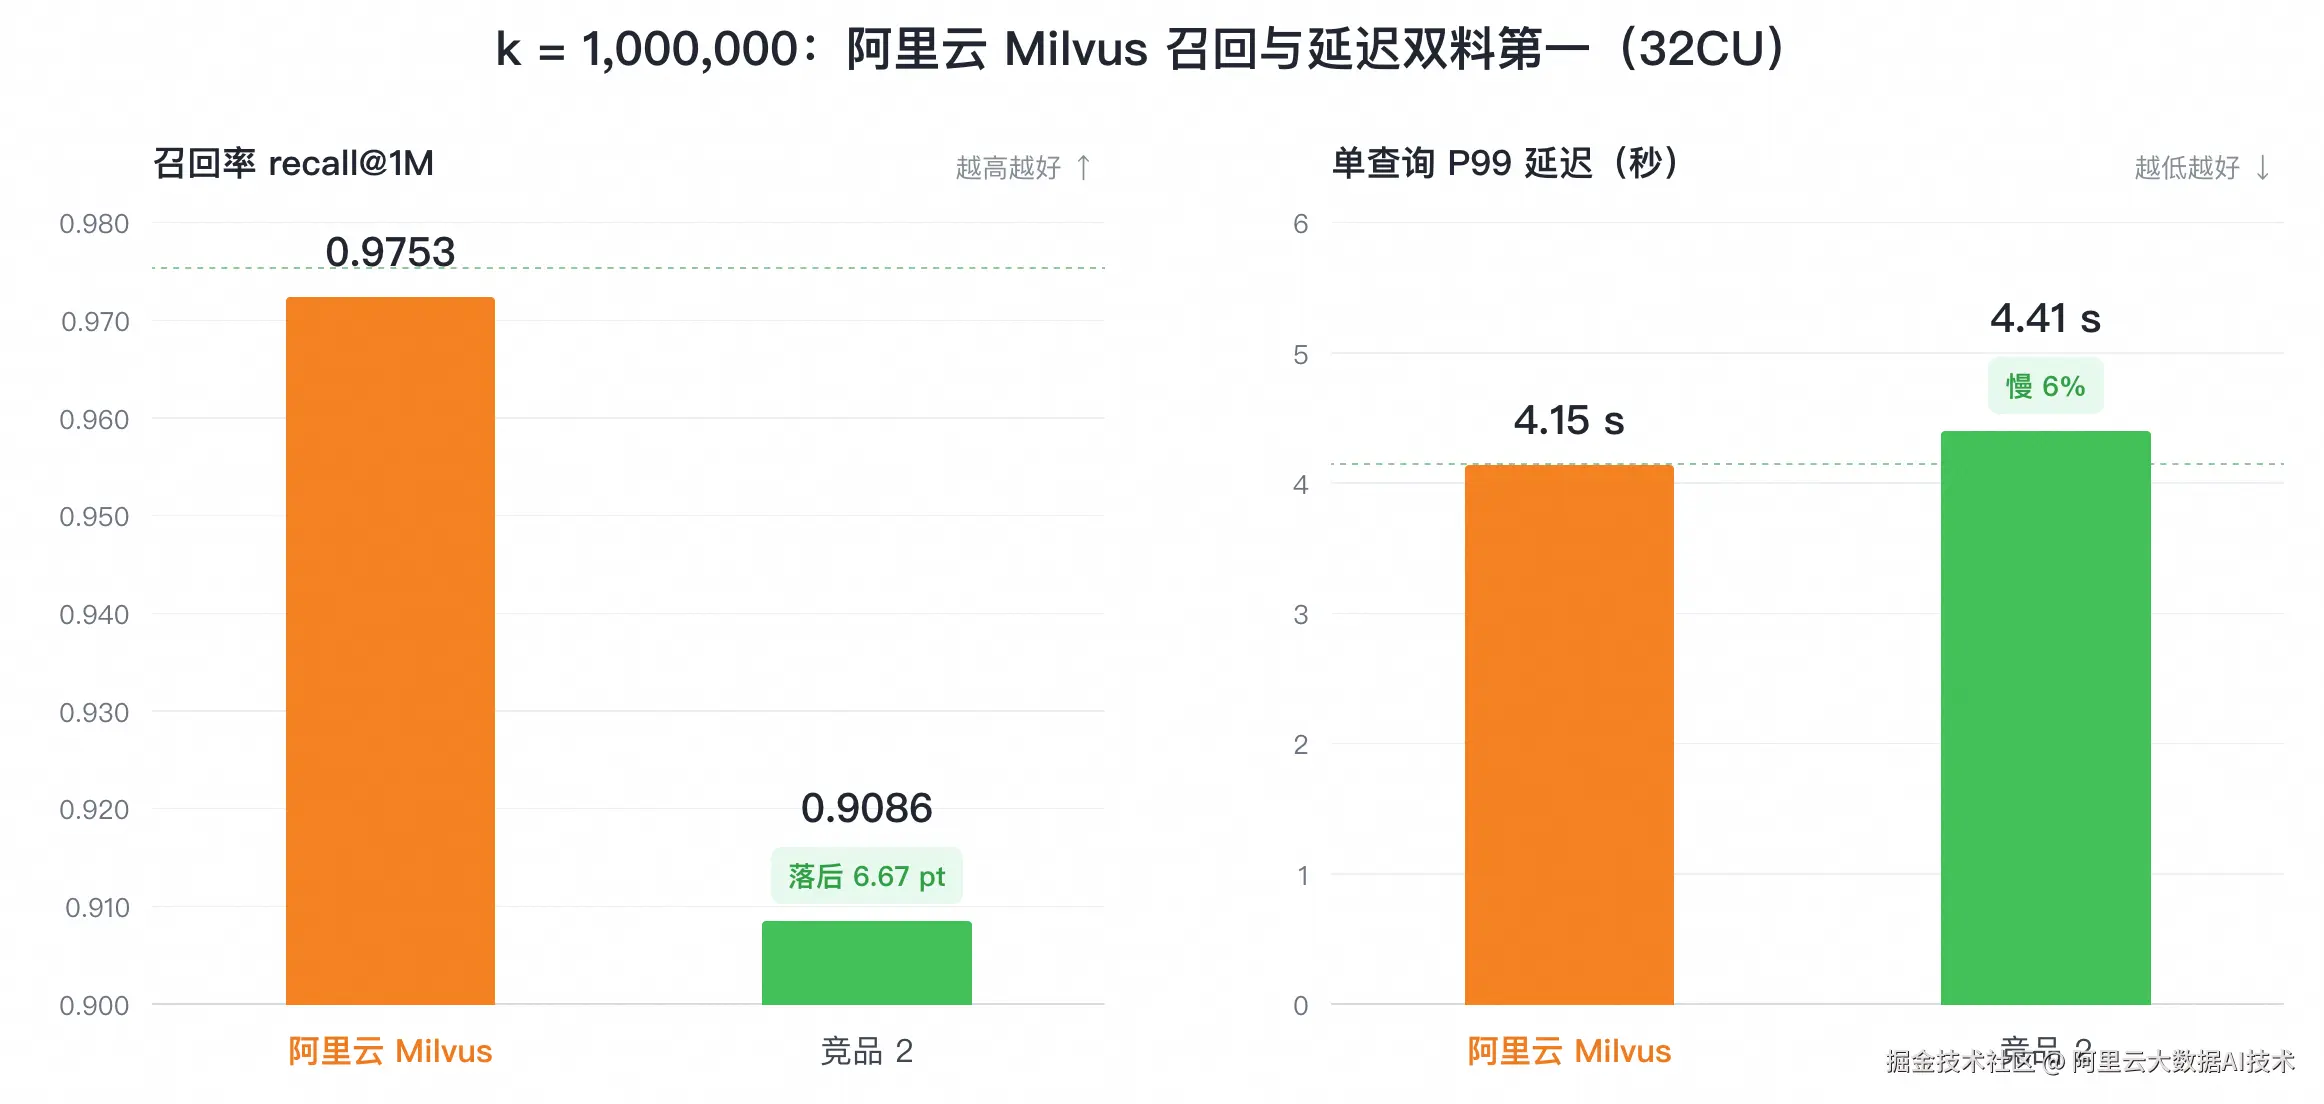
如何使用 Large TopK 能力
在使用最新阿里云 Milvus 容量型集群 容量型索引索引的基础上,只需要打开 large TopK 查询开关,无需重建或者重新加载索引。
1、容量型磁盘索引准备
容量型索引使用文档:在阿里云 Milvus 上使用容量型磁盘索引
阿里云 Milvus 版本:2.6.18-0.2.2_3.11.2 版本及以上
2、在 collection 上打开 large topk 模式查询开关
- 如果是新建 collection,推荐创建时设置属性
python
from pymilvus import MilvusClient

client = MilvusClient(uri="your_uri", token="your_token")

client.create_collection(
    collection_name="your_collection",
    schema=schema,
    index_params=index_params,
    properties={"query_mode": "large_topk"}
)- 如果是已存在 collection,可以动态打开查询开关,已处于加载状态无需重新加载
python
from pymilvus import MilvusClient

client = MilvusClient(uri="your_uri", token="your_token")

client.alter_collection_properties(
    collection_name="your_collection",
    properties={"query_mode": "large_topk"}
)
3、索引构建和 load 完成后执行查询,指定 limit 大小
python
from pymilvus import MilvusClient

client = MilvusClient(uri="your_uri", token="your_token")

results = client.search(
    collection_name="your_collection",
    data=[query_vector],
    limit=1000000
)
测试条件
-
Benchmark:VectorDBBench
-
数据集:Performance768D100M
-
测试算力:相同 128CU 计算资源或者引擎可选上限
结语
在 k=10 / k=100 的常规赛道上,主流向量引擎的差距往往只是几个百分点的召回与几倍的吞吐。但当业务真正需要一次召回百万级候选时,差距会被放大成能与不能的区别:阿里云 Milvus,Topk 查询上限 1,000 万,且完整返回;在 k=1百万上召回与延迟双料第一;小 topk 场景同样最优。如果你的业务涉及召回+精排两阶段架构、大规模去重聚类、或亿级库的离线语义挖掘,Large TopK 能力应当被列为选型的一级指标。在这个场景上,阿里云 Milvus 目前是明确的领先者。