很多从 Java 过来的同学看 LangGraph 文档会觉得概念满天飞:State、Node、Edge、Checkpointer、interrupt......其实你写过状态机、用过工作流引擎,这些概念一个都不新。这篇文章用一套 Java 心智映射表讲清 LangGraph,再用我的客服 Agent 实例走一遍,最后给实测数据。
心智映射表
| LangGraph | Java 世界里最像的东西 | 一句话职责 |
|---|---|---|
| StateGraph | 流程定义(Activiti 的 BPMN) | 声明有哪些节点、怎么流转 |
| State | 贯穿调用链的 Context/DTO | 各节点共享读写的上下文 |
| Node | 一个 Handler/Service 方法 | 读状态 → 干活 → 返回状态增量 |
| 条件边 | if/else 路由器 | 按状态决定下一个节点 |
| add_messages reducer | 集合合并策略(add 而不是 set) | 声明字段更新是"追加"还是"覆盖" |
| Checkpointer | 把流程实例状态落库的持久化层 | 断点续跑、跨重启恢复 |
| interrupt() | 人工任务节点 | 流程挂起,等人工决策后继续 |
对齐了这张表,LangGraph 就不再神秘:它就是把状态机显式化的编排框架。
State 那一行值得单独看一眼代码。LangGraph 的状态是一个 TypedDict,字段可以声明"归并方式"(reducer):
python
class AgentState(TypedDict, total=False):
    """客服 Agent 的状态。

    total=False 表示字段都可以缺省,节点只需返回自己要更新的键。
    """
    # 对话消息列表。Annotated[..., add_messages] = 追加式更新
    messages: Annotated[list, add_messages]

    # 意图分类结果:order(查订单)/ knowledge(政策咨询)/ refund(退款)/ chat(闲聊)
    intent: str
messages 声明了 add_messages:节点返回 {"messages": [AIMessage(...)]} 时,新消息追加 到列表尾部,而不是替换整个列表------这就是多轮记忆在状态层的地基。用 Java 的话说,这相当于给字段指定了合并策略:往 Collection 里 add,还是引用直接 set。intent 没声明 reducer,就是朴素的覆盖写。
实例:电商售后客服 Agent
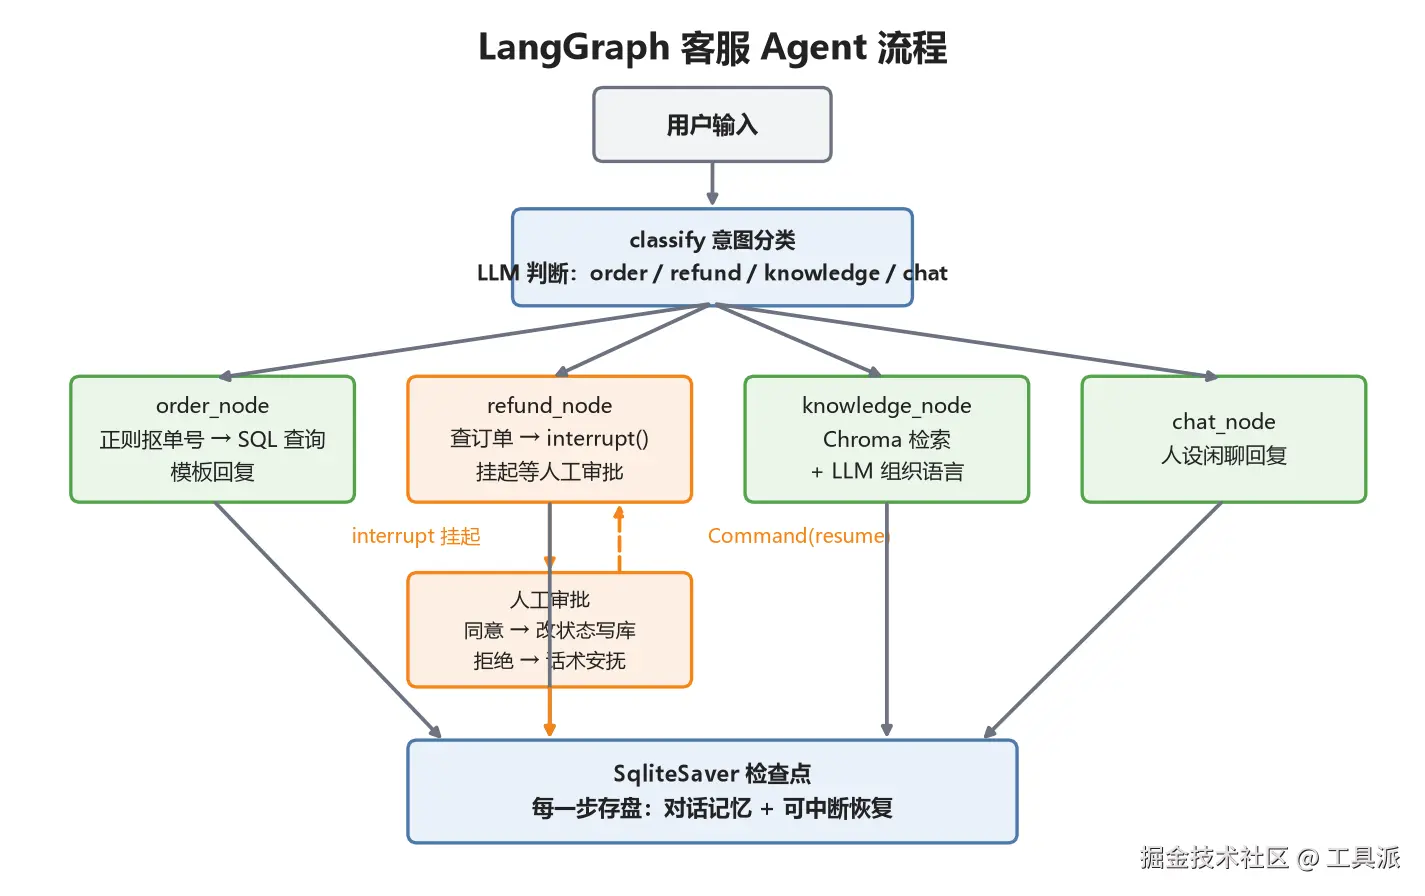
我做的客服 Agent 有五类意图:查订单、售后政策、退款、投诉、闲聊。图的结构一句话讲完------
text
START → classify(意图分类) →条件边→ order / knowledge / refund / complaint / chat → END组图的代码就是这几行,读完你会有点失望------原来"编排 Agent"这么朴素:
python
def build_graph(checkpointer: BaseCheckpointSaver | None = None):
    """构建并编译客服 Agent 图。

    结构:
        START → classify →(条件边)→ order/refund/knowledge/chat 四个节点 → END
    传入 checkpointer 后,每个 thread_id 的对话状态独立持久化:
    多轮记忆和中断恢复都靠它。
    """
    builder = StateGraph(AgentState)
    builder.add_node("classify", classify_node)
    builder.add_node("order_node", order_node)
    builder.add_node("refund_node", refund_node)
    builder.add_node("knowledge_node", knowledge_node)
    builder.add_node("chat_node", chat_node)
    builder.add_node("complaint", complaint)

    builder.add_edge(START, "classify")
    # 条件边:classify 之后按 route_by_intent 的返回值决定去向
    builder.add_conditional_edges("classify", route_by_intent)
    for node in ("order_node", "refund_node", "knowledge_node", "chat_node", "complaint"):
        builder.add_edge(node, END)

    return builder.compile(checkpointer=checkpointer)
add_node 注册节点、add_edge 连边、add_conditional_edges 挂路由函数、compile 出图------和画一张 Activiti 流程图的 API 没有本质区别。注意 checkpointer 是在 compile 时注入的:不传它,图跑完状态即丢;传了它,同一段代码就有了多轮记忆和中断恢复两种能力,业务节点对此完全无感。
classify 节点是唯一的 LLM 分类调用:提示词要求模型只输出一个类别单词,代码里再做合法性兜底(输出不在五个合法值里就走闲聊分支)------不信任模型的自由文本,是写 Agent 的基本素养。提示词和节点原样贴出来:
python
CLASSIFY_PROMPT = """你是客服系统的意图分类器。把用户最后一句话分成以下四类,只输出类别单词:
order     ------ 查询订单状态、物流进度(通常含订单号或"我的订单")
refund    ------ 明确要求退款、退货退款(涉及钱款退回的操作)
knowledge ------ 咨询售后政策:退货规则、运费、保修、发票、发货时效等
chat      ------ 打招呼、寒暄、其他无法归类的闲聊
complaint ------ 用户表达不满、抱怨服务或商品、要求投诉/索赔/升级处理
只输出一个单词,不要解释。"""


def classify_node(state: AgentState) -> dict:
    """意图分类节点:输出写入 state["intent"],供条件边读取。"""
    intent = _chat(CLASSIFY_PROMPT, _last_user_text(state)).lower()
    # 防御性处理:模型可能输出多余字符,只认四个合法值
    for label in ("complaint", "refund", "order", "knowledge", "chat"):
        if label in intent:
            return {"intent": label}
    return {"intent": "chat"}
校验的写法是"包含匹配"而不是全等:模型偶尔会输出 Intent: order 这种带前缀的文本,label in intent 能兜住;五个合法值一个都不在,就落到 chat。顺带交代一个已知的小瑕疵:提示词首行写着"分成以下四类",实际列了五个类别------这是我后来加 complaint 分支时忘了改注释,合法值校验按五个来,不影响行为,但属于要清理的注释债。条件边的路由函数就是一张映射表:
python
def route_by_intent(state: AgentState) -> str:
    """条件边的路由函数:把 intent 映射成下一个节点名。"""
    return {
        "order": "order_node",
        "refund": "refund_node",
        "knowledge": "knowledge_node",
        "complaint": "complaint",
    }.get(state.get("intent", "chat"), "chat_node")
dict.get 的第二个参数是第二层兜底:就算 intent 被污染成未知值,图也永远有边可走。Java 工程师可以把这一行读成 switch 的 default 分支。
业务节点 里有个重要的设计原则:工具执行必须是确定性代码。查订单节点拿到单号后走 SQL 查询,回复用模板拼装------单号、金额这种关键数据绝不让模型转述,模型只负责"决策调哪个工具",不负责生产事实。order_node 完整代码:
python
def order_node(state: AgentState) -> dict:
    """查订单节点:提取单号 → SQL 查询 → 模板化回复(确定性输出,不让模型编单号)。"""
    order_no = _order_no_from_state(state)
    if not order_no:
        reply = "请提供您的订单号(格式如 E2025001),我马上帮您查询。"
        return {"messages": [AIMessage(content=reply)]}

    order = query_order(order_no)
    if not order:
        reply = f"未查询到订单 {order_no},请核对单号是否正确,或联系人工客服核实。"
    else:
        reply = (
            f"为您查到订单 {order['order_no']}:\n"
            f"- 商品:{order['product']}\n"
            f"- 金额:¥{order['amount']}\n"
            f"- 状态:{order['status']}\n"
            f"- 物流:{order['logistics']}\n"
            f"- 下单时间:{order['created_at']}"
        )
    return {"messages": [AIMessage(content=reply)]}
回复模板里没有一个字经过模型。单号提取也是正则,不是让模型"找找看":
python
ORDER_NO_PATTERN = re.compile(r"E\d{6,}")

def extract_order_no(text: str) -> str | None:
    """从用户输入中提取订单号,没有则返回 None。"""
    match = ORDER_NO_PATTERN.search(text.upper())
    return match.group(0) if match else None
这条原则的价值评测里能直接看到:查订单场景的回复就是模板渲染的结果,金额 ¥349.0、状态"运输中"与订单库逐字一致,这类断言可以写得非常死。
查询本身也是普通到不能再普通的代码------单号做参数化 SQL,查无此单返回 None:
python
def query_order(order_no: str) -> dict | None:
    """查订单工具:按单号查 mock 订单库。

    返回订单字典;查无此单返回 None。真实项目里这里是调订单中台的 REST API。
    """
    conn = sqlite3.connect(str(config.ORDERS_DB))
    conn.row_factory = sqlite3.Row
    try:
        row = conn.execute(
            "SELECT order_no, user_name, product, amount, status, logistics, created_at "
            "FROM orders WHERE order_no = ?",
            (order_no,),
        ).fetchone()
        return dict(row) if row else None
    finally:
        conn.close()
Java 工程师看到这里应该彻底放心了:这一层就是一个 DAO 方法,没有魔法。所谓"Agent 的工具调用",在确定性这一侧就是函数调用;LLM 的参与被压缩到"决策"那一刻------这条边界划得越清楚,系统越可测。
退款节点 是整个图的灵魂:涉及资金的操作,流程走到这里用 interrupt() 挂起,把订单信息抛给人工审批,人批复之后用 Command(resume=...) 恢复执行。恢复时节点会从头重跑,所以 interrupt 之前的代码必须幂等(查订单是只读 SQL,满足),写库操作放在 interrupt 之后,保证审批通过才执行、且只执行一次。这段机制展开讲又是一篇长文,我在 Checkpointer 踩坑实录那篇里单独拆了。
实测数据
这套图跑起来是什么水平?我建了一套 11 个场景的评测:意图路由 10 个场景对 9 个(错的那条是超纲问题被分到闲聊分支,但兜底话术依然得体),11 项全断言场景通过 10 个;退款从挂起、人工批复"同意"到订单库状态真实变更为"退款中",全链路通过,且恢复执行 0 次 LLM 调用(重跑的是模板逻辑)。平均每轮耗时 1.0 秒,19 轮评测总 token 成本不到 1 分钱。
退款全链路值得把三步的真实记录摆出来看。第一步,说"我要退款,订单号 E2025001",图在 interrupt 处挂起,回传给审批方的是结构化信息------interrupt挂起: order_no=E2025001 金额=199.0 商品=无线蓝牙耳机;第二步,批复"同意"后图恢复,回复是模板渲染的"退款申请已审批通过 √ 订单 E2025001(¥199.0)已转入退款流程",同时订单库里这条记录的状态真实变成了"退款中";第三步,用户不死心再说一次"我要退款,订单号 E2025001",状态机直接拦下:"订单 E2025001 当前状态为「退款中」,无需重复申请。"------防重逻辑在查订单之后、挂起之前,一条状态判断就挡住了重复申请,这同样是确定性代码的功劳。
补一条错分场景的真实记录。问"年假有几天?"(知识库是售后政策,没有年假),分类节点把它分到了 chat 而不是 knowledge,但闲聊分支的兜底回复是:
这个我帮不上忙哦~我是电商售后客服,主要负责订单和售后问题(退换货、运费、物流等)。年假属于公司人事政策,建议您咨询HR或查看员工手册哈~😊
路由错了,结果没崩------这就是"每个分支都有体面兜底"的价值。对评测的诚实解读:意图路由是这套系统里最薄弱的一环(单次 LLM 调用,边界样本会抖),但它错的代价被架构兜住了。
对 Java 工程师的上手建议就一条:别把它当新框架学,把它当你熟悉的状态机写------先画图(节点、边、条件),再逐节点写纯函数,最后接 LLM。
代码在这里,含完整的图定义和评测报告: