如一 Agent 架构解读(四):异步整理------压缩不该堵住用户
上一篇把压缩展开成一架五级成本阶梯,但那架阶梯有一个共同的隐含假设:所有压缩都发生在模型调用边界,同步执行。这篇拆这个假设。上下文超了就必然要等压缩完成吗?不一定------"算"和"换"本来就不是一回事。
开题:同步压缩的三宗罪
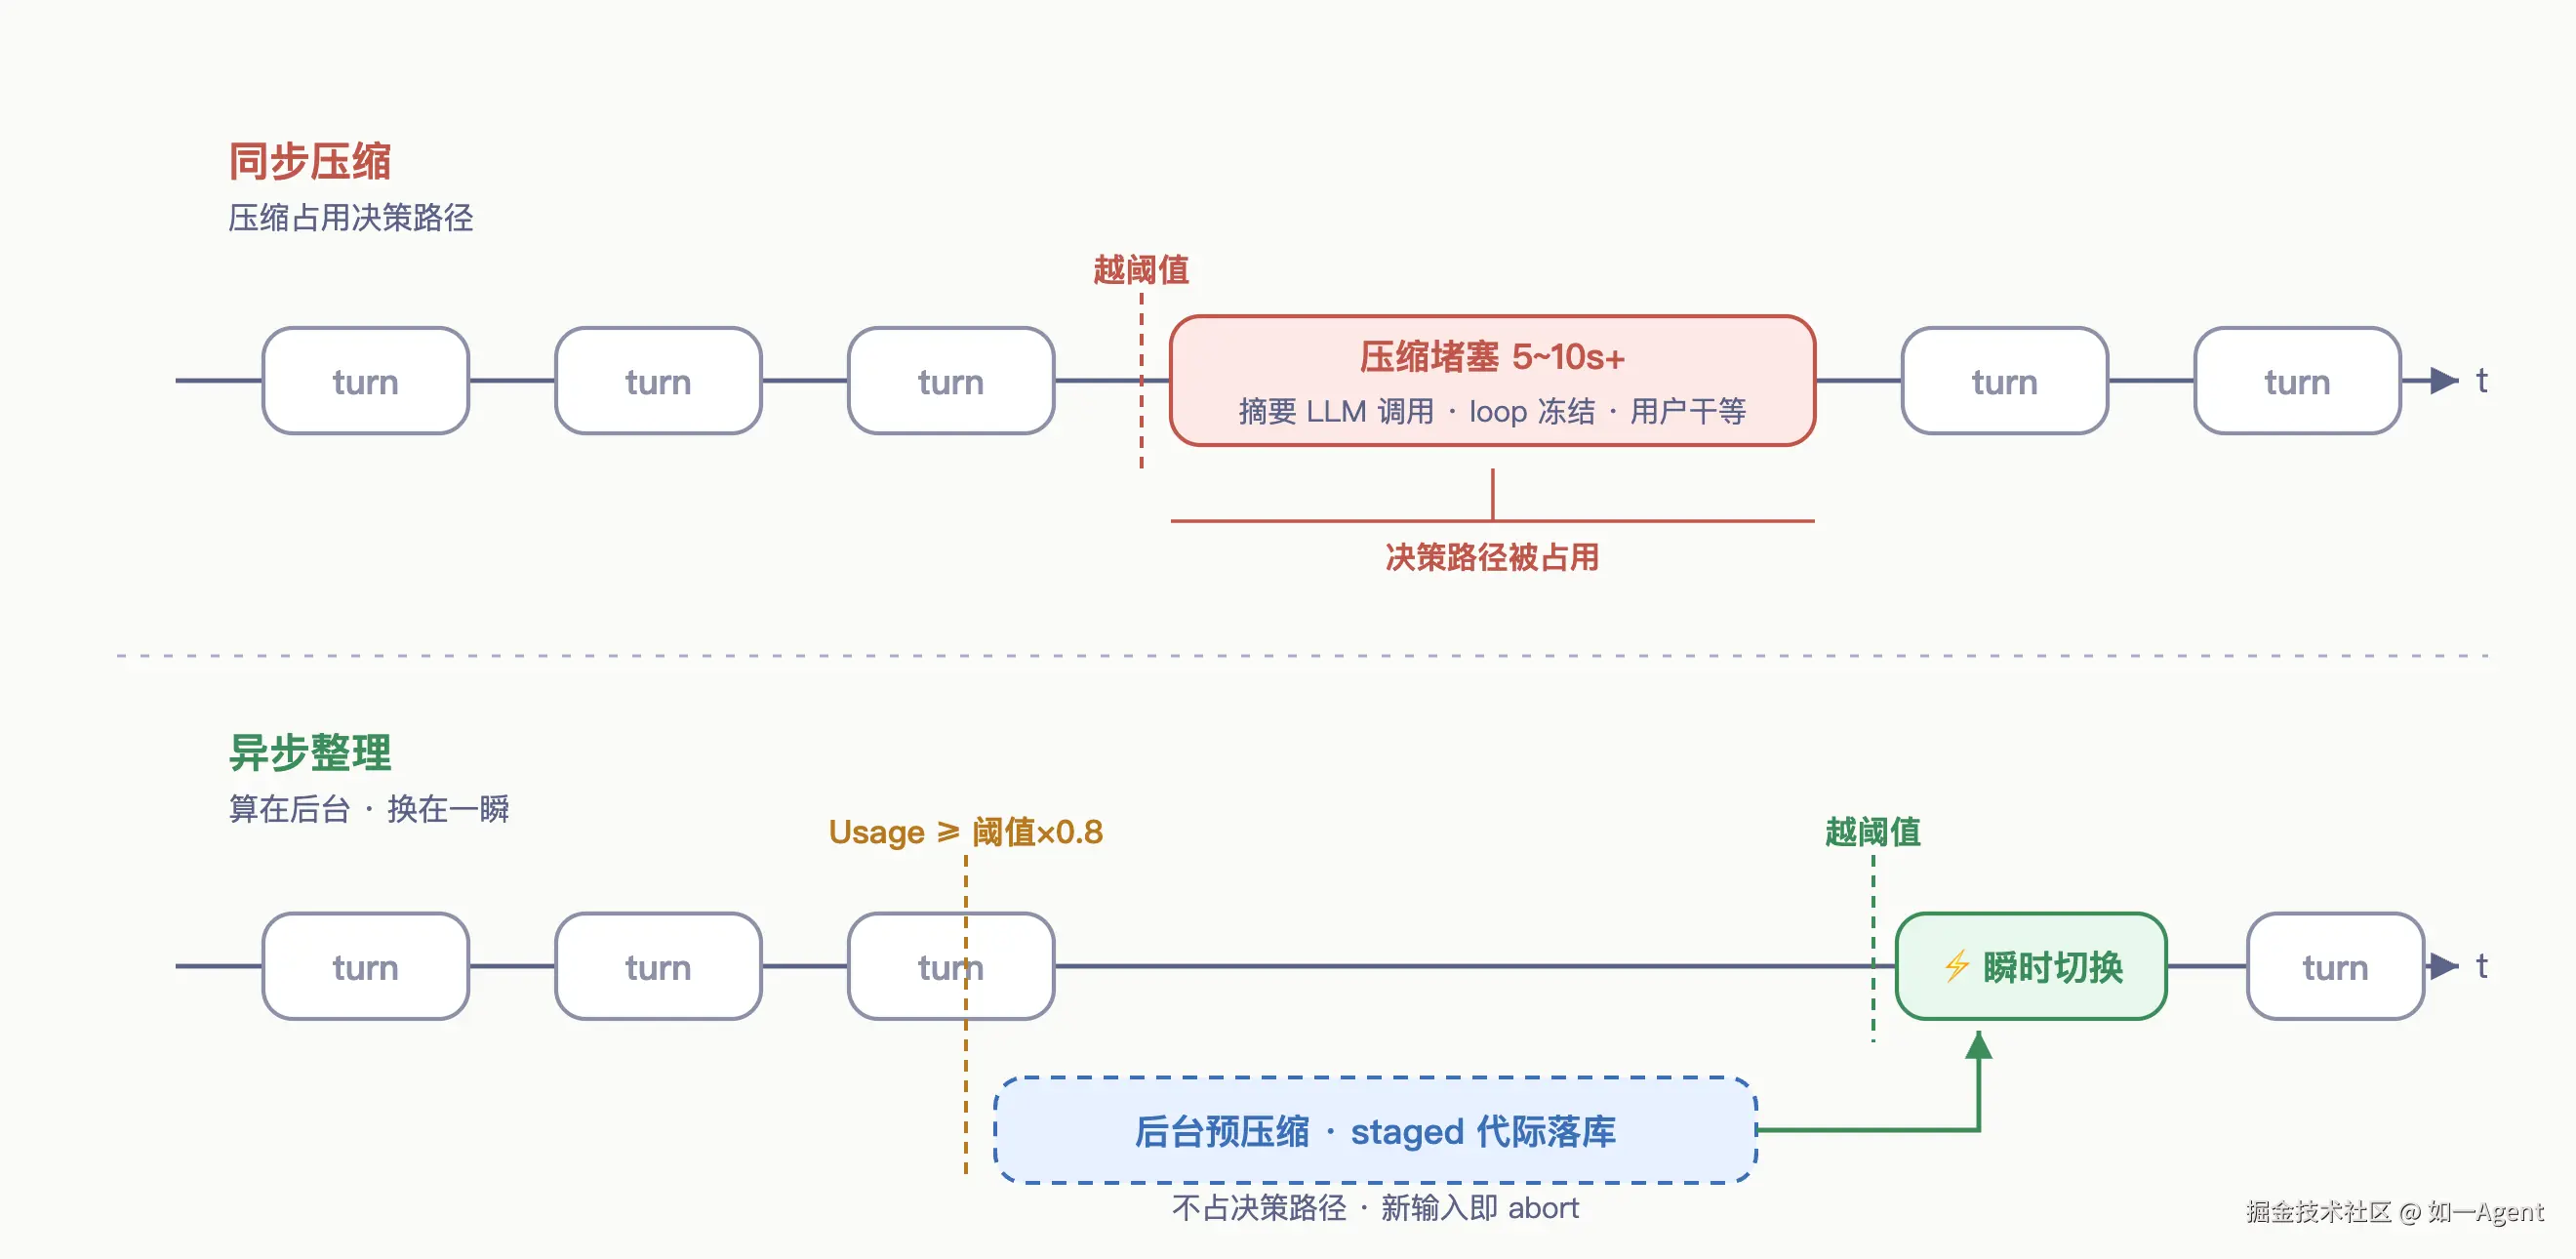
先描述一个每个 Agent 用户都见过的场景:对话正酣,Agent 突然卡住,转圈十秒,然后像什么都没发生一样继续------它刚做完一次同步压缩。这个"卡一下"背后是三宗结构性罪过:
一曰堵。摘要是一次完整的 LLM 调用,5~10 秒起步,期间整个 loop 冻结。Claude Code 的源码里甚至专门给远端 bridge 加 30 秒 keepalive------因为压缩调用太长,WebSocket 会被服务端当空闲断连。用户看到的是转圈,系统扛的是连接维持。
二曰冷。摘要请求是独立报文,每次压缩都冷烧一次全量 prefill。压缩省下的 token,有一部分当场还给了摘要自身。
三曰急。越阈值的当口才现算,质量没有回旋余地:摘要失败只能下轮重试,连败就熔断停用------在最需要压缩的时刻,压缩恰恰最脆弱。
三宗罪的共同根源:把"算"(生成摘要、选定切点)和"换"(切换投影)绑在同一时刻、同一条决策路径上。本篇的核心命题由此而来:
算换分离------"算"随时可以在后台,"换"只在安全边界的一瞬。
业界调研:四派答案
业界没有谁做到了"全异步",但成熟方案都在用自己的方式逼近算换分离。按证据硬度排:
Claude Code:增量预抽取派
CC 的 SessionMemory 是"算异步/换同步"的生产级实证,源码注释写得很直白:后台 fork 子代理定期抽取会话要点,"without interrupting the main conversation flow"。整套机制四个要点:
- 安全点双门:只在「最后一个 assistant turn 无 tool call」(工具链已闭合、历史静态)且「token 增量过门槛」(不做无用功)时才启动后台抽取;
- 压缩时零现算 :自动压缩触发时先试现成 memory 直接换投影,全量摘要降级为 fallback------同步压缩从"现算大摘要"退化为"轻量 swap";
- fork 缓存共享 :后台摘要 fork 复用主线程的前缀缓存,代价是 cache-key 参数必须全等------源码注释专门警告:不要给 fork 设 maxOutputTokens,否则 thinking 配置失配、缓存当场作废;
- 烧钱闸门 :连败 3 次熔断。这个数字是学费换来的------遥测发现 1279 个会话单会话连败 50 次以上(最高 3272 次),全局每天浪费约 25 万次 API 调用。
另外它还有个最小化的空闲利用:awaySummary 在终端失焦 5 分钟后后台生成回顾摘要,用户回来即 abort------"用户空闲是免费算力窗口"的最简实现。
Letta:sleep-time compute 派
学术界的同构答案。Letta(前 MemGPT)的 sleep-time compute 让 Agent 在空闲期做记忆巩固:整理合并碎片化条目、重算重要性权重、生成更高层摘要、重建检索索引。核心主张与本文命题同构:把计算密集的记忆维护从在线路径移到离线路径。
但要看它的诚实警告:官方自己标注这是"研究原型",生产开启 token 开销高。空闲算力不是免费的,是账期后置------没有预算纪律的异步化,是把延迟问题换成成本问题。
Codex:平台卸载派
Remote V2 把压缩做成 API 原生能力:服务端加密 Compaction 项,客户端不用算也不用懂,信任交给平台。这是终态,但自建 runtime 抄不了------能学的是它的定位:压缩是平台能力,不是应用逻辑。
OpenHands:同步管道派(对照组)
condenser 模块在 loop 内同步冷凝,截断/摘要/保留轮次可配,没有任何异步设计。放在这里不是贬它------是为了说明:异步不是默认答案,是系统被延迟和成本抽打过之后的答案。
四派合流:五条设计律
把四家的做法压成一张表,就是异步整理的全部要义:
| # | 设计律 | 出处 |
|---|---|---|
| 1 | 算换分离:算随时可后台,换只在 run/turn 边界 | CC 全部设计、Letta 离线路径 |
| 2 | 安全点触发:工具链闭合的 turn 结束才可算,增量门槛防无用功 | CC 双门判据 |
| 3 | 预计算必须可失效:锚定进度、stale 判定、串行化、新输入即 abort | CC sequential + 15s 等待 + 1min stale |
| 4 | 缓存经济学:后台调用共享主前缀缓存,否则省下的延迟被冷烧 prefill 吃回 | CC fork 注释 |
| 5 | 烧钱闸门:连败熔断、并发闸、空闲才跑 | CC 熔断遥测、Letta 成本警告 |
第 4 条藏着一个有趣的推论。上一篇的差距清单里有一条"摘要独立 scene 冷烧 prefill",当时计划借鉴 CC 的 fork 缓存共享来修。但 CC 用主模型自己做摘要(thinking 关掉)正是为了凑参数全等、共享缓存 ------它是被同步路径逼的。异步化之后,预压缩在后台跑,冷烧 prefill 根本不占用户延迟,轻量摘要模型 + 独立报文反而成立。异步不是补一个功能,是把旧矛盾变没。
落地方案:如一的三阶段
调研到此为止,落地要回答自己的题。如一手里的牌和 CC 不同:
- 等待态是天然安全点 + 空闲窗口 :如一是 C 端分身,
ask/consent/交付确认这些等待用户的状态,工具链必然闭合、用户必然不在敲键盘------比 CC 拿终端失焦当信号强得多; - transcript 全量在 DB:后台整理就是查询与写入,没有 CC 的本地文件物化负担;
- 多实例无单点:后台任务过分布式锁(与 RunSlots 同一套),不存在"哪个进程来整理"的争议。
阶段一:预压缩(speculative compaction)
主线。思路一句话:在阈值到来之前,把压缩算好备着。
text
上一轮真实 Usage ≥ 阈值 × 0.8(且处于安全点)
→ 后台算好「摘要 + 切点」
→ 落 session_compactions 为 staged 代际(投影不动)
→ 真越阈值时看 boundary 之后新增量:
少 → staged 转正,新增进 tail,同步压缩零等待
多 → 丢弃重算,烧掉的算力当保费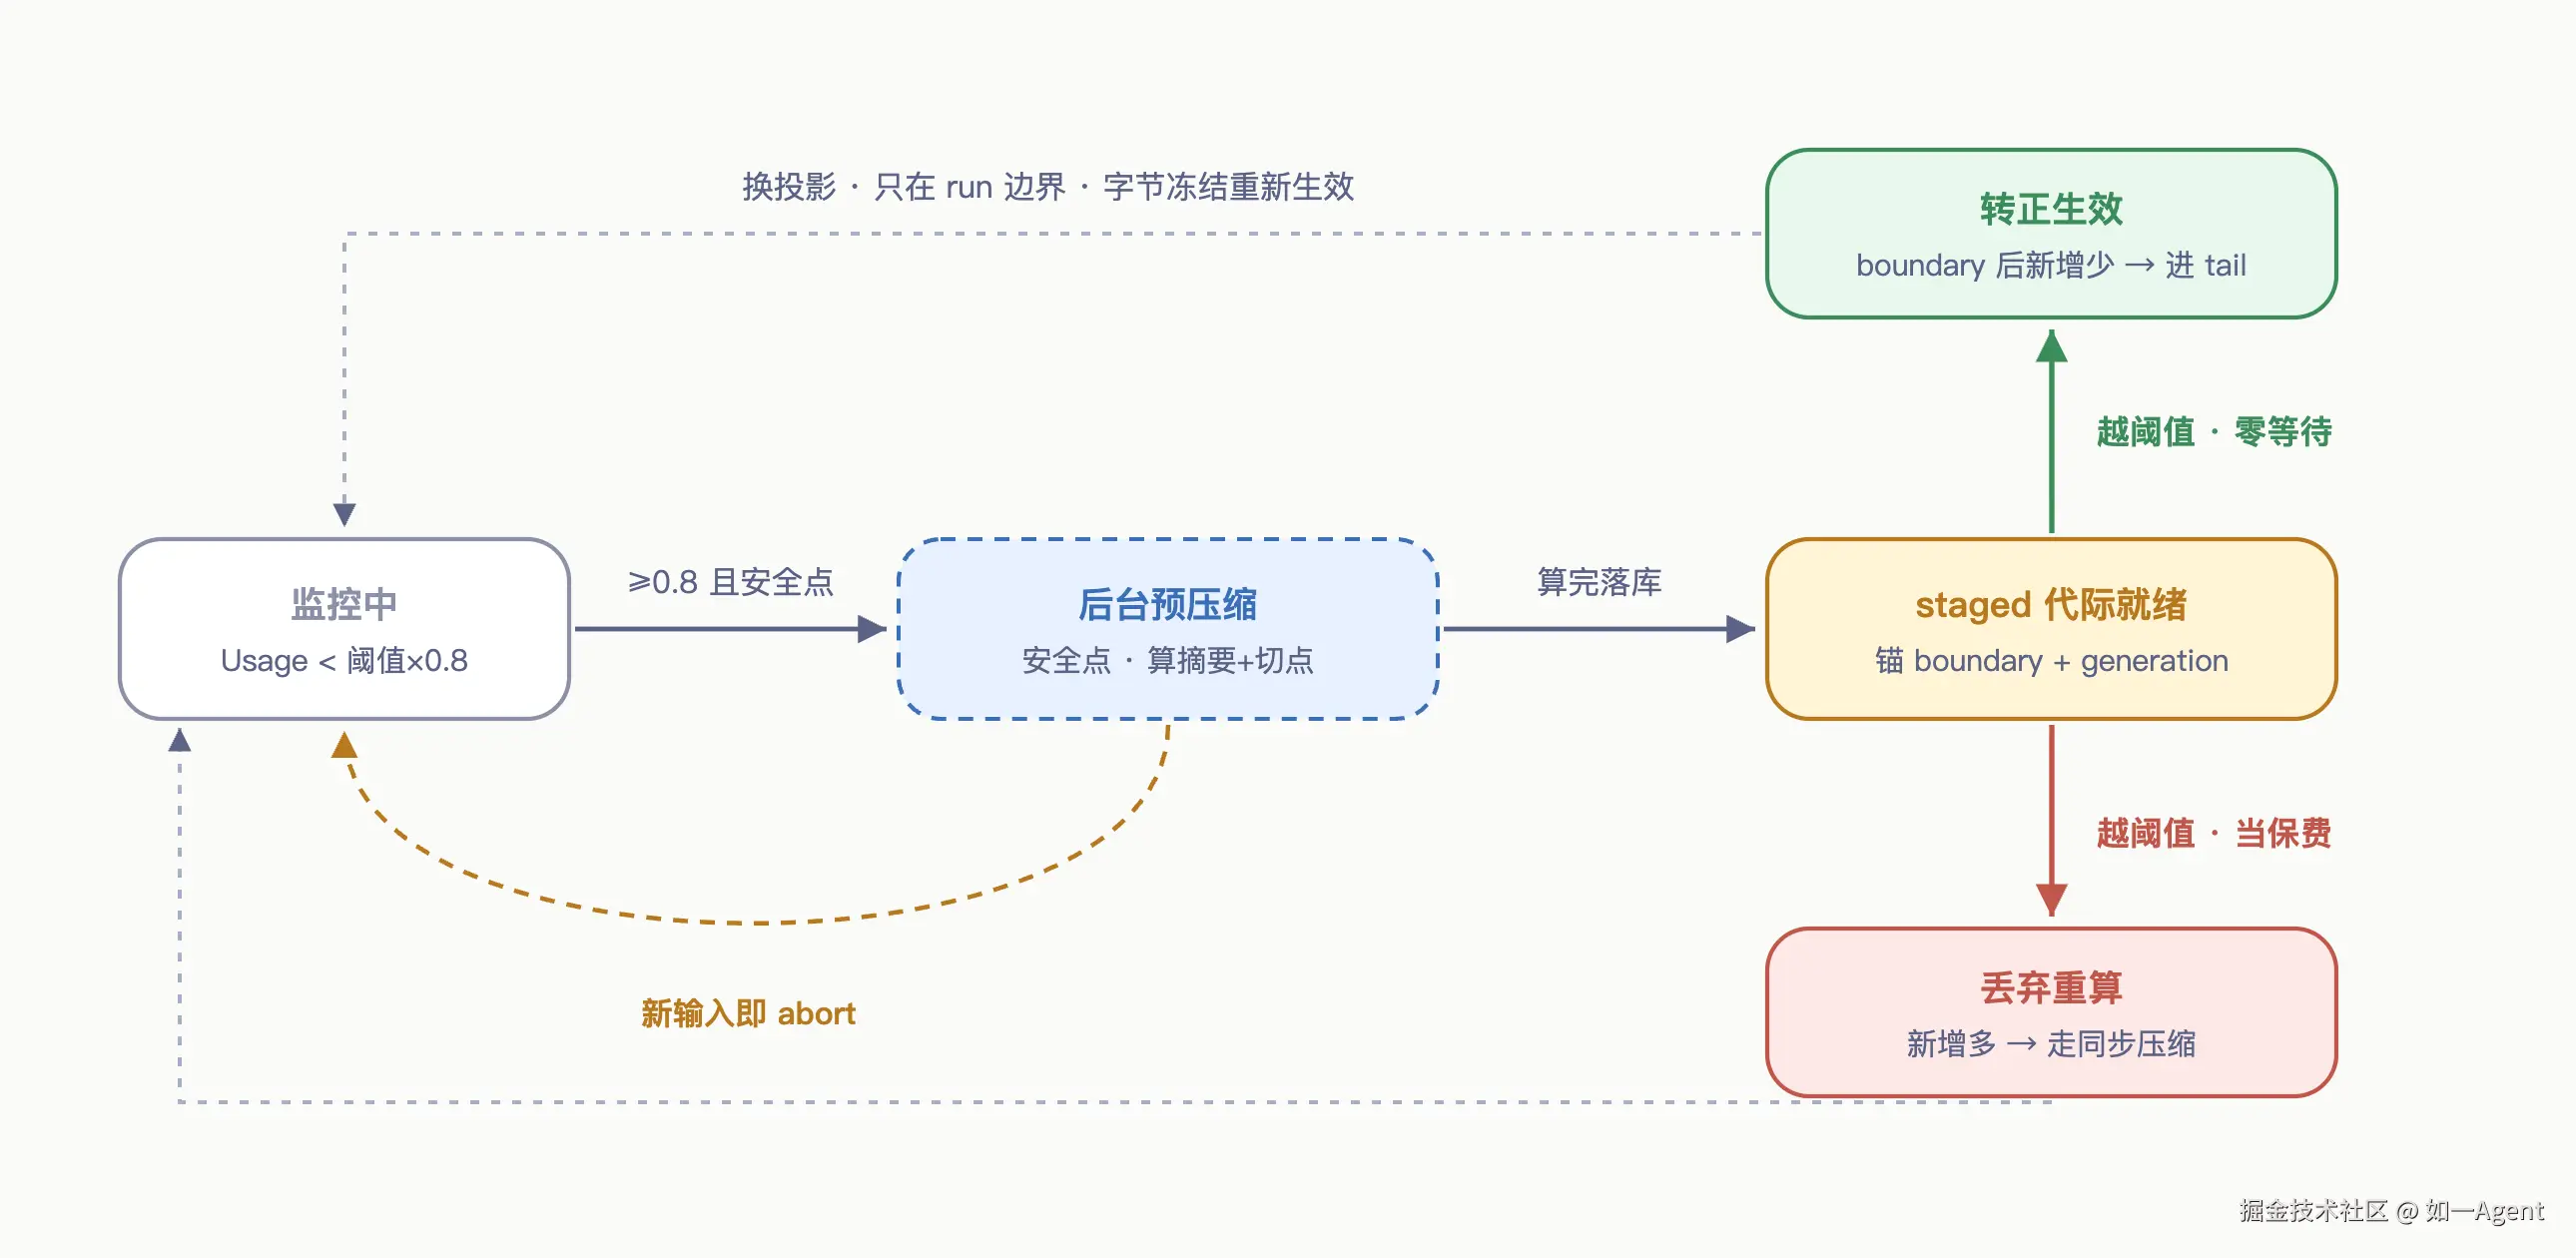 三个设计要点:
- 失效管理靠锚定:staged 摘要锚定 boundarySequenceNo + generation(上一篇埋的代际编号在此转正),失效判定只是比较序号,不需要任何语义判断;
- 换仍在一瞬:staged 转正、丢弃重算、常规同步压缩,三个路径的"换投影"动作完全同构,都发生在 run 边界------字节冻结不变量原封不动;
- 北极星指标是预压缩命中率:多少次阈值触发被 staged 救成零等待。命中率低说明 0.8 系数或安全点判据不对,调高提前量或放宽安全点,用数据调,不拍脑袋。
阶段二:增量抽取(给下一篇打地基)
安全点上做增量整理,产物不是 CC 那样的 memory 文件,而是话题卡------已结束的话题降级为「结论 + 未兑现承诺 + 文件/产物指针」。这是"部分内容折叠、话题级再整理"的地基,本篇只立机制(什么时候算、怎么串行、怎么失效),话题语义留给下一篇。
阶段三:空闲窗口(C 端成本纪律)
用户离开、夜间这类天然空闲批量整理。但 C 端多租户,后台烧的是毛利------熔断器与并发闸先于功能上线,这是 CC 25 万次调用买的教训,不能白嫖人家的学费。
验收:三个不变量一份答卷
上一篇立的三个不变量,异步化不是豁免理由,是验收标准:
- 历史不可篡改------后台只写派生层(staged 代际、话题卡),会话消息表依旧绝对真实;
- 投影字节冻结------异步只提前"算","换"永远发生在 run 边界,换完冻结重新生效。mid-turn 换投影这件事在代码里不存在路径;
- 压缩不能压死自己------后台整理独立预算、独立熔断、新输入即 abort,任何失败路径用户零感知。
收个尾。同步压缩是"撞了才整,整了就堵";异步整理是"闲时勤整,整了备用,换在一瞬":
算换分离是全部要义,预压缩命中率是全部考核。
配图:同步压缩 vs 异步整理时序对比(决策路径上的堵塞段 vs 后台预计算+瞬时切换)、预压缩状态机(staged → 转正/丢弃)------与系列同设计语言。