批量数据处理作业中,输入还有大量数据等待处理,现有节点也已繁忙,但计算任务可能受 Ray Data 的算子资源预算约束,暂时无法继续提交。启用自适应弹性扩容后,满足条件的任务可以超出这一预算,进入 Ray Core 调度,并在需求超过当前容量时请求扩容。
它的作用是让更多待处理任务的资源需求进入调度与扩容流程。任务依然按照声明的资源需求等待调度,扩容速度取决于集群配置、资源供给和节点启动时间。
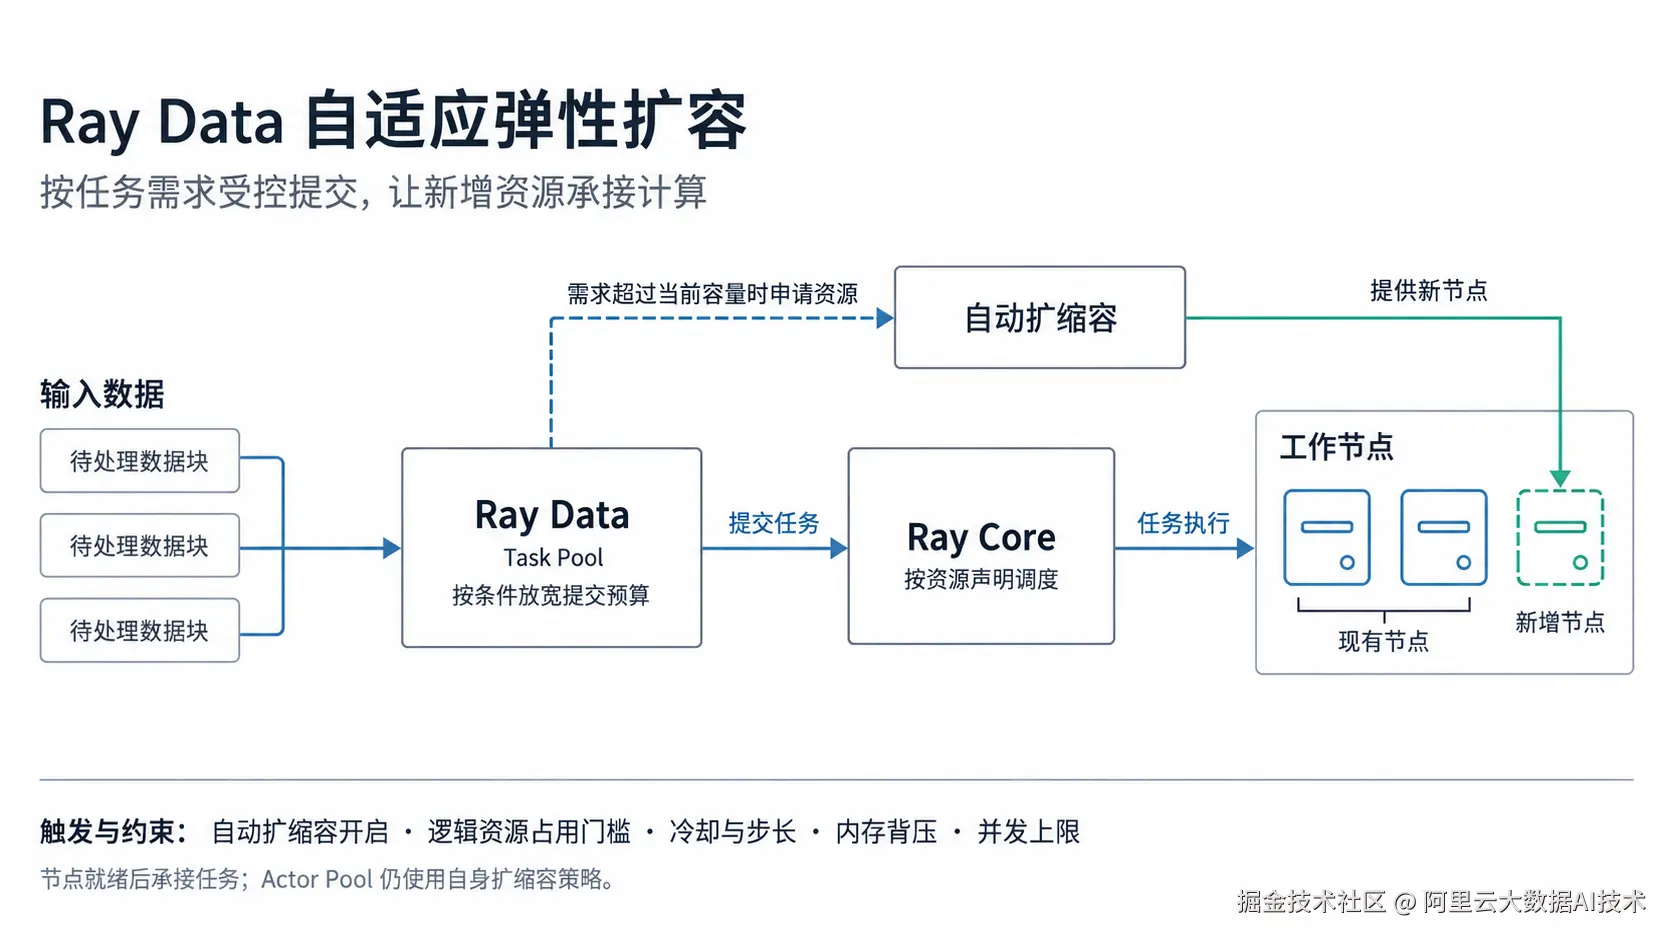
图 1:任务提交与节点扩容分别推进;新节点就绪后,由 Ray Core 按资源声明调度任务。
1. 什么场景适合开启
优先用于开启自动扩缩容、任务可以独立并行的批处理作业,例如文本清洗、图片预处理、特征计算。开始前确认:
-
集群还有扩容空间。 已启用自动扩缩容,节点上限与资源配额允许继续增加容量。
-
确实有可并行的任务。 输入有足够的数据块,处理阶段采用 Task Pool,且并发上限没有把任务数限制得过小。
-
瓶颈在计算资源供给。 如果已经存在大量对象存储积压、spill 或输出写入阻塞,应先解决这些问题,再增加计算并发。
当前开关作用于 Task Pool 算子 。普通函数形式的 map_batches 默认使用 Task Pool;传入可调用类的模型推理通常使用 Actor Pool,其扩缩容应通过 Actor Pool 自身的配置调整。混合管道中的任务阶段可以使用自适应弹性,Actor 阶段仍遵循自身策略。
2. 在处理代码中开启
先从 CPU 任务开启、GPU 任务保持原有预算控制 开始,其他参数保留默认值。下面示例读取含 id 和字符串 text 的 Parquet 数据,完成文本规范化并写出结果。保存为 job.py,替换 OSS 路径后提交:
python
import re
import unicodedata

import numpy as np
import ray


def normalize_text(batch):
    texts = [
        re.sub(r"\s+", " ", unicodedata.normalize("NFKC", text)).strip()
        for text in batch["text"]
    ]
    return {"id": batch["id"], "text": np.asarray(texts, dtype=object)}


ray.init(address="auto")
ctx = ray.data.DataContext.get_current()
ctx.task_resource_overcommit_enabled = True
ctx.task_resource_overcommit_cpu_enabled = True
ctx.task_resource_overcommit_gpu_enabled = False

ds = ray.data.read_parquet("oss://<bucket>/input/texts")
ds = ds.map_batches(
    normalize_text,
    batch_format="numpy",
    batch_size=256,
    num_cpus=1,
)
ds.write_parquet("oss://<bucket>/jobs/run-001/output", mode="append")
在创建 Dataset 前配置 DataContext,并保留默认启用的算子资源预留机制。目标运行时需要支持上述配置项;不要仅凭 Ray 版本号判断产品扩展是否可用。
示例未固定 concurrency,由框架按输入与资源情况调度。batch_size=256 和 num_cpus=1 只是示例起点:前者控制 UDF 每批处理的行数,后者声明每个任务所需的逻辑 CPU,均应按业务负载调整。每个业务批次使用独立输出路径。
配置好产品网关与身份认证后,按正常方式提交即可,无需额外的扩容脚本:
bash
# ray job submit 前必须设置 ray address 和 headers
export RAY_ADDRESS='https://emr-spark-ray-gateway-cn-hangzhou.aliyuncs.com'
export RAY_JOB_HEADERS='{"ray-token": "<RAY_TOKEN>"}'

ray job submit --working-dir . -- python job.py
3. 先使用默认保护,再调整扩容节奏
自适应弹性默认关闭。开启后仍受资源占用门槛、扩容步长和冷却时间限制,同时保留对象存储背压与算子并发上限。
| 配置 | 当前默认值 | 使用建议 |
|---|---|---|
task_resource_overcommit_enabled |
False |
在确认自动扩缩容可用后开启。 |
task_resource_overcommit_cpu_enabled |
None,跟随总开关 |
本例显式设为 True,允许 CPU 任务使用自适应弹性。 |
task_resource_overcommit_gpu_enabled |
None,跟随总开关 |
CPU 预处理场景先设为 False;GPU 任务按实际需求单独评估。 |
task_resource_overcommit_cooldown_s |
120.0 秒 |
先保留默认值;结合节点就绪耗时和积压变化决定是否调整。 |
task_resource_overcommit_step_factor |
1.5 |
控制相对于当前集群容量的阶梯上限;不代表立即扩容到 1.5 倍。 |
CPU/GPU 独立开关为 None 时跟随总开关;显式设为 True 或 False 时,覆盖总开关对该资源类型的设置。本例使用总开关 True、CPU 开关 True、GPU 开关 False。一个同时申请 CPU 和 GPU 的任务,需要两类资源都允许自适应弹性才能走这条提交路径;示例关闭 GPU 自适应弹性后,这类任务继续按正常预算调度。
当前实现还保留单次增量限制和资源占用门槛,通常无需一起修改。这里的"资源占用"来自 Ray 的逻辑资源分配,例如总 CPU 与可用 CPU 的差值,不能直接当作操作系统 CPU 使用率或 GPU 计算利用率。
冷却时间限制的是进一步超额提交的节奏,正常预算内的任务仍可继续运行。先观察默认配置,避免同时缩短冷却时间、扩大阶梯上限和提高并发,导致难以判断变化来源。
4. 观察效果,按瓶颈调整
开启后,重点观察 待调度任务、节点数量、处理吞吐、对象存储压力与资源成本。节点增加只有转化为更高吞吐或更短作业耗时,才算带来收益。
| 观察到的现象 | 优先处理方式 |
|---|---|
| 任务持续等待,节点没有增加 | 检查自动扩缩容状态、节点上限、配额、节点规格是否满足单个任务需求,以及节点创建失败原因。 |
| 节点仍有空闲,任务并行度很低 | 检查输入数据块数量和 concurrency;仅增大 batch_size 不会增加并行任务数。 |
| 新节点已就绪,但扩容节奏仍跟不上持续积压 | 确认限制来自冷却或提交上限后,再逐项调整对应参数,并比较吞吐与成本。 |
| 节点增加,吞吐提升不明显,spill 或内存压力上升 | 检查数据块与批次大小、下游处理和写出速度,优先消除数据积压,放缓扩容。 |
| 大部分时间耗在节点启动,作业很快结束 | 评估适当提高最小容量或调整批次规模;短作业未必能从动态扩容中获益。 |
日常使用可以从"开启 CPU 任务的自适应弹性、保留默认保护、观察吞吐与成本"开始。固定规模集群、Actor Pool 的扩缩容,以及读取或写入已经成为瓶颈的管道,应优先调整各自的资源与并发策略。
5. 优势与收益
这套机制本身不产生计算能力,它改变的是积压的可见性:让等待处理的记录从"卡在 Ray Data 内部"变成"排在调度队列里",扩缩容才有机会把集群的扩容空间用起来。收益顺着这条链路产生。
扩容真正被触发,吞吐和耗时受益。 开启前,预算内的任务跑完,剩余任务在算子内部排队,调度器看不到 pending 需求,扩缩容无从响应;开启后超额任务进入 Ray Core 调度,需求持续可见,自动扩缩容据此追加节点。对文本清洗、图片预处理、特征计算这类可独立并行的作业,直接表现为吞吐更高、作业整体耗时更短------第 1 节的判断清单,判断的正是"你的作业能不能拿到这份收益"。
不改业务代码,也不写扩容脚本。 开启方式就是三行 DataContext 配置,UDF、数据流、提交命令保持不变;扩容决策仍由集群侧完成,作业里不需要出现任何扩容逻辑,也不需要预估并发数。
扩张有刹车,风险边界清楚。 默认关闭;开启后仍受资源占用门槛、扩容步长、冷却时间约束,对象存储背压与算子并发上限原样保留。稳妥的路径是先只对 CPU 任务开启、保留默认参数跑一轮,确认收益后再评估 GPU。
成本可算、可回退。 步长与冷却把扩容约束成渐进节奏,配合第 4 节的观察指标,吞吐、耗时与资源成本可以放在一起对比;如果收益不明显,把参数调回默认值即可回到原有行为。