阿里云百炼的 CLI(bl)在微调链路上有两个前置检查,一个管数据集,一个管基座模型。两条命令都不要鉴权,都能在建任务之前跑完,但返回语义都比表面上复杂:bl dataset validate 默认是抽样校验,覆盖率随文件规模非单调变化;bl finetune capability 有三种返回形态,其中一种命令成功、退出码正常、supported 是空数组。
这篇拆这两条命令的判定边界:抽样窗实际看了哪些行、六种 schema 各自的必填字段与错误码、三种返回态的判定写法,以及上传路径与校验强度为什么互斥。
取数条件:2026-10-12,bl 2.1.0,macOS。会随时间变的读数都带日期戳。
环境:Node.js 18+,npm install -g bailian-cli。本文两条主命令都是 No Auth,只有真建训练任务那一步要 Key(CLI 安装页、API Key 签发页)
一、两条命令的职责边界
| 命令 | 回答的问题 | 鉴权 | 判定落点 |
|---|---|---|---|
bl dataset validate --file <path> |
文件能不能逐行解析、形状对不对 | 不需要 | 退出码 + stats + errors[].path |
bl finetune capability --training-type <t> |
这种训练方式支持哪些基座 | 不需要 | 返回的模型名单 |
bl finetune capability --base-model <m> |
这个基座能用什么方式训 | 不需要 | supported 是否非空 |
bl finetune text create --datasets <file-id 或本地路径> |
建训练任务 | 需要 | pending_uploads 与 training_type |
capability 的 --base-model 和 --training-type 二选一,帮助文本写明必填其一。第三行的判定落点不是命令是否成功,是 supported 非空,第六节展开。
二、抽样窗:覆盖率与行数不是单调关系
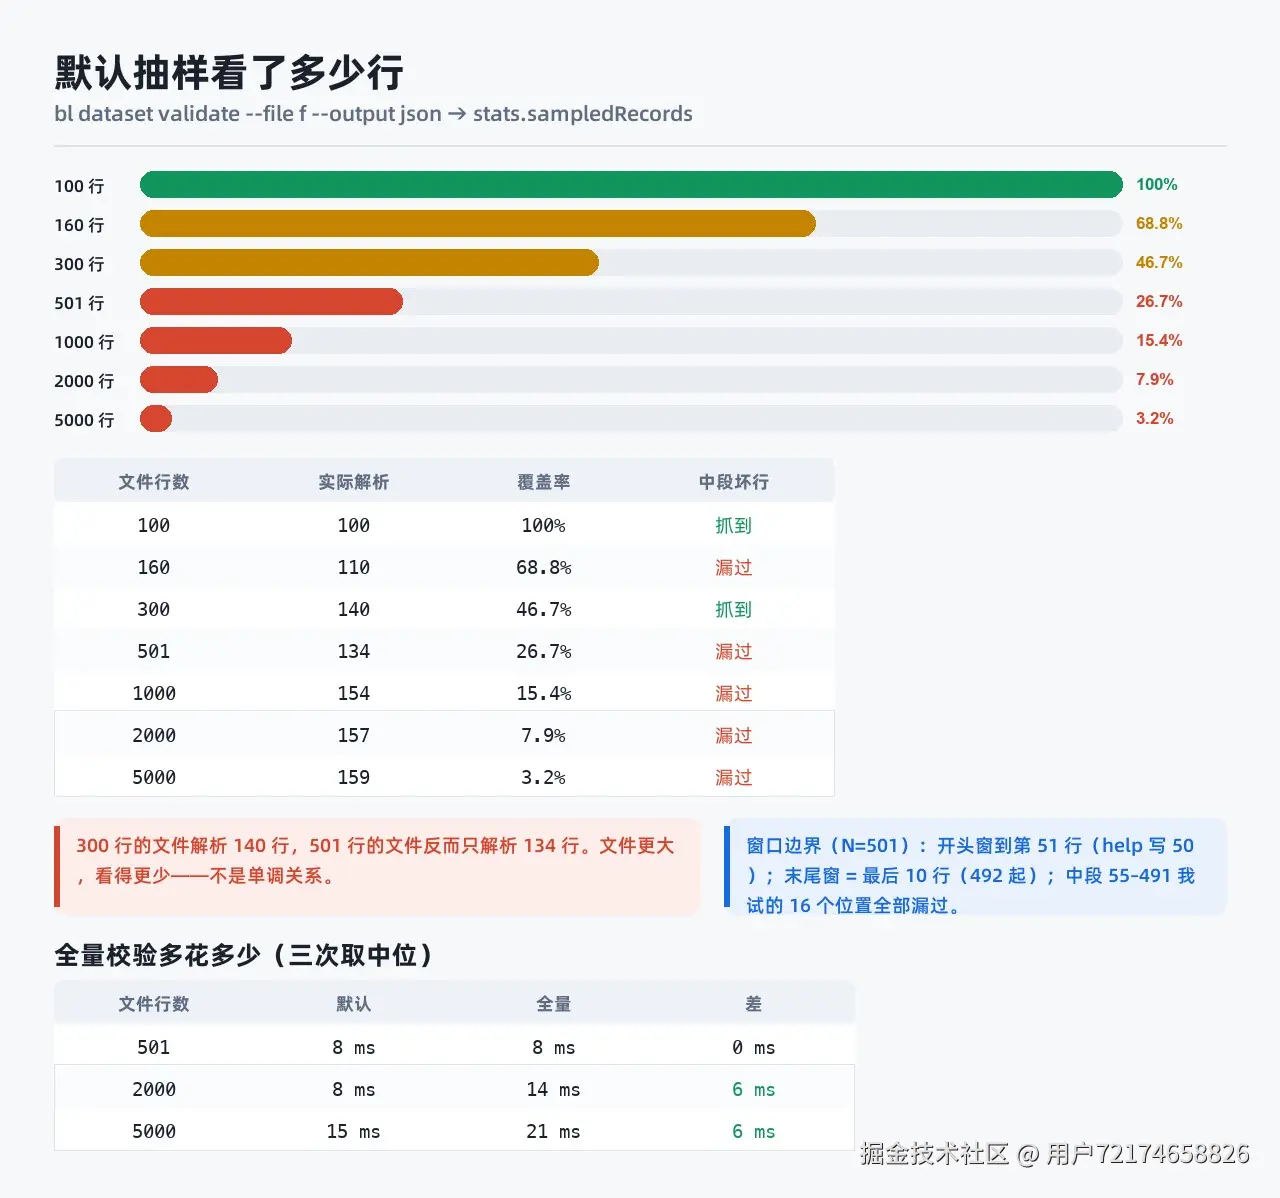
帮助文本对默认模式的描述是:每行做结构检查,然后抽大约 160 行(开头 50 行、中间等距 100 行、末尾 10 行)做 schema 检查。
我造了一批只有行数不同的干净文件,每个在中段埋一行 schema 坏行(JSON 合法、缺 messages),实测解析行数:
| 文件行数 | 实际解析行数 | 覆盖率 | 中段坏行 |
|---|---|---|---|
| 100 | 100 | 100% | 抓到 |
| 160 | 110 | 68.8% | 漏过 |
| 300 | 140 | 46.7% | 抓到 |
| 501 | 134 | 26.7% | 漏过 |
| 1000 | 154 | 15.4% | 漏过 |
| 2000 | 157 | 7.9% | 漏过 |
| 5000 | 159 | 3.2% | 漏过 |
解析行数在 110 到 159 之间波动,不随文件增大而增大:300 行解析 140 行,501 行反而只解析 134 行。所以"文件不大、默认校验够用"这个推断不成立,覆盖率与行数不是单调关系。
把坏行逐位置埋一遍,501 行文件的命中情况:
| 区间 | 实测位置 | 结果 |
|---|---|---|
| 开头窗 | 1、25、50、51 | 全部抓到 |
| 中段 | 55、60、100、134、150、200、250、251、253、300、350、400、450、480、490、491 | 全部漏过 |
说准确一点:默认模式漏的是 schema 坏行(字段缺失这类);结构坏行(JSON 本身非法)任何位置都抓得到,因为结构检查是逐行的。 | 末尾窗 | 492、495、500、501 | 全部抓到 |
两个边界与帮助文本的口径有差:开头窗实际覆盖到第 51 行(文本写 50),末尾窗是最后 10 行(N=501 时从 492 起,501−10+1=492)。中间那 440 行里,我试的 16 个位置无一被解析。
等距抽样在 501 行上确有落点,只是与我试的位置错开;在 300 行上又恰好命中。落点公式我没查明,因此这里只给位置对照,不做外推。工程结论是:无法靠推测行号判断某条坏行是否落在窗内。
三、两层覆盖面:结构逐行、schema 抽样
"每行做结构检查,然后抽约 160 行做 schema 检查"是两套覆盖面,不是一套。同一位置埋两种坏法:
| 坏行形态 | 位置 250(窗外) | 位置 300(窗外) |
|---|---|---|
| JSON 非法(如被截断) | 抓到 | 抓到 |
JSON 合法但缺 messages |
漏过 | 漏过 |
结构检查逐行执行,非法 JSON 在任意位置都会被拦下;schema 检查走抽样,字段级问题只在窗内可见。
这条区分决定了默认校验的适用面。脚本写坏的文件(中途截断、编码错乱、多一个逗号)大概率能拦;字段名写错、少一列、role 拼错这类结构完整但内容不对的问题,窗外一律放行,而后者正是人工整理数据集的主要错法。
准确表述是:默认模式漏 schema 坏,不漏结构坏。
四、--full-validate 的开销
--full-validate 的帮助文本是 JSON.parse every line instead of sampling (slower)。每档跑三次取中位数:
| 文件行数 | 默认耗时 | 全量耗时 | 差值 |
|---|---|---|---|
| 501 | 8 ms | 8 ms | 0 ms |
| 2000 | 8 ms | 14 ms | 6 ms |
| 5000 | 15 ms | 21 ms | 6 ms |
五千行全量比抽样多 6 毫秒,五百行两者一致。在万行以内,那个 (slower) 不构成取舍。
超过万行未测。官方给的文件上限是 SFT/DPO 200MB、CPT 300MB、带媒体 zip 2GB;zip 数据集我只引帮助文本口径,未实测,因此不对大规模下的耗时做外推。
五、六种 schema:字段形状与错误码映射
帮助文本给出六种 schema 的字段形状,逐个照抄构造后的结果:
| schema | 帮助文本写的形状 | 照抄结果 | 补齐方式 |
|---|---|---|---|
| chatml | {messages:[...]} |
通过 | 无需补 |
| cpt | {text:"..."} |
通过 | 无需补 |
| tts | {wav_fn:"train/xxx.wav", text:"..."} |
通过 | 无需补 |
| dpo | {messages:[...], chosen, rejected} |
失败 MESSAGE_NOT_OBJECT |
chosen/rejected 改单个消息对象 |
| image | {img_path:"..."} |
失败 MISSING_PROMPT |
补 prompt |
| video | {first_frame_path:"...", video_path:"..."} |
失败 MISSING_PROMPT |
补 prompt |
三处帮助文本没写清的地方。
image 与 video 都需要 prompt,补上后两者都通过。video 用首帧加尾帧(first_frame_path + last_frame_path + prompt)同样通过,对应首尾帧生视频的形状。
自动探测靠 img_path 认 image。只给 prompt 不给 img_path 时,它回落按 chatml 判,报 MISSING_MESSAGES,错误码指向的字段与真实问题无关。
dpo 的 chosen/rejected 必须是单个消息对象,且 messages 要以 user 结尾。四种写法实测:
chosen/rejected 写法 |
结果 |
|---|---|
字符串 "c" / "r" |
失败 |
消息数组 [{role,content}] |
失败 |
消息对象 {role,content} |
通过 |
messages 末条为 assistant |
失败 DPO_LAST_MSG_NOT_USER |
MESSAGE_NOT_OBJECT 字面指向 messages 数组,实际坏的是 chosen/rejected。定位要靠错误对象里的 path,只看文本输出会漏掉它。
一个反向用法:传 --schema 就是逐行强制按该形状判,不再自动探测。同一文件用六种 schema 各判一遍,错误码互不相同(MISSING_CHOSEN、MISSING_TEXT、MISSING_WAV_FN、MISSING_IMG_PATH、MISSING_FIELD),可以用来确认文件被识别成了哪种 schema。
bash
bl dataset validate --file my.jsonl --output json
bl dataset validate --file my.jsonl --schema dpo --full-validate
六、capability 的三种返回态
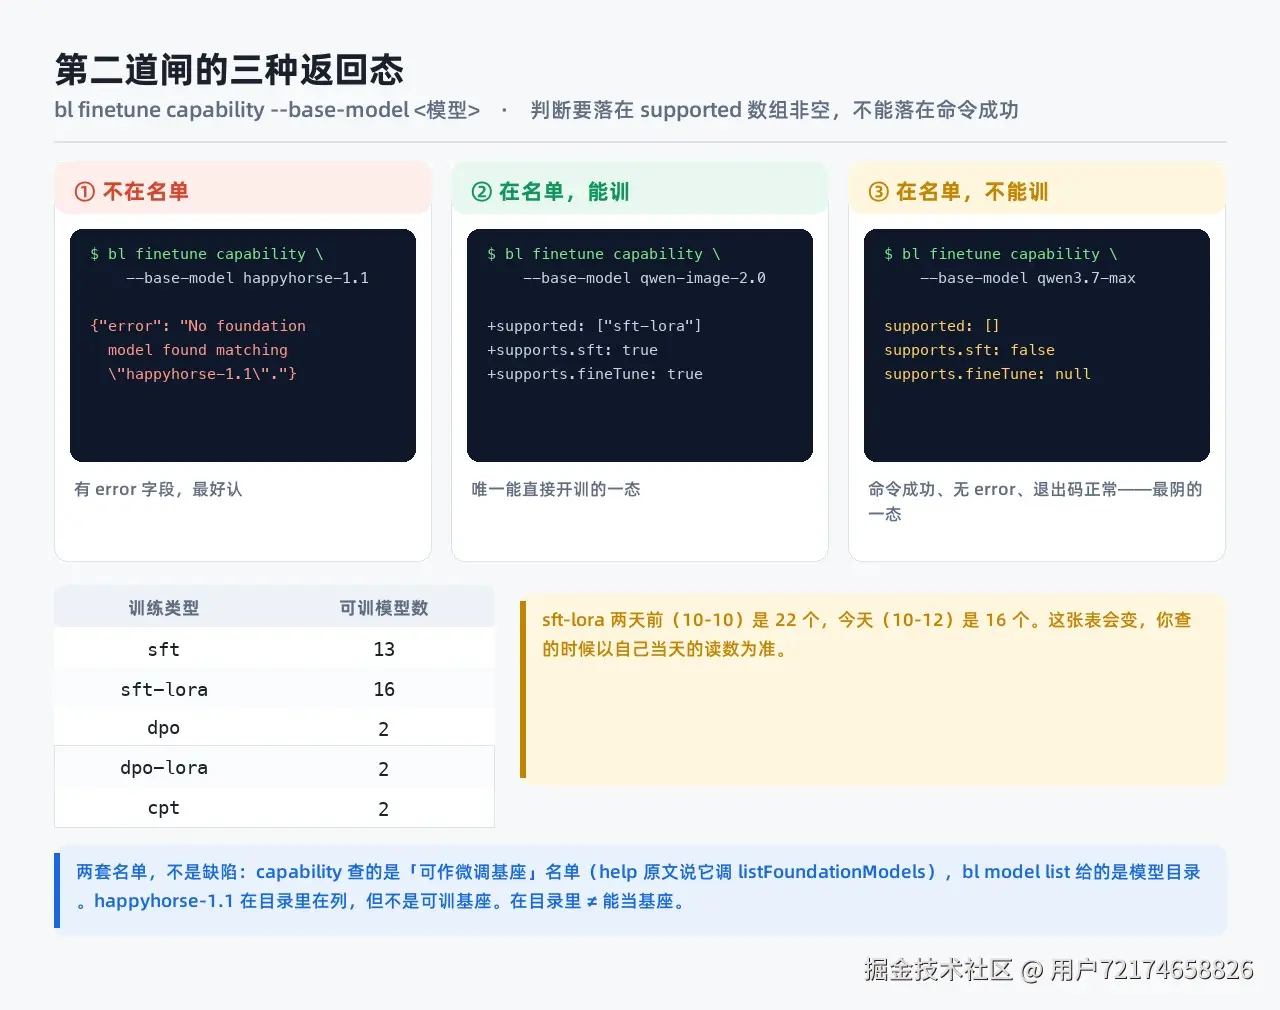
bl finetune capability --training-type 当天(2026-10-12)读数:
| 训练类型 | 支持的模型数 |
|---|---|
| sft | 13 |
| sft-lora | 16 |
| dpo | 2 |
| dpo-lora | 2 |
| cpt | 2 |
sft-lora 那 16 个覆盖三种模态:图像是 qwen-image-2.0、qwen-image-2.0-pro;视频是 wan2.2-i2v-flash、wan2.2-kf2v-flash、wan2.5-i2v-preview、wan2.7-i2v;文本侧是 qwen3-4b-instruct-2507、qwen3.5-27b、qwen3.6-27b、qwen3.8-27b 与三个 qwen3-vl 规格。
这份名单会变。2026-10-10 同一档读数是 22,2026-10-12 是 16,两天少 6 个。变化原因我没查明,那两天正好有一批模型下线落地,但没有证据支撑因果,不做推断。判定逻辑必须以当天读数为准。
--base-model 有三种返回形态,帮助文本未区分:
| 返回态 | 命令参数 | 返回 | 正确解读 |
|---|---|---|---|
| 不在名单 | --base-model happyhorse-1.1 |
{"error": "No foundation model found matching \"happyhorse-1.1\"."} |
不是可训基座 |
| 在名单且可训 | --base-model qwen-image-2.0 |
supported: ["sft-lora"]、supports.sft: true |
可按该方式训 |
| 在名单但不可训 | --base-model qwen3.7-max |
supported: []、supports.sft: false、supports.fineTune: null |
在名单里但不能训 |
第三种是判定陷阱:命令正常返回、无 error 字段、退出码正常,只有 supported 是空数组。任何按"命令是否报错"分支的脚本都会把它读成可训。判定必须写在 supported 非空上。
还有一条:帮助文本 Examples 里的 bl finetune capability --base-model qwen3-8b 跑不通,返回 No foundation model found matching "qwen3-8b"。交叉核验过:bl model search --keyword qwen3-8b 返回 total 0,bl model list --page-size 50 翻三页得到的 125 个模型家族里也没有它,目录中的 qwen3 系列是 3.5/3.6/3.7/3.8 几条线。
七、两套名单的口径差
bl finetune capability 查的是平台"可作微调基座"名单,帮助文本原文说它调 listFoundationModels 这个公开接口;bl model list 给的是模型目录。这是两套名单,不是一份名单的两个视图。
happyhorse-1.1 是典型例子:它在模型目录里在列,按 happyhorse 搜能出来 7 个模型,家族列表里 happyhorse-1.0 与 happyhorse-1.1 都在,而 capability 报找不到。原因是它不是可训基座,不是命令出错。
工程含义有两条。判断"这个模型能不能训"只能问 capability,问目录得不到答案;反过来,capability 报 not found 也推不出"这个模型不存在"。
八、上传路径与校验强度互斥
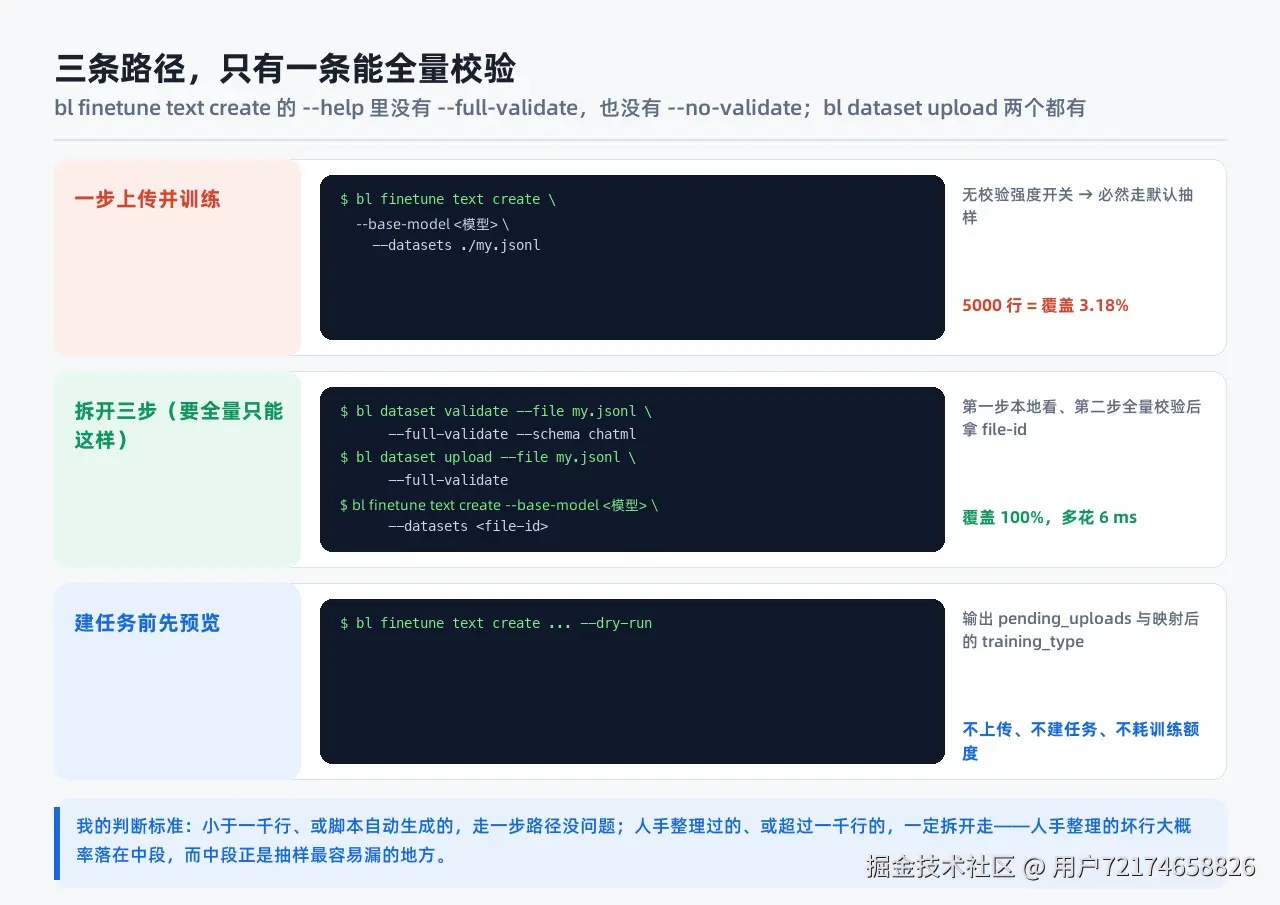
bl finetune text create --datasets 接受本地路径,帮助文本写明本地路径会先被校验并上传,再用返回的 file-id 建任务。一步到位,但这条命令没有任何校验强度开关:bl finetune text create --help 里没有 --full-validate,也没有 --no-validate。而 bl dataset upload 两个开关都有,--no-validate 后面标着 "(not recommended)"。
结论是走一步路径必然使用默认抽样校验,五千行文件上就是 3.18% 覆盖率。要全量只能拆三步:
bash
bl dataset validate --file my.jsonl --full-validate --schema chatml
bl dataset upload --file my.jsonl --full-validate
bl finetune text create --base-model <模型> --datasets <上一步返回的 file-id>
选择标准可以写成一条规则:小于一千行、或脚本自动生成的数据集,一步路径可用;人手整理过的、或超过一千行的,拆三步。人手整理的数据集坏行落在中段是大概率事件,中段恰是抽样最容易漏 schema 坏行的区间。
bl finetune text create 支持 --dry-run,输出含 pending_uploads(将被上传的本地文件)与映射后的 training_type(sft-lora 在接口边界映射为服务端的 efficient_sft),不上传、不建任务、不耗训练额度。建任务前跑一次,成本远低于事后收拾。
九、失败输出的解析
校验失败时标准输出含两个 JSON 对象:前一个是完整报告(errors、stats),后一个是 {"error":{"code":1,"message":"Dataset validation failed: 1 error(s)."}}。直接 json.load 整段输出会抛 Extra data,脚本侧用 json.JSONDecoder().raw_decode() 取第一个对象。
错误对象结构:
json
{
  "severity": "error",
  "code": "MISSING_MESSAGES",
  "message": "Required field \"messages\" is missing or not an array.",
  "line": 30,
  "path": "messages"
}
line 定位行,path 定位字段。第五节 MESSAGE_NOT_OBJECT 那个误导靠 path 一步破掉,它指的是 chosen。--output json 是这套流程里性价比最高的一个开关。
退出码:不通过 exit 1,通过 exit 0,这一条与返回体一致。同一个 CLI 里 bl model list --model 有过对目录内在列家族回答 not found 且退出码 0 的情况,所以退出码是否可信要逐命令确认,不能整体假设。
十、前置检查清单
| 步骤 | 命令 | 判定 |
|---|---|---|
| 全量校验 | bl dataset validate --file <path> --full-validate --schema <s> |
exit 0 |
| 确认识别形态 | bl dataset validate --file <path> --schema <s> --output json |
错误码与预期 schema 一致 |
| 基座可训 | bl finetune capability --base-model <m> |
supported 非空 |
| 建任务前预览 | bl finetune text create --base-model <m> --datasets <file-id> --dry-run |
核对 pending_uploads 与 training_type |
四步里前三步用的 dataset validate 与 finetune capability 都不要鉴权,装完 CLI 就能跑,适合放在建任务之前当固定动作。
数据集这道闸只是链路开头。训练怎么起、checkpoint 怎么挑、导出之后怎么部署是另外几件事,这篇不展开。
你那边判 CLI 结果的脚本是看退出码还是看返回体字段?supported 空数组这类"命令成功但结果不可用"的返回态,在别的命令上还出现过哪些,评论区想收对照样本。