> ✍✍计算机编程指导师
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡如果你遇到具体的技术问题或计算机毕设方面需求可以在主页上详细资料里与博主交流~~
⚡⚡获取源码主页--> 计算机编程指导师
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方免费提供的博客联系方式的名片!
温馨提示:文末有CSDN平台官方免费提供的博客联系方式的名片!
温馨提示:文末有CSDN平台官方免费提供的博客联系方式的名片!
台北市住宅价格数据可视化分析系统-系统简介
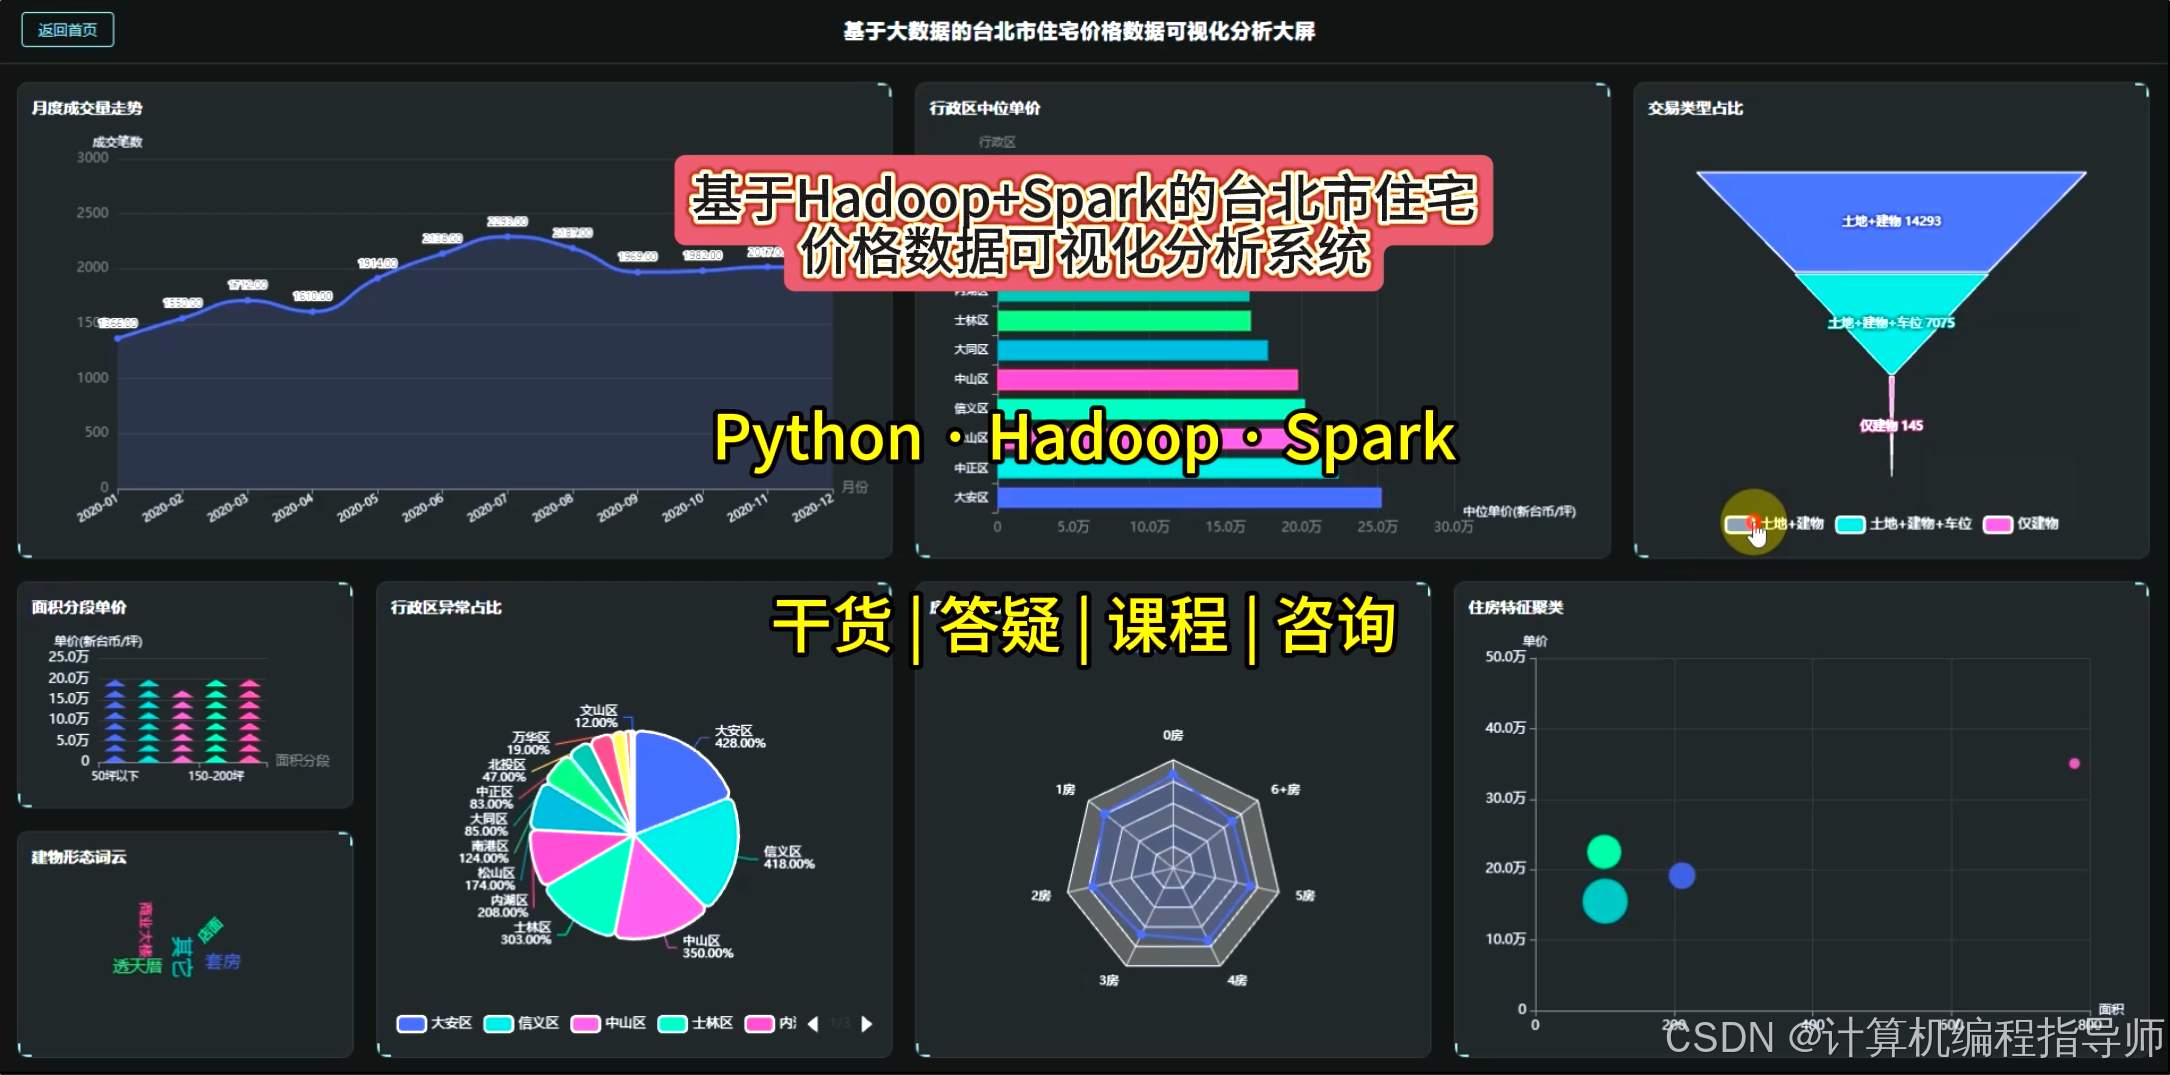
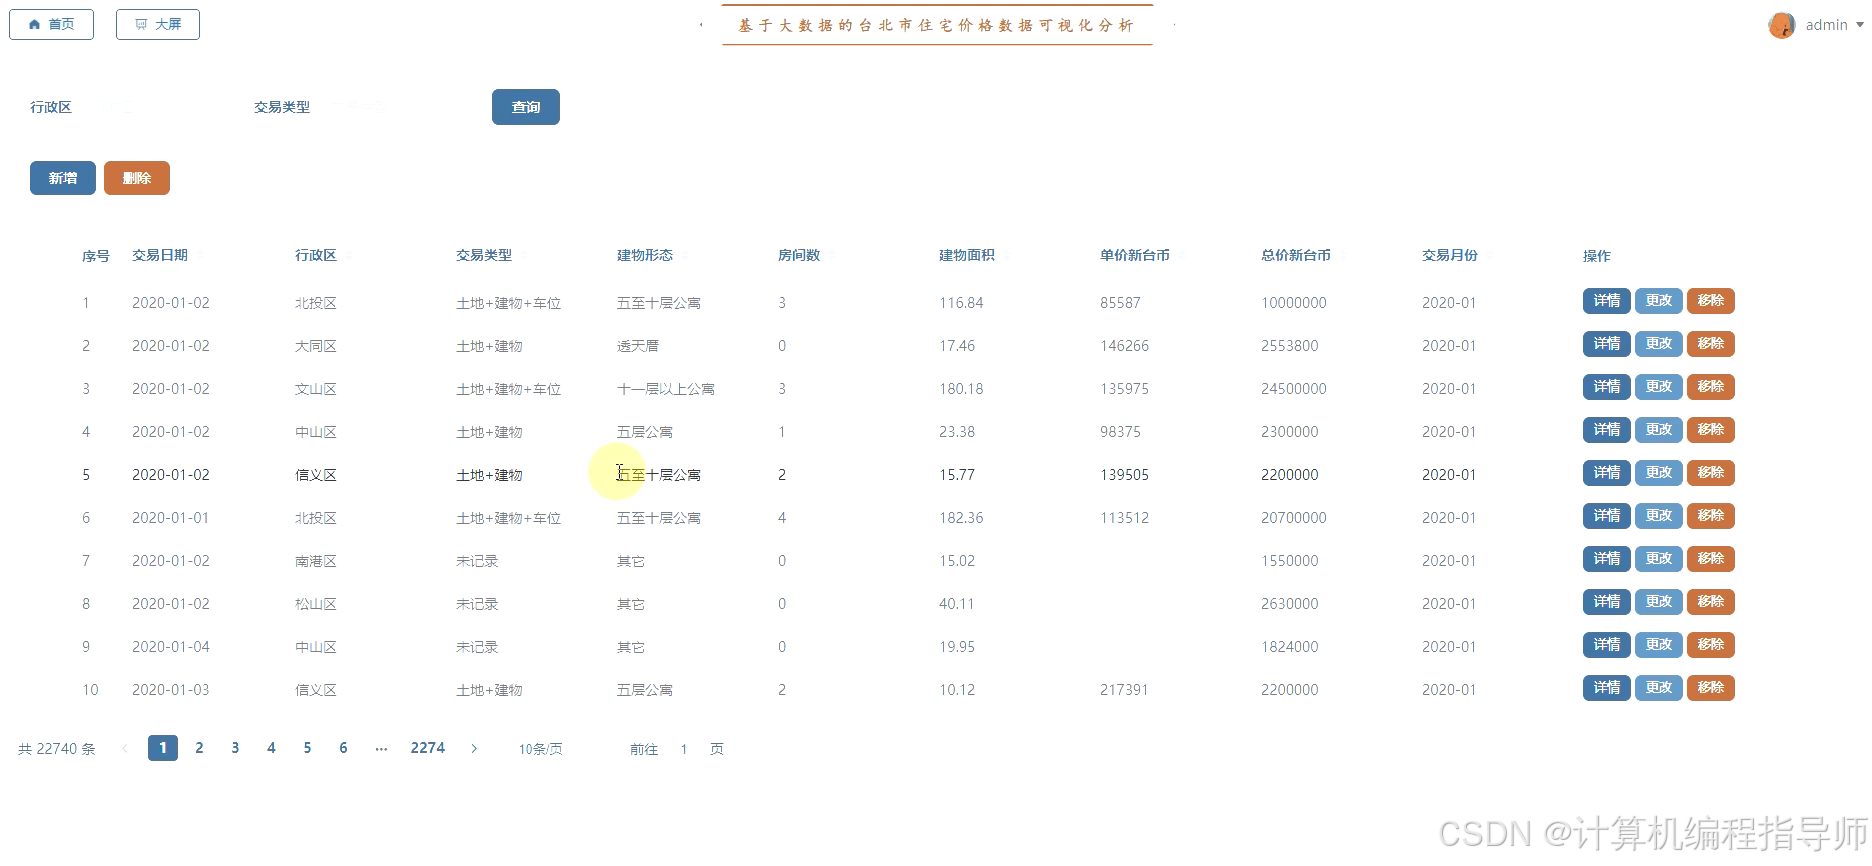
基于Hadoop+Spark的台北市住宅价格数据可视化分析系统是一套完整的大数据可视化分析平台,专注于台北市住宅实价登记数据的深度分析与可视化呈现。系统整体采用Python技术栈开发,后端基于Django框架构建RESTful接口服务,前端使用Vue框架搭配ElementUI组件库进行页面布局,数据可视化部分通过Echarts库实现多种图表渲染,同时结合HTML、CSS、JavaScript和jQuery完成基础页面交互。在大数据存储与计算层面,系统使用Hadoop的HDFS作为分布式文件存储底座,将原始台北市住宅交易数据文件统一管理;计算引擎采用Spark和Spark SQL,对大规模交易记录进行数据清洗、字段提取、分组聚合与统计分析。数据预处理环节借助Pandas和NumPy完成缺失值过滤、特征派生与数值标准化操作,例如从完工年份派生屋龄分箱、从交易日期派生月度维度等。系统共设计16个分析模块,基础分析模块涵盖行政区均价对比、月度成交量与均单价走势、建物型态与交易类型占比、房龄段与面积段均价、房间数均价、电梯溢价差、建材均价排名、行政区成交排名、楼层段均价以及车位配比价等维度;高级分析模块引入K-Means算法对住宅特征进行聚类分析以发现典型产品簇,使用Isolation Forest算法识别价格异常交易点,并通过FP-Growth算法挖掘住宅配置特征的频繁共现规则。所有分析结果均输出为结构化CSV文件并同步至MySQL数据库,前端通过Echarts以柱状图、折线图、饼图、环形图、雷达图等多种可视化形式展示,帮助用户全面把握台北市住宅市场的价格分布特征与交易规律。
台北市住宅价格数据可视化分析系统-核心亮点
亮点一:Hadoop+Spark大数据架构支撑
系统底层采用Hadoop HDFS分布式文件系统进行数据存储,计算层使用Spark内存计算框架与Spark SQL引擎,相比传统单机方案在数据处理效率上有明显提升。整个数据链路从原始文件加载、清洗过滤到聚合统计均在Spark框架内完成,体现了大数据技术在实际数据分析场景中的应用方式。
亮点二:多维度数据分析体系
系统设计了16个分析模块,覆盖行政区均价、月度成交量、建物型态占比、房龄段均价、面积段均价、电梯溢价、建材排名、楼层段均价、车位配比等11个基础统计维度,分析角度较为全面,能够从不同切片观察台北市住宅市场的交易特征。
亮点三:三种机器学习算法融合
系统在基础统计之外引入了K-Means聚类算法对住宅特征进行客群分簇、Isolation Forest算法识别价格异常交易点、FP-Growth算法挖掘住宅配置的频繁共现规则,将数据分析从描述性统计延伸到模式发现层面。
亮点四:精细化缺失数据处理策略
每个分析模块针对自身涉及的字段采用独立的缺失数据过滤策略,不进行全局删除或硬编码众数填充,尽量保留原始数据口径的真实性,例如对完工年份缺失的记录不伪造屋龄,对交易类型缺失的记录不填众数。
亮点五:多图表可视化呈现
前端使用Echarts图表库,根据不同分析模块的数据特征匹配对应的图表类型,包括横向柱状图、排名条形图、折线图、双轴面积图、饼图、环形图、分组柱状图、雷达图等,分析结果以直观的图形方式展示。
台北市住宅价格数据可视化分析系统-核心功能
功能一:行政区均价与成交分析
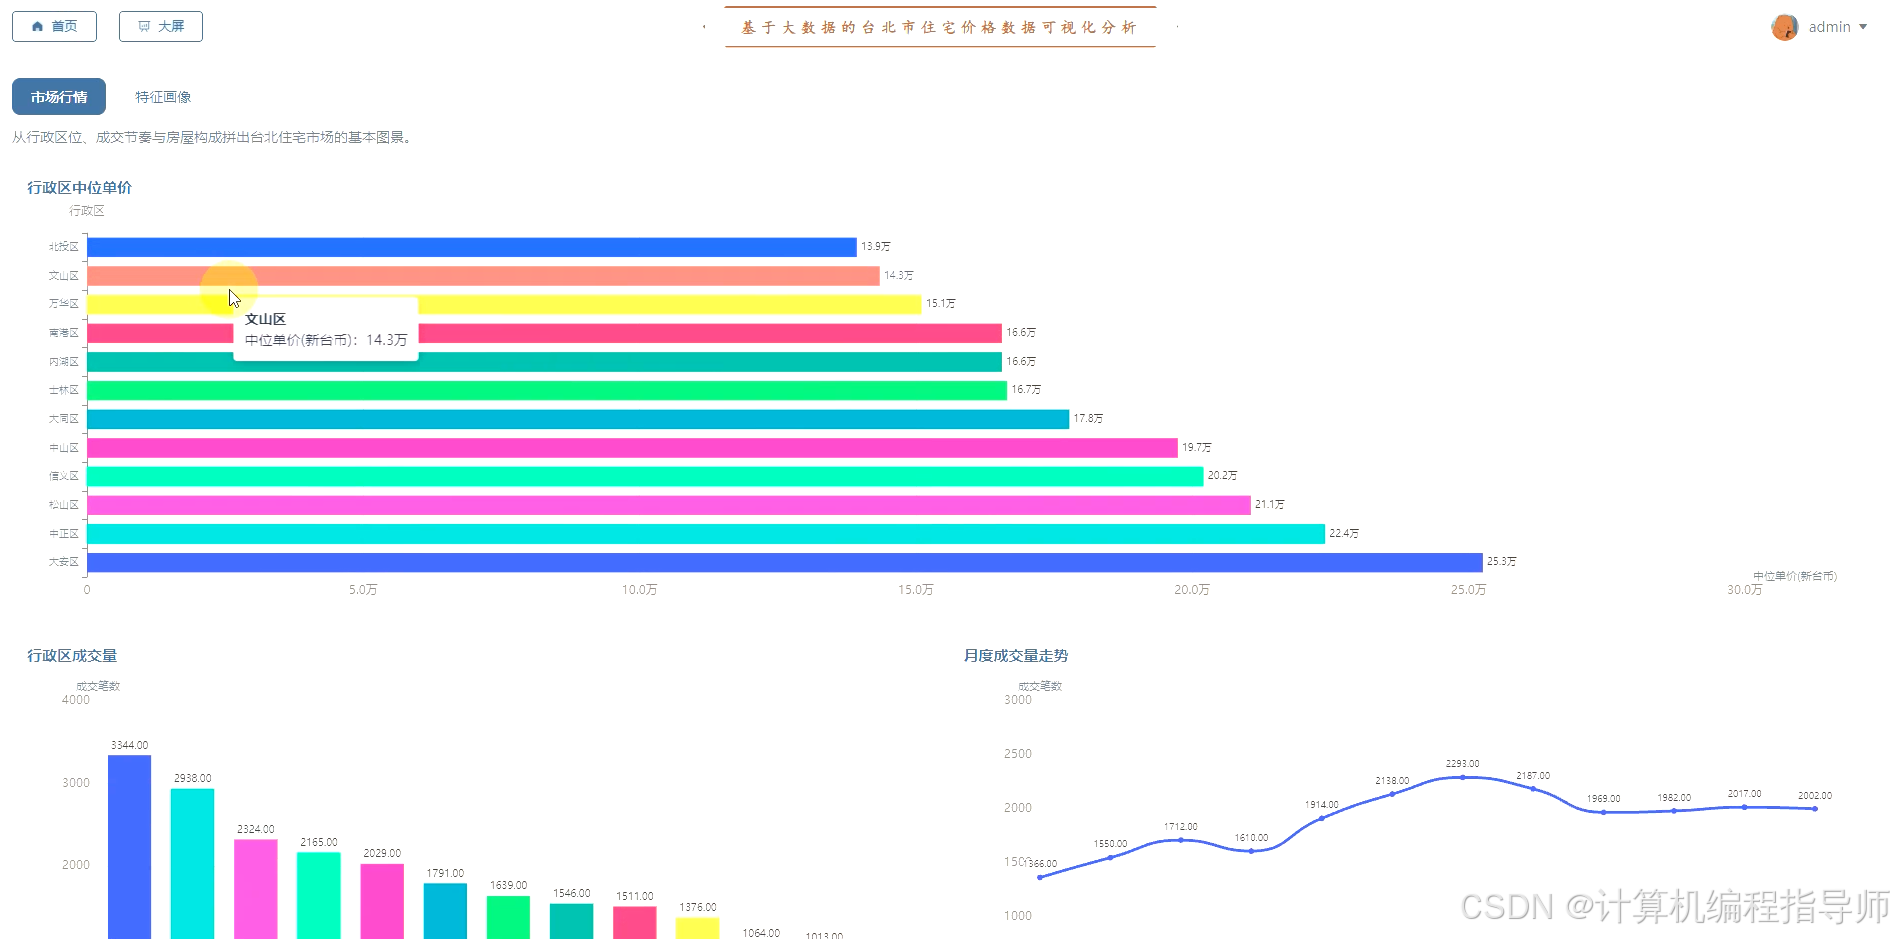
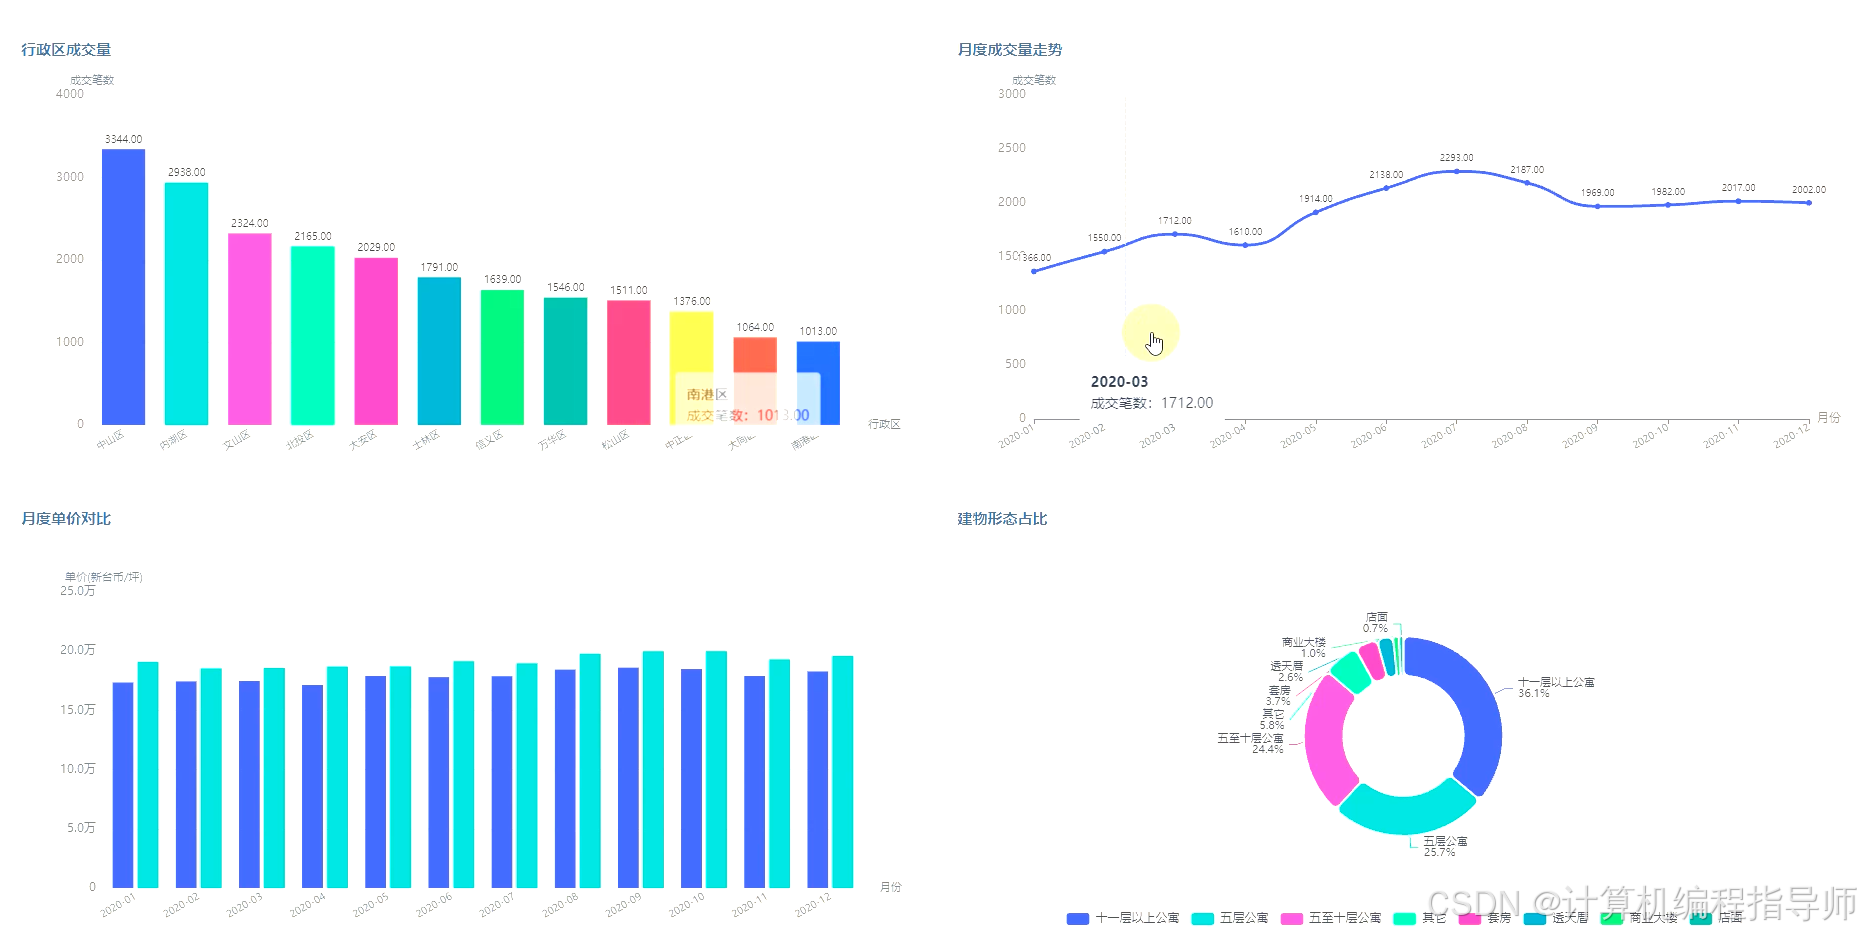
系统按台北市12个行政区分别聚合计算成交笔数、单位价中位数与均价,生成行政区均价对比与成交排名,帮助用户识别高房价区域与市场活跃度较高的行政区,以横向柱状图和排名条形图展示。
功能二:月度价量趋势分析
系统按月度维度统计成交笔数与单位均价走势,将成交量与均价放在同一时间轴上对照展示,观察台北市住宅市场的淡旺季特征与价量关系,以折线图和双轴面积图呈现。
功能三:住宅属性维度均价分析
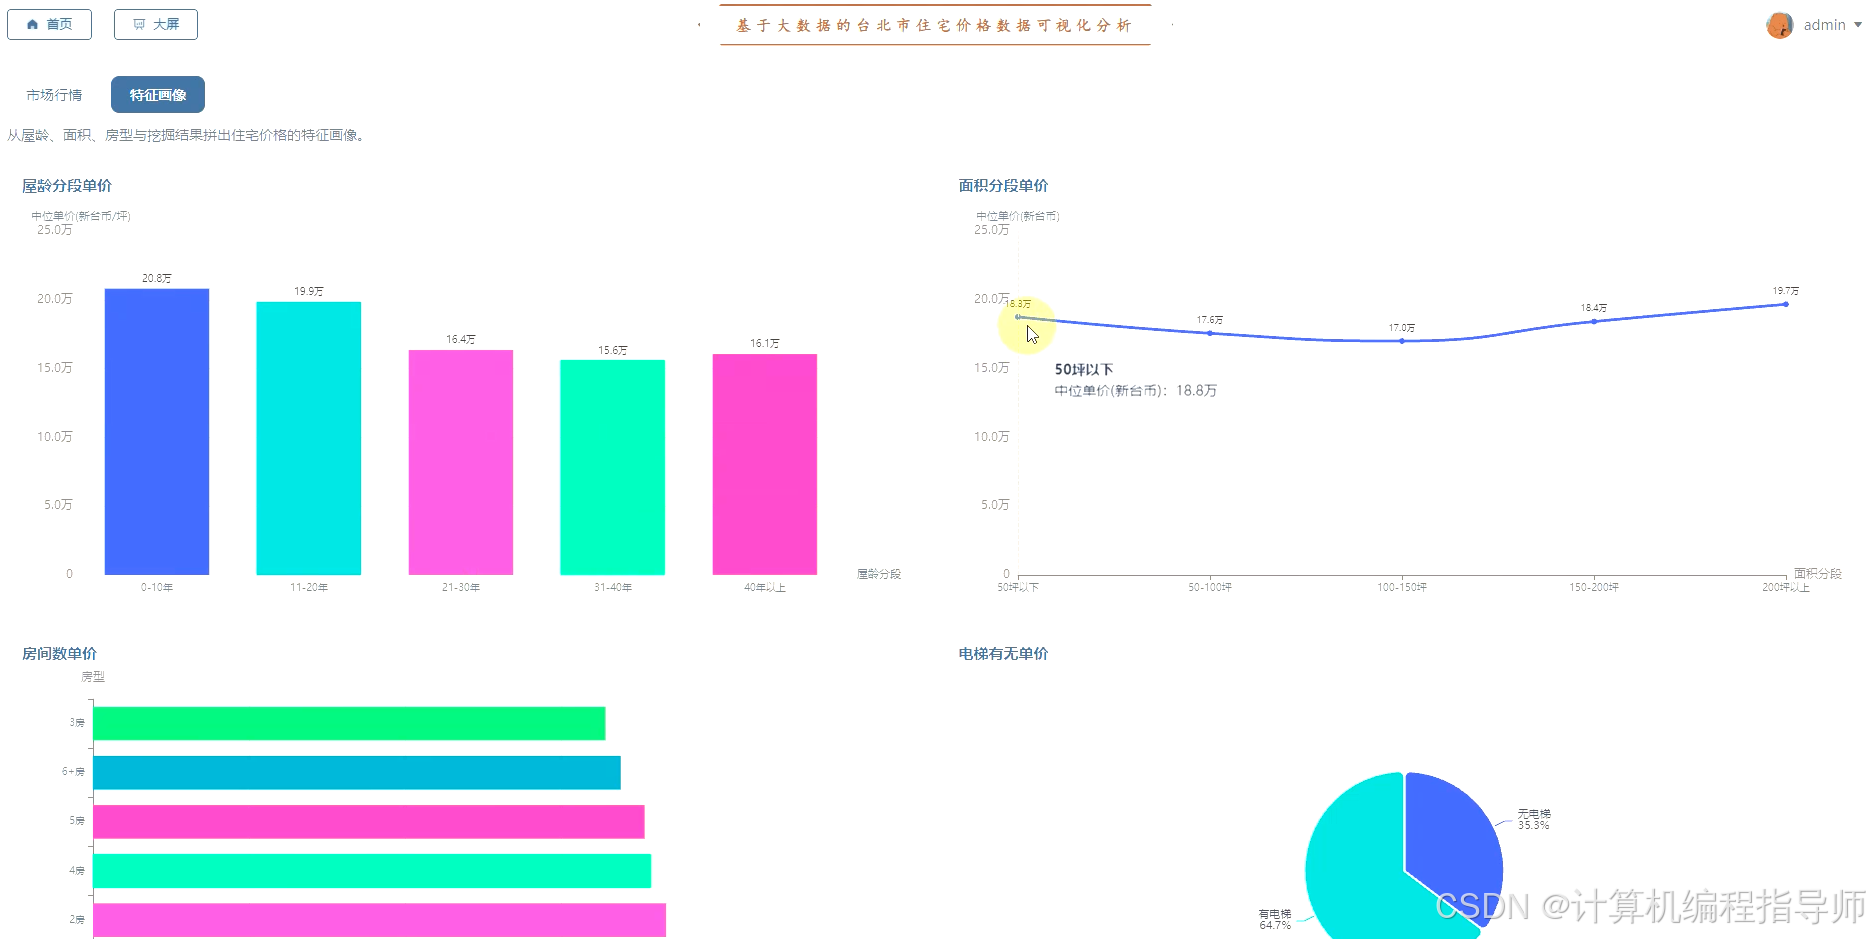
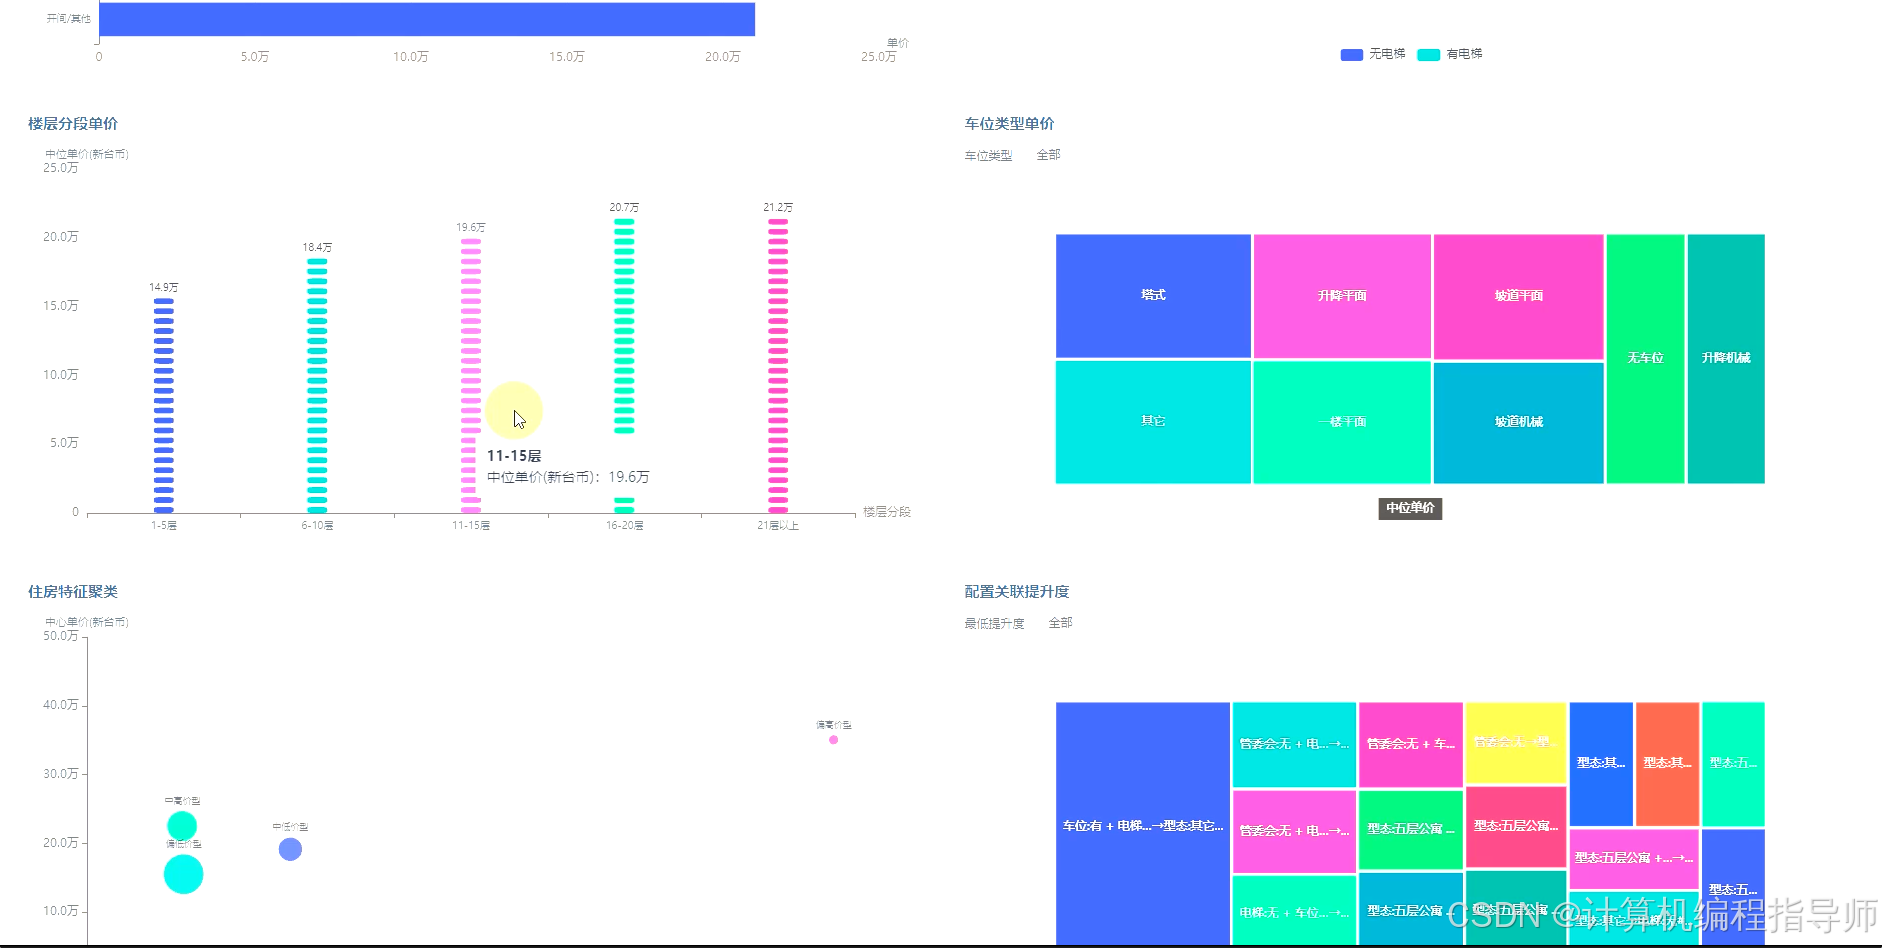
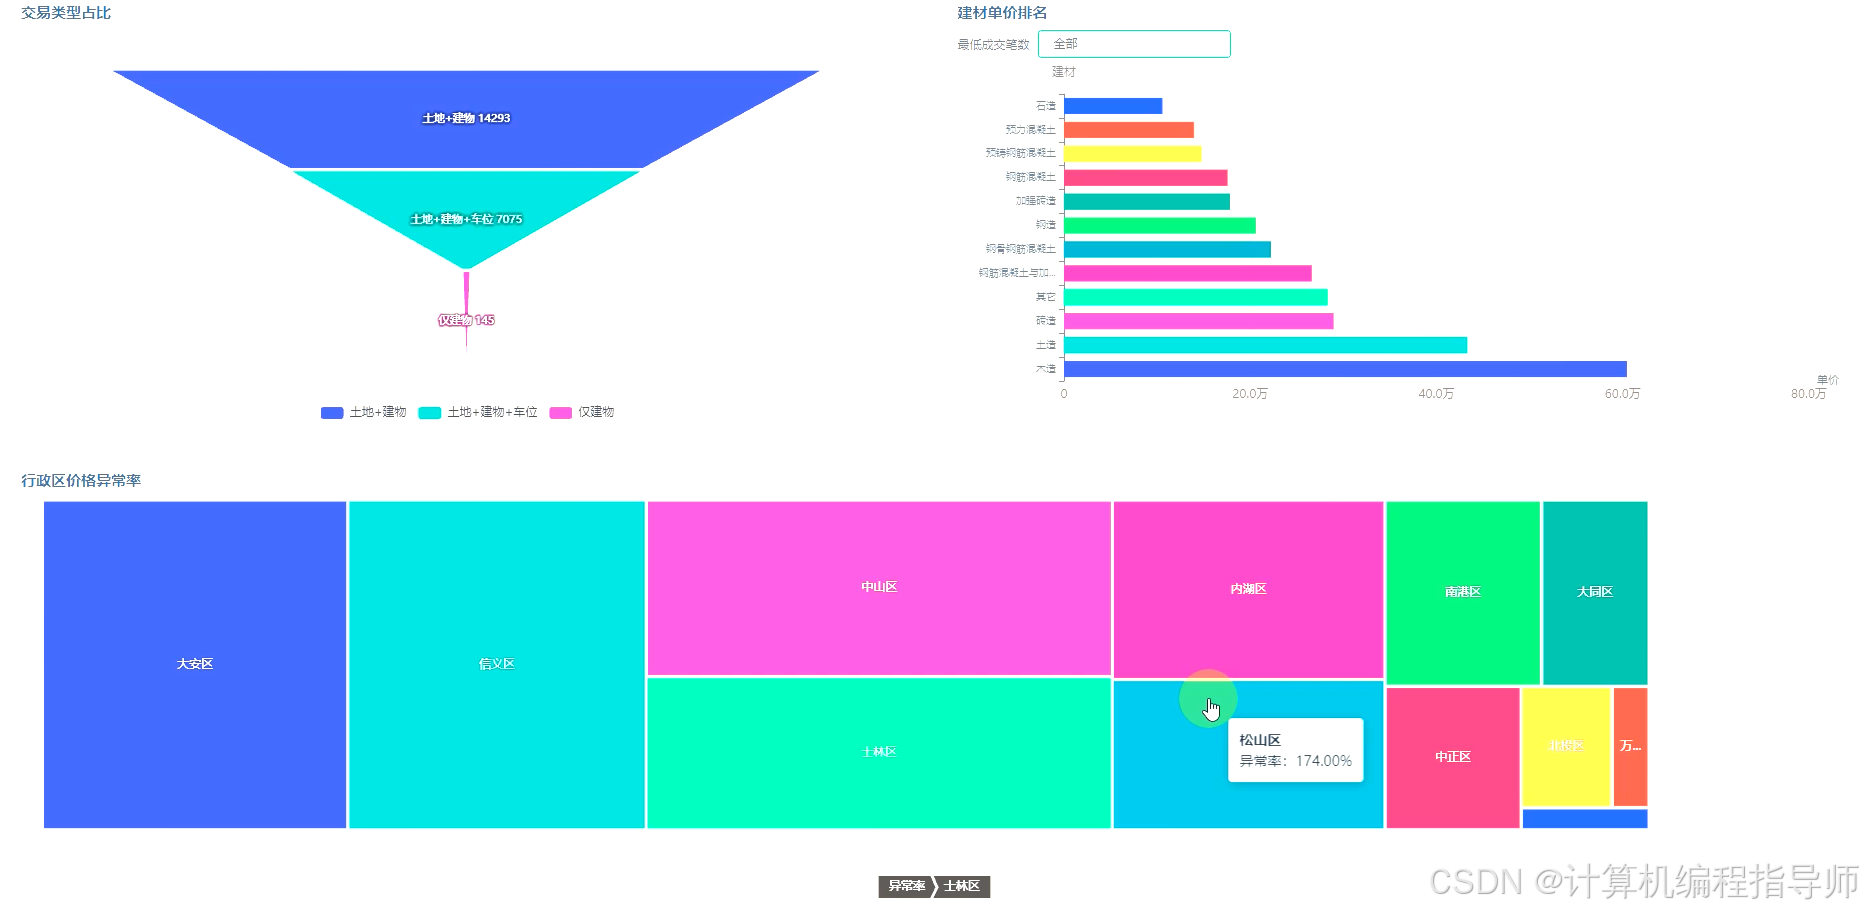
系统围绕建物型态、房龄段、面积段、房间数、电梯有无、主要建材、总楼层段、车位配置等属性维度分别聚合单位均价,对比不同属性条件下的价格差异,例如电梯溢价差、新房与旧房均价对比等。
功能四:K-Means住宅特征聚类
系统选取单位均价、建筑面积、房间数、总楼层、屋龄等数值特征进行标准化处理后使用K-Means算法聚类,通过肘部法则或轮廓系数选择最优簇数,输出各簇规模与特征中心,发现典型住宅产品客群,以雷达图和分组柱状图展示簇中心对比。
功能五:Isolation Forest异常交易识别
系统利用Isolation Forest算法以约1%至3%的污染率对价格、面积等多维特征空间进行异常检测,识别极端高价或低价交易点,按行政区汇总异常交易数量与占比,辅助发现潜在异常成交记录。
功能六:FP-Growth配置共现规则挖掘
系统将每笔交易的行政区、建物型态、电梯、管委会、车位等离散属性转为项集,使用FP-Growth算法挖掘频繁共现的住宅配置组合与关联规则,输出前件、后件、支持度、置信度和提升度指标,发现市场上常见的住宅产品配置模式。
台北市住宅价格数据可视化分析系统-技术
开发语言:Python或Java
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
台北市住宅价格数据可视化分析系统-视频展示
基于Hadoop+Spark的台北市住宅价格数据可视化分析
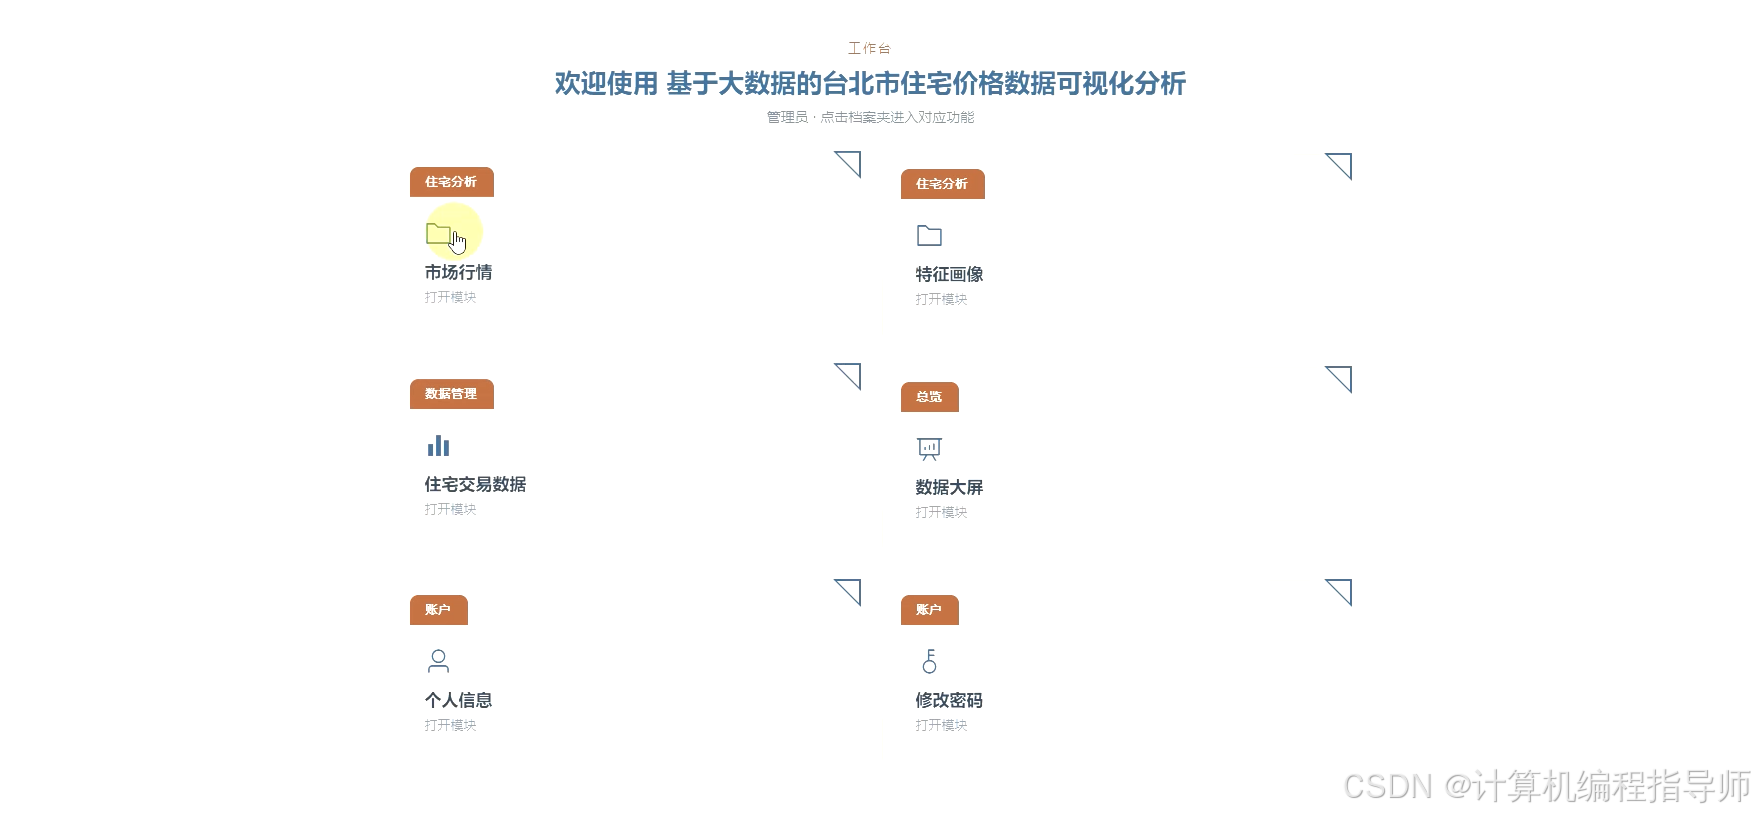
台北市住宅价格数据可视化分析系统-图片展示
台北市住宅价格数据可视化分析系统-结语
做计算机毕设遇到卡壳太正常了,谁还没被报错和需求文档折磨过呢😂。这篇文章我把系统的整体思路和关键实现都梳理清楚了,希望能帮你理清头绪、少走弯路。
如果这期分享对你准备计算机毕设有帮助,别忘了顺手点赞、收藏、关注支持一下,你的支持就是我持续更新的动力。
也欢迎大家在评论区多交流技术和选题想法,你踩过的坑、卡住的地方,都可以拿出来说说,互相参考,争取计算机毕设顺顺利利通过、答辩稳稳过关!🎓