文章目录
-
- 前言
- 一、理解哈希表的基本原理
-
- [1.1 从关键字计算存储位置](#1.1 从关键字计算存储位置)
- [1.2 直接定址:关键字范围较小时的简单方案](#1.2 直接定址:关键字范围较小时的简单方案)
- [1.3 哈希冲突为何需要单独处理](#1.3 哈希冲突为何需要单独处理)
- [1.4 负载因子与空间、效率的关系](#1.4 负载因子与空间、效率的关系)
- 二、哈希函数的构造方法
-
- [2.1 除留余数法与容量选择](#2.1 除留余数法与容量选择)
- [2.2 乘法散列法:利用乘积的小数部分](#2.2 乘法散列法:利用乘积的小数部分)
- [2.3 全域散列:从一组函数中随机选择](#2.3 全域散列:从一组函数中随机选择)
- [2.4 非整数关键字与哈希仿函数](#2.4 非整数关键字与哈希仿函数)
-
- [字符串的 BKDR 思路](#字符串的 BKDR 思路)
- [2.5 其他构造思路](#2.5 其他构造思路)
- 三、哈希冲突的处理方式
-
- [3.1 开放定址法:在数组内继续探测](#3.1 开放定址法:在数组内继续探测)
-
- [3.1.1 线性探测与连续聚集](#3.1.1 线性探测与连续聚集)
- [3.1.2 二次探测与正负平方偏移](#3.1.2 二次探测与正负平方偏移)
- [3.1.3 双重探测与步长互质](#3.1.3 双重探测与步长互质)
- [3.1.4 删除标记为什么不能省略](#3.1.4 删除标记为什么不能省略)
- [3.2 链地址法:把冲突集中到对应桶中](#3.2 链地址法:把冲突集中到对应桶中)
- [四、用 C++ 实现线性探测哈希表](#四、用 C++ 实现线性探测哈希表)
-
- [4.1 接口、槽位与状态设计](#4.1 接口、槽位与状态设计)
- [4.2 查找:按插入时的规则继续探测](#4.2 查找:按插入时的规则继续探测)
- [4.3 扩容与删除标记清理](#4.3 扩容与删除标记清理)
- [4.4 插入:先查重,再判断是否需要重新散列](#4.4 插入:先查重,再判断是否需要重新散列)
- [4.5 查找接口、修改与删除](#4.5 查找接口、修改与删除)
- [五、用 C++ 实现链地址哈希表](#五、用 C++ 实现链地址哈希表)
-
- [5.1 节点与桶数组的定义](#5.1 节点与桶数组的定义)
- [5.2 查找:定位桶后遍历链表](#5.2 查找:定位桶后遍历链表)
- [5.3 扩容:重新连接已有节点](#5.3 扩容:重新连接已有节点)
- [5.4 插入:查重、扩容与头插](#5.4 插入:查重、扩容与头插)
- [5.5 删除:区分桶头与链表内部节点](#5.5 删除:区分桶头与链表内部节点)
- [5.6 析构与对象管理](#5.6 析构与对象管理)
- 六、完整代码与使用验证
-
- [6.1 代码文件的组织](#6.1 代码文件的组织)
- [6.2 插入、查找、修改与删除示例](#6.2 插入、查找、修改与删除示例)
- [6.3 容易遗漏的边界情况](#6.3 容易遗漏的边界情况)
- [6.4 如何理解哈希表的复杂度](#6.4 如何理解哈希表的复杂度)
- 总结
前言
查找一个关键字时,顺序表通常需要逐个比较;平衡搜索树则利用关键字的大小关系,把查找范围不断缩小。哈希表采用了另一条思路:先根据关键字计算存储位置,再到对应位置寻找数据。
不过,"计算下标"只是开始。两个关键字算出相同的下标怎么办?删除一个元素后,会不会影响其他元素的查找?数组扩容后,原来的位置还能不能继续使用?这些问题决定了哈希表能否正确工作,也决定了它的实际效率。
下面先介绍哈希映射与哈希函数,再比较开放定址法和链地址法,最后用 C++17 分别实现线性探测哈希表和链式哈希表。实现采用不允许重复关键字的键值对模型,并提供插入、查找、修改、删除和扩容功能。
一、理解哈希表的基本原理
1.1 从关键字计算存储位置
哈希表也叫散列表,其核心是建立关键字与存储位置之间的映射关系。为了区分两个步骤,可以把定位过程写成:
index = H ( key ) m o d M \text{index}=H(\text{key})\bmod M index=H(key)modM
这里, H H H 把关键字转换为整数哈希值, M M M 是底层数组的容量,取模则把哈希值限制到合法下标范围内。
例如,整数关键字可以直接参与计算;字符串则需要先把字符序列转换成整数。插入和查找必须使用同一套规则,才能从关键字重新找到数据。
需要注意,哈希值和最终下标都不必唯一。计算得到的位置只是查找的起点;发生冲突时,还要继续探测或遍历对应的链表。因此,不能只比较哈希值来判断两个关键字是否相等。
1.2 直接定址:关键字范围较小时的简单方案
如果关键字恰好是 0~99 的整数,可以直接准备长度为 100 的数组,让关键字本身充当下标。对于小写英文字母,也可以使用 ch - 'a' 映射到 0~25。
这种方法称为直接定址法。在映射一一对应的前提下,不同关键字不会争用同一个位置。
例如,寻找字符串中第一个只出现一次的字符,可以先统计各字母出现的次数,再按原字符串顺序寻找答案。以下代码约定输入仅包含小写英文字母:
cpp
#include <array>
#include <string>

std::string::size_type first_unique(const std::string& text) {
    std::array<std::size_t, 26> frequency{};
    for (char ch : text)
        ++frequency[ch - 'a'];

    for (std::size_t i = 0; i < text.size(); ++i)
        if (frequency[text[i] - 'a'] == 1)
            return i;
    return std::string::npos;
}
统计需要一次遍历,确定第一个唯一字符还需要一次遍历,总时间复杂度为 O ( n ) O(n) O(n),额外空间固定为 26 个计数器。
直接定址的限制在于空间由关键字的取值范围决定。假如只有十个关键字,却分散在上百万个可能取值中,为每个可能取值预留一个位置就很浪费。一般哈希表通过压缩映射,让数组规模更多地取决于实际数据量。
1.3 哈希冲突为何需要单独处理
假设使用下面的映射:
h ( k ) = k m o d 11 h(k)=k\bmod 11 h(k)=kmod11
关键字 19 和 30 都对应下标 8。这种"不同关键字映射到同一位置"的现象,就是哈希冲突。
当关键字的可能取值数量大于数组位置数量时,不可能让所有可能关键字都拥有独立的位置。一个哈希函数可以让常见输入分布得更均匀,却不能为任意输入消除冲突。
因此,设计哈希表需要同时考虑两件事:如何计算位置,以及位置发生冲突后如何存储和查找数据。
1.4 负载因子与空间、效率的关系
设当前有 N N N 个有效元素,数组有 M M M 个位置,负载因子定义为:
α = N M \alpha=\frac{N}{M} α=MN
它描述了表中数据相对于数组规模的密集程度。在其他条件相近时,负载因子增大通常会带来更多探测或更长的桶链表;降低负载因子则需要更多空间。
不同存储方式对它的约束不同:
| 存储方式 | 元素放在哪里 | 负载因子的含义 |
|---|---|---|
| 开放定址法 | 全部放在数组槽位中 | 最多为 1,实际通常在达到 1 之前扩容 |
| 链地址法 | 放在数组各位置连接的链表中 | 可以超过 1,均匀分布时也是平均链长 |
本文的线性探测实现把有效元素负载限制在约 0.7 以内,链地址实现采用 1.0 的阈值。这是两套实现各自的策略,并不是算法只能使用这些数值。
以标准 C++ 的 std::unordered_map 为例,默认最大负载因子为 1.0,可以通过 max_load_factor 调整;具体桶数和扩容阶梯由实现决定。C++ 标准草案:unordered_map 的构造
二、哈希函数的构造方法
2.1 除留余数法与容量选择
除留余数法直接对整数取模:
h ( k ) = k m o d M h(k)=k\bmod M h(k)=kmodM
它容易实现,但下标分布会受到关键字规律和 M M M 的共同影响。
如果 M = 2 r M=2^r M=2r,对非负整数取模就只保留最低的 r r r 个二进制位。例如,31 % 16 和 63 % 16 都为 15。如果输入的差异主要集中在高位,直接取模便利用不到这些差异。
类似地,对 10 r 10^r 10r 取模只保留末尾 r r r 位十进制数字。某些编号具有固定后缀时,就可能集中映射到少数位置。
在"整数直接取模"的简单方案中,选择合适的质数作为容量是一种常见做法。一些经典 STL 实现也使用预先准备的质数表管理桶数。不过,质数容量不保证均匀分布 :如果输入都相差 M M M 的整数倍,仍然会全部冲突。
反过来,容量也并非不能取 2 的幂。只要前面的哈希混合足够合适,2 的幂容量也可以有效工作。以 OpenJDK 8 的 HashMap 为例,非空关键字先产生 hashCode(),再进行高低位混合,最后计算桶下标:
java
int h = key.hashCode();
int mixed = h ^ (h >>> 16);
int index = mixed & (capacity - 1);
其中 >>> 是 Java 的无符号右移,不能直接当成 C++ 运算符使用。这里参与混合的是关键字的哈希值,并非任意对象本身。OpenJDK 8:HashMap 实现
2.2 乘法散列法:利用乘积的小数部分
乘法散列法选取常数 A A A,满足 0 < A < 1 0<A<1 0<A<1。先计算 k A kA kA 的小数部分,再映射到数组范围内:
h ( k ) = ⌊ M ( k A − ⌊ k A ⌋ ) ⌋ h(k)=\left\lfloor M\left(kA-\lfloor kA\rfloor\right)\right\rfloor h(k)=⌊M(kA−⌊kA⌋)⌋
常见的选择是:
A = 5 − 1 2 ≈ 0.6180339887 A=\frac{\sqrt{5}-1}{2}\approx 0.6180339887 A=25 −1≈0.6180339887
例如,取 k = 1234 k=1234 k=1234、 M = 1024 M=1024 M=1024:
- 计算乘积,约为
762.653942。 - 取小数部分,约为
0.653942。 - 乘以
1024,约为669.636。 - 向下取整,得到下标
669。
这个构造不要求 M M M 为质数。但数学公式和机器实现仍有区别:使用浮点数处理很大的整数时,要考虑精度问题;也不能在 C++ 中直接写 x % 1.0,因为 % 不支持浮点操作数。实际性能则取决于具体实现和硬件,不能只根据公式就断言一定快于或慢于取模。
2.3 全域散列:从一组函数中随机选择
固定的散列规则可能遇到大量冲突的输入。全域散列的思路是先构造一个具有碰撞概率保证的函数族,再随机选出一个函数供哈希表使用。
一种常见构造为:
h a , b ( k ) = ( ( a k + b ) m o d P ) m o d M h_{a,b}(k)=((ak+b)\bmod P)\bmod M ha,b(k)=((ak+b)modP)modM
这里假设关键字已编码为 0 , P − 1 0,P-1 0,P−1 内的整数, P P P 为不小于 M M M 的质数,并选择:
1 ≤ a ≤ P − 1 , 0 ≤ b ≤ P − 1 1\le a\le P-1,\qquad 0\le b\le P-1 1≤a≤P−1,0≤b≤P−1
这样可以形成 P ( P − 1 ) P(P-1) P(P−1) 个参数组合。建表时随机选取一组参数,此后插入、查找、删除都沿用这组参数。例如, P = 17 P=17 P=17、 M = 6 M=6 M=6、 a = 3 a=3 a=3、 b = 4 b=4 b=4、 k = 8 k=8 k=8 时:
h 3 , 4 ( 8 ) = ( 28 m o d 17 ) m o d 6 = 11 m o d 6 = 5 h_{3,4}(8)=(28\bmod17)\bmod6=11\bmod6=5 h3,4(8)=(28mod17)mod6=11mod6=5
这里的随机性属于函数选择过程 ,并不是每次查找都随机生成一个位置。如果更换参数,就必须重新散列已有元素。计算 a * k + b 时,也需要避免机器整数溢出破坏预期的模运算。
随机选择可以降低固定输入恰好针对某个函数造成集中冲突的风险,但不意味着任何攻击输入都能被自动解决。尤其面对能够不断观察系统行为的输入方,还需要结合具体的安全散列设计。
2.4 非整数关键字与哈希仿函数
对于字符串或自定义结构体,先把关键字转换为整数,再计算数组下标,能让容器结构和关键字类型相互独立。
在 C++ 中,可以通过重载 operator() 提供一个可调用对象,即哈希仿函数。本文使用统一接口:
cpp
template<class K>
struct KeyHash {
    std::size_t operator()(const K& key) const {
        return std::hash<K>{}(key);
    }
};
它只负责返回哈希值,取模由哈希表完成。对于标准库未提供哈希支持的自定义类型,可以另外传入一个仿函数,不必改动哈希表本身。
字符串的 BKDR 思路
将字符编码直接相加虽然简单,却忽略了顺序。例如,"abcd" 与 "bcad" 的字符和相同。
BKDR 常用多项式累积的方式,让前面的计算结果参与后面的计算:
H i + 1 = H i × seed + c i , H 0 = 0 H_{i+1}=H_i\times\text{seed}+c_i,\qquad H_0=0 Hi+1=Hi×seed+ci,H0=0
选取 seed = 131,可以写成:
cpp
template<>
struct KeyHash<std::string> {
    std::size_t operator()(const std::string& key) const noexcept {
        std::size_t result = 0;
        for (unsigned char ch : key)
            result = result * 131u + ch;
        return result;
    }
};
这里使用 unsigned char 读取每个字节,避免普通 char 的有符号性影响结果;使用无符号的 std::size_t 累积,其溢出按无符号整数规则回绕。
种子也可以选择 31,此时 h * 31 在数学上等价于 (h << 5) - h,实际是否需要手动替换应交给性能测量判断。多项式哈希仍然可能碰撞,也不是密码学哈希。
无论采用什么哈希算法,都要遵守一个约定:被相等比较器判定为相等的关键字,必须产生相同的哈希值。例如,若比较字符串时忽略大小写,哈希计算也必须采用对应的大小写规则。
另外,表中的关键字不能随意修改。修改后如果哈希值改变,元素却还停留在旧位置,后续查找就会失效。本文的查找接口只返回值的指针,不向外暴露可修改的关键字。
2.5 其他构造思路
除了以上方法,还可以根据数据特点选择其他构造方式:
| 方法 | 主要思路 | 使用时需要关注的问题 |
|---|---|---|
| 平方取中法 | 对关键字平方,截取中间若干位 | 平方的溢出,以及所选位是否有足够变化 |
| 折叠法 | 将关键字分段,再对各段进行组合 | 分段方式和组合运算会影响分布 |
| 数字分析法 | 分析样本中各位的变化,选择分布较好的位 | 数据分布发生变化后,原来的选择可能不再合适 |
| 基于伪随机映射的方法 | 利用固定规则把关键字映射到看似随机的整数 | 同一关键字在同一张表中必须得到稳定结果 |
评价一个哈希函数时,不能只看公式是否复杂,还要看输入分布、计算开销以及它与冲突处理方式是否匹配。
三、哈希冲突的处理方式
3.1 开放定址法:在数组内继续探测
开放定址法把所有元素都放在数组中。当初始位置已被占用时,按照事先约定的探测序列寻找其他位置。
下面用长度为 11 的数组说明几种探测方法,初始状态如下:
如上图,每个位置都能存放一个元素。不同探测方法的区别在于:发生冲突后,下一个要检查的位置如何计算。
为便于比较,下面的图解固定使用容量 11,暂不触发自动扩容;后面的实际代码会根据负载因子提前扩容。
3.1.1 线性探测与连续聚集
线性探测每次向后移动一个位置,到数组末尾后回到开头:
h i ( k ) = ( h 0 ( k ) + i ) m o d M , i = 0 , 1 , ... , M − 1 h_i(k)=(h_0(k)+i)\bmod M,\qquad i=0,1,\ldots,M-1 hi(k)=(h0(k)+i)modM,i=0,1,...,M−1
取 h 0 ( k ) = k m o d 11 h_0(k)=k\bmod11 h0(k)=kmod11,依次插入:
text
19、30、5、36、13、20、21、12过程如下:
| 关键字 | 初始下标 | 探测过程 | 最终下标 |
|---|---|---|---|
| 19 | 8 | 8 为空 | 8 |
| 30 | 8 | 8 被占用,继续检查 9 | 9 |
| 5 | 5 | 5 为空 | 5 |
| 36 | 3 | 3 为空 | 3 |
| 13 | 2 | 2 为空 | 2 |
| 20 | 9 | 9 被占用,继续检查 10 | 10 |
| 21 | 10 | 10 被占用,回到 0 | 0 |
| 12 | 1 | 1 为空 | 1 |
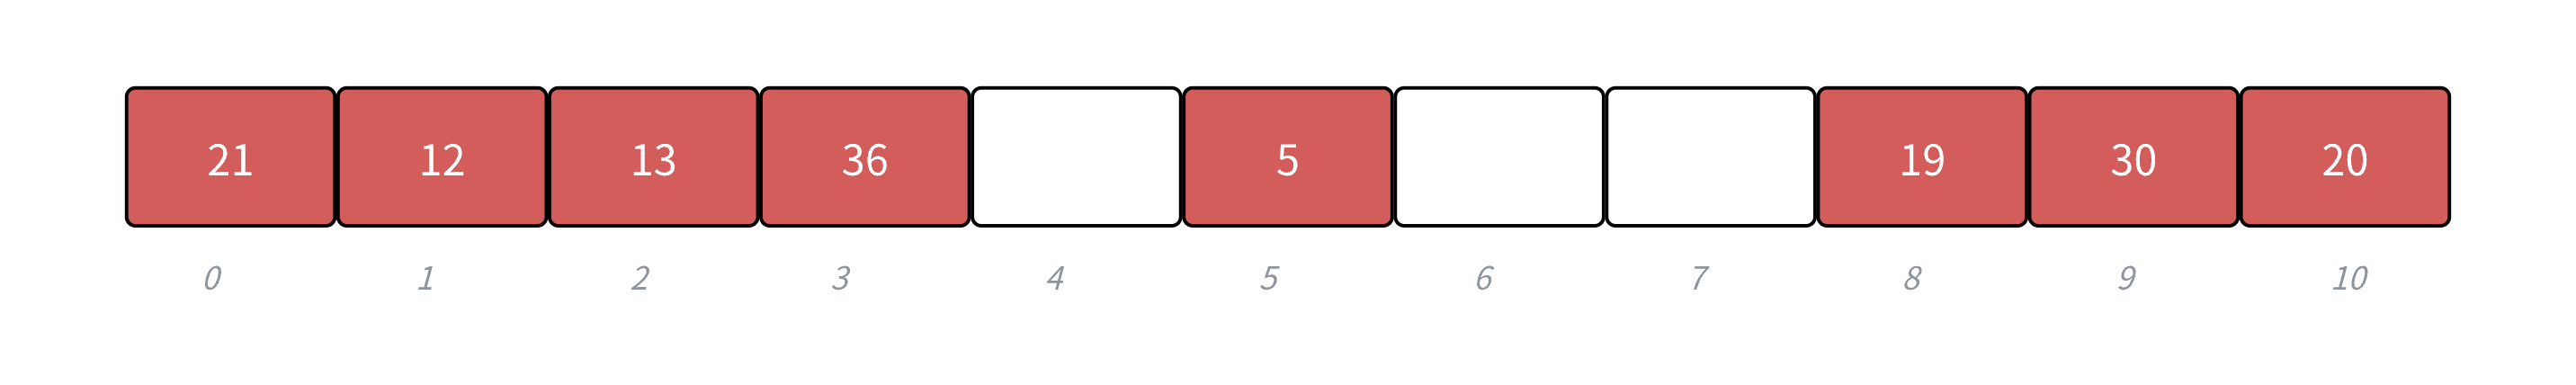
如上图,19 和 30 的初始位置相同,但冲突的影响不止于它们两个。30 占据了下标 9,使原本映射到 9 的 20 也必须后移;接着 21 又受到影响。
这种连续占用区不断增长的现象称为一次聚集,也常被称为堆积。即使新关键字的初始哈希值与之前不同,只要落入这片区域,也需要经过更多探测。
线性探测的优点是实现简单、数组访问较连续;缺点则是负载上升后,连续聚集容易拉长查找路径。因此,控制负载因子是它保持效率的重要条件。
3.1.2 二次探测与正负平方偏移
二次探测使用平方相关的偏移,避免总是紧挨着检查下一个位置。这里采用以下探测顺序:
h 0 , h 0 + 1 2 , h 0 − 1 2 , h 0 + 2 2 , h 0 − 2 2 , ... h_0,\quad h_0+1^2,\quad h_0-1^2,\quad h_0+2^2,\quad h_0-2^2,\ldots h0,h0+12,h0−12,h0+22,h0−22,...
各位置都要对 M M M 取模。注意,每个偏移都以初始位置 h 0 h_0 h0 为基准,不是从上一次位置继续加平方数。
为了与下方数组中的位置一致,本例依次插入:
text
19、52、30、63、11、22仍然使用 h 0 ( k ) = k m o d 11 h_0(k)=k\bmod11 h0(k)=kmod11,具体过程为:
| 关键字 | 探测过程 | 最终下标 |
|---|---|---|
| 19 | 初始下标为 8,直接放入 | 8 |
| 52 | 8 被占用,检查 8 + 1² = 9 | 9 |
| 30 | 8、9 均被占用,检查 8 − 1² = 7 | 7 |
| 63 | 8、9、7 均被占用,检查 (8 + 2²) % 11 = 1 | 1 |
| 11 | 初始下标为 0,直接放入 | 0 |
| 22 | 0、1 被占用,检查 (0 − 1²) mod 11 = 10 | 10 |
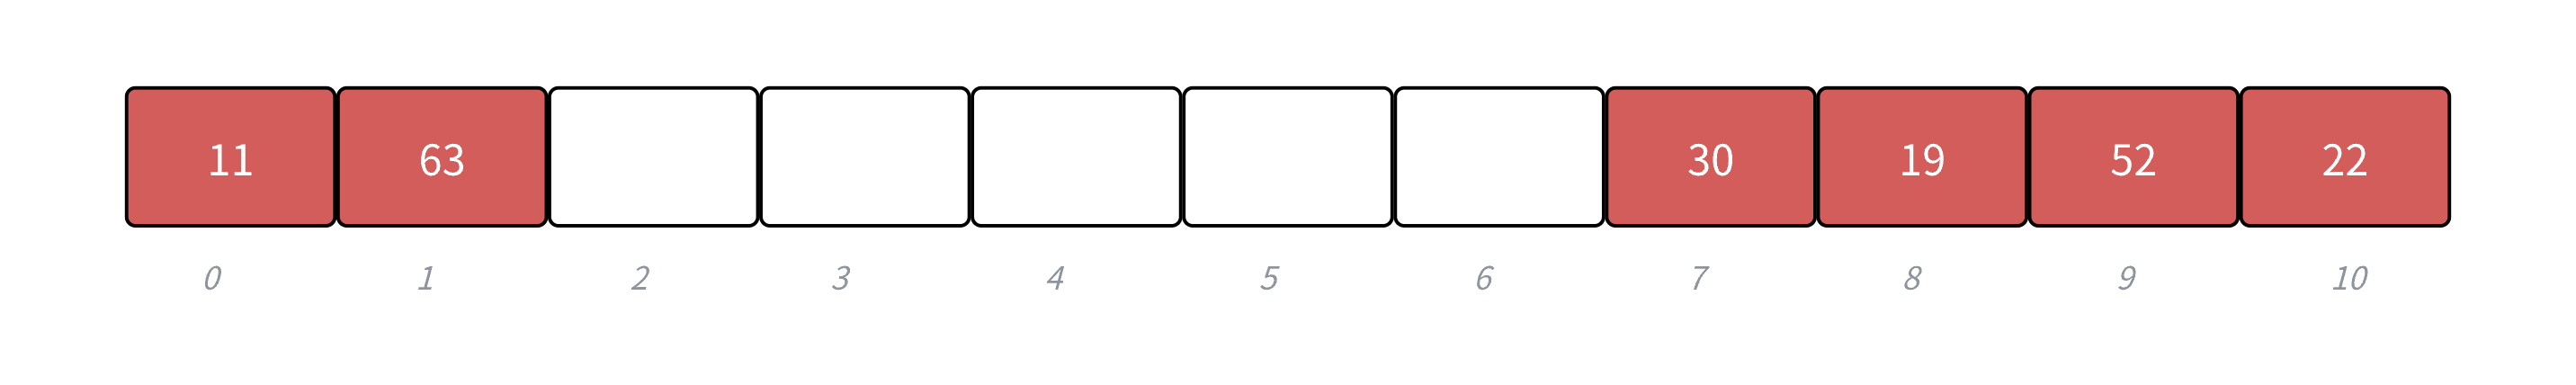
如上图,映射到下标 8 的几个元素被分散到了 8、9、7、1。这里 30 位于 7、52 位于 9,与本例中先插入 52、后插入 30 的顺序相对应;交换这两个元素的插入顺序,它们的最终位置也会交换。
二次探测能够缓解线性探测的一次聚集,但初始位置相同的关键字仍然可能共享一条探测序列,形成二次聚集。另外,不同二次探测公式对容量的要求也不同,不能看到数组还有空位,就认定某条平方探测序列一定能找到它。
实现时还要处理负余数。在 C++ 中,-1 % 11 为 -1,并不是合法下标。对于不会溢出的有符号中间值,可以先计算余数,若小于零再加上容量,将其规范到 0~M-1。
3.1.3 双重探测与步长互质
双重探测使用两个函数:第一个确定起点,第二个确定步长。
h i ( k ) = ( h 1 ( k ) + i ⋅ h 2 ( k ) ) m o d M h_i(k)=(h_1(k)+i\cdot h_2(k))\bmod M hi(k)=(h1(k)+i⋅h2(k))modM
若 M M M 为质数,可以选择:
h 1 ( k ) = k m o d M , h 2 ( k ) = k m o d ( M − 1 ) + 1 h_1(k)=k\bmod M,\qquad h_2(k)=k\bmod(M-1)+1 h1(k)=kmodM,h2(k)=kmod(M−1)+1
第二个函数使步长落在 1~M-1,因此不会为零,并且与质数容量互质。
例如, M = 11 M=11 M=11,依次插入 19、30、52、74:
| 关键字 | 起点 | 步长 | 探测结果 |
|---|---|---|---|
| 19 | 8 | 10 | 8 为空,放在 8 |
| 30 | 8 | 1 | 8 被占用,放在 9 |
| 52 | 8 | 3 | 8 被占用,(8 + 3) % 11 = 0,放在 0 |
| 74 | 8 | 5 | 8 被占用,(8 + 5) % 11 = 2,放在 2 |
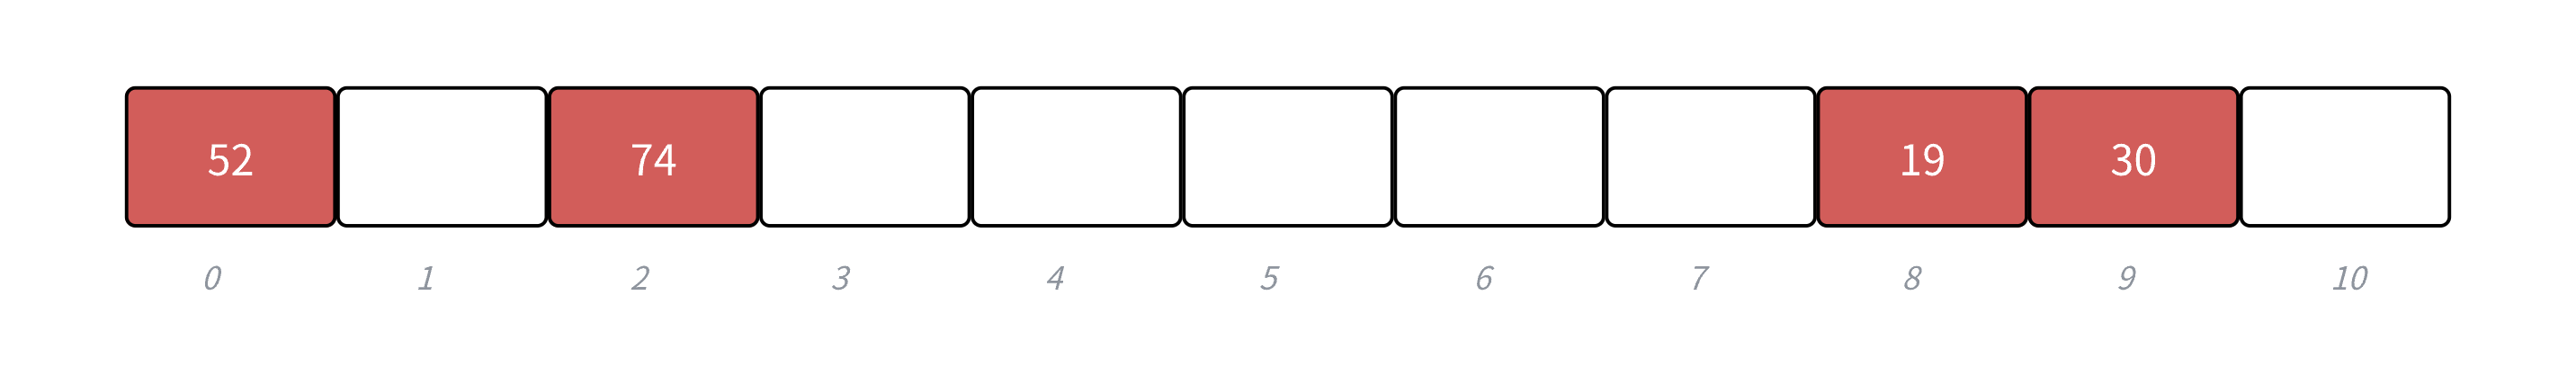
如上图,几个关键字的起点虽然相同,但步长不同,因此后续探测位置也不同。这有助于减少大量关键字沿同一条探测序列前进的情况。
步长与容量互质是完整遍历数组的关键条件。 例如,容量为 12、步长为 3,从下标 1 出发只能访问 1、4、7、10,随后又回到 1。一般情况下,可访问的不同位置数量为:
M gcd ( M , h 2 ( k ) ) \frac{M}{\gcd(M,h_2(k))} gcd(M,h2(k))M
因此,容量为质数时可以使用上面的步长构造;容量为 2 的幂时,则通常要求步长为奇数。双重探测增加了计算量,也可能降低访问的连续性,最终性能仍要结合工作负载判断。
3.1.4 删除标记为什么不能省略
回到前面的线性探测例子,30 位于下标 9,20 位于下标 10。现在删除 30:
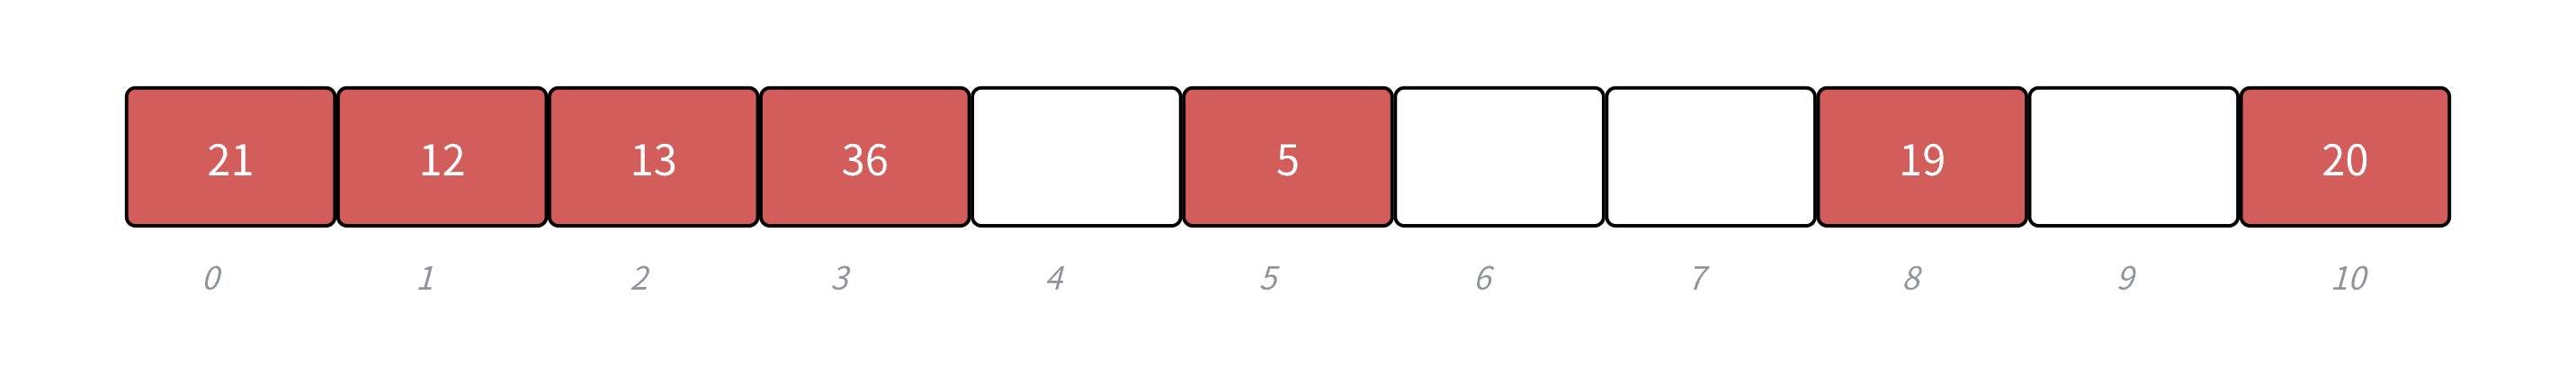
如上图,下标 9 已经没有有效关键字。但查找 20 时,仍然会先计算 20 % 11 = 9。如果把这个位置当成"从未使用过",查找就可能立即结束,错误地认为 20 不存在。
因此,数组位置至少需要区分三种状态:
| 状态 | 含义 | 查找时的处理 |
|---|---|---|
EMPTY |
当前这一轮建表以来未放入过元素 | 可以结束,关键字不存在 |
OCCUPIED |
存放有效元素 | 比较关键字,不相等则继续 |
DELETED |
曾经使用,元素现已删除 | 跳过当前位置,继续探测 |
上图的空白只表示 30 已被移除;在实现中,这个位置应记录为 DELETED,不能直接恢复成 EMPTY。
删除位置可以被后续插入复用,但这里还有一个容易遗漏的细节:遇到删除位置时,不能在尚未检查完重复键的情况下直接插入。 目标关键字可能已经存在于探测序列的后面。可以先完整查重,再寻找可用位置;也可以记下第一个删除位置,继续查重后再决定是否使用它。
此外,删除标记本身不会减少探测长度。如果反复插入、删除,即使有效元素很少,数组中仍可能积累大量标记。因此,查找要限制最多探测 M 次,必要时还应通过重新散列清理这些标记。
3.2 链地址法:把冲突集中到对应桶中
链地址法把数组中的每个位置看作一个桶,每个桶保存一条链表的头指针。关键字映射到哪个桶,就插入该桶的链表。
在这种结构中,所有元素都存放在节点中;即使某个桶只有一个元素,它也仍然是一个链表节点。
设桶数为 11,依次插入:
text
19、30、5、36、13、20、21、12、24、96若每次采用头插法,结果如下:
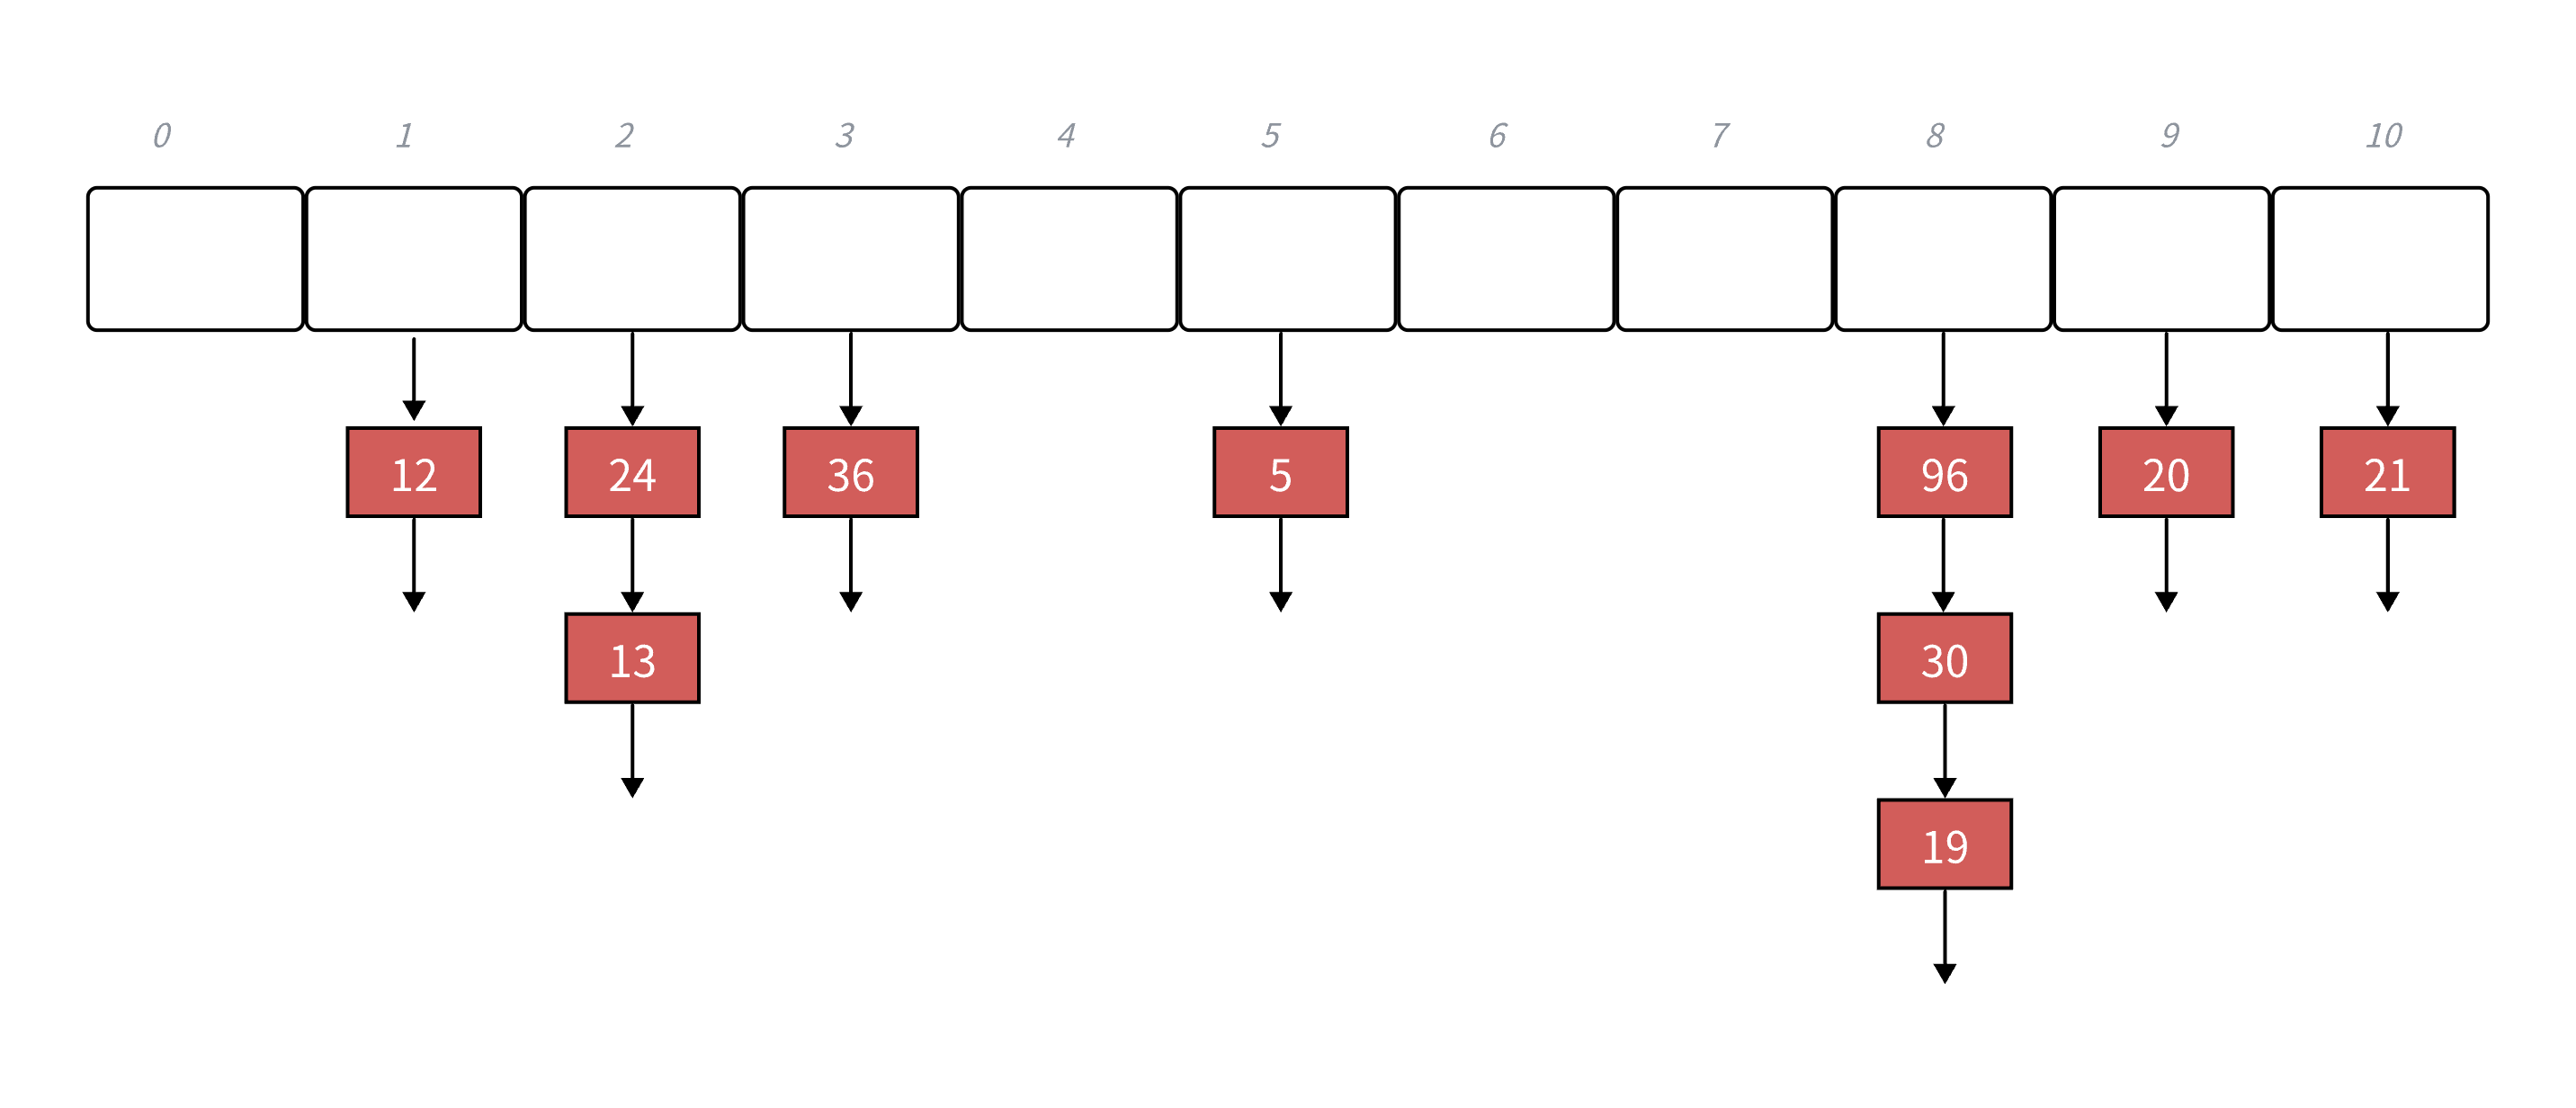
如上图,19、30、96 都映射到桶 8。由于新节点插在链表头部,最终顺序为 96 → 30 → 19。同理,桶 2 中的顺序为 24 → 13。
查找 30 时,先定位桶 8,再在这条链表中逐个比较。删除时,只需断开目标节点并修复链表连接,不需要开放定址法中的删除标记。
两种方法的取舍可以概括为:
| 比较项 | 开放定址法 | 链地址法 |
|---|---|---|
| 存储布局 | 元素位于连续数组中 | 桶数组连接独立节点 |
| 冲突后的查找 | 按探测序列访问槽位 | 遍历目标桶中的链表 |
| 删除处理 | 需维护探测可达性,本文使用删除标记 | 修改前驱或桶头指针即可 |
| 容量限制 | 元素数不能超过槽位数 | 元素数可以超过桶数 |
| 主要额外开销 | 空槽位、状态信息、重新散列 | 节点指针、动态分配、链表遍历 |
| 局部性 | 线性探测的访问通常较连续 | 节点可能分散在不同内存位置 |
链地址法不会因一个桶装入更多元素就直接占用另一个桶的位置,但仍可能产生很长的链表。若所有关键字都落入同一个桶,查找就会退化为线性遍历。
长链表与树化处理
一种改善长链表的方法,是在满足条件时将桶内结构改为平衡树。OpenJDK 8 的 HashMap 使用了这类策略,其中树化阈值常量为 8,最小树化容量为 64;容量较小时,会优先扩容。具体转换还与插入路径有关,不能只凭"链长等于 8"就判断一定已经树化。OpenJDK 8:HashMap 实现
也不能把树化简单理解为所有输入都无条件获得对数查找时间:当哈希值相同且关键字之间缺少可用的比较顺序时,仍可能需要搜索多个分支。本文的实现只保留单链表,便于集中理解哈希桶的组织与扩容。
四、用 C++ 实现线性探测哈希表
4.1 接口、槽位与状态设计
本节实现 LinearHashTable<K, V, Hash, Equal>。其中 Hash 负责计算哈希值,Equal 负责比较关键字。
主要接口约定如下:
| 接口 | 行为 |
|---|---|
insert(key, value) |
只插入新关键字;重复时返回 false,保留原值 |
find(key) |
返回值的指针;不存在时返回 nullptr |
erase(key) |
删除成功返回 true,不存在返回 false |
size() / empty() |
查询有效元素数量或是否为空 |
capacity() / print(out) |
查看容量和槽位状态 |
底层结构如下:
cpp
enum class State { Empty, Occupied, Deleted };
struct Slot {
    State state = State::Empty;
    std::optional<std::pair<K, V>> data;
};
std::vector<Slot> slots_;
std::size_t size_ = 0;
std::size_t deleted_ = 0;
Hash hash_;
Equal equal_;
std::optional 表示槽位当前是否真正持有一个键值对。因此,空槽位不需要先构造一个无用的 K 或 V,删除时也可以立即释放键值对持有的资源。
size_ 只统计有效元素,deleted_ 单独统计删除标记。仅关注 size_ 无法反映探测路径上的历史占用情况。
哈希和比较对象作为成员保存,整个表使用同一组对象。这样也可以支持带固定种子等状态的哈希仿函数,而不是在每次操作中重新构造它。
4.2 查找:按插入时的规则继续探测
先实现一个内部辅助函数 locate。找到时返回下标,没有找到时返回数组容量,作为不可能与合法下标混淆的哨兵值。
cpp
std::size_t locate(const K& key) const {
    const auto capacity = slots_.size();
    auto index = hash_(key) % capacity;
    for (std::size_t visited = 0; visited < capacity; ++visited) {
        const auto& slot = slots_[index];
        if (slot.state == State::Empty) return capacity;
        if (slot.state == State::Occupied &&
            equal_(slot.data->first, key)) return index;
        index = (index + 1) % capacity;
    }
    return capacity;
}
这里有三个关键点:遇到 Empty 才能提前停止;遇到 Deleted 继续向后;最多访问 capacity 个位置。最后一个限制使查找即使遇到全是有效槽位或删除标记的数组,也能正常结束。
(index + 1) % capacity 负责循环回到数组起点,保证末尾发生的冲突也能继续探测。
4.3 扩容与删除标记清理
容量改变后,hash(key) % capacity 的结果可能改变。所以扩容不能只调用 vector::resize,再让元素留在原来的下标中。
正确过程是:分配新数组,把有效元素按照新容量重新定位,最后替换旧数组。删除标记不需要迁移。
cpp
static std::size_t live_limit(std::size_t capacity) {
    // floor(capacity * 0.7),避免先乘 7 造成溢出。
    return (capacity / 10) * 7 + (capacity % 10) * 7 / 10;
}

void rehash(std::size_t capacity) {
    std::vector<Slot> fresh(capacity);
    for (const auto& slot : slots_) {
        if (slot.state != State::Occupied) continue;
        auto index = hash_(slot.data->first) % capacity;
        while (fresh[index].state == State::Occupied)
            index = (index + 1) % capacity;
        fresh[index].data.emplace(*slot.data);
        fresh[index].state = State::Occupied;
    }
    slots_.swap(fresh);
    deleted_ = 0;
}
live_limit 计算允许的有效元素数量上限;把乘法拆开是为了避免先计算 capacity * 7 时溢出。
rehash 既能用于增大容量,也能在容量不变时整理数组。后者只迁移有效元素,可以将所有删除标记清零。
新数组中不存在删除标记,且调用方保证其容量足够,因此内部放置元素时只需跳过已占用位置。所有元素迁移完成后才进行 swap;旧数组随后由局部变量负责释放。
容量使用预先选好的质数阶梯,每次扩容选择一个更大的值。本文默认从 11 开始,接着是 23、53、97、193......。如果需求超过阶梯的上限,函数明确抛出异常,不会返回原容量继续假装扩容成功。完整的 next_capacity 位于文末公共头文件中。
4.4 插入:先查重,再判断是否需要重新散列
插入流程分为四步:检查重复键、判断容量或删除标记情况、寻找可复用位置、构造元素并更新计数。
cpp
bool insert(const K& key, const V& value) {
    if (locate(key) != slots_.size()) return false;
    // 先保存参数,防止 value 来自本表而被 rehash 失效。
    std::pair<K, V> pending(key, value);
    const auto capacity = slots_.size();
    if (size_ >= live_limit(capacity)) {
        rehash(next_capacity(capacity + 1));
    } else if (size_ + deleted_ >= live_limit(capacity)) {
        rehash(capacity); // 清理删除标记,不扩大容量。
    }

    auto index = hash_(pending.first) % slots_.size();
    for (std::size_t visited = 0; visited < slots_.size(); ++visited) {
        auto& slot = slots_[index];
        if (slot.state != State::Occupied) {
            const bool reused = slot.state == State::Deleted;
            slot.data.emplace(pending);
            slot.state = State::Occupied;
            ++size_;
            if (reused) --deleted_;
            return true;
        }
        index = (index + 1) % slots_.size();
    }
    throw std::logic_error("no free slot after capacity check");
}
这里先调用 locate,因此后面遇到 Deleted 时可以安全复用,不会把探测序列后方已经存在的关键字再插入一遍。
两个重新散列条件分别解决不同问题:
- 有效元素已经达到数量上限:新元素插入前扩大容量。
- 有效元素与删除标记之和达到上限:有效数据尚不多,但探测环境已经拥挤,按原容量重新整理。
判断发生在插入之前。例如,容量为 11 时允许最多 7 个有效元素,第 8 个新关键字到来时先扩容。重复键由于在最前面返回,不会无故引发扩容。
pending 用来提前保存待插入数据。如果调用者把本表中某个值的引用作为参数传入,重新散列可能让原引用失效;提前复制可以避免随后访问失效引用。
4.5 查找接口、修改与删除
基于 locate,对外的查找和删除都可以写得比较直接:
cpp
V* find(const K& key) {
    const auto index = locate(key);
    return index == slots_.size() ? nullptr : &slots_[index].data->second;
}
const V* find(const K& key) const {
    const auto index = locate(key);
    return index == slots_.size() ? nullptr : &slots_[index].data->second;
}
bool erase(const K& key) {
    const auto index = locate(key);
    if (index == slots_.size()) return false;
    auto& slot = slots_[index];
    slot.data.reset();
    slot.state = State::Deleted;
    --size_;
    ++deleted_;
    return true;
}
修改值不需要重新计算位置,因为决定位置的是关键字。例如:
cpp
if (auto* count = table.find("pear")) {
    ++*count;
}
删除时先释放槽位中的数据,再把状态改为 Deleted,同时减少有效元素数量、增加删除标记数量。
另外,线性探测版本中的 find 返回指向数组内数据的指针。后续插入如果触发扩容或原容量整理,这些指针就会失效,因此不能长期保存后跨越相关操作使用。
五、用 C++ 实现链地址哈希表
5.1 节点与桶数组的定义
链地址版本使用 ChainedHashTable<K, V, Hash, Equal>,对外接口与前面的线性探测版本保持一致。这样可以用同一组操作观察两种存储方式的差异。
cpp
struct Node {
    std::pair<const K, V> data;
    std::size_t hash_code;
    Node* next = nullptr;
    Node(const K& key, const V& value, std::size_t code)
        : data(key, value), hash_code(code) {}
};
std::vector<Node*> buckets_;
std::size_t size_ = 0;
Hash hash_;
Equal equal_;
桶数组中的每个元素都是链表头指针,空桶保存 nullptr。节点中的关键字使用 const K,值仍然可以修改。
节点额外保存了完整的 hash_code。查找时可以先比较哈希值,再调用关键字比较器;扩容时也可以直接利用已有哈希值重新计算桶下标。注意,缓存的是哈希值,不是旧桶下标。
5.2 查找:定位桶后遍历链表
链地址查找不需要跨桶探测:
cpp
Node* locate(const K& key, std::size_t code) const {
    auto* current = buckets_[code % buckets_.size()];
    while (current) {
        if (current->hash_code == code && equal_(current->data.first, key))
            return current;
        current = current->next;
    }
    return nullptr;
}如果同一哈希值对应多个不同关键字,equal_ 会进一步区分它们。没有找到时返回 nullptr。
对外提供可修改值的 V* 和只读的 const V* 两种接口。由于关键字被限制为不可修改,调用者更新值不会改变节点应该归属的桶。
5.3 扩容:重新连接已有节点
链地址法扩容同样要按照新桶数重新分配元素,但不必复制键值对,也不必为已有元素重新分配节点。
cpp
void rehash(std::size_t capacity) {
    std::vector<Node*> fresh(capacity, nullptr);
    for (auto* head : buckets_) {
        while (head) {
            auto* next = head->next;
            const auto index = head->hash_code % capacity;
            head->next = fresh[index];
            fresh[index] = head;
            head = next;
        }
    }
    buckets_.swap(fresh);
}
移动一个节点时,必须先保存旧的 next,再修改该节点的链接。如果直接把 head->next 改成新桶的头指针,就会丢失原链表中尚未处理的后续节点。
这里仍采用头插法,因此扩容后桶内节点的先后顺序可能发生变化。哈希表本身不承诺按插入顺序或关键字大小顺序遍历,这种改变不会影响查找结果。
整个过程只移动已有节点的归属关系,元素数量不变。创建新桶数组需要与新桶数成正比的初始化工作,迁移节点需要访问每个元素一次。
5.4 插入:查重、扩容与头插
本实现将最大负载因子设为 1:当现有元素数等于桶数时,下一个新元素插入前扩容。
cpp
bool insert(const K& key, const V& value) {
    const auto code = hash_(key);
    if (locate(key, code)) return false;
    auto pending = std::make_unique<Node>(key, value, code);
    // 将负载因子的阈值设为 1,插入后超过阈值才需扩容。
    if (size_ >= buckets_.size())
        rehash(next_capacity(buckets_.size() + 1));
    const auto index = code % buckets_.size();
    pending->next = buckets_[index];
    buckets_[index] = pending.release();
    ++size_;
    return true;
}
哈希值只计算一次,查重和定位都使用同一个结果。即使发生扩容,也只是取模时采用新的桶数。
新节点先由 unique_ptr 暂时管理。如果节点构造或新桶数组分配失败,不会遗留无人管理的节点。确定可以接入桶链表之后,再调用 release(),把节点交给哈希表管理。
这里的负载阈值是实现选择。链地址结构本身允许一个桶中存在多个节点,因此并不存在"元素数等于桶数就没有地方存储"的物理限制。
5.5 删除:区分桶头与链表内部节点
删除节点时,需要同时记录当前节点和前驱节点:
cpp
bool erase(const K& key) {
    const auto code = hash_(key);
    const auto index = code % buckets_.size();
    Node* previous = nullptr;
    auto* current = buckets_[index];
    while (current) {
        if (current->hash_code == code && equal_(current->data.first, key)) {
            if (previous) previous->next = current->next;
            else buckets_[index] = current->next;
            delete current;
            --size_;
            return true;
        }
        previous = current;
        current = current->next;
    }
    return false;
}
如果删除桶内第一个节点,需要更新桶头;如果删除中间或末尾节点,则修改前驱的 next。完成连接调整之后释放目标节点,最后减少元素数量。
与开放定址法不同,这里删除节点不会破坏其他节点的定位路径,因此不需要保留删除标记。
5.6 析构与对象管理
桶数组保存的是原始指针,销毁 vector<Node*> 只会释放指针数组,不会自动释放每个节点,所以必须显式清理所有链表:
cpp
~ChainedHashTable() {
    for (auto* head : buckets_) {
        while (head) {
            auto* next = head->next;
            delete head;
            head = next;
        }
    }
}
析构需要扫描所有桶并访问所有节点,时间复杂度为 O ( M + N ) O(M+N) O(M+N)。
为了把篇幅集中在哈希表本身,本文两套实现都显式禁用了复制和移动。对于链地址版本,尤其不能直接使用默认浅拷贝:两张表若共同持有同一批节点,析构时就会重复释放。若需要可复制容器,应另外实现节点的深拷贝及相应赋值操作。
本链地址实现的重新散列不移动节点对象,所以指向仍存活元素的值指针不会仅因扩容失效;删除对应元素或销毁哈希表后,这些指针仍然会失效。
六、完整代码与使用验证
6.1 代码文件的组织
将下面三个头文件和示例程序放在同一目录,使用 C++17 编译。两套容器位于 teaching 命名空间中,共用哈希仿函数和容量选择函数。
正文前面的代码按功能拆开讲解,下面提供可以直接保存使用的完整版本。
HashCommon.h:哈希函数与容量阶梯
cpp
#pragma once
#include <cstddef>
#include <functional>
#include <stdexcept>
#include <string>

namespace teaching {
inline std::size_t next_capacity(std::size_t requested) {
    // 预先选好的质数阶梯;耗尽时明确报错。
    constexpr std::size_t primes[] = {
        11u, 23u, 53u, 97u, 193u, 389u, 769u, 1543u,
        3079u, 6151u, 12289u, 24593u, 49157u, 98317u,
        196613u, 393241u, 786433u, 1572869u, 3145739u,
        6291469u, 12582917u, 25165843u, 50331653u,
        100663319u, 201326611u, 402653189u, 805306457u,
        1610612741u, 3221225473u, 4294967291u
    };
    for (auto p : primes)
        if (p >= requested) return p;
    throw std::length_error("capacity ladder exhausted");
}

template<class K>
struct KeyHash {
    std::size_t operator()(const K& key) const {
        return std::hash<K>{}(key);
    }
};

template<>
struct KeyHash<std::string> {
    std::size_t operator()(const std::string& key) const noexcept {
        std::size_t result = 0;
        for (unsigned char ch : key)
            result = result * 131u + ch;
        return result;
    }
};
} // namespace teaching
LinearHashTable.h:线性探测版本
cpp
#pragma once
#include "HashCommon.h"
#include <optional>
#include <ostream>
#include <utility>
#include <vector>

namespace teaching {
template<class K, class V, class Hash = KeyHash<K>,
         class Equal = std::equal_to<K>>
class LinearHashTable {
    enum class State { Empty, Occupied, Deleted };
    struct Slot {
        State state = State::Empty;
        std::optional<std::pair<K, V>> data;
    };
    std::vector<Slot> slots_;
    std::size_t size_ = 0;
    std::size_t deleted_ = 0;
    Hash hash_;
    Equal equal_;
    std::size_t locate(const K& key) const {
        const auto capacity = slots_.size();
        auto index = hash_(key) % capacity;
        for (std::size_t visited = 0; visited < capacity; ++visited) {
            const auto& slot = slots_[index];
            if (slot.state == State::Empty) return capacity;
            if (slot.state == State::Occupied &&
                equal_(slot.data->first, key)) return index;
            index = (index + 1) % capacity;
        }
        return capacity;
    }
    static std::size_t live_limit(std::size_t capacity) {
        // floor(capacity * 0.7),避免先乘 7 造成溢出。
        return (capacity / 10) * 7 + (capacity % 10) * 7 / 10;
    }

    void rehash(std::size_t capacity) {
        std::vector<Slot> fresh(capacity);
        for (const auto& slot : slots_) {
            if (slot.state != State::Occupied) continue;
            auto index = hash_(slot.data->first) % capacity;
            while (fresh[index].state == State::Occupied)
                index = (index + 1) % capacity;
            fresh[index].data.emplace(*slot.data);
            fresh[index].state = State::Occupied;
        }
        slots_.swap(fresh);
        deleted_ = 0;
    }

public:
    explicit LinearHashTable(std::size_t capacity = 11,
                             Hash hash = Hash{}, Equal equal = Equal{})
        : slots_(next_capacity(capacity)),
          hash_(std::move(hash)), equal_(std::move(equal)) {}

    LinearHashTable(const LinearHashTable&) = delete;
    LinearHashTable& operator=(const LinearHashTable&) = delete;
    LinearHashTable(LinearHashTable&&) = delete;
    LinearHashTable& operator=(LinearHashTable&&) = delete;
    bool insert(const K& key, const V& value) {
        if (locate(key) != slots_.size()) return false;
        // 先保存参数,防止 value 来自本表而被 rehash 失效。
        std::pair<K, V> pending(key, value);
        const auto capacity = slots_.size();
        if (size_ >= live_limit(capacity)) {
            rehash(next_capacity(capacity + 1));
        } else if (size_ + deleted_ >= live_limit(capacity)) {
            rehash(capacity); // 清理删除标记,不扩大容量。
        }

        auto index = hash_(pending.first) % slots_.size();
        for (std::size_t visited = 0; visited < slots_.size(); ++visited) {
            auto& slot = slots_[index];
            if (slot.state != State::Occupied) {
                const bool reused = slot.state == State::Deleted;
                slot.data.emplace(pending);
                slot.state = State::Occupied;
                ++size_;
                if (reused) --deleted_;
                return true;
            }
            index = (index + 1) % slots_.size();
        }
        throw std::logic_error("no free slot after capacity check");
    }
    V* find(const K& key) {
        const auto index = locate(key);
        return index == slots_.size() ? nullptr : &slots_[index].data->second;
    }
    const V* find(const K& key) const {
        const auto index = locate(key);
        return index == slots_.size() ? nullptr : &slots_[index].data->second;
    }
    bool erase(const K& key) {
        const auto index = locate(key);
        if (index == slots_.size()) return false;
        auto& slot = slots_[index];
        slot.data.reset();
        slot.state = State::Deleted;
        --size_;
        ++deleted_;
        return true;
    }

    std::size_t size() const noexcept { return size_; }
    bool empty() const noexcept { return size_ == 0; }
    std::size_t capacity() const noexcept { return slots_.size(); }
    void print(std::ostream& out) const {
        for (std::size_t i = 0; i < slots_.size(); ++i) {
            out << i << ": ";
            const auto& slot = slots_[i];
            if (slot.state == State::Occupied)
                out << slot.data->first << " => " << slot.data->second;
            else
                out << (slot.state == State::Empty ? "EMPTY" : "DELETED");
            out << '\n';
        }
    }
};
} // namespace teaching
ChainedHashTable.h:链地址版本
cpp
#pragma once
#include "HashCommon.h"
#include <memory>
#include <ostream>
#include <utility>
#include <vector>

namespace teaching {
template<class K, class V, class Hash = KeyHash<K>,
         class Equal = std::equal_to<K>>
class ChainedHashTable {
    struct Node {
        std::pair<const K, V> data;
        std::size_t hash_code;
        Node* next = nullptr;
        Node(const K& key, const V& value, std::size_t code)
            : data(key, value), hash_code(code) {}
    };
    std::vector<Node*> buckets_;
    std::size_t size_ = 0;
    Hash hash_;
    Equal equal_;
    Node* locate(const K& key, std::size_t code) const {
        auto* current = buckets_[code % buckets_.size()];
        while (current) {
            if (current->hash_code == code && equal_(current->data.first, key))
                return current;
            current = current->next;
        }
        return nullptr;
    }
    void rehash(std::size_t capacity) {
        std::vector<Node*> fresh(capacity, nullptr);
        for (auto* head : buckets_) {
            while (head) {
                auto* next = head->next;
                const auto index = head->hash_code % capacity;
                head->next = fresh[index];
                fresh[index] = head;
                head = next;
            }
        }
        buckets_.swap(fresh);
    }

public:
    explicit ChainedHashTable(std::size_t capacity = 11,
                              Hash hash = Hash{}, Equal equal = Equal{})
        : buckets_(next_capacity(capacity), nullptr),
          hash_(std::move(hash)), equal_(std::move(equal)) {}

    ChainedHashTable(const ChainedHashTable&) = delete;
    ChainedHashTable& operator=(const ChainedHashTable&) = delete;
    ChainedHashTable(ChainedHashTable&&) = delete;
    ChainedHashTable& operator=(ChainedHashTable&&) = delete;
    bool insert(const K& key, const V& value) {
        const auto code = hash_(key);
        if (locate(key, code)) return false;
        auto pending = std::make_unique<Node>(key, value, code);
        // 将负载因子的阈值设为 1,插入后超过阈值才需扩容。
        if (size_ >= buckets_.size())
            rehash(next_capacity(buckets_.size() + 1));
        const auto index = code % buckets_.size();
        pending->next = buckets_[index];
        buckets_[index] = pending.release();
        ++size_;
        return true;
    }

    V* find(const K& key) {
        auto* node = locate(key, hash_(key));
        return node ? &node->data.second : nullptr;
    }
    const V* find(const K& key) const {
        auto* node = locate(key, hash_(key));
        return node ? &node->data.second : nullptr;
    }
    bool erase(const K& key) {
        const auto code = hash_(key);
        const auto index = code % buckets_.size();
        Node* previous = nullptr;
        auto* current = buckets_[index];
        while (current) {
            if (current->hash_code == code && equal_(current->data.first, key)) {
                if (previous) previous->next = current->next;
                else buckets_[index] = current->next;
                delete current;
                --size_;
                return true;
            }
            previous = current;
            current = current->next;
        }
        return false;
    }
    ~ChainedHashTable() {
        for (auto* head : buckets_) {
            while (head) {
                auto* next = head->next;
                delete head;
                head = next;
            }
        }
    }

    std::size_t size() const noexcept { return size_; }
    bool empty() const noexcept { return size_ == 0; }
    std::size_t capacity() const noexcept { return buckets_.size(); }
    void print(std::ostream& out) const {
        for (std::size_t i = 0; i < buckets_.size(); ++i) {
            out << i << ": ";
            for (auto* p = buckets_[i]; p; p = p->next)
                out << '[' << p->data.first << " => " << p->data.second << "] -> ";
            out << "nullptr\n";
        }
    }
};
} // namespace teaching
6.2 插入、查找、修改与删除示例
下面的程序用同一套操作测试两种结构。重复插入 pear 不会把原来的值改为 99;随后通过 find 修改原值,再删除并重新插入 apple。
cpp
#include "LinearHashTable.h"
#include "ChainedHashTable.h"
#include <iostream>
#include <string>

template<class Table>
void demonstrate(const char* name) {
    Table table;
    table.insert("apple", 3);
    table.insert("pear", 5);
    table.insert("orange", 2);
    std::cout << name << '\n';
    std::cout << "duplicate inserted: " << table.insert("pear", 99) << '\n';
    if (auto* count = table.find("pear")) ++*count;
    table.erase("apple");
    table.insert("apple", 8);
    std::cout << "pear count: " << *table.find("pear") << '\n';
    std::cout << "missing found: " << (table.find("banana") != nullptr) << '\n';
    std::cout << "size: " << table.size() << '\n';
    table.print(std::cout);
}
int main() {
    demonstrate<teaching::LinearHashTable<std::string, int>>("linear");
    demonstrate<teaching::ChainedHashTable<std::string, int>>("chained");
}
编译与运行:
bash
g++ -std=c++17 -O2 -Wall -Wextra -pedantic demo.cpp -o demo
./demo
两种版本都应得到以下关键结果:
text
duplicate inserted: 0
pear count: 6
missing found: 0
size: 3
后续 print 输出展示各自的底层布局。线性探测版本打印每个槽位的状态;链地址版本打印各桶中的链表。对于一般输入,两套结构的遍历顺序不必相同。
6.3 容易遗漏的边界情况
只验证"插入后能够找到"还不够。冲突处理、删除和扩容相互影响,更值得检查以下情况:
- 多个关键字的哈希值完全相同,能否全部插入并分别找到。
- 探测经过数组末尾,能否正确回到开头。
- 删除探测序列前方的元素后,后面的元素是否仍然可达。
- 删除位置后面已经存在相同关键字时,插入是否正确拒绝重复。
- 扩容后所有旧元素的值是否保持不变。
- 反复插入、删除后,不存在的关键字能否及时返回。
- 链地址版本能否正确删除链表头部、中间和末尾节点。
- 析构后节点及键值对象是否得到释放。
配套测试使用 std::unordered_map 对照了两种实现的插入、查找、修改和删除结果,普通哈希与所有关键字集中冲突两种输入合计进行了 12 万次随机操作。同时单独检查了循环探测、重复键、删除后重插、字符串键和对象生命周期。
这些验证覆盖了本文实现的主要行为;本文没有实现迭代器、分配器定制、并发访问等标准容器的完整功能。
6.4 如何理解哈希表的复杂度
在哈希分布合理、负载因子受到控制的条件下,查找、插入和删除通常可以获得期望常数级效率。链地址法的期望查找代价可写成 O ( 1 + α ) O(1+\alpha) O(1+α);线性探测则还受到连续聚集和删除标记的影响。
一次扩容需要处理现有元素,并初始化新的数组或桶。由于容量按近似倍增的阶梯增长,扩容成本可以摊到多次插入上。不过,开放定址重新插入大量集中冲突的元素时,本身也可能需要很多探测;"重新散列为线性时间"的常见分析同样依赖合理分布。
如果大量关键字集中到同一位置,单次查找、插入或删除都可能退化为 O ( N ) O(N) O(N)。因此,哈希表的常数级效率是有条件的平均或期望表现,不能当成任意输入下的最坏情况保证。
以上分析还通常把哈希与比较视为常数开销。对于长度为 L L L 的字符串,计算哈希本身需要读取字符,代价还应计入 O ( L ) O(L) O(L)。
总结
理解哈希表,可以沿着一条完整的操作路径来梳理:先将关键字转换为哈希值,再映射到数组位置;发生冲突后,根据探测序列或桶内链表继续查找;元素增多或删除标记积累时,再通过重新散列调整存储结构。
开放定址法把元素集中存放在数组中,需要重点维护探测路径、删除状态和负载因子。链地址法通过节点链表容纳冲突,需要重点处理链表连接、节点释放和扩容时的重新分桶。
两种方式都依赖稳定的哈希规则和正确的关键字比较。把查找、插入、删除以及扩容之间的关系理清楚,才能写出在冲突和边界情况下仍然正确工作的哈希表。