文章目录
- 查询表中的索引及其相关信息
- [alter 修改表结构](#alter 修改表结构)
-
- [新增列 add](#新增列 add)
- [删除列 drop](#删除列 drop)
- [修改已有列 modify](#修改已有列 modify)
- [重命名 change](#重命名 change)
- 普通索引的使用
- 创建复合索引
- 删除索引
- [explain 关键字](#explain 关键字)
查询表中的索引及其相关信息
sql
-- 两种写法都可以:
show index from 表名;
show keys from 表名;
截取部分列:
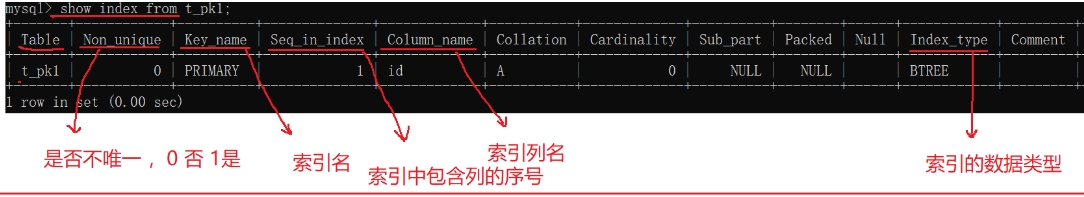
可以看到改表中有一个索引,索引名Key_name为 PRIMARY
Table:来着哪个表Non_unique:是否唯一。0表示否,也就是没有唯一约束;1表示有唯一约束;Key_name:索引名,可手动指定,默认为加索引那一列的列名(主键索引默认为PRIMARY)Index_type:索引数据类型
alter 修改表结构
alter table 可以用来修改已经存在的表结构:
sql
alter table 表名 操作;新增列 add
add 新增列:
sql
-- 在表最后追加一列
alter table student add age int;
-- 指定放在 name 这一列后面
alter table student add age int after name;
-- 加到第一列
alter table student add age int first;
使用 add 能够给已有字段增加主键以及各类约束:
增加主键:
sql
alter table student add primary key (id);增加唯一约束:
sql
alter table student add unique (phone);为字段增添普通索引:
sql
alter table student add index (name);增加外键约束:
sql
alter table 子表名 add foreign key (外键字段) references 主表(主键);删除列 drop
sql
alter table student drop column age;
-- 可以省略 column:
alter table student drop age;
修改已有列 modify
修改列的类型、约束,不改列名:
sql
alter table student modify age tinyint;
alter table student modify name varchar(50) not null;
注意:modify 只能干两件事
①:设置列上not null和default这两个属性
②:修改列的数据类型
modify 不能用来新增主键、唯一、外键,也不能新增索引
- 且执行 modify 会重写列的全部定义,原来写过的约束如果这次不写上,就会丢失,modify 是重新定义整列,不是"只修改你写的那一项"。
- 但是modify 只会覆盖该列所有列级属性,不会移除表级约束:主键、外键,比如使用modify id ... ,id的其他属性会被此次的修改覆盖掉,但如果它原来是主键,之后依然会是主键
重命名 change
change 既可以改列名,也可以顺带改类型
sql
-- 旧列名  新列名  新的数据类型
alter table student change age stu_age int;
重命名整张表:
sql
-- 两种写法都可以:
alter table student rename to stu;
alter table student rename stu;
普通索引的使用
普通索引的创建的时机:
- 创建表的时候,明确知道某些列会频繁查询,就创建好 (不过其实当表中数据过少的时候,全表扫描可能效率还比索引更高)
- 随着业务的不断发展,在版本迭代的过程中添加索引
随表创建索引:
sql
create table 表名(
sno varchar(20),
-- 字段...
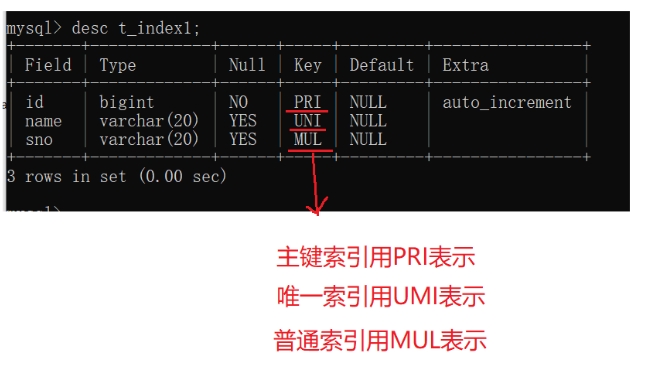
index(sno) -- 为字段sno加上普通索引,索引名字默认为字段名sno
);
表外使用 create 创建索引,并指定索引名(推荐使用):
sql
-- 在student表中为son创建索引:
create index 索引名 on student(sno);- 索引名命名规范建议:
idx_表名_字段名,这样以便于在使用过程中更容易查找到索引,如:idx_student_sno
创建复合索引
创建语法与创建普通索引相同,只不过指定多个列,列与列之间用逗号隔开
随表创建:
sql
create table student(
name varchar(30),
sno varchar(20),
index(sno,name)
);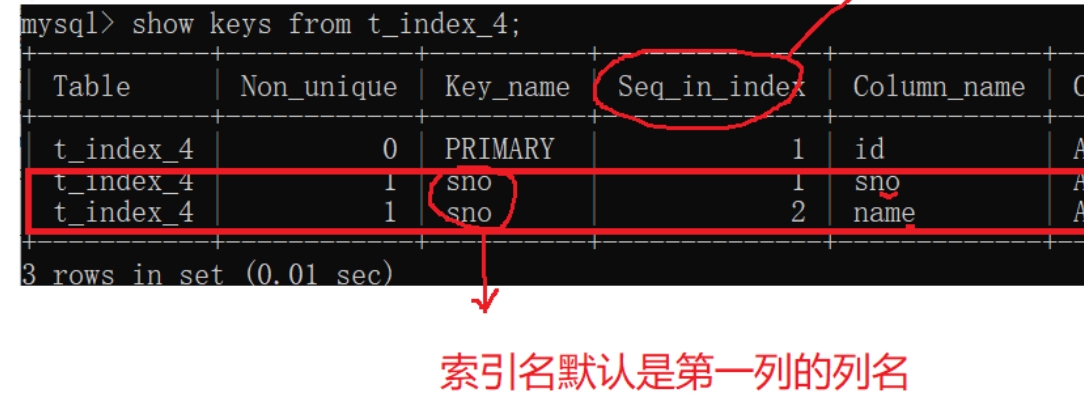
- 创建复合索引之后就可以解释
Seq_in_index和Column_name之间的关系了,可以看到他们的索引名都是sno,因为复合索引名默认使用所包含的第一个列的列名。Column_name 是索引中包含的列,前面的Seq_in_index 是该列在索引中的序号,所以sno为1,name为2
表外创建复合索引并指定索引名:
sql
create index idx_student_sno_name on student(sno, name);删除索引
删除主键索引,也不用写索引名了,直接删除:
sql
alter table 表名 drop primary key;- 删除主键前,如果主键是自增列,必须先去掉 auto_increment ,否则无法删除主键。
- 因为 auto_increment 必须依附主键(唯一且非空)。必须先用 modify 把自增属性去掉,再删主键。
删除其他索引:
sql
alter table 表名 drop index 索引名;explain 关键字
explain 放在 select 查询语句前面,用来查看一条查询语句的执行计划,看 MySQL 有没有用上索引。
使用explain会查出来一张表:
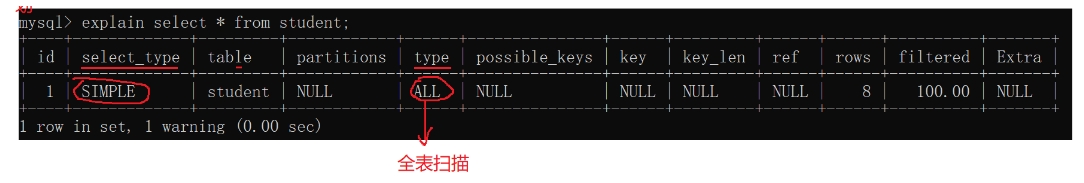
- id
查询的编号,代表执行顺序
- 相同 id,从上往下执行
- 不同 id,id 大的优先执行
- select_type (了解)
常见: simple :简单查询,没有子查询、没有 union
- table
这一行数据来自哪一张表
- type(重点)
访问类型,性能从好到差排序:
system > const > eq_ref > ref > range > index > all
- const(常量级别查询):根据主键 / 唯一索引 匹配一行,速度极快
- ref :普通索引,匹配多行
- range :范围查找, between 、 > 、 <
- index :遍历整个索引树
- all :全表扫描(最坏,尽量避免)
- possible_keys
理论上可能会用到哪些索引
- key
实际被 MySQL 选中使用的索引
如果这里是 null :没有使用任何索引
- key_len
索引占用字节长度,可以判断复合索引用到了前面几列
- ref
和索引进行等值匹配的对象
- rows
MySQL 预估要扫描多少行,数字越小越好
- Extra
额外信息 :
- using index :覆盖索引,很好,不需要回表
- using where :存储引擎把数据读出来之后,MySQL 服务层再用 where 条件过滤。