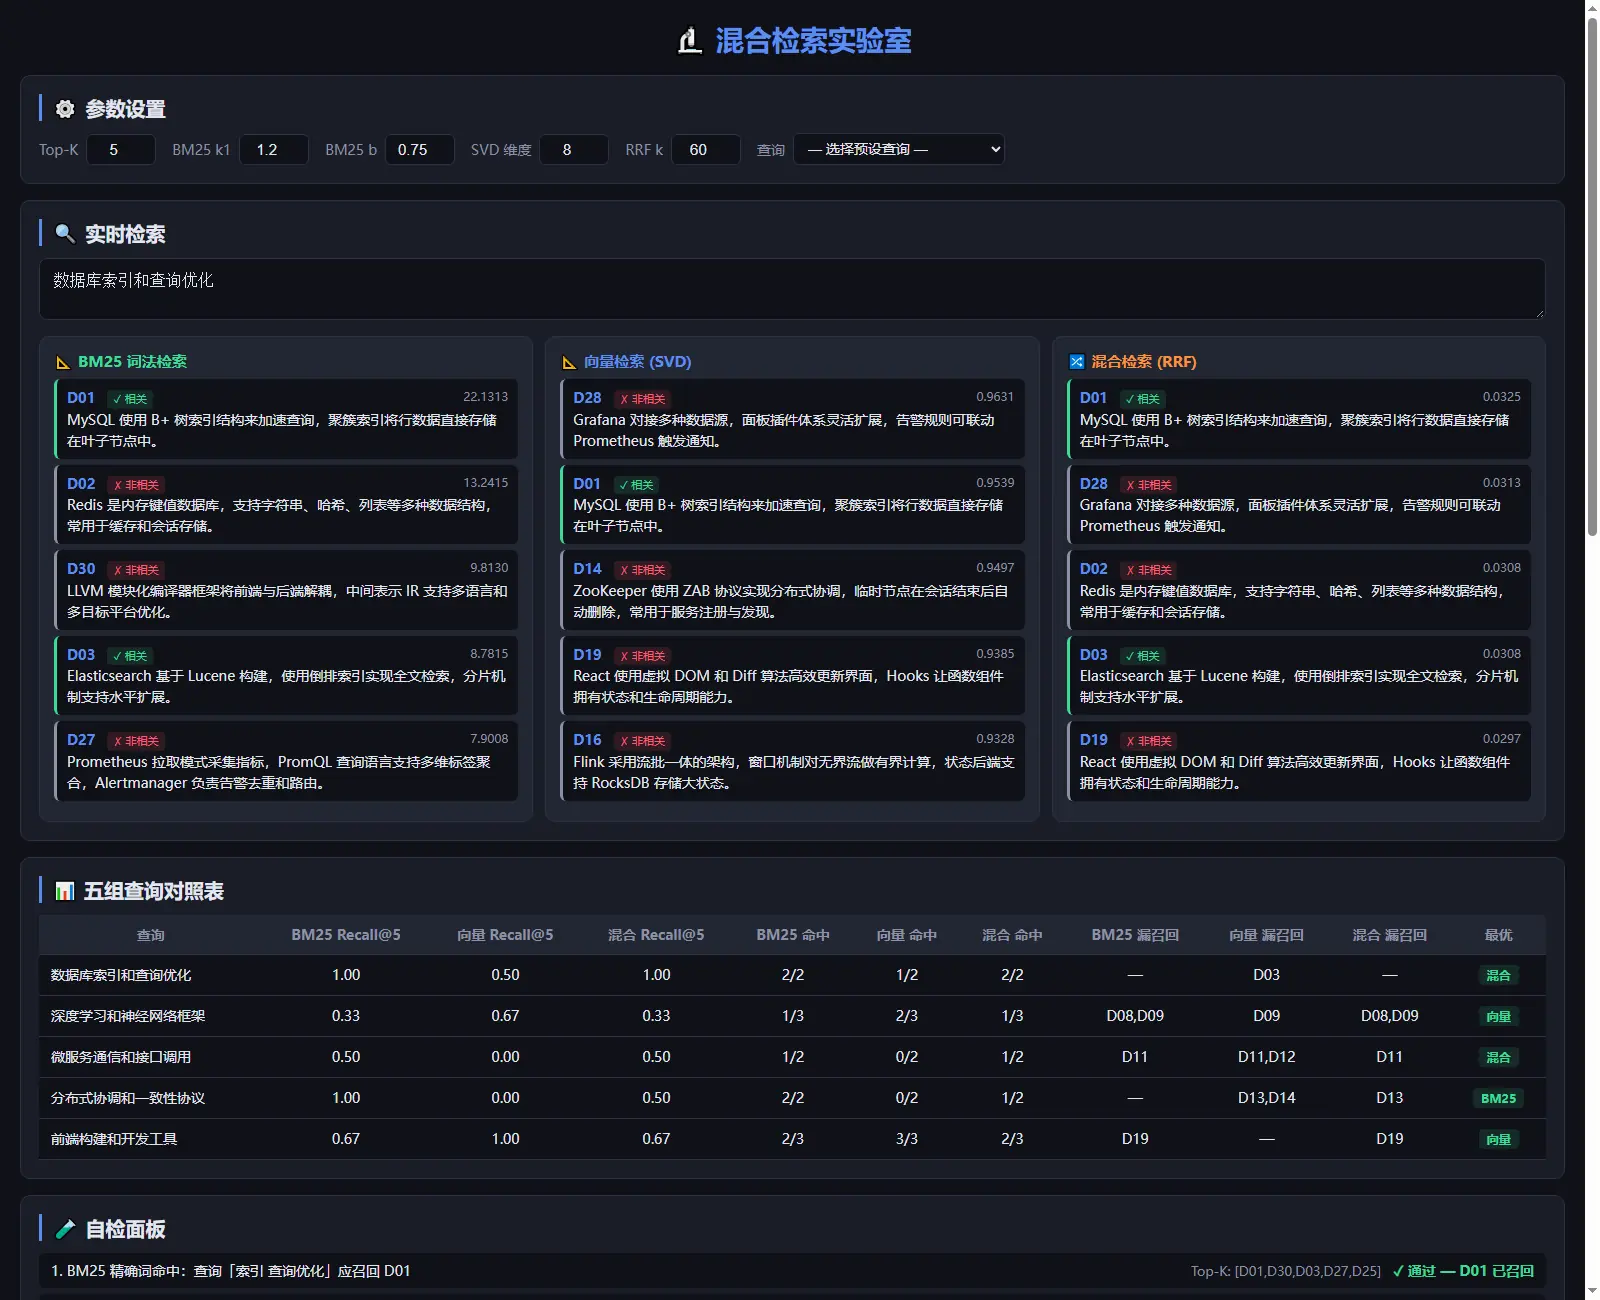
先给结论:能补回来一部分,但补不全。
「微服务通信和接口调用」这组,纯向量检索 Top-5 一篇相关文档都没捞到,recall 是 0.00。
两路排名融合之后补回了 D12,recall 变成 0.50,D11 还是没进来。
「数据库索引和查询优化」那组,纯向量只命中 1/2,融合补回 D03,回到 2/2。
反过来的例子也有。
5 组查询里有 2 组,融合的 recall 低于两路里更强的那一路:「深度学习和神经网络框架」融合 0.33,纯向量单跑 0.67。
这些数字不是我写死的。
页面打开时当场算:30 篇文档、两路候选、RRF 融合、15 条自检。
成品是一个单文件 index.html,双击就能跑,不联网,不引第三方库。
案例目录在这里,下载下来直接打开:
text
https://atomgit.com/deli007/demo_park/tree/main/codearts-hybrid-search-lab为什么把「漏召回」摆到台面上
BM25 这路检索很好解释:一个词只在少数文档里出现,它的 IDF 就高,命中就被顶上去。
向量检索听起来更聪明,它把文档投影到低维空间,按余弦相似度排序。
降维是有代价的,精确的实词特别容易被摊薄。
我自己量过这件事:查询「微服务通信和接口调用」,纯向量给 D16、D14、D08、D25、D07 都打了 0.93 以上的分,人工标注的 D11、D12 一个都没进前五。
D11 在纯向量的完整排名里掉到第 14 位。
于是这个页面要回答的问题就很具体了:把两路排名融合起来,那些被降维挤掉的文档能回来吗。
我做成实验室而不是直接给结论,是因为答案跟语料强相关。
换一批文档、换一个 K,结论都可能变。
三种检索器各干什么
| 检索器 | 排序依据 | 这次用的参数 | 实测里的一句话结论 |
|---|---|---|---|
| BM25 词法 | 词频 + 文档长度归一 + IDF | k1=1.2,b=0.75 | 精确实词的召回最稳,5 组里 4 组是它最高 |
| 向量(SVD) | TF-IDF 矩阵降到 8 维后算余弦相似度 | 维度 8,幂迭代 100 轮 | 对同义说法有反应,但会把实词挤下去 |
| 混合(RRF) | 两路排名倒数相加 | k=60 | 能把向量漏掉的实词文档捞回一部分 |
RRF 那一行的算法叫 Reciprocal Rank Fusion,公式是每个文档把两路里的排名倒数加起来,k 用来压平高位排名的差距。
中文这边我没有用分词库,BM25 走的是单字加双字切分,这样做的好处是不用装依赖,代价是词表偏大。
五组查询逐组看
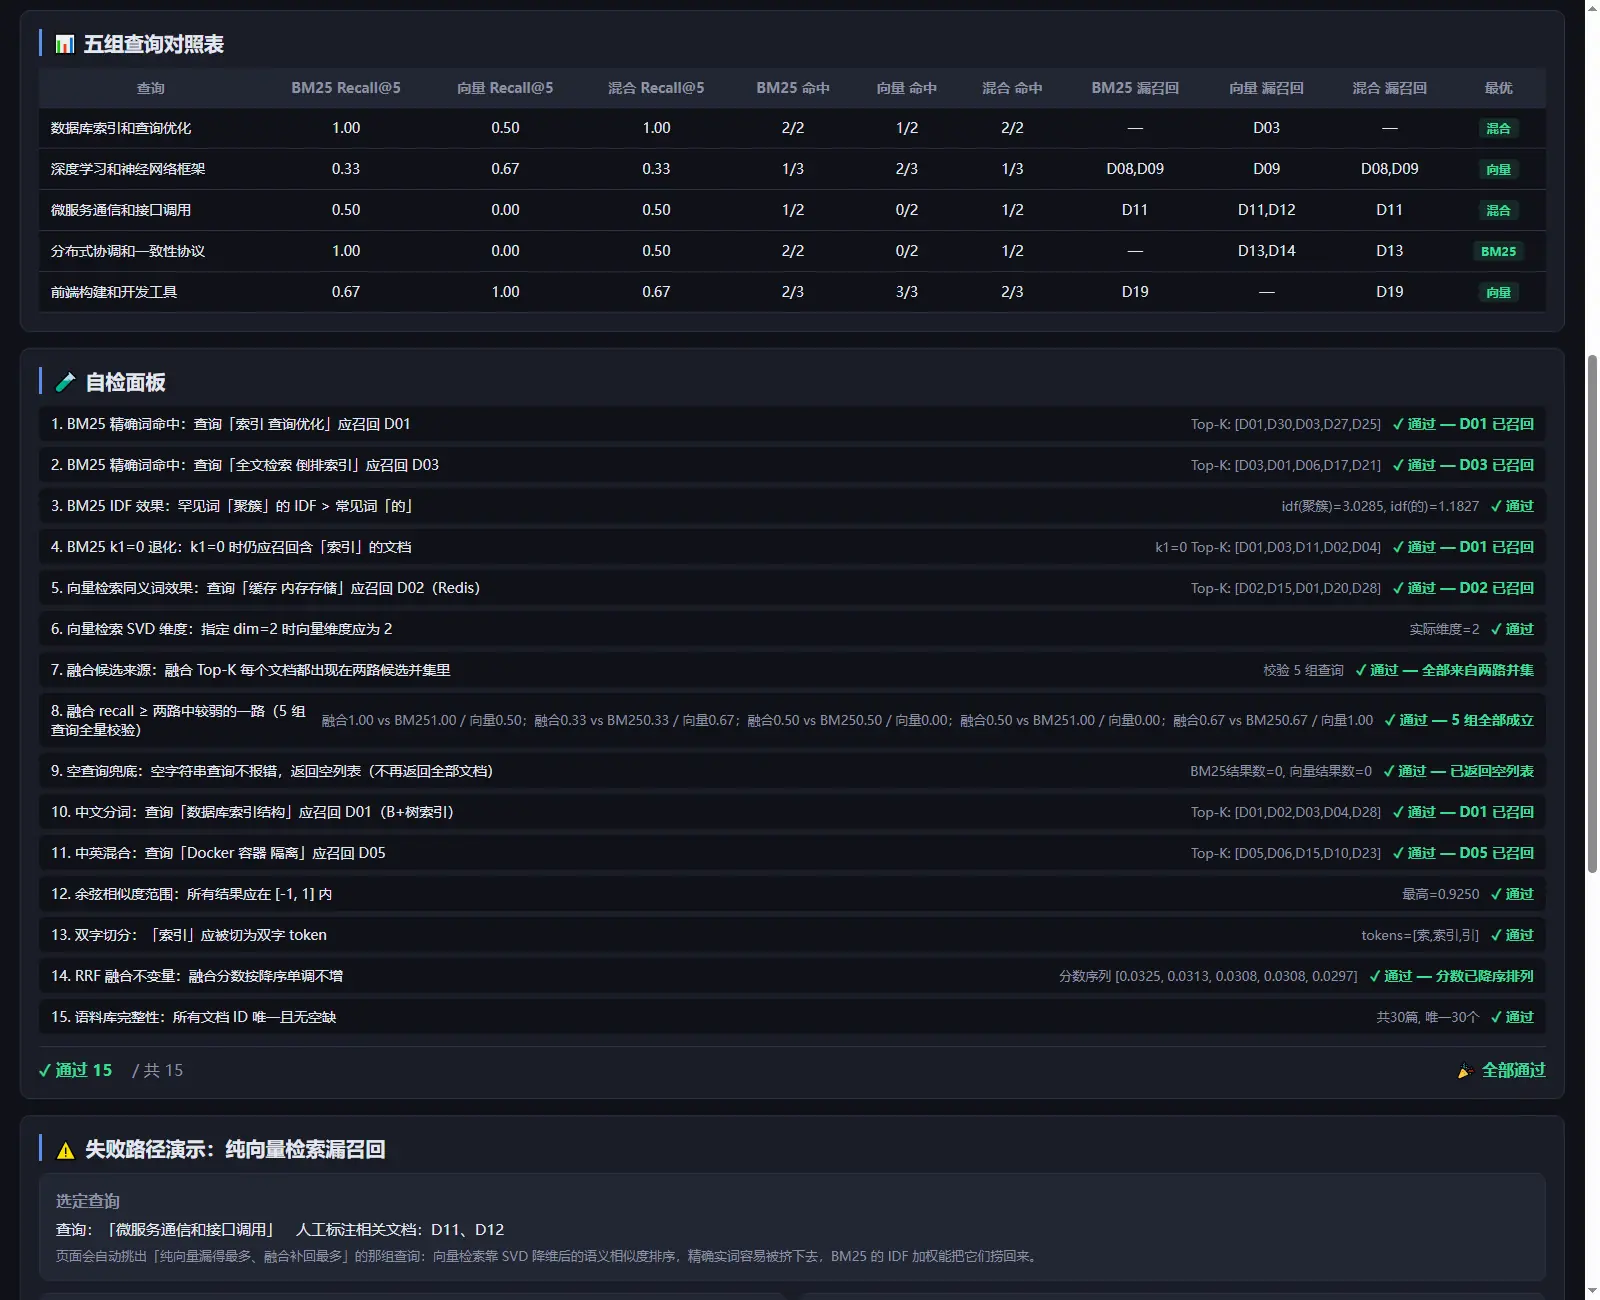
| 查询 | BM25 | 向量 | 融合 | 融合漏掉 | 这一组最优 |
|---|---|---|---|---|---|
| 数据库索引和查询优化 | 1.00 | 0.50 | 1.00 | --- | 混合 |
| 深度学习和神经网络框架 | 0.33 | 0.67 | 0.33 | D08、D09 | 向量 |
| 微服务通信和接口调用 | 0.50 | 0.00 | 0.50 | D11 | 混合 |
| 分布式协调和一致性协议 | 1.00 | 0.00 | 0.50 | D13 | BM25 |
| 前端构建和开发工具 | 0.67 | 1.00 | 0.67 | D19 | 向量 |
这 5 行里,融合拿到 2 次最优,向量 2 次,BM25 1 次。
注意第三列全是 0.00 和 0.50 那种粗粒度,是因为 Top-K 只有 5,每组标注的相关文档只有 2 到 3 篇,一篇就是 0.33 到 0.50。
这也是我不想把话说满的原因:样本太小,粒度太粗。
失败路径:纯向量漏掉的两篇,融合只捞回一篇
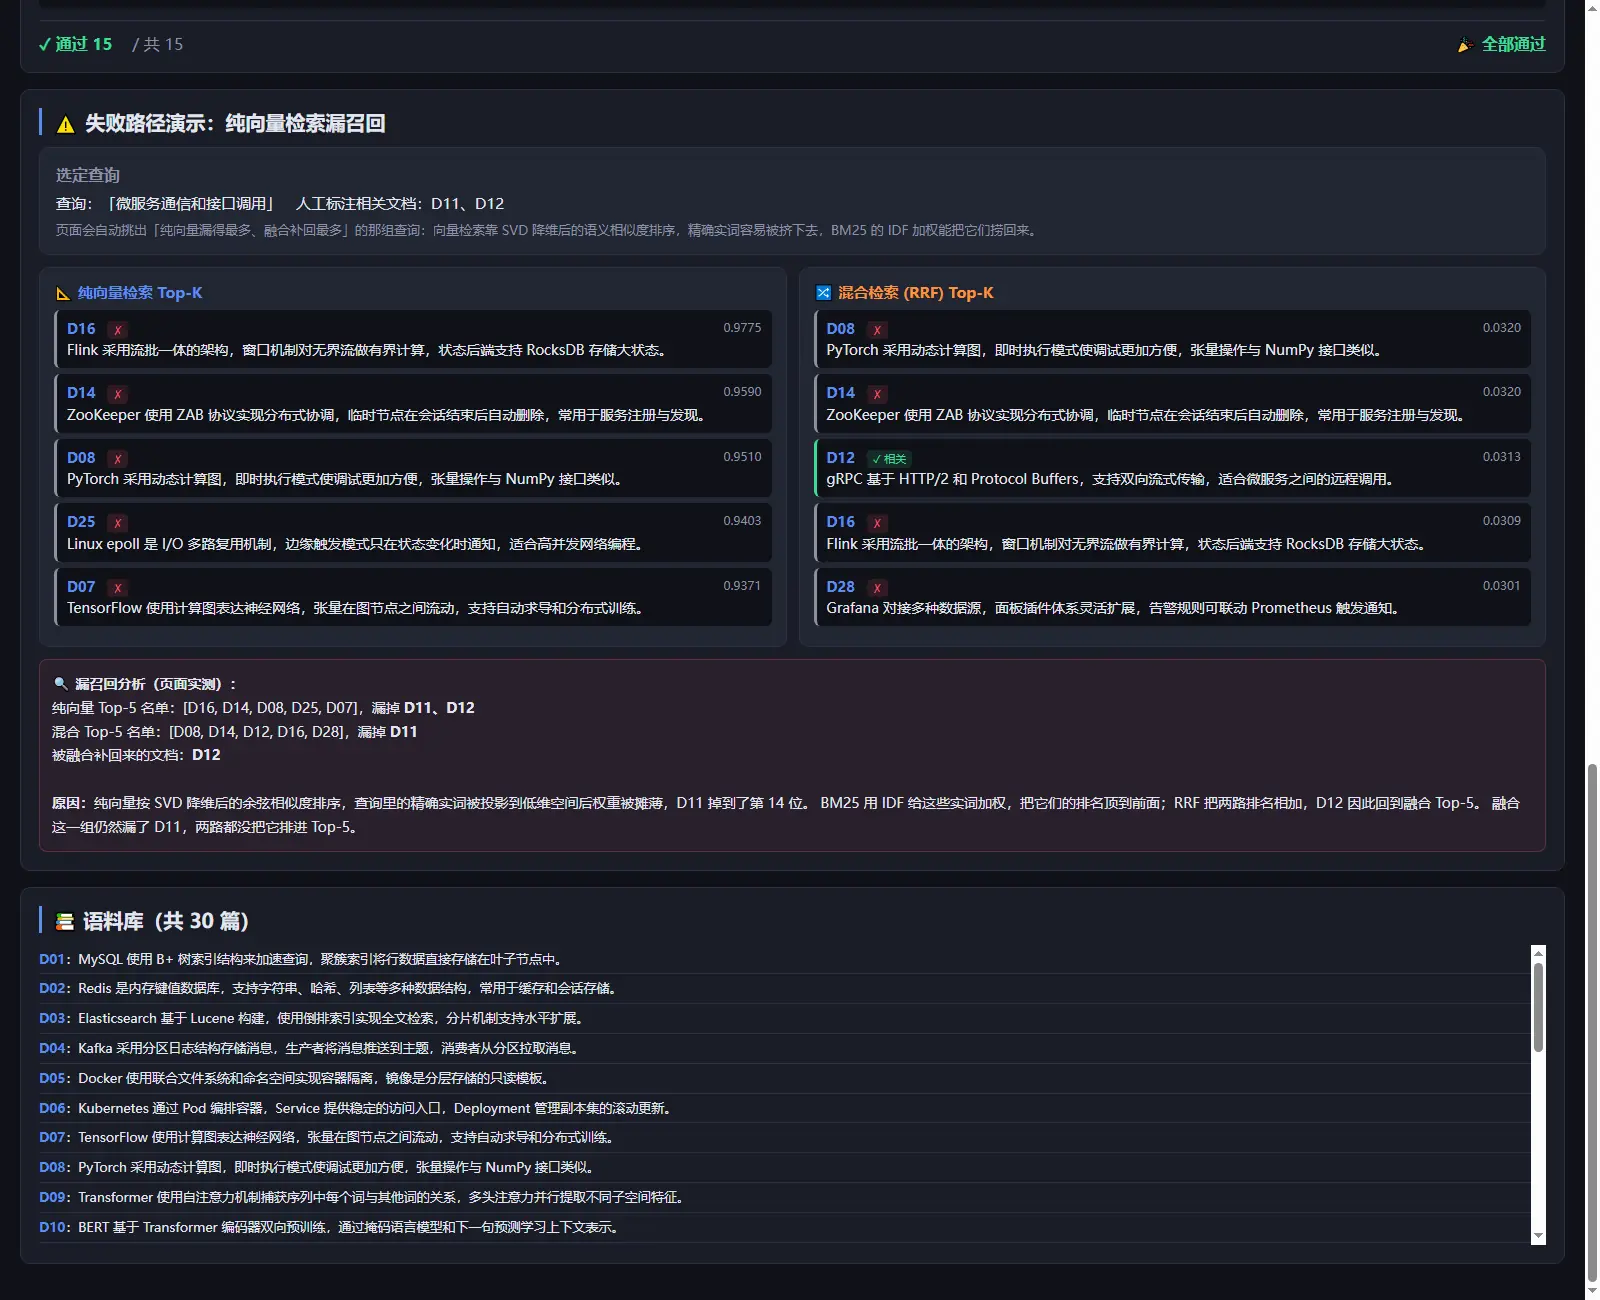
这块我没有写死查询,页面自己挑「纯向量漏得最多、融合补回最多」的那一组。
这次挑中的是「微服务通信和接口调用」,人工标注的相关文档是 D11、D12。
纯向量的 Top-5 是 D16、D14、D08、D25、D07,两篇相关文档全漏。
融合的 Top-5 是 D08、D14、D12、D16、D28,D12 回来了,D11 依然没有。
页面上那行分析文字也是算出来的:D11 掉到第 14 位,两路都没把它排进前五。
捞回一半,这就是这组数据的真实结果。
验证与踩坑:15 条断言,和我改掉的七处
页面底部的自检会把 15 条断言真跑一遍,逐条给出实测值和结论,最后一行是总数。
改之前是 14/15。
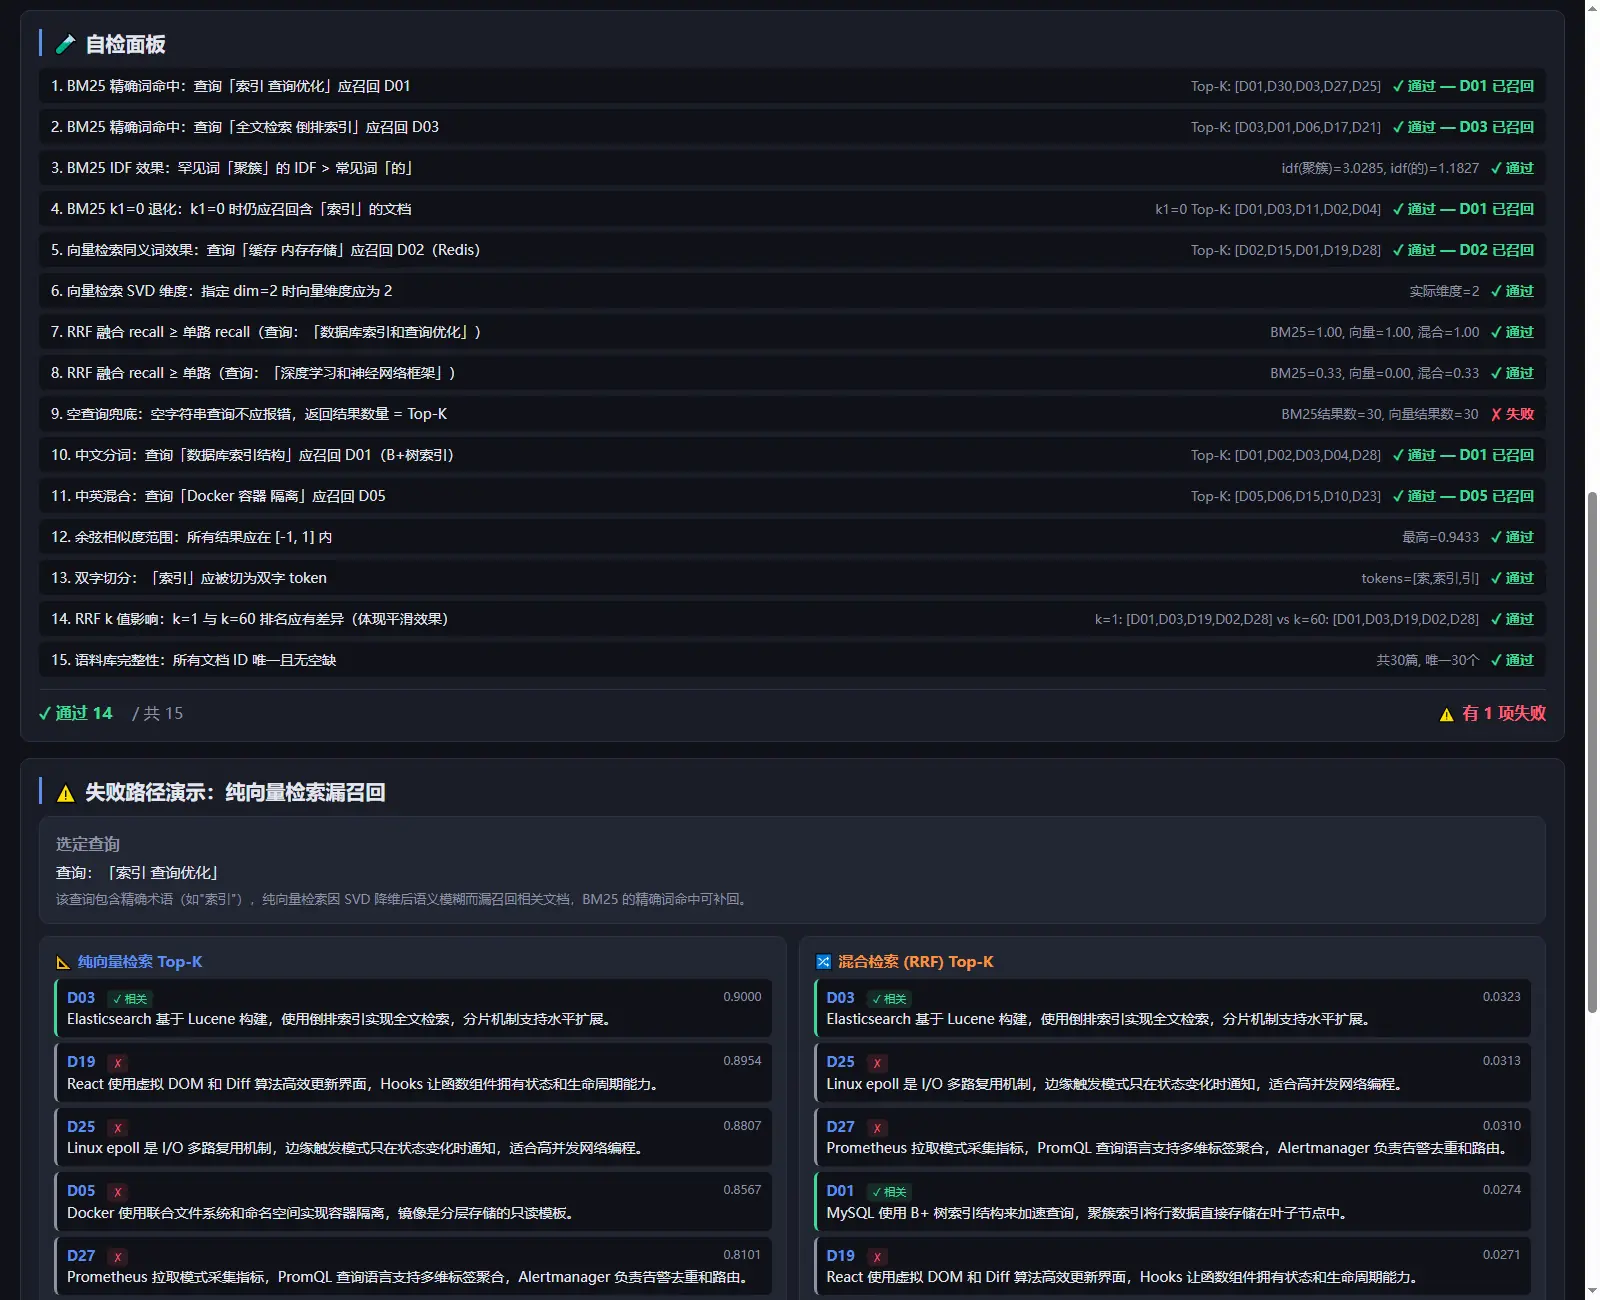
第一处,也是最要紧的一处:空查询会返回整个语料库。
BM25 和向量检索各自都有「查询没切出词」的分支,第一版两个分支都直接返回了全部 30 篇文档。
断言 9 期望的是 Top-K 条,于是当场报红。
改成返回空列表之后,空查询不再吐 30 条噪声,断言也跟着改成「返回空列表」。
第二处:结果不可复现。
幂迭代 SVD 的初始向量用了 Math.random()。
同一份文件两次打开,同一组查询的向量 recall 一次是 0.50,一次是 0.00,我自己都说不清该信哪一次。
修法是把初始向量换成固定种子的线性同余发生器,改完两次刷新结果完全一致。
第三处:融合吃得太少。
第一版把两路的 Top-5 直接丢给 RRF,等于每个候选最多只有两票。
改成用完整排名融合,再把结果切 Top-5,「数据库索引和查询优化」从 0.50 涨到 1.00。
同一处改动也让「前端构建和开发工具」从 1.00 掉到 0.67。
5 组里 1 组涨、1 组跌、3 组不动,平均 0.57 到 0.60,不能算纯赚,两组数字我都留着。
第四处:断言 14 是恒真的。
它的判据写成「两个名单不同,或者两个名单完全相同」,两种情况都通过。
换成一条真能测的不变量:融合分数必须按降序单调不增。
第五处:「最优」那一列只看融合一路。
向量单独更强的时候,那一列显示一个横线,等于把反例藏起来了。
改成三路比较之后,5 组里 2 组的最优是向量,2 组是混合,1 组是 BM25。
第六处:断言 7 和 8 的预期本身就写错了。
第一版写的是「融合 recall ≥ 任一路」。
实测 5 组里有 2 组不成立,这条断言测的是我的愿望,不是代码。
我把它换成两条真能测的:融合候选必须来自两路并集;融合 recall 不低于两路里较弱的一路。
范围写进标题,不写满。
第七处:失败路径那块的分析文字是写死的。
第一版固定查询「索引 查询优化」,正文里也写死了一句「D01 未能进入 Top-K」。
修完之后这个查询两路都能召回,写死的那句话就成了假话。
现在页面自己挑那一组,结论按实测数据拼出来。
自检面板长什么样
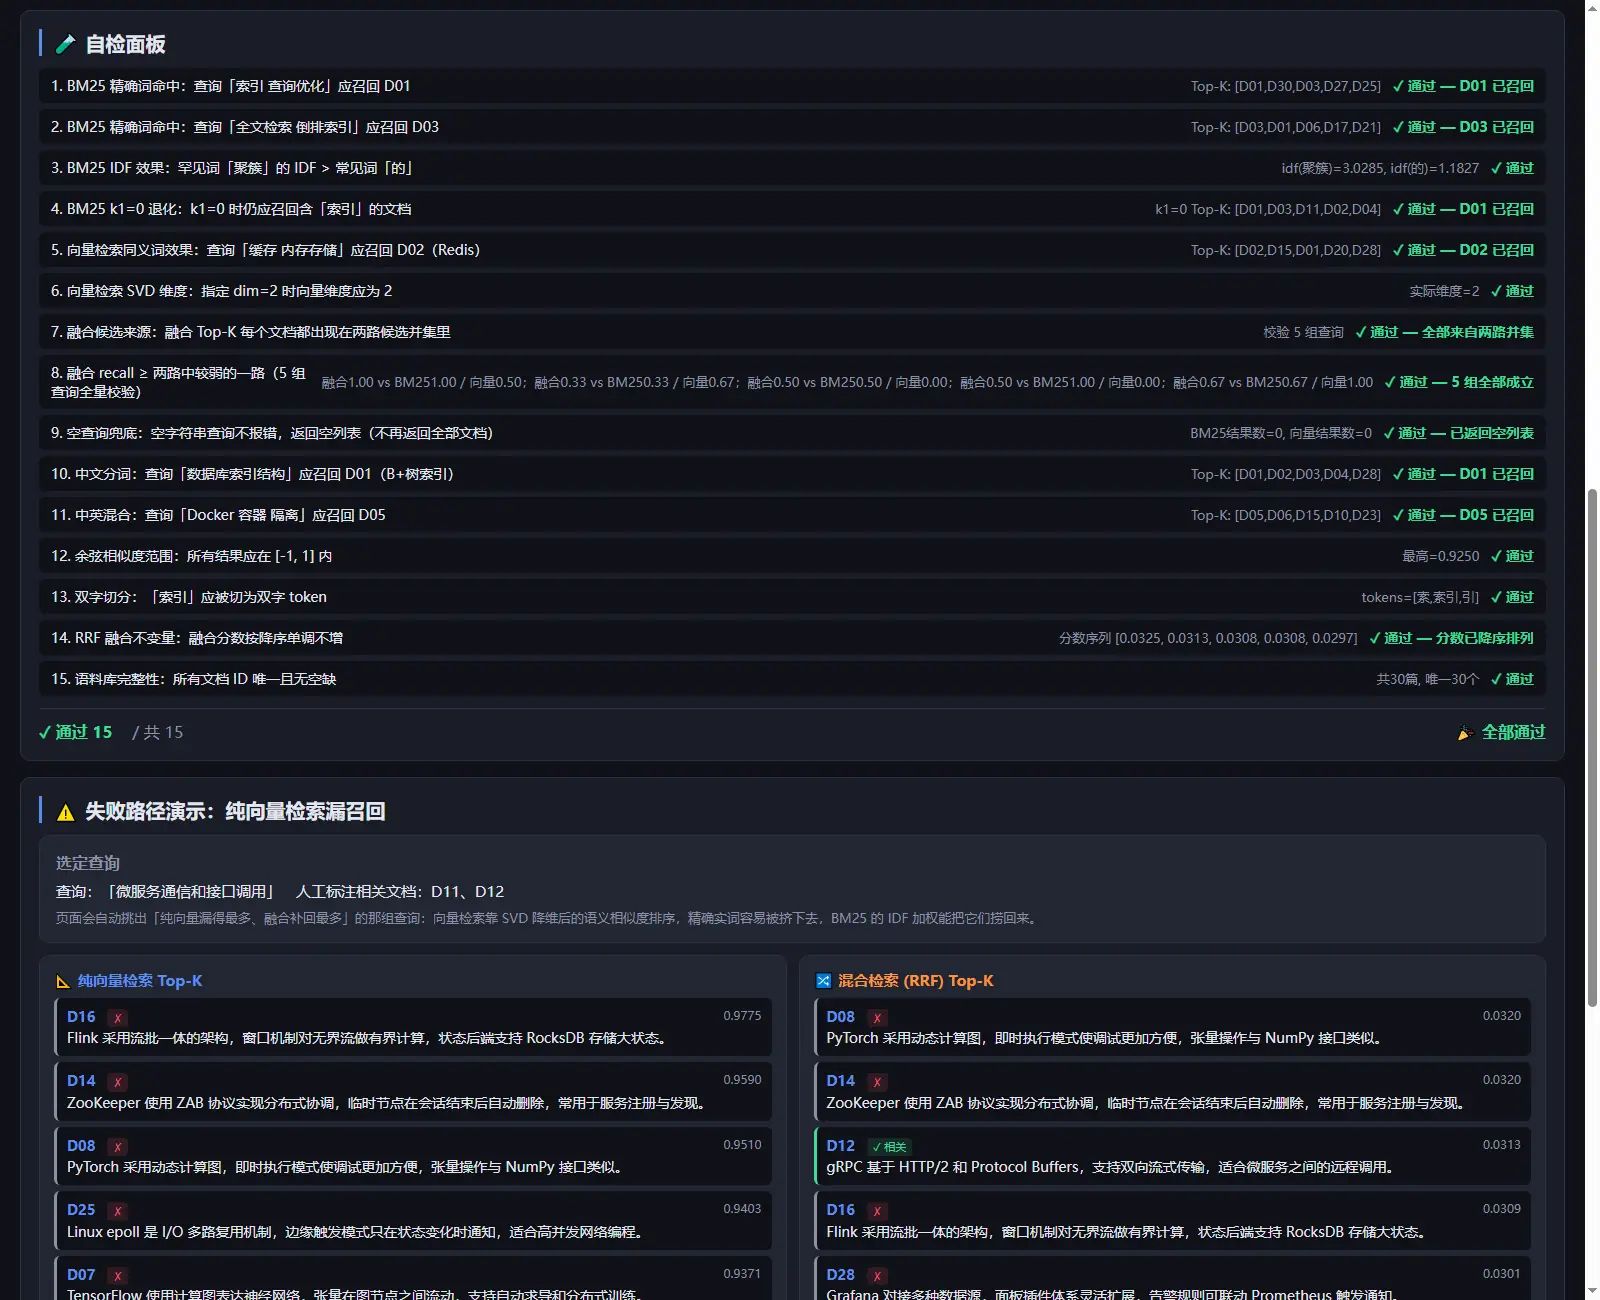
几条我自己会回头看的实测值:
| 断言 | 实测 |
|---|---|
| IDF 效果 | idf(聚簇)=3.0285,idf(的)=1.1827 |
| 空查询兜底 | BM25 结果数 0,向量结果数 0 |
| 融合候选来源 | 校验 5 组查询,全部来自两路并集 |
| 融合分数单调性 | 0.0325、0.0313、0.0308、0.0308、0.0297 |
| 语料库完整性 | 共 30 篇,ID 唯一 30 个 |
改完这些之后,自检是 15/15 通过,跑两遍结果完全一样。
整个页面是纯 JS,没有引任何库,SVD、BM25、RRF 都是自己写的。
本地复现
把案例目录下载下来,随便起一个静态服务就行:
bash
cd codearts-hybrid-search-lab
python -m http.server 8000
然后浏览器打开 http://localhost:8000/index.html 就能看到跟截图一样的页面。
不起服务直接双击 index.html 也可以。
想看修复前的样子,把自检面板那一版翻出来跑一遍就行,断言 9 会红。
准备环境:打开码道 Web 版
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...
登录后在对话框里把需求说清楚就行,不用装软件。
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件),本文用的是 WebUI。
用码道做这个页面的一点体会
我把需求一次说完:三种检索器、语料规模、对照表、自检面板、失败路径演示。
它一次就给了 35.8 KB 的单文件,接的是内置预览,跑起来就能点。
但「能跑」和「对」是两件事。
上面那七处,没有一处是读代码读出来的,全靠自检和两次复现的对比抓出来。
我自己的结论只有一句:让 AI 写代码,验收这一半得自己扛。
边界,我写清楚
语料只有 30 篇,ground truth 是我手标的,5 组查询的样本量很小。
向量那一路是幂迭代 SVD 的近似降维,不是真的 embedding 模型,同义词效果有限。
Top-5 的粒度太粗,一篇文档就是 0.33,别拿这里的小数点当精度。
融合不保证优于任何单路,这份数据里就有 2 组反例。
断言里的期望值是我写的,它只能证明代码算出了我预期的东西,证明不了我的预期是对的。