截止目前,YOLO26最新创新改进系列已更新110+种,排列组合后可达到上万种创新模型!极大节省科研时间!!! 仍在持续更新中...
畅享持续更新且可大幅度提升文章档次的纯干货工具!
YOLO26 改进:融合 LW-DETR 思想的轻量 TokenMixer,让 Neck 从局部堆叠走向局部-全局协同!嘎嘎创新!
前言:为什么这个改进值得写
很多 YOLO 改进文章的问题不在于模块不够新,而在于"痛点没有扣住"。如果只是把一个模块塞进网络,再写几句"提升精度、降低参数",读者很难判断它为什么合理,论文审稿人也会质疑它是不是机械堆模块。
本次改进的切入点不是某个本地数据集,也不是某个训练技巧,而是原始 YOLO26 Neck 融合结构自身的瓶颈:在 P5 高层语义上采样并与 P4 中层特征拼接后,原模型使用 C3k2 进行融合。C3k2 的优势是成熟稳定、局部卷积表达强,但在这个融合节点上也存在三个结构性不足。
第一,拼接后的特征同时包含 P5 的高级语义和 P4 的空间细节,单纯依赖局部卷积瓶颈堆叠,容易把跨区域上下文选择交给后续层被动完成。第二,C3k2 通过 CSP 分支和 C3k/Bottleneck 堆叠增强局部特征,表达能力强,但对轻量化部署并不总是最优。第三,P4/16 是小目标与中尺度目标定位、背景抑制、语义校准共同发生的关键尺度,如果这里缺少显式全局门控,复杂场景中容易出现局部纹理强、全局语义弱的问题。
因此,本次改进将原始第 13 层:
yaml
- [-1, 2, C3k2, [512, True]]替换为:
yaml
- [-1, 1, LWDETRTokenMixer, [512, 7, 4]]它并不是把完整 LW-DETR 检测器搬进 YOLO,而是借鉴 LW-DETR 中"局部窗口与全局建模交替"的轻量思想,在 YOLO26 Neck 的关键融合节点落地为一个卷积化 Token Mixer:用 7×7 深度卷积负责局部空间混合,用全局池化门控负责图像级语义筛选,再通过逐点卷积输出融合后的特征。
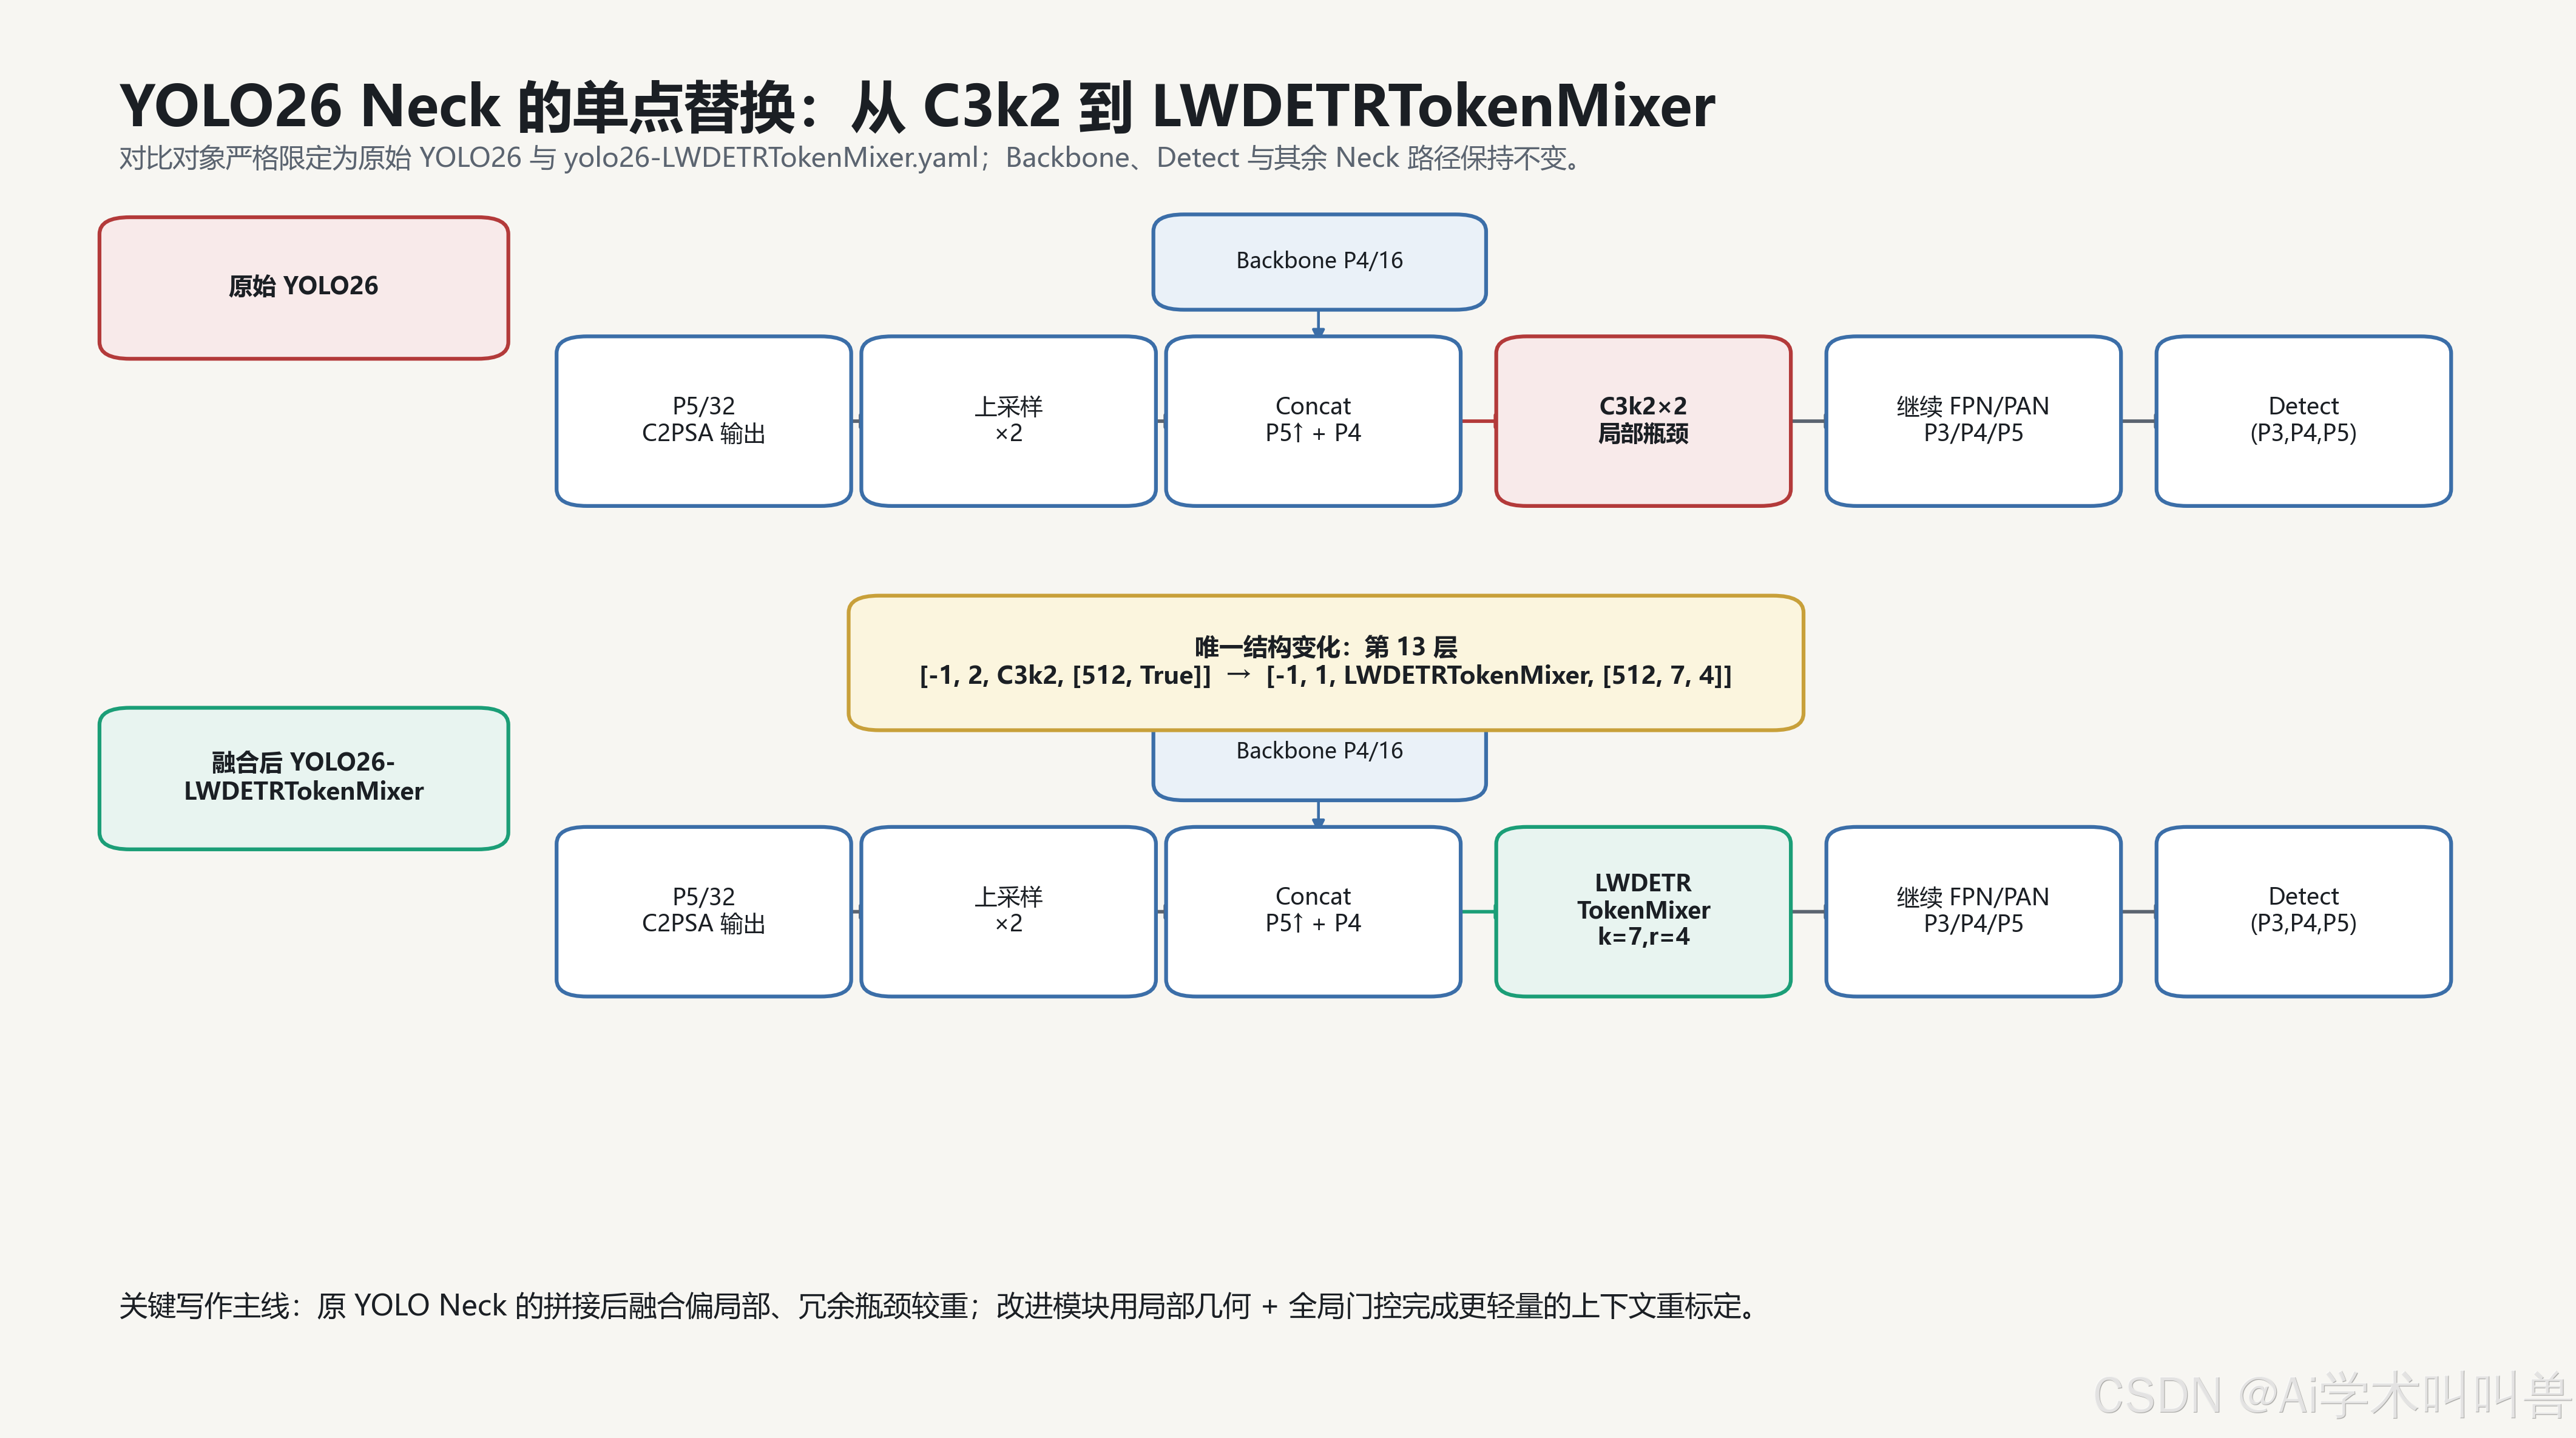
这类改进的论文价值在于:它不是泛泛地"加注意力",而是在 Neck 中语义与细节冲突最明显的位置,引入局部几何建模和全局语义重标定的耦合机制。痛点来自原始 YOLO 融合结构本身,叙述自然,创新点也更容易写清楚。
1. 原文信息、摘要译述与介绍总结
1.1 原文链接
论文题目:LW-DETR: A Transformer Replacement to YOLO for Real-Time Detection
arXiv 链接:https://arxiv.org/abs/2406.03459
需要注意的是,本文的 LWDETRTokenMixer 是 受 LW-DETR 思想启发的轻量化 Neck Token Mixer,进行YOLO适配改进,它不等同于原论文中的完整 ViT encoder + projector + shallow DETR decoder 架构。本文所有结构解释以当前仓库代码为准。
1.2 摘要译述
LW-DETR 论文提出了一种轻量级检测 Transformer,目标是在实时目标检测中挑战甚至替代传统 YOLO 系列检测器。其整体结构由 ViT 编码器、连接用的投影器以及浅层 DETR 解码器组成。为了让 Transformer 检测器具备实时性,作者引入了多项有效训练和高效推理技术,包括改进损失、预训练策略,以及在 ViT 编码器中采用局部窗口注意力与全局注意力交替的方式降低复杂度。
论文还强调,通过聚合多层特征以及编码器中间层与最终层特征,可以形成更丰富的表示;同时采用 window-major 的特征组织方式,可以降低交替注意力计算中的特征重排成本。整体思想可以概括为:在保持实时性的前提下,让模型具备更强的全局建模能力和更高效的特征组织方式。
1.3 Introduction 总结提炼
原文引言的逻辑非常适合迁移到 YOLO 改进写作中。它先指出实时目标检测长期由卷积检测器主导,YOLO 系列代表了速度与精度之间的成熟折中;随后指出 DETR 类方法虽然在全局建模和端到端检测上具有潜力,但实时检测场景下仍然存在计算复杂度、结构设计和推理效率的问题。
LW-DETR 的解决思路可以提炼为三点:
| 论文中的问题 | LW-DETR 的原始解决思路 | 本文在 YOLO26 中的对应落点 |
|---|---|---|
| 全局注意力计算代价高 | 局部窗口注意力与全局注意力交替 | 用 7×7 DWConv 表示局部窗口混合,用 GAP 门控表示全局语义选择 |
| 单层输出特征表达不足 | 聚合多层与中间层特征 | 放在 P5 上采样与 P4 拼接后的融合节点 |
| 特征重排和推理效率受限 | window-major 组织减少重排 | 使用卷积化 Token Mixer,避免完整 Transformer 注意力开销 |
因此,本文不是照搬 DETR,而是抽取其中最适合 YOLO Neck 的核心思想:在实时检测网络中,把局部空间交互和全局上下文选择以更轻的方式耦合起来。
2. 为什么要融合:创新切入点
YOLO26 的 Neck 本质上承担两类任务:一类是把深层语义向浅层传递,另一类是把浅层定位细节向深层回流。第 13 层位于第一次 top-down 融合之后,输入来自:
text
P5/32 高层语义特征 → 上采样 ×2
P4/16 主干中层特征 → Concat
此时特征既包含语义抽象,也包含纹理边界。原始 C3k2 可以继续增强局部表达,但它的核心仍然是卷积瓶颈堆叠。对于复杂背景、尺度变化、遮挡目标或密集目标,仅靠局部卷积逐层传播上下文,往往需要更多层数才能形成有效的全局筛选。
LWDETRTokenMixer 的融合价值就在这里:它把 P4 融合节点从"拼接后局部卷积增强"改为"局部空间混合 + 全局通道门控"的双分支重标定。
从论文写作角度,这个创新切入点有三个优点:
| 切入点 | 原始问题 | 改进后的表达 |
|---|---|---|
| 融合节点明确 | 不是随意插入模块,而是针对 P5→P4 的关键语义融合点 | 控制变量清晰,只替换第 13 层 |
| 机制可解释 | 原始 C3k2 偏局部卷积堆叠 | DWConv 负责局部几何,GAP Gate 负责全局语义 |
| 轻量化自然 | 完整 Transformer 注意力不适合直接塞入 Neck | 卷积化 Token Mixer 保留局部/全局思想,同时控制计算量 |
这正是适合写进论文的逻辑:不是为了堆新模块,而是为了解决 YOLO Neck 在跨尺度融合时局部建模强、全局校准弱的结构性矛盾。
3. 改进模块核心结构与原理对比
3.1 改进前:原始 C3k2 融合结构
在原始 yolo26.yaml 中,第 13 层为:
yaml
- [-1, 2, C3k2, [512, True]]结合 parse_model 的解析逻辑,C3k2 属于带重复次数的基础模块。其结构继承自 C2f,核心过程可以概括为:
- 输入特征
X经过 1×1 卷积生成两组隐藏特征; - 一支进入 Bottleneck 或 C3k 分支进行局部卷积增强;
- 另一支作为 CSP 旁路保留原始信息;
- 多分支特征拼接;
- 再通过 1×1 卷积输出。
公式化表示为:
text
C_h = e · C_o
U = Conv1×1(X),  U → [y0, y1]
y_i = B_i(y_{i-1}),  i = 1, ..., n
Y = Conv1×1(Concat(y0, y1, ..., y_n))
其中 B_i 在该位置对应 C3k 局部瓶颈结构,C3k 内部继续使用 3×3 Bottleneck。它的优势是稳定、卷积归纳偏置强,对局部纹理、边缘和短程空间关系友好;不足是全局上下文选择不是显式建模的,而是依赖层间传播逐步形成。
3.2 改进后:LWDETRTokenMixer 的真实代码结构
当前仓库中的 LWDETRTokenMixer 定义如下:
python
class LWDETRTokenMixer(nn.Module):
    def __init__(self, c1: int, c2: int, kernel: int = 7, reduction: int = 4):
        self.proj = Conv(c1, c2, 1, 1)
        self.local = DWConv(c2, c2, kernel, 1)
        hidden = max(c2 // reduction, 8)
        self.global_gate = nn.Sequential(
            nn.AdaptiveAvgPool2d(1),
            nn.Conv2d(c2, hidden, 1, bias=True),
            nn.SiLU(inplace=True),
            nn.Conv2d(hidden, c2, 1, bias=True),
            nn.Sigmoid(),
        )
        self.out = Conv(c2, c2, 1, 1)

    def forward(self, x):
        x = self.proj(x)
        return self.out(self.local(x) + x * self.global_gate(x))
其前向过程可以写成:
text
Z = Conv1×1(X)
L = DWConv_k×k(Z)
g = σ(W2 · SiLU(W1 · GAP(Z)))
Y = Conv1×1(L + Z ⊙ g)
其中:
| 符号 | 含义 |
|---|---|
X |
P5 上采样与 P4 拼接后的输入特征 |
Z |
1×1 投影后的统一通道特征 |
L |
7×7 深度卷积得到的局部空间混合结果 |
g |
全局池化后经过两层 1×1 卷积生成的通道门控 |
Z ⊙ g |
使用全局语义先验对输入 token 进行通道重标定 |
Y |
局部与全局融合后的输出特征 |
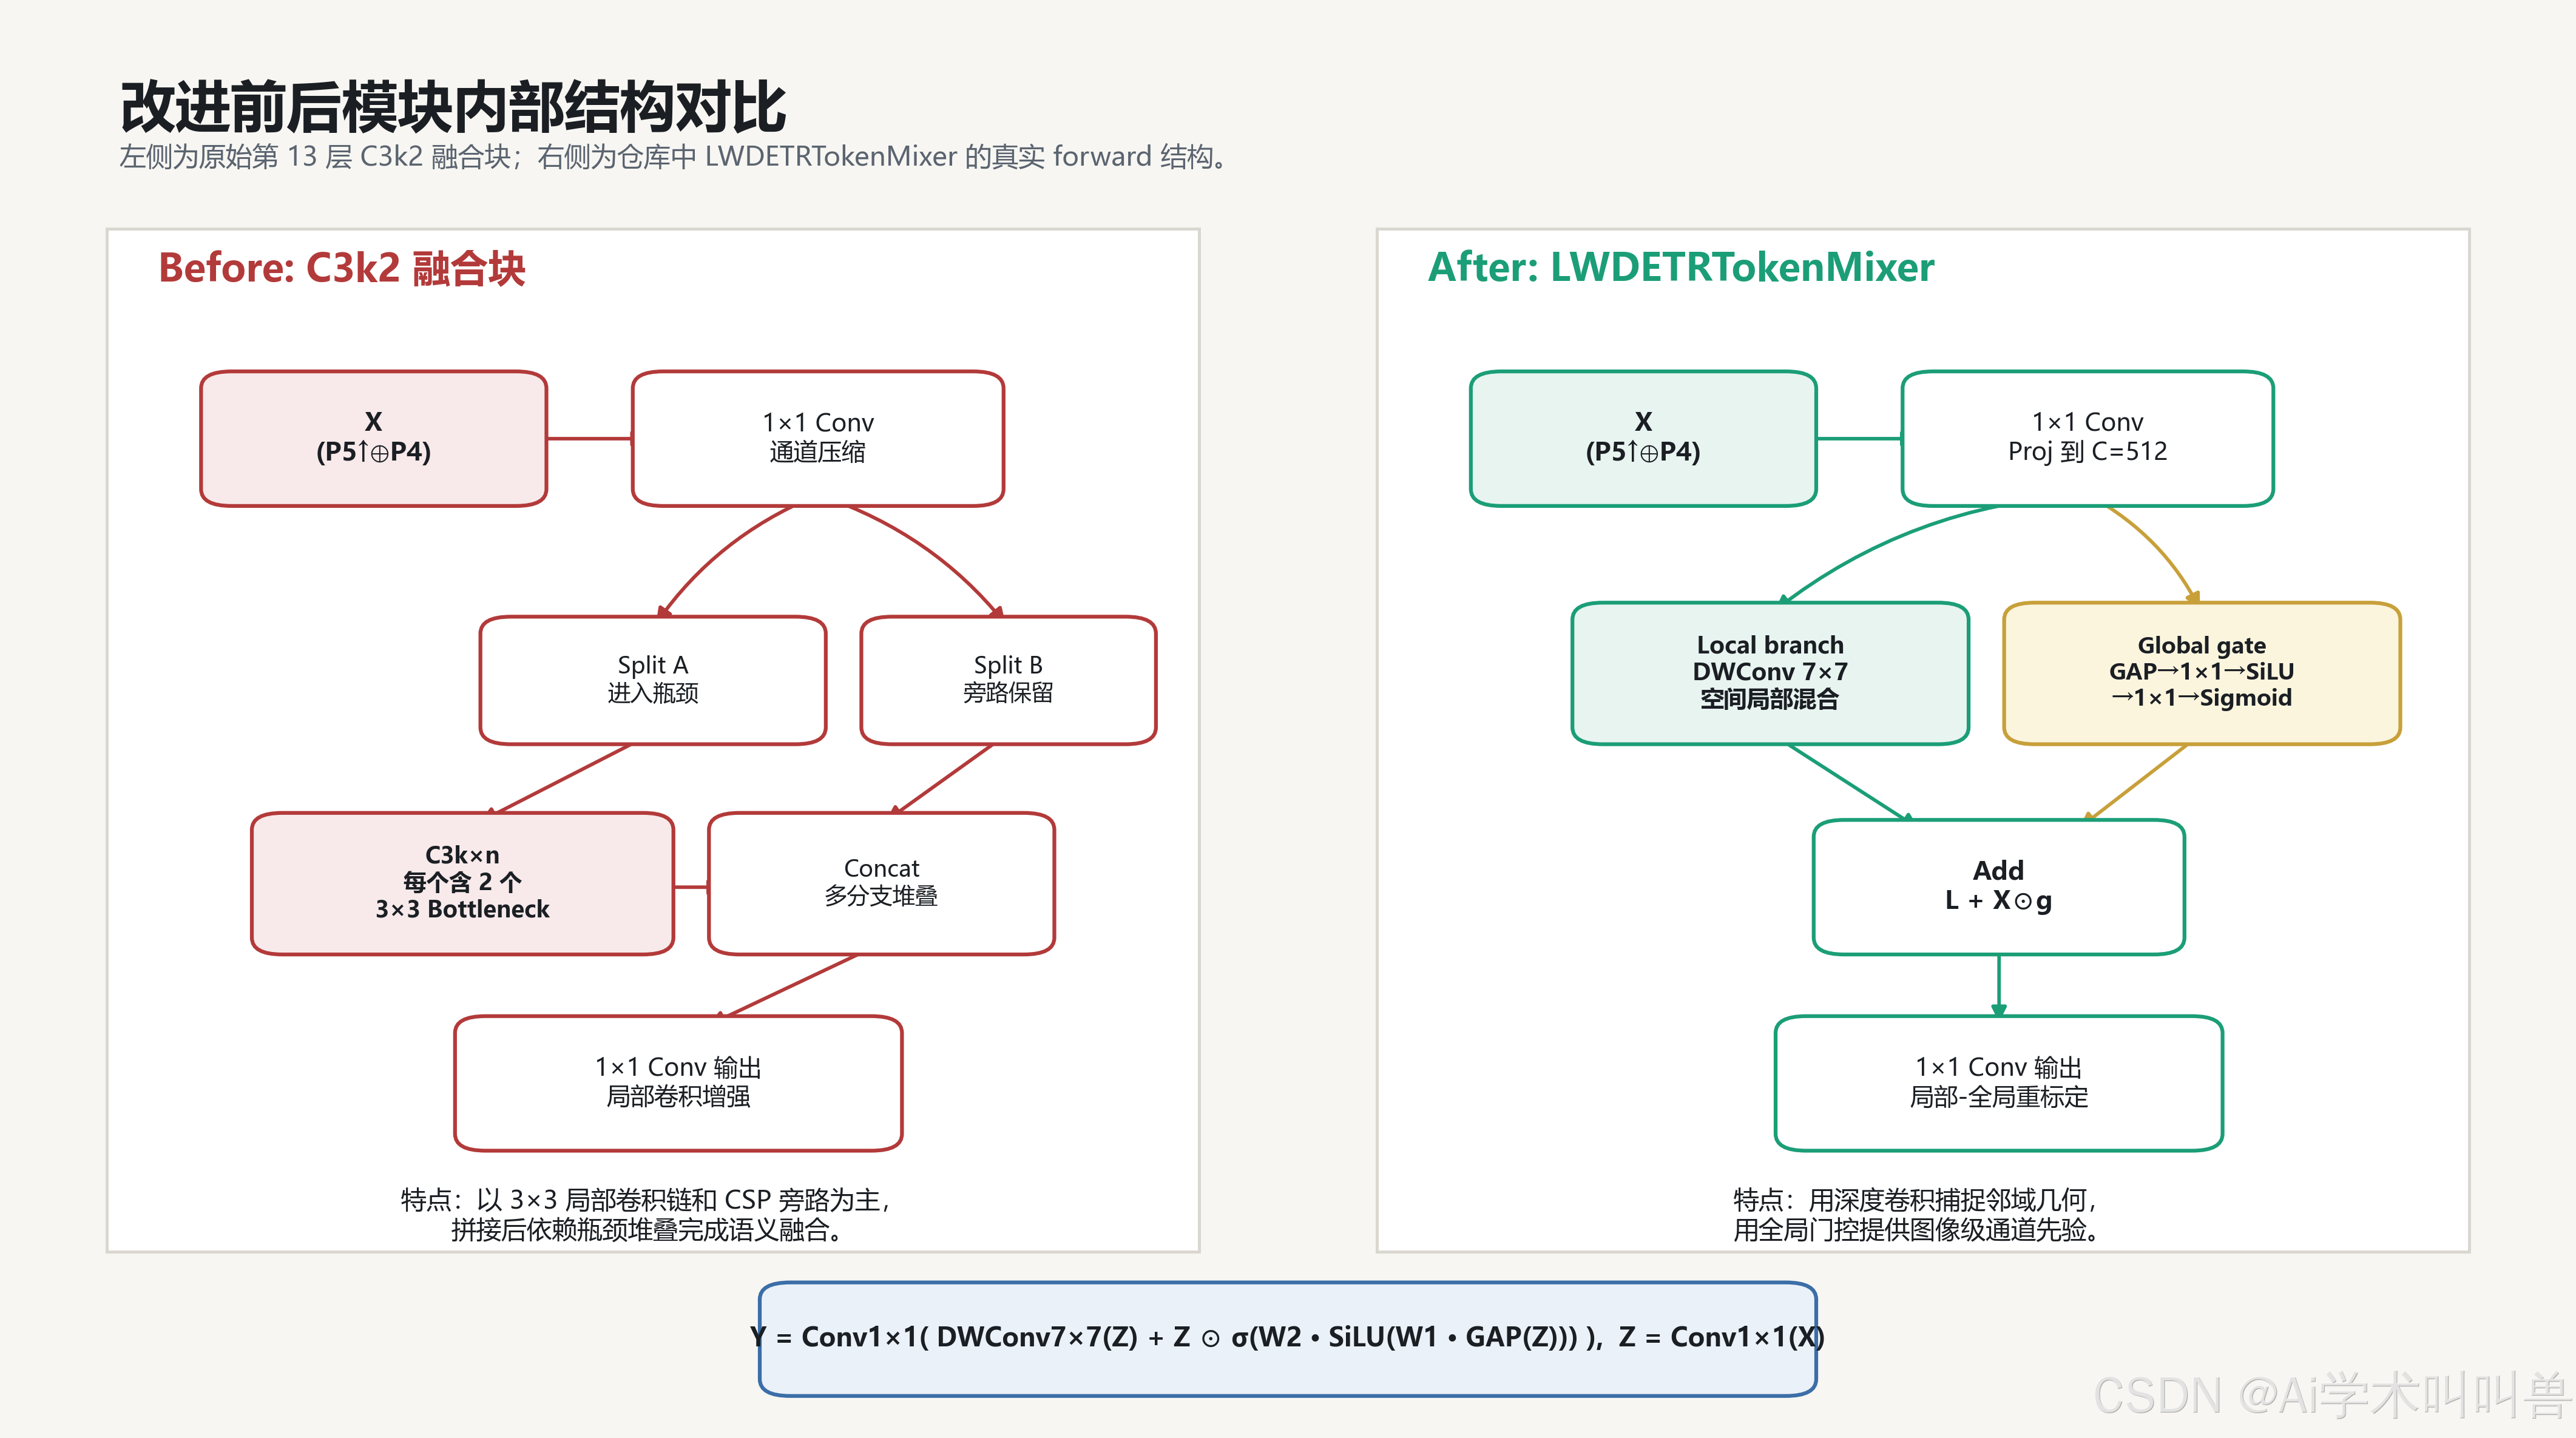
3.3 局部-全局融合机制
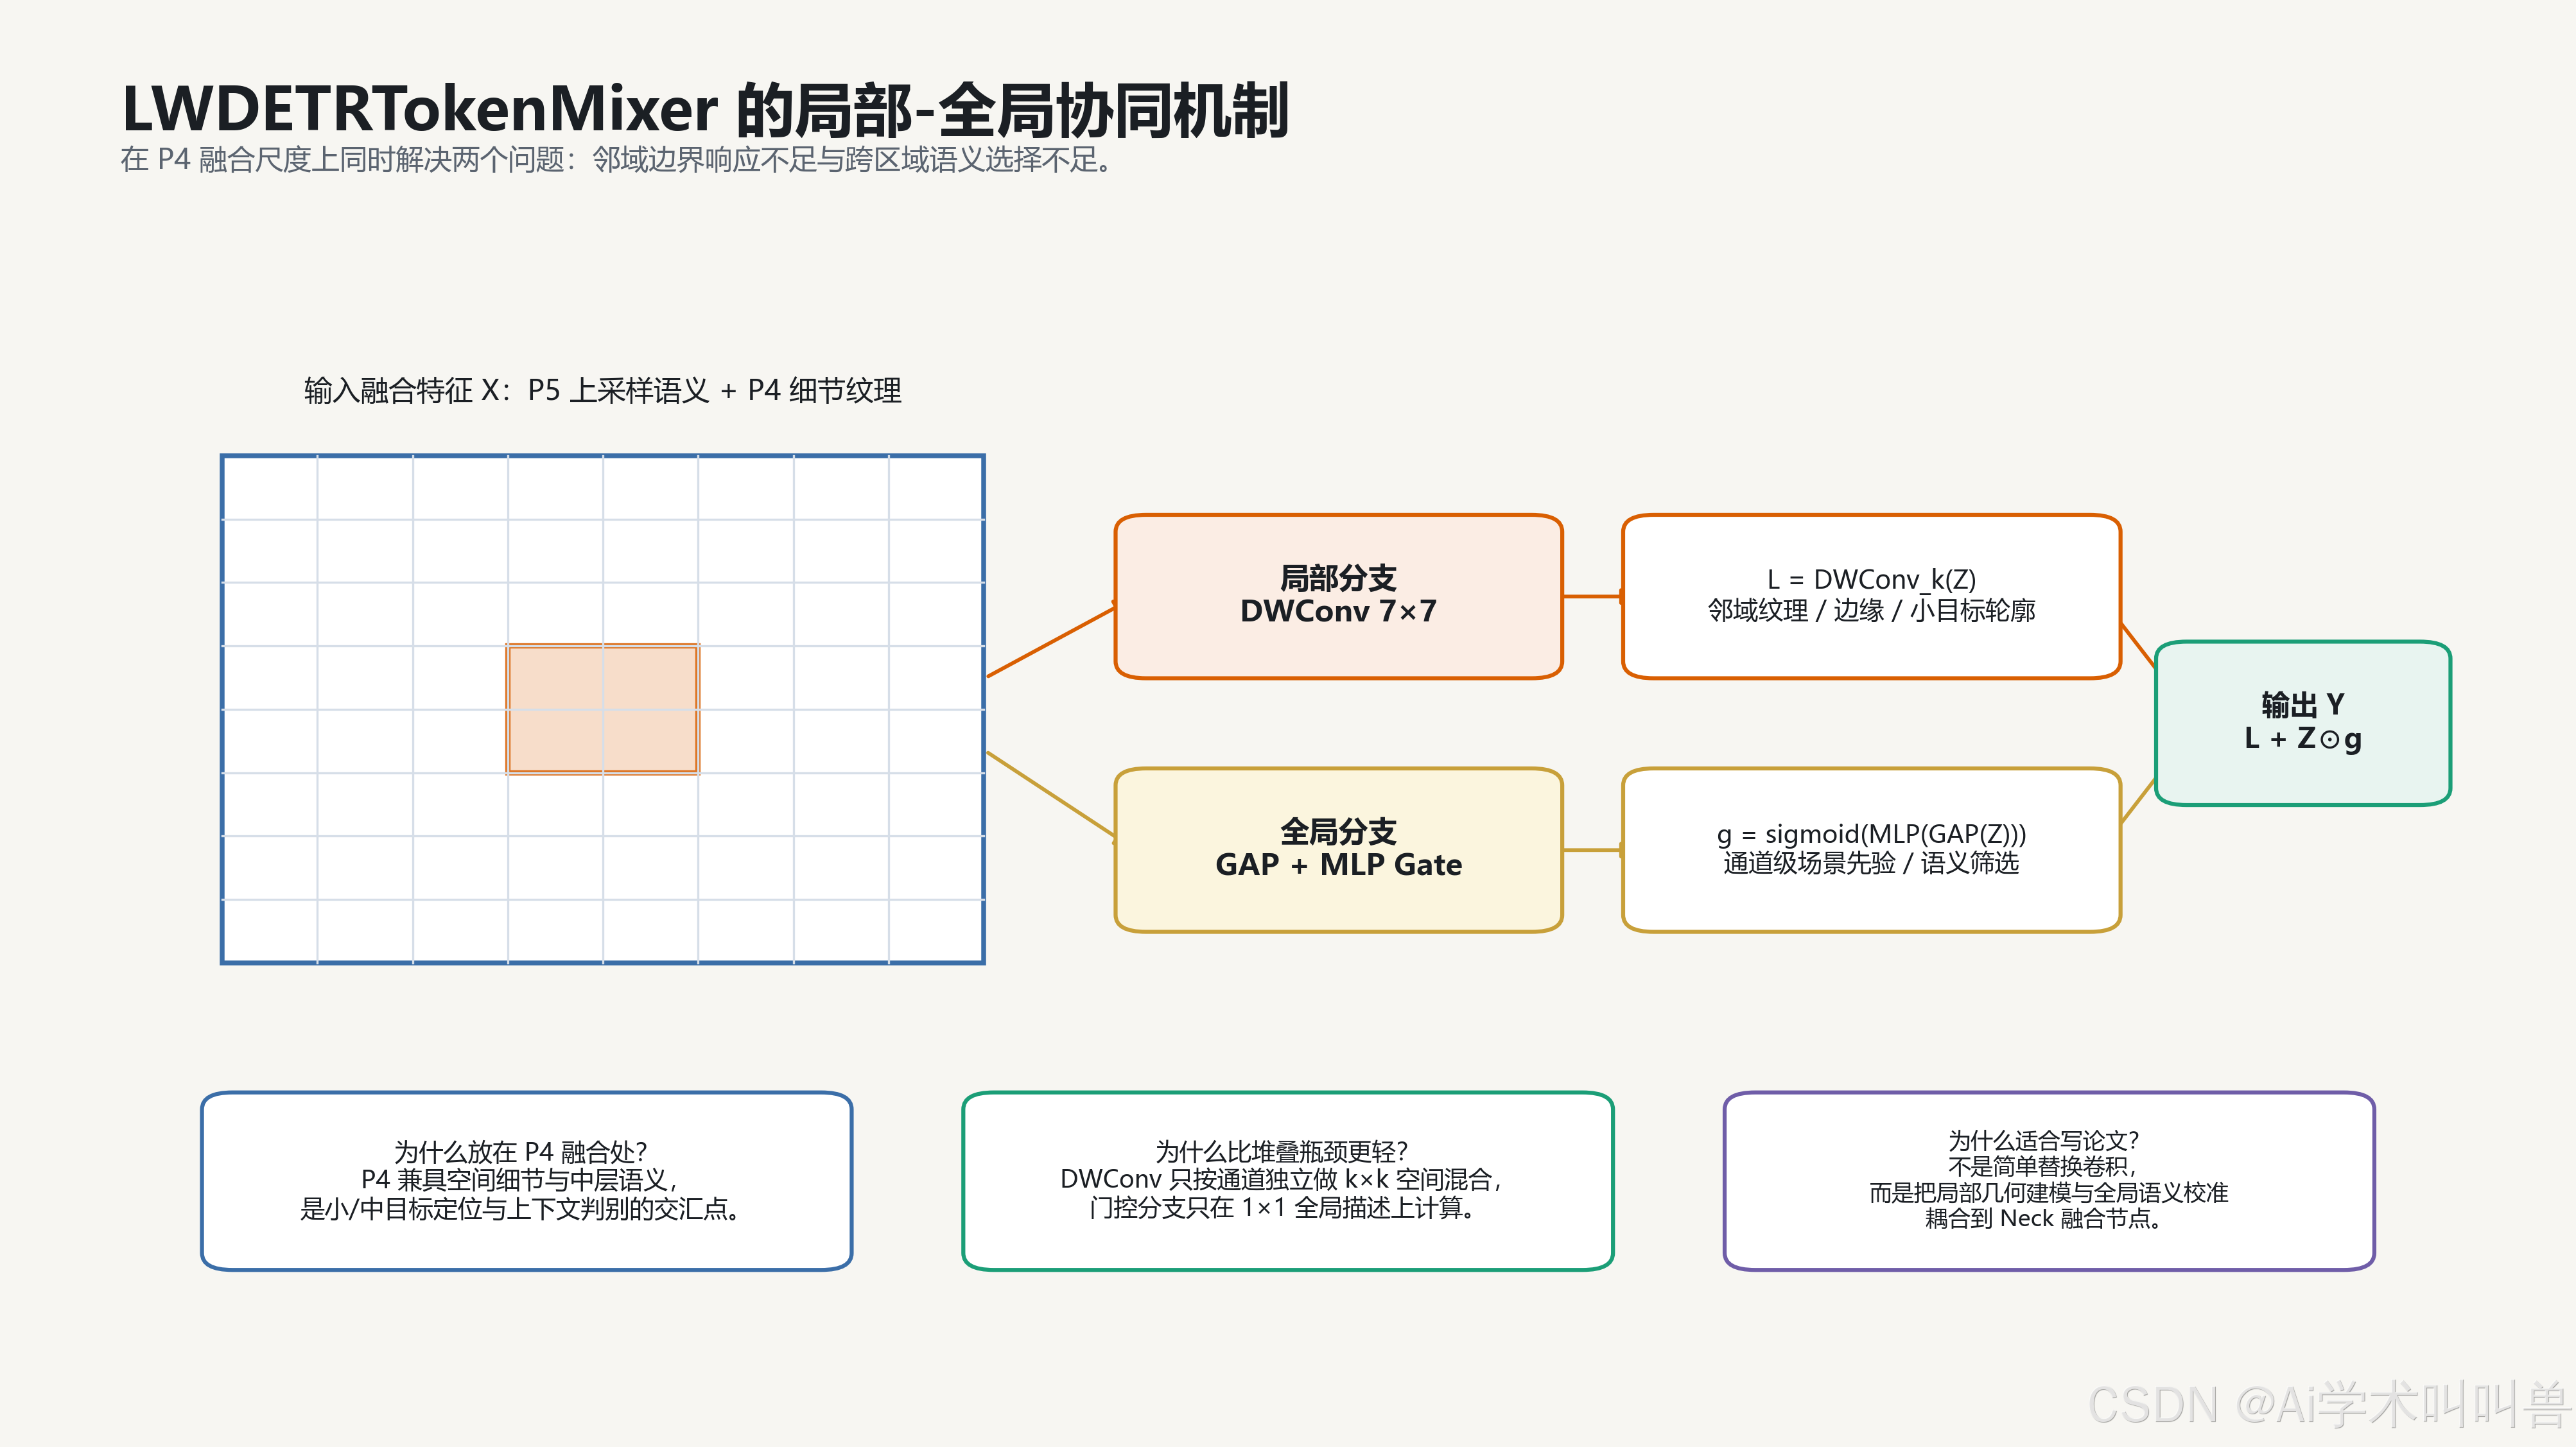
LWDETRTokenMixer 的核心不是简单注意力,而是轻量化的 token mixing。它保留卷积网络的空间归纳偏置,同时引入图像级全局门控。这个设计非常适合 YOLO Neck,因为 Neck 融合层最需要解决的是不同尺度特征之间的语义对齐问题。
局部分支:
text
L = DWConv_7×7(Z)7×7 深度卷积扩大了局部窗口范围。与普通卷积不同,DWConv 按通道独立进行空间混合,参数量与计算量都更低。它可以增强局部边界、纹理、轮廓以及中小目标的邻域结构。
全局门控分支:
text
g = σ(W2 · SiLU(W1 · GAP(Z)))该分支先用全局平均池化获得整幅图像的通道描述,再通过两层 1×1 卷积和 Sigmoid 生成通道权重。它不直接做昂贵的全局 self-attention,但能够提供一种全局语义先验:哪些通道更重要,哪些通道应该被抑制。
最终融合:
text
Y = Conv1×1(L + Z ⊙ g)这一步把局部空间增强特征 L 与全局门控后的特征 Z ⊙ g 相加,再通过输出投影完成融合。换句话说,模型不是在局部和全局之间二选一,而是让局部结构负责"看清边界",让全局门控负责"判断哪些响应值得保留"。
3.4 参数与计算逻辑对比
以 YAML 标称通道估算,第 13 层输入来自 P5↑ + P4 拼接,通道可理解为 C_i = 1536,输出为 C_o = 512。实际不同 scale 会按照 width/depth 系数缩放。
LWDETRTokenMixer 的参数主要来自:
text
P_LW ≈ C_i·C_o + k²·C_o + 2·C_o·C_h + C_o·C_o
C_h = max(C_o / r, 8)
当 k=7, r=4, C_i=1536, C_o=512, C_h=128 时,忽略 BN 后约为:
text
1536×512 + 7×7×512 + 2×512×128 + 512×512 ≈ 1.21M原始 C3k2 的结构可概括为:
text
P_C3k2 ≈ P_Conv1×1(C_i → 2C_h)
       + P_Conv1×1((2+n)C_h → C_o)
       + n · P_C3k(C_h)
若按原始 repeats=2 的标称结构估算,约为 2.75M;若在小尺度模型中深度缩放为 1 次,约为 1.90M。这个对比说明,LWDETRTokenMixer 的优势不是用更复杂的注意力堆叠替换卷积,而是用更直接的局部-全局耦合方式减少融合节点的冗余瓶颈。
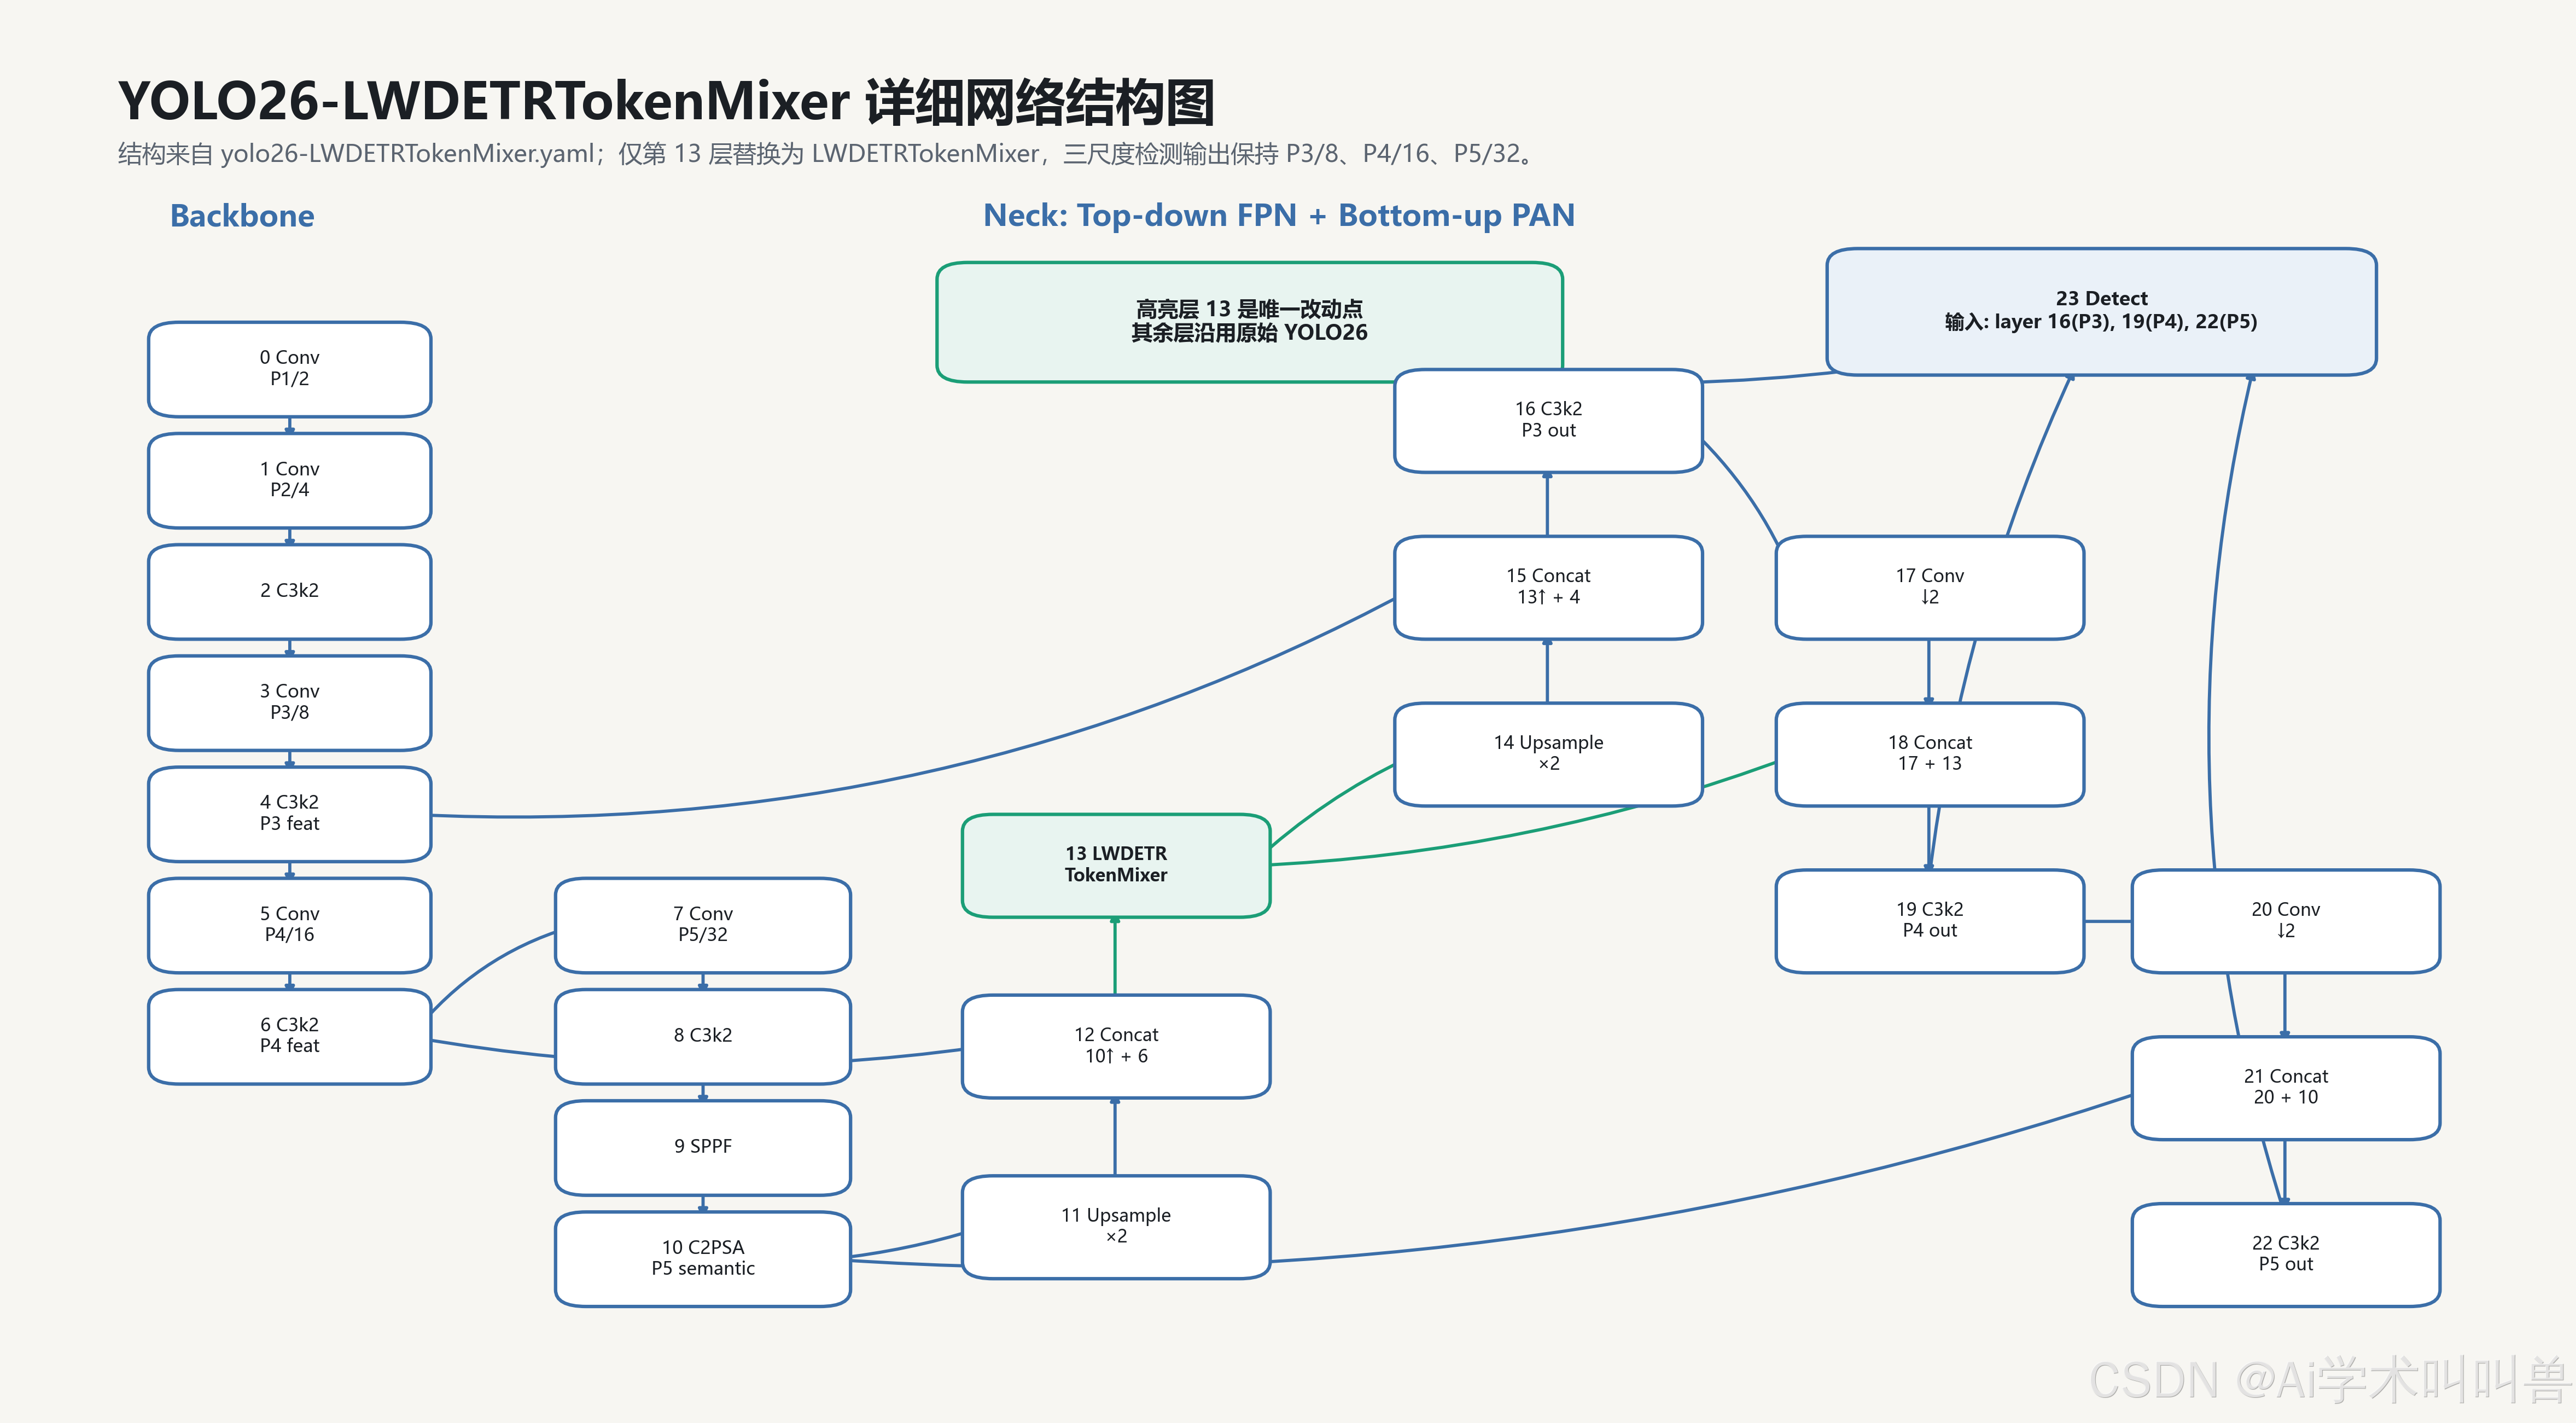
4. 整合融合方法总览
4.1 YAML 级别的单点替换
原始 YOLO26 Head 关键片段:
yaml
head:
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 6], 1, Concat, [1]]
  - [-1, 2, C3k2, [512, True]]
改进后:
yaml
head:
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 6], 1, Concat, [1]]
  - [-1, 1, LWDETRTokenMixer, [512, 7, 4]]
对比可以看到,Backbone 不变,Detect 不变,后续 P3、P4、P5 三尺度输出不变。改动严格限定在第 13 层融合块。
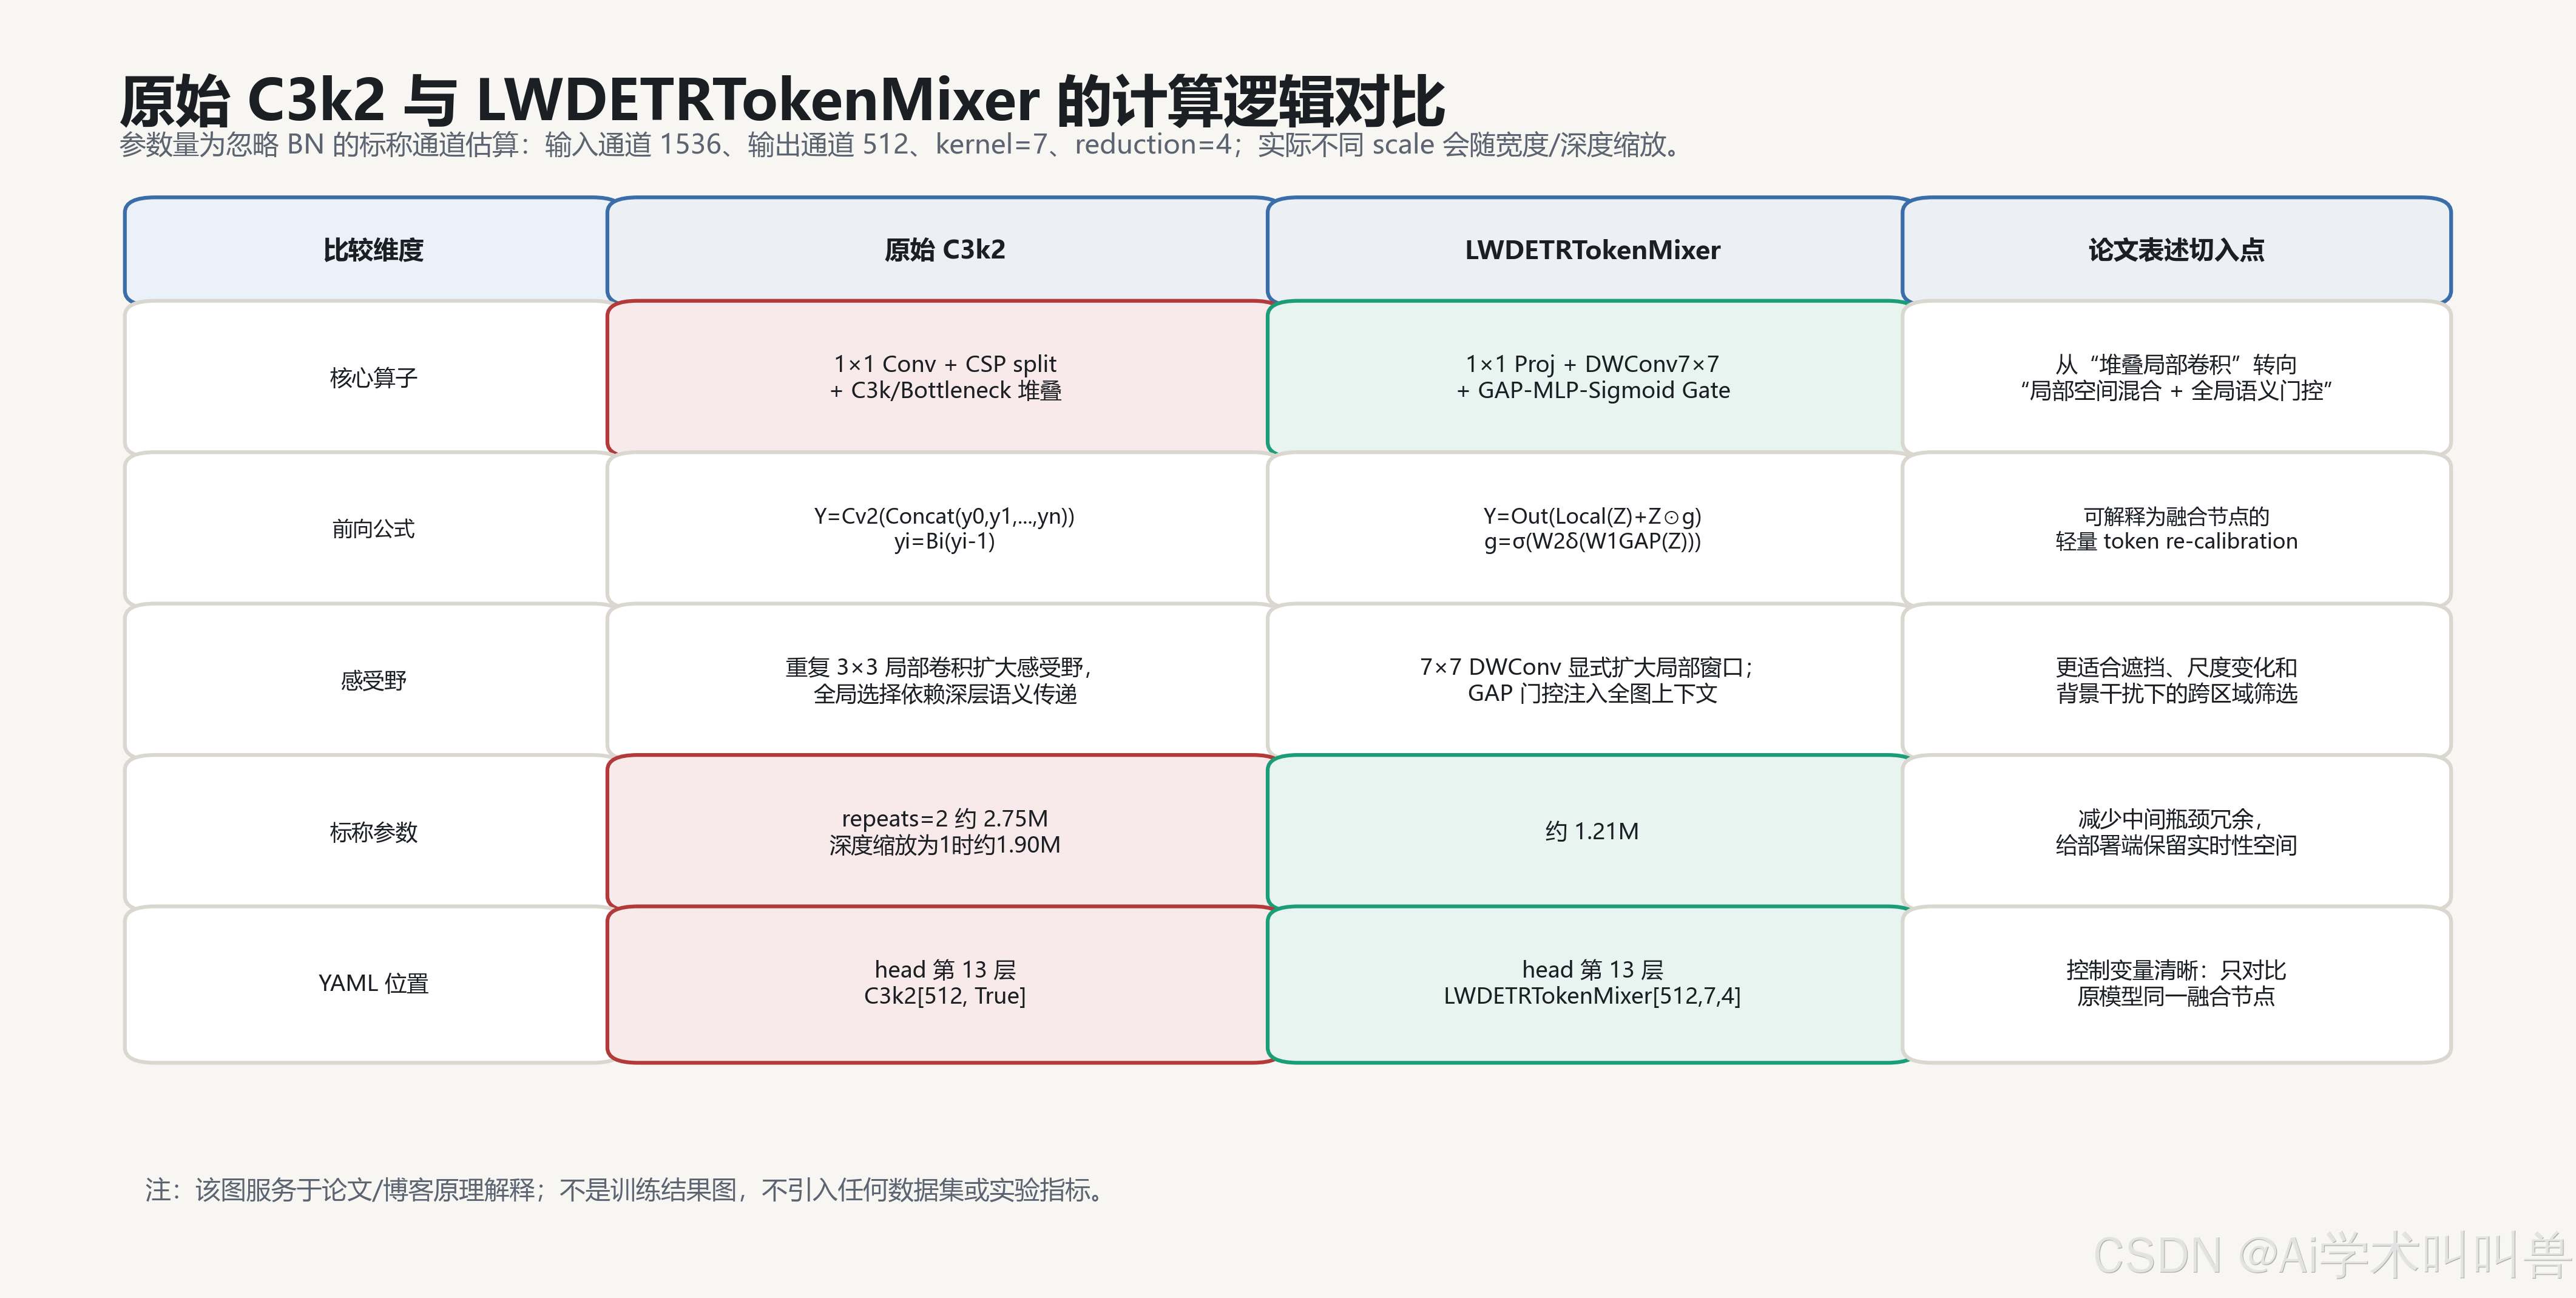
4.2 各分支优势与特点
| 组件 | 结构 | 作用 | 优势 |
|---|---|---|---|
proj |
1×1 Conv | 统一拼接后的通道维度 | 降低通道冗余,为后续混合做准备 |
local |
7×7 DWConv | 局部空间 token mixing | 扩大局部窗口,保持轻量计算 |
global_gate |
GAP + 1×1 + SiLU + 1×1 + Sigmoid | 生成全局通道权重 | 低成本引入图像级语义先验 |
x * gate |
逐通道重标定 | 抑制无效响应,突出关键语义 | 提升融合特征选择性 |
out |
1×1 Conv | 融合输出 | 完成局部与全局信息的再投影 |
4.3 方法总览
可以把该方法总结为四步:
- 跨尺度拼接:P5 高层语义经过上采样,与 P4 中层特征在通道维度拼接。
- 通道投影:用 1×1 卷积把拼接后的高维特征投影到目标通道数。
- 双分支混合:局部分支用 7×7 DWConv 建模邻域结构,全局分支用 GAP 门控建模通道级语义先验。
- 融合输出:将局部响应与全局重标定响应相加,并通过 1×1 卷积输出到后续 FPN/PAN。
这使得第 13 层从"局部卷积增强模块"变成"轻量局部-全局 Token Mixer"。对于论文写作,最关键的表述是:该模块在不改变检测头和主干结构的情况下,增强了 Neck 融合节点对上下文语义的选择能力。
5. 适合写进论文的创新点表述
中文创新点表述
创新点 1:提出面向 Neck 跨尺度融合的轻量局部-全局 Token Mixer。
针对原始 YOLO26 在 P5→P4 融合阶段主要依赖局部卷积瓶颈进行特征整合的问题,本文引入受 LW-DETR 局部/全局交替建模思想启发的轻量 TokenMixer。该模块通过 7×7 深度卷积建模局部空间关系,并通过全局池化门控生成通道级语义先验,从而实现对融合特征的局部几何增强与全局语义重标定。
创新点 2:在关键 P4 融合节点实现结构可控的单点替换。
本文没有改变 YOLO26 的 Backbone、Detect Head 和三尺度输出路径,而是在 Neck 中 P5 上采样与 P4 拼接后的第 13 层进行模块替换。该设计保证了对比对象清晰,能够更直接地分析局部-全局融合机制对 Neck 表征能力的影响。
创新点 3:以卷积化方式吸收 LW-DETR 的高效建模思想。
不同于直接引入完整 Transformer 注意力,本文将 LW-DETR 中局部窗口与全局上下文协同建模的思想转化为 DWConv 局部分支与 GAP 门控全局分支,使模型在保持 YOLO 实时检测框架的同时具备更强的上下文筛选能力。
6. 原网络与融合后特点对比
| 维度 | 原始 YOLO26 | YOLO26-LWDETRTokenMixer |
|---|---|---|
| 改进位置 | 第 13 层 C3k2 |
第 13 层 LWDETRTokenMixer |
| 主干结构 | 不变 | 不变 |
| 检测头 | 不变 | 不变 |
| 核心融合方式 | CSP 分支 + C3k/Bottleneck 局部卷积堆叠 | 7×7 DWConv 局部混合 + GAP 全局门控 |
| 上下文建模 | 主要依赖卷积堆叠逐层扩大感受野 | 显式引入图像级通道语义先验 |
| 轻量化特点 | 局部表达强,但瓶颈分支较多 | 深度卷积和门控分支计算更集中 |
| 论文叙述重点 | 局部卷积增强 | 局部几何建模与全局语义校准协同 |
| 适合解决的结构痛点 | 常规拼接后融合 | 跨尺度融合中的语义选择和冗余响应抑制 |
从结构上看,融合后模型没有改变 YOLO26 的整体检测范式,而是在 Neck 的关键融合点提供了一个更清晰的上下文增强机制。这一点非常重要,因为论文中最怕"全网大改但解释不清"。本改进的优势在于路径短、变量少、结构明确,能自然形成"问题提出-模块设计-机制解释-对比分析"的完整叙述链。
写在最后
学术因方向、个人实验和写作能力以及具体创新内容的不同而无法做到一通百通,关注UP:Ai学术叫叫兽
在所有资料中留下联系方式以便在科研之余为家人们答疑解惑,本up主获得过国奖,发表多篇SCI,擅长目标检测领域,拥有多项竞赛经历,拥有软件著作权,核心期刊等经历。
因为经历过所以更懂小白的痛苦!
因为经历过所以更具有指向性的指导!
祝所有科研工作者都能够在自己的领域上更上一层楼!