语音评测显示 Passed,为什么工具调用只有 1/2?
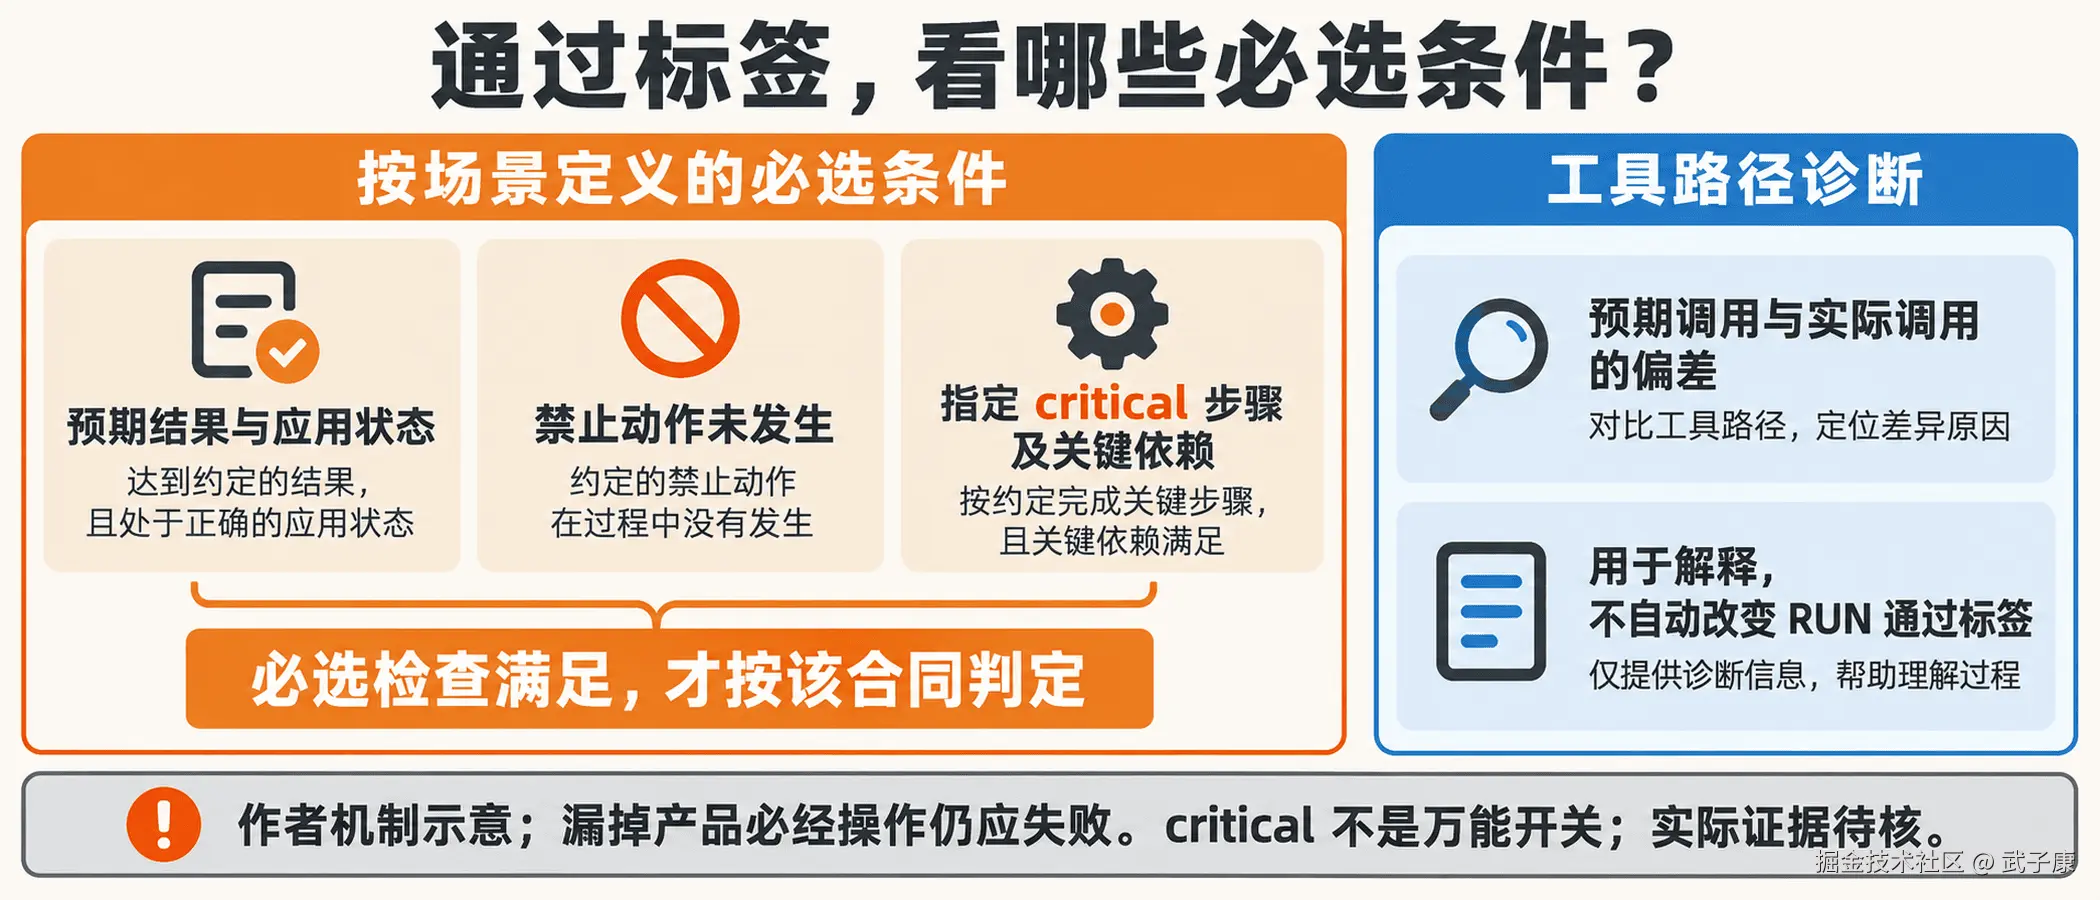
作者未执行的任务判定示意;不代表harness/API或设备验收,实际采集/播放待核。
小团队给语音配件接上模型、工具和播报之后,往往会先问:这条任务能不能跑通?但评测报告里的 Passed 究竟承诺了什么,也需要先说清。
OpenAI 的 GPT-Live 评估指南发布过一条这样的结果:任务通过,工具准确度却只有 50%,预期两次工具调用实际完成一次。它不是我们测出来的失败样本,也不代表某个模型的成功率,而是厂商公开的单次模拟对话记录。本文以 2026 年 10 月 12 日核对的文档、报告与固定版本源码为依据,回答一个问题:如果产品有一项绝不能跳过的操作,怎样避免它只影响诊断分数,却不影响通过标签?
一、先看这次 Passed 到底通过了哪些条件
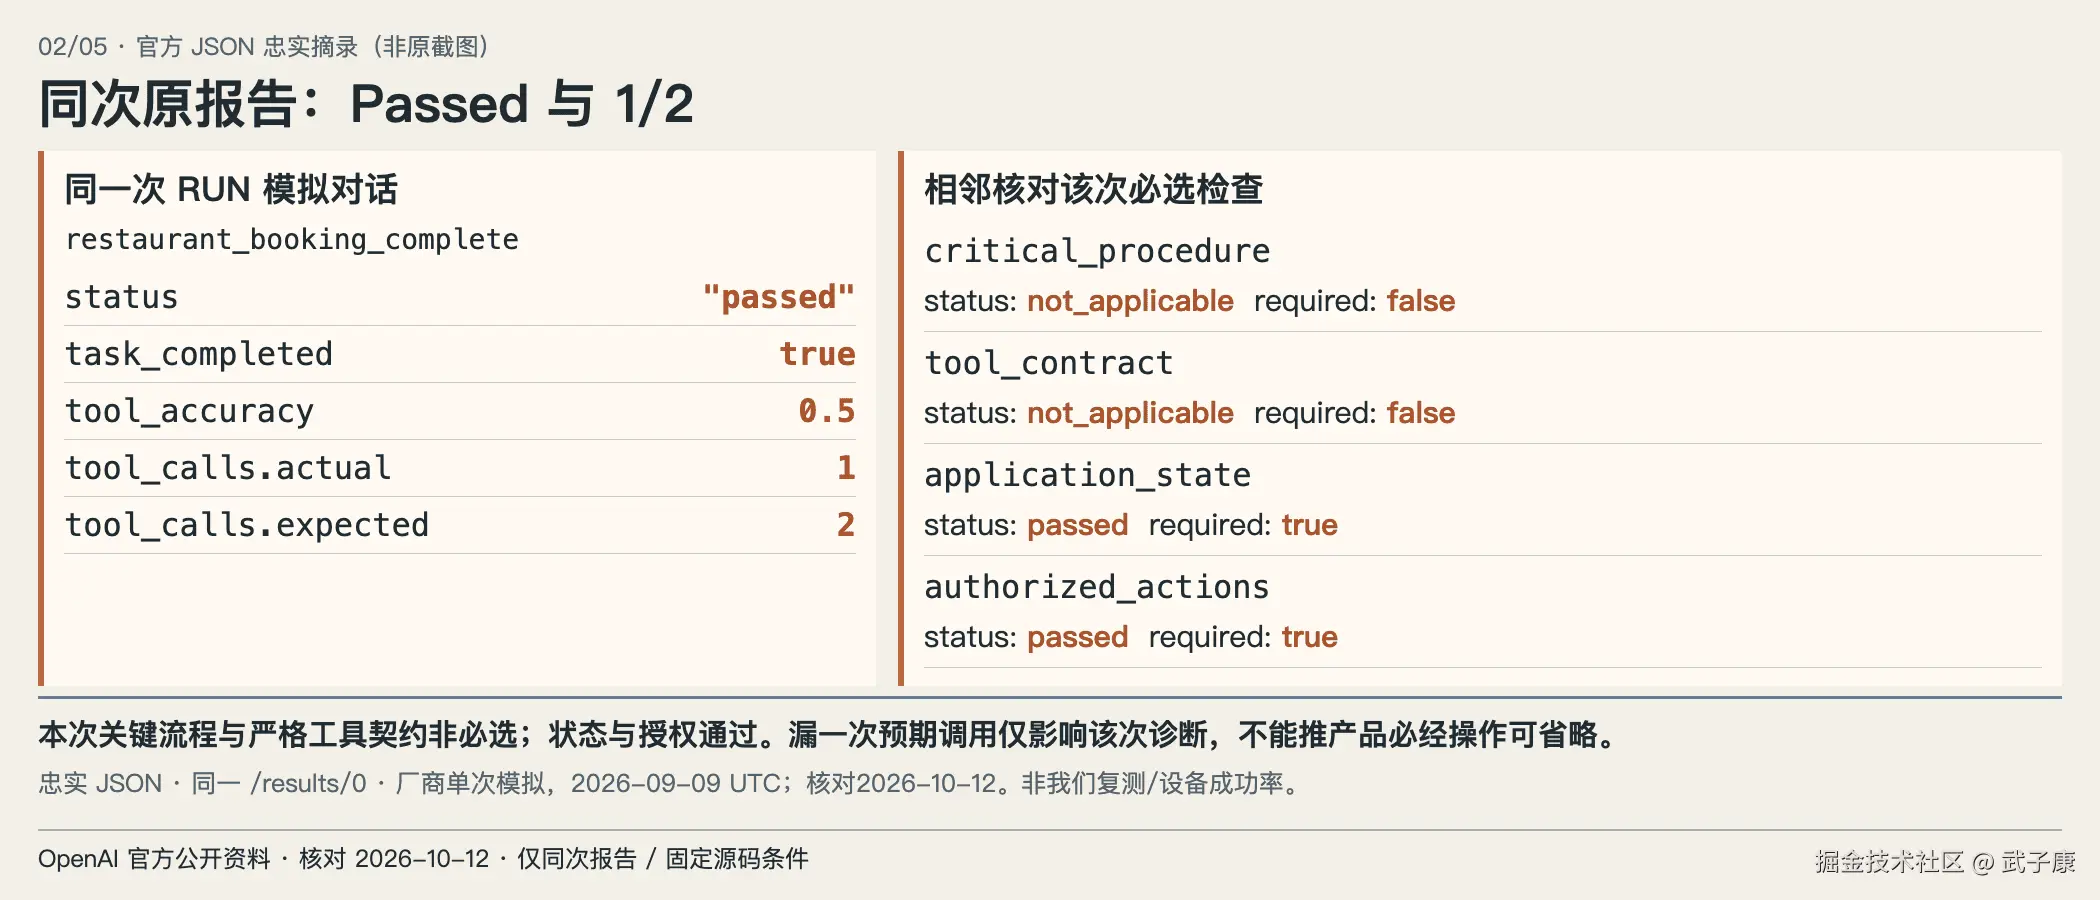
官方JSON/sourcecode忠实摘录与中文作者解释,明确非原始界面截图;公开单样例2026-09-09UTC,2026-10-12核对,不是本次复测。
公开记录的运行 ID 含日期 20260909;指南明确说明录制于 2026 年 9 月 9 日(UTC)。场景是虚构餐厅助手与模拟来电者完成预约,不是真实顾客订位,也不是我们给语音设备做的实测。^1^
下面是官方 results.json 的聚焦提取,字段和值保持原义:^2^
| 原报告中的位置 | 原值 |
|---|---|
results[0].status |
passed |
metrics.task.task_completed |
true |
metrics.task.tool_accuracy |
0.5 |
metrics.task.tool_calls |
actual: 1,expected: 2 |
assessment.checks 中的 critical_procedure |
not_applicable,required: false |
同处的 tool_contract |
not_applicable,required: false |
同处的 application_state、authorized_actions |
均为 passed |
这组值放在一起,才解释了表面冲突:该次报告判定所要求的结果与应用状态成立,未观察到禁止动作;关键流程和严格工具契约没有作为必选项生效。因此,漏掉一个预期工具会降低诊断分数,却未必推翻本次任务通过。
这里不能顺手推出"少调用工具没关系"。若产品要求写入前必须检查冲突,或必须经过授权,那么相同的省略对这个产品就是失败。公开报告不能替团队决定哪些步骤允许省略。
也不要把摘要里的一次工具执行与逐条事件日志行数混用。开始、调用、完成和投影记录可能围绕同一次操作出现;报告里的次数有自己的口径。本文只引用官方报告计数,没有重新计算其真实执行次数,也没有重跑评估。
因此,核对者应先把产品问题写成一句可以被观察推翻的话,再回到报告。例如,产品要求创建提醒前必须查冲突,核对者要问的是'这次写入之前有没有完成这项检查',而不是'工具准确度是否足够高'。如果通过条件只收最终提醒状态,报告可以回答提醒是否符合预期,却没有因此回答创建过程是否遵守了本产品的要求。这两句话之间的空档,正是需要补进场景合同的内容。
把两份报告放在一起时,也应先看它们要求什么,而不是先比较哪个 Passed 更多。即使名字相同、输入任务看起来相似,只要一个场景把查冲突设成必经步骤,另一个场景只看最终提醒,两份通过标签就没有表达同一件事。某次标签变化可能来自应用真的改变,也可能来自核对条件改变。只有固定任务要求、模式与场景版本,再比较同类观察,标签差异才有清楚的解释。本文没有进行这样的配对实验。
二、名叫 required 的列表,在不同模式里作用不同
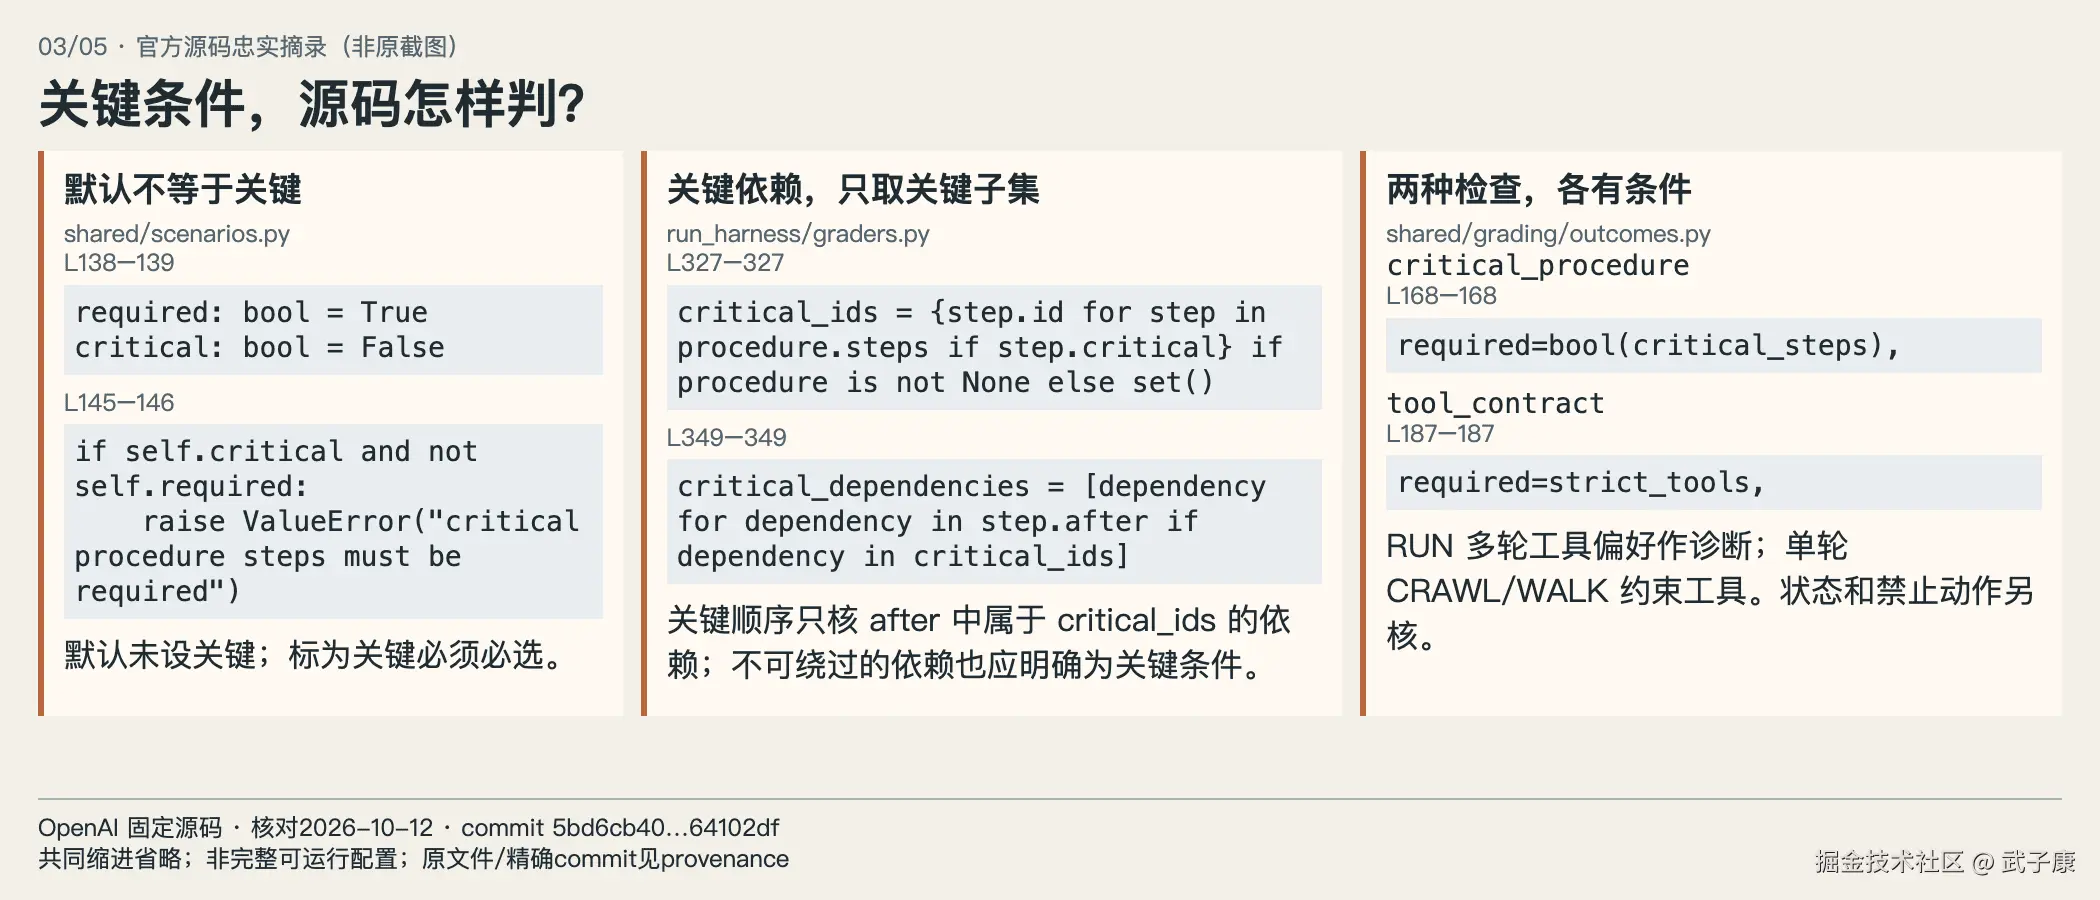
官方JSON/sourcecode忠实摘录与中文作者解释,明确非原始界面截图;公开单样例2026-09-09UTC,2026-10-12核对,不是本次复测。
官方指南把单轮请求的 CRAWL、WALK,与完整多轮模拟对话的 RUN 分开。CRAWL 和 WALK 会约束 expected.tools.required 中的有序调用;RUN 将它用于偏好工具路径的诊断,必经流程要在 expected.procedure.steps[] 中明确标为 critical: true。^1^
这不是只靠一段说明推测。文档链接的官方 Cookbook 源码,在本次冻结的 commit 5bd6cb40b6b84b69b2032d810610aa85064102df 中,也将两种判断分开:^3^
run_harness/graders.py的grade_procedure单独收集 critical 步骤失败,并生成critical_passed。shared/grading/outcomes.py的critical_procedure检查,在存在关键步骤时成为必选检查;tool_contract是否启用严格判定,则依赖模式。shared/scenarios.py中关键步骤默认不是 critical;还会拒绝"critical 但非 required"的矛盾配置。
这是第二个可核对的证据单元:同一个"预期流程"既可以是解释偏差的参考,也可以成为决定失败的条件。字段名称相似,不能据此认定它已经拦住了产品禁止的遗漏。
critical: true 也不是一句万能配置。需要选对实际可观察的步骤,配好要匹配的证据;如果先后顺序本身不可绕过,相应依赖步骤也必须被定义为关键条件。否则,配置里写了"先检查",却未必按团队想要的顺序判定。最终应用状态与禁止动作还要各自核对,不能用关键步骤标记替代。
对小团队而言,真正省下返工的动作,是先选定一条高频任务,将"结果正确"和"过程不可省略"分别写清,再扩大场景。无需把所有偏好都提升为硬条件;只要求最终信息正确的问答,没有必要硬规定同一条工具路径。
对提醒例子来说,产品可以有两种合理要求。第一种只要求把修正后的时间写对,并禁止重复和未授权写入;它未必要求模型使用特定的查询工具。第二种还规定创建之前必须完成冲突检查。在第二种要求下,检查本身成为过程约束。不能因为第一种产品允许不同工具路径,就替第二种产品放宽必经操作;也不能反过来要求所有问答都必须走同一条黄金工具路径。这里的取舍应来自这条任务,而不是让诊断分数决定产品流程。
顺序要求还需要再具体一步。设检查冲突为 A,写入提醒为 B。如果团队的要求是 A 完成后才允许 B,仅把 B 标为关键,再让它引用一个非关键的 A,并不能凭字段外观认定关键顺序门已按这个要求设置。当前源码对关键依赖采用关键步骤的子集,所以 A 与 B 的关键性质和依赖关系都需要核对。这个判断只针对这里的关键顺序检查,不表示所有普通依赖没有意义,也不表示其他判定已经失效。
随后要问的是 A 的观察证据是什么。应用记录可以显示发出了检查请求,但请求发出不等于检查结果已经可用。若场景要求的是'检查完成后写入',预期步骤与实际证据就应描述这个完成条件;不能把动作名称相同当作已经满足。同理,B 也不应只匹配到一句'准备设置提醒',而需要与这条任务的写入观察及结果对应。这里给的是应用设计要求,没有将这些词组直接包装成供应商已接受的配置。
三、把一条提醒任务改成能判定的记录
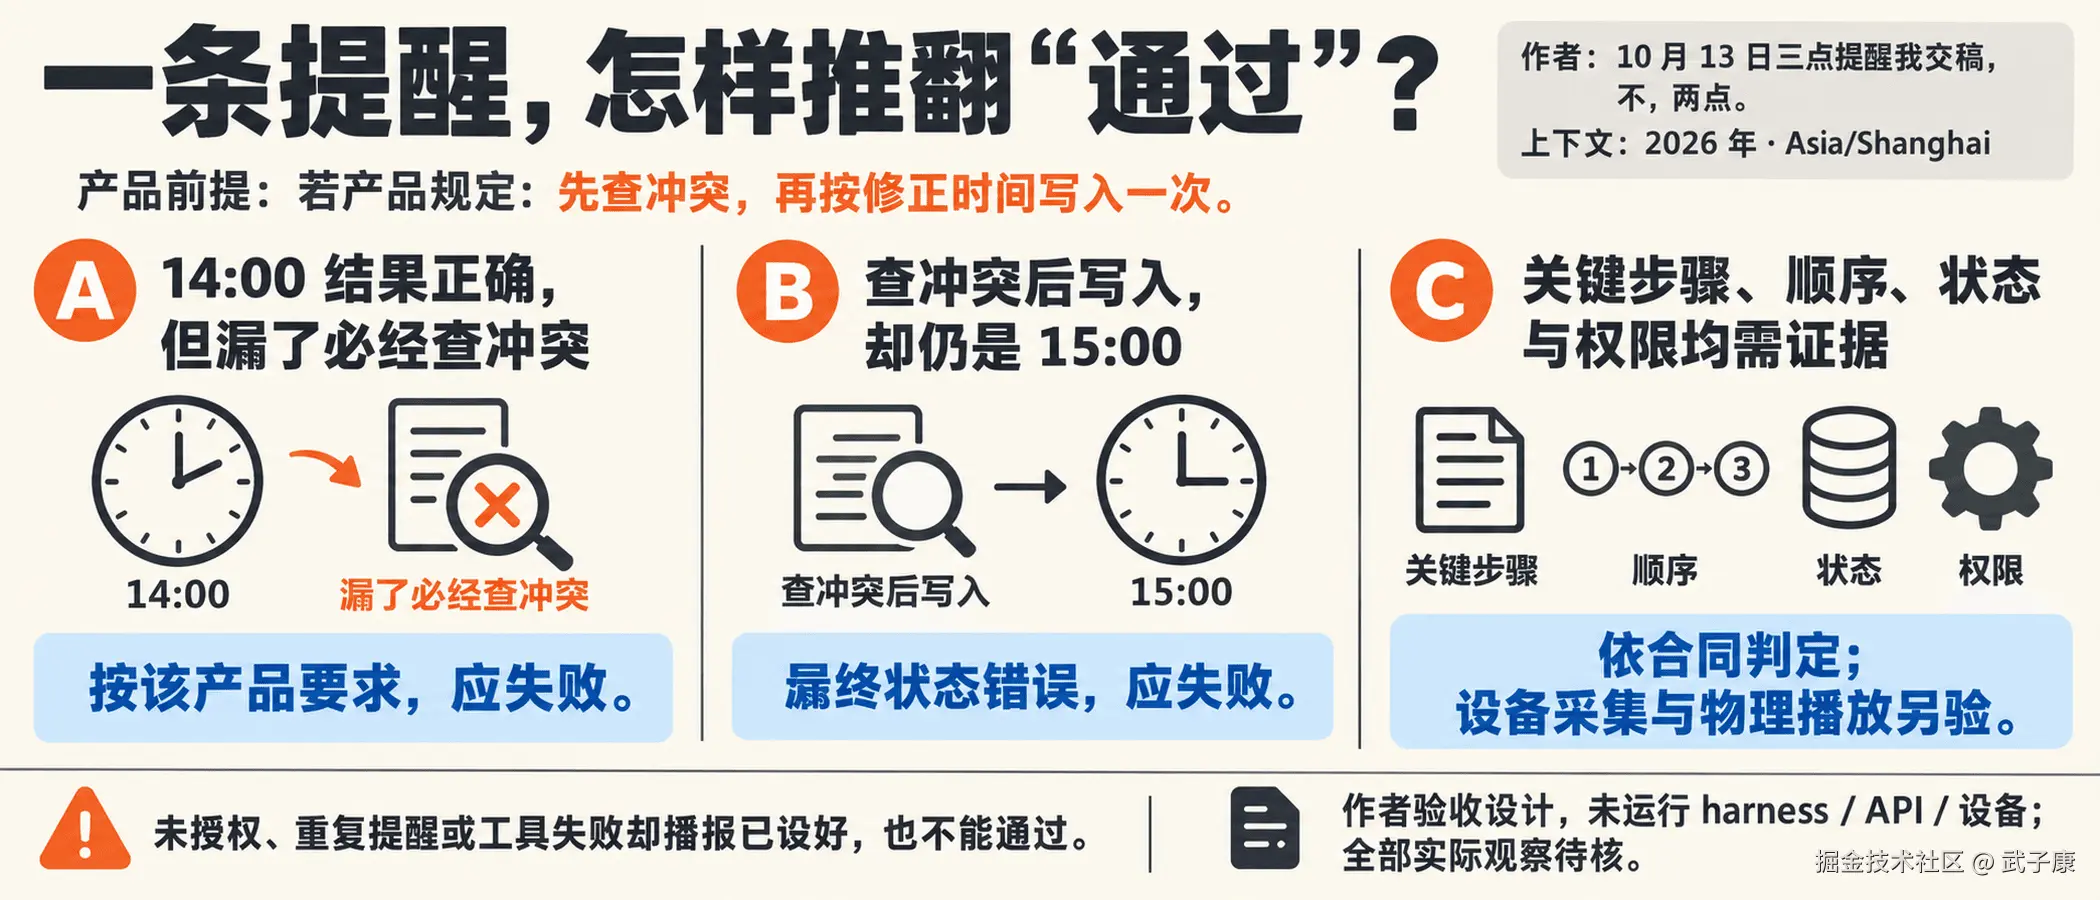
作者未执行的任务判定示意;不代表harness/API或设备验收,实际采集/播放待核。
假设产品提供语音创建提醒,当前要验证的是一句改口请求:"10 月 13 日下午三点提醒我交稿,不,两点。"测试上下文预先固定为 2026 年、Asia/Shanghai;这是作者设计的请求,没有实际说给设备或模型听。
最终目标可以很小:仅新建一条 2026 年 10 月 13 日 14:00 的交稿提醒,不出现 15:00 的旧提醒。如果这个产品还规定"创建前必须查冲突",就把该操作与正确写入一起设为不可省略条件,而不是只把两个工具放进期望列表。
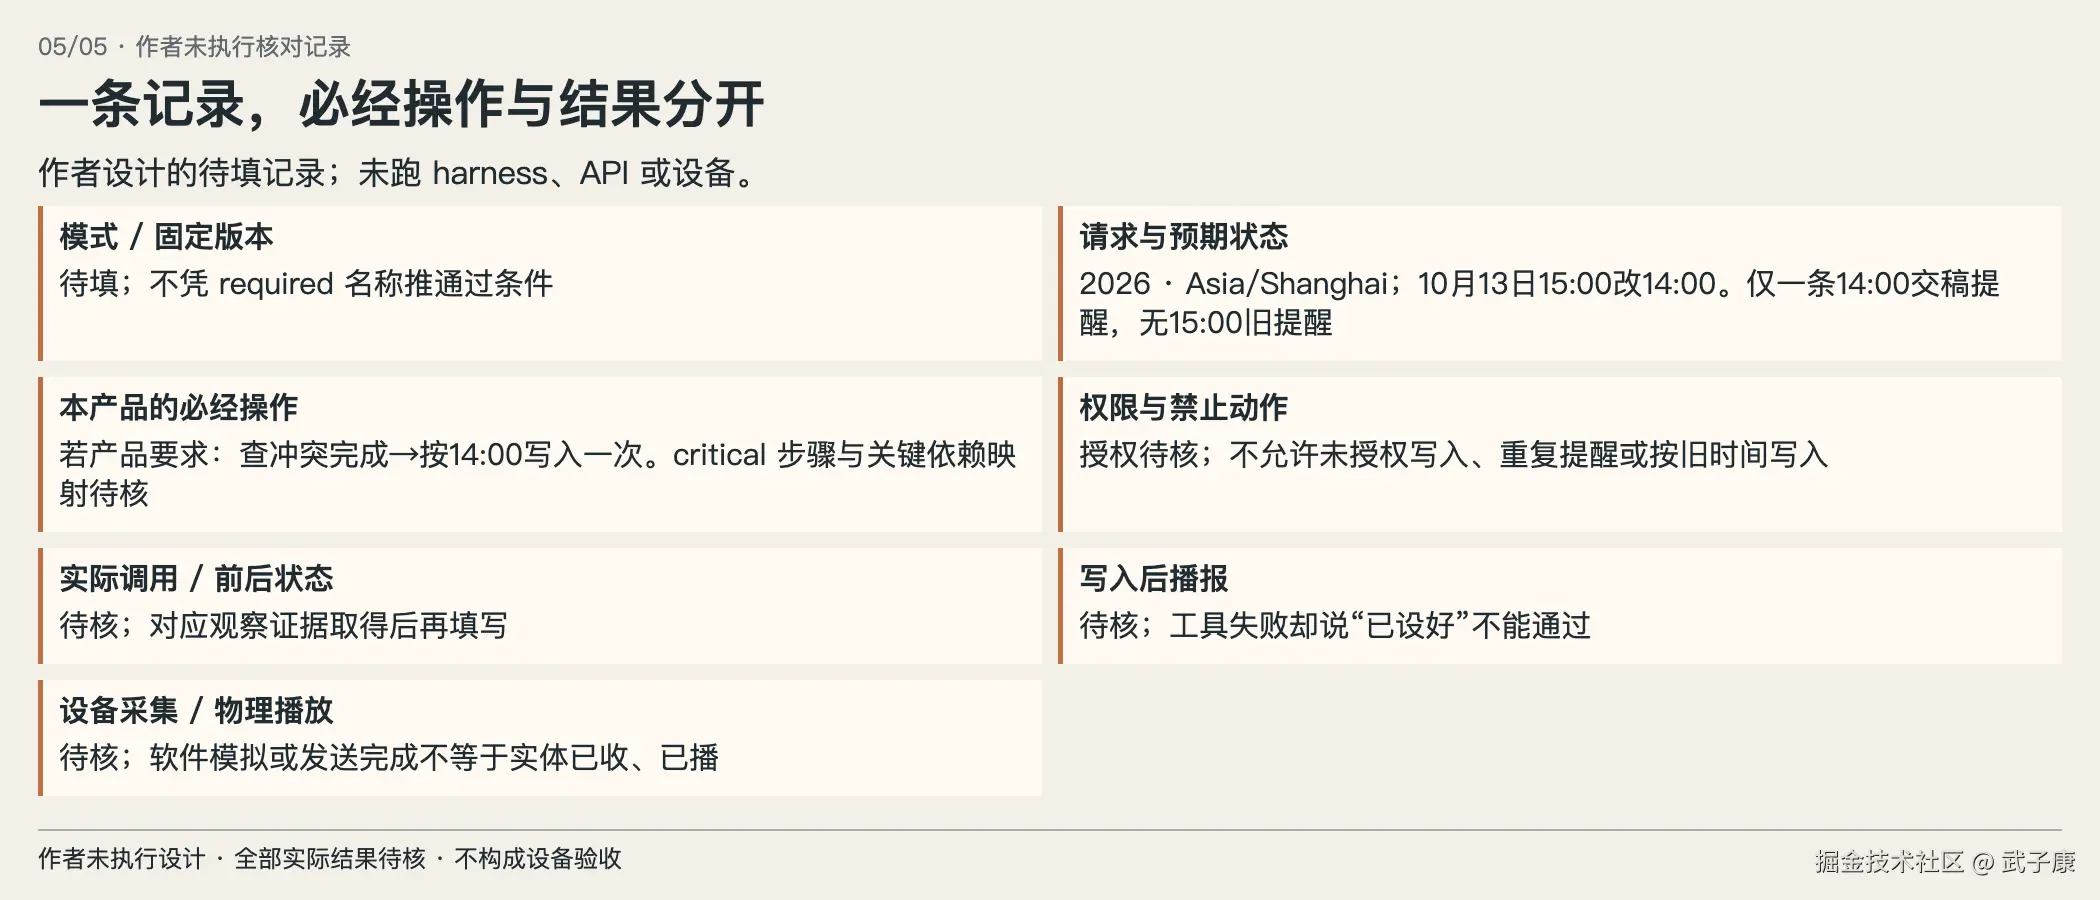
作者未执行的任务判定示意;不代表harness/API或设备验收,实际采集/播放待核。
下面是一条待执行的核对记录。字段是作者应用记录,不是供应商事件或可直接提交的完整场景配置:
text
case: corrected-reminder-001
mode / harness_commit: 待填
request_context: 2026 年;Asia/Shanghai
expected_final_state: 一条 10 月 13 日 14:00 交稿提醒;无 15:00 旧提醒
mandatory_procedure: 查冲突完成后,按修正时间写入一次
forbidden_action: 未授权写入;重复提醒;按旧时间写入
critical_steps_and_dependencies: 待映射到所用 harness 并检查配置
observed_calls / state_before / state_after: 待核
spoken_confirmation_after_write: 待核
device_capture / physical_playback: 待核
verdict_and_failed_required_checks: 待核
填写时,至少让一次真实观察能推翻判断:若最终提醒正确,但必经的冲突检查缺失,这个产品的场景应失败;若调用顺序正确,最终仍写成 15:00,也应失败;若工具失败,助手却说"已设好",不能因回答自然就通过。这里给的是作者的验收要求,不是已观察到的三类故障,也没有声称修改场景后官方 harness 已接受或正确执行。
记录还刻意保留了最后两个"待核"。自动音频评估经过模拟输入和软件链路,不能单凭通过标签证明配件麦克风实际收到这句话、手机锁屏后仍能完成操作,或实体扬声器已经播出结果。LiveKit 官方也把文本模式行为测试与音频模拟分开,后者覆盖配置的语音处理链路;两者均须按实际输入路径解释。^4^ 本篇不为设备另造一套评测体系,只提醒团队不要扩大这条记录的证明范围。
执行这条任务之前,先固定请求含义。这里明确了年份与时区,并给出了从三点修正为两点的同一句请求,目的是让核对者能判定旧时间与新时间是否混用;不是把这个示例设成所有提醒产品的默认解析规则。如果真实用户只说'明天两点'而环境没有可靠的日期或时区,团队还需要为那种输入单独定义期望行为,不能借本例的固定上下文替模型补答案。本篇只处理已经固定上下文的这条请求。
再给初始状态留一个可核对的位置。'最后只出现一条提醒'需要说明是这次操作新建的哪一条,以及有没有留下旧的 15:00 对象;不能只数界面上总共有多少条记录。已有其他提醒时,删除或忽略它们来凑一个总数并不符合本例要求。核对记录应保存与目标对象有关的前后状态和对应关系。本文没有读取真实数据库,因此这里不提供实际对象 ID,也不把作者填写的目标值称为观察结果。
过程核对可以围绕一个小切片进行:用户修正了时间之后,应用实际调用了什么,检查结果何时可供使用,随后写入采用的是哪个时间,最终对象又是什么。请求日志回答'试图做什么',结果或状态记录回答'最终发生什么',播报回答'向用户说了什么'。这三类材料相互核对,就可以发现时间已经修正但仍写旧值、后端失败却播报成功等不一致;没有相关材料时,应保留待核而不是替它补一条推测日志。
当观察结果与合同冲突时,先写具体矛盾,不急着把它归成模型不好。例如,可记录'期望 14:00,实际对象为 15:00',或者'要求检查完成后写入,缺少能证实检查完成的观察'。前一种已取得实际错值时可以据合同判失败;后一种缺证据时至少不能宣告条件通过,也不能虚构检查确实没发生。应失败的设计反例与真实失败记录要分开,本例目前只有前者,没有后者。
用九条本地记录,把失败条件跑出来
前面的记录仍然需要真实应用填写,但它的判定规则可以先单独运行。下面保存为 reminder_check.py,使用 Python 3 标准库即可运行,不需要安装评估框架、申请 API Key 或连接提醒服务。它是作者为这一条提醒设计的最小判定器,不是官方 RUN grader 的替代实现;官方的对话结束、回答证据、委派策略等其他检查没有搬进来。
输入先限定为可信的、已解析的本地记录。created 只放本任务新增的提醒对象,并包含上海时区的绝对时间;它不是数据库全部记录,也不是模型声称创建的内容。authorized 表示本次写入已有授权,不能从写入成功倒推授权成立。两个时间字段分别是查冲突完成与写入开始的相对毫秒数,必须来自同一条可比较时间线。示例采用整数,严格要求前者小于后者;同毫秒而无法判断顺序时,该最小合同不放行。
这里还约定了两种不同的缺失:键不存在,表示未取得证据,输出 INSUFFICIENT_EVIDENCE;键存在且值为 None,表示完整观察确认查冲突没有完成,按要求判失败。接真实日志时必须先解释清楚采集覆盖,不能把"没采到事件"自动转换成"动作没发生"。这一约定仅适用于本例的构造输入,不是通用日志解析规则。
tool_accuracy 故意保持在 0.5,判定器却不读取它。要测试的是状态、授权及必经流程的合同,而不是给诊断分数另定一个及格线。前两条案例使用同一份"最终时间正确但没有查冲突"的记录,只改变是否要求查冲突;其余案例分别改变一个关键条件,最后一条同时展示失败写入与错误成功播报。
python
"""Constructed reminder records; no harness, API, microphone or backend run."""
from copy import deepcopy


def assess(record, require_conflict=True):
    required = ["created", "authorized", "write_started_ms"]
    if require_conflict:
        required.append("conflict_completed_ms")
    missing = [key for key in required if key not in record]
    if missing:
        return "INSUFFICIENT_EVIDENCE", "missing:" + ",".join(missing)
    failures = []
    # created contains only objects added by this task, not the whole database.
    if record["created"] != [{"time": "2026-10-13T14:00:00+08:00", "title": "交稿"}]:
        failures.append("final_state")
    if record["authorized"] is not True:
        failures.append("authorization")
    if require_conflict:
        checked = record["conflict_completed_ms"]
        written = record["write_started_ms"]
        # None here means observed absence, not unavailable instrumentation.
        if checked is None or written is None or checked >= written:
            failures.append("critical_procedure")
    if record.get("write_failed") is True and record.get("said_success") is True:
        failures.append("false_confirmation")
    return ("FAIL", ",".join(failures)) if failures else ("PASS", "required_checks")


BASE = {
    "created": [{"time": "2026-10-13T14:00:00+08:00", "title": "交稿"}],
    "authorized": True,
    "conflict_completed_ms": 100,
    "write_started_ms": 200,
    "tool_accuracy": 0.5,
}


def run_examples():
    no_check = deepcopy(BASE)
    no_check["conflict_completed_ms"] = None
    late_check = deepcopy(BASE)
    late_check["conflict_completed_ms"] = 250
    wrong_time = deepcopy(BASE)
    wrong_time["created"][0]["time"] = "2026-10-13T15:00:00+08:00"
    duplicate = deepcopy(BASE)
    duplicate["created"] *= 2
    unauthorized = deepcopy(BASE)
    unauthorized["authorized"] = False
    missing = deepcopy(BASE)
    del missing["conflict_completed_ms"]
    false_reply = deepcopy(BASE)
    false_reply.update(created=[], write_failed=True, said_success=True)
    cases = [
        ("state_only", no_check, False, "PASS", "required_checks"),
        ("critical_missing", no_check, True, "FAIL", "critical_procedure"),
        ("correct", BASE, True, "PASS", "required_checks"),
        ("late_check", late_check, True, "FAIL", "critical_procedure"),
        ("wrong_time", wrong_time, True, "FAIL", "final_state"),
        ("duplicate", duplicate, True, "FAIL", "final_state"),
        ("unauthorized", unauthorized, True, "FAIL", "authorization"),
        ("missing_evidence", missing, True, "INSUFFICIENT_EVIDENCE", "missing:conflict_completed_ms"),
        ("false_confirmation", false_reply, True, "FAIL", "final_state,false_confirmation"),
    ]
    for name, record, critical, expected, reason in cases:
        actual = assess(record, critical)
        if actual != (expected, reason):
            raise AssertionError((name, actual, expected, reason))
        print(f"{name}: {actual[0]} ({actual[1]})")
    print(f"self_check: {len(cases)}/{len(cases)}; scope=constructed_local_records")


if __name__ == "__main__":
    run_examples()
在文件所在目录运行:
bash
python3 reminder_check.py2026 年 10 月 13 日,本地 Python 3 实际运行该文件,退出码为 0,标准错误为空。下面是当次标准输出,不是计划输出或生成的设备日志:
text
state_only: PASS (required_checks)
critical_missing: FAIL (critical_procedure)
correct: PASS (required_checks)
late_check: FAIL (critical_procedure)
wrong_time: FAIL (final_state)
duplicate: FAIL (final_state)
unauthorized: FAIL (authorization)
missing_evidence: INSUFFICIENT_EVIDENCE (missing:conflict_completed_ms)
false_confirmation: FAIL (final_state,false_confirmation)
self_check: 9/9; scope=constructed_local_records
输出中的 FAIL 是案例本身违反了合同,不是脚本执行失败;自检同时比较预期标签和具体失败原因,任何一个不符都会抛出异常,使命令非零退出。因而 9/9 的含义是九个构造案例都得到了约定结果,不是九次真实语音请求全部成功。
其中最有用的是第一组对照:最终提醒和授权相同,state_only 允许不同工具路径,因此通过;产品把查冲突设为不可省略条件后,critical_missing 失败。第三条保留工具准确度 0.5,但状态、授权与先后关系均符合本例合同,所以通过。这三条结果把诊断与通过条件分开的主张,变成了能修改输入、观察标签变化的本地实验。
late_check 进一步区分"调用过"和"在写入前完成":即使最终状态正确,250 毫秒才完成检查、200 毫秒已开始写入,也违反顺序要求。wrong_time 与 duplicate 则让过程顺序保持正确,仅更改最终对象,分别暴露旧时间和重复对象。unauthorized 说明正确结果不能抵消权限失败;false_confirmation 同时返回状态与播报矛盾的原因,而不是只保留一个笼统失败标签。
剩下的 missing_evidence 是一个容易混淆的边界:证据字段缺失时,不能判通过,也不能声称已观察到漏查。程序单独输出证据不足,让补采集和修业务流程成为两条不同处理路线。在批量统计中,证据不足需要单列,不能悄悄并入成功数,也不应当作已经定位根因的模型失败样本。
这些反例还有诊断上的用途。如果移除 critical_procedure 判断,第二条和第四条应失败的案例就会被放行;如果只检查提醒时间,重复对象仍可能漏过;如果把 tool_accuracy 当通过阈值,第三条又会被误拒。读者修改代码后重跑九条案例,可以判断自己是否丢掉了某种约束。这比只放一条正确输入更能说明判定器到底守住了什么。
真正接入时,先将后端前后状态投影为本任务新增对象,再从完整调用链取出检查完成、写入开始与业务结果,最后填写授权和播报证据。不能直接把转写、工具请求开始或一句"已设好"投影成成功写入。跨进程时间不可直接比较时,应使用能证明因果顺序的事件关联;本例没有实现分布式追踪、重试去重或并发冲突控制,需要由应用保证投影语义。
另外,脚本没有验证用户说话是否被正确识别、设备是否真的播放,也不防止"检查之后、写入之前"其他请求改变冲突状态。若产品需要原子的冲突检查与写入,数据库事务或后端接口仍应承担这一职责。通过离线规则自检,只说明对给定记录能分辨约定条件;要证明真实任务通过,仍须获得那次运行的实际记录。图里的待填项因此继续保留,新增加的验证结果只属于这一段本地程序。
所以,看到 Passed 与 1/2 并列时,第一步应当打开该次报告的必选检查,再看所用模式与场景定义。诊断分数告诉你哪里偏离了预期;通过标签是否值得采用,取决于不可省略条件是否进入判定,以及对应的观察证据是否确实取得。本文交付的是这一条待填记录,不是产品上线、用户留存或定制硬件投资的验证结论。
来源与核对范围
Footnotes
-
OpenAI,GPT-Live evaluation guide,2026-10-12 核对 Metrics 与 Results report;公开示例不是本次复现。 ↩ ↩2
-
OpenAI,公开运行结果 JSON。本次只用本地标准库读取并核对已发布字段,未调用评估 API。 ↩
-
OpenAI Cookbook,固定 commit 的 RUN graders、同 commit 的
shared/grading/outcomes.py与shared/scenarios.py。核对日期 2026-10-12;源码阅读,不是运行 harness。 ↩ -
LiveKit,Debugging and testing overview、Agent Simulations,2026-10-12 核对文本与音频范围,不据此声称当前配件可用。 ↩