文章目录
-
- [1. 先把问题讲清楚:为什么需要 MoE](#1. 先把问题讲清楚:为什么需要 MoE)
- [2. Dense FFN 和 MoE FFN 的结构差异](#2. Dense FFN 和 MoE FFN 的结构差异)
- [3. MoE 公式怎么读](#3. MoE 公式怎么读)
- [4. 用代码模拟 top-k routing](#4. 用代码模拟 top-k routing)
- [5. 负载均衡:不能所有 token 都挤到一个专家](#5. 负载均衡:不能所有 token 都挤到一个专家)
- [6. 容量因子:专家最多接多少 token](#6. 容量因子:专家最多接多少 token)
- [7. Token dispatch:MoE 为什么会有通信成本](#7. Token dispatch:MoE 为什么会有通信成本)
- [8. 总参数、激活参数、显存、通信要分开](#8. 总参数、激活参数、显存、通信要分开)
- [9. MoE 微调要注意什么](#9. MoE 微调要注意什么)
- [10. 什么时候适合 MoE](#10. 什么时候适合 MoE)
- [11. 常见误区](#11. 常见误区)
- [12. 小结](#12. 小结)
- 大模型视角
- 下一篇
摘要:MoE(Mixture of Experts,专家混合)是现代大模型中常见的稀疏架构。它的核心不是让模型里出现人类意义上的"法律专家、医学专家",而是把 Transformer 中的部分 FFN 替换为多个专家网络,并用 router 为每个 token 选择少数专家。这样可以提高总参数容量,同时控制每 token 的计算量。本文会从 dense FFN 的瓶颈讲起,拆解 top-k routing、路由权重、负载均衡、容量因子、token dispatch、专家并行、显存和通信成本,并给出可运行的小代码帮助你理解 MoE 为什么强、为什么难部署。
- 前置知识:专栏一 Transformer、分布式训练、优化器;专栏二 DeepSeek、第 35 篇 Mixtral
- 阅读时间:60-75 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释 MoE 和 dense FFN 的区别,能理解 router、top-k、负载均衡和容量因子,能判断 MoE 部署、训练和微调风险
1. 先把问题讲清楚:为什么需要 MoE
Transformer block 里通常有两大核心模块:Attention 和 FFN。Attention 负责读取上下文,FFN 负责对每个 token 的表示做非线性变换。很多大模型的参数大量集中在 FFN 中。
如果想增强模型能力,最直接的办法是把 FFN 做大。但 dense FFN 有一个问题:每个 token 都要经过同一个大 FFN,参数越多,每 token 计算越贵。
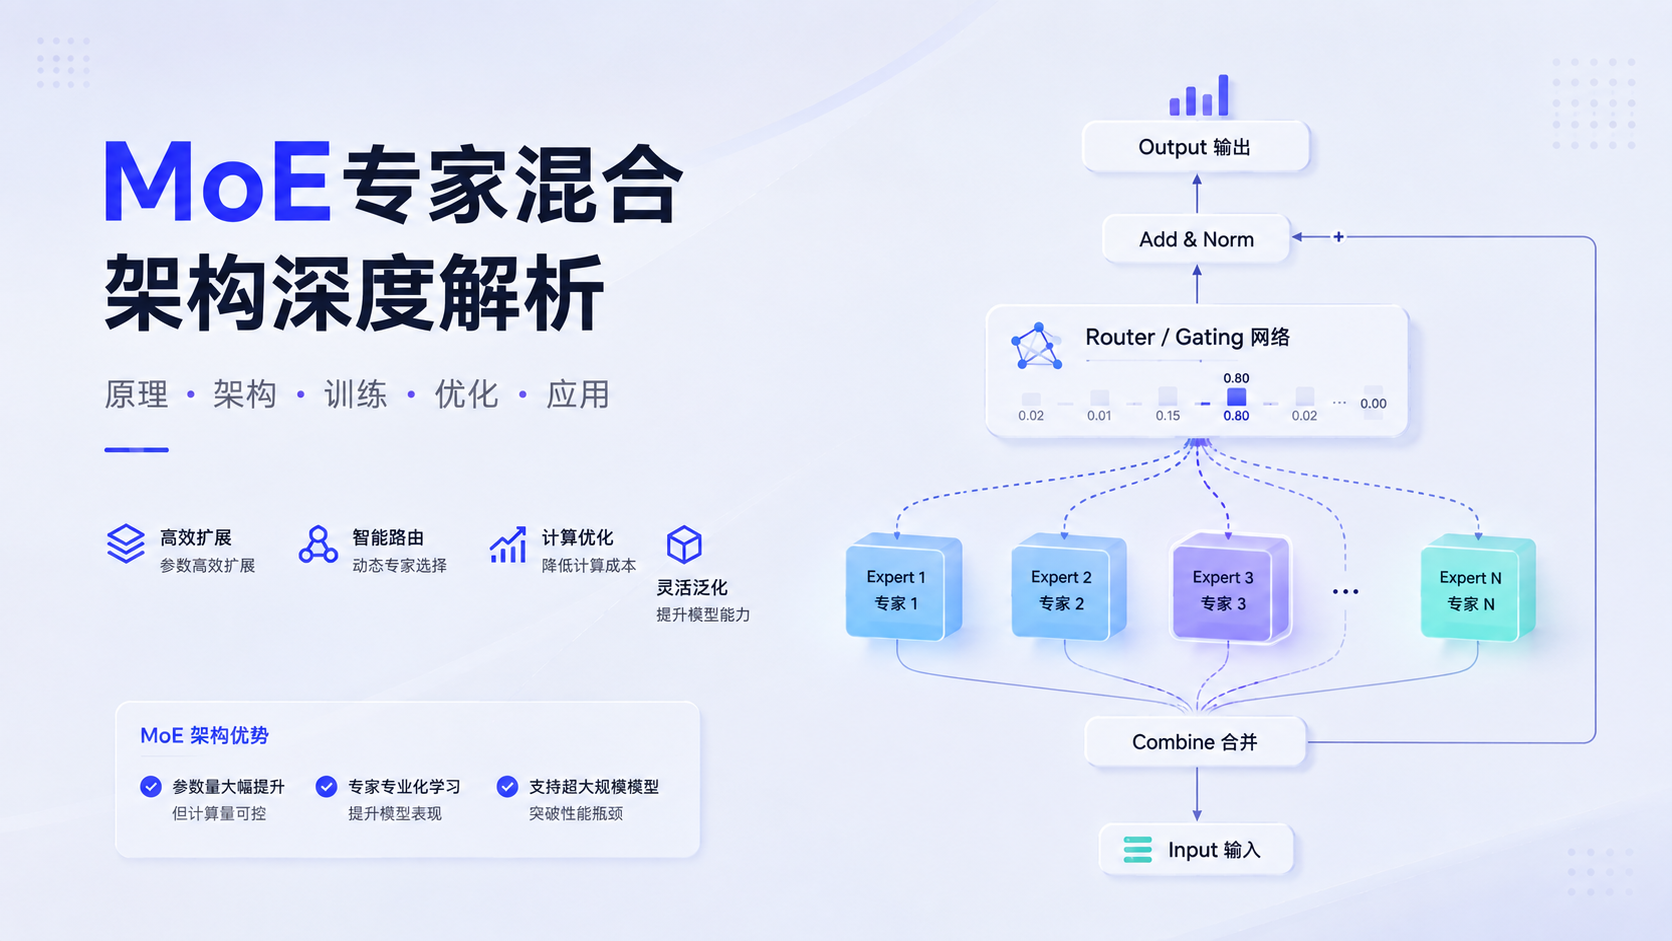
MoE 的思路是:
text
准备多个 FFN 专家;
每个 token 只选择其中少数几个专家;
总容量变大,但单 token 计算相对可控。
这叫稀疏激活。模型有很多参数,但每次只激活一部分。
一个类比:公司有很多专业小组,但每个工单不会发给所有小组,只会由调度系统分给最相关的几个小组处理。MoE 里的 router 就像调度系统,专家就是不同 FFN 分支。
2. Dense FFN 和 MoE FFN 的结构差异
Dense Transformer block 可以简化成:
text
x -> Attention -> FFN -> outputMoE Transformer block 通常把部分 FFN 换成专家集合:
text
x -> Attention -> Router -> TopK Experts -> Combine -> outputDense FFN 对每个 token 都使用同一套参数;MoE FFN 对不同 token 可能选择不同专家。
| 维度 | Dense FFN | MoE FFN |
|---|---|---|
| 参数容量 | 一个 FFN | 多个专家 FFN |
| 每 token 计算 | 全部 FFN 都用 | 只用 top-k 专家 |
| 路由 | 不需要 | 需要 router |
| 负载均衡 | 不涉及 | 关键问题 |
| 分布式通信 | 相对简单 | 可能需要 all-to-all |
| 微调复杂度 | 较低 | router/专家/共享层都要考虑 |
MoE 的收益来自容量/计算折中,代价来自动态路由和系统复杂度。
3. MoE 公式怎么读
MoE 层可以简化写成:
y = ∑ i ∈ TopK ( r ( x ) ) p i E i ( x ) y = \sum_{i \in \text{TopK}(r(x))} p_i E_i(x) y=i∈TopK(r(x))∑piEi(x)
先用大白话说一遍:router 看一下 token 表示 x x x,给每个专家打分;选出分数最高的 k 个专家;这些专家分别处理 token;最后按权重把专家输出加起来。
逐项解释:
- x x x:某个 token 的隐藏表示;
- r ( x ) r(x) r(x):router,对每个专家打分;
- E i E_i Ei:第 i i i 个专家网络,通常是 FFN;
- TopK \text{TopK} TopK:只选择得分最高的 k 个专家;
- p i p_i pi:被选专家的归一化权重;
- y y y:MoE 层输出。
注意:专家不是人类可解释的领域专家。它们是训练出来的计算分支,可能学到某些模式,但不一定对应"代码专家""法律专家"这种标签。
4. 用代码模拟 top-k routing
下面用随机 router 分数模拟 top-k 路由。真实模型的 router 是可学习网络,这里只看机制。
python
# Python 3.10+
import math
import random

random.seed(0)


def softmax(values):
    m = max(values)
    exps = [math.exp(v - m) for v in values]
    total = sum(exps)
    return [v / total for v in exps]

num_tokens = 6
num_experts = 4
top_k = 2

for token_id in range(num_tokens):
    scores = [random.uniform(-1, 1) for _ in range(num_experts)]
    probs = softmax(scores)
    selected = sorted(enumerate(probs), key=lambda x: x[1], reverse=True)[:top_k]
    print("token", token_id, "probs", [round(p, 2) for p in probs], "->", selected)
这个输出会显示:不同 token 可能选择不同专家。这就是 MoE 的稀疏性来源。
实际训练中,router 学得好不好非常关键。router 太随机,专家学不到稳定分工;router 太偏,少数专家过载,其他专家浪费。
5. 负载均衡:不能所有 token 都挤到一个专家
如果 router 总是选择同一个专家,会出现两个问题:
text
1. 热门专家过载,吞吐下降;
2. 冷门专家很少被训练,参数浪费。
因此 MoE 通常需要负载均衡损失或路由约束,让 token 分布不要太极端。
用代码统计专家负载:
python
# Python 3.10+
from collections import Counter

assignments = [0, 1, 1, 1, 2, 1, 3, 1, 2, 1, 0, 0]
num_experts = 4
counts = Counter(assignments)
loads = [counts[i] for i in range(num_experts)]
print("loads:", loads)
print("max/min ratio:", round(max(loads) / max(min(loads), 1), 2))
负载均衡不只是训练细节。推理时如果大量 token 都跑到同一专家,那张 GPU 或那个专家分片会成为瓶颈,整个 batch 都要等它。
6. 容量因子:专家最多接多少 token
MoE 的动态路由会带来一个工程问题:一个 batch 里某个专家可能被太多 token 选中。系统通常会给每个专家设置容量。
容量可以粗略写成:
capacity = ⌈ tokens experts × capacity factor ⌉ \text{capacity} = \left\lceil \frac{\text{tokens}}{\text{experts}} \times \text{capacity factor} \right\rceil capacity=⌈expertstokens×capacity factor⌉
逐项解释:
- tokens:当前 batch 中 token 总数;
- experts:专家数量;
- capacity factor:容量放大系数;
- capacity:每个专家最多处理的 token 数。
代码:
python
# Python 3.10+
import math


def expert_capacity(num_tokens, num_experts, capacity_factor):
    return math.ceil(num_tokens / num_experts * capacity_factor)

for cf in [1.0, 1.25, 1.5, 2.0]:
    print(cf, expert_capacity(1024, 8, cf))
容量太小,部分 token 可能被丢弃、退化处理或重路由;容量太大,显存和计算浪费。MoE 的工程难点就在这种动态性:输入分布一变,路由和负载也会变。
7. Token dispatch:MoE 为什么会有通信成本
在多 GPU 部署中,不同专家可能放在不同设备上。一个 batch 的 token 经过 router 后,需要按专家重新分组,发送到对应设备,计算后再合并回原顺序。
流程:
text
token batch -> router scores -> top-k experts -> dispatch to expert devices -> expert FFN -> combine -> original order用小例子模拟分桶:
python
# Python 3.10+
from collections import defaultdict

token_to_experts = {
    "t0": [1, 2],
    "t1": [0, 1],
    "t2": [2, 3],
    "t3": [1, 3],
}

buckets = defaultdict(list)
for token, experts in token_to_experts.items():
    for expert in experts:
        buckets[expert].append(token)

for expert, tokens in sorted(buckets.items()):
    print("expert", expert, "receives", tokens)
真实系统里,这个 dispatch 可能对应跨 GPU all-to-all 通信。网络互联越慢、专家分布越不均,MoE 越难发挥理论优势。
8. 总参数、激活参数、显存、通信要分开
MoE 讨论里最容易混淆四个概念:
| 概念 | 含义 | 常见误解 |
|---|---|---|
| 总参数 | 所有专家和共享层参数总和 | 总参数大不等于每 token 都算 |
| 激活参数 | 单 token 实际经过的专家参数 | 激活少不等于权重显存少 |
| 权重显存 | 部署时要加载或分片的参数 | MoE 仍可能需要大量显存 |
| 通信成本 | token 分发到专家再聚合 | 多卡 MoE 可能很贵 |
一个粗略计算:
python
# Python 3.10+

def ffn_params(hidden, ffn):
    return hidden * ffn + ffn * hidden


def moe_layer_params(hidden, ffn, num_experts, active_experts):
    one = ffn_params(hidden, ffn)
    return {
        "total": one * num_experts,
        "active_per_token": one * active_experts,
    }

for experts, active in [(8, 2), (16, 2), (64, 4)]:
    r = moe_layer_params(4096, 14336, experts, active)
    print(experts, active, "total_B=", round(r["total"]/1e9, 2), "active_B=", round(r["active_per_token"]/1e9, 2))
这段代码再次强调:MoE 的"总容量"和"每 token 计算"不是同一回事。
9. MoE 微调要注意什么
微调 MoE 比 dense 模型复杂,因为你要决定更新哪些部分:
text
1. 更新 router 吗?
2. 更新所有专家,还是部分专家?
3. LoRA 加在共享层、专家层,还是都加?
4. 小数据是否会让路由偏向少数专家?
5. 是否需要冻结 router 避免路由漂移?
6. 微调后负载是否变差?
7. 安全和通用能力是否退化?
小数据微调尤其要谨慎。少量领域数据可能让 router 过度偏向某些专家,导致专家负载和能力分布变化。评估时不能只看目标任务,还要看通用能力、路由分布和吞吐。
一个微调前后路由统计表很有价值:
| 指标 | 微调前 | 微调后 | 风险 |
|---|---|---|---|
| top 专家占比 | 18% | 45% | 路由过度集中 |
| 空闲专家数 | 0 | 3 | 参数浪费 |
| tokens/s | 1000 | 720 | 负载或通信变差 |
| 目标任务分 | 72 | 84 | 有收益 |
| 通用任务分 | 80 | 68 | 遗忘风险 |
没有路由监控,MoE 微调很容易只看见任务分涨,看不见系统成本恶化。
10. 什么时候适合 MoE
适合 MoE 的场景:
text
1. 需要更大模型容量;
2. 有多卡或推理集群支持;
3. 任务吞吐足够高,能摊薄调度复杂度;
4. 团队能监控路由、负载和通信;
5. 模型质量收益能抵消部署复杂度;
6. 有明确评估集,而不是只看参数规模。
不适合的场景:
text
1. 单卡小应用;
2. 极低延迟任务;
3. 团队没有推理调优经验;
4. 任务简单,小 dense 模型足够;
5. 需要频繁小数据微调但无法监控路由。
MoE 是提高能力/计算比的架构工具,不是所有项目的默认选择。
11. 常见误区
误区一:专家就是人类可解释领域专家。 专家分工来自训练,不一定对应法律、医学、代码等人类领域。
误区二:MoE 总参数大,所以一定更强。 能力还取决于数据、训练、路由、对齐和评估。
误区三:MoE 激活参数少,所以部署一定便宜。 权重显存、KV Cache、通信和调度仍然存在。
误区四:负载均衡只是训练细节。 负载不均会直接影响推理吞吐和稳定性。
误区五:MoE 微调和 dense 微调一样简单。 router、专家、共享层和负载都可能变化,必须额外监控。
12. 小结
MoE 用多个专家扩大模型总容量,用 router 为每个 token 选择少数专家,从而控制每 token 计算量。它的关键机制包括 top-k routing、路由权重、负载均衡、容量因子、token dispatch 和专家并行。
MoE 的工程价值在于容量/计算折中,工程代价是路由、显存、通信、负载和微调复杂度。是否选择 MoE,必须结合任务收益、部署能力和评估体系判断。
大模型视角
从大模型架构角度看,MoE 是 dense scaling 之外的重要路线。它让"模型更大"不再简单等于"每个 token 计算更贵",但把复杂度转移到了路由和系统层。理解 MoE,才能理解 DeepSeek、Mixtral 等模型为什么强调稀疏激活和专家并行。
下一篇
下一篇会讲 VLM,多模态模型如何把图片、截图、文档等视觉输入接入语言模型。