⭐️博主: 此生决int-@CSDN博客
** 速胜派就是最大的投降派!!!**
** 🔥热门专栏🔥**
文章目录
- [3. 进程概念](#3. 进程概念)
-
- [1. 冯诺依曼体系结构](#1. 冯诺依曼体系结构)
- [2. 操作系统(Operator System)](#2. 操作系统(Operator System))
- [3. 进程](#3. 进程)
-
- **定义与描述**:
- **查看与控制相关命令**:
- [`fork` 的三个经典问题](#
fork的三个经典问题) -
-
- 问题一:为什么父子进程要返回不同的值?
- 问题二:为什么一个函数看起来返回了两次?
- [问题三:一个变量为什么能让 `if/else` 同时成立?](#问题三:一个变量为什么能让
if/else同时成立?)
-
- 进程状态
- [3-2 进程状态](#3-2 进程状态)
-
- [3-2-1 Linux 内核源代码怎么说](#3-2-1 Linux 内核源代码怎么说)
- [3-2-2 进程状态查看](#3-2-2 进程状态查看)
- [3-2-3 Z(zombie)- 僵尸进程](#3-2-3 Z(zombie)- 僵尸进程)
- [3-2-4 僵尸进程危害------内存泄漏](#3-2-4 僵尸进程危害——内存泄漏)
- [3-2-5 孤儿进程](#3-2-5 孤儿进程)
- [3-3 进程优先级](#3-3 进程优先级)
-
- [3-3-1 基本概念](#3-3-1 基本概念)
- [3-3-2 查看系统进程](#3-3-2 查看系统进程)
- [3-3-3 PRI and NI](#3-3-3 PRI and NI)
- [3-3-4 PRI vs NI](#3-3-4 PRI vs NI)
- [3-3-5 查看进程优先级的命令](#3-3-5 查看进程优先级的命令)
- [3-3-6 补充概念 - 竞争、独立、并行、并发](#3-3-6 补充概念 - 竞争、独立、并行、并发)
- [3-4 进程切换](#3-4 进程切换)
- [3-4 Linux2.6 内核进程 O(1) 调度队列](#3-4 Linux2.6 内核进程 O(1) 调度队列)
-
- [3-4-1 一个 CPU 拥有一个 runqueue](#3-4-1 一个 CPU 拥有一个 runqueue)
- [3-4-2 优先级](#3-4-2 优先级)
- [3-4-3 活动队列](#3-4-3 活动队列)
- [3-4-4 过期队列](#3-4-4 过期队列)
- [3-4-5 active 指针和 expired 指针](#3-4-5 active 指针和 expired 指针)
- [3-4-6 总结](#3-4-6 总结)
- 下期预告
- 进程概念(下)
- 结语
上期回顾
大家好,这里是此生弃int(财哥) ,欢迎来到我的博客。上一篇我们主要学习了一些基础开发工具。包括Vim、 gcc/ G++、 Makefile、 Git版本管理和GDB调试等等 ,那么接下来我们就要开始学习真正的Linux系统部分了。包括进程、文件系统、基础I/O。今天我们来学习和认识进程!
3. 进程概念
1. 冯诺依曼体系结构
组成与分工:
-
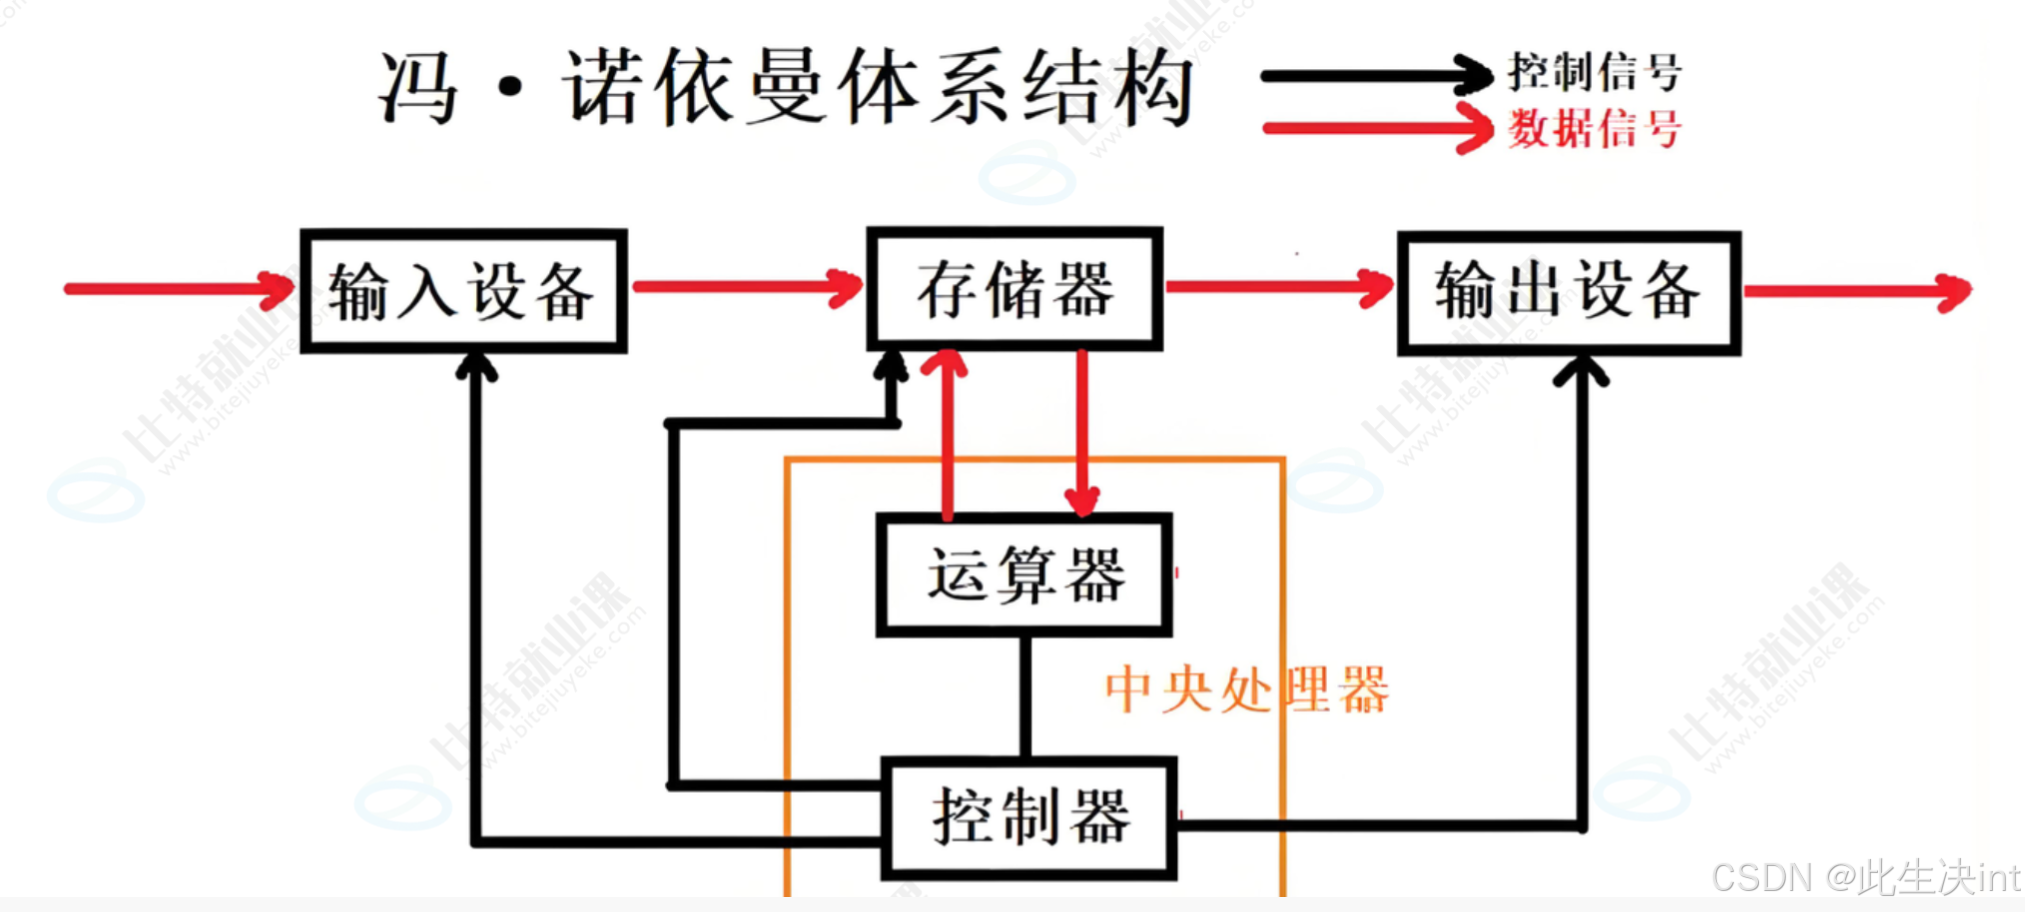
五大部件:输入设备、输出设备、存储器、运算器、控制器 ;运算器与控制器组成 CPU。
-
本节的存储器主要指内存:保存正在使用的程序和数据;磁盘属于外存,用于持久保存。
-
输入/输出按数据方向划分;网卡接收时是输入设备,发送时是输出设备;磁盘也可读、可写。
数据流与效率:
-
简化模型:
输入设备 → 内存 → CPU → 内存 → 输出设备;外设间传输:外设 A → 内存 → 外设 B。 -
因此可以看出:内存是主要的数据交换中心 ;"CPU 只与内存打交道"这虽然只是一句是教学抽象,不是对实际硬件 I/O 的绝对限制。但是很好的概括了这一点。
-
CPU、内存、外设速度差异巨大;寄存器访问极快,外设延迟依设备与操作而异,不能一概视为毫秒级。
-
拷贝:把数据从一处复制到另一处;整体效率不仅取决于 CPU,也取决于数据传输、拷贝和等待开销。
重点:设备速度差异巨大,体系结构的效率很大程度上取决于设备之间的拷贝效率。
总之就是,一切都要与内存打交道,都要先进入内存。CPU和内存之间交数据交换非常快,但是内存与其他外部设备交换速度非常慢。所以总体的速率不仅与CPU有关,还与内存与其他设备之间的数据传输速度有关。
存储层次 :
存储金字塔:
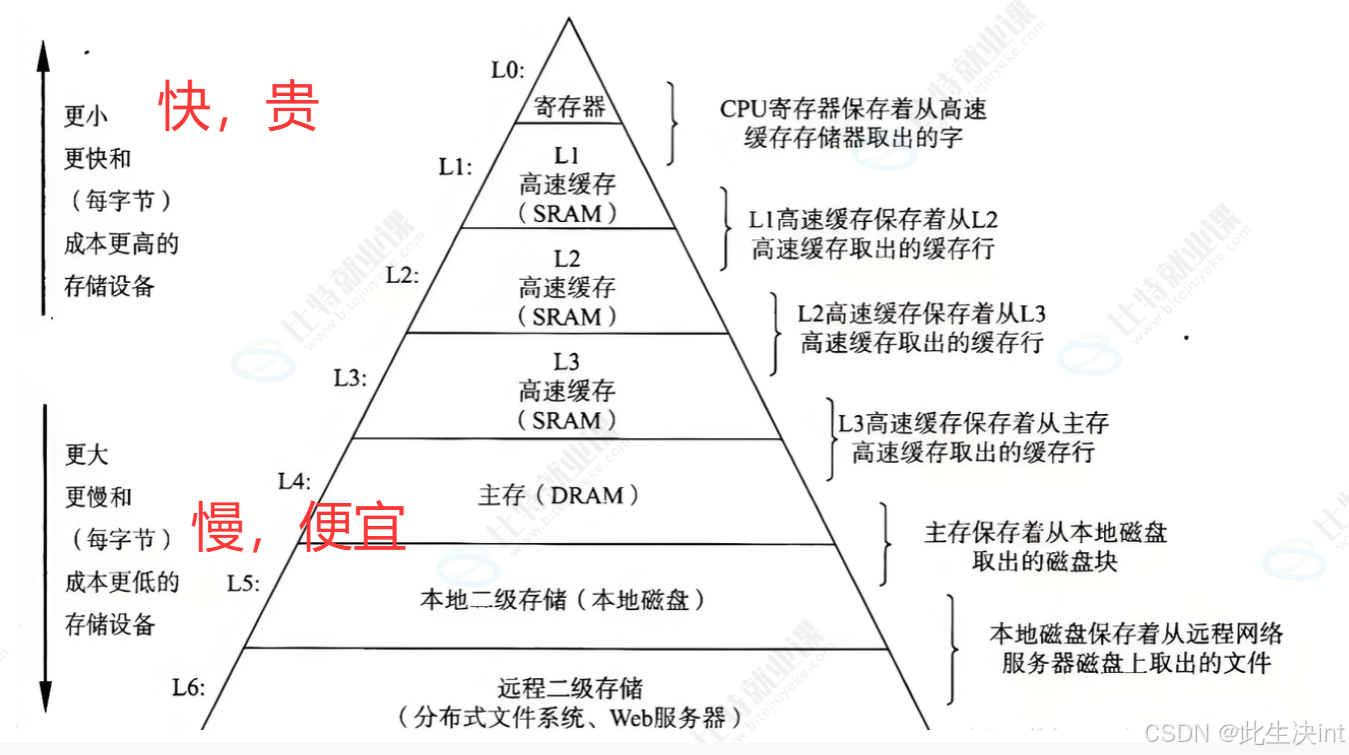
| 从快到慢的典型层次 | 特点 |
|---|---|
| 寄存器 | CPU 内部;容量极小,访问最快 |
高速缓存 L1 → L2 → L3 |
通常使用 SRAM;保存近期可能再使用的数据;一般 L1 最快 |
| 内存 DRAM | 保存运行中的程序与数据;容量较大、成本较低 |
| 磁盘 | 长期存储,断电后通常保留数据 |
| 网盘 | 远程服务器存储;访问受网络影响 |
- 越靠上,通常速度越快、单位容量成本越高、容量越小;SRAM 为静态随机存取存储器,DRAM 为动态随机存取存储器。
跨主机通信:
- QQ 文字:
A 键盘 → A 内存 → A 网卡 → 网络 → B 网卡 → B 内存 → B 显示器。 - 文件传输:
A 磁盘 → A 内存 → A 网卡 → 网络 → B 网卡 → B 内存 → B 磁盘。 - 两台主机各有自己的体系结构;上述为简化数据路径,省略 CPU 处理等环节。
2. 操作系统(Operator System)
定位与目的:
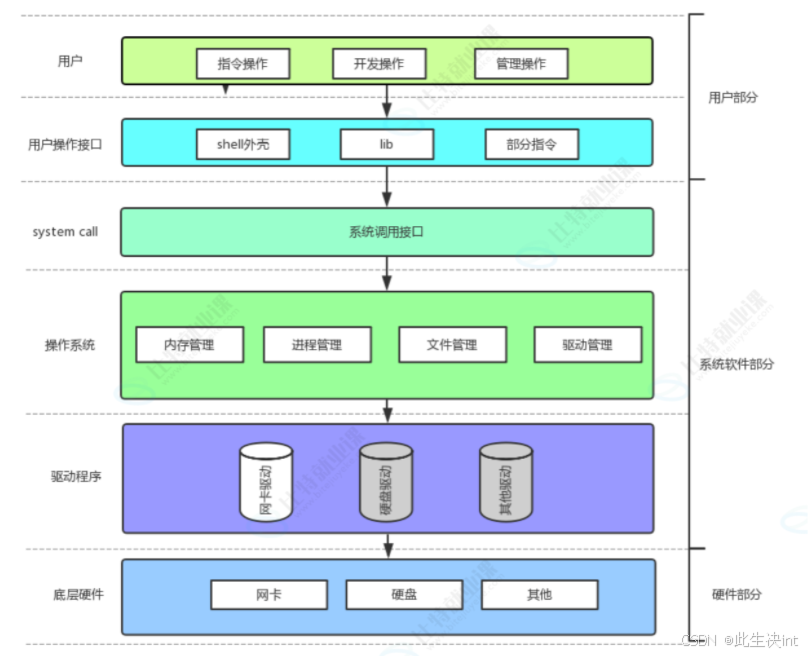
OS 的英文全称为 Operating System;操作系统的本质定位:它不是某个具体应用,而是负责统一管理计算机资源的软件。
-
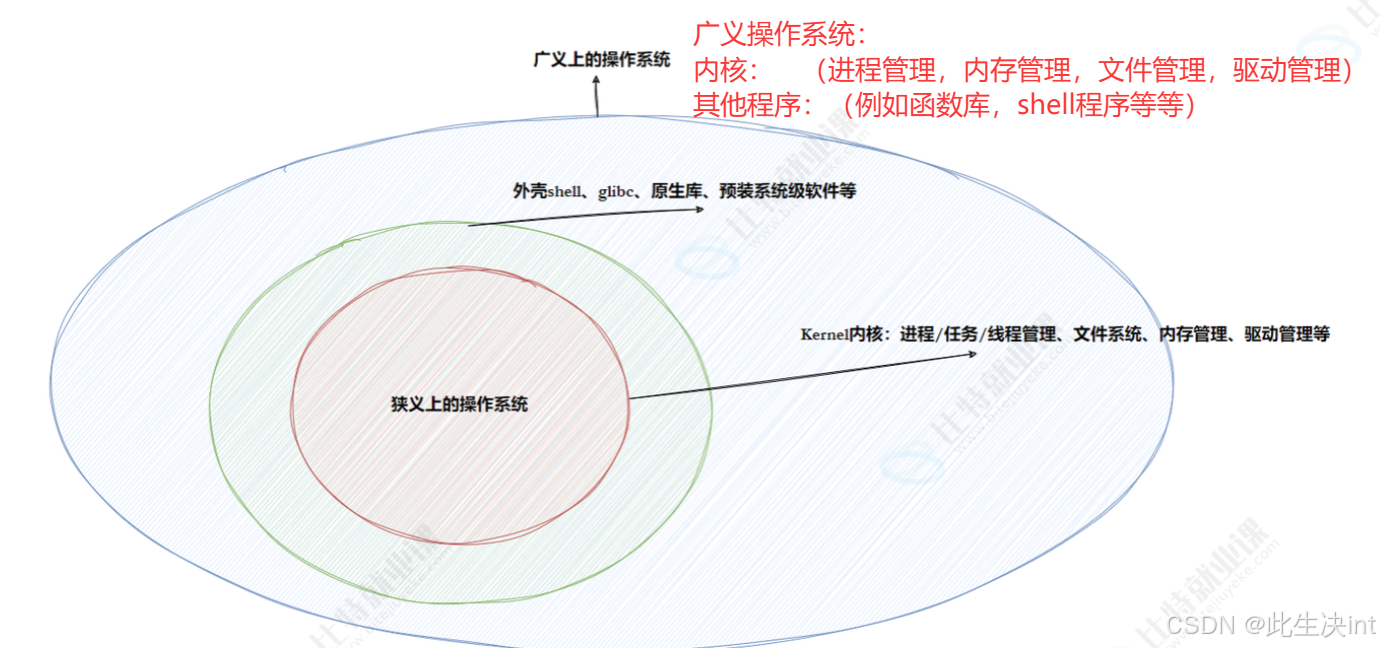
狭义 OS=内核;广义 OS=内核+shell、函数库、系统工具等配套软件。
-
内核负责进程、内存、文件、设备等管理;shell 解释命令;
glibc是 Linux 常用的 C 函数库;驱动负责具体硬件控制。 -
总之,操作系统,对下管理资源是手段,对上为用户提供统一、方便、安全的程序执行环境是目的。
整体
管理方法:
- 管理依据是描述对象的数据;信息可由中间层获取,操作由内核模块、驱动等执行。
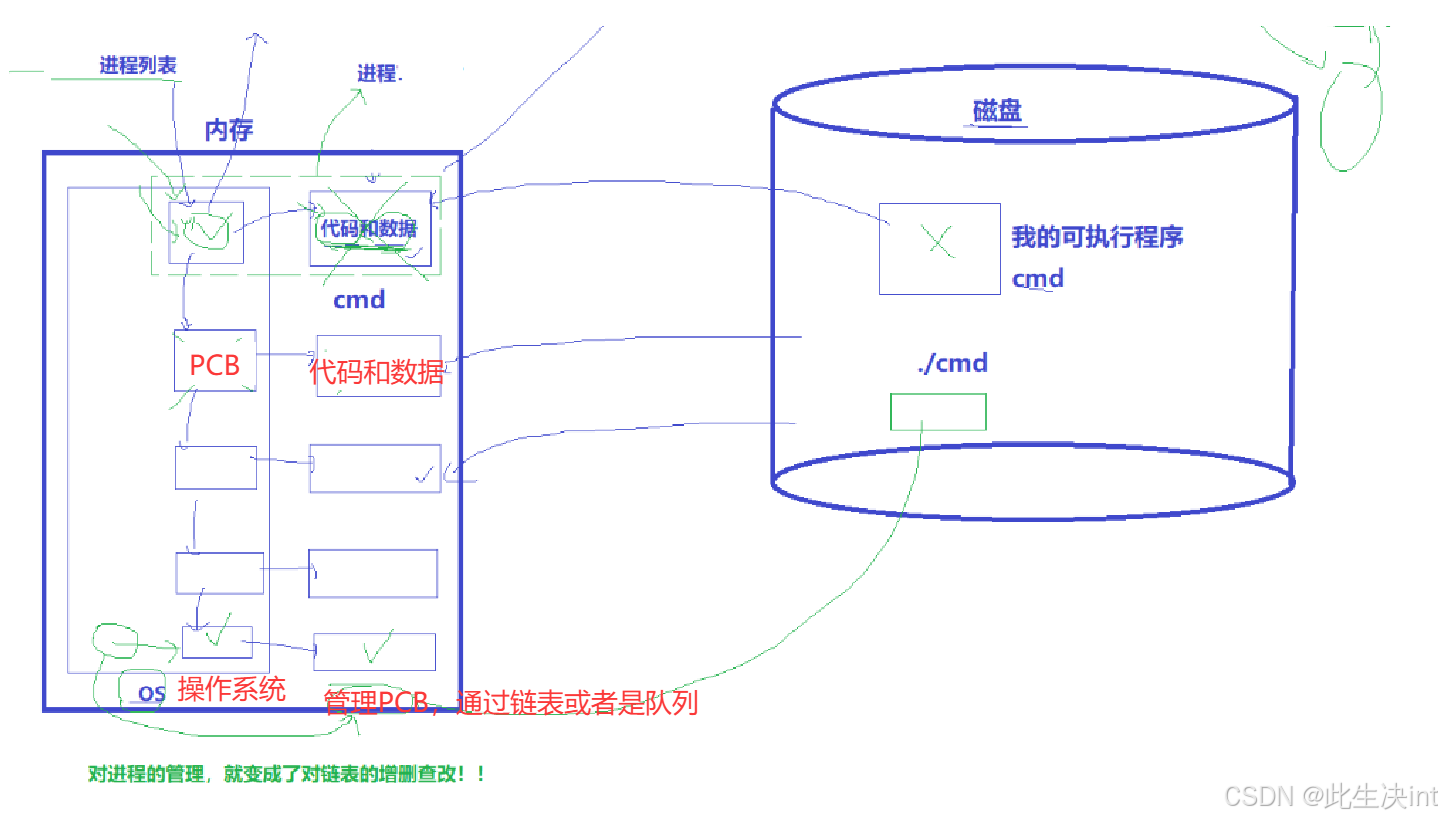
- 先描述,再组织:结构体记录对象信息,链表、队列等组织多个对象;管理落到数据结构的增、删、查、改。
- 进程描述结构为 PCB,在Linux上是
task_struct;组织方式包括进程链表、调度队列、等待队列。
访问层次: - 典型路径:
用户程序 / shell → 库函数或系统调用接口 → 内核 → 驱动 → 硬件;库函数不是必经层。 - 系统调用是用户程序请求内核服务的正式入口;关注服务、参数、返回值;内核检查地址、权限、资源及参数合法性。
例如:printf 是格式化输出库函数:写入标准输出 stdout;通常连接终端,也可重定向到文件;实际输出时通常借助系统调用,可能先经过用户态缓冲。
库函数与系统调用:
| 对比项 | 库函数 | 系统调用 |
|---|---|---|
| 所在层次 | 用户态函数库 | 内核提供的服务接口 |
| 作用 | 提供便捷封装、格式化等功能 | 请求受保护的系统服务 |
| 是否进入内核 | 不一定 | 会 |
| 关系 | 可能封装一个或多个系统调用 | 由内核处理请求 |
| 跨平台 | 标准库接口可屏蔽部分差异 | 不同 OS 的接口可能不同 |
3. 进程
定义与描述:
- 课本视角:程序的一次执行实例;资源视角:操作系统分配资源的实体。
进程=内核管理数据结构+自己的代码和数据;
- 一般用PCB描述,Linux 用
task_struct描述进程,用户程序不能任意直接修改它。 - 管理不只是操作一条链表,还涉及调度队列、地址空间、文件资源等。
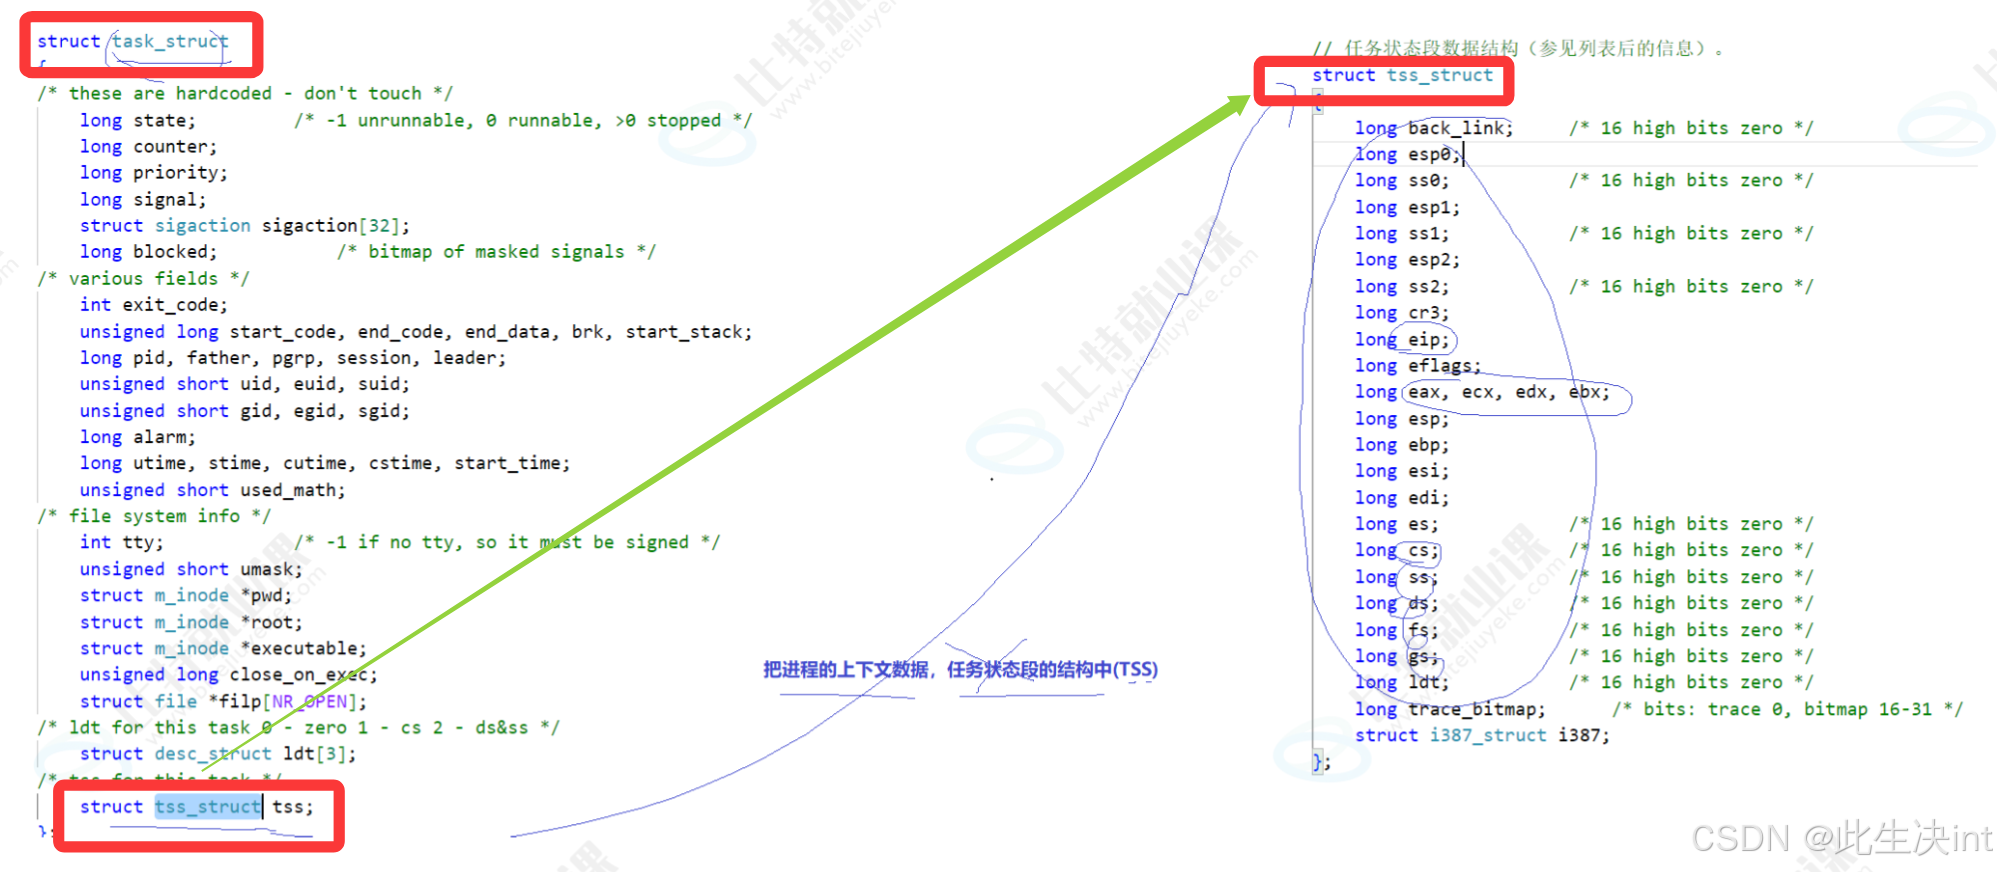
task_struct 相关信息 |
作用 |
|---|---|
| 标识符 | PID 区分进程,PPID 表示父进程 |
| 状态、优先级 | 表示运行条件与调度属性 |
| 程序计数器、上下文 | 保存执行位置、寄存器现场 |
| 内存管理信息 | 关联代码、数据、地址空间 |
| I/O 状态 | 关联打开的文件、等待的事件 |
| 记账信息 | 记录 CPU 时间等资源使用情况 |
查看与控制相关命令:
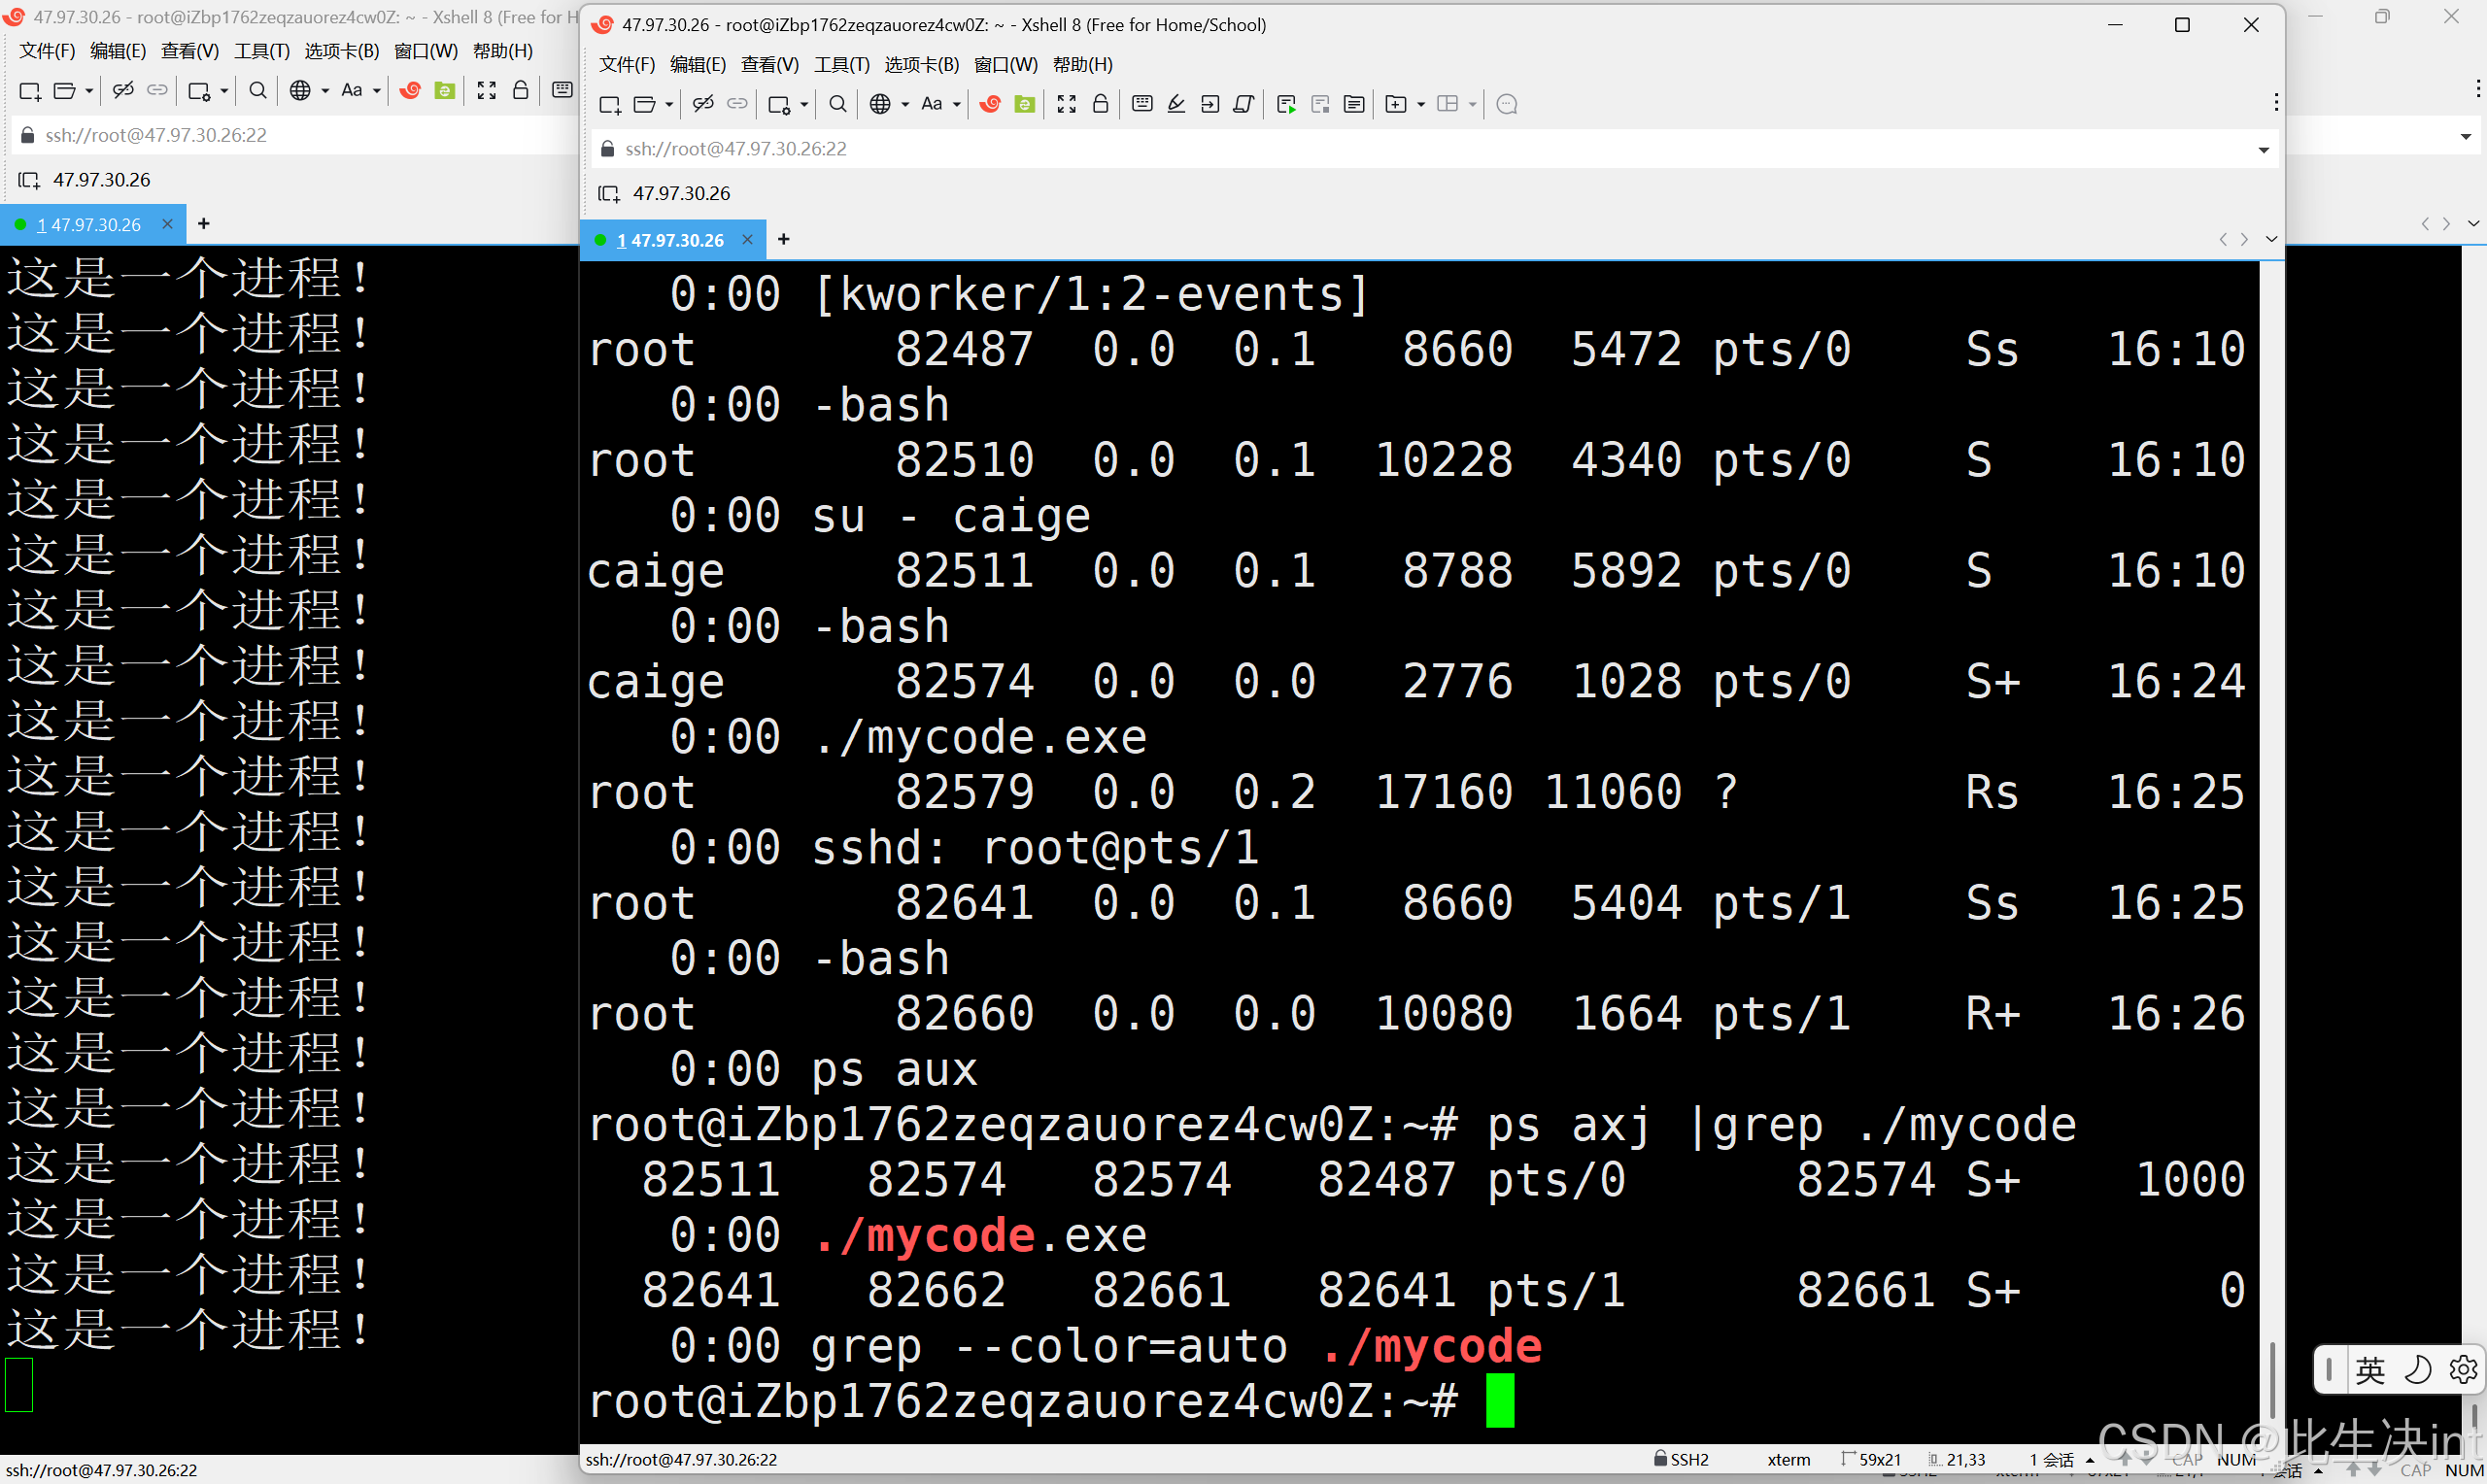
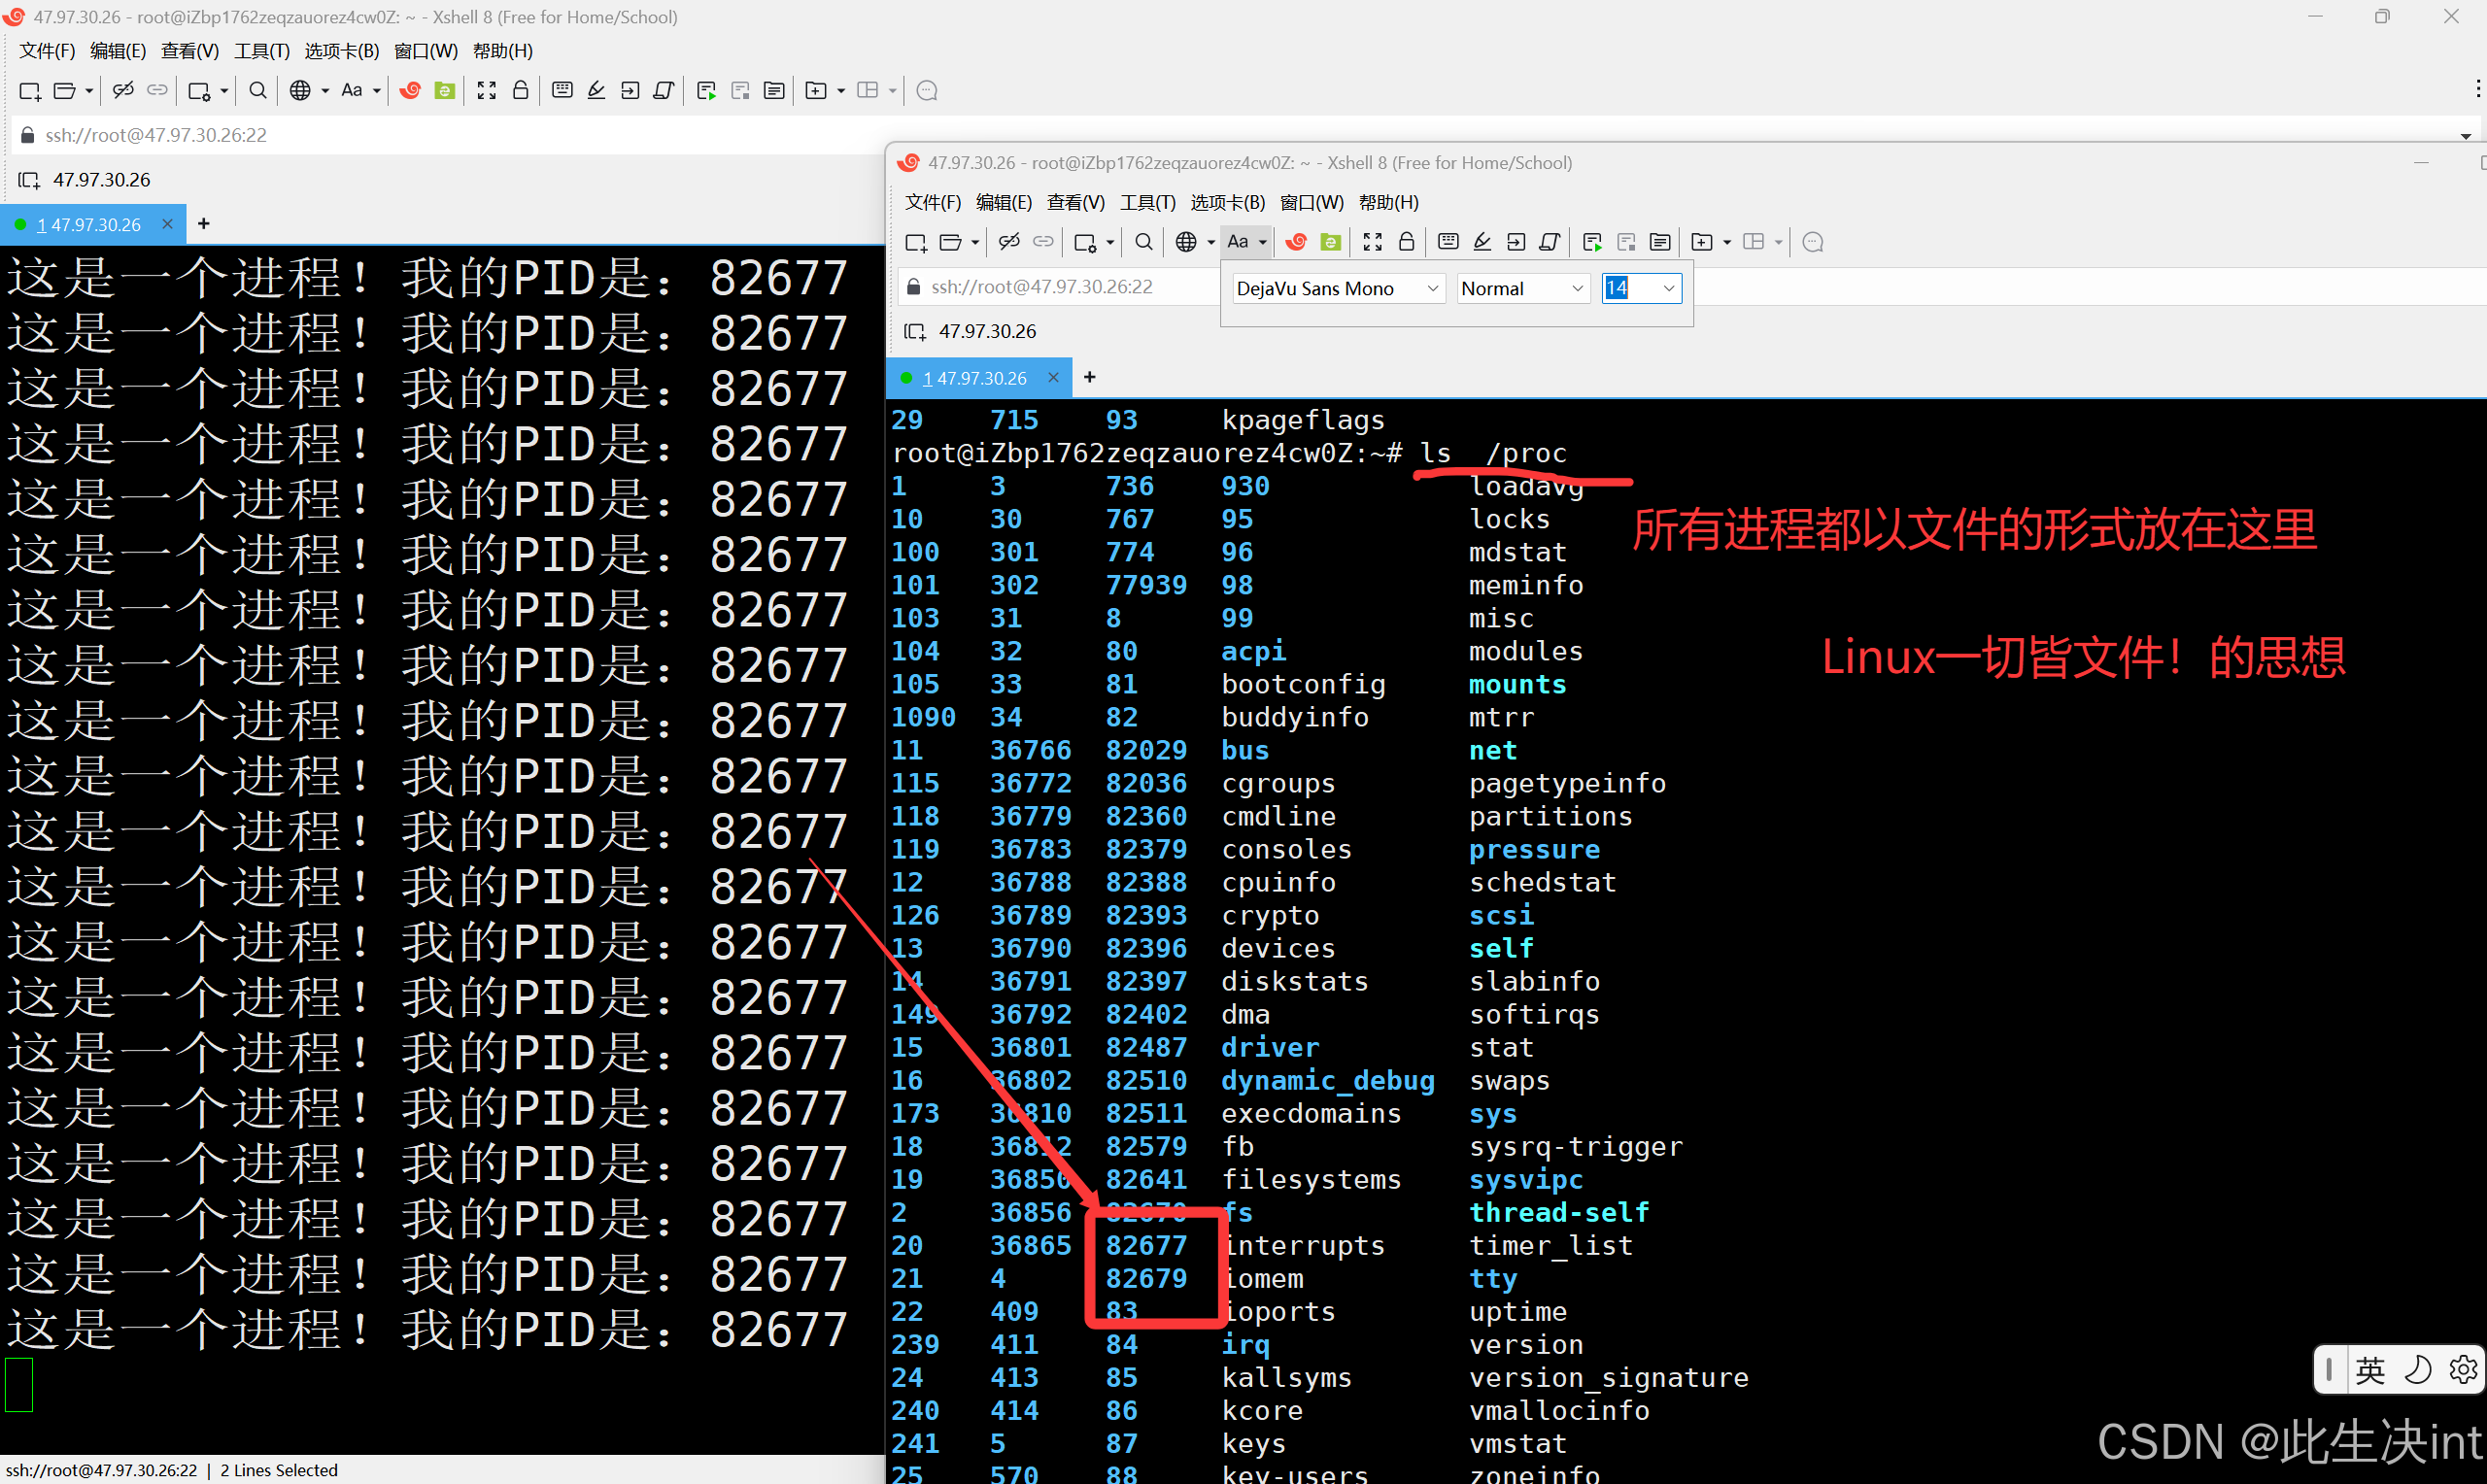
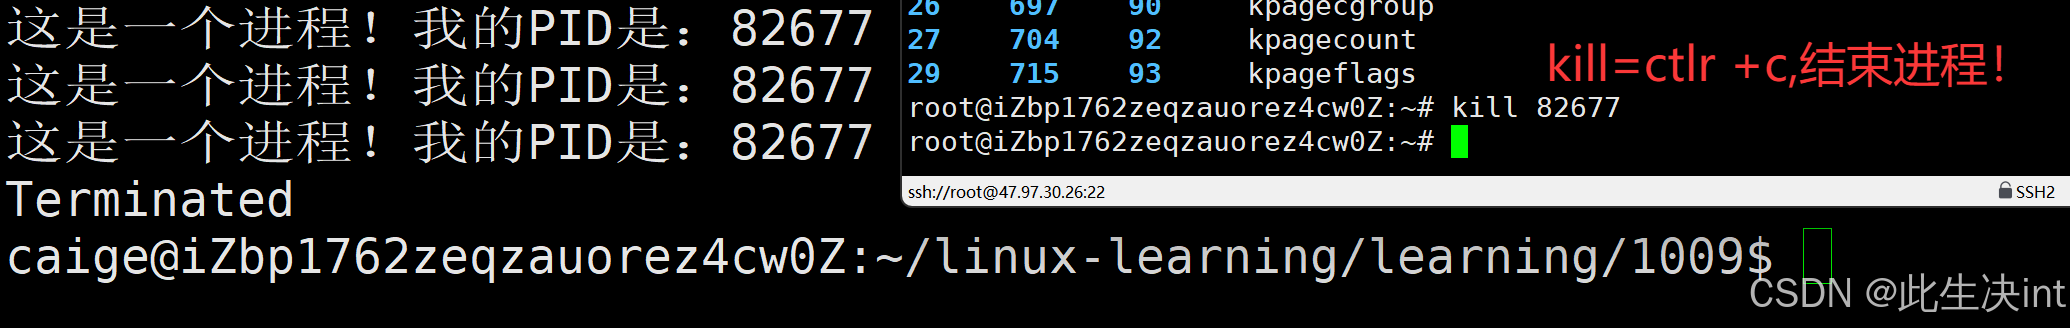
ps aux:用户格式查看进程;a扩展到其他用户的终端进程,x包含无终端进程,u使用用户格式。ps axj:作业格式查看 PID、PPID、进程组等;j表示作业格式;状态见STAT列。/proc:内核动态生成信息的虚拟文件系统;ls -l /proc/PID/查看进程信息,ls -l /proc/PID/exe查看可执行文件链接,ls -l /proc/PID/cwd查看当前工作目录链接。kill的本质是发送信号,不一定终止进程。
| 操作 | 信号与效果 |
|---|---|
Ctrl+C |
向终端前台进程组发送 SIGINT,默认终止 |
kill -9 PID |
向指定进程发送 SIGKILL,不可捕获、阻塞或忽略;D 状态下可能延迟生效 |
kill -STOP PID |
暂停进程 |
kill -CONT PID |
继续运行 |
查看pid,身份接口:
- 头文件
<unistd.h>;pid_t为进程 ID 类型。 pid_t getpid(void):无参数,返回当前 PID;pid_t getppid(void):无参数,返回当前父进程 PID。man 2 getpid、man 2 getppid:查看第 2 区系统调用手册。- 命令行启动的普通外部程序,其父进程通常是当前 shell,如
bash。
fork 接口与执行流:
- 头文件
<unistd.h>;原型pid_t fork(void):无参数,以调用进程为模板创建子进程。
| 结果 | 父进程返回值 | 子进程返回值 |
|---|---|---|
| 成功 | 子进程 PID,正数 | 0 |
| 失败 | -1 |
不创建子进程 |
c
pid_t ret = fork();                 // 一次调用,成功后两个进程继续执行
if (ret < 0) return 1;              // 创建失败
if (ret == 0) {
    /* 子进程:ret 为 0 */         // 独立执行流
} else {
    /* 父进程:ret 为子进程 PID */ // 可据此管理子进程
}- 成功时建立子进程管理结构,初始化继承信息,加入管理结构与调度队列;父子都从
fork返回处继续,不会从main开头重跑。 - "返回两次"指两个进程各返回一次;父子分别拥有自己的
ret,不是同一进程中的if/else同时成立。 - 父子关系可为
1:n;父进程取得子 PID,子进程可通过getppid()获取父 PID。 - 父子执行先后由调度决定;
sleep只能影响时机,不是可靠同步。
关于进程最重要的理解:
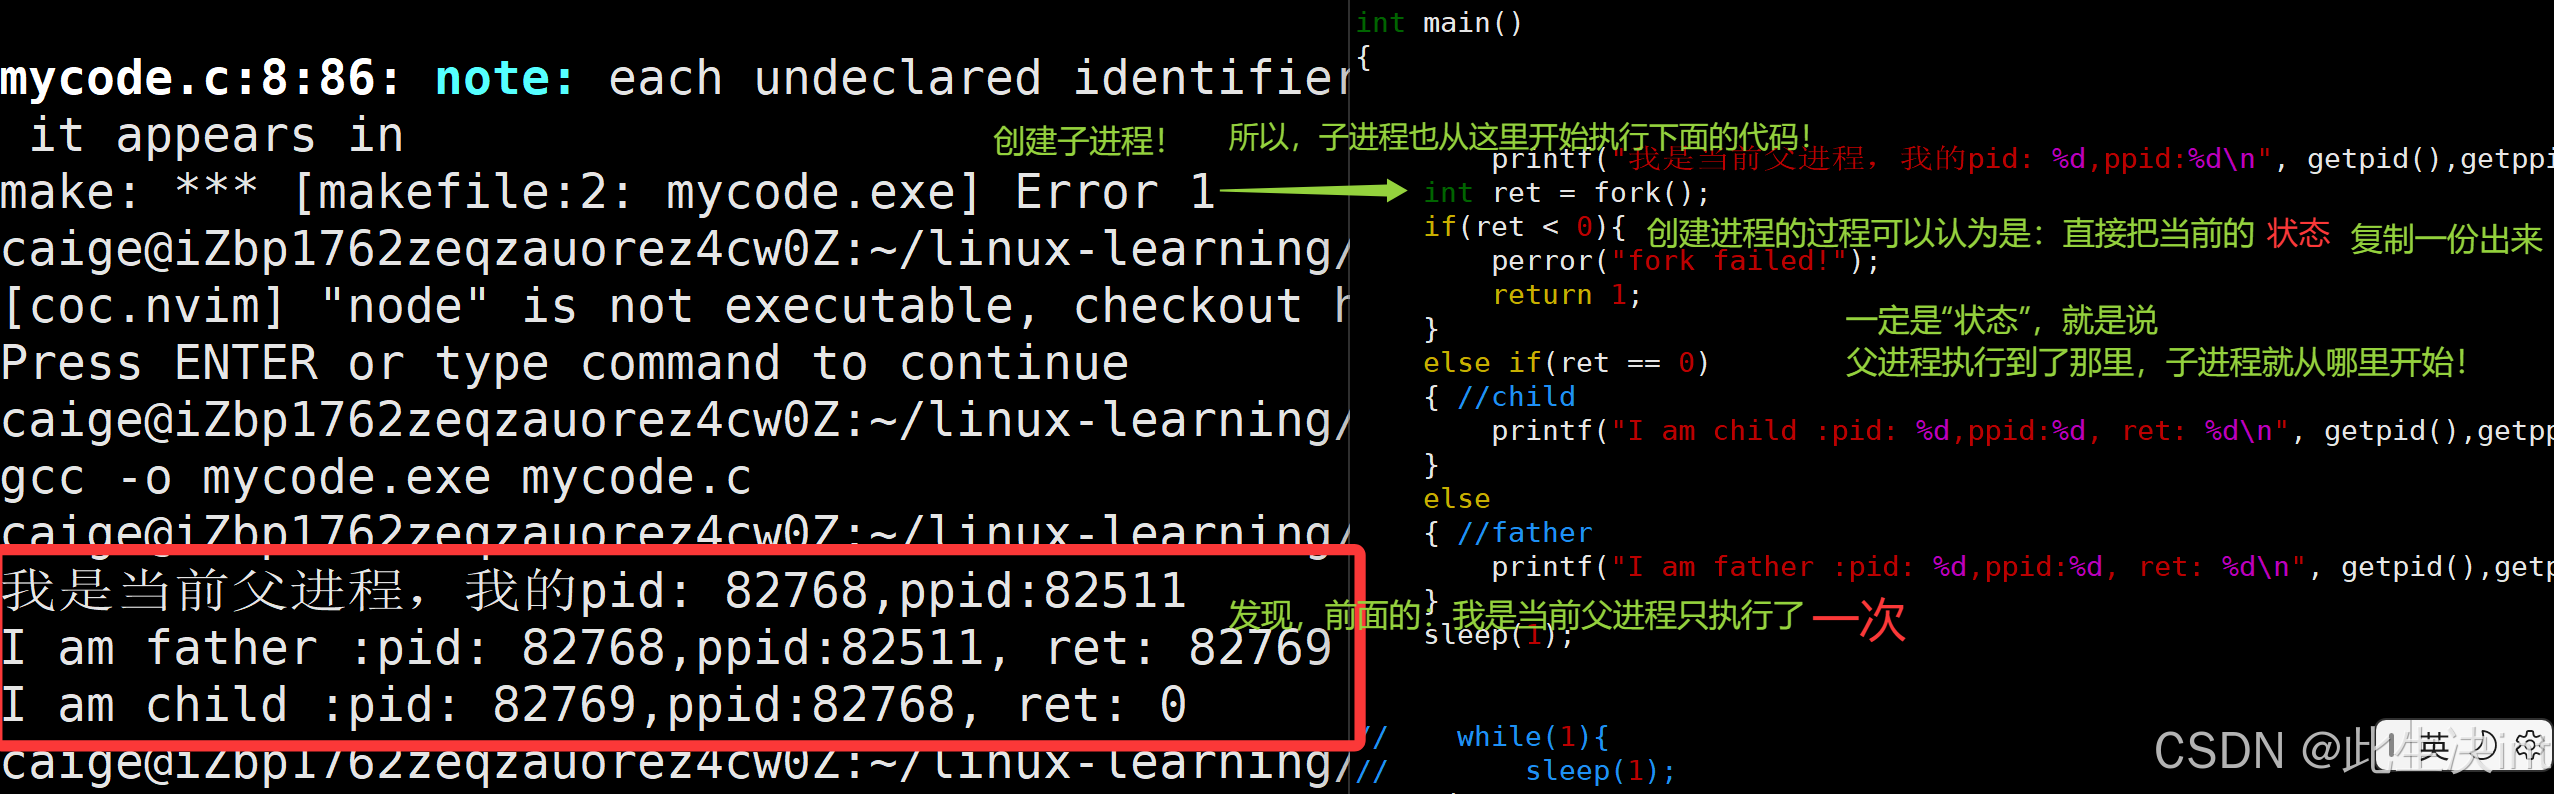
创建子进程的过程可以大致理解为,把父进程当前的属性复制一份出来,给子进程,
子进程的PCB里面大部分与父进程一样,只有少数像pid之类的不一样!
进程里面代码和数据和父进程共用,
所以,会执行剩下的代码,并且两人执行的是同一份一样的代码,如果剩下的代码里面没有可以区分子父进程的函数(之前学过的所有函数),那么,他们的运行结果就一模一样!
那么为了可以区分子进程和父进程,就有fork的返回值不同来区分!
子进程返回:0
父进程返回:子进程pid
根据这一点就可以写出让子父进程执行不同的代码
cpp
int main()
{
        printf("我是当前父进程,我的pid: %d,ppid:%d\n", getpid(),getppid());
    int ret = fork();
    if(ret < 0){
        perror("fork failed!");
        return 1;
    }
    else if(ret == 0)//根据ret的不同值来决定执行那段代码
    { //child
        printf("I am child :pid: %d,ppid:%d, ret: %d\n",  getpid(),getppid(), ret);
    }
    else
    { //father
        printf("I am father :pid: %d,ppid:%d, ret: %d\n", getpid(),getppid(), ret);
    }
    sleep(1);
fork 的三个经典问题
问题一:为什么父子进程要返回不同的值?
父进程可能创建多个子进程:
text
一个父进程
├── 子进程 1
├── 子进程 2
└── 子进程 3
父进程需要知道每个子进程的 PID,才能分别管理它们,例如等待某个子进程结束或向某个子进程发送信号。
因此:
- 父进程返回子进程 PID;
- 子进程返回
0,因为它只需要知道"自己是子进程"; - 创建失败返回
-1。
父进程与子进程的数量关系可以是 1:n,所以父进程必须获得子进程的唯一编号。
问题二:为什么一个函数看起来返回了两次?
从源代码看,fork() 只有一次调用;但从运行结果看,父子进程都继续执行了 fork 后面的代码。
原因是 fork 内部大致完成了这些操作:
text
申请子进程的 task_struct
        ↓
复制父进程的 task_struct
        ↓
把子进程挂入进程管理链表和调度队列
        ↓
分别让父子进程继续运行
        ↓
父进程得到子进程 PID,子进程得到 0
这里的"返回两次"并不是同一个函数被同一个进程调用两次,而是:
- 原来的父进程继续执行并得到一个返回值;
- 新创建的子进程也从相应位置继续执行并得到另一个返回值。
从实现角度看,return 的本质是把返回值写入约定的位置,然后让调用者继续执行。fork 返回时,子进程已经被创建并可以独立参与调度。
问题三:一个变量为什么能让 if/else 同时成立?
父子进程拥有各自独立的执行流。虽然它们从同一个 fork 位置继续执行,但看到的返回值不同:
text
父进程:ret = 子进程 PID
子进程:ret = 0所以在父进程中,ret == 0 不成立,执行 else;在子进程中,ret == 0 成立,执行 if。
更深层的原因涉及虚拟地址空间和写时拷贝:父子进程可以使用相同的变量地址,但这些地址在不同进程中属于各自的地址空间。这个问题会在程序地址空间部分进一步说明。
进程的共享与独立性:
- 父子可共享只读代码物理页;私有数据在逻辑上独立,最初可共享物理页,写入时通过写时拷贝分离。
- 子进程修改全局变量,不改变父进程中的变量值;相同虚拟地址不代表同一个物理存储位置。
父子进程之间采用的是写时拷贝 !(C++的智能指针同理)
就是没有修改数据时,父子共用一份数据,只有发生修改时,子进程才拷贝出自己的那一份
进程状态
3-2 进程状态
对与操作系统来说,进程状态可以分为:
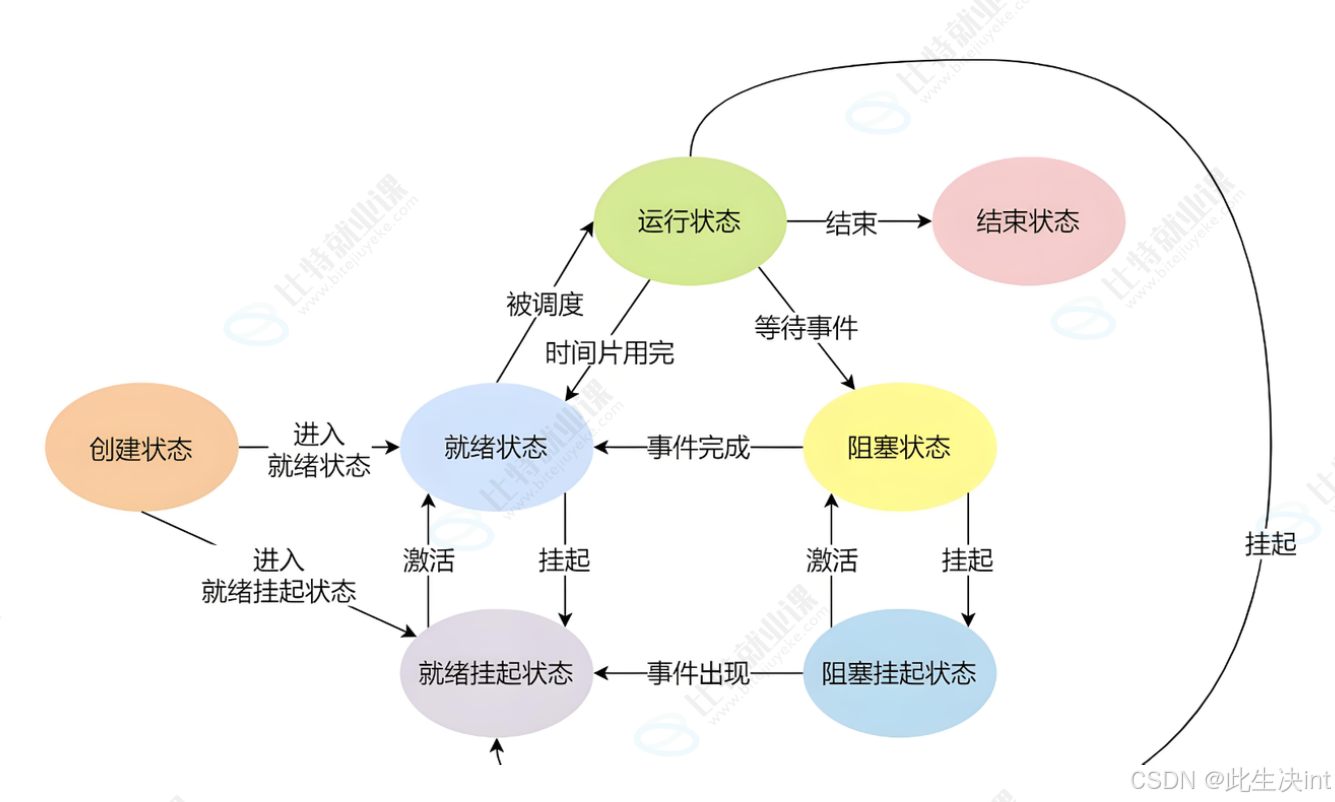
| 状态 | 核心含义 | 队列或内存特征 |
|---|---|---|
| 运行/就绪 | 正在执行或等待 CPU | 可运行任务由 runqueue 管理 |
| 阻塞 | 等待事件或非 CPU 资源 | 离开运行队列,进入相应等待队列 |
| 挂起 | 暂不运行且相关内存被换出 | 管理信息仍需保留;现代 Linux 通常按页换出,不单列"挂起"状态 |
堵塞状态就是程序在等待资源 ,比如scanf/,一直在等屏幕输入,就发生堵塞,进程进入对应的等待队列
挂起状态就是内存空间不够了,把暂时不执行的进程的代码和数据放到磁盘的swap区 (一个专门的区域)
这些状态是操作系统层面区分的,具体的操作系统还要细分!例如下面的Linux系统
3-2-1 Linux 内核源代码怎么说
为了弄明白正在运行的进程是什么意思,我们需要知道进程的不同状态。一个进程可以有几个状态(在 Linux 内核里,进程有时候也叫做任务)。
下面的状态在 kernel 源代码里定义:
c
/*
 *The task state array is a strange "bitmap" of
 *reasons to sleep. Thus "running" is zero, and
 *you can test for combinations of others with
 *simple bit tests.
*/
static const char *const task_state_array[] = {
    "R (running)",      /*0*/
    "S (sleeping)",     /*1*/
    "D (disk sleep)",   /*2*/
    "T (stopped)",      /*4*/
    "t (tracing stop)", /*8*/
    "X (dead)",         /*16*/
    "Z (zombie)",       /*32*/
};
所以,一共就以下7种状态!
Linux 内核状态:
| 字母 | 含义 | 易忘点 |
|---|---|---|
R |
running/runnable | 正在执行或已就绪 |
S |
可中断睡眠 | 等待事件,可被相关信号唤醒 |
D |
不可中断睡眠 | 常见于 I/O 等内核等待;kill -9 也可能无法立即终止 |
T |
停止 | 可由 SIGSTOP 产生,SIGCONT 恢复 |
t |
跟踪停止 | 调试器追踪、断点等 |
X |
死亡 | 短暂内部状态,通常难以观察 |
Z |
僵尸 | 已退出,退出信息尚未回收 |
3-2-2 进程状态查看
ps aux / ps axj 命令:
- a:显示一个终端所有的进程,包括其他用户的进程。
- x:显示没有控制终端的进程,例如后台运行的守护进程。
- j:显示进程归属的进程组 ID、会话 ID、父进程 ID,以及与作业控制相关的信息
- u:以用户为中心的格式显示进程信息,提供进程的详细信息,如用户、CPU 和内存使用情况等
3-2-3 Z(zombie)- 僵尸进程
- 僵死状态(Zombies)是一个比较特殊的状态。当子进程退出并且父进程(使用
wait()系统调用,后面讲)没有读取到子进程退出的返回代码时就会产生僵死(尸)进程 - 僵死进程会以终止状态保持在进程表中,并且会一直在等待父进程读取退出状态代码。
- 所以,只要子进程退出,父进程还在运行,但父进程没有读取子进程状态,子进程进入 Z 状态
来一个创建维持 30 秒的僵死进程例子:
c
#include <stdio.h>
#include <stdlib.h>

int main()
{
    pid_t id = fork();
    if(id < 0){
        perror("fork");
        return 1;
    }
    else if(id > 0){ //parent,父亲状态休眠30秒,而子进程休眠5秒,早已经结束了,父进程一直不接收子进程的退出状态,子进程进入僵尸状态!
        printf("parent[%d] is sleeping...\n", getpid());
        sleep(30);
    }else{
        printf("child[%d] is begin Z...\n", getpid());
        sleep(5);
        exit(EXIT_SUCCESS);
    }
    return 0;
}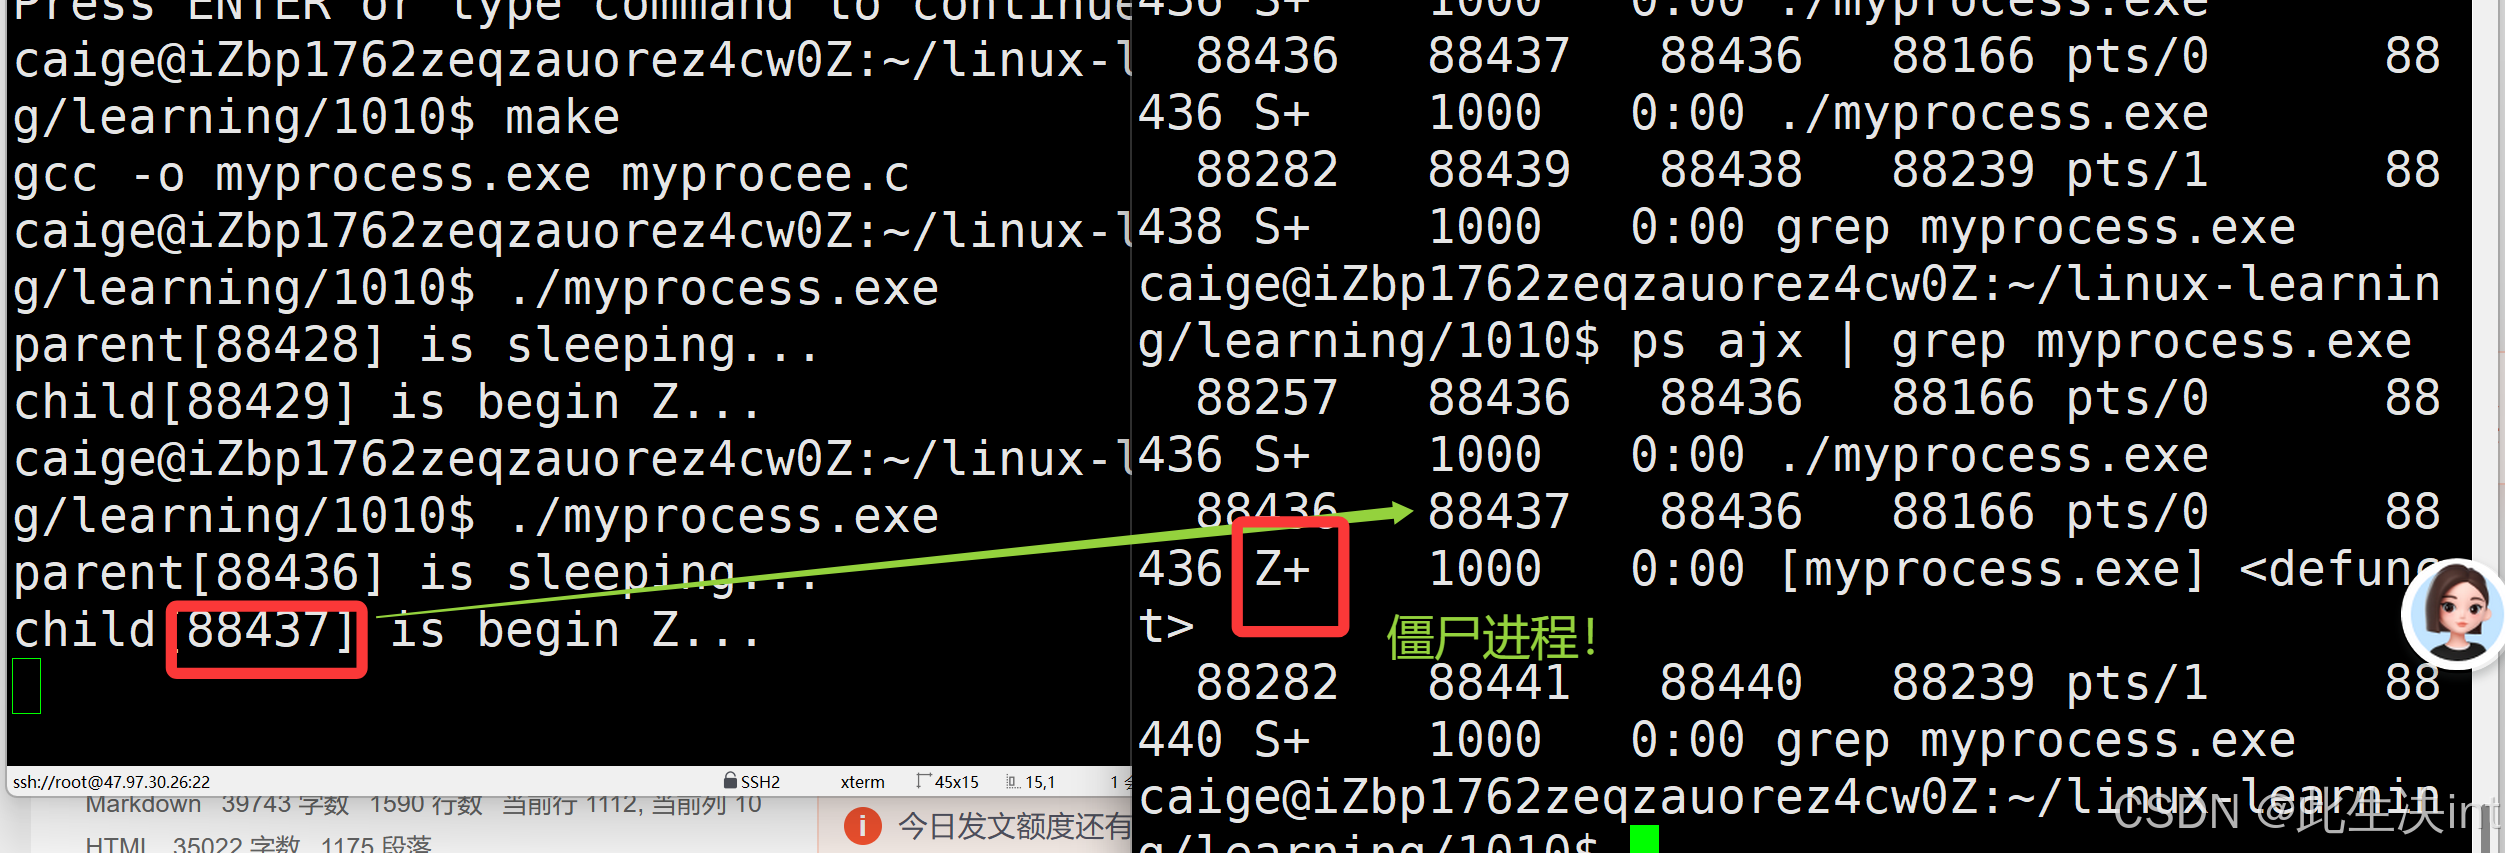
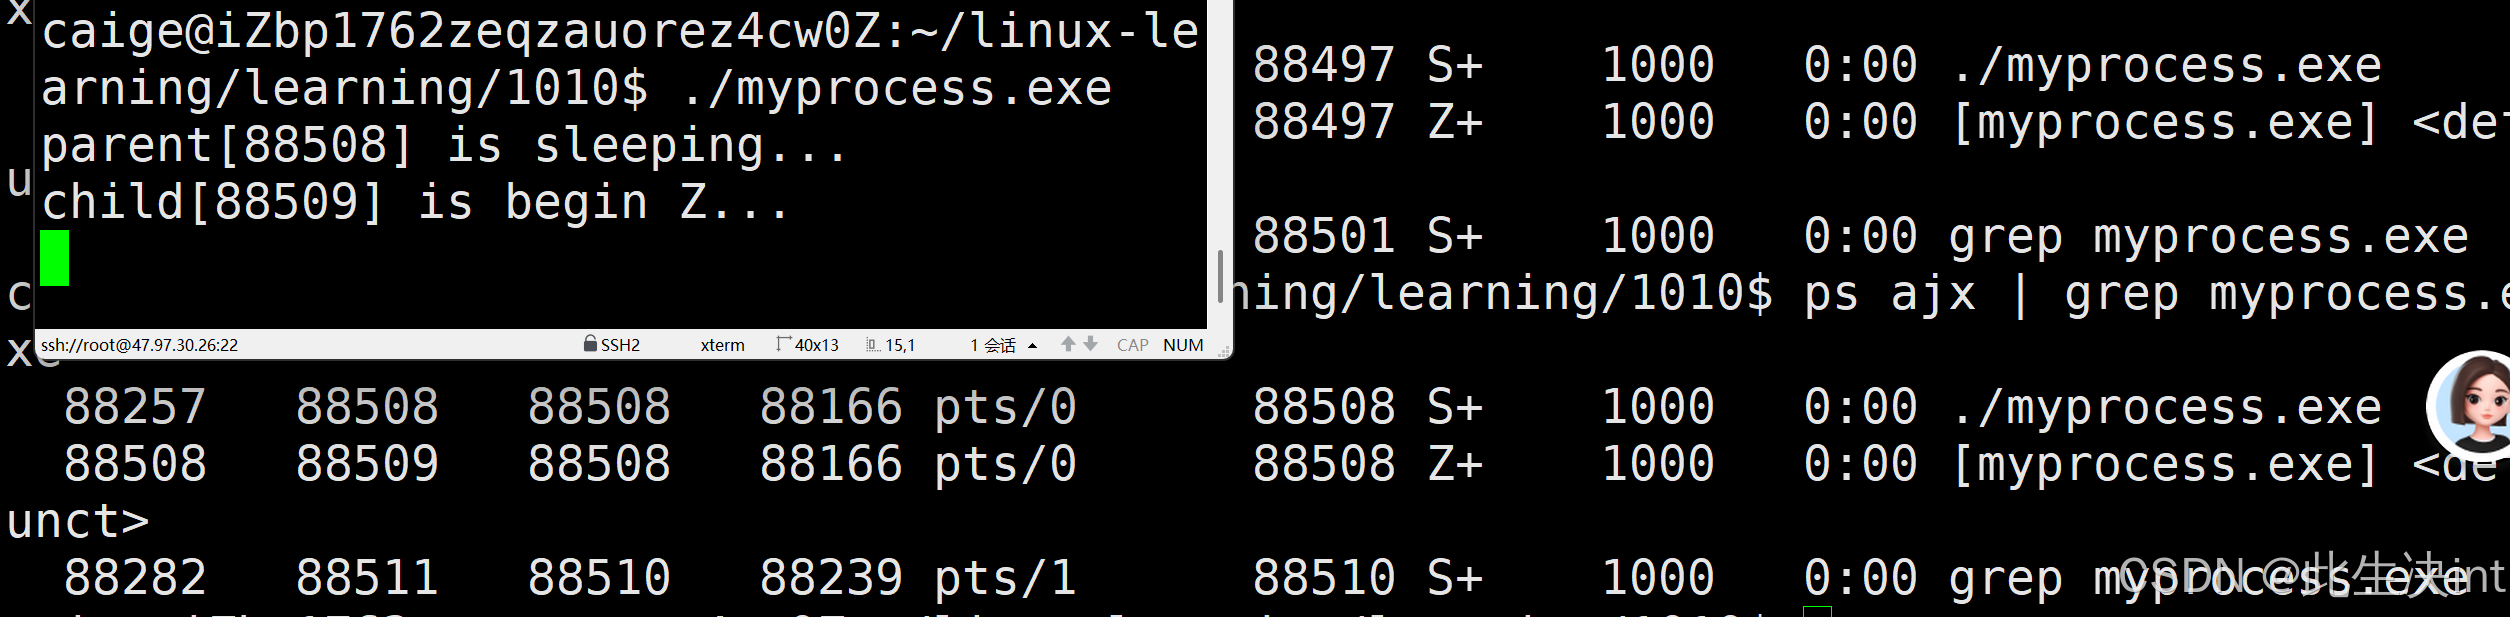
如果父进程可以退出,就是没有什么危害,就可以用kill先杀死父进程,子僵尸进程会被系统接收
kill 命令
kill -15,正常杀死进程
kill -9 强制终止进程
3-2-4 僵尸进程危害------内存泄漏
- 进程的退出状态必须被维持下去,因为他要告诉关心它的进程(父进程),你交给我的任务,我办的怎么样了。可父进程如果一直不读取,那子进程就一直处于 Z 状态?是的!
- 维护退出状态本身就是要用数据维护,也属于进程基本信息,所以保存在 task_struct(PCB)中,换句话说,Z 状态一直不退出,PCB 一直都要维护?是的!
- 那一个父进程创建了很多子进程,就是不回收,是不是就会造成内存资源的浪费?是的!因为数据结构对象本身就要占用内存,想想 C 中定义一个结构体变量(对象),是要在内存的某个位置进行开辟空间!
又因为一般服务器一直在运行,一直内存泄漏内存会一直减少,所以非常危险
3-2-5 孤儿进程
- 父进程先退出,子进程就称之为"孤儿进程"
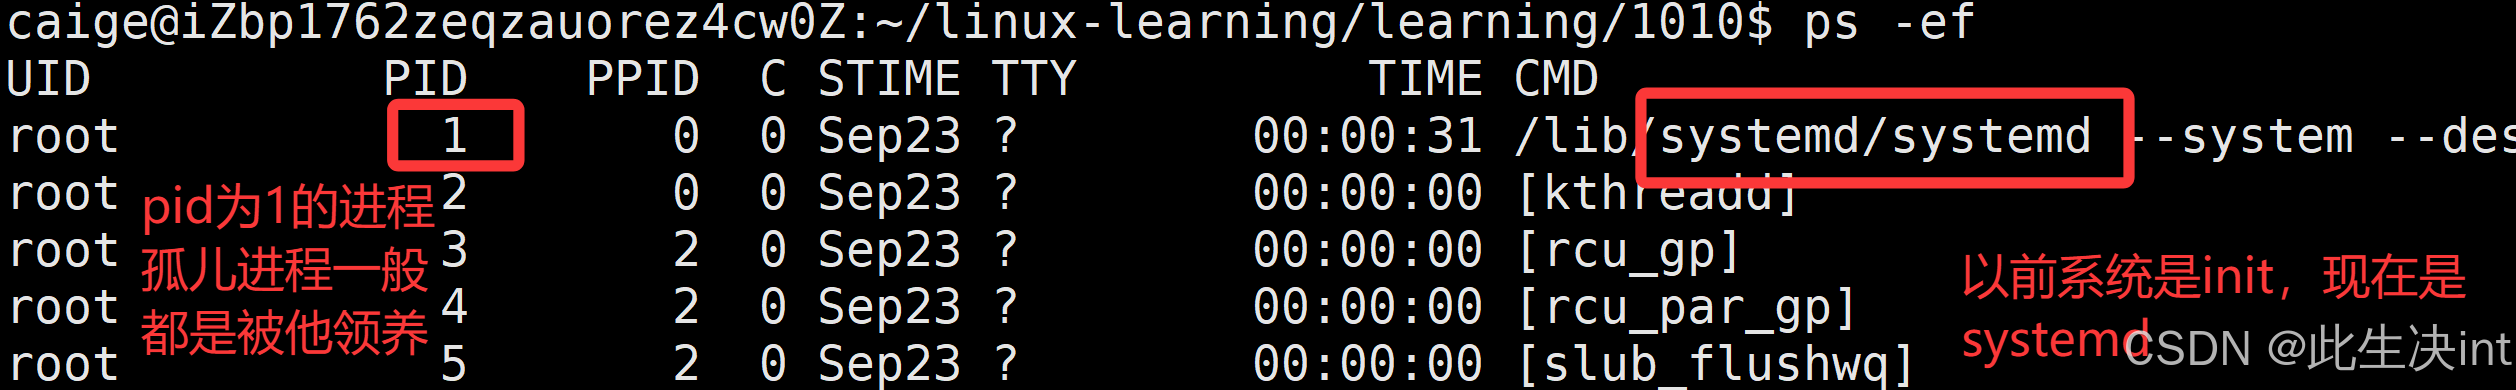
- 孤儿进程被 1 号 init/systemd 进程领养,当然要有 init/systemd 进程回收喽。
c
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>

int main()
{
    pid_t id = fork();
    if(id < 0){
        perror("fork");
        return 1;
    }
    else if(id == 0){//child
        printf("I am child, pid : %d\n", getpid());
        sleep(10);//子进程晚退出,即父进程退出,子进程没有父进程了,成了孤儿,孤儿进程
    }else{//parent
        printf("I am parent, pid: %d\n", getpid());
        sleep(3);
        exit(0);
    }
    return 0;
}孤儿进程的处理方式:可以直接杀死子进程,Ctrl C 不行!!!
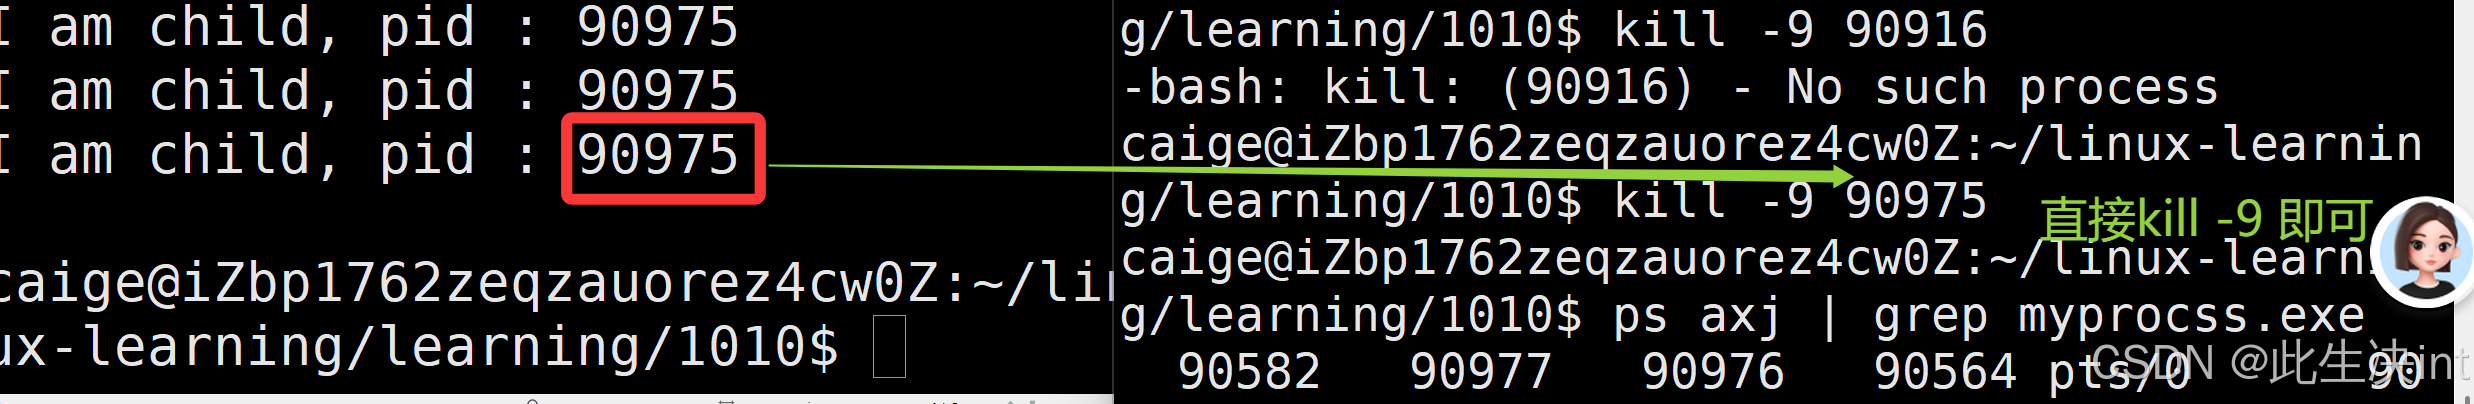
核心原因:Ctrl+C 和 kill 发送信号的方式不同。
Ctrl+C:终端将SIGINT信号发送给当前终端的前台进程组 。父进程退出后,孤儿进程可能不再属于当前终端的前台进程组,因此收不到这个信号。kill -9 PID:通过指定 PID,直接向目标进程发送SIGKILL信号,不要求目标进程属于当前终端的前台进程组,因此可以终止仍在运行的孤儿进程。
注意:kill -9 也不是万能的,例如处于不可中断睡眠状态(D)的进程,通常不能立即终止。
3-3 进程优先级
3-3-1 基本概念
- cpu 资源分配的先后顺序,就是指进程的优先权(priority)。
- 优先权高的进程有优先执行权利。配置进程优先权对多任务环境的 linux 很有用,可以改善系统性能。
- 还可以把进程运行到指定的 CPU 上,这样一来,把不重要的进程安排到某个 CPU,可以大大改善系统整体性能。
3-3-2 查看系统进程
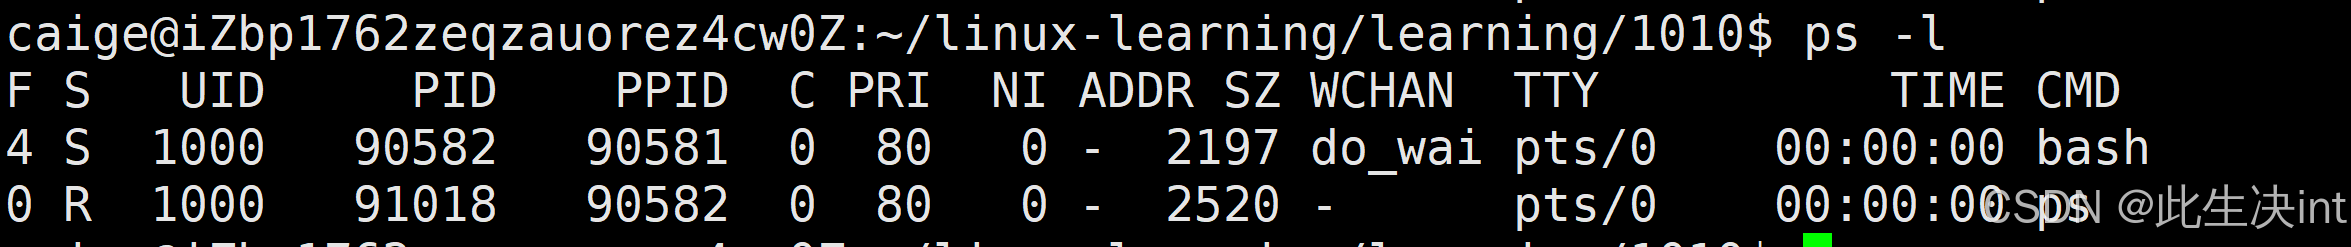
在 linux 或者 unix 系统中,用 ps -l 命令则会类似输出以下几个内容:
我们很容易注意到其中的几个重要信息,有下:
- UID :代表执行者的身份
- PID :代表这个进程的代号
- PPID :代表这个进程是由哪个进程发展衍生而来的,亦即父进程的代号
- PRI :代表这个进程可被执行的优先级,其值越小越早被执行
- NI :代表这个进程的 nice 值
3-3-3 PRI and NI
- PRI 也还是比较好理解的,即进程的优先级 ,或者通俗点说就是程序被 CPU 执行的先后顺序,此值越小进程的优先级别越高
- 那 NI 呢?就是我们所要说的 nice 值了,其表示进程可被执行的优先级的修正数值
- PRI 值越小越快被执行,那么加入 nice 值后,将会使得 PRI 变为:PRI(new) = PRI(old) + nice
- 这样,当 nice 值为负值的时候,那么该程序将会优先级值将变小,即其优先级会变高,则其越快被执行
- 所以,调整进程优先级 ,在 Linux 下,就是调整进程 nice 值
- nice 其取值范围是 -20 至 19,一共 40 个级别。
pri 默认是80,-20到19的话就把可能值变成 60~99
每次调整NI来调整优先级都是默认从80开始,而不是上一次的优先级开始,这这也证明,设置NI的目的就是让我们在每一次调整程序优先级的时候,不需要知道它上一次的优先级是什么。
3-3-4 PRI vs NI
- 需要强调一点的是,进程的 nice 值不是进程的优先级,他们不是一个概念,但是进程 nice 值会影响到进程的优先级变化。
- 可以理解 nice 值是进程优先级的修正数据
3-3-5 查看进程优先级的命令
用 top 命令更改已存在进程的 nice:
top- 进入 top 后按"r"→输入进程 PID→输入 nice 值
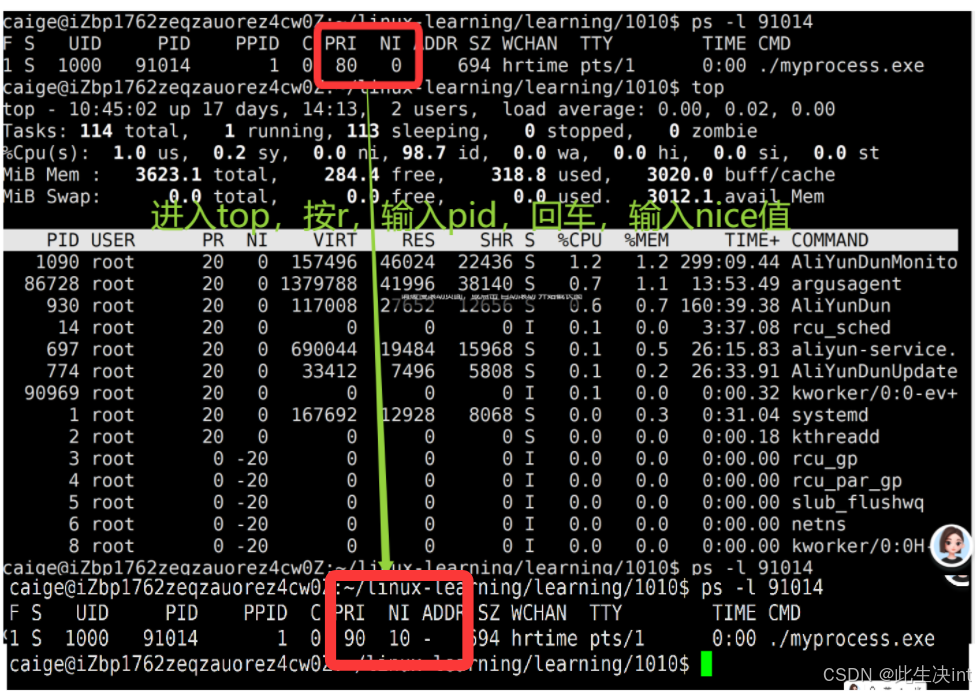
- 其他调整优先级的命令:nice,renice
- 系统函数:
c
#include <sys/time.h>
#include <sys/resource.h>

int getpriority(int which, int who);
int setpriority(int which, int who, int prio);
3-3-6 补充概念 - 竞争、独立、并行、并发
- 竞争性:系统进程数目众多,而 CPU 资源只有少量,甚至 1 个,所以进程之间是具有竞争属性的。为了高效完成任务,更合理竞争相关资源,便具有了优先级
- 独立性:多进程运行,需要独享各种资源,多进程运行期间互不干扰
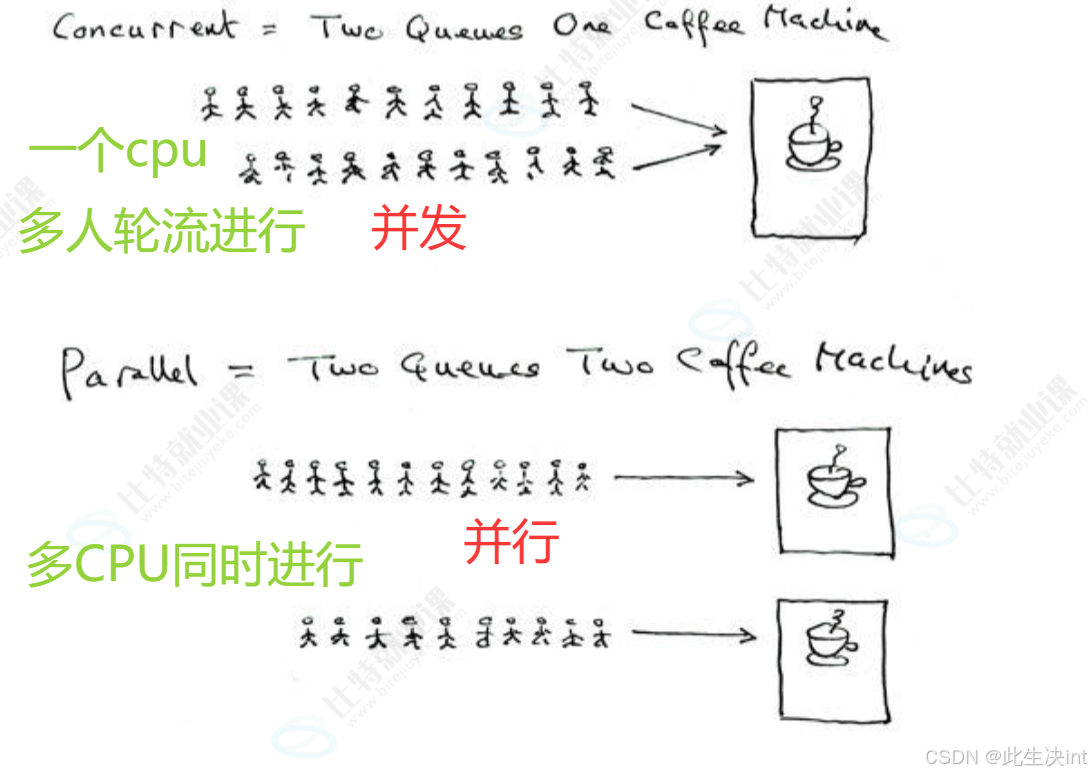
- 并行:多个进程在多个 CPU 下分别,同时进行运行,这称之为并行
- 并发 :多个进程在一个 CPU 下采用进程切换的方式,在一段时间之内,让多个进程都得以推进,称之为并发
3-4 进程切换
时间片:当代计算机都是分时操作系统,每个进程都有它合适的时间片(其实就是一个计数器)。时间片到达,进程就被操作系统从 CPU 中剥离下来。所以,进程之间通常需要切换
CPU 上下文切换 :其实际含义是任务切换,或者 CPU 寄存器切换。当多任务内核决定运行另外的任务时,它保存正在运行任务的当前状态,也就是 CPU 寄存器中的全部内容。这些内容被保存在任务自己的堆栈中,入栈工作完成后就把下一个将要运行的任务的当前状况从该任务的栈中重新装入 CPU 寄存器,并开始下一个任务的运行,这一过程就是 context switch。
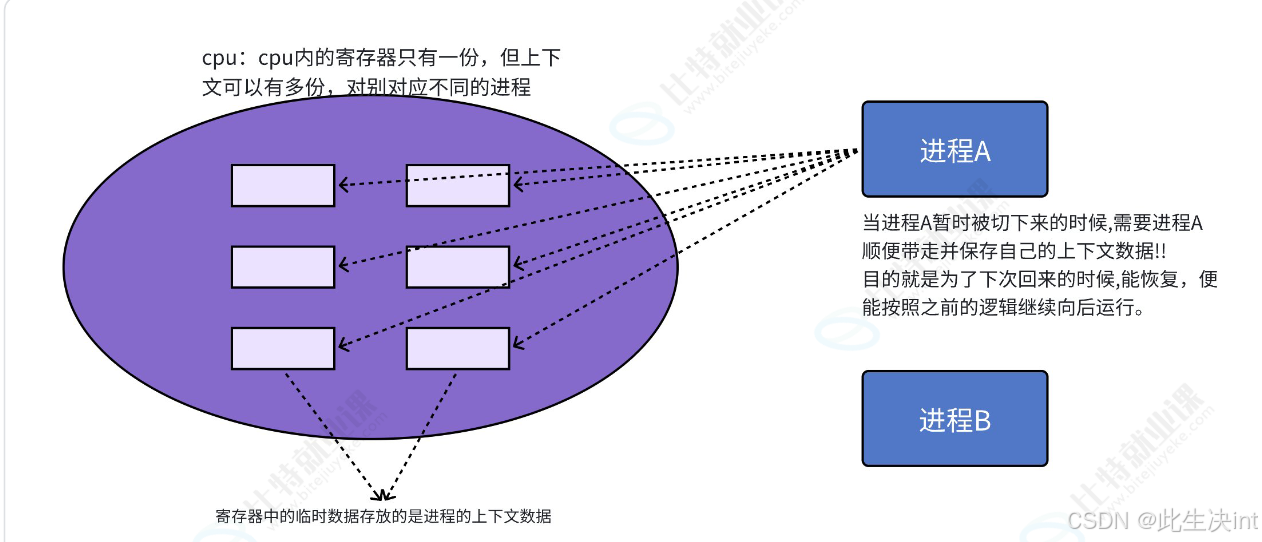
进程的上下问数据放到PCB里面的tss里面
3-4 Linux2.6 内核进程 O(1) 调度队列
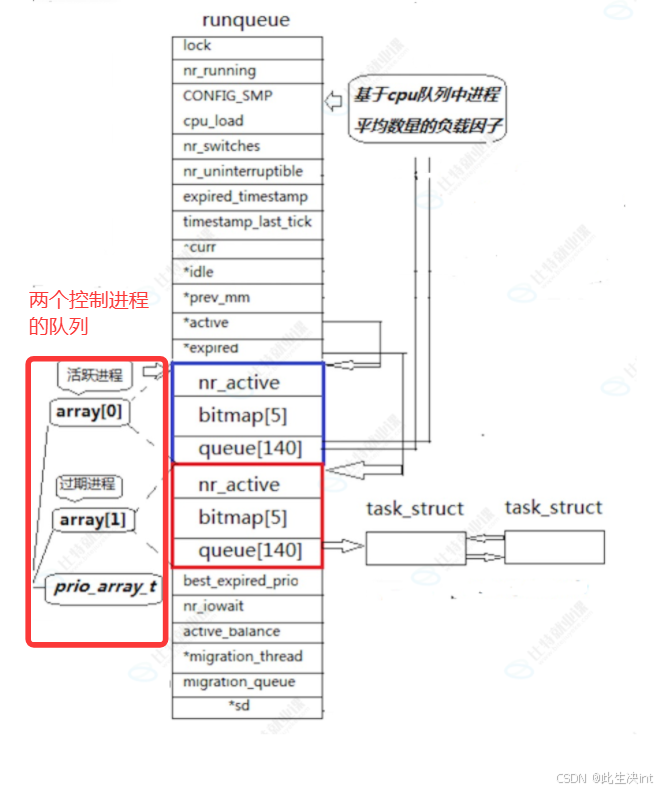
3-4-1 一个 CPU 拥有一个 runqueue
- 如果有多个 CPU 就要考虑进程个数的负载均衡问题
3-4-2 优先级
上面我们说的【60,90】是数字区间,实际是100~139,因为0 ~ 99是实时优先级
- 普通优先级:100~139(我们都是普通的优先级,想想 nice 值的取值范围,可与之对应!)
- 实时优先级:0~99(不关心)
3-4-3 活动队列
- 时间片还没有结束的所有进程都按照优先级放在该队列
nr_active:总共有多少个运行状态的进程queue[140]:一个元素就是一个进程队列,相同优先级的进程按照 FIFO 规则进行排队调度,所以,数组下标就是优先级!- 从该结构中,选择一个最合适的进程,过程是怎么的呢?
- 从 0 下标开始遍历
queue[140] - 找到第一个非空队列,该队列必定为优先级最高的队列
- 拿到选中队列的第一个进程,开始运行,调度完成!
- 遍历
queue[140]时间复杂度是常数!但还是太低效了!
- 从 0 下标开始遍历
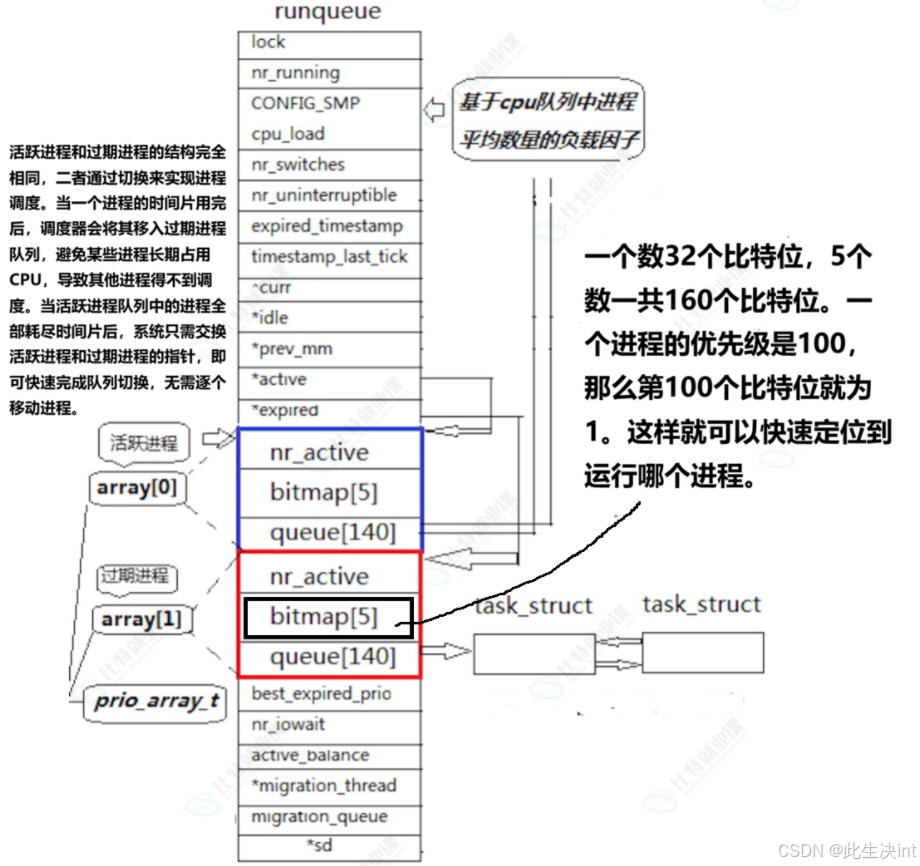
bitmap[5]:一共 140 个优先级,一共 140 个进程队列,为了提高查找非空队列的效率,就可以用 5*32 个比特位表示队列是否为空,这样,便可以大大提高查找效率!
3-4-4 过期队列
- 过期队列和活动队列结构一模一样
- 过期队列上放置的进程,都是时间片耗尽的进程
- 当活动队列上的进程都被处理完毕之后,对过期队列的进程进行时间片重新计算
3-4-5 active 指针和 expired 指针
- active 指针永远指向活动队列
- expired 指针永远指向过期队列
- 可是活动队列上的进程会越来越少,过期队列上的进程会越来越多,因为进程时间片到期时一直都存在的。
- 没关系,在合适的时候,只要能够交换 active 指针和 expired 指针的内容,就相当于具有了一批新的活动进程!
3-4-6 总结
-
在系统当中查找一个最合适调度的进程的时间复杂度是一个常数,不随着进程增多而导致时间成本增加,我们称之为进程调度 O(1) 算法!
-
swap是内存页的后备存储区域;换出不等于进程退出,也不等于T停止状态。
下期预告
进程概念(下)
结语
** 本文到此结束,感谢大家的阅读!如果觉得本文对你有所帮助,欢迎点赞、收藏、关注,也欢迎在评论区一起交流讨论。**
** 也欢迎订阅我的**
深入理解 C++系列:从语法入门到底层原理,系统掌握现代 C++
算法系列:从入门到精通,蓝桥杯、ACM、LeetCode 与面试算法全路线
快速复习系列:知识梳理、查漏补缺,考前冲刺必备
Linux系列:从零带你系统学习Linux系统,深入理解计算机组成原理!
** 愿每一次敲下键盘,都比昨天更进一步!** ** 愿每一行代码落下,都让未来多一种可能!**