扩散语言模型综述:并行生成的潜力与边界
论文:A Survey on Diffusion Language Models
作者:Tianyi Li、Mingda Chen、Bowei Guo、Zhiqiang Shen。
版本:本文依据上传的 arXiv:2508.10875v3,版本日期为 2026 年 6 月 4 日。该 PDF 没有单列附录,以下将各章节的理论、方法、性能分析与末尾讨论融合介绍。
本文介绍的是综述梳理的研究体系。涉及具体方法和实验时,会注明相应模型;"阅读理解"表示依据原文所作的解释。
一、这篇工作整体做了什么?
这篇综述系统回答了一个问题:语言生成能否从逐 token 的自回归预测,转向并行的迭代去噪?
作者首先把扩散语言模型(Diffusion Language Models,DLMs)分为连续空间、离散空间和 AR--Diffusion 混合模型,解释它们与自回归语言模型、掩码语言模型的关系;随后梳理预训练、监督微调、推理能力后训练,以及并行解码、重新掩码、引导、缓存和步数蒸馏;最后讨论多模态统一建模、代表性性能、实际应用与部署难点。
这篇工作的价值在于提供一张完整的研究地图:并行生成、双向上下文和迭代修订带来了新的能力,但它们如何转化为质量与速度,取决于训练目标、生成顺序和系统设计。
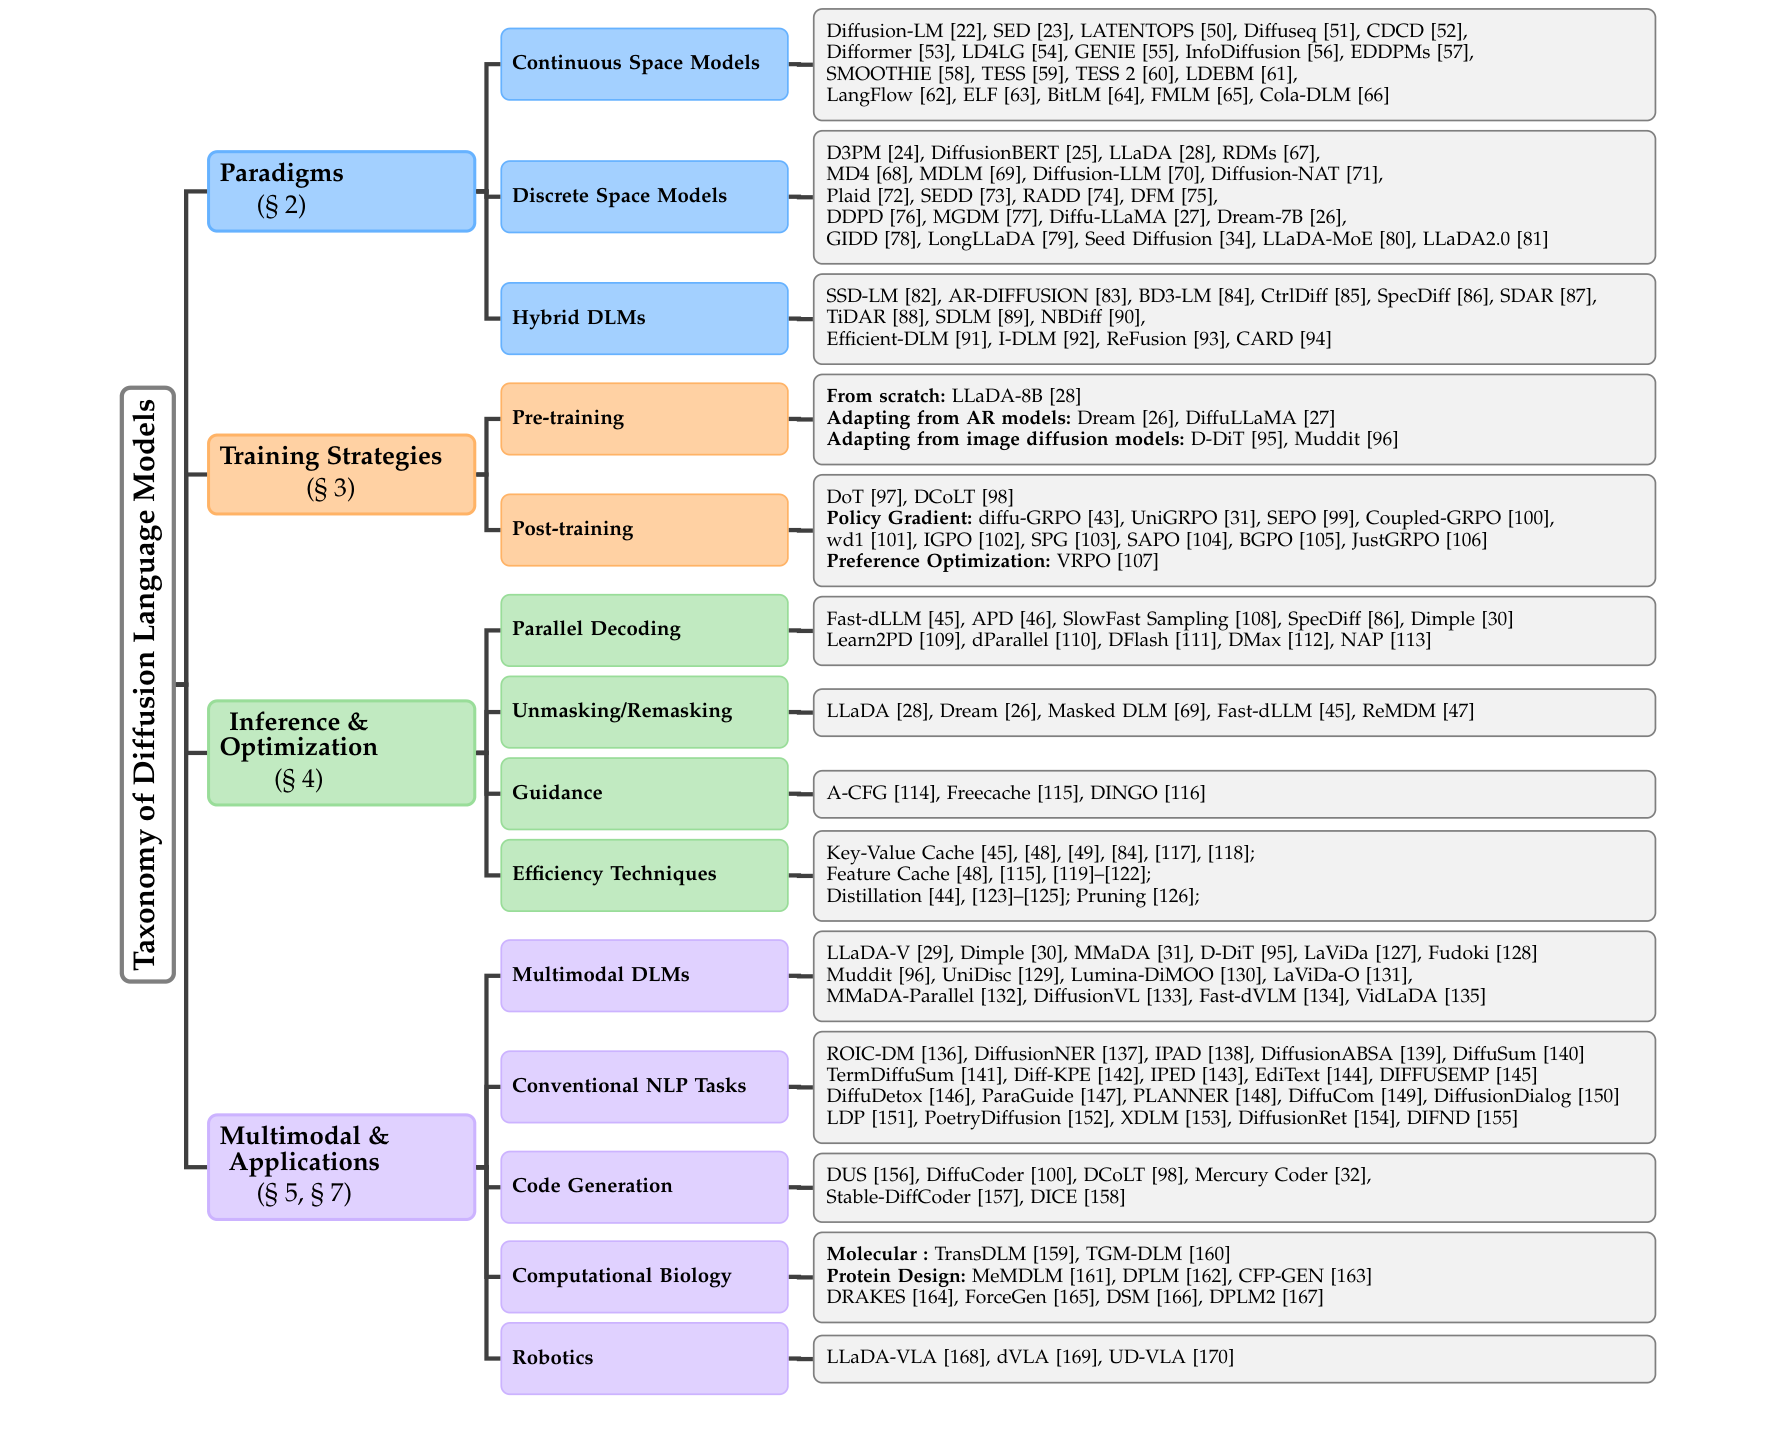
原文图 3。作者的分类覆盖建模范式、训练、推理优化、多模态与应用。
二、研究动机:为什么重新考虑语言生成范式?
2.1 自回归的瓶颈发生在生成阶段
自回归语言模型把序列概率分解为:
p θ ( x 1 , ... , x L ) = ∏ i = 1 L p θ ( x i ∣ x < i ) . p_\theta(x_1,\ldots,x_L) =\prod_{i=1}^{L}p_\theta(x_i\mid x_{<i}). pθ(x1,...,xL)=i=1∏Lpθ(xi∣x<i).
相应训练损失为:
L A R = − E x ∼ D ∑ i = 1 L log p θ ( x i ∣ x < i ) . \mathcal L_{\mathrm{AR}} =-\mathbb E_{x\sim\mathcal D} \sum_{i=1}^{L}\log p_\theta(x_i\mid x_{<i}). LAR=−Ex∼Di=1∑Llogpθ(xi∣x<i).
训练时,teacher forcing 提供完整的真实前缀,因此不同位置的损失可以并行计算。生成时,新 token 依赖已经生成的前缀,通常需要顺序推进。
论文的出发点就是这一区别:AR 的概率分解清晰、生成机制成熟,但逐 token 的推理过程限制了并行度。扩散模型则通过反复去噪,同时更新多个位置,提供了不同的质量与延迟权衡。
2.2 图像扩散的思路不能直接照搬到文本
在图像等连续数据上,可以逐渐加入噪声,再学习恢复数据。文本由离散 token 构成:对词汇直接使用连续扰动,需要明确扰动对象以及最终如何恢复离散输出。
综述梳理了两条主要路径:
- 连续 DLM:把 token 映射到 embedding、latent 或 logit 表示中,在连续空间进行去噪,再映射回 token。
- 离散 DLM:直接在词汇状态上定义随机转移,例如把 token 逐渐替换为 MASK,再学习恢复。
因此,DLM 的核心设计首先涉及在哪个空间定义噪声,以及怎样从噪声回到语言 。
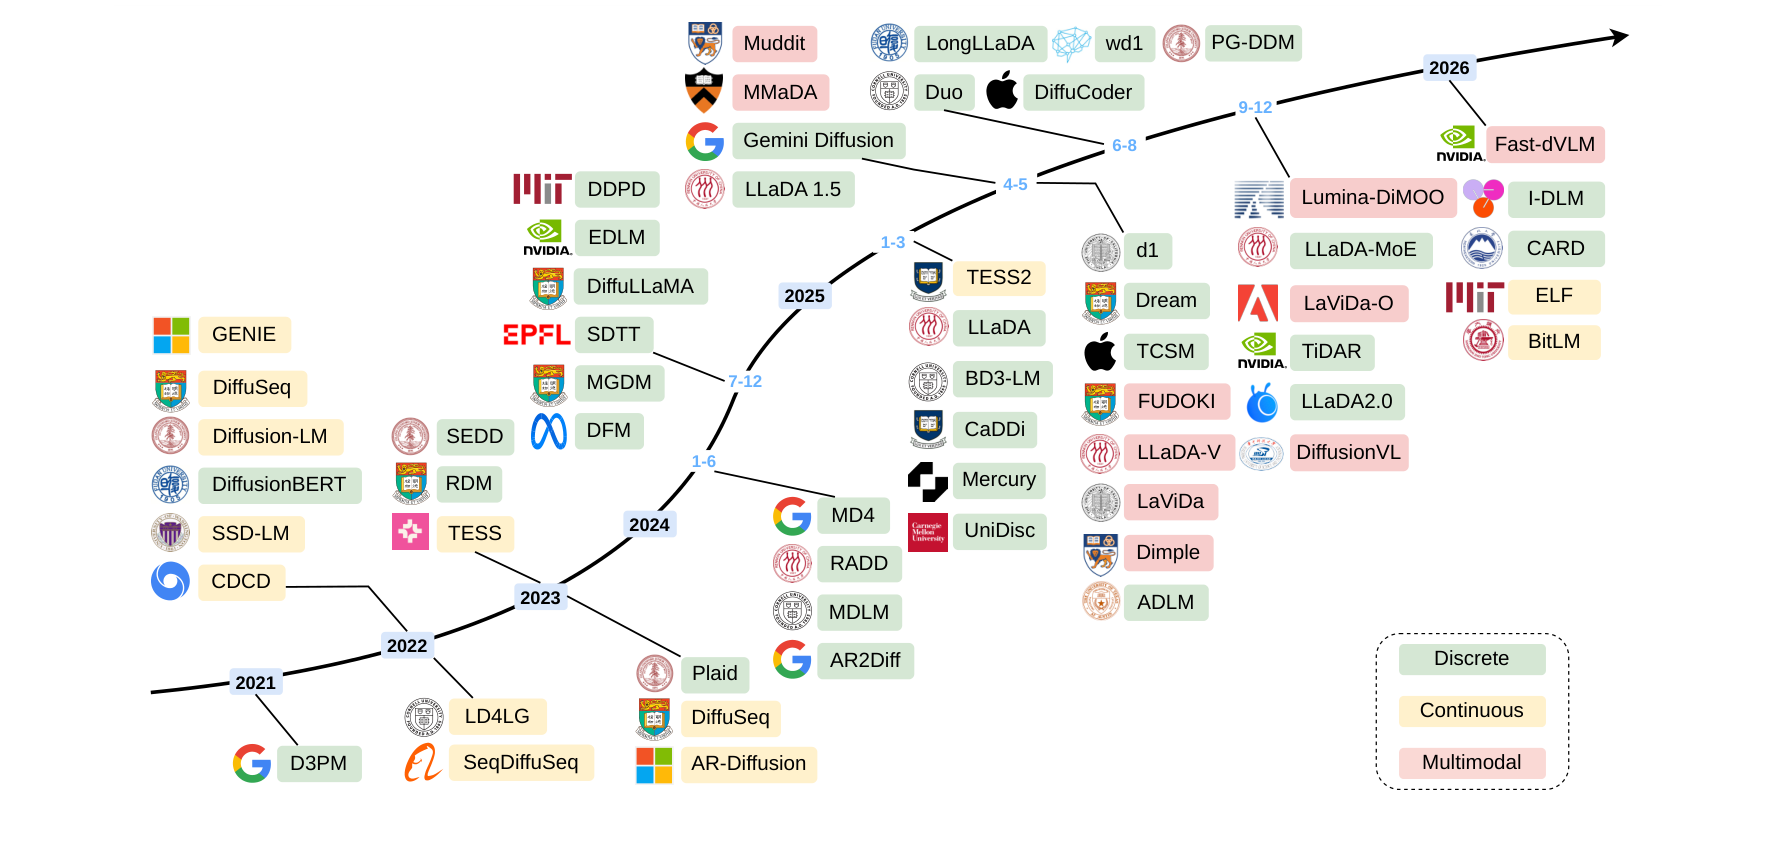
原文图 1。早期工作较多探索连续表示,后续离散 DLM 与多模态 DLM 逐渐丰富。
2.3 从"补全缺失"走向"生成完整序列"
掩码语言模型已经能够利用双向上下文恢复缺失 token。其典型目标为:
L M L M = − E x , M ∑ i ∈ M log p θ ( x i ∣ x ∖ M ) , \mathcal L_{\mathrm{MLM}} =-\mathbb E_{x,M} \sum_{i\in M}\log p_\theta(x_i\mid x_{\setminus M}), LMLM=−Ex,Mi∈M∑logpθ(xi∣x∖M),
其中 M M M 是被掩码的位置集合。
但恢复一个部分可见的句子,与从高度损坏甚至全掩码状态生成完整文本,是不同的生成设置。DLM 将去噪组织为多噪声水平下的训练目标和迭代恢复过程,使模型能够逐步构造、细化序列。
这也带来了 AR 不同的操作方式:可以固定指定位置、补全两侧上下文之间的缺口,或者在一定策略下重新修改已经生成的部分。
**阅读理解:**这条发展路径把语言建模从"接下来生成什么",扩展到了"在当前全局状态下,哪些位置应该被补全或修订"。
2.4 为什么需要一篇覆盖全流程的综述?
随着 DLM 进入更大规模的语言模型、代码生成和多模态任务,问题已经超出了噪声过程本身:
- 怎样训练,或怎样利用已有 AR 模型的权重?
- 怎样让多步去噪过程学会推理和偏好对齐?
- 怎样选择同时生成哪些 token,避免破坏依赖关系?
- 怎样缓存、减少去噪步数,并处理长序列和动态长度?
- 怎样把文本、图像乃至动作放进统一框架?
这正是综述将建模、训练、推理、应用与系统问题连接起来的动机。
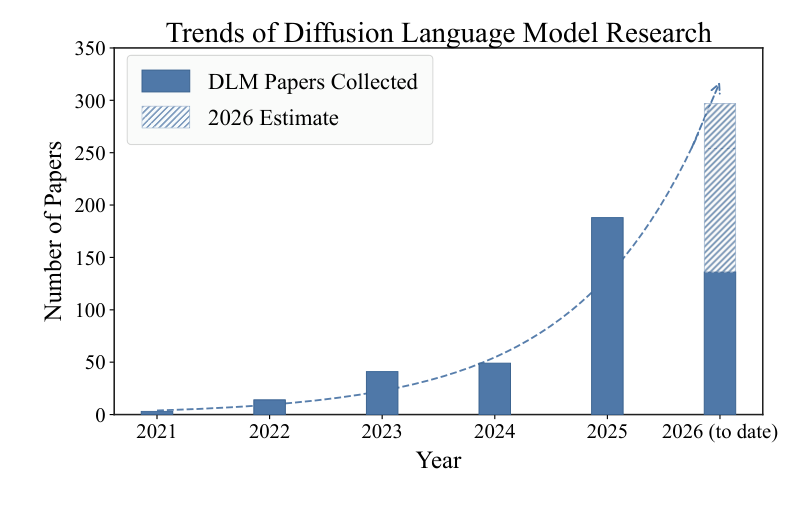
原文图 2。统计口径是作者仓库收录的、具有日期的独立 arXiv 条目;2026 年浅色部分为依据截至当年 5 月中旬收录情况作出的线性估计,适合作为原文覆盖时期的发展背景。
三、建模方法:三类 DLM 的基本机制
3.1 连续 DLM:先恢复表示,再恢复 token
在连续 DLM 中, x 0 x_0 x0 表示文本对应的连续表示。前向过程逐步施加噪声,典型边缘形式为:
x t = α t x 0 + b t ϵ , ϵ ∼ N ( 0 , I ) . x_t=\alpha_t x_0+b_t\epsilon, \qquad \epsilon\sim\mathcal N(0,I). xt=αtx0+btϵ,ϵ∼N(0,I).
α t \alpha_t αt 和 b t b_t bt 由噪声调度确定。模型学习从 x t x_t xt 预测干净数据、噪声或速度等目标 z z z:
L s i m p l e = E t , x 0 , z ∥ f θ ( x t , t ) − z ∥ 2 2 . \mathcal L_{\mathrm{simple}} =\mathbb E_{t,x_0,z} \left\\left\\\|f_\\theta(x_t,t)-z\\right\\\|_2\^2\\right. Lsimple=Et,x0,z∥fθ(xt,t)−z∥22.
生成从噪声开始,通过学习到的反向过程逐步得到干净表示 x ^ 0 \hat x_0 x^0。之后,使用最近邻、解码头或阈值等方式将它映射到离散 token。
综述中的代表设计包括:
| 路线 | 原文中的代表方法 | 主要设计 |
|---|---|---|
| Embedding 空间扩散 | Diffusion-LM、SED | 在 token embedding 上去噪;SED 引入 self-conditioning |
| Seq2Seq 条件生成 | DiffuSeq | 对目标序列的表示施加噪声,通过条件输入引导恢复 |
| 紧凑 latent 空间 | LD4LG、LATENTOPS | 利用编码器或预训练语言模型构造 latent,再去噪、解码 |
| Logit 空间扩散 | TESS、TESS 2 | 在 token 的 logit/simplex 表示上建模;TESS 2 利用已有 AR 模型扩展能力 |
| 连续 flow 路线 | LangFlow、ELF | 明确设计连续表示中的路径与 flow matching 训练 |
原文也讨论了连续表示的优化问题,例如 embedding collapse,以及连续去噪结果与离散 token 之间的转换。
**阅读理解:**这一类方法保留了连续扩散的建模工具,但最终输出仍是文本,所以表示恢复与离散解码之间的接口十分重要。
3.2 离散 DLM:直接定义词汇状态的扰动
以 D3PM 为例,前向过程由转移矩阵 Q t Q_t Qt 定义:
Q ˉ t = ∏ s = 1 t Q s , \bar Q_t=\prod_{s=1}^{t}Q_s, Qˉt=s=1∏tQs,
q ( x t ∣ x 0 ) = Cat ( x t ; p = x 0 Q ˉ t ) . q(x_t\mid x_0) =\operatorname{Cat}\left(x_t;\,p=x_0\bar Q_t\right). q(xt∣x0)=Cat(xt;p=x0Qˉt).
这里 x 0 x_0 x0 可表示为 one-hot 行向量, Q t Q_t Qt 描述 token 在不同词汇状态之间转移的概率。一种常见选择是吸收态:token 保持不变,或转移到特殊的 MASK 状态。
反向模型根据损坏序列,预测原始 token 的分布。LLaDA 所采用的 masked diffusion 目标在原文中写为:
L ( θ ) = − E t , x 0 , x t 1 t ∑ i = 1 L 1 \[ x t i = M log p θ ( x 0 i ∣ x t ) ] . \mathcal L(\theta) =-\mathbb E_{t,x_0,x_t} \left \\frac{1}{t} \\sum_{i=1}\^{L} \\mathbf 1\[x_t\^i=M\, \log p_\theta(x_0^i\mid x_t) \right]. L(θ)=−Et,x0,xtt1i=1∑L1\[xti=Mlogpθ(x0i∣xt)].
其中:
- M M M 表示 MASK;
- 指示函数保证损失只作用于被掩码的位置;
- t t t 对应噪声时间,原文从均匀分布中采样;
- 1 / t 1/t 1/t 是这一训练形式中的权重。
连续时间参数与离散 token 状态并不矛盾:这里的"离散"主要指被建模的状态空间。
典型生成过程是:
- 给定目标长度,初始化全掩码响应。
- 模型利用当前可见的文本与掩码位置,预测待恢复 token。
- 按置信度或调度策略兑现部分预测。
- 更新序列,并继续去噪。
还需要区分"继续恢复未填位置"和"重新修改已填位置"。基础 masked diffusion 中,已经确定的 token 通常会被固定;ReMDM 等方法则允许重新掩码已经解码的 token。GIDD 把 masking 与 uniform noise 结合,Fudoki 使用更一般的离散概率路径,也都在探索修订能力。
因此,离散 DLM 的设计空间比单一的 mask-predict 循环更宽;模型是否能够修改已生成内容,取决于噪声过程与采样器。
3.3 混合模型:块间自回归,块内扩散
混合 AR--Diffusion 模型尝试保留因果依赖与已有 AR 系统机制,同时利用块内并行生成。
BD3-LM 的典型形式有两个循环:外层顺序生成块,内层对当前块迭代去噪。原文给出的目标为:
L B D ( x , θ ) = − ∑ b = 1 B E t , q 1 t log p θ ( x b ∣ x t b , x \< b ) . \mathcal L_{\mathrm{BD}}(x,\theta) =-\sum_{b=1}^{B} \mathbb E_{t,q} \left \\frac{1}{t} \\log p_\\theta(x\^b\\mid x_t\^b,x\^{\
其中, x < b x^{<b} x<b 是已经生成的前序块, x t b x_t^b xtb 是当前块的损坏状态。
这个分解意味着:
- 块内可以并行恢复 token。
- 块间通过前序块建立条件依赖。
- 完成的块可提供稳定的历史上下文,使 KV cache 与动态长度生成更容易实现。
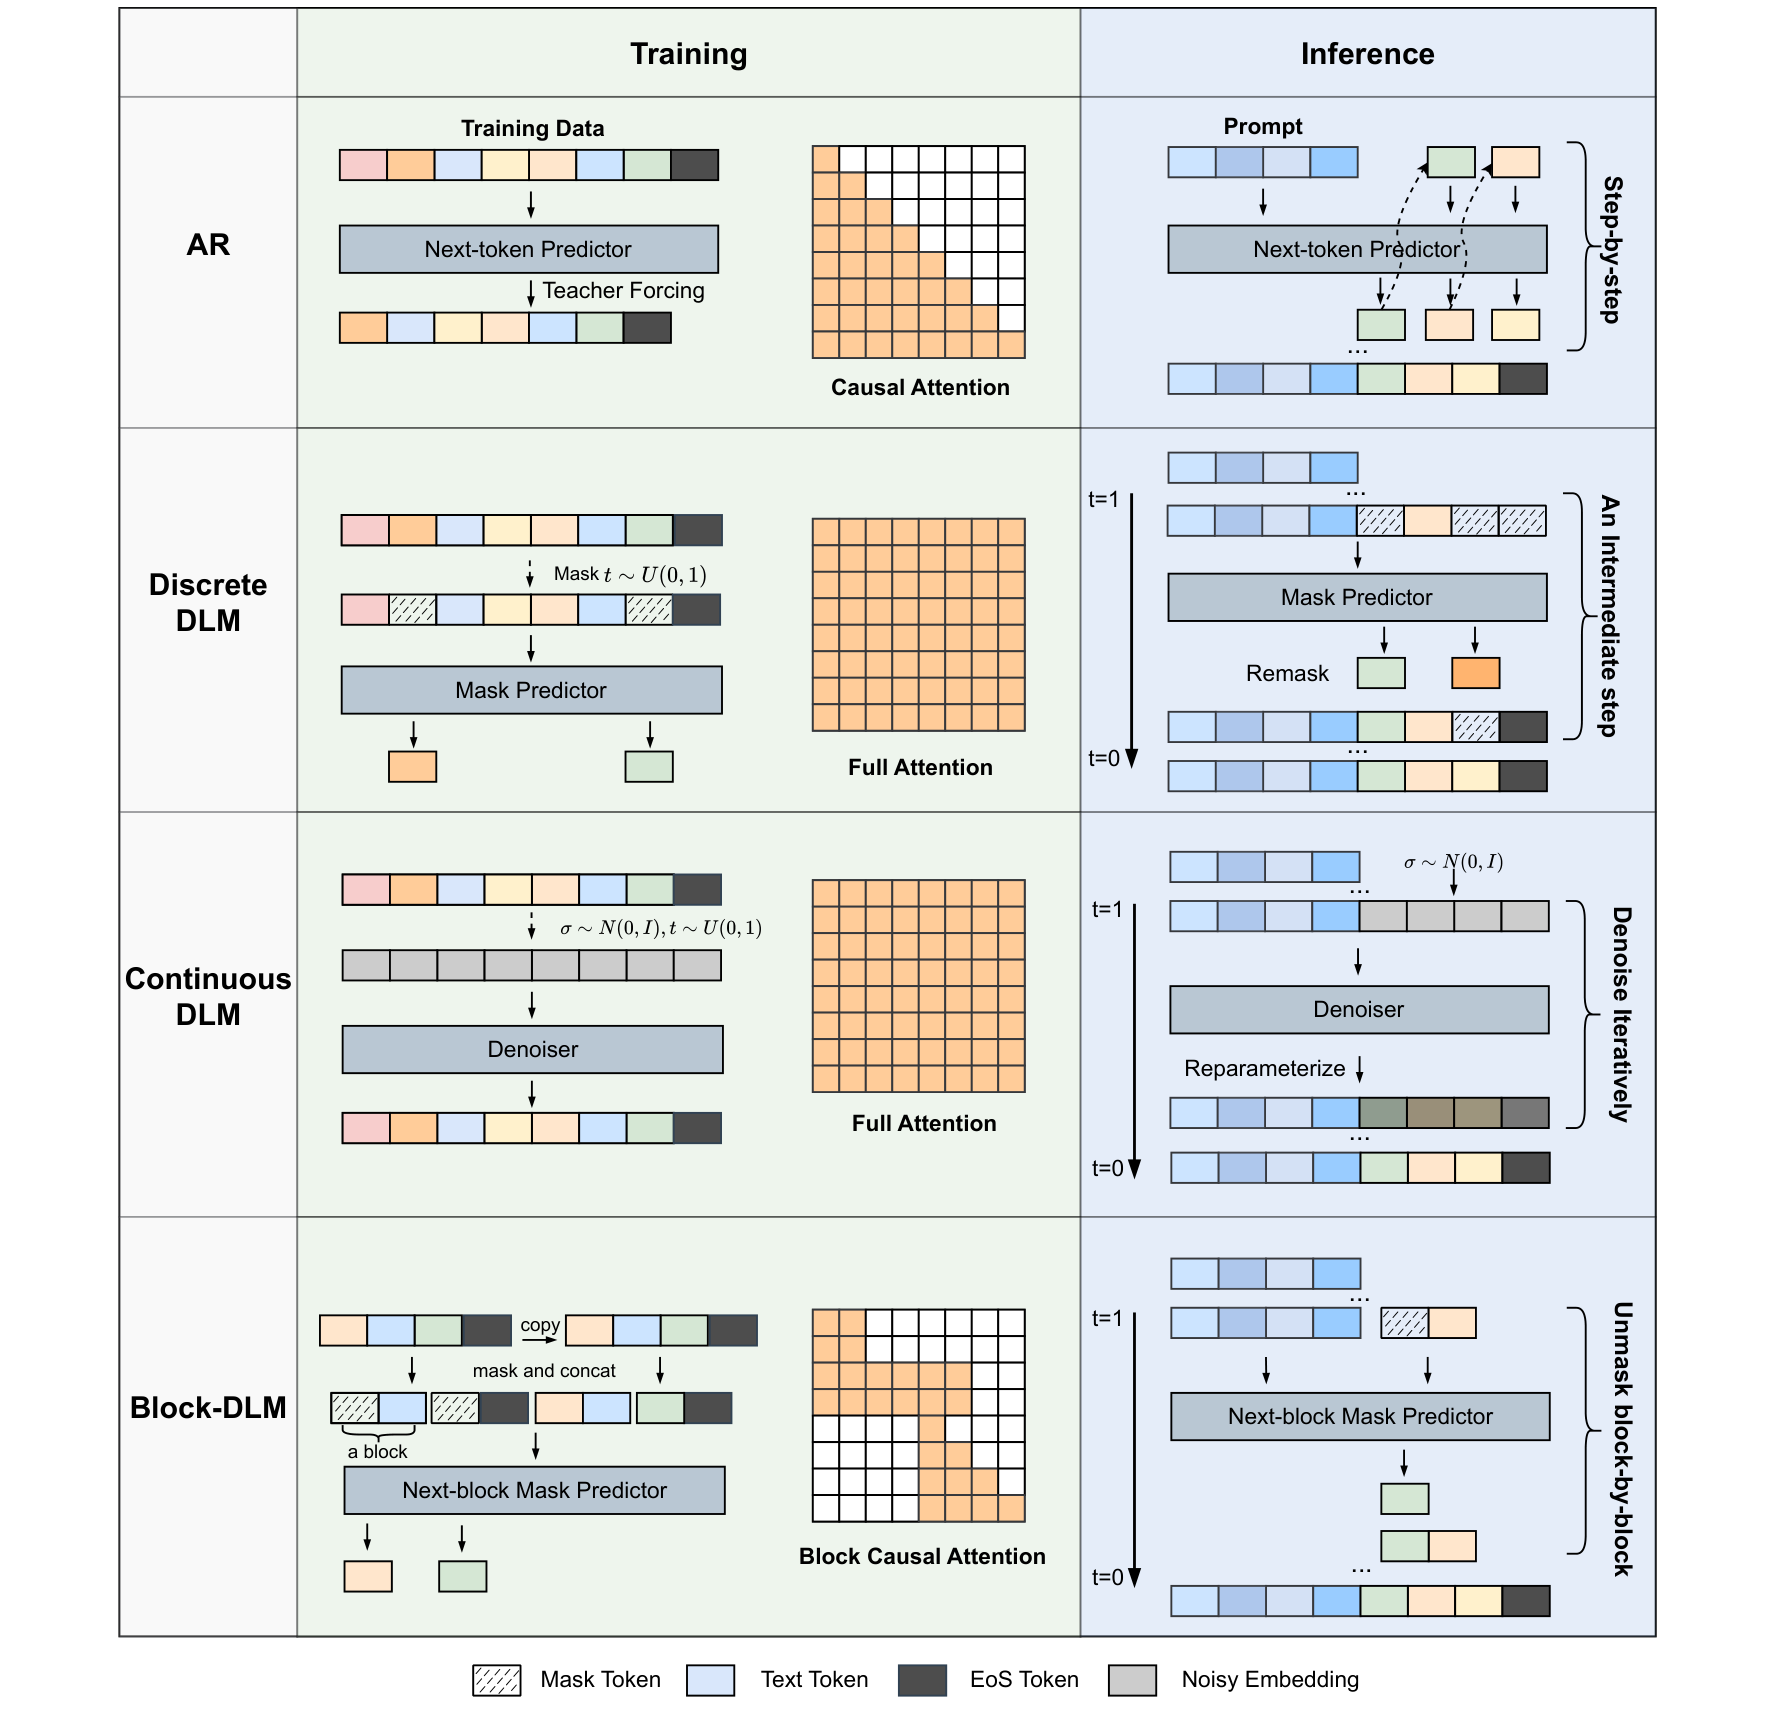
原文图 4,PDF 第 8 页。AR 使用 causal attention;图中的典型全序列 DLM 使用双向 attention;Block-DLM 使用 block-causal attention。
混合也可以发生在其他层面:例如由扩散模型规划中间表示,再用 AR 解码;或由扩散模型并行起草,再由 AR 模型验证。综述分别讨论了这些路线,以及 TiDAR、SDAR、SDLM 等设计。
**阅读理解:**block diffusion 调整了双向上下文的作用范围:当前块内具有双向交互,跨块则遵循因果条件。它通过这一结构换取缓存兼容性和更灵活的输出长度,是表达方式与系统效率共同决定的选择。
四、训练方法:去噪目标如何获得语言与推理能力?
4.1 从零训练与已有模型初始化
综述梳理了三种预训练起点:
| 起点 | 原文中的代表方法 | 说明 |
|---|---|---|
| 从零训练 DLM | LLaDA | 直接训练 masked diffusion 语言模型 |
| 从 AR 模型转换 | DiffuGPT、DiffuLLaMA、Dream | 复用已有语言表征,再通过扩散训练适配 |
| 从图像扩散骨干初始化 | D-DiT、Muddit | 利用已有多模态或图像生成表示,扩展文本建模 |
例如,原文记录 LLaDA-8B 从零训练使用约 2.3T token;Dream-7B 从 Qwen2.5-7B 初始化,再使用 580B token 训练。这里的数字描述不同的训练起点与阶段,比较训练投入时需要包含初始化模型已有的知识与训练成本。
SFT 则较为直接:对于 masked DLM,保持 prompt 可见,只损坏 response,让模型学习条件响应恢复;连续 DLM 也可以只对响应表示施加噪声。
4.2 训练效率还受到 token 覆盖率影响
原文指出,在典型 masked DLM 设置中,均匀采样噪声时间时,平均只有约一半 token 被掩码并参与损失。一次样本的其他位置主要提供上下文。
LaViDa 使用 complementary masking:对同一个样本构造两种互补掩码,使每个目标 token 在其中一种视图里被掩码。因此,每个位置都能作为预测目标参与训练。
同样的思路也出现在 DiffuCoder 的 coupled-GRPO 中,不过后者将它用于似然估计与强化学习。
**阅读理解:**互补掩码改善的是目标覆盖与梯度信号。它需要两种视图及相应计算,所以覆盖更完整与训练计算更省,是需要分别衡量的两个问题。
综述还引用了 scaling-law 研究:在计算受限的设置下,DLM 往往更需要数据;而在数据受限、可以多轮使用同一数据的训练设置中,DLM 又可能表现出更高的数据复用潜力。这两种观察针对不同的资源约束。
4.3 后训练首先遇到序列似然问题
AR 的响应 log-probability 可以直接写为:
log p θ ( y ∣ c ) = ∑ i log p θ ( y i ∣ c , y < i ) . \log p_\theta(y\mid c) =\sum_i\log p_\theta(y_i\mid c,y_{<i}). logpθ(y∣c)=i∑logpθ(yi∣c,y<i).
这为 policy gradient、GRPO 和偏好优化提供了方便的概率接口。DLM 的输出经过多步、非顺序去噪,序列似然通常需要估计或界,因此把已有 RL 算法迁移过来,要先处理概率估计的计算量、偏差与方差。
以 d1 的 diffu-GRPO 为例,综述说明它使用 mean-field 分解,将序列概率近似为各位置概率的乘积。按这一文字描述,可以写成:
log p ~ θ ( y ∣ c ) = ∑ i log p θ ( y i ∣ M ∣ y ∣ , c ~ ) , \log \tilde p_\theta(y\mid c) =\sum_i \log p_\theta \left(y_i\mid \mathbf M_{|y|},\tilde c\right), logp~θ(y∣c)=i∑logpθ(yi∣M∣y∣,c~),
其中 M ∣ y ∣ \mathbf M_{|y|} M∣y∣ 是全掩码 completion, c ~ \tilde c c~ 是随机掩码后的 prompt。这个式子表达的是其近似接口,而非真实多步生成分布的精确似然。
后续研究针对这一接口继续改进:coupled-GRPO 用互补掩码让所有位置在部分可见上下文中得到评价;UniGRPO 采样不同 response 掩码比例,使训练涉及不同去噪阶段;VRPO 则降低偏好优化中 ELBO 估计的方差。
4.4 推理后训练:内容、顺序与估计器一起设计
原文表 2 的方法可以按它们解决的问题来阅读:
| 问题 | 代表方法 | 核心机制 |
|---|---|---|
| 怎样组织推理过程 | DoT、DCoLT | DoT 把 CoT 放入并行去噪与训练期纠错;DCoLT 用结果奖励优化去噪轨迹,并学习 unmasking policy |
| 怎样构造 policy gradient 接口 | SEPO、diffu-GRPO | SEPO 使用 score entropy 与 importance sampling;diffu-GRPO 使用高效的一步概率估计 |
| 怎样增加覆盖、减少估计方差 | coupled-GRPO、UniGRPO | 互补掩码;或结构化地覆盖不同噪声水平并设计多任务奖励 |
| 怎样进行偏好对齐 | VRPO | 分配 Monte Carlo 预算,并在估计中共享时间步与损坏样本来降低方差 |
| 怎样减小近似带来的偏差 | SPG、wd1 | SPG 同时利用似然上下界;wd1 重写为加权似然形式,减少需要估计的项 |
| 怎样在显存限制下扩大采样 | BGPO | boundary-guided lower bound 与梯度累积支持更大的 Monte Carlo 样本量 |
| 怎样改善探索与过程奖励 | IGPO、SAPO | 部分注入真实推理轨迹引导探索;或设计与去噪步骤相对应的过程奖励 |
| 生成顺序是否总有益 | JustGRPO | 在 RL 中放弃有害的任意顺序探索,检验标准 GRPO 对推理能力的作用 |
这里应保留一个关键区别:文本里的推理步骤,与模型进行一次去噪更新,并不天然对应同一层次。DoT、DCoLT 和其他方法正是在尝试设计这种对应关系。
**阅读理解:**DLM 的推理后训练既涉及学会表达正确答案,也涉及如何评价轨迹、怎样揭示 token、奖励什么过程,以及怎样获得稳定的概率估计。
五、推理方法:并行能力如何转化为实际速度?
!在这里插入图片描述(https://i-blog.csdnimg.cn/direct/9b35eece8bbc4adf952cb22906d6588d.png) *原文图 5。六类机制分别为并行解码、unmasking/remasking、classifier-free guidance、KV cache、feature cache 和 step distillation。*
5.1 并行解码的关键是决定哪些预测可以同时兑现
一次前向可以预测多个位置,但过于激进地同时采样,可能破坏它们之间的依赖关系。
综述中的策略包括:Fast-dLLM 按置信度阈值选择 token;APD 借助辅助 AR 模型调节并行度;Slow-Fast Sampling 先谨慎建立稳定内容,再更积极地完成剩余部分;Learn2PD 学习哪些位置可以 unmask;dParallel 则通过训练促进多个位置同时达到较高确定性。
因此,实际并行度由预测状态、调度策略和训练共同决定,单次前向能够输出多个 token 分布只是起点。
5.2 Unmasking 与 remasking 决定修订范围
Unmasking 决定当前恢复哪些位置;remasking 决定哪些内容需要重新变为待恢复状态。
置信度排序、随机选择和温度等策略会影响生成质量与收敛速度。允许已解码位置重新掩码,可以增加修订机会,但也需要控制预算和更新策略。原文以 ReMDM 为例,说明 remasking budget 提供了计算量与质量之间的调节方式。
"迭代生成"与"能够反复改写全部已生成内容"需要区分,后者依赖具体采样机制。
5.3 Guidance 提供条件控制
原文给出的 classifier-free guidance 形式为:
s g u i d e d = s u n c o n d + λ ( s c o n d − s u n c o n d ) . s_{\mathrm{guided}} =s_{\mathrm{uncond}} +\lambda \left(s_{\mathrm{cond}}-s_{\mathrm{uncond}}\right). sguided=suncond+λ(scond−suncond).
λ \lambda λ 调节条件引导强度。这里组合的是去噪或 score 估计,用来改变生成轨迹对条件的响应。
综述还介绍了更具体的约束:FreeCache 利用 verifier 评价候选 token,DINGO 将正则表达式约束组织为自动机上的搜索。它们说明,控制还可以发生在解码与验证层面。
5.4 缓存的难点是上下文仍在变化
AR 的 causal attention 使历史 token 的 K、V 可以稳定复用。全序列 DLM 使用双向上下文时,其他位置的变化可能影响当前表示,所以缓存需要重新设计。
| 缓存路线 | 原文中的代表方法 | 复用依据 |
|---|---|---|
| 已完成块的缓存 | BD3-LM | block-causal 结构下固定前序块 |
| 近似跨步 KV 复用 | Fast-dLLM DualCache | 利用相邻去噪步中 prefix、suffix KV 的近似稳定性 |
| 延迟缓存 | dKV-Cache | 观察解码后表示的稳定性,延后存入缓存 |
| 自适应刷新 | d2 Cache、Elastic-Cache | 只更新变化较快的状态,或按 attention、层深检测漂移 |
| 中间特征缓存 | dLLM-Cache | 分别处理较稳定的 prompt 与变化更稀疏的 response,并检测是否需要刷新 |
**阅读理解:**token 的字面内容保持不变,与它在双向上下文中的表示保持不变,是两回事。缓存的正确性与近似程度,需要结合 attention 结构和刷新机制判断。
5.5 缓存与蒸馏优化不同部分
缓存主要减少每一步的重复计算;step distillation 则减少生成所需的步数,通过额外的训练让学生模仿教师。
原文分别讨论 Di4C 对离散扩散中的 token 相关性进行蒸馏,以及 DLM-One 对连续 DLM 进行一步生成蒸馏。它们的训练与建模设置不同,报告的加速倍数也对应各自的基线。
把推理过程写成两个层面,有助于理解这些策略:
推理总开销 ≈ 去噪步数 × 每步计算开销 . \text{推理总开销} \approx \text{去噪步数} \times \text{每步计算开销}. 推理总开销≈去噪步数×每步计算开销.
这是对综述推理优化部分的概括。质量控制、缓存和蒸馏可能共同作用,但它们改变的计算环节与代价并不相同。
六、核心证据:如何理解性能与生成行为?
6.1 减少步数,会改变错误的性质
原文图 7 使用同一道长方体体积题,比较 LLaDA 与 MMaDA 在不同去噪步数下的输出。题目的正确计算为:
( 2 x + 3 ) ( x + 1 ) ( x − 1 ) ∣ x = 4 = 11 × 5 × 3 = 165. (2x+3)(x+1)(x-1)\big|_{x=4} =11\times5\times3 =165. (2x+3)(x+1)(x−1) x=4=11×5×3=165.
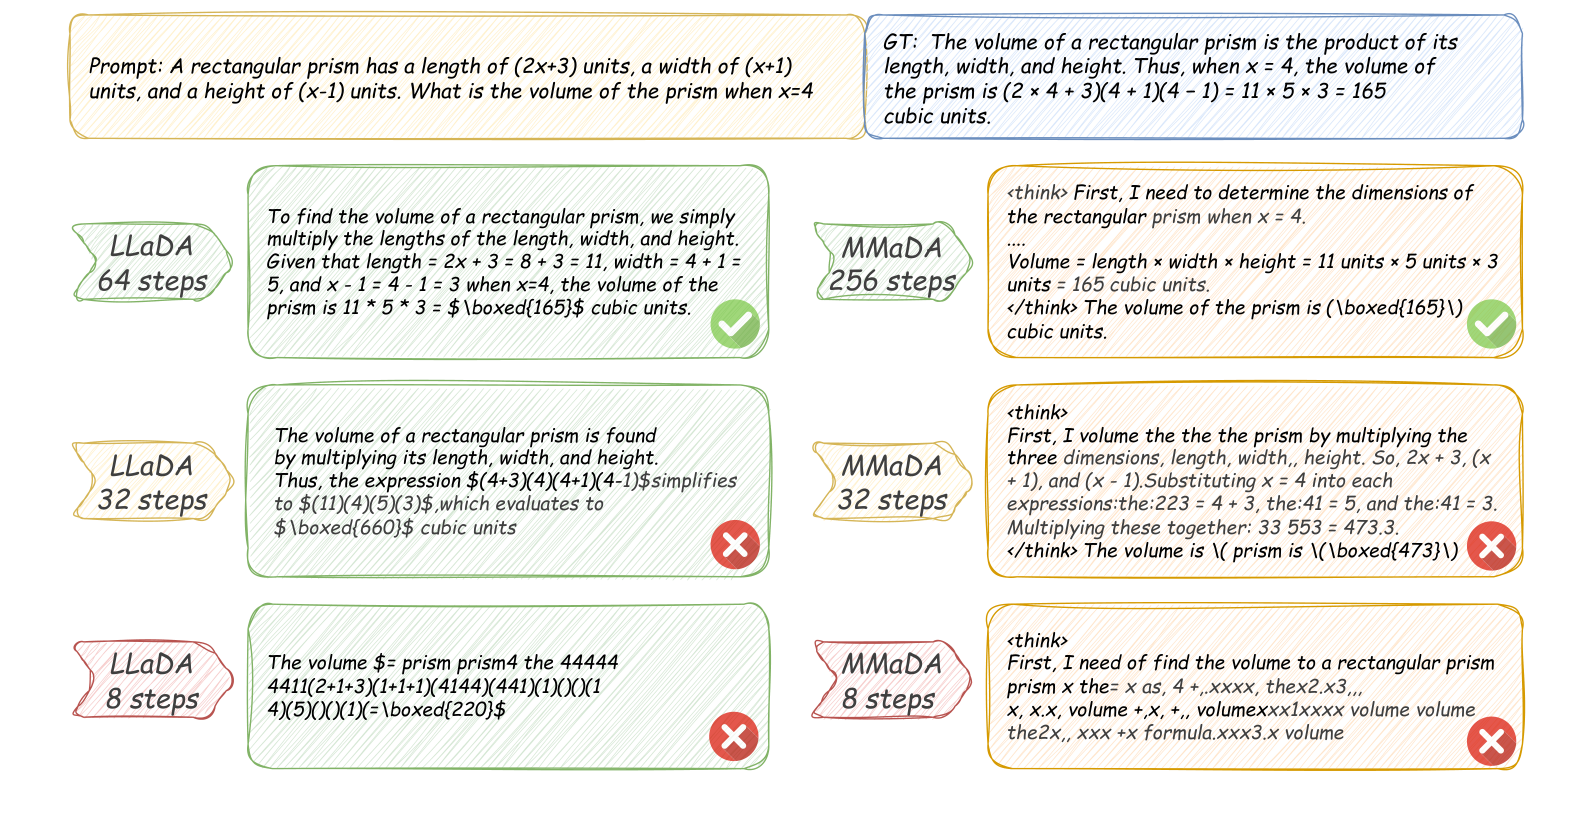
原文图 7。LLaDA 的生成长度设为 128,MMaDA 设为 256。步数减少后,图中的输出先出现错误答案,再出现明显的重复与不连贯。
按图中的固定生成长度除以步数,得到平均分配量:
| 模型 | 生成长度 | 去噪步数 | 长度 / 步数 | 图中观察 |
|---|---|---|---|---|
| LLaDA | 128 | 64 | 2 | 正确且连贯 |
| LLaDA | 128 | 32 | 4 | 错误答案 |
| LLaDA | 128 | 8 | 16 | 明显不连贯、错误 |
| MMaDA | 256 | 256 | 1 | 正确且连贯 |
| MMaDA | 256 | 32 | 8 | 错误答案 |
| MMaDA | 256 | 8 | 32 | 明显不连贯 |
"长度 / 步数"是根据图中设置计算的平均分配量,用于解释并行预算,不代表任意自适应采样器每一步的实时行为。
这个例子有两层含义:中等步数下,文本可以相对流畅但逻辑错误;并行度进一步增加时,连语言结构的一致性也可能被破坏。
**证据范围:**图 7 展示的是一个 prompt 的案例,支持并行度与质量之间存在权衡。它不能给出所有模型、所有任务都适用的最低步数阈值。
6.2 Parallel Decoding Curse 指向联合依赖
原文给了一个简明例子:训练数据只有"ABABAB"和"BABABA"。在每个位置上,A、B 都同样常见;但整个序列具有严格的交替结构。
如果多个位置只按各自的预测分布独立采样,就可能得到"AAABBA"这样的无效组合。AR 在确定第一个 token 后,后续条件能够体现交替关系;并行生成则需要通过已有上下文、迭代更新或额外策略协调新生成位置。
**阅读理解:**这里的问题是位置之间如何共同形成一致的序列。置信度调度、谨慎地建立稳定上下文、remasking 和验证,都是综述中与这一问题有关的路线。
6.3 任意顺序是设计空间,推理收益需要验证
DLM 能以不同顺序揭示 token,这种能力有利于 infilling 和结构控制;但对于推理任务,原文给出的证据更细致。
DCoLT 学习 unmasking policy,表明顺序可以进入优化过程;JustGRPO 则发现,在 RL 中放弃有害的 arbitrary-order exploration,可以更有效地激发推理能力。
因此,**可变顺序提供了选择空间,具体选择仍需服从任务中的依赖与训练目标。**它与"任何顺序都会改善推理"是不同的命题。
6.4 性能汇总显示潜力,也保留配置差异
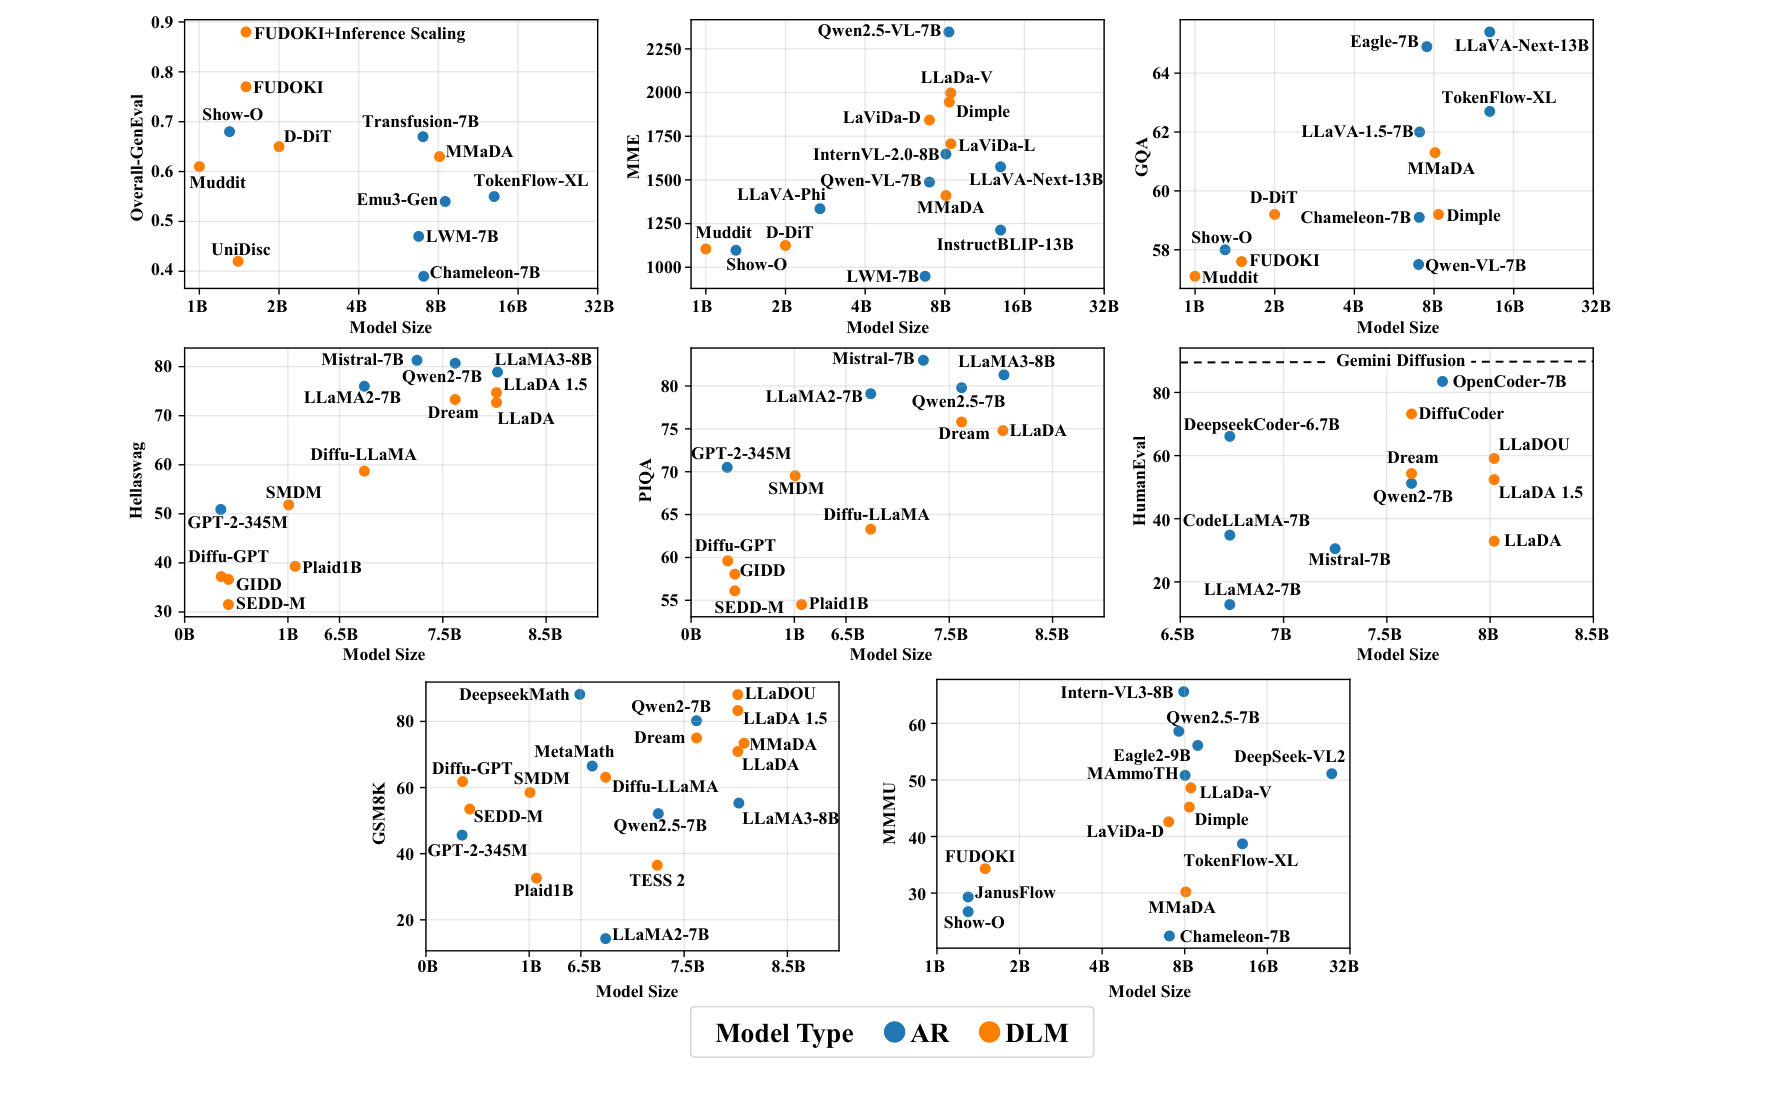
原文图 6。比较图像生成、视觉理解、语言理解、代码与数学推理等任务。第三项按子图坐标轴及正文记为 GQA;原图图注中该项写作 CQA。
作者在第 6 节说明,数据主要来自原始论文;缺少结果时,使用后续工作报告的可比较评价。因此,这张图是已有结果的汇总。
原文给出的整体观察包括:
- 一般语言理解中,LLaDA 等模型表现接近、或略低于同规模 AR 对照。
- 数学、科学相关任务中,LLaDA、Dream 等模型显示较强潜力。
- DiffuCoder 展示了 DLM 在代码这类结构与逻辑较强的领域中的竞争力。
- MMaDA、LLaDA-V 等多模态模型展示了扩散框架在跨模态理解与生成中的可能性。
解释这些结果时,需要保留训练起点、数据、后训练、推理步数和模型结构的差异。仅用参数规模对齐,不能把不同配置之间的差异全部归因于生成范式。
**阅读理解:**这张图支持 DLM 已覆盖多个具有竞争力的研究方向;要回答某项设计具体带来什么,则还需要相应方法中的对照与消融。
6.5 长序列开销取决于步数怎样增长
原文第 8 节分析:全双向 attention 的单步开销约为 O ( N 2 ) O(N^2) O(N2)。如果每一步只恢复固定数量 k k k 个 token,则去噪步数随序列长度增长:
S ≈ N k , S\approx\frac{N}{k}, S≈kN,
attention 总开销 ∼ S N 2 ≈ N 3 k . \text{attention 总开销} \sim SN^2 \approx\frac{N^3}{k}. attention 总开销∼SN2≈kN3.
当 k k k 固定时,就出现原文讨论的三次增长。这个结论具有明确条件:如果步数预算固定,或使用 block-causal、缓存等结构,计算方式就会变化。
此外,固定长度的生成画布可能在 EOS 之后仍被更新。逻辑上已经结束的文本,与实际停止对整个序列计算,需要由模型与解码设计共同处理。
原文也讨论了 LongLLaDA 和 UltraLLaDA,后者结合 RoPE scaling 与长上下文后训练,扩展到 128K。由此可见,长上下文是正在被改进的能力,原文对常见基线的长度限制不能被理解为整个 DLM 范式的固定上限。
6.6 加速结果需要与基线、质量一起读
综述汇总了并行解码、缓存、蒸馏和商业模型的加速报告。这些结果涉及不同模型、不同硬件或配置,以及不同的质量容许范围。
有些方法减少网络调用次数,有些复用中间计算,有些改变模型结构,还有些先承担蒸馏训练成本。它们共同说明系统优化的重要性,但不同论文中的倍数需要分别回到各自实验设置理解。
因此,评估 DLM 的实际价值时,应同时看生成质量、步数或并行预算、缓存机制、基线及端到端开销。
七、多模态与应用:去噪框架如何继续扩展?
7.1 视觉理解与统一生成是不同层次
| 路线 | 原文中的代表模型 | 方法特点 |
|---|---|---|
| 视觉编码器接入 DLM | LLaDA-V、LaViDa、Dimple | 将视觉特征投影到语言表示空间,用 DLM 生成文本响应 |
| 文本与图像共同离散去噪 | MMaDA、UniDisc、Muddit、Lumina-DiMOO | 对图像离散码与文本 token 组织统一建模 |
| 连续图像与离散文本共同建模 | D-DiT | 图像使用连续 latent 扩散,文本使用离散 masked diffusion,并联合优化 |
| 更一般的离散概率路径 | Fudoki | 使用 discrete flow matching,探索更有语义结构的扰动与自我修订 |
综述给出的两个训练观察尤其有助于理解这些路线。
LaViDa 的互补掩码关注目标覆盖:视觉问答中,关键答案 token 若没有进入损失,可能影响梯度信号。Dimple 则观察到纯离散扩散训练中的不稳定、性能与长度偏差,采用 Autoregressive-then-Diffusion:先通过 AR 训练建立视觉、语言对齐,再切换到扩散训练。
**阅读理解:**统一去噪框架可以有不同的数据表示和训练路径。最终模型采用扩散生成,与训练各阶段是否都从扩散开始,是两个需要分别描述的设计问题。
7.2 应用中被恢复的对象也不同
原文第 7 节展示,扩散过程可以作用于不同的任务对象:
- 常规 NLP:DiffusionNER 恢复实体边界,DiffuSum 生成摘要句表示,其他方法处理编辑、风格、翻译和受约束生成。
- 代码:DiffuCoder、DCoLT、DUS 等关注结构依赖、生成顺序及并行调度;DICE 面向 CUDA kernel 生成。
- 生物与科学:分子序列、蛋白序列及其结构可以通过条件生成或联合建模组织起来;DPLM2 联合处理序列与离散化结构。
- 机器人:VLA 模型将视觉、文本推理和动作纳入扩散建模;UD-VLA 同步去噪未来图像与动作 token。
这些应用的共同线索是在约束与上下文中迭代恢复相互关联的对象。各任务的表示、奖励和评价仍有自己的设计要求。
八、这篇综述留下了哪些研究问题?
原文最后的挑战与未来方向,可以与前面的机制逐一对应:
| 已讨论的问题 | 原文提出的研究方向 |
|---|---|
| 并行采样损害一致性 | 改善 token 依赖建模、约束和采样策略 |
| 训练目标覆盖与效率 | 改进训练方案和混合架构 |
| 长序列、动态长度成本 | 改进上下文扩展、缓存和生成机制 |
| 模型与推理成本 | 探索低比特量化、二值化、剪枝和蒸馏 |
| 多模态能力尚未充分整合 | 加强跨模态统一推理 |
| 实际部署与交互能力 | 完善基础设施,探索 DLM-based agents |
该版本表 1 已记录 LLaDA2.0 的更大模型,以及多种混合、长上下文和多模态扩展。作者对 scalability 的讨论,关注的是更充分的大规模验证及与成熟 AR 体系的差距,而非一个固定的参数量上限。
**阅读理解:**这篇综述最值得保留的视角,是把概率建模、生成顺序、后训练估计器与推理系统放在一起。DLM 的并行潜力是真实的设计空间;它在某项任务中是否形成优势,则要通过这些层面的具体实现与证据来判断。