深入理解 C 语言:预处理与宏从定义到条件编译实战
预处理(Preprocessing)是 C 语言编译过程的第一个阶段。编译器在正式翻译代码前,会先由预处理器对源代码进行文本级别的处理。如果说结构体是"内存布局的蓝图",那么预处理就是"编译前的总指挥"。它允许我们定义常量、编写宏函数、控制代码的编译条件,甚至实现跨平台的条件编译。
本文将严格以13个核心预处理知识点为大纲,从底层文本替换的视角出发,带你彻底吃透 C 语言预处理的底层逻辑。所有代码均保证可以直接编译运行。
目录
- 一、预定义符号
- [二、
#define定义常量](#define 定义常量) - [三、
#define定义宏](#define 定义宏) - 四、带有副作用的宏参数
- 五、宏替换的规则
- 六、宏函数的对比
- [七、
#和##](# 和 ##) - 八、命名约定
- 九、
#undef - 十、命令行定义
- 十一、条件编译
- 十二、头文件的包含
- 十三、其他预处理指令
- 十四、总结
一、预定义符号
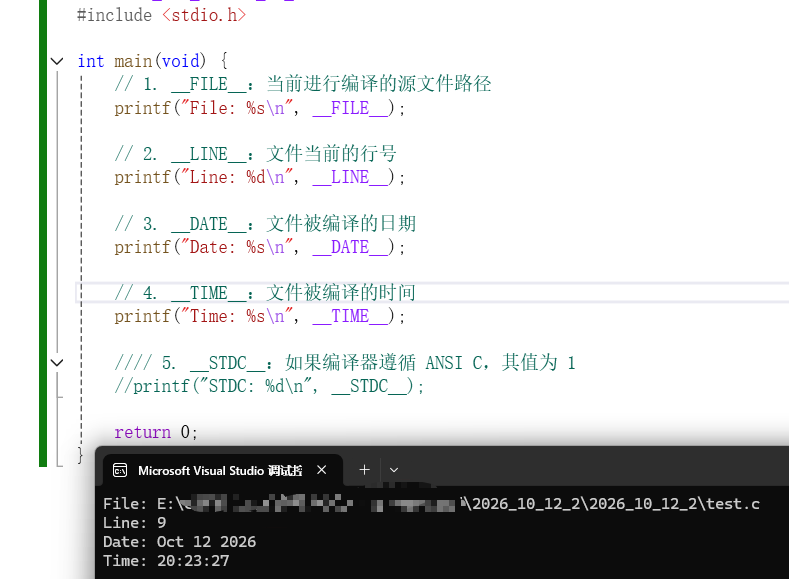
C 语言标准规定了一些预定义符号,它们在编译时由编译器自动填充。这些符号在调试、日志记录和跨平台代码中非常有用。
c
#include <stdio.h>

int main(void) {
    // 1. __FILE__:当前进行编译的源文件路径
    printf("File: %s\n", __FILE__);

    // 2. __LINE__:文件当前的行号
    printf("Line: %d\n", __LINE__);

    // 3. __DATE__:文件被编译的日期
    printf("Date: %s\n", __DATE__);

    // 4. __TIME__:文件被编译的时间
    printf("Time: %s\n", __TIME__);

    // 5. __STDC__:如果编译器遵循 ANSI C,其值为 1
    printf("STDC: %d\n", __STDC__);

    return 0;
}
c
#include <stdio.h>

int main(void) {
    // 1. __FILE__:当前进行编译的源文件路径
    printf("File: %s\n", __FILE__);

    // 2. __LINE__:文件当前的行号
    printf("Line: %d\n", __LINE__);

    // 3. __DATE__:文件被编译的日期
    printf("Date: %s\n", __DATE__);

    // 4. __TIME__:文件被编译的时间
    printf("Time: %s\n", __TIME__);

    // 5. __STDC__:如果编译器遵循 ANSI C,其值为 1
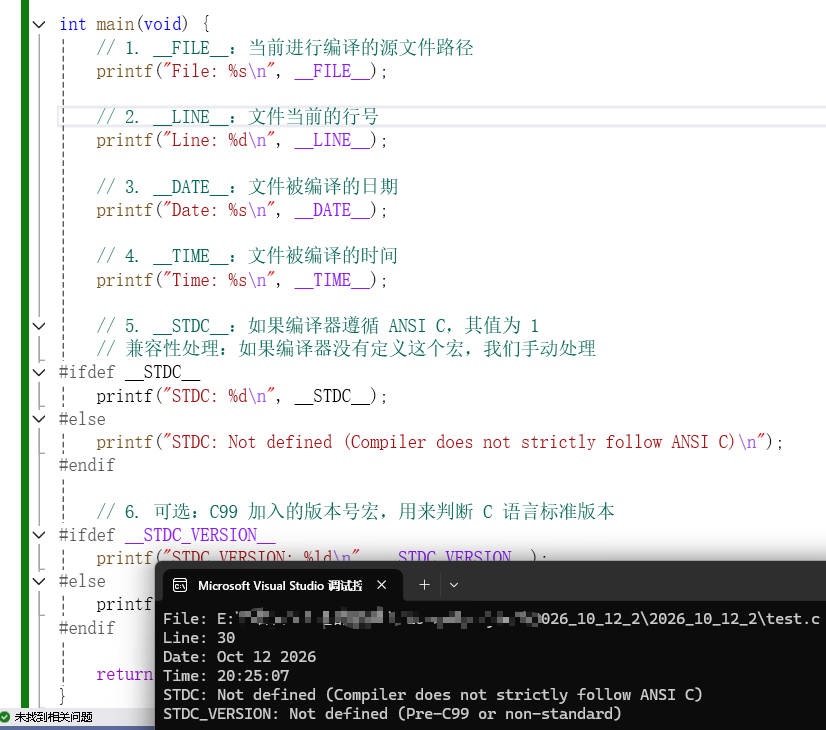
    // 兼容性处理:如果编译器没有定义这个宏,我们手动处理
    #ifdef __STDC__
        printf("STDC: %d\n", __STDC__);
    #else
        printf("STDC: Not defined (Compiler does not strictly follow ANSI C)\n");
    #endif

    // 6. 可选:C99 加入的版本号宏,用来判断 C 语言标准版本
    #ifdef __STDC_VERSION__
        printf("STDC_VERSION: %ld\n", __STDC_VERSION__);
    #else
        printf("STDC_VERSION: Not defined (Pre-C99 or non-standard)\n");
    #endif

    return 0;
}
要点总结:
- 本质是编译期字面量替换 :这些符号由预处理器在编译阶段直接替换为字面量,不占用任何运行时内存,也没有运行时开销。它们既不是变量,也不是函数。
__FILE__和__LINE__是调试利器 :-
它们分别代表当前源文件名和当前行号。
-
在工程中,通常将它们封装在日志宏中,用于精准定位错误发生的位置。例如:
c#define LOG_ERROR(msg) \ fprintf(stderr, "[ERROR] %s:%d: %s\n", __FILE__, __LINE__, msg) -
配合断言(
assert)使用,能在程序崩溃时快速定位问题代码。
-
__DATE__和__TIME__记录编译时间戳 :- 分别代表源文件被编译的日期(如
"Oct 12 2026")和时间(如"14:30:00")。 - 常用于版本信息打印,或者用于判断当前运行的二进制文件是否是最新编译的(防止旧版本覆盖新版本)。
- 分别代表源文件被编译的日期(如
__STDC__和__STDC_VERSION__判断编译标准 :__STDC__:如果编译器遵循 ANSI C 标准,其值为1,否则未定义(或为0)。__STDC_VERSION__:C99 引入的宏,用于指示具体的 C 标准版本。例如 C99 为199901L,C11 为201112L,C17 为201710L。- 在跨平台代码中,可以通过
#if __STDC_VERSION__ >= 199901L来判断是否支持 C99 特性(如变长数组、inline关键字等)。
- C99 补充:
__func__获取当前函数名 :- 虽然严格意义上它不是一个预处理器宏(而是 C99 标准规定的预定义标识符),但在实际开发中常与预定义符号配合使用。
- 它会在函数内部展开为一个指向当前函数名字符串的静态数组。例如在
main函数中打印__func__会输出"main"。
- 避坑提示 :
- 这些符号区分大小写 (如
__FILE__不能写成__file__)。 - 不要试图对它们取地址(如
&__LINE__),因为它们在预处理阶段就被替换成了常量,而非内存实体。 - 在某些极端的嵌入式编译器中,可能不支持某些符号(如
__func__),使用前需确认编译器文档。
- 这些符号区分大小写 (如
核心心法:预定义符号是编译器留给开发者的"后门",用它们在代码中埋下定位坐标,但切忌在正式发布(Release)版本中泄露敏感的绝对路径信息(__FILE__ 可能包含源码路径)。
二、#define 定义常量
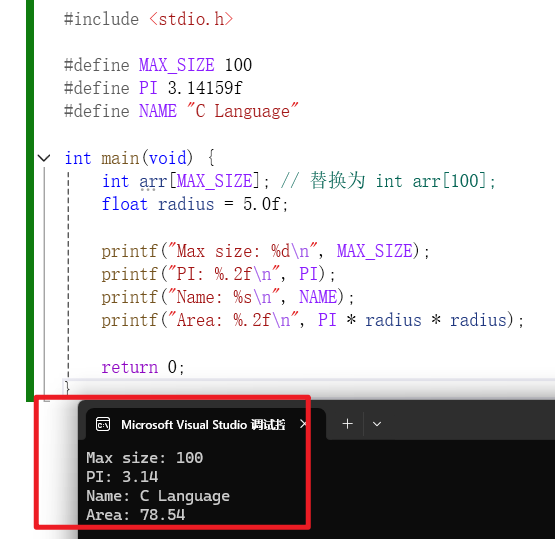
#define 最基本的用法是定义标识符常量。在预处理阶段,编译器会将代码中出现的标识符直接替换为对应的文本。
c
#include <stdio.h>

#define MAX_SIZE 100
#define PI 3.14159f
#define NAME "C Language"

int main(void) {
    int arr[MAX_SIZE]; // 替换为 int arr[100];
    float radius = 5.0f;

    printf("Max size: %d\n", MAX_SIZE);
    printf("PI: %.2f\n", PI);
    printf("Name: %s\n", NAME);
    printf("Area: %.2f\n", PI * radius * radius);

    return 0;
}
要点总结:
- 本质与特性 :
#define是预处理阶段的纯文本替换,不占用内存、无类型检查、无法取地址,替换后的宏名在符号表中不存在,调试时不可见。 - 与
const的核心对比 :const有内存实体、有类型安全、可调试、遵循块作用域;#define无内存实体、无类型概念、不可调试、全局生效(直到#undef)。现代 C 工程首选const或enum定义常量 ,仅条件编译或定义数组维度时才用#define。 - 两大语法陷阱 :
- 末尾绝不加分号 :
#define MAX 100;会让int arr[MAX];展开为int arr[100;];,直接报错。 - 表达式必加括号 :
#define ADD 1 + 2,在3 * ADD中会展开为3 * 1 + 2 = 5。规范写法:#define ADD (1 + 2)。
- 末尾绝不加分号 :
- 多行与命名规范 :多行宏需用反斜杠
\续行(\后不能有空格);宏名必须全大写 (如MAX_SIZE),防止与变量/函数命名冲突。 - 避坑提示: :纯替换、无内存;末尾勿加分号;表达式必加括号;调试不可见,现代 C 优先用
const。
三、#define 定义宏
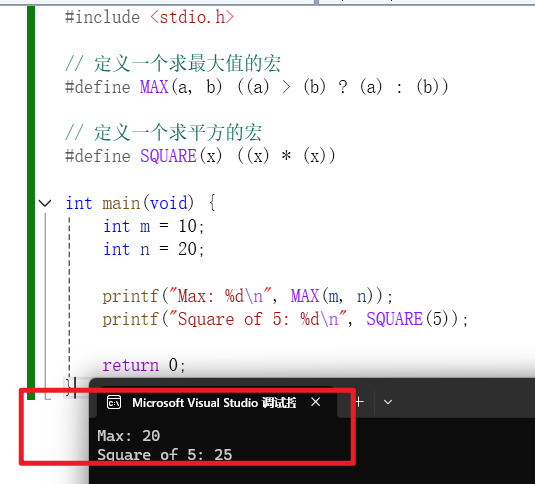
宏是一种带参数的替换机制。它看起来像函数,但在预处理阶段进行文本替换,不涉及函数调用的开销。
c
#include <stdio.h>

// 定义一个求最大值的宏
#define MAX(a, b) ((a) > (b) ? (a) : (b))

// 定义一个求平方的宏
#define SQUARE(x) ((x) * (x))

int main(void) {
    int m = 10;
    int n = 20;

    printf("Max: %d\n", MAX(m, n));
    printf("Square of 5: %d\n", SQUARE(5));

    return 0;
}
避坑提示:
-
括号是宏的生命线(优先级陷阱):
- 参数必须加括号 :如果写成
#define SQUARE(x) x * x,调用SQUARE(1 + 2)会展开为1 + 2 * 1 + 2,结果是 5 而不是 9。因为*的优先级高于+,参数替换后破坏了原有运算逻辑。 - 整个宏体也必须加括号 :仅给参数加括号是不够的!例如
#define ADD(a, b) (a) + (b),在2 * ADD(3, 4)中会展开为2 * (3) + (4),结果是 10 而不是 14。必须写成#define ADD(a, b) ((a) + (b))。 - 规范写法 :最外层括号保护整体,每个参数外层括号保护自身,即
((x))或((a) + (b))。
- 参数必须加括号 :如果写成
-
宏没有类型(泛型双刃剑):
- 泛型优势:宏参数没有数据类型,可以是整数、浮点数、甚至结构体,这使得宏比函数更具泛型性,一份定义就能处理多种类型。
- 缺乏类型检查 :宏不会进行任何类型安全检查,也不会发生隐式类型转换(
const的"隐式转换"问题在宏中完全不存在)。例如MAX("abc", 123)编译器不会报错类型不匹配,而是会在替换后产生晦涩难懂的编译错误,调试极为痛苦。 - 操作符兼容性 :泛型意味着宏体中的操作符必须对传入的类型有效。如果宏体内使用了
+,而你传入了指针,就会产生未定义行为。
-
代码膨胀与调试困难:
- 代码膨胀:每调用一次宏,代码就会在调用处展开一次。如果宏体较大且调用频繁,会急剧增加二进制文件体积(代码膨胀),而函数调用则只有一份代码。
- 调试不可见:宏在预处理阶段就被展开,编译器报错时行号指向宏调用处,但错误信息往往是展开后的代码,调试器(GDB)也无法在宏展开的代码中单步执行,难以定位逻辑错误。
四、带有副作用的宏参数
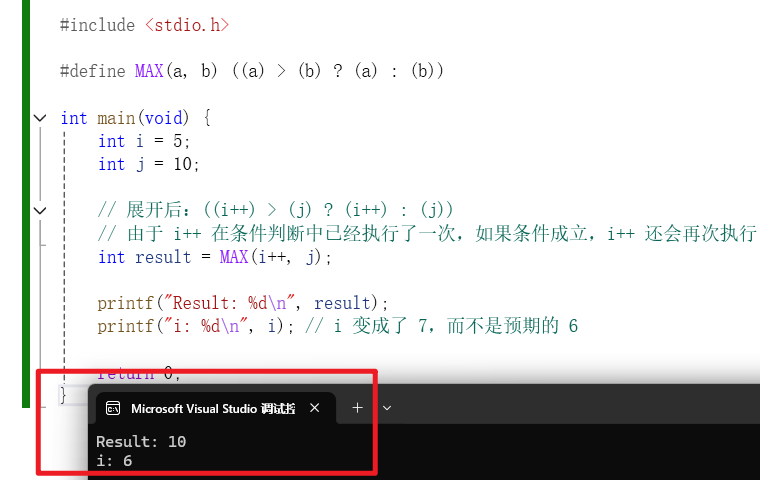
这是宏使用中最经典的陷阱。如果宏的参数在宏体中被多次使用,而传入的参数带有副作用(如 i++),就会导致不可预期的结果。
c
#include <stdio.h>

#define MAX(a, b) ((a) > (b) ? (a) : (b))

int main(void) {
    int i = 5;
    int j = 10;

    // 展开后:((i++) > (j) ? (i++) : (j))
    // 由于 i++ 在条件判断中已经执行了一次,如果条件成立,i++ 还会再次执行
    int result = MAX(i++, j);

    printf("Result: %d\n", result);
    printf("i: %d\n", i); // i 变成了 7,而不是预期的 6

    return 0;
}
要点总结:
- 副作用 :
i++、i--等操作在宏中会被多次执行,导致变量值被意外修改。 - 避坑建议 :绝对不要将带有副作用的表达式作为宏的参数 。如果必须使用,建议改用
static inline函数(C99 起支持)来替代宏。
五、宏替换的规则
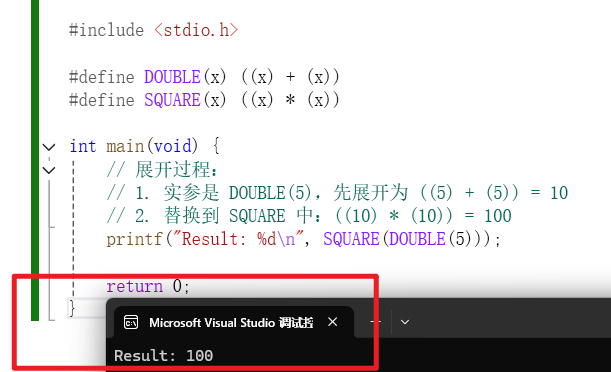
理解宏替换的步骤,有助于排查复杂的宏展开问题。预处理阶段,宏替换遵循以下规则:
- 参数替换:在调用宏时,首先检查参数,如果参数中包含其他宏,则先展开参数。
- 文本替换:将宏体中的参数替换为传入的实参。
- 再次扫描:替换完成后,预处理器会再次扫描结果,如果其中还包含宏,则继续替换。
c
#include <stdio.h>

#define DOUBLE(x) ((x) + (x))
#define SQUARE(x) ((x) * (x))

int main(void) {
    // 展开过程:
    // 1. 实参是 DOUBLE(5),先展开为 ((5) + (5)) = 10
    // 2. 替换到 SQUARE 中:((10) * (10)) = 100
    printf("Result: %d\n", SQUARE(DOUBLE(5)));

    return 0;
}
要点总结:
- 宏替换是递归且带"预展开"的(核心机制) :
- 宏替换并非简单的一遍扫描。预处理器在处理带参宏时,遵循严格的步骤:① 实参预展开 (先检查传入的参数本身是否包含其他宏,如果有,先展开);② 参数替换 (将展开后的实参代入宏体);③ 重新扫描(对替换后的结果再次扫描,如果还包含宏,继续展开,直到没有宏为止)。
- 代码示例 :
#define DOUBLE(x) ((x)+(x)),#define SQUARE(x) ((x)*(x))。当调用SQUARE(DOUBLE(5))时,预处理器先展开DOUBLE(5)为((5)+(5)),再代入SQUARE,最终结果为((((5)+(5)))*((5)+(5))),而非简单的文本拼接。
- 宏替换发生在编译之前,不占用运行时间(时间与空间的权衡) :
- 零运行时开销:替换在预处理阶段完成,不涉及函数调用(无栈帧创建、无参数压栈、无返回跳转),因此执行效率极高。
- 代码膨胀代价:不占用运行时间,但会占用编译时间,且每次调用都会在调用处展开一次,导致二进制文件体积增大(空间换时间)。
- 特殊抑制:
#和##阻断预展开(进阶避坑) :- 如果在宏体中使用了字符串化操作符
#或记号粘贴操作符##,预处理器不会对这两个操作符对应的参数进行预展开,而是直接使用原始文本。这一点在嵌套宏调用时极易踩坑。
- 如果在宏体中使用了字符串化操作符
- 递归的死循环风险 :
- 虽然标准规定宏不能递归(例如
#define A A),预处理器通常能够检测并阻止直接递归。但如果在不同宏之间形成间接循环(如#define A B和#define B A),可能会导致预处理器陷入死循环或报错。宏替换是"一条道走到黑"的文本替换,不具备图灵完备性。
- 虽然标准规定宏不能递归(例如
六、宏函数的对比
宏和函数在 C 语言中各有优劣,理解它们的区别是写出高效、健壮代码的关键。
| 特性 | 宏 (#define) |
函数 |
|---|---|---|
| 代码长度 | 每次使用都会展开,代码体积变大 | 函数代码只出现一份,体积小 |
| 执行速度 | 直接替换,无调用开销,速度更快 | 有函数调用和返回的开销 |
| 类型检查 | 无类型检查,容易出错 | 有严格的类型检查 |
| 调试 | 预处理阶段展开,难以调试 | 可以逐语句调试 |
| 副作用 | 容易产生副作用(如 i++) |
参数在调用时求值一次,无副作用 |
| 递归 | 不能递归 | 可以递归 |
避坑提示:
- 如果逻辑简单且性能要求极高,可以使用宏。
- 如果逻辑复杂、代码量较大,或者需要类型安全检查,务必使用函数。
- C99 引入的
static inline函数结合了宏的速度和函数的类型安全,是现代 C 语言的首选。
七、# 和 ##
这两个预处理操作符用于在宏中实现更高级的文本操作。
1. # 字符串化操作符
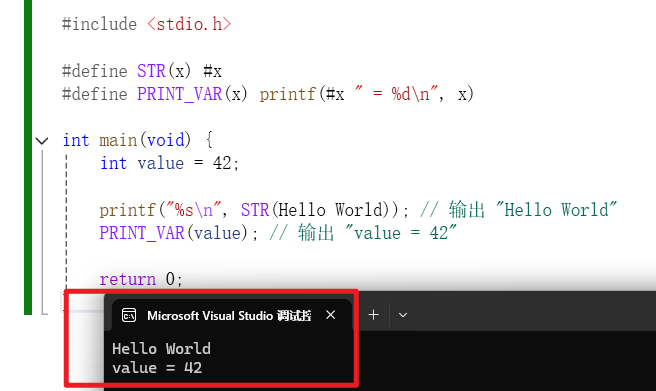
# 用于将宏参数转换为字符串字面量。
c
#include <stdio.h>

#define STR(x) #x
#define PRINT_VAR(x) printf(#x " = %d\n", x)

int main(void) {
    int value = 42;

    printf("%s\n", STR(Hello World)); // 输出 "Hello World"
    PRINT_VAR(value); // 输出 "value = 42"

    return 0;
}
2. ## 记号粘贴操作符
## 用于将两个记号(Token)连接成一个新的记号。
c
#include <stdio.h>

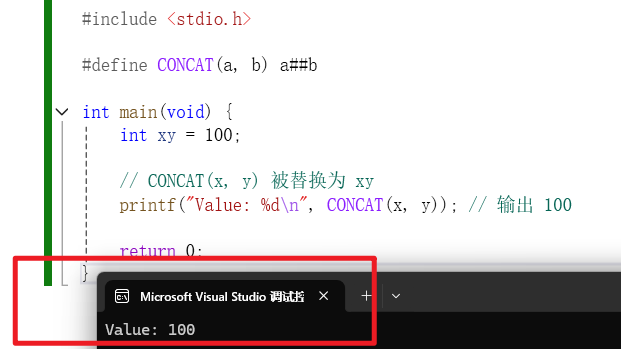
#define CONCAT(a, b) a##b

int main(void) {
    int xy = 100;

    // CONCAT(x, y) 被替换为 xy
    printf("Value: %d\n", CONCAT(x, y)); // 输出 100

    return 0;
}
# 与 ## 要点总结:
#:字符串化
把宏参数变成字符串,常用于调试宏,直接打印变量名和值。##:记号粘贴
把两个记号拼成一个新标识符,常用于批量生成变量名或函数名。- 共同陷阱:阻断预展开
#和##都不会先展开参数中的宏;若需先展开,必须用间接宏(如STR/XSTR)包装。 ##硬性限制
不能出现在宏体首尾,只能夹在两个记号之间;拼接结果必须是合法 C 记号,否则编译报错。- 工程建议
元编程利器,但预处理后完全不可见,调试困难,慎用并加注释。
八、命名约定
为了避免宏与函数、变量之间的命名冲突,工程中通常遵循以下约定:
- 宏名全大写 :如
MAX_SIZE、DEBUG。这是 C 语言最广泛的约定,用于在阅读代码时一眼区分宏与普通函数、变量。 - 函数名小写 + 下划线 :如
get_max(),这是 C 语言的标准风格;若团队使用驼峰,则统一为GetMax()。关键是保持项目内风格一致。 - 避免使用保留标识符 :以下划线开头后跟大写字母或另一个下划线(如
__MAX__、_Max)的标识符,以及双下划线开头的标识符,均保留给编译器和标准库使用,用户代码绝对不要使用。 - 宏名加项目/模块前缀 :如
MYLIB_MAX_SIZE,可有效避免与第三方库或系统头文件中的宏发生冲突。
避坑提示:
- 不要定义与标准库函数同名的宏(如
#define printf、#define malloc),会导致不可预知的错误,甚至破坏标准库行为。 - 宏名应具有描述性,避免使用
a、b等无意义的名称,也要避免使用max、min、temp等过于通用的词。 - 函数式宏同样遵循全大写约定(如
MAX(a,b)),但要注意与函数名区分。 - 头文件保护宏建议使用
_HEADER_H风格,但不要用双下划线开头 ,推荐PROJECT_HEADER_H。
九、#undef
#undef 用于取消一个已定义的宏。这通常用于限制宏的作用域,或者在包含头文件后取消不需要的宏。
c
#include <stdio.h>

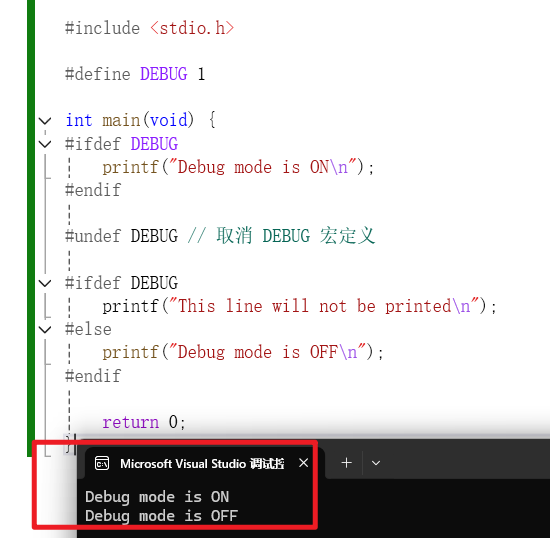
#define DEBUG 1

int main(void) {
    #ifdef DEBUG
        printf("Debug mode is ON\n");
    #endif

    #undef DEBUG // 取消 DEBUG 宏定义

    #ifdef DEBUG
        printf("This line will not be printed\n");
    #else
        printf("Debug mode is OFF\n");
    #endif

    return 0;
}
要点总结:
#undef后,该宏不再有效。- 通常配合条件编译使用,用于清理不再需要的宏定义。
十、命令行定义
在编译时,可以通过命令行参数定义宏,这在构建不同版本(如 Debug 和 Release)时非常有用。
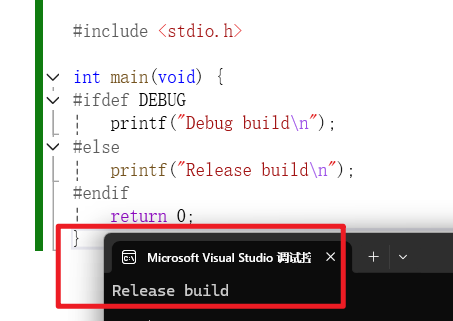
示例代码 (main.c):
c
#include <stdio.h>

int main(void) {
    #ifdef DEBUG
        printf("Debug build\n");
    #else
        printf("Release build\n");
    #endif
    return 0;
}
命令行定义:
编译命令示例:(了解即可,仅供参考0
bash
# 生成 Debug 版本(定义 DEBUG 宏)
gcc -DDEBUG main.c -o debug_app

# 生成 Release 版本(不定义 DEBUG,或显式取消)
gcc main.c -o release_app

# 定义带值的宏(注意等号两边不能有空格)
gcc -DVERSION=2 -DMAX_SIZE=100 main.c -o app

# 强制取消代码中的宏定义(-U 优先级高于 -D)
gcc -UDEBUG main.c -o release_app
要点总结:
-D定义宏 :等价于在源文件开头写#define 宏名(或#define 宏名 值),但命令行优先级更高,常用于构建系统切换配置(Debug/Release、不同平台、不同功能开关)。-U取消宏 :强制取消代码中已定义的宏,优先级高于-D和文件内的#define,可用于覆盖默认配置。- Makefile 常见用法 :通过
CFLAGS += -DDEBUG或条件判断传递不同宏,实现一套代码多版本构建。 - 避坑提示 :
- 宏值中若包含空格或特殊字符,必须用引号包裹,如
-DMSG="Hello World"。 - 若源文件中已定义同名宏,命令行
-D会引发重定义警告,最终以命令行定义为准(或根据编译器行为覆盖)。 - 不同编译器(GCC/Clang/MSVC)的选项略有差异,MSVC 使用
/D,跨平台构建时需用 CMake 等工具屏蔽差异。
- 宏值中若包含空格或特殊字符,必须用引号包裹,如
- 建议 :命令行定义适合编译期配置,不宜滥用;复杂配置建议用头文件或构建系统管理。
十一、条件编译
条件编译允许我们根据不同的条件编译不同的代码。这在跨平台开发、调试代码、防止头文件重复包含中极为重要。
1. 常用指令
#if、#elif、#else、#endif#ifdef、#ifndefdefined()操作符
c
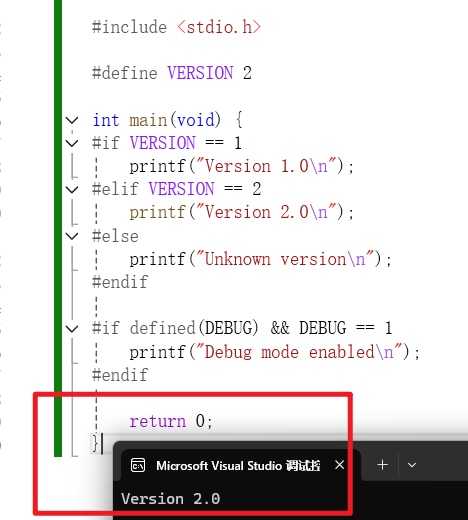
#include <stdio.h>

#define VERSION 2

int main(void) {
    #if VERSION == 1
        printf("Version 1.0\n");
    #elif VERSION == 2
        printf("Version 2.0\n");
    #else
        printf("Unknown version\n");
    #endif

    #if defined(DEBUG) && DEBUG == 1
        printf("Debug mode enabled\n");
    #endif

    return 0;
}
2. 防止头文件重复包含(头文件卫士)
这是条件编译最经典的应用。
c
// header.h
#ifndef HEADER_H
#define HEADER_H

// 头文件内容
int add(int a, int b);

#endif // HEADER_H
避坑提示:
- 条件编译在预处理阶段完成,不满足条件的代码根本不会进入编译阶段。
#ifdef和#if defined()的区别:#if defined()更灵活,可以组合多个条件。
十二、头文件的包含
#include 指令用于将其他文件的内容包含到当前文件中。有两种包含方式:
1. #include <stdio.h>(尖括号)
- 用于包含标准库头文件。
- 编译器会直接在系统标准库路径中查找。
2. #include "my_header.h"(双引号)
- 用于包含自定义头文件。
- 编译器首先在当前源文件所在目录查找,如果找不到,再去系统路径查找。
要点总结:
- 使用尖括号查找速度通常更快。
- 自定义头文件使用双引号,方便工程组织。
- 头文件中只放声明,不放定义 (除非是
static inline函数或const常量),否则会导致多重定义错误。
十三、其他预处理指令
除了上述常用指令,C 语言还提供了一些其他预处理指令:
-
#error:在编译时生成错误信息,通常用于检查编译环境。c#ifndef __STDC__ #error "This compiler does not conform to ANSI C" #endif -
#line:修改__LINE__和__FILE__的值,通常用于代码生成工具。c#line 100 "my_file.c" printf("%d\n", __LINE__); // 输出 100 -
#pragma:用于向编译器传递特定指令。最常用的是#pragma once(保证头文件只被包含一次)和#pragma pack(修改内存对齐,如结构体文章中所述)。c#pragma once
避坑提示:
#pragma指令是编译器相关的,不同编译器支持不同,跨平台时需谨慎。
十四、总结
结合预处理与编译的底层视角,我们可以提炼出预处理的通关心法:
- 预定义符号是调试利器 :
__FILE__、__LINE__在日志中不可或缺。 #define是文本替换:不占用内存,没有类型,但要注意括号和副作用。- 宏与函数各有所长 :简单逻辑用宏,复杂逻辑用函数,现代 C 语言首选
static inline。 #和##是高级技巧:字符串化和记号粘贴在元编程中威力巨大。- 条件编译是跨平台和调试的基石 :
#ifdef和头文件卫士是工程代码的标配。 - 头文件包含有讲究 :
<>找系统,""找当前目录,防止重复包含是基本素养。
核心心法:宏定义是文本替换,条件编译是编译开关。 掌握预处理,才能写出高效、可移植、易维护的 C 语言代码。
各位大佬,留个关注支持一下吧!!