引子:你每天都在用它,却未必说得清它
先看四件毫不相干的事。
你在官网下载软件,页面角落挂着一串 64 位英数字符,你从没点开看过。你注册某个 App,服务器转身就把密码变成一串乱码存进数据库,没人再记得你的原文。你问 AI 一个问题,它回答得又快又稳,而这段对话背后其实经过了好几次"取指纹---验指纹"。还有那个宣称数据一经写入便不可篡改的区块链。
这四件事的底层,站的是同一个东西------哈希算法。
它极其低调:不占头条,不露脸,很多人还以为它和"加密"是一回事。但它又是整个数字世界最硬的一块地基------你可以把服务器重启、把数据库迁到另一个半球,只要哈希还在,数据是否被改过一个比特,就会被当场识破。
一、一句话定义:把任意大的东西,压成固定尺寸的锁
哈希算法,是一种把任意长度的输入,转换成固定长度输出的确定性规则。
输入叫"消息"或"原文",输出叫哈希值 (Hash Value),也叫摘要 (Digest)、指纹(Fingerprint)------三种叫法指的是同一件事。
请特别注意"任意长度"四个字。它的跨度有多大?一个英文字母 a 是 1 字节,一部高清电影是几十 GB,一个数据中心的归档数据是几个 ZB。可只要用的是同一个算法,这几样东西丢进去,出来的哈希值长度完全一样。如果是 SHA-256,那永远是一串 256 比特、也就是 64 个十六进制字符的字符串,一个不多,一个不少。
就像一台神奇的压缩机器:不管你把一卡车棉花还是一枚硬币扔进去,它吐出来的永远是一张身份证大小的卡片。卡片内容完全由原料决定,但你无法从卡片反推出原料是什么。
这听着像变魔术,背后却是天经地义的数学事实:把无限多的输入映射到有限多的输出,输出必然被重复使用。这句话是理解哈希全部安全性与全部局限性的钥匙。
至于"确定性",意思是同样输入永远得到同样输出------不限时间、不限机器、不限你在北京还是里约热内卢。
二、三大特性:吃透这三条,哈希就没有秘密
特性一:同输入,必同输出
用 SHA-256 计算 Hello,得到:
185f8db32271fe25f561a6fc938b2e264306ec304eda518007d1764826381969你今天算、换台十年后的新电脑算、用另一种语言算------只要输入还是那五个字符,输出的这一长串就一个字都不会变。
这条特性解决了一个价值千金的难题:跨时空比对 。你要确认一份 50GB 的备份和三个月前异地机房里的那份完全一致,逐字节比对要搬运 50GB 数据;而比哈希值,只需要搬运 64 个字符。数据量差了差不多九个数量级,结论的可靠性却是一样的------因为特性一保证了:两份文件内容相同,哈希必然相同;哈希不同,内容必然不同。
现实中几乎所有软件分发、容器镜像、Git 版本库、云存储的完整性校验,都建立在这条特性上。
特性二:微小改动,结果天翻地覆
这是哈希最反直觉、也最迷人的一条,业内叫雪崩效应(Avalanche Effect)。
还是 Hello,只把首字母改成小写变成 hello------没增字符,没减字符,没有任何结构变化。对比两次输出:
Hello  →  185f8db32271fe25f561a6fc938b2e264306ec304eda518007d1764826381969
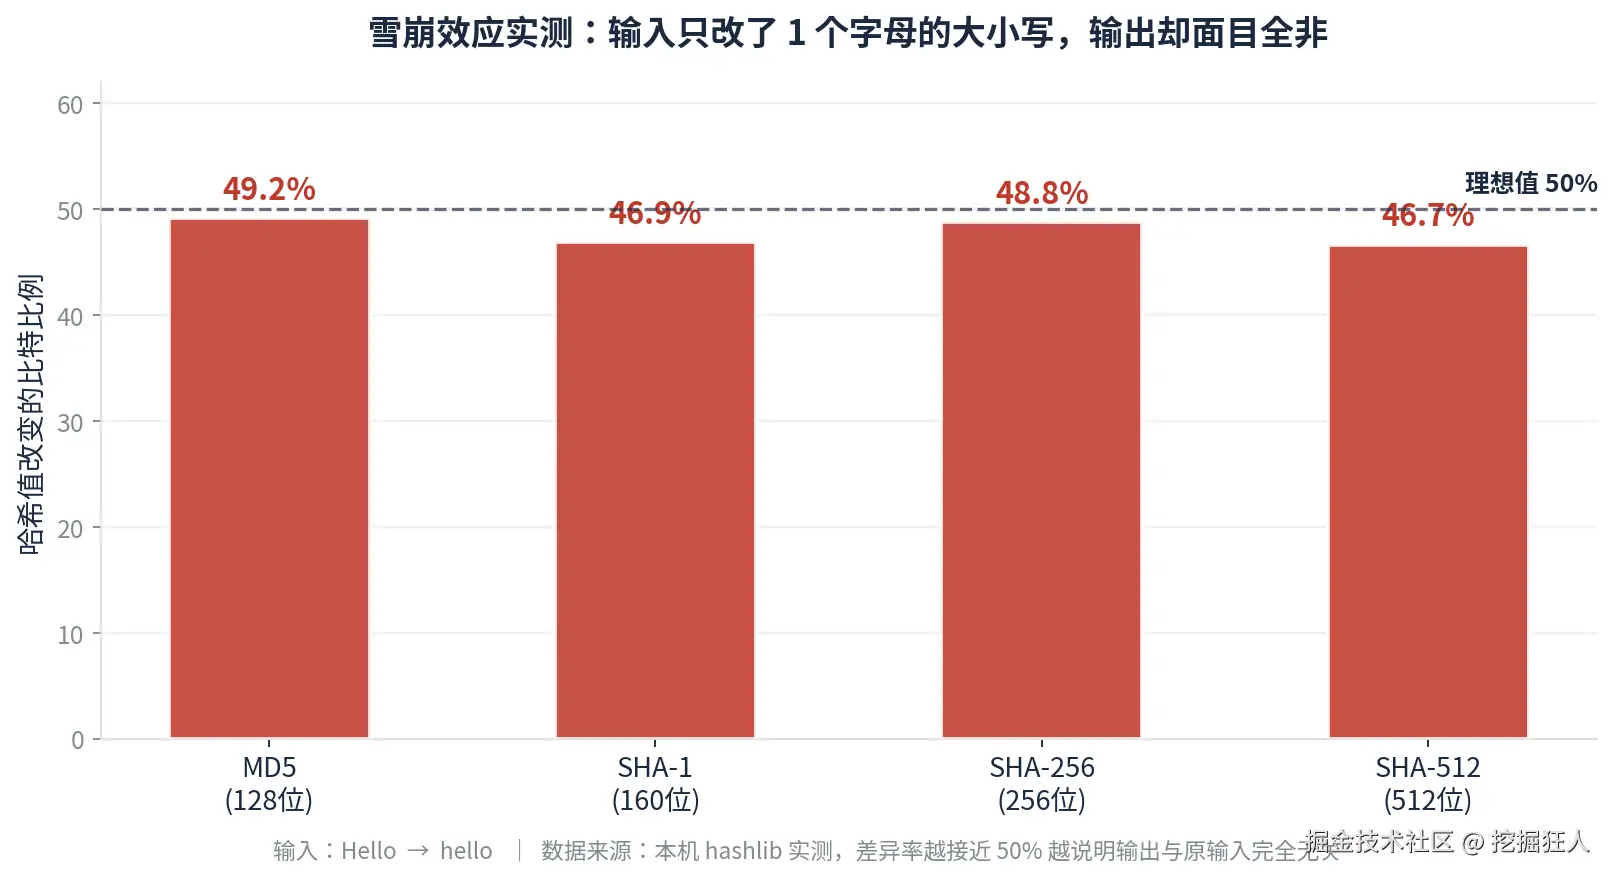
hello → 2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824请诚实盯一会儿这两行。它们之间有任何可以辨认的"血缘关系"吗?找不到。这不是巧合,而是设计目标:一套合格的哈希算法,要求输入端任何一个比特的翻转,都让输出端大约一半的比特跟着翻转------输出与输入的关系应该看起来完全随机。
我实测了一遍,把 Hello 改成 hello,统计各算法输出的比特差异:
| 算法 | 输出位数 | 改变比特数 | 差异比例 |
|---|---|---|---|
| MD5 | 128 | 63 | 49.2% |
| SHA-1 | 160 | 75 | 46.9% |
| SHA-256 | 256 | 125 | 48.8% |
| SHA-512 | 512 | 239 | 46.7% |
理想值是 50%,四种算法都紧贴这个数字------输入只动了 1 个字符的大小写,输出却有一半的比特彻底翻了个面。
好处非常实际:它让"修改数据而不被发现"变得几乎不可能。你无法偷偷加一个空格、换一个标点,然后指望哈希"只变一点点"来蒙混过关。任何一丝篡改,都会在摘要上炸出一个完全陌生的结果。
特性三:输出长度永久固定
无论输入多大,输出长度是写死在算法规格里的常量。我用真实数据跑了一遍,让输入体积跨越八个数量级------从 1 字节的 a,到 100MB 的重复字符------SHA-256 的输出始终是 64 个字符,SHA-512 始终是 128 个,没有任何浮动。
这条为什么重要?因为它让哈希值可以被当作"定长的数据类型"使用。如果长度随输入变化,你就没法把它存进数据库的固定字段,没法塞进网络协议的固定报头,没法用固定大小的数组索引它。正是因为长度固定,哈希才从"一种计算"变成了"一种可以存储、传输、比较、索引的数据"------这才是它能渗透进几乎所有系统的前提。
三条如何咬合: 特性一保证结果可比 → 于是能校验;特性二保证改动藏不住 → 于是能防篡改;特性三保证结果可存储可索引 → 于是能做数据结构。三者缺一,哈希都成不了地基。
三、四条应用线索:从下载按钮到区块链
线索一:每个安装包,都带着一枚指纹
你在官网下载软件,页面旁边常挂着一串 SHA256: abc123...。很多人以为那是装饰或版本号,其实它是安全凭证。
流程很朴素:官方发布文件时算出 SHA-256,把值和文件一起公布;你下载完成后在本机算一遍。两者一致 ,说明你拿到的文件与官方发布的那一刻逐比特相同------传输没出错,没被劫持注入广告,没被中间人替换成带后门的版本。不一致,说明文件已被改动,直接删掉,不要安装。
起作用的是特性一与特性二的组合:特性一让你能在相隔万里的两台机器上比对同一份文件;特性二保证任何细微篡改都会导致哈希彻底对不上,攻击者无法靠"改动很小"逃避检测。Linux 发行版、容器镜像、驱动包、固件------凡是要保证"从源头到你手上没被动手脚"的,都得靠哈希。
线索二:正规网站从不存你的密码------但也不能只存哈希
结论先行:正规网站不会明文存密码,存的是哈希值。 你注册时系统算一次哈希入库;登录时再算一次,和库里比对,一致放行,不一致报错。整个过程中系统本身也不知道你的真实密码。就算数据库被拖走,黑客手里也只有一堆哈希字符串。
但这里有个全网都该知道的坑:只做哈希,远远不够。
问题出在人身上。太多人用 123456、admin、password 这类弱密码。而特性一告诉我们------同一个密码,在全世界任何一台机器上算出来都是同一个哈希。实测:
123456   → 8d969eef6ecad3c29a3a629280e686cf0c3f5d5a86aff3ca12020c923adc6c92
admin    → 8c6976e5b5410415bde908bd4dee15dfb167a9c873fc4bb8a81f6f2ab448a918
password → 5e884898da28047151d0e56f8dc6292773603d0d6aabbdd62a11ef721d1542d8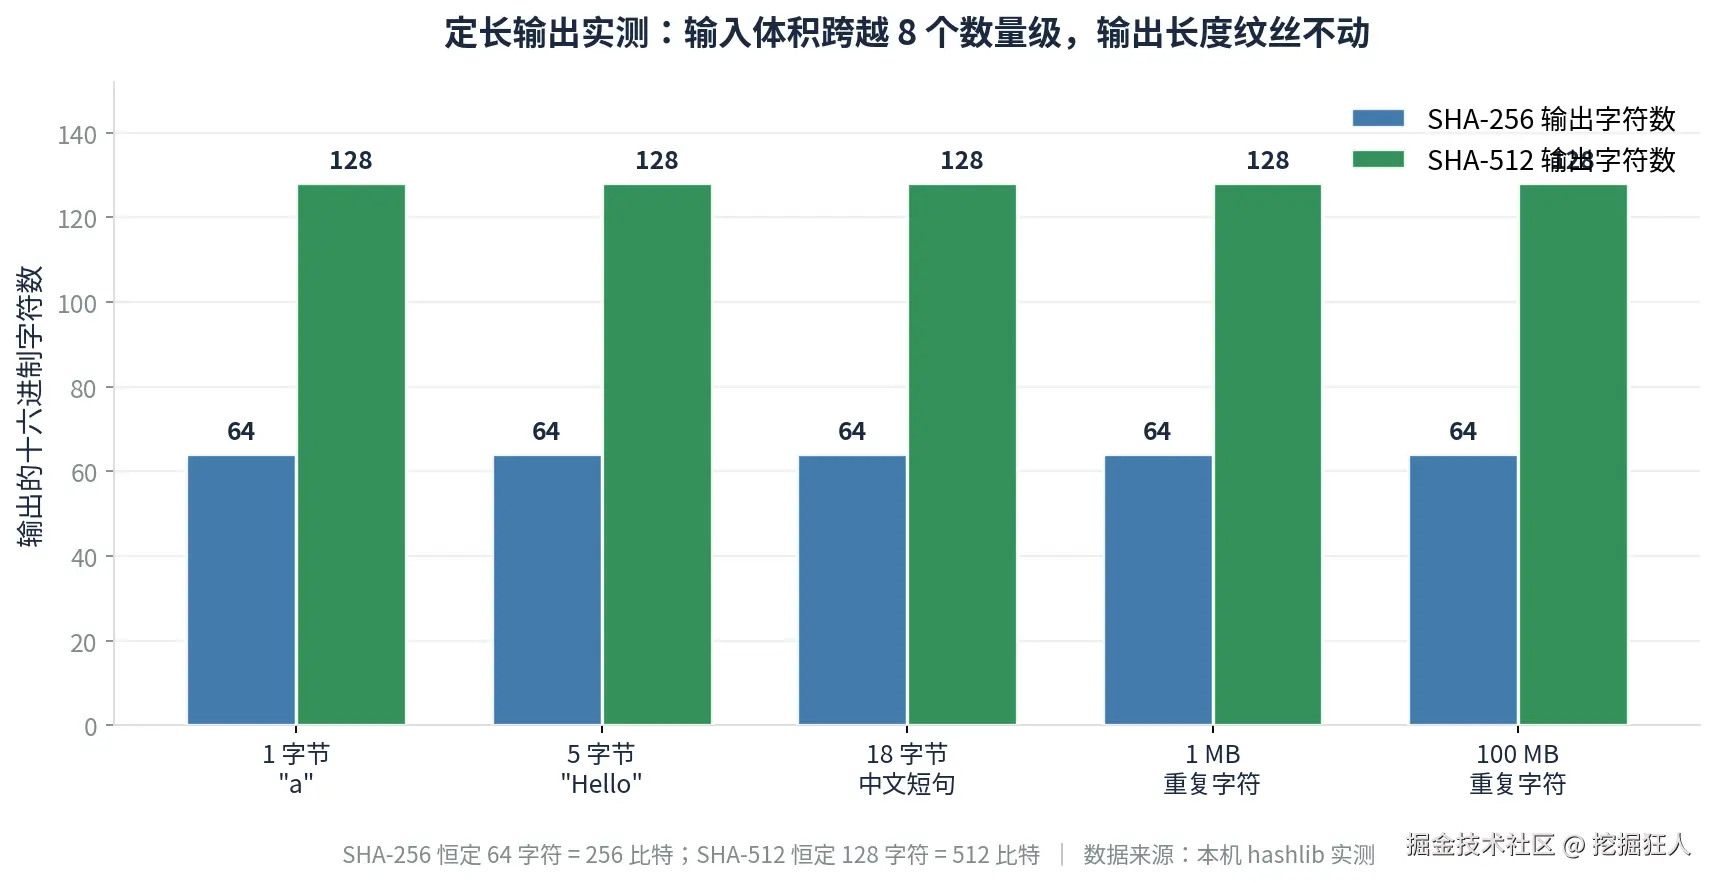
这些值是全网通用 的。黑客可以提前把所有常见密码算一遍,做成一张"明文 → 哈希"对照表------就是彩虹表 (Rainbow Table)。拿到泄露的哈希后,他不需要破解任何算法,只要查表就能当场还原原文。
解法叫"加盐"(Salting) :为每个账户随机生成一串专属字符(盐),与密码拼接后再哈希。关键在于每个账户的盐都不同、且随机生成 。实测同一个密码 123456 配四个不同的盐:
123456   → 8d969eef6ecad3c29a3a629280e686cf0c3f5d5a86aff3ca12020c923adc6c92
admin    → 8c6976e5b5410415bde908bd4dee15dfb167a9c873fc4bb8a81f6f2ab448a918
password → 5e884898da28047151d0e56f8dc6292773603d0d6aabbdd62a11ef721d1542d8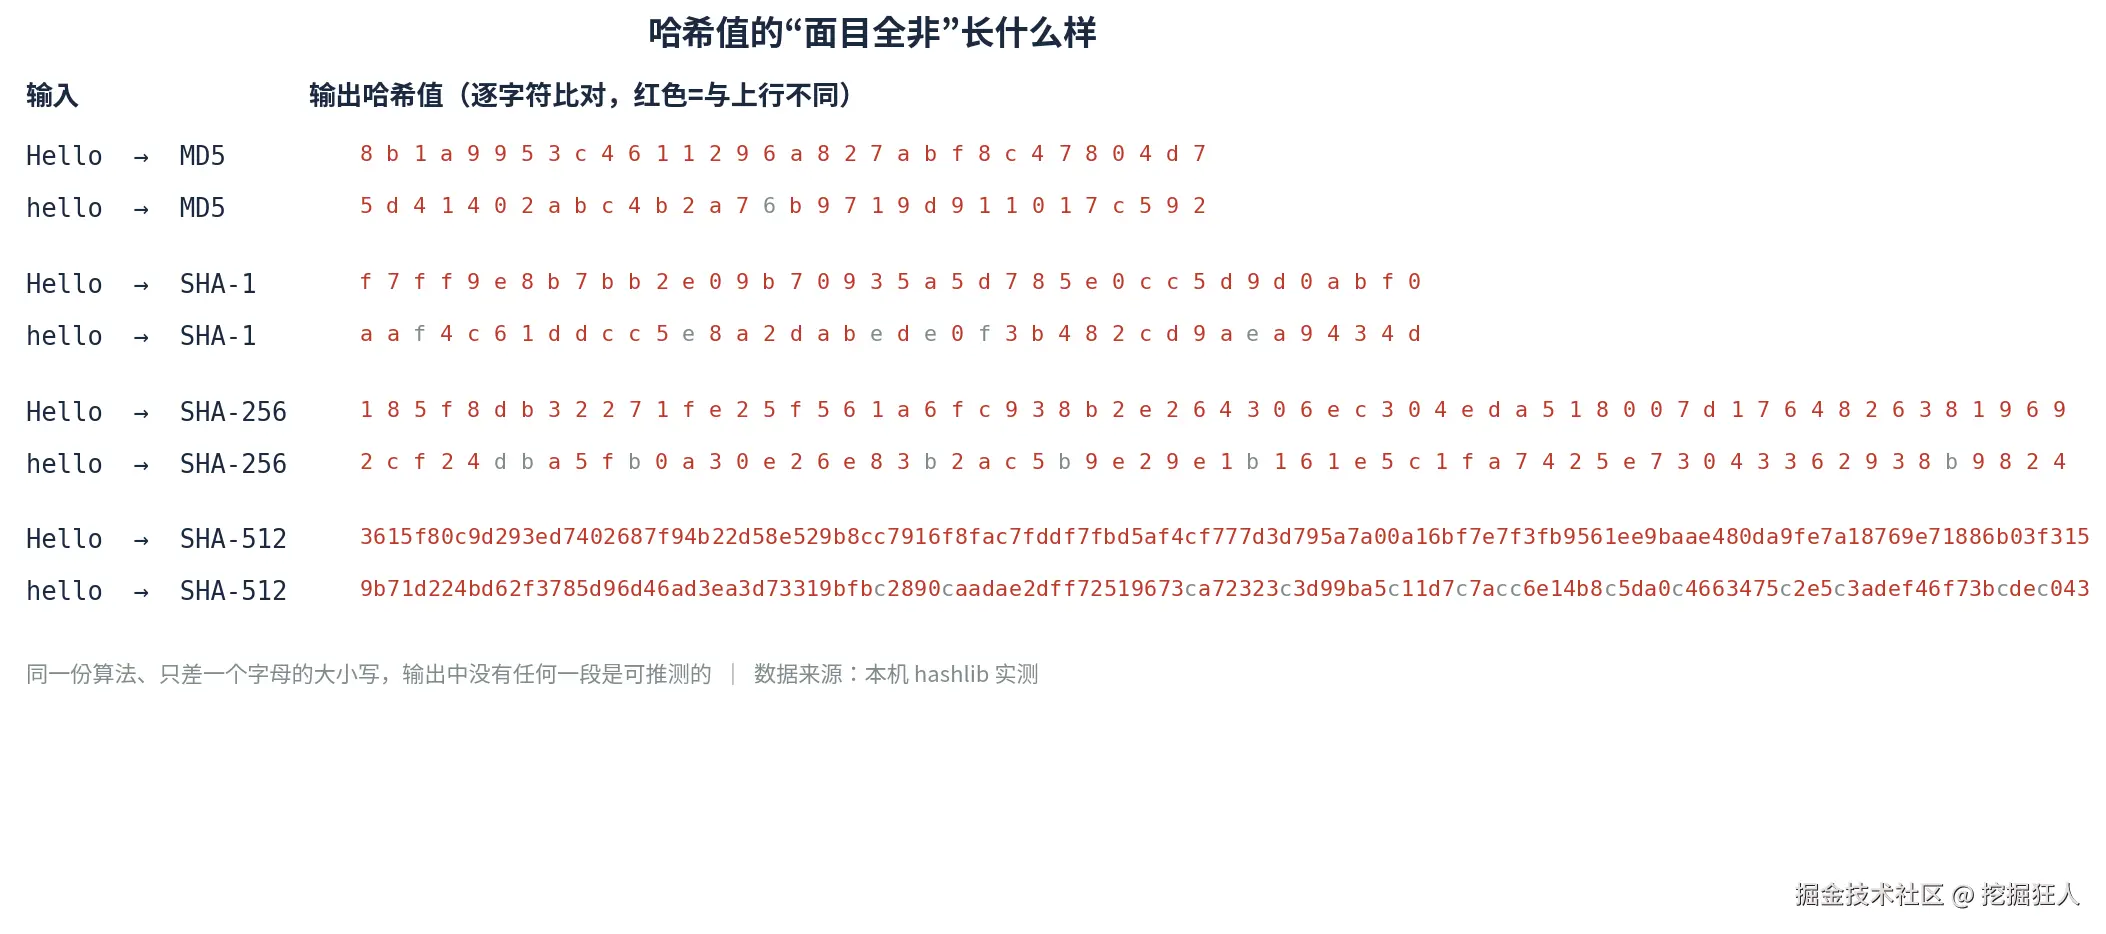
同一个密码,四个完全不同的哈希。彩虹表就此失效------因为盐是随机的、每账户一份,攻击者必须为每一个盐单独建表,预计算在算力上直接不成立,批量还原退化成逐个暴力穷举。
记住:盐本身不需要保密,通常和哈希值一起明文入库。它的作用不是"藏起来",而是让每个账户的哈希各不相同,废掉预计算表的规模效应。
再说选型,这比想象中更要紧:
| 算法 | 定位 | 能否存密码 |
|---|---|---|
| MD5 | 128 位,已有严重漏洞,可人为构造碰撞 | 绝对不行 |
| SHA-1 | 160 位,NIST 已于 2011 年弃用,2013 年起禁止用于数字签名 | 不行 |
| SHA-256 / SHA-384 / SHA-512 | 当前主流通用安全算法 | 可以,但不够好 |
| bcrypt / scrypt / Argon2 | 专为密码存储设计 | 推荐 |
最后两行的区别藏着一个很反直觉的设计思路。SHA-256 非常快------每秒能算几十亿次。对文件校验来说快是优点;对密码存储来说,快是致命缺点 ,因为它让攻击者的暴力枚举也变快了。bcrypt、scrypt、Argon2 的设计目标恰恰相反:故意变慢、故意吃内存。它们可调成本参数,让每次验证耗时几十到几百毫秒------对用户毫无感觉,对每秒想试几十亿次的攻击者来说成本被抬到天上。Argon2 更进一步,专门增加内存开销,用来对抗 GPU 与专用芯片的并行破解。
一句话原则:校验文件用快的(SHA-256),存密码用慢的(bcrypt / Argon2)。
线索三:AI 大模型的数据交互,也在默默用哈希
这一条很少有人讲,却是哈希在当代最典型的"隐形在场"。
一是请求完整性。 你的请求抵达服务端前,可能经过负载均衡器、网关、缓存层。要保证这一路报文没被损坏或篡改,链路层会附带校验值。数据量越大,逐字节比对越不划算,哈希摘要就是最经济的核对手段。
二是模型与数据集的校验。 开源大模型的权重文件动辄几十 GB,训练数据集可能是 TB 级,下载、同步、分片分发时都要确认完整性。尤其是训练数据集------里面哪怕万分之一的样本被污染,都可能影响模型行为。用哈希校验,是唯一可行且成本可控的方案。
三是缓存与去重。 这是最巧妙的一处。同一个 prompt 被大量用户重复提交很常见,系统如何"认出"两次请求其实是同一个问题?最直接的办法就是把请求内容算成哈希,用哈希值作为缓存键:哈希相同,直接返回上次算好的结果,不必再跑一遍价值不菲的推理。效率来源还是特性一------同样的输入必然得到同样的哈希,于是可以用一个定长的短字符串去索引一段昂贵的计算结果。
你在网盘、内容平台见过的"秒传"同理:系统先算文件哈希,发现库里已有,就把你的文件指向已有副本,一秒完成。
线索四:区块链的"不可篡改",本质是一根哈希链条
它的核心结构简单得令人意外:每个区块里,都存着前一个区块的哈希值。
scss
区块 N-1 的内容 → 算出哈希 H(N-1),写进区块 N 的头部
区块 N   的内容 → 算出哈希 H(N),  写进区块 N+1 的头部 ...... 首尾相连
假设有人想篡改区块 N-1 里的某条交易记录。根据特性二,哪怕他只改一个字符,区块 N-1 的哈希也会天翻地覆,变成 H'(N-1) ≠ H(N-1)。可区块 N 的头部记的是旧哈希------链条在这一环断掉了 。更麻烦的是,由于区块 N 的内容也依赖头部这个哈希,区块 N 的哈希同样跟着变,进而让区块 N+1 也对不上......一个区块的改动会沿链条一路传导,导致后续所有区块的哈希全部失效。
这就是区块链无法作假的真正原因。它不靠什么神秘黑科技,而是靠雪崩效应 + 链式引用 ,把"改一处"的成本放大成"改所有后续区块,并且要在全网算力竞赛中重算并获胜"。哈希在这里充当数据之间的信任接口:把"内容是否被改过"这个难以直接检验的问题,转化成"一个定长字符串是否相等"这个毫秒级的判断。
还有个更普遍、更基础的应用:哈希表(HashMap)。 几乎每门语言里最常用的数据结构之一就是它。原理是用哈希函数把键(key)直接映射到数组中的某个位置,于是查找不再需要从头遍历,而是一步定位。字典、集合、缓存、数据库索引背后都是它。它之所以可行,还是那三条特性:输出定长(能当数组下标)、结果确定(存进去和取出来能找到同一位置)、分布均匀(数据不会挤在一起)。哈希表把"查找"从线性时间问题变成近乎常数时间问题------这是计算机科学里最漂亮的一次"用数学换性能"。
四、绕不开的专业词:哈希碰撞
哈希碰撞 (Collision):两段完全不同的数据,算出了完全相同的哈希值。
很多人第一次听到会紧张:这不就说明哈希不安全吗?冷静一下,回到第一节那把钥匙:输入可以是无限多的,输出长度却是固定、有限的。
SHA-256 有 2²⁵⁶ 种可能的输出------比可观测宇宙里的原子总数还大得多。它确实大得离谱,但它是有限的 。而可能的输入是无限的。把无限多的东西塞进有限多的格子里,必然有格子被塞进不止一样东西 ------这是逻辑学里的鸽巢原理 。所以数学上,碰撞不是"可能发生",而是必然存在。
那安全性从何而来?答案在于:碰撞存在,和你能找到碰撞,是完全不同的两件事。
安全性评估的真正标准,是看算法把碰撞难度抬到多高:
- MD5 已被淘汰,原因不是输出太短,而是黑客能用极低成本人为构造出两个内容不同但 MD5 相同的文件------"哈希一致但内容不同"可以被伪造,在数字签名、软件分发场景里是灾难性的。
- SHA-1 走同一条路。NIST 于 2011 年宣布弃用,2013 年起禁止用于数字签名;2017 年 Google 公开的 SHAttered 项目构造出了真实可验证的 SHA-1 碰撞文件,宣告它彻底退出安全领域。
- SHA-256 / SHA-3 目前几乎无法被人为构造碰撞。按已知攻击进展估算,找一个 SHA-256 碰撞的计算量是天文数字。现实中的攻击者不会走这条路------他们会去攻击实现漏洞、撞库、钓鱼,那些便宜得多。
这里有个反直觉但至关重要的推论:碰撞的"必然存在"恰恰保护了你。 因为输出空间固定且巨大,一个随机改动过比特的文件,其哈希恰好落到与原文相同那一个格子的概率是 1/2²⁵⁶------小到你穷尽此生所有计算设备也撞不到。特性二说的"改动必被发现",在概率上正是靠这个支撑。
一句话记忆:判断算法安不安全,不看它会不会碰撞(一定会),只看它把碰撞成本抬到了多高。
五、把整条线索收起来
哈希的本质:把任意长度的数据,压成固定长度的摘要。
三条特性:① 同输入必同输出,结果可跨机器跨时间比对;② 微改动即大变化(雪崩效应),任何篡改都会暴露;③ 输出长度固定,摘要可被存储、传输、索引。
四项核心能力 :① 校验完整性 ------下载的文件、传输的数据,拿哈希对一下就知道有没有被动过;② 安全存储密码 ------存哈希而非明文,配合加盐与慢哈希算法抵御彩虹表和暴力破解;③ 构建高效索引 ------哈希表用一步定位替代线性遍历,撑起几乎所有语言的基础数据结构;④ 支撑不可篡改结构------区块链靠链式哈希引用,把"改一处"变成"改全链"。
一个必须知道的坑:裸哈希不安全,加盐 + 慢算法(bcrypt / Argon2)才是密码存储的正确做法。
一个必须理解的概念:碰撞必然存在,但难度决定安全。MD5、SHA-1 被淘汰,不是因为它们会碰撞,而是因为它们把碰撞变得容易了。
结语:简单,所以可靠
哈希算法没有依赖任何复杂的黑科技,它建立在两件最朴素的数学事实之上:确定性的映射,和有限的输出空间。
正是这近乎无聊的简单,让它成了一切的基础。校验用它的确定性,防篡改用它的雪崩效应,索引使用它的定长输出,区块链用它构造不可断裂的链条。它不发声、不出镜,藏在每个安装包的角落、每一行密码字段里、每一次点击背后的数据结构中。
所以下次你在下载页看到那串 SHA256: 185f8db3...,你会知道:那不是装饰性的乱码,而是一枚只有 64 个字符、却能守住整个文件完整性的指纹。
哈希算法,是现代网络、数据安全与分布式系统的地基。它看着小众,实则贯穿你每一次上网。