H3-World 的动作控制,为什么不能只靠一句提示词?
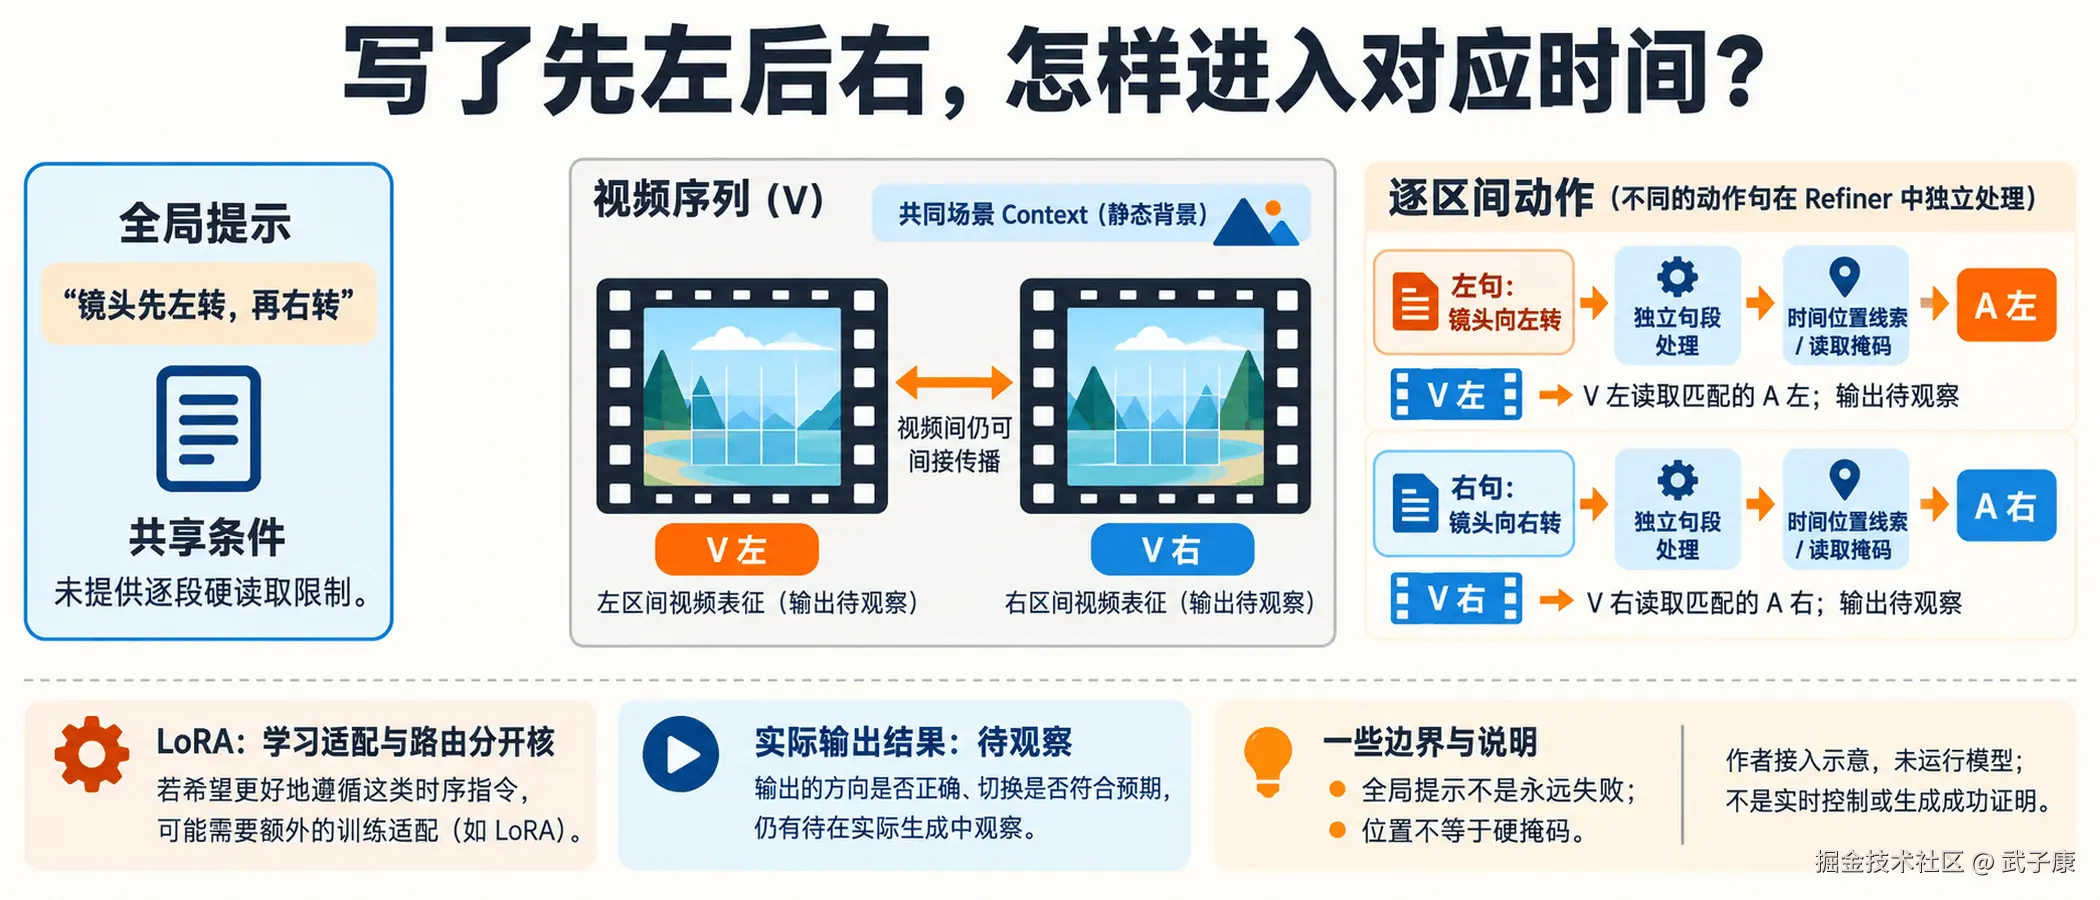
作者静态机制/未执行记录;不代表模型生成成功或实时测量。
给视频模型写"镜头先向左转,再向右转",听起来已经把动作和顺序交代清楚了。但模型读懂左右,不等于这两个方向分别进入了指定的视频时间段。H3-World 要解决的就是这个差别:动作仍用语言表达,时间归属却不能只留在一句全局描述里。
本文以 2026 年 10 月 12 日核对的论文 v1 与官方固定代码为准。讨论对象是按动作生成固定长度视频片段的接口,不是实时游戏控制器。没有运行模型、下载权重或测量设备延迟。逐帧动作如何压入时间槽,是进入模型前需要核对的另一处边界。这里假定槽级动作已正确准备,继续追问它们如何进入主干,以及读代码时怎样证明"左句属于左段、右句属于右段"。
1. 模型会向左转,为什么还不能先左后右?
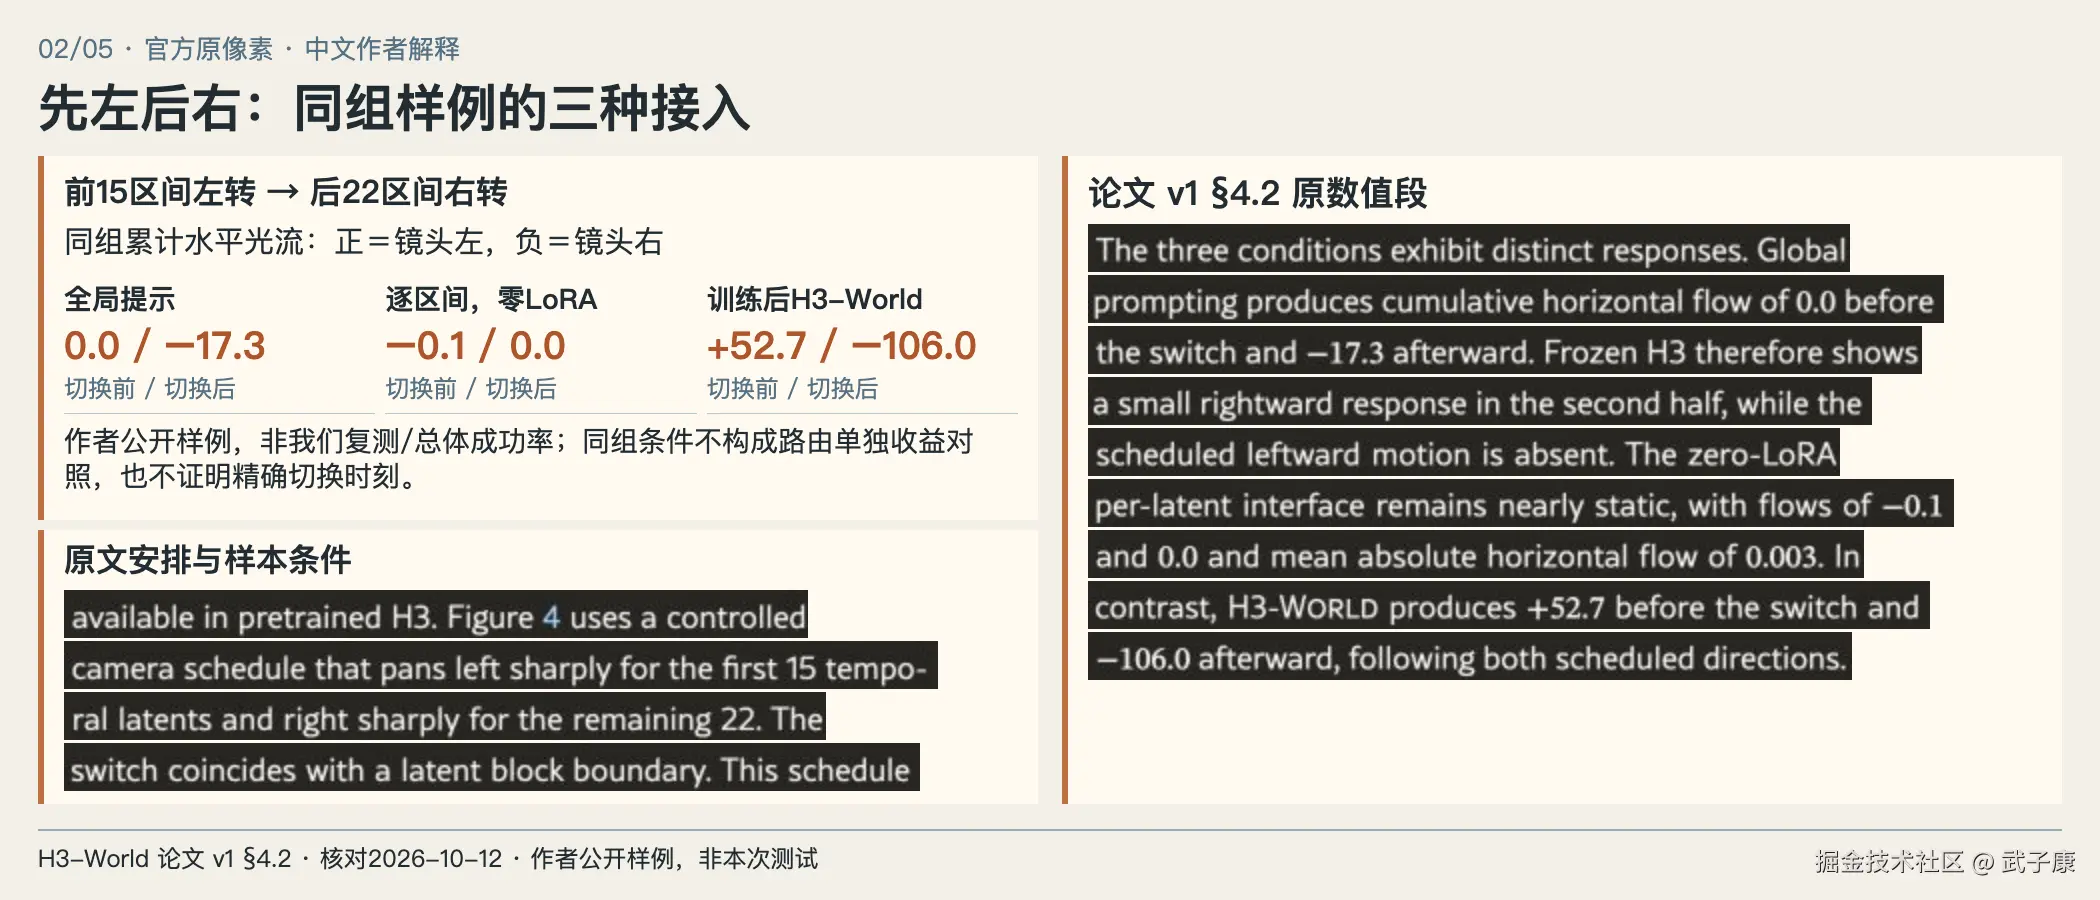
官方原页面原像素聚焦与中文作者解释;论文v1/固定commit,2026-10-12核对,非我们复测。
最直接的证据不是架构名词,而是论文第 4.2 节的一组对照:前 15 个视频 latent 要求镜头向左转,后 22 个要求向右转,切换点放在 latent 边界。作者比较了全局运动提示、逐 latent 接口但 LoRA 更新置零,以及训练后的 H3-World。同一"懂得镜头方向"的基础能力,在三种接入方式下并没有产生相同的时序响应。
| 论文展示条件 | 切换前累计水平光流 | 切换后累计水平光流 |
|---|---|---|
| 冻结 H3,全局运动提示 | 0.0 | -17.3 |
| 逐 latent 接口,LoRA 置零 | -0.1 | 0.0 |
| 训练后的 H3-World | +52.7 | -106.0 |
这组值来自厂商论文的公开样例;论文在此约定正值对应镜头左向运动、负值对应右向运动。它们不是我们复测的轨迹,也不是所有场景、所有随机种子的成功率。对当前问题,它们提供的反常点已经足够明确:把一条句子拆成多条,并不能自动得到动作时序;但只把失败归因于模型"不会转镜头",同样过早。论文 §4.2
全局提示在整个生成范围内作为共享条件。"先左后右"含有顺序语义,却没有在计算图中单独标出哪些视频 token 直接读取"左"、哪些直接读取"右"。模型可以根据语言与训练先验自行组织一段运动,但接口没有给应用一个逐时间段的读取约束。需求若只是整段保持一个方向,这种简单接入可能已够用;若要检查某个切换点前后的方向,就需要把时间归属变成可核对的输入与可见关系。
H3-World 因而为每个视频 latent 区间准备独立动作句。这里的 latent 是视频在模型内部的时间表示,一个区间可能解码为多帧,不等于一条按键对应一张输出画面。角色动作与镜头动作拼成该区间的短句,经共享的 H3 编码器进入同一个表示空间。本文的"左句""右句"指镜头动作;不能把镜头左转、人物向左移动和画面光流方向当成同一个控制变量。
把左段和右段分开,首先解决的是身份问题:这条文本是谁的动作条件。随后还要避免在进入主干之前把身份混掉。官方补丁中,Token Refiner(文本 token 细化层)把静态头部与每条动作句划成独立序列。句内 token 可以互相读取,不同动作句在这一层不互相混合。这一步很容易在只看主干路由图时被漏掉。
例如,假设 A左 在细化层已经读入 A右 的内容,后面即使只让左段视频读取 A左,它读到的也不再是单独的左动作表征。后端掩码能够禁止一条读取边,却不能把已经混入向量的右动作内容剥离出来。源码对 Refiner 分段的说明正是在处理这个上游问题。因此核对"动作直达匹配视频"之前,要先核对动作表征有没有通过其他动作句获得旁路信息。
这不意味着动作句从此没有场景信息。Refiner 的句间分隔,与主干中动作读取静态场景、首帧条件,是两处不同的关系。把它们都画成"动作完全孤立",会误读模型;反过来,因为动作需要场景信息就允许所有动作句先混合,也会丢掉逐段绑定的意义。
2. 位置告诉模型去哪里找,路由规定谁能读
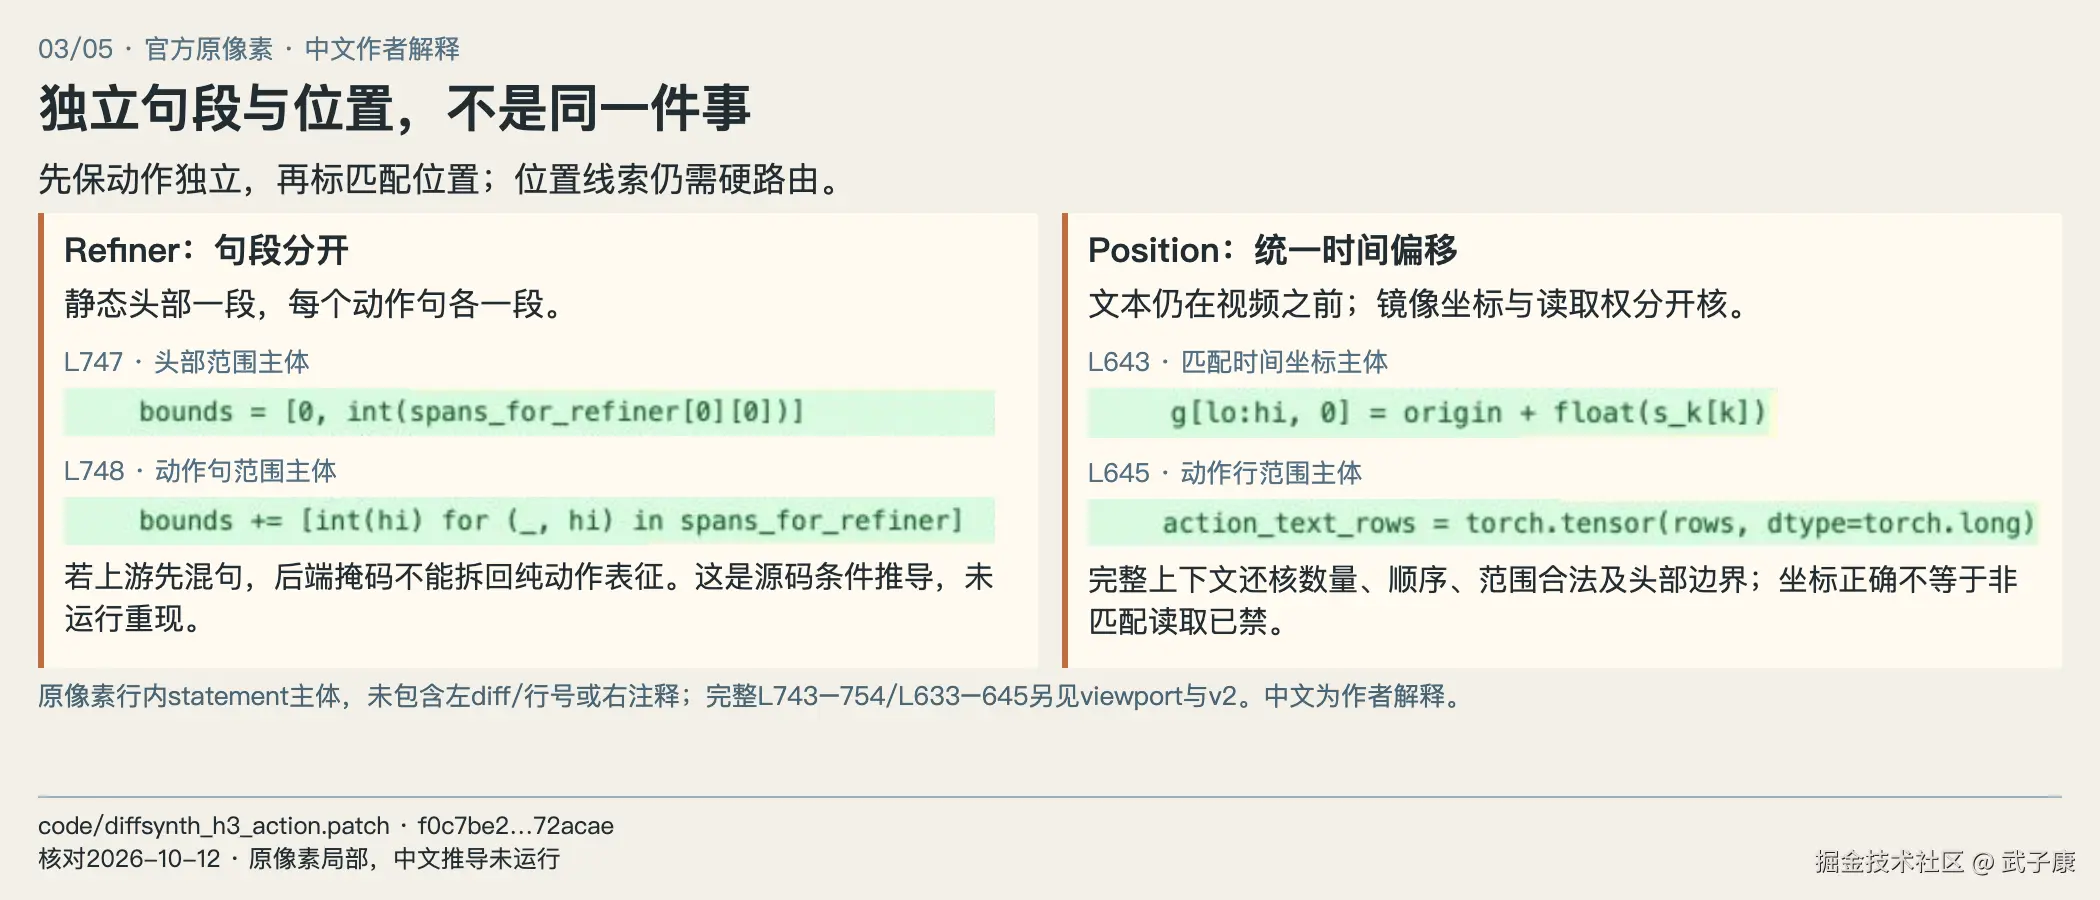
官方原页面原像素聚焦与中文作者解释;论文v1/固定commit,2026-10-12核对,非我们复测。
H3-World 没有另设一层专用的文本到视频交叉注意力。动作文本、静态语义、初始画面条件和视频表示进入同一条打包序列,由单流自注意力处理。论文为了突出视觉控制省略部分音频记号;当前代码的实际布局是 text、condition、audio、video、padding。静态语义与各动作句都属于文本区域,首帧细节条件与生成目标也不能因同属视觉 token 就混为一段。
打包在一起,只说明它们共享计算路径,并没有替应用规定动作属于哪个视频区间。补丁为动作文本 span(连续 token 范围)记录起止位置,再给该 span 写入与匹配视频区间有固定偏移的时间坐标。镜像位置不是把动作 token 移到视频 token 的内存位置:文本仍处于文本侧,只是用于位置编码的时间坐标按匹配视频的顺序排列,并保持在视频之前。
这一做法让各匹配对有统一的相对位置线索,也保留预训练中的文本在视频之前的排列关系。但位置线索本身不会把非匹配读取权重强制归零。如果一条动作具有正确时间坐标,另一段视频仍然被允许直接读取它,那么"它应该属于哪里"与"谁实际上可以读到它"仍是两件事。前者由位置与 span 标识表达,后者由路由掩码决定。
固定补丁把位置与读取关系分成两处边界。 _build_packed_fl2va 要求动作 span 数量等于视频 latent 数量,范围合法且有序、互不重叠;它按视频时间网格设置动作坐标,并检查动作位置不会侵入前面的头部范围。_build_action_block_masks 则根据动作编号与视频编号决定查询和键是否可见。不能用"span 数量正确"替代"可见关系正确",也不能因为掩码存在就省略前面的对应关系检查。固定补丁
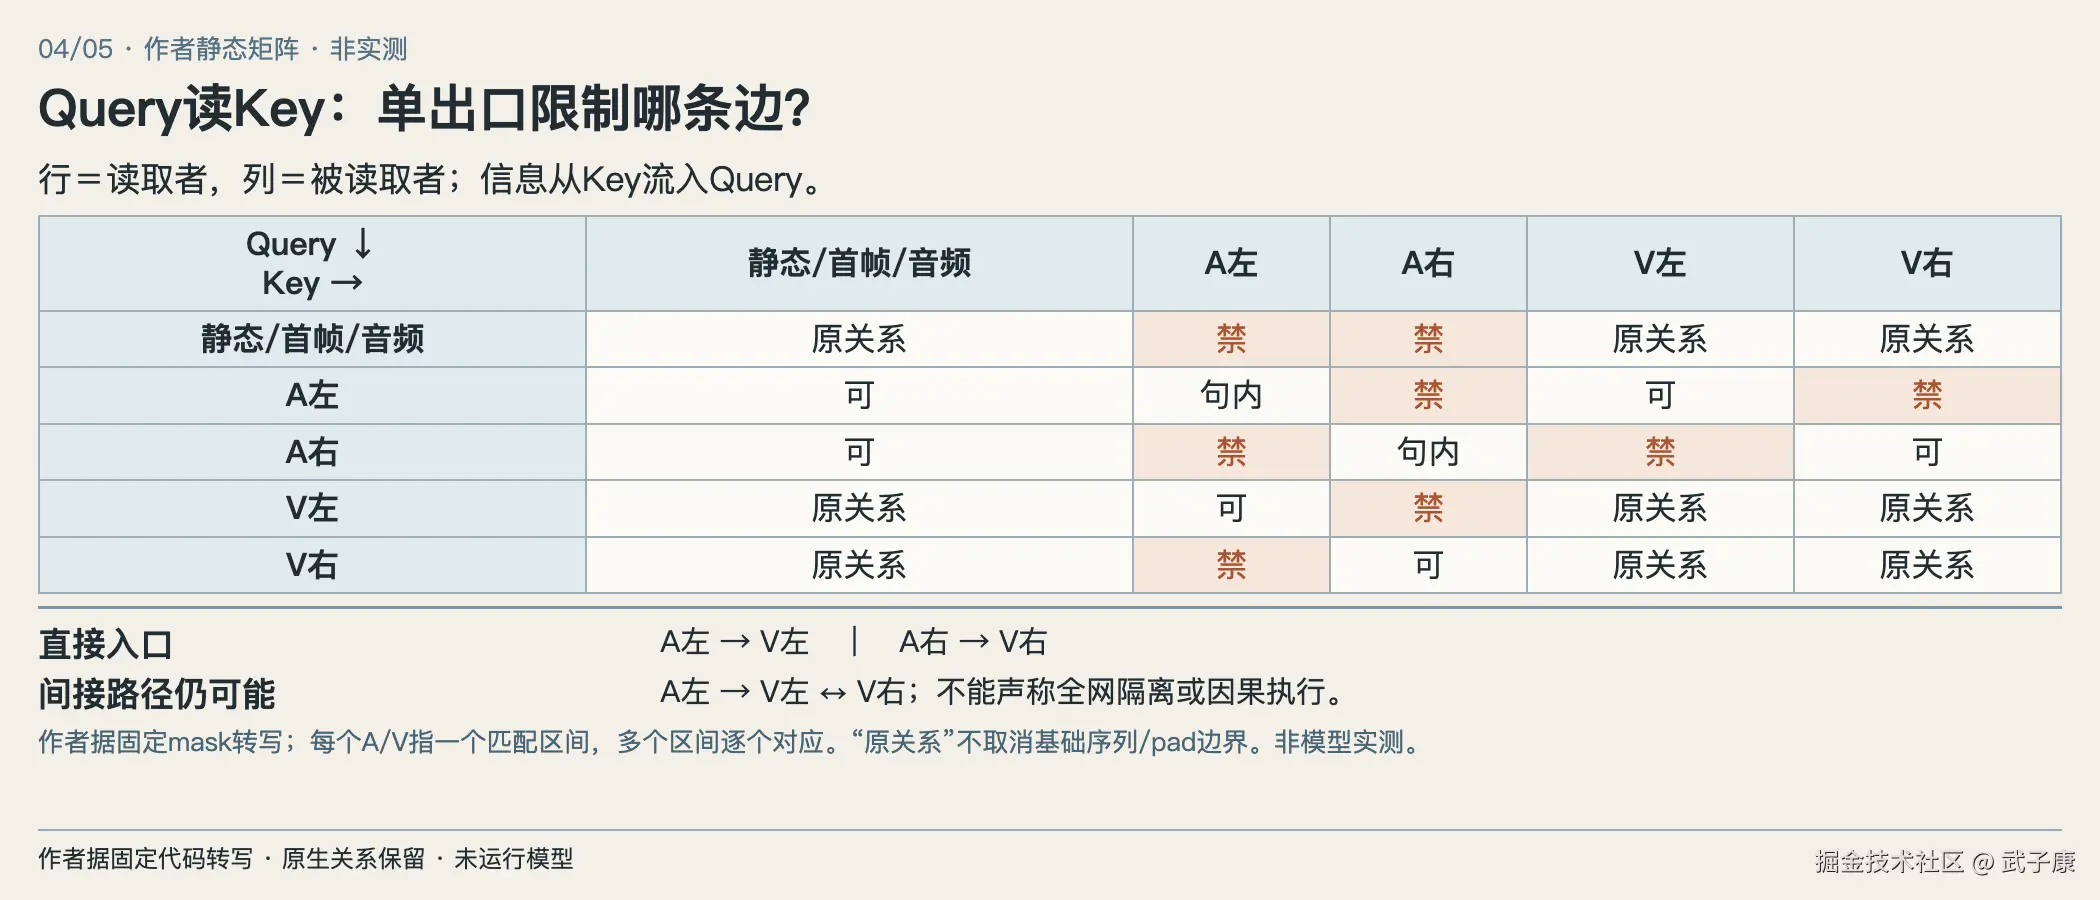
作者静态机制/未执行记录;不代表模型生成成功或实时测量。
读掩码时最容易看反的是方向。表中行是 query,即正在读取信息的位置;列是 key,即被读取的位置。若 V左 读取 A左,信息从 A左 进入 V左,而不是动作句从视频读到了什么。下面按固定补丁表达直接可见性,不表示生成结果已达到要求。
| Query 读取者 / Key 被读取者 | 静态语义或首帧、音频 | A左 | A右 | V左 | V右 |
|---|---|---|---|---|---|
| 静态语义或首帧、音频 | 保留原关系 | 禁止 | 禁止 | 保留原关系 | 保留原关系 |
| A左 | 允许 | 句内允许 | 禁止 | 允许 | 禁止 |
| A右 | 允许 | 禁止 | 句内允许 | 禁止 | 允许 |
| V左 | 保留原关系 | 允许 | 禁止 | 保留原关系 | 保留原关系 |
| V右 | 保留原关系 | 禁止 | 允许 | 保留原关系 | 保留原关系 |
A左 与 A右 各自代表一个匹配区间的动作 span;如果一段方向连续占多个区间,应逐区间建立对应,不能把上表的一个符号当成随意跨越多个区间的实际 token 块。"保留原关系"指该动作路由没有新增阻断,不是取消基础模型原有的序列边界、padding 或其他规则。
Single-Egress(单出口)约束的是动作进入视频流的直接入口。A左 作为 key 时,只有本句内部及匹配 V左 可以读它;静态条件、音频和其他动作句不能先读走 A左,再把内容绕进不匹配的视频。A左 作为 query 时,仍能读取静态上下文及匹配 V左,但不能读取 A右 或 V右。两种方向都检查,才不会把"右视频不能读左动作"误写成"左动作可以从右动作得到内容也无妨"。
这也是为什么该机制不是把视频切成彼此隔绝的小模型。V左 与 V右 之间仍保留基础模型的双向关系。A左 的信息先通过 V左 进入视频流后,可以沿视频间通信影响 V右。上表把这条间接路径与动作句之间的上游混合、静态条件旁路分别列开,方便读者检查是哪一种边被阻断。这里没有承诺后半段绝不受到前半段影响,也没有把生成未来改成只能读取过去的因果模型。
FlexAttention 在实现中承担按这些规则计算注意力的工作。补丁通过 create_block_mask 构造分段掩码,再在存在掩码的分支传入 attn_mask 并启用 use_flex。分段索引是局部的,所以应核当前 packed segment 的映射,而不是把整个序列的绝对坐标未经换算塞进每个分段。当前实现还处理真实长度与 padding:真实 token 不应读到补齐行,补齐行保留自读。本文只从分支和索引规则核对接入条件,没有测量编译耗时、显存或速度提升。
因此,看到项目里用了 FlexAttention,并不足以断定当前输入已经启用了动作路由。还要沿实际传参确认 action_text_rows 到达主干、动作与视频起点匹配,以及对应分支确实获得 block mask。工具名称说明可以怎样计算,不替代这次输入实际上用了什么规则。
3. 一条先左后右记录,要分别核输入、路由与输出
位置与路由不包含可学习参数,LoRA(低秩适配)则更新注意力投影,学习如何沿允许路径把动作语义变成视觉变化。论文把基础主干与编码器等参数冻结,低秩更新作用于主干自注意力及两层 Refiner 的 QKV 与输出投影。由此不能把 LoRA 文件理解成已经包含路由实现的独立控制器:低秩权重负责学习,span 分段与掩码负责访问关系,两者需要在同一接入路径中配合。
论文的零 LoRA 对照说明,完整逐 latent 接口即使已经存在,仍不能直接继承为可用时序控制。这是该样例支持的判断。它没有给出一组训练后 LoRA 保留、仅移除 routing 的严格对照,所以不能据此把收益百分比分配给位置、Refiner 分段、路由或 LoRA,也不能说所有增益只由某一处产生。"理论上阻断了直接读取"与"训练后每次都能按时执行"应分开验收。
对接入者来说,可带走的产物不必是一套评测大全,而是一条可以留空、可以失败的方向切换记录。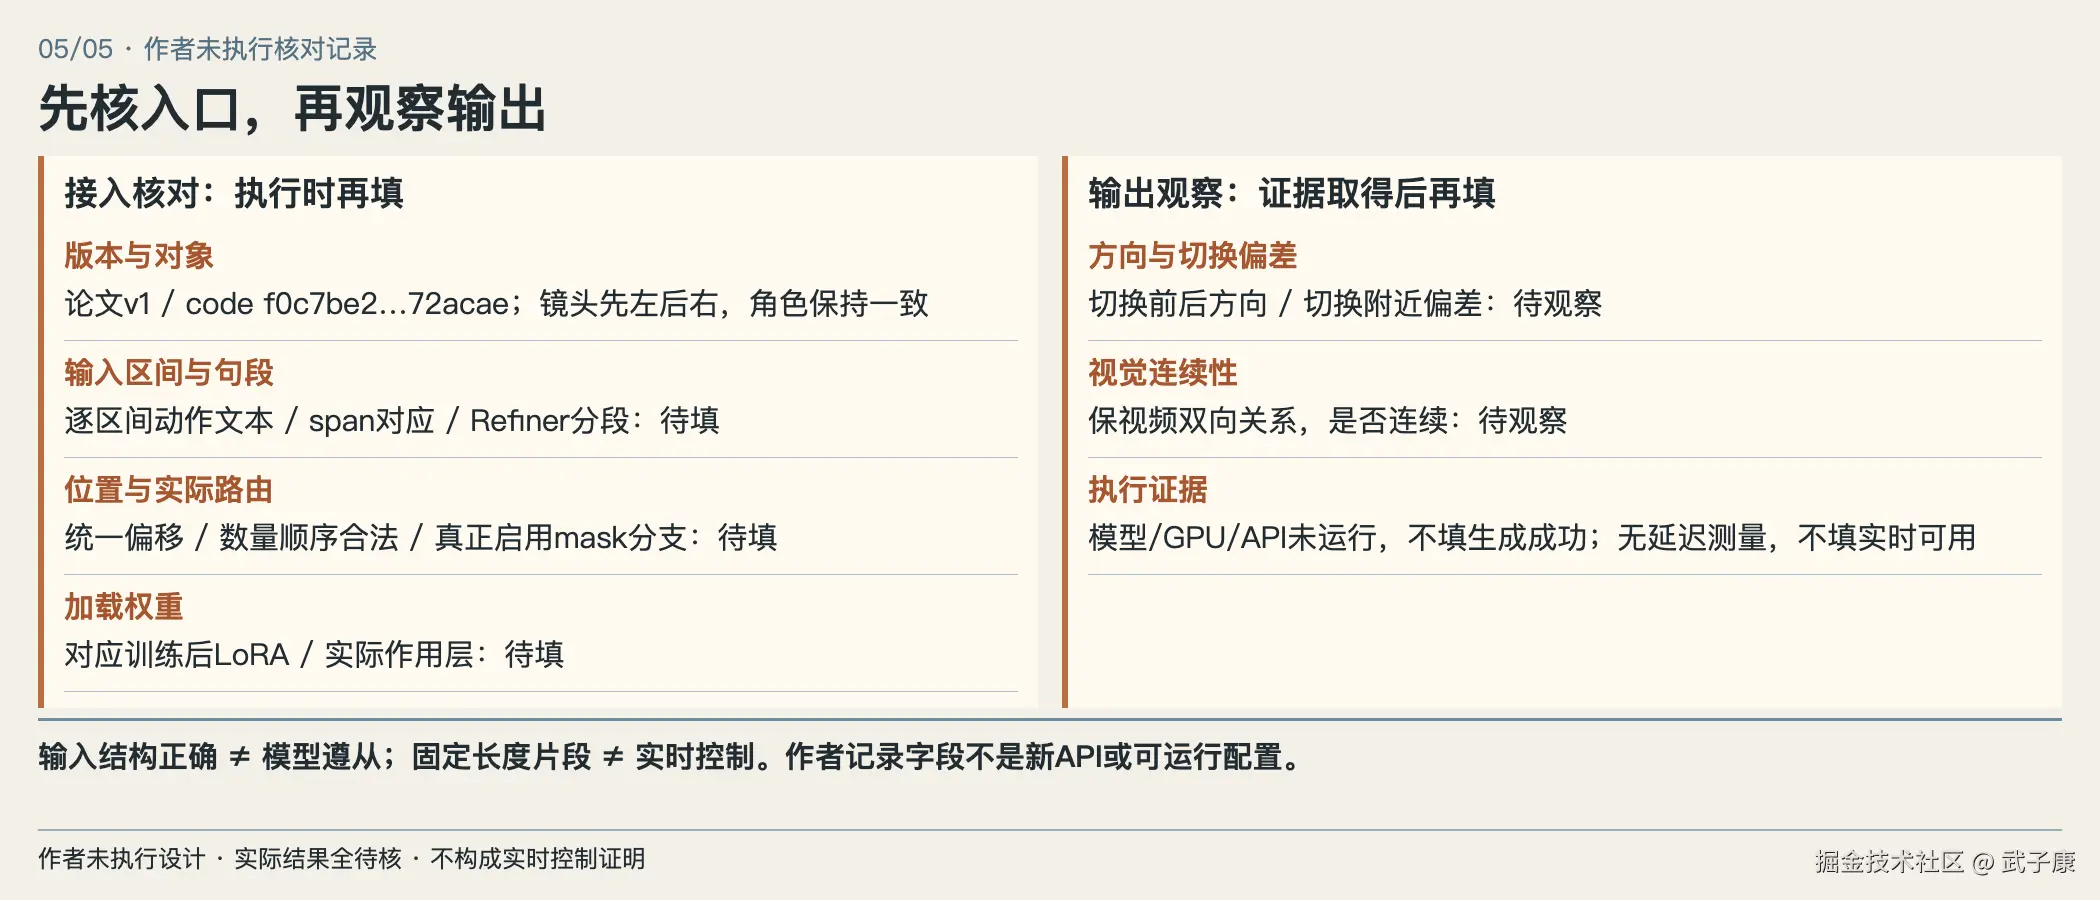
作者静态机制/未执行记录;不代表模型生成成功或实时测量。
下面是作者设计的未执行记录,字段属于检查记录,不是 H3-World 的新 API 或可直接运行的配置。
| 记录项 | 本例预期 / 实际待填 |
|---|---|
| 固定版本 | 论文 v1;代码 f0c7be2acbbde8256b2473f6e7b088f58272acae;实际运行版本待填 |
| 动作对象 | 镜头先左转、后右转;角色动作保持一致;实际句子待填 |
| 槽级输入 | 切换点前后使用各自方向的动作句;区间对应与实际 span 待填 |
| Refiner | 静态头部与各动作句分段;实际分段边界待填 |
| 位置 | 各动作 span 与匹配视频有统一时间偏移;实际坐标与合法范围待填 |
| 主干可见性 | 匹配视频可读本动作,非匹配视频与其他动作不可直接读;实际 mask 与激活分支待填 |
| 保留关系 | 视频之间仍双向读取;不能将其写成未来不可见 |
| 适配权重 | 预期使用相应训练后 LoRA;实际加载与作用层待填 |
| 输出观察 | 切换前后镜头方向、切换附近偏差及连续性均待观察,不因前面检查通过自动填成功 |
填写时先保留槽级动作文本和对应区间,再记录 Refiner 与主干各自的分段。这样某段运动错误时,能够区分"动作内容或所属区间已经不对"和"输入正确但生成没有遵从"。原始帧聚合检查适用于前一种情况;表格继续检查正确的动作是否经过了正确的入口。两者不是相互替代的诊断。
如果实际记录里没有 action_text_rows,不要先修改动作句的形容词来试运气:应确认当前走的是逐 latent 文本路径还是普通全局提示路径。如果对应关系正确但 Refiner 仍把多句当成一个序列,也不能只在主干补一个"左右分开"的图就声称修好。反之,输入与可见性均核对无误、输出仍未按要求切换,记录应保留这一失败,而不是把结构检查升级成模型行为证明。
观察输出时应固定需要比较的初始条件与生成设置,并把实际使用的权重、动作顺序和切换区间记录下来。这是作者建议的核对方法,不是本次已经完成的实验。若另做反向顺序对照,也要保留两条各自的记录,不能把"左后右"和"右后左"的输出拼成一次成功过程。没有输出轨迹,就只填写输入与静态代码核对;没有实际延迟测量,就不填写实时可用。
不加载模型,先运行一个读取关系检查
读取矩阵不一定要等到 GPU 推理失败之后才核对。下面的最小示例将固定补丁中 mask_mod 的布尔关系转写成 Python 标量运算,并添加文本 span 的数量、范围与顺序检查。保存为 mask_check.py 后,用 Python 3 标准库即可执行;不安装 PyTorch,不构造 FlexAttention block mask,也不加载任何视频权重。
本例只取一个 packed segment,用六个位置代表静态条件 S、左右动作 Aleft/Aright、左右视频 Vleft/Vright 和一个 padding。每个动作 span 和视频区间各用一个 token,目的是让矩阵的每一格可以直接读懂;真实句子多 token、单个视频区间多空间 token 的情况,必须先由应用建立正确行编号,不能照搬这六个索引。real_len=5 表示前五个位置有效,第六个只是补齐。
annotations 给动作位置标出所属区间,frames 给视频位置标出所属区间,其余位置标 -1。判断动作作为 key 时,只有同一句动作内部与匹配的视频可以读取;动作作为 query 时,不能读取其他区间的视频。最后单独加上真实长度限制和自读例外,保留原补丁"padding 只读自己"的条件。这里的列方向依旧是被读取的 key,信息从列流向行。
代码中的五行预期值来自前文已经逐格解释的读取矩阵,不是运行后把程序结果再填回预期值。新增反例则故意把两个动作的区间编号交换:即使 span 数量与范围都合法,Vleft 也会读到被错误绑定的 Aright。这能说明数量检查为什么不能代替语义对应检查。
python
"""Scalar transcription of pinned mask_mod, one segment; no torch/model run."""


def validate_spans(spans, text_len, latent_t):
    if len(spans) != latent_t:
        raise ValueError("count")
    previous = 0
    for lo, hi in spans:
        if not 0 <= lo < hi <= text_len:
            raise ValueError("range")
        if lo < previous:
            raise ValueError("overlap_or_order")
        previous = hi


def visible(q, key, annotations, frames, real_len):
    aq, ak = annotations[q], annotations[key]
    fq, fk = frames[q], frames[key]
    same_action = aq >= 0 and ak >= 0 and aq == ak
    own_video = fq >= 0 and ak >= 0 and fq == ak
    leak_out = ak >= 0 and not same_action and not own_video
    leak_in = aq >= 0 and fk >= 0 and aq != fk
    real = q < real_len and key < real_len
    return q == key or (real and not (leak_out or leak_in))


def run_examples():
    # S, Aleft, Aright, Vleft, Vright, padding; one token per role.
    annotations = [-1, 0, 1, -1, -1, -1]
    frames = [-1, -1, -1, 0, 1, -1]
    names = ["S", "Aleft", "Aright", "Vleft", "Vright"]
    expected = ["10011", "11010", "10101", "11011", "10111"]
    print("columns: " + " ".join(names))
    for q, name in enumerate(names):
        row = "".join(str(int(visible(q, k, annotations, frames, 5))) for k in range(5))
        if row != expected[q]:
            raise AssertionError((name, row, expected[q]))
        print(f"{name}: {row}")
    for i in range(5):
        if visible(i, 5, annotations, frames, 5) or visible(5, i, annotations, frames, 5):
            raise AssertionError("padding leaked")
    if not visible(5, 5, annotations, frames, 5):
        raise AssertionError("padding lost self-read")
    # Swapped role-to-latent mapping produces an observable wrong direct edge.
    swapped = [-1, 1, 0, -1, -1, -1]
    if visible(3, 1, swapped, frames, 5) or not visible(3, 2, swapped, frames, 5):
        raise AssertionError("wrong-map counterexample missing")
    print("matrix: 25/25; padding: 11/11; swapped_map: detected")
    cases = [
        ("valid", [(1, 2), (2, 3)], None),
        ("count", [(1, 2)], "count"),
        ("range", [(1, 2), (2, 4)], "range"),
        ("overlap", [(1, 3), (2, 3)], "overlap_or_order"),
        ("reversed", [(2, 3), (1, 2)], "overlap_or_order"),
    ]
    for name, spans, expected_error in cases:
        error = None
        try:
            validate_spans(spans, text_len=3, latent_t=2)
        except ValueError as exc:
            error = str(exc)
        if error != expected_error:
            raise AssertionError((name, error, expected_error))
        print(f"span_{name}: " + ("accepted" if error is None else "rejected:" + error))
    print("scope=one_segment_scalar_boolean_and_span_checks")


if __name__ == "__main__":
    run_examples()
在文件所在目录运行:
bash
python3 mask_check.py2026 年 10 月 13 日,本地 Python 3 实际运行该文件,退出码为 0,标准错误为空。当次标准输出如下:
text
columns: S Aleft Aright Vleft Vright
S: 10011
Aleft: 11010
Aright: 10101
Vleft: 11011
Vright: 10111
matrix: 25/25; padding: 11/11; swapped_map: detected
span_valid: accepted
span_count: rejected:count
span_range: rejected:range
span_overlap: rejected:overlap_or_order
span_reversed: rejected:overlap_or_order
scope=one_segment_scalar_boolean_and_span_checks
五位字符串从左到右对应 S、Aleft、Aright、Vleft、Vright;1 表示允许直接读取,0 表示禁止。Vleft 的 11011 因而允许读取 S 与 Aleft,禁止读取 Aright,同时保留左右视频之间的关系。Aright 的 10101 则可以读取 S、本句及 Vright,不能读取另一句和 Vleft。这里报告的 25/25 是五乘五布尔单元与预先写定矩阵相等,不是 25 次视频生成通过。
padding 的 11 个条件分别是五个真实位置不能读 padding、padding 不能读五个真实位置,以及 padding 自读必须保留。即使它对应零向量,放进注意力归一化也可能改变结果;反过来,若 padding 行连自己都不能读,就可能出现没有可见 key 的情况。示例只验证可见关系,没有计算 softmax、数值稳定性或编译行为。
swapped_map: detected 不是程序替读者自动识别"左"的语义,而是已知左右预期下构造的反例。我们交换动作编号后,Vleft 不能再读位置 1,却能读位置 2;断言确认这种错误对应会改变直接入口。真实集成中,需要从输入动作计划取得预期绑定,再核实际行编号,不能只给动作随意编号后让代码自证正确。否则一个错误映射也可以拥有整齐、可运行的矩阵。
span 的五条记录检验另一类问题:两个合法连续区间被接受;数量不等于视频区间数、超过文本边界、重叠和倒序分别被拒绝。半开区间 [lo, hi) 中,起点包含、终点不包含,因此 [1,2) 与 [2,3) 相邻但不重叠。把终点误当包含会在接口转换时多算一行,这不是增加一个 mask 就能修好的问题。实际句子长度改变时,也应重新核对 span,而不是沿用上次的范围。
这段 validate_spans 只转写固定补丁的前三类入口条件,不包含镜像时间坐标不得侵入头部范围的检查,也不实现 Refiner 的完整分段与连续铺满约束。合法 span 只证明这三个条件成立,不能自动宣告位置编码和上游句段均正确。正文把这些职责分开,是为了在失败时知道接下来应该检查哪一处,而不是让一个短脚本冒充完整模型接入验收。
如果改动代码,可以先做三个破坏性对照:去掉非匹配动作限制,读取矩阵应报错;取消真实长度判断,padding 条件应报错;取消重叠判断,重叠 span 应被错误接受并触发断言。程序退出码与"某条非法输入被拒绝"也要分开理解:非法输入是预设案例,正确拒绝它才是本地检查成功。任何预期不符都会以异常退出,让后续命令能发现回归。
以上结果仍需要与真实接入的边界分开。该布尔转写没有覆盖多 segment 的绝对坐标换算、位置网格、权重加载、分支实际激活和 GPU 内核;它也没有测量光流、切换偏差或实时延迟。图中那些项目继续等待真实执行记录。读者现在可以带走的是一段能跑、能被错误输入推翻的静态检查,用来先排除左右读取方向、padding 和基本 span 约束上的误读。
论文自身也限定了范围:当前生成固定长度片段,尚不提供持久世界状态、实时交互、规划或策略学习。把论文中的 interactive 一词直接搬成"按键后实时更新世界"的产品能力,会跳过尚未提供的部分。视频能按一个预先给定的动作计划变化,与用户随时改变输入、系统维持长期状态,是不同的验证对象。
所以,这条记录最后回答的不是"H3-World 是否已经是完整游戏引擎",而是一个更具体的问题:这次先左后右的动作计划,是否以独立表征、匹配位置和实际启用的路由进入模型;进入之后,输出是否真的遵从。全局提示仍是简单需求的合理入口,但当应用需要核对动作何时生效时,语言语义之外的这些对应关系不能省略。
来源与范围
- 作者论文 H3-World v1,2026-09-01:§3.3/§3.4 的时序绑定与路由,§4.2 的单组方向切换对照,§5 的局限;检查日 2026-10-12。
- 官方固定代码补丁:packing、Refiner 分段、查询/键掩码及 FlexAttention 调用。原文全文、行号摘录与 SHA 随研究包保留。
- 官方固定仓库说明:接入与研究范围交叉核对。原 ZIP 仅为选题种子,未把其中推论升级为新实测结果;视频素材仅 reference_only,本文没有据未审看媒体评价生成质量。