论文:StretchTime: Adaptive Time Series Forecasting via Symplectic Attention
作者:Yubin Kim、Viresh Pati、Jevon Twitty、Vinh Pham、Shihao Yang、Jiecheng Lu,Georgia Institute of Technology。
原文:arXiv:2602.08983v1。本文依据该版本正文及附录 A--E 撰写;图片直接截取上传的 PDF,并标明原图号与页码。"阅读理解"表示依据原文公式和实验作出的解读,不作为作者额外验证过的结论。
一、这项工作做了什么?
StretchTime 研究一个容易被固定位置编码忽略的问题:采样间隔可以相等,系统演化的节奏却未必恒定。 当周期不断伸长或缩短时,相同的索引距离不再对应相同的动态关系。
论文先证明:在非混叠条件下,标准 RoPE 的固定频率位置相位无法精确表示非仿射时间扭曲。随后提出 Symplectic Positional Embeddings(SyPE,辛位置嵌入):从输入学习单调递增的时间坐标,再用可学习的稳定辛流调制 Query 和 Key。作者将其与最后值残差、全局与局部混合的 token 化结合,构成多变量预测模型 StretchTime,并用合成数据、真实数据及内部消融检验其效果。
**核心思路:**让位置编码学习"系统推进了多少",并在这把可变时钟上计算相对位置。
二、动机:为什么索引距离不足以描述时间关系?
2.1 周期结构仍然存在,但周期长度正在变化
论文关注的不是"序列完全没有规律",而是规律的推进速度发生变化 。原文列举金融周期、心跳间隔和生态物候等现象,用于说明真实系统的节奏可能伸缩;这些例子是研究动机,并非本文分别开展实验的数据集。
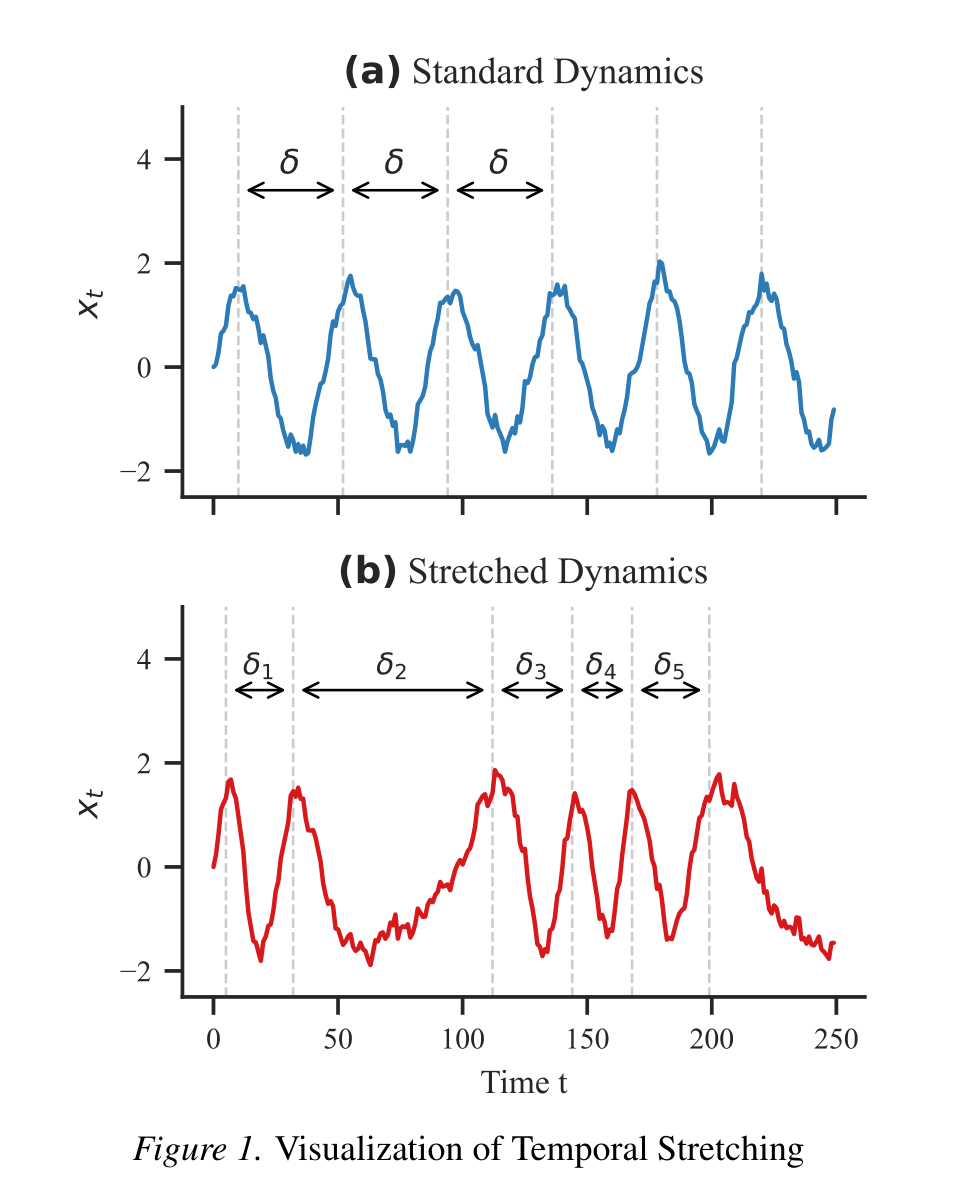
原文 Figure 1。上图的周期距离近似固定,下图的周期距离随时间变化。
为了把问题写成可分析的形式,作者引入单调时间扭曲函数 τ ( t ) \tau(t) τ(t),定义季节性 AR(1) 过程:
x t = ϕ x t − 1 + A sin ( ω 0 τ ( t ) ) + ϵ t , ϵ t ∼ N ( 0 , σ 2 ) . x_t=\phi x_{t-1}+A\sin\bigl(\omega_0\tau(t)\bigr)+\epsilon_t, \qquad \epsilon_t\sim\mathcal N(0,\sigma^2). xt=ϕxt−1+Asin(ω0τ(t))+ϵt,ϵt∼N(0,σ2).
这对应原文公式 (1)。其中 t t t 是采样索引, τ ( t ) \tau(t) τ(t) 是系统的有效时间。季节项的相位关系由 ω 0 ( τ ( m ) − τ ( n ) ) \omega_0\bigl(\tau(m)-\tau(n)\bigr) ω0(τ(m)−τ(n)) 决定,而不只是 m − n m-n m−n。
因此,寻找相似周期阶段时,真正需要关注的是扭曲后的时间差能否与基础周期 2 π / ω 0 2\pi/\omega_0 2π/ω0 对齐。相同的索引间隔,在序列不同位置可能对应不同的相位差。
2.2 RoPE 的限制来自固定角速度
标准 RoPE 在二维子空间中,按照索引对 Query 和 Key 施加固定频率旋转。对一个频率 θ \theta θ,位置相位随 t t t 线性增长,两个位置的相对相位只能是 θ ( m − n ) \theta(m-n) θ(m−n)。
论文定理 3.1 将这个限制形式化:设 τ \tau τ 非仿射,基础频率 ω 0 ≠ 0 \omega_0\ne 0 ω0=0,并满足
∣ ω 0 ( τ ( t + 1 ) − τ ( t ) ) ∣ < π . \left|\omega_0\bigl(\tau(t+1)-\tau(t)\bigr)\right|<\pi. ω0(τ(t+1)−τ(t)) <π.
则不存在固定 θ \theta θ,使所有位置对都满足
θ ( m − n ) ≡ ω 0 ( τ ( m ) − τ ( n ) ) ( m o d 2 π ) . \theta(m-n)\equiv \omega_0\bigl(\tau(m)-\tau(n)\bigr)\pmod{2\pi}. θ(m−n)≡ω0(τ(m)−τ(n))(mod2π).
证明的关键是考察相邻位置。记 Δ τ ( t ) = τ ( t + 1 ) − τ ( t ) \Delta\tau(t)=\tau(t+1)-\tau(t) Δτ(t)=τ(t+1)−τ(t),取 θ \theta θ 在 ( − π , π ] (-\pi,\pi] (−π,π] 内的代表元,就有
ω 0 Δ τ ( t ) = θ + 2 π k t , k t ∈ Z . \omega_0\Delta\tau(t)=\theta+2\pi k_t, \qquad k_t\in\mathbb Z. ω0Δτ(t)=θ+2πkt,kt∈Z.
非混叠条件排除了非零 k t k_t kt,于是每一步都必须满足 Δ τ ( t ) = θ / ω 0 \Delta\tau(t)=\theta/\omega_0 Δτ(t)=θ/ω0。这意味着时间增量恒定, τ \tau τ 必须是仿射函数,与假设矛盾。
**理解这个定理时要保留它的范围:**被排除的是固定频率位置相位对目标扭曲相位的精确表示。定理没有证明所有采用 RoPE 的深层网络都无法预测这类序列;网络的内容表示与其他模块仍可能承担补偿作用。
2.3 换成其他静态位置编码,也没有直接解决问题
附录 B 将讨论扩展到相对位置偏置和共享绝对位置嵌入。
对于 T5、ALiBi 一类仅依赖索引距离的相对偏置,形式可以写成
B m , n = b ( m − n ) . B_{m,n}=b(m-n). Bm,n=b(m−n).
附录 B.1 考察它能否等于 g ( τ ( m ) − τ ( n ) ) g\bigl(\tau(m)-\tau(n)\bigr) g(τ(m)−τ(n)),其中 g g g 是能够区分时间差的单射。同一个索引距离会得到相同的 b b b,但非仿射时钟的相邻有效时间差可能不同,两者因而冲突。这里的单射要求很重要:论证针对的是需要区分不同有效时间差的偏置。
共享的可学习绝对位置嵌入则面临另一种矛盾。附录 B.3 使用一个简化设定:所有通道共享 p t p_t pt,输出仅由共享映射 F ( p t ) F(p_t) F(pt) 决定。如果同一索引上,不同通道的独立时钟要求不同输出,一个固定的 F ( p t ) F(p_t) F(pt) 就无法同时满足它们。
这个讨论强调的是共享位置向量缺少通道与样本条件。它不是对所有含绝对位置嵌入模型的普遍不可能性证明。事实上,StretchTime 自身仍保留可学习的绝对位置嵌入,还加入通道标识;新的部分是让有效时钟进一步依赖输入。
作者也讨论了已有时间序列方法:固定季节滞后难以直接适应变化的节奏,DTW 可以进行序列对齐,却不是本文采用的端到端预测机制。由此得到本文的路线:不预先指定扭曲函数,而是将时间伸缩放进可微的预测模型中学习。
三、方法:分别学习时间坐标与变换几何
3.1 StretchTime 的输入与整体结构
任务输入为 X ∈ R L × C X\in\mathbb R^{L\times C} X∈RL×C,预测未来 T T T 步的 Y ∈ R T × C Y\in\mathbb R^{T\times C} Y∈RT×C。原文将模型处理的时间序列长度记为 N = L + T N=L+T N=L+T,并为每个目标通道构造一条 token 序列。
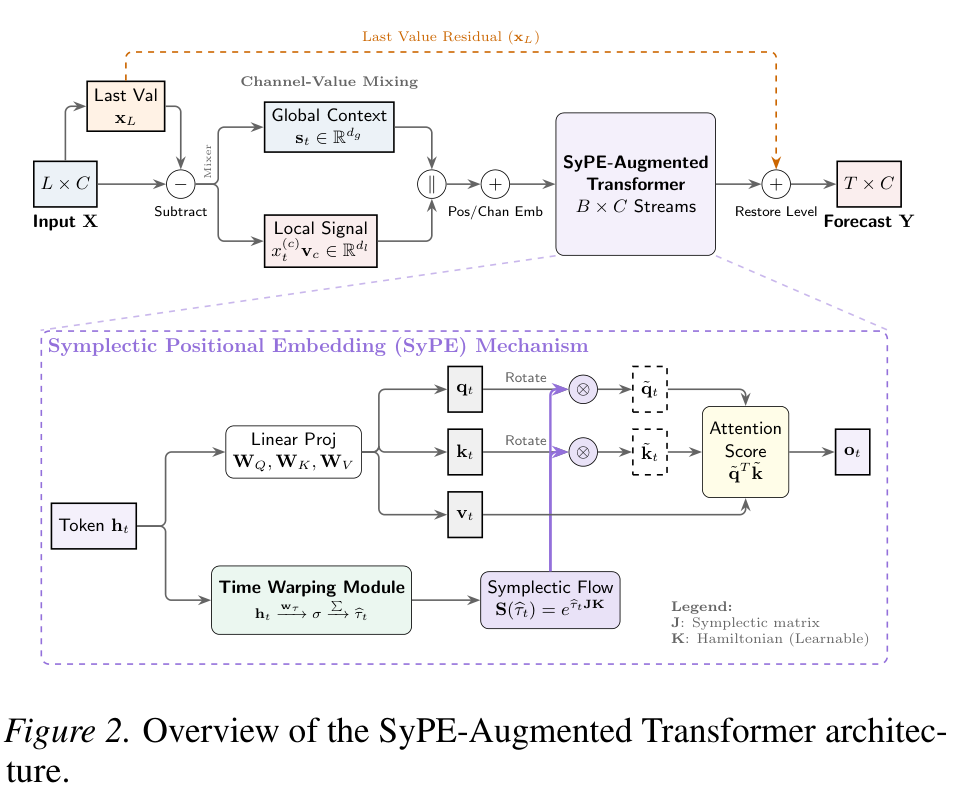
原文 Figure 2。上半部分为预测结构,下半部分为输入驱动的时间扭曲及辛位置嵌入。
首先,模型使用最后值残差学习 。以历史窗口最后一个值 x L x_L xL 为参照:
X d i f f = X − x L , Y ^ = M ( X d i f f ) + x L . X_{\mathrm{diff}}=X-x_L, \qquad \widehat Y=\mathcal M(X_{\mathrm{diff}})+x_L. Xdiff=X−xL,Y =M(Xdiff)+xL.
这是原文 §3.6 与公式 (12) 的组合。模型学习相对于最后观测水平的变化,再恢复该水平;它不使用窗口均值与方差作为这里的中心化依据。
随后,对目标通道 c c c,作者构造混合 token:
z t ( c ) = s t ; x t ( c ) v c + p t + e c . z_t^{(c)}= \lefts_t\\,;\\,x_t\^{(c)}v_c\\right+p_t+e_c. zt(c)=st;xt(c)vc+pt+ec.
这对应原文公式 (13),其中输入值经过上述残差处理:
| 项 | 原文定义 | 在 token 中提供的信息 |
|---|---|---|
| s t ∈ R d g l o b a l s_t\in\mathbb R^{d_{\mathrm{global}}} st∈Rdglobal | 同一时刻全部通道的线性投影 | 全局多变量上下文 |
| x t ( c ) v c ∈ R d l o c a l x_t^{(c)}v_c\in\mathbb R^{d_{\mathrm{local}}} xt(c)vc∈Rdlocal | 通道标量乘以通道特定基向量 | 当前通道的局部数值与表示 |
| p t p_t pt | 共享可学习绝对位置嵌入 | 索引位置 |
| e c e_c ec | 可学习通道标识 | 目标通道身份 |
每个目标通道有独立的处理流,但 token 已包含全局上下文。 因而不能把它理解为完全不使用其他通道信息的预测。原图将这些流标为 B × C B\times C B×C。
训练时还采用随机比例通道 dropout:按样本随机保留部分输入通道,并以保留率的倒数缩放保留信号。作者用它抑制通道特定噪声,增强表示的泛化能力。
3.2 自适应时间模块:先学习每一步推进多少
对时间步表示 h t h_t ht,原文公式 (5) 定义
Δ τ ^ t = Softplus ( w τ ⊤ h t ) , τ ^ m = ∑ i = 1 m Δ τ ^ i . \Delta\widehat\tau_t= \operatorname{Softplus}\left(w_\tau^\top h_t\right), \qquad \widehat\tau_m=\sum_{i=1}^{m}\Delta\widehat\tau_i. Δτ t=Softplus(wτ⊤ht),τ m=i=1∑mΔτ i.
Softplus 使时间增量为正,累计求和使时钟保持单调。序列顺序得到保留,但相邻 token 在新坐标上的距离可以变化。
由于 h t h_t ht 来自当前样本及目标通道的表示, τ ^ \widehat\tau τ 不是一个只查索引的固定表。它可以根据输入,在不同样本、不同通道上形成不同的节奏。作者将这个模块与预测任务共同训练,没有要求提供真实扭曲函数作为监督标签。
**阅读理解:**这里学习的是用于预测的有效时间坐标。增量较大时,同样一个采样步在模型时钟上推进得更多;增量较小时则推进得更少。
3.3 辛流:从固定旋转扩展到可学习的稳定变换
时钟解决"用什么坐标表示位置",SyPE 则解决"如何把这个坐标作用于向量"。每个二维子空间都有一个对称 Hamiltonian 矩阵:
K = ( a c c b ) , a , b > 0 , a b − c 2 > 0. K= \begin{pmatrix} a&c\\ c&b \end{pmatrix}, \qquad a,b>0,\quad ab-c^2>0. K=(accb),a,b>0,ab−c2>0.
定义
J = ( 0 1 − 1 0 ) , S ( t ) = exp ( t J K ) . J= \begin{pmatrix} 0&1\\ -1&0 \end{pmatrix}, \qquad S(t)=\exp(tJK). J=(0−110),S(t)=exp(tJK).
与保持欧氏内积的正交旋转不同,这个流保持的是辛形式:
S ( t ) ⊤ J S ( t ) = J . S(t)^\top J S(t)=J. S(t)⊤JS(t)=J.
因此,几何不必局限于各向同性旋转,可以包含原文讨论的各向异性伸缩;同时保留用于构造相对位置关系的结构。
附录 A.1 进一步说明,论文采用的是振荡而非双曲发散的流。其稳定参数化为
a = e α , b = e β , ρ = tanh γ , c = ρ a b . a=e^\alpha,\qquad b=e^\beta,\qquad \rho=\tanh\gamma,\qquad c=\rho\sqrt{ab}. a=eα,b=eβ,ρ=tanhγ,c=ρab .
于是
det K = a b − c 2 = a b ( 1 − ρ 2 ) > 0. \det K=ab-c^2=ab(1-\rho^2)>0. detK=ab−c2=ab(1−ρ2)>0.
原文将方法描述为从 S O ( 2 ) \mathrm{SO}(2) SO(2) 扩展到 S p ( 2 , R ) \mathrm{Sp}(2,\mathbb R) Sp(2,R)。结合附录约束,更准确的理解是:使用辛群中由正定 K K K 生成的稳定流,而不是毫无约束地使用任意辛矩阵。
3.4 为什么注意力仍能表达相对时间?
先按标准方式得到
q t = W Q h t , k t = W K h t , v t = W V h t . q_t=W_Qh_t,\qquad k_t=W_Kh_t,\qquad v_t=W_Vh_t. qt=WQht,kt=WKht,vt=WVht.
在每个二维子空间,SyPE 对 Query 和 Key 的调制并不完全相同。原文公式 (6) 为
q ~ m = S ( τ ^ m ) q m , k ~ n = J S ( τ ^ n ) k n . \widetilde q_m=S(\widehat\tau_m)q_m, \qquad \widetilde k_n=J S(\widehat\tau_n)k_n. q m=S(τ m)qm,k n=JS(τ n)kn.
Key 分支上的 J J J 是推导的关键。 一般辛矩阵不满足正交矩阵的 S ⊤ S = I S^\top S=I S⊤S=I,不能直接照搬 RoPE 中"两侧相同旋转"的内积推导。
根据群性质 S ( t ) S ( u ) = S ( t + u ) S(t)S(u)=S(t+u) S(t)S(u)=S(t+u) 和辛守恒关系:
q ~ m ⊤ k ~ n = q m ⊤ S ( τ ^ m ) ⊤ J S ( τ ^ n ) k n = q m ⊤ S ( τ \^ m ) ⊤ J S ( τ \^ m ) S ( τ ^ n − τ ^ m ) k n = q m ⊤ J S ( τ ^ n − τ ^ m ) k n . \begin{aligned} \widetilde q_m^\top\widetilde k_n &=q_m^\top S(\widehat\tau_m)^\top J S(\widehat\tau_n)k_n\\ &=q_m^\top \leftS(\\widehat\\tau_m)\^\\top J S(\\widehat\\tau_m)\\right S(\widehat\tau_n-\widehat\tau_m)k_n\\ &=q_m^\top J S(\widehat\tau_n-\widehat\tau_m)k_n. \end{aligned} q m⊤k n=qm⊤S(τ m)⊤JS(τ n)kn=qm⊤S(τ m)⊤JS(τ m)S(τ n−τ m)kn=qm⊤JS(τ n−τ m)kn.
这就是定理 3.2:位置变换通过扭曲后的时间差进入注意力。 内容仍由 q m , k n q_m,k_n qm,kn 提供,因此不能把整个注意力分数理解为"只看时间、不看内容"。
拼接各二维块后,注意力仍使用缩放点积与 softmax:
s m , n = q ~ m ⊤ k ~ n d h , a m , n = exp ( s m , n ) ∑ j = 1 N exp ( s m , j ) , o m = ∑ n = 1 N a m , n v n . s_{m,n}=\frac{\widetilde q_m^\top\widetilde k_n}{\sqrt{d_h}}, \qquad a_{m,n}=\frac{\exp(s_{m,n})}{\sum_{j=1}^{N}\exp(s_{m,j})}, \qquad o_m=\sum_{n=1}^{N}a_{m,n}v_n. sm,n=dh q m⊤k n,am,n=∑j=1Nexp(sm,j)exp(sm,n),om=n=1∑Nam,nvn.
附录 A.1 还补全了辛守恒的证明。令 M ( t ) = S ( t ) ⊤ J S ( t ) M(t)=S(t)^\top JS(t) M(t)=S(t)⊤JS(t),利用 S ˙ = J K S \dot S=JKS S˙=JKS、 K ⊤ = K K^\top=K K⊤=K、 J ⊤ = − J J^\top=-J J⊤=−J 和 J 2 = − I J^2=-I J2=−I:
d M d t = ( J K S ) ⊤ J S + S ⊤ J ( J K S ) = S ⊤ K S − S ⊤ K S = 0. \begin{aligned} \frac{dM}{dt} &=(JKS)^\top JS+S^\top J(JKS)\\ &=S^\top KS-S^\top KS=0. \end{aligned} dtdM=(JKS)⊤JS+S⊤J(JKS)=S⊤KS−S⊤KS=0.
因为 M ( 0 ) = J M(0)=J M(0)=J,所以该关系在整个流上保持成立。这里证明的是结构性质;它并不要求模型学习到的时钟与真实物理时间完全相等。
3.5 附录的闭式解:不必逐 token 计算通用矩阵指数
令 G = J K G=JK G=JK。这里用 G G G 表示生成矩阵,以免与季节项振幅 A A A 混淆;它对应附录 A.1 中的矩阵 A A A:
G = ( c b − a − c ) , G 2 = − ( a b − c 2 ) I . G= \begin{pmatrix} c&b\\ -a&-c \end{pmatrix}, \qquad G^2=-(ab-c^2)I. G=(c−ab−c),G2=−(ab−c2)I.
定义 ω = a b − c 2 \omega=\sqrt{ab-c^2} ω=ab−c2 ,矩阵指数的偶次项与奇次项分别合并为余弦与正弦,得到原文公式 (24):
S ( t ) = cos ( ω t ) I + sin ( ω t ) ω G . \boxed{ S(t)=\cos(\omega t)I+ \frac{\sin(\omega t)}{\omega}G }. S(t)=cos(ωt)I+ωsin(ωt)G.
这个式子同时解释了两点: det K > 0 \det K>0 detK>0 产生振荡频率;实际实现可以通过标量三角函数与二维矩阵运算得到流,无须反复调用通用矩阵指数。
对于偶数头维度 d h d_h dh,附录 A.2 将空间分成 d h / 2 d_h/2 dh/2 个二维块,每块学习独立 K i K_i Ki:
S t o t a l ( t ) = blkdiag ( S 1 ( t ) , ... , S d h / 2 ( t ) ) . S_{\mathrm{total}}(t)= \operatorname{blkdiag} \left(S_1(t),\ldots,S_{d_h/2}(t)\right). Stotal(t)=blkdiag(S1(t),...,Sdh/2(t)).
不同块可以学习不同频率与几何;输入驱动的时钟则决定这些变换沿序列如何推进。 附录所说的每块流计算 O ( 1 ) O(1) O(1),针对这个闭式解,不代表完整 softmax 注意力也变成线性复杂度。
3.6 它如何包含 RoPE,又比 RoPE 多了什么?
当 K = ω I K=\omega I K=ωI 时,附录公式 (26) 给出
S ( t ) = ( cos ( ω t ) sin ( ω t ) − sin ( ω t ) cos ( ω t ) ) = R ( ω t ) . S(t)= \begin{pmatrix} \cos(\omega t)&\sin(\omega t)\\ -\sin(\omega t)&\cos(\omega t) \end{pmatrix} =R(\omega t). S(t)=(cos(ωt)−sin(ωt)sin(ωt)cos(ωt))=R(ωt).
也就是说,各向同性 Hamiltonian 产生普通旋转;若同时令 τ ^ t = t \widehat\tau_t=t τ t=t,时间推进也退回均匀索引。
不过,SyPE 的交互写成 q ⊤ J R ( θ ) k q^\top J R(\theta)k q⊤JR(θ)k,普通 RoPE 的交互写成 q ⊤ R ( θ ) k q^\top R(\theta)k q⊤R(θ)k。对附录 A.2 作公式解读时,应保留这个 J J J。由于旋转与 J J J 可交换:
q ⊤ J R ( θ ) k = q ⊤ R ( θ ) ( J k ) . q^\top J R(\theta)k =q^\top R(\theta)(Jk). q⊤JR(θ)k=q⊤R(θ)(Jk).
固定的 J J J 可以吸收到可学习的 Key 投影中。因此,二者在这种参数设置下具有相同的分数表达形式;这不等于保持所有原始 Query、Key 不变时,逐项分数也完全相同。
由此可把方法的两个自由度分开理解:
| 组成 | 改变了什么 | 退回固定 RoPE 的条件 |
|---|---|---|
| 自适应时钟 τ ^ \widehat\tau τ | 相同索引间隔对应的有效时间差 | τ ^ t = t \widehat\tau_t=t τ t=t |
| 稳定辛流 S S S | 时间坐标对向量施加的频率与各向异性几何 | 每块 K i = ω i I K_i=\omega_i I Ki=ωiI,并作上述固定基变换 |
这个区分也决定了实验应该怎样读:固定索引的问题与旋转几何的问题,需要分别消融。
四、实验:哪些证据真正解释了方法?
4.1 先明确实验设置与比较口径
正文表 2、附录 D 和附录 E 实际列出 10 个真实数据集:Weather、Solar、ECL、四个 ETT 子集,以及 PEMS03、PEMS04、PEMS08。原文部分叙述中的数据集数量不一致,这里以具体结果表为准。
附录 C.1 给出的数据覆盖气象、光伏、电力与交通:Weather 每 10 分钟采样,Solar 每 10 分钟采样,ECL 每小时采样,ETT 分为每小时及每 15 分钟版本,PEMS 每 5 分钟采样。附录 D 的预测长度为:前三类及 ETT 使用 { 96 , 192 , 336 , 720 } \{96,192,336,720\} {96,192,336,720},PEMS 使用 { 12 , 24 , 48 , 96 } \{12,24,48,96\} {12,24,48,96}。
附录 C.2 补充了训练配置:
| 设置 | 真实数据实验 | 合成实验 |
|---|---|---|
| Transformer 层数 / 头数 | 3 层 / 4 头 | 1 层 / 4 头 |
| 隐藏维度 | 随数据规模取 64 或 128 | 128 |
| 前馈维度 | 4 d m o d e l 4d_{\mathrm{model}} 4dmodel | 512 |
| 优化器 / 学习率 | AdamW / 5 × 10 − 4 5\times10^{-4} 5×10⁻⁴ | AdamW / 2 × 10 − 4 2\times10^{-4} 2×10⁻⁴ |
| Dropout | ETT 与 Weather 使用 0.1 | 0.1 |
模型采用注意力前的 LayerNorm、GPT-2 权重初始化、MSE 损失,有效 batch size 为 32;大数据集通过梯度累积实现。真实数据训练使用余弦退火与 patience 为 12 的早停。所有实验使用随机种子 2026,硬件为单张 RTX4090 或 L40S。
还需保留附录 C 的比较背景:OLinear 与 TimeMixer++ 的成绩取自各自原论文;作者说明未能在自己的设置下复现 TimeMixer++ 的报告表现。Traffic 和 PEMS07 因 TimeMixer 的显存需求被排除;Exchange 因随机游走及最后值基线较强而被排除。因而本文最直接的机制证据来自同一模型内部的对照,不能把所有跨论文成绩理解为统一重训结果。
4.2 合成实验揭示的失败模式:峰谷出现的时间错了
作者使用前述季节性 AR(1) 过程,令时间扭曲为
τ ( t ) = ∑ i = 0 t ( 1 + A sin 2 π i P ) . \tau(t)=\sum_{i=0}^{t} \left(1+A\sin\frac{2\pi i}{P}\right). τ(t)=i=0∑t(1+AsinP2πi).
这个构造模拟周期性加速与减速。合成序列有 7 个通道、17,420 个时间点,历史窗口 L = 96 L=96 L=96;所有对照都只使用一层注意力,以贴近理论分析的单层设定。
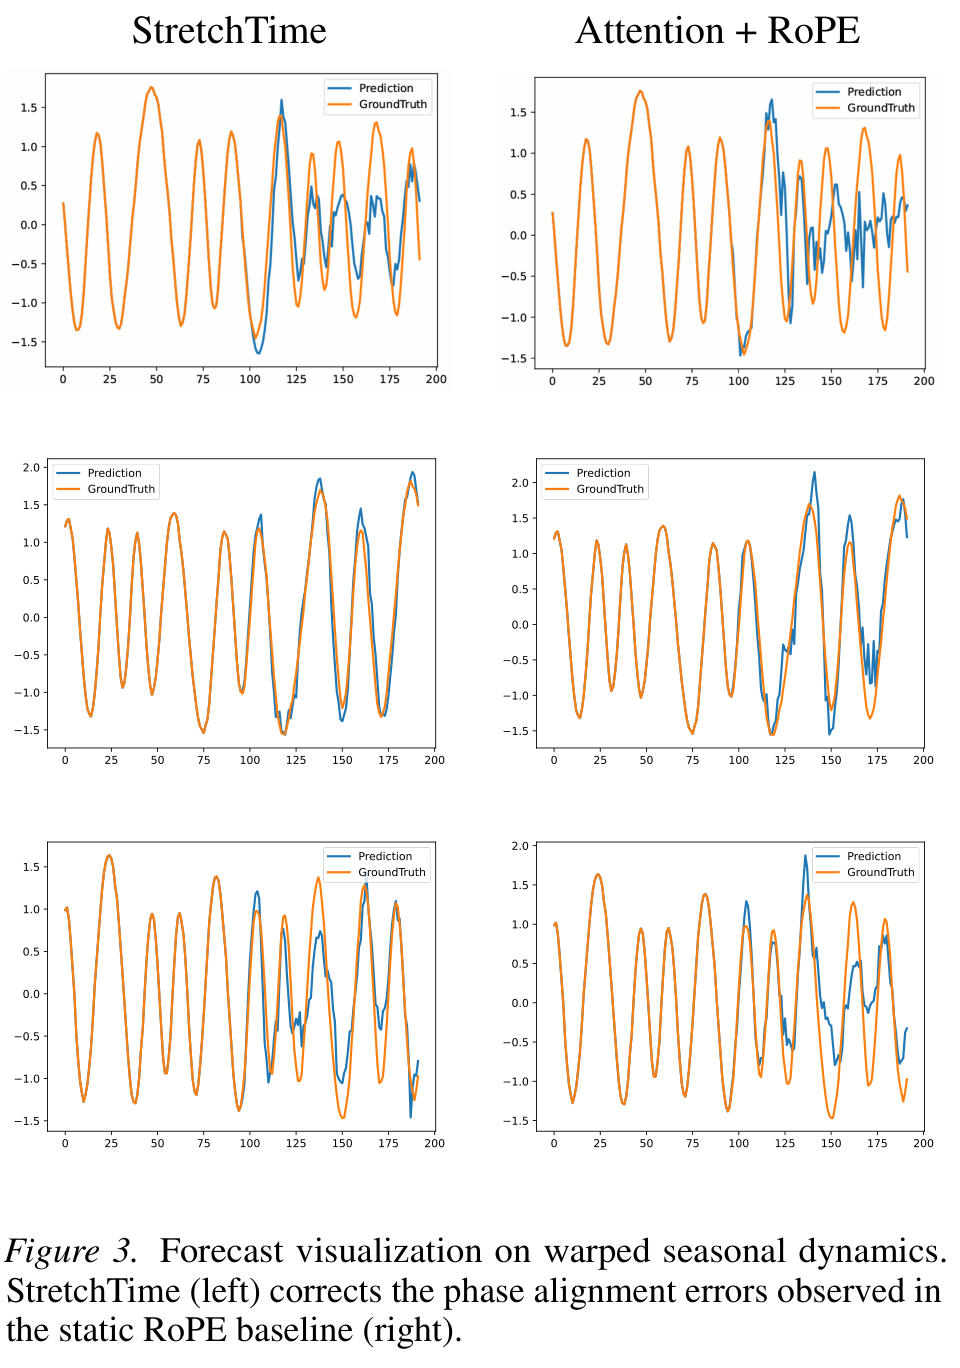
原文 Figure 3。左列为 StretchTime,右列为 Attention + RoPE;蓝色为预测,橙色为真实值。
比平均误差更重要的是原图展示的相位失同步。右列 RoPE 的预测仍保留部分振幅结构,但峰谷时刻逐渐错开;左列 StretchTime 的相位对齐通常更好。改善并不意味着每个预测点都精确吻合,图中仍能看到振幅与局部形状误差。
表 1 还比较了移除通道混合 MLP 的版本:
| 预测长度 | StretchTime MSE | RoPE MSE | w/o MLP MSE |
|---|---|---|---|
| 96 | 0.053 | 0.058 | 0.078 |
| 192 | 0.073 | 0.084 | 0.105 |
| 336 | 0.120 | 0.184 | 0.161 |
| 720 | 0.331 | 0.411 | 0.358 |
短预测上,删去 MLP 会明显损失性能;但到 336、720 步,保留可变时钟与辛机制的 w/o MLP 仍优于完整 RoPE 对照。
**阅读理解:**在这个受控的时间伸缩任务中,增加内容处理能力不能完全替代合适的时间坐标。这支持作者关注位置机制的动机,也保留了 MLP 在短预测中的价值。它不能推广为"MLP 对时间序列预测不重要"。
4.3 主要收益来自可变时钟,辛几何的收益依赖数据
表 4 是拆分两部分作用的关键实验:
| 变体 | 时间坐标 | 几何变换 | 检验的问题 |
|---|---|---|---|
| StretchTime | 自适应 τ ^ \widehat\tau τ | 稳定辛流 | 完整方法 |
| w/o Symplectic | 保留自适应 τ ^ \widehat\tau τ | 普通 RoPE 旋转 | 更丰富的几何是否必要? |
| w/o Warp | 固定 τ ^ t = t \widehat\tau_t=t τ t=t | 保留辛流 | 可变时钟是否必要? |
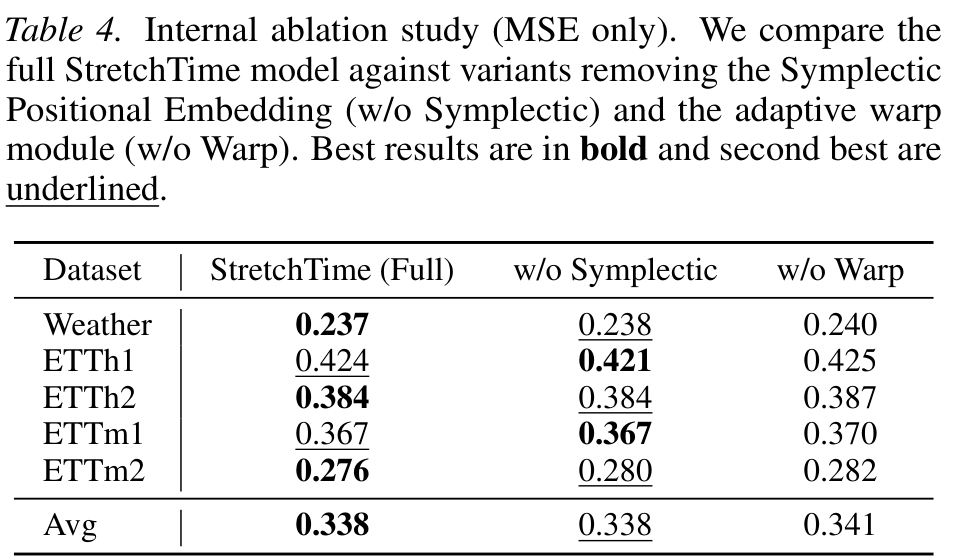
原文 Table 4。报告五个数据集上各预测长度平均后的 MSE。
去掉 Warp 后,表中五个数据集都变差,报告的平均 MSE 从 0.338 变为 0.341。相比之下,完整模型与 w/o Symplectic 的平均值按表中精度都为 0.338:Weather、ETTm2 上完整模型略好,ETTh2、ETTm1 持平,ETTh1 上普通旋转版本反而更好,分别为 0.421 与 0.424。
作者将这种差异解释为:结构较清晰时,各向异性几何可能有用;噪声较强时,更严格的旋转约束可能起到正则化作用。
阅读理解: 这组结果对"自适应时间坐标有用"的支持更一致;对"必须使用更一般的辛几何"的支持则较弱且依赖数据。表中差值也不大,不宜把它写成辛变换带来普遍而显著的提升。性能表本身没有直接展示学习后的 K K K,所以"模型在噪声下退回旋转"应视为作者的解释,而非已观察到的参数事实。
4.4 附录消融说明:普通注意力并不自动解决时间失配
附录 E 进一步比较四个版本:完整 StretchTime、固定 RoPE、Pure Softmax,以及 LinAttn + RoPE。其中 Pure Softmax 仍有输入端的绝对位置嵌入,只是去掉 RoPE / SyPE 这样的相对位置注入;LinAttn + RoPE 则更换为线性注意力。
表 6 中,StretchTime 在 40 个"数据集 × 预测长度"的 MSE 对比项里取得 38 个第一,平均排名为 1.05。这不是 40 次独立试验,也不是把 MSE 与 MAE 合并后的 38/40。两个例外都在 PEMS04:24 步时 RoPE 更好,96 步时 LinAttn + RoPE 更好。
更有意思的是,Pure Softmax 的平均排名 2.65 略好于固定 RoPE 的 2.73。加入静态旋转并不保证改善;位置先验能否适配数据,与是否加入位置机制同样值得关注。
完整方法对这些内部版本的优势,说明收益不能仅归因于"使用了 Transformer 或 softmax"。但这组对照同时改变了时钟和几何,不能单独用于证明辛几何是收益的唯一来源;区分两者仍应回到表 4。
完整截图见:原文 Table 6,PDF 第 16 页。

4.5 附录完整结果:优势随预测长度与误差口径变化
按正文表 2 的数据集平均 MSE,StretchTime 在 10 个数据集上都优于内部 RoPE 对照,且 Solar、PEMS03 等任务的差异较突出。这与作者关于季节节奏和交通周期变化的解释相符。不过,真实数据比较没有直接测量其真实扭曲函数,不能仅凭成绩就断言已证明每个数据集具有某种具体的非仿射时钟。
附录 D 的完整表 5 补充了几项更细的认识:
第一,收益不一定随着预测长度单调增加。 Solar 在 96 步时,StretchTime 与 RoPE 的 MSE 为 0.158 与 0.190;到 720 步则为 0.217 与 0.218,差异很小。合成任务上的长预测收益,不能直接推广到所有真实任务。
第二,更好的 MSE 不等于同时得到更好的 MAE。 Solar 96 步时,StretchTime 的 MSE 低于 OLinear 的 0.179,但 MAE 为 0.241,高于 OLinear 的 0.191。这说明评价口径影响优势判断,不能只选择一个指标就声称所有误差表现都更好。
第三,"最好平均排名"依赖汇总方式。 正文表 2 先按数据集汇总,报告 StretchTime 平均排名 2.20、OLinear 为 2.30;附录表 5 在所有预测长度上统计,报告两者为 2.27 与 2.08。后者的第一名次数分别为 13 与 12,TimeMixer++ 为 17。StretchTime 有竞争力,但并非每一种统计口径都全面领先。
完整截图见:原文 Table 5,PDF 第 15 页。

4.6 参数少与运算少,是两个不同的结论
正文表 3 在 ETTm1 上比较不同预测长度,报告平均成本:
| 模型 | 平均 FLOPs | 平均参数量 |
|---|---|---|
| StretchTime | 2.79G | 493.75K |
| TimeMixer++ | 6.25G | 1.22M |
| iTransformer | 212.75M | 9.68M |
| PatchTST | 2.54G | 11.53M |
| DLinear | 905.25K | 65.25K |
StretchTime 的参数量明显小于表中两个 Transformer 基线;相较 TimeMixer++,FLOPs 约低 55%。这支持作者关于预测能力与模型规模之间折中的讨论。
但它的平均 FLOPs 高于 iTransformer 和 PatchTST,也远高于 DLinear。因此,不能把参数效率较高 等同于计算量最低。闭式辛流降低的是位置变换计算成本,完整模型仍保留全注意力的计算负担。
五、如何理解这项工作的贡献与边界?
阅读理解: 本文最值得关注的贡献,是将"时间步的推进速度"从一个固定假设,变成输入驱动的模型组成部分。辛流提供了一种保持相对位置结构的可学习几何,而消融进一步提醒我们:重新定义时间坐标 与增加几何自由度不是同一项改动,前者的作用在本文实验中更明确。
理论与实验之间也应保留层次。定理解释固定位置相位的结构限制;合成实验展示与之相符的相位错位;真实数据和内部消融支持新机制在这些任务上的预测价值。三类证据互相补充,但不应被合并成"所有 RoPE 模型都必然存在不可消除预测误差"的普遍结论。
另外, τ ^ \widehat\tau τ 通过预测损失学习。论文没有给出学习时钟与真实 τ \tau τ 的恢复误差,也没有证明它唯一对应真实物理时间。原文 Figure 3 展示的是预测相位更好地对齐,而不是对真实时钟恢复的直接验证。
原文结论明确保留了扩展边界:尚未在海量数据上检验基础模型及零样本预测能力,也未验证一般序列任务中的效果,例如自然语言处理。附录只报告一个固定随机种子,没有给出多种子误差条;对于表 4 中较小的差异,现有结果不足以判断其跨训练运行的稳定程度。
这篇论文因此提供了一条具体、可拆分检验的研究路线:当周期节奏变化时,从输入学习有效时间,再为该坐标配置具有结构约束的位置变换。对它的评价,应同时关注相位是否对齐、时钟模块是否真正有用,以及额外几何自由度在什么数据上值得保留。