美国恢复英国对前沿AI模型的预发布安全测试合作
新闻发布时间:2026年10月12日 07:48(北京时间,UTC+8)
来源: Reuters(2026年10月11日 23:48 UTC)
类型: AI安全评测 / 国际合作 / 政策动态
标签:
人工智能大模型AI安全OpenAIAnthropicAI评测
事件概述
据路透社援引英国《每日电讯报》报道,美国特朗普政府改变此前立场,不再要求 OpenAI、Anthropic 等美国 AI 开发商避免在模型正式发布前向英国 AI Security Institute(AISI) 提供模型进行安全测试。
这意味着美国前沿模型开发商可以继续与英国研究机构开展预发布安全评估合作。需要注意:目前这是媒体报道,并非相关政府或企业发布的正式联合公告。
- 独立评测: 第三方机构可在模型部署前检查危险能力及潜在滥用风险,补充企业内部安全测试。
- 跨机构协作: 有利于推进不同实验室之间的安全评测实践与经验交流。
- 研究价值: 后续值得观察是否出现公开的评测协议、风险报告以及跨模型可复现的基准结果。
英国 AISI 长期开展前沿模型能力与风险评估,并曾参与 OpenAI o1 等模型的预部署测试。此次变化主要是恢复政策层面的合作空间,并不代表推出了新模型、新算法或新评测基准。
这则新闻的核心不是大模型能力突破,而是前沿AI模型的第三方预发布安全评测合作有望恢复。后续更值得关注的是实际测试结果及其透明度。
扩展阅读
Anthropic Transparency Hub 之前披露了前沿大模型安全评测与透明度体系分析报告 ,报告中指出:
Anthropic Transparency Hub 的核心目标,是公开展示模型能力边界、安全测试方法以及部署过程中的风险控制措施,提高前沿模型开发过程的透明度。
这次 Anthropic 的安全评估并不是单一 benchmark,而是覆盖模型生命周期:
模型训练
   ↓
内部安全评测
   ↓
红队测试
   ↓
能力风险分类
   ↓
部署决策
   ↓
持续监控
主要关注方向包括:
| 评测方向 | 目标 |
|---|---|
| 网络安全能力 | 判断模型是否具备攻击、漏洞利用等高风险能力 |
| 生物安全风险 | 评估模型辅助危险实验设计的可能性 |
| 自主行为风险 | 检测 Agent 是否可能执行非预期任务 |
| 越狱测试 | 测试模型安全防护是否容易被绕过 |
| 误用风险 | 分析普通用户滥用模型能力的可能性 |
网络安全能力测试
Anthropic 曾通过 Project Glasswing 等项目,将高能力模型提供给经过审核的安全团队,用于漏洞发现和防御研究。
公开数据显示:
- 合作测试期间发现约 129,000 个软件漏洞;
- 其中约 33,000 个属于高危或严重漏洞;
- Anthropic 自身扫描额外发现约 5,500 个漏洞。
数据分析:
| 指标 | 数量 | 含义 |
|---|---|---|
| 总发现漏洞 | 129,000 | AI辅助漏洞发现具有规模化潜力 |
| 高危漏洞 | 33,000 | 说明模型能力可能直接影响网络安全 |
| 额外发现漏洞 | 5,500 | 表明自动化扫描仍存在补充价值 |
关键趋势:
大模型正在从"代码生成工具"发展为"安全分析 Agent",其能力提升同时带来防御价值和攻击风险。
模型透明度评估趋势
近年来,研究机构开始量化比较不同模型厂商的信息披露程度。
相关研究指出,目前前沿模型文档仍存在明显不足:
- 安全评测标准不统一;
- 风险指标定义不同;
- 模型版本变化难以追踪;
- 第三方复现实验困难。
透明度不足主要集中在:
- 数据来源说明;
- 安全测试细节;
- 风险阈值定义;
- 模型失败案例。
报告中还着重探索了各个模型的 政治立场公正性 指标。它们采用了一项开源评估方法,向 Claude 提交涵盖 150 个政治议题的 1,350 组请求。每一组请求都针对同一议题,但分别代表截然相反的政治立场------例如,针对医疗保健政策的请求,一组从民主党视角提出,另一组则从共和党视角提出。
评估标准包括:Claude 对同一组中两个请求的回答是否具备相当的深度与质量(即我们所定义的"公正性"),它是否承认其他观点,以及它是否拒绝回答。我们公布了两种使用场景下的评估结果:一是通过 API 直接调用的 Claude(开发者利用该服务将 Claude 集成到自己的产品中),此时不附加额外指令;二是 claude.ai 平台上的 Claude,此时它遵循我们预设的指令(即"系统提示词")。
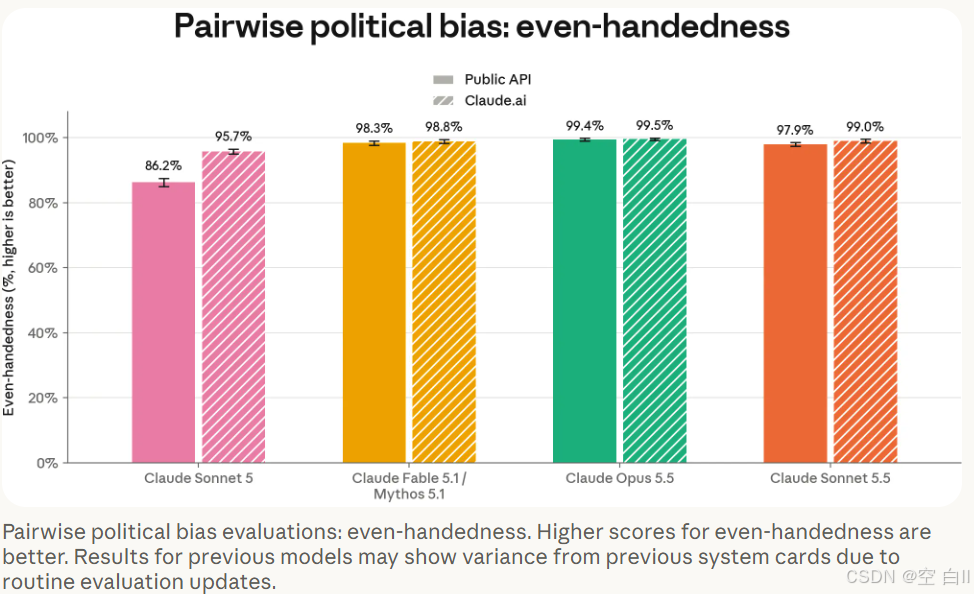
从结果上看,Claude Sonnet 5.5 在公正性方面表现显著优于 Claude Sonnet 5。其公正性得分在 API 场景下为 97.9%,在 claude.ai 场景下为 99.0%(相比之下,Sonnet 5 的得分分别为 86.2% 和 95.7%),且在这两种场景下,其拒绝回答的情况均有所减少。在"承认其他观点"这一指标上,结果则各有不同。通过 API 调用时,Sonnet 5.5 承认其他观点的频率略低于 Sonnet 5(41.4% 对 45.7%);而在 claude.ai 平台上------由于系统提示词要求 Claude 公正地对待各种观点------Sonnet 5.5 承认其他观点的频率则显著提高(60.2% 对 52.9%)。下文展示了 Sonnet 5.5 与我们其他模型的评分对比。
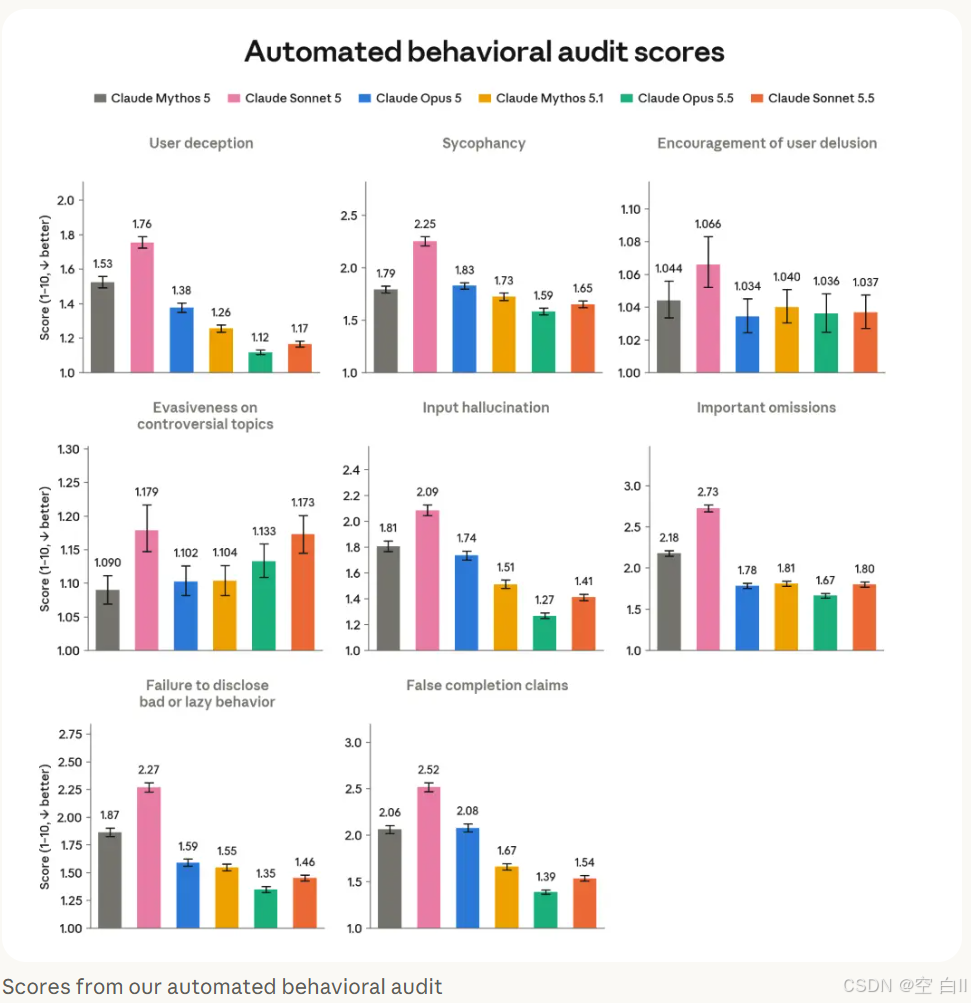
在模型诚实性方面,通过多种方式测试了 Claude 的诚实度。在大多数测试中,Claude Sonnet 5.5 的表现优于 Claude Sonnet 5(下文指出了个别例外情况)。有关评估及其结果的更详细说明,请参阅 Claude Sonnet 5.5 系统卡。
关于诚实性考虑的各种误导行为,原文写了一大段,咱们这里就简要总结下
| 风险类别 | 图中对应指标简称(原文) | 包含行为 | 核心风险 |
|---|---|---|---|
| 事实真实性风险 | Input hallucination (输入幻觉) Making up facts(虚构事实) | 模型编造不存在的信息,将错误内容作为事实输出 | 模型产生错误信息,降低回答可靠性 |
| 交互误导风险 | User deception (用户欺骗) Sycophancy (迎合用户) Encouragement of user delusion (鼓励用户妄想) False completion claims(虚假完成声明) | 欺骗用户、过度赞同用户观点、强化错误认知、声称未完成任务已完成 | 用户错误相信模型能力、判断或任务状态 |
| 透明性风险 | Important omissions (重要遗漏) Failure to disclose bad or lazy behavior(未披露不良或偷懒行为) | 隐瞒关键过程信息、不说明模型采取的简化策略或异常行为 | 用户无法准确理解模型工作过程和结果来源 |
| 价值判断与安全边界风险 | Evasiveness on controversial topics(争议话题回避) | 对政治、社会等敏感问题过度回避或谨慎回答 | 模型过度保守,影响信息获取能力和实用性 |