REA登顶GitHub:AI如何逆向一切软件
- [REA 到底是什么](#REA 到底是什么)
- 为什么逆向一直很难交给机器
- [Agent 怎么调起 133 个工具](#Agent 怎么调起 133 个工具)
- 证据模型:把能证明的和不能证明的分开
- [横向对比:REA、Jev、OpenClaw 与传统逆向](#横向对比:REA、Jev、OpenClaw 与传统逆向)
- 上手路径:现在就能试的两条路
- 增长曲线:半年潜伏,十月爆发
- 冷静视角:三个值得保留的疑问
- 小结
2026年10月12日,一个名为 REA(Reverse Engineer Anything,逆向一切)的开源项目在 GitHub 上突破 11.5 万星、2.5 万 fork,一度连续多日占据 Trending 榜首。「比 Jev 更爆火」是社区里流传的说法,但它的技术内核和那些「现象级模型」并不是一类东西。REA 不是训练出来的新模型,而是一套让 AI Agent 直接对软件做逆向工程的工具链:通过 133 个 MCP 工具调度 Hopper、Ghidra、IDA 等逆向引擎,并把每一步结果固化成可核验的证据。这篇文章想回答三个问题:它到底解决了什么老问题、内部如何运转、以及现在上手值不值得。
概念澄清:REA 到底是不是又一个「AI 神器」
很多爆火项目的第一印象是「又来一个万能模型」,REA 不是。它的仓库 morluto/rea 用 TypeScript 写成,采用 MIT 协议,对外暴露三种形态:一个 MCP 服务器、一个命令行工具 rea,以及一套 Agent 可直接加载的 skill 包。换句话说,REA 本身是「胶水」和「调度层」,真正干活的是它背后那一整套成熟的逆向工具。
把这件事说清楚很重要,因为它决定了你怎么定位 REA。它不做模型推理,也不产生新的权重;它把 Hopper 看反汇编、Ghidra 做反编译、JADX 拆 APK、Binwalk 抽固件这些本来要人手动点的操作,封装成 Agent 可以调用的工具。社区给它起的「逆向灭霸」外号,形容的是覆盖面广,而不是它内部有某种神秘算法。
REA 覆盖的目标类型有九类:原生二进制(配合 Hopper / Ghidra / IDA)、JavaScript 与 Electron 应用、.NET 程序集(CIL 字节码)、Android APK、网站与 HAR / mitmproxy 抓包、固件(Binwalk / Unblob)、WASM 与 EVM 字节码、进程运行时行为(通过 PTY 观测)。这九类基本覆盖了「一个软件从安装包到运行态」的全部形态。
理解这一点,就能避开一个常见误读:REA 不会替你「读懂」软件,它只负责把软件拆开、把每一步拆开的结果记好。真正做判断的,还是你或者你的 Agent。skill 包里那套 216 行的 SKILL.md,本质上是给 Agent 的「操作手册」:它规定遇到一个二进制先看什么、比对两版时比哪些维度、重建完如何验证、遇到解释不了的地方怎样如实标注。所以 REA 的竞争力不在某个单项能力多强,而在它把逆向这件事从「老师傅的手艺」变成了一套可重复执行的流程。
为什么逆向一直很难交给机器
逆向工程长期是高度依赖专家经验的活。一个反编译出来的函数是机器给的,但「这个函数到底在做什么业务」「这段逻辑对应哪个功能」「两版之间改了哪里」这些判断,传统工具给不出理由,只能靠人读。问题出在三处。
第一,工具结果没有「出处」。反编译器吐出一串变量名,你不记得它来自哪个文件的哪一段、第几个字节,复查时就只能重新跑一遍。第二,推断和事实混在一起。有经验的人会说「我猜这里是鉴权入口」,但工具不会把「猜」标出来,后人分不清哪些是确定的、哪些只是假设。第三,跨工具协作成本高。看原生二进制用 IDA,看网页用浏览器加抓包,看 .NET 用 dnSpy,切换环境、对齐符号,整个过程零散且不可复现。
REA 的切入点是把这三处一次性补上:每个结论带出处、每个推断被显式标注、所有工具通过统一协议被 Agent 调度。它没发明新的逆向能力,而是给旧能力加了「工程化外壳」。
举个具体场景:你想知道某款闭源剪贴板工具会不会把内容偷偷上传。传统做法要自己装反编译环境、定位网络相关代码、再人工判断那段逻辑是不是上传。每一步都依赖你对工具链的熟练度,换个人来结果可能完全不同。更麻烦的是,做完一遍你手里只多了一份笔记,三个月后想复查,往往要重头再来。REA 想解决的正是这种「做一次就丢、换人就废」的浪费。
Agent 怎么调起 133 个工具
REA 的运转可以拆成四层。最上面是调用方,也就是你本地的 AI Agent(Claude Code、Codex、Cursor、Gemini CLI 等),它负责把「帮我看看这个闭源 App 的剪贴板逻辑」这样的自然语言任务拆解成工具调用。
这个分层的好处是职责清晰:调用方只管提需求,协议层负责把需求翻译成工具调用,引擎层专注把二进制拆开,证据层则独立于「分析动作」单独存在。正因为证据层和分析动作解耦,REA 才能做到「哪怕分析过程换了工具,证据链条依然连续」。很多自制的逆向脚本做不到这点,工具一换,之前的结论就作废了。
中间是 MCP 协议层,REA 在这里注册了 133 个 MCP 工具,其中只有 5 个是只读的,其余都会触发实际的逆向动作。只读工具的存在很关键:它们只负责「看」,不会改动被分析的对象,这让 REA 在审计场景里更安全------你不用担心分析过程本身污染了证据。其余会触发动作的工具,则对应反编译、比对、抓包这类真正动手的步骤,使用时需要你明确授权。它还内置 6 个引导式 prompt:调查某个功能、比对两个应用版本、验证重建是否正确、追溯崩溃原因、审计残留的未知项、以及为合规抓包做准备。这些 prompt 不是花哨的提示词,而是强制把工作流规范化的模板。
再往下是逆向引擎层,也就是 Hopper / Ghidra / IDA 等真实工具,由 MCP 层按需唤起。最底层是证据层:每一条结果都附带文件 digest、字节范围、JSON 指针,以及一份「暂时无法解释的项」清单。证据层用一个叫 computeEvidenceId 的函数生成 ID------它是 ev_ 前缀加上内容的 SHA-256 哈希,这意味着证据一旦生成就不可被悄悄篡改,任何修改都会让 ID 对不上。
那 6 个引导式 prompt 对应六类典型任务:调查某个具体功能怎么实现、比对两个版本之间改了什么、验证你重建的代码是否和原程序行为一致、追溯一次崩溃或异常的根因、把还解释不了的地方列成清单、以及为一次有边界的抓包做准备。它们存在的目的,是防止 Agent 拿到工具后「自由发挥」------没有模板,模型很容易把推断当事实写进结论,而这恰恰是逆向最不能犯的错。
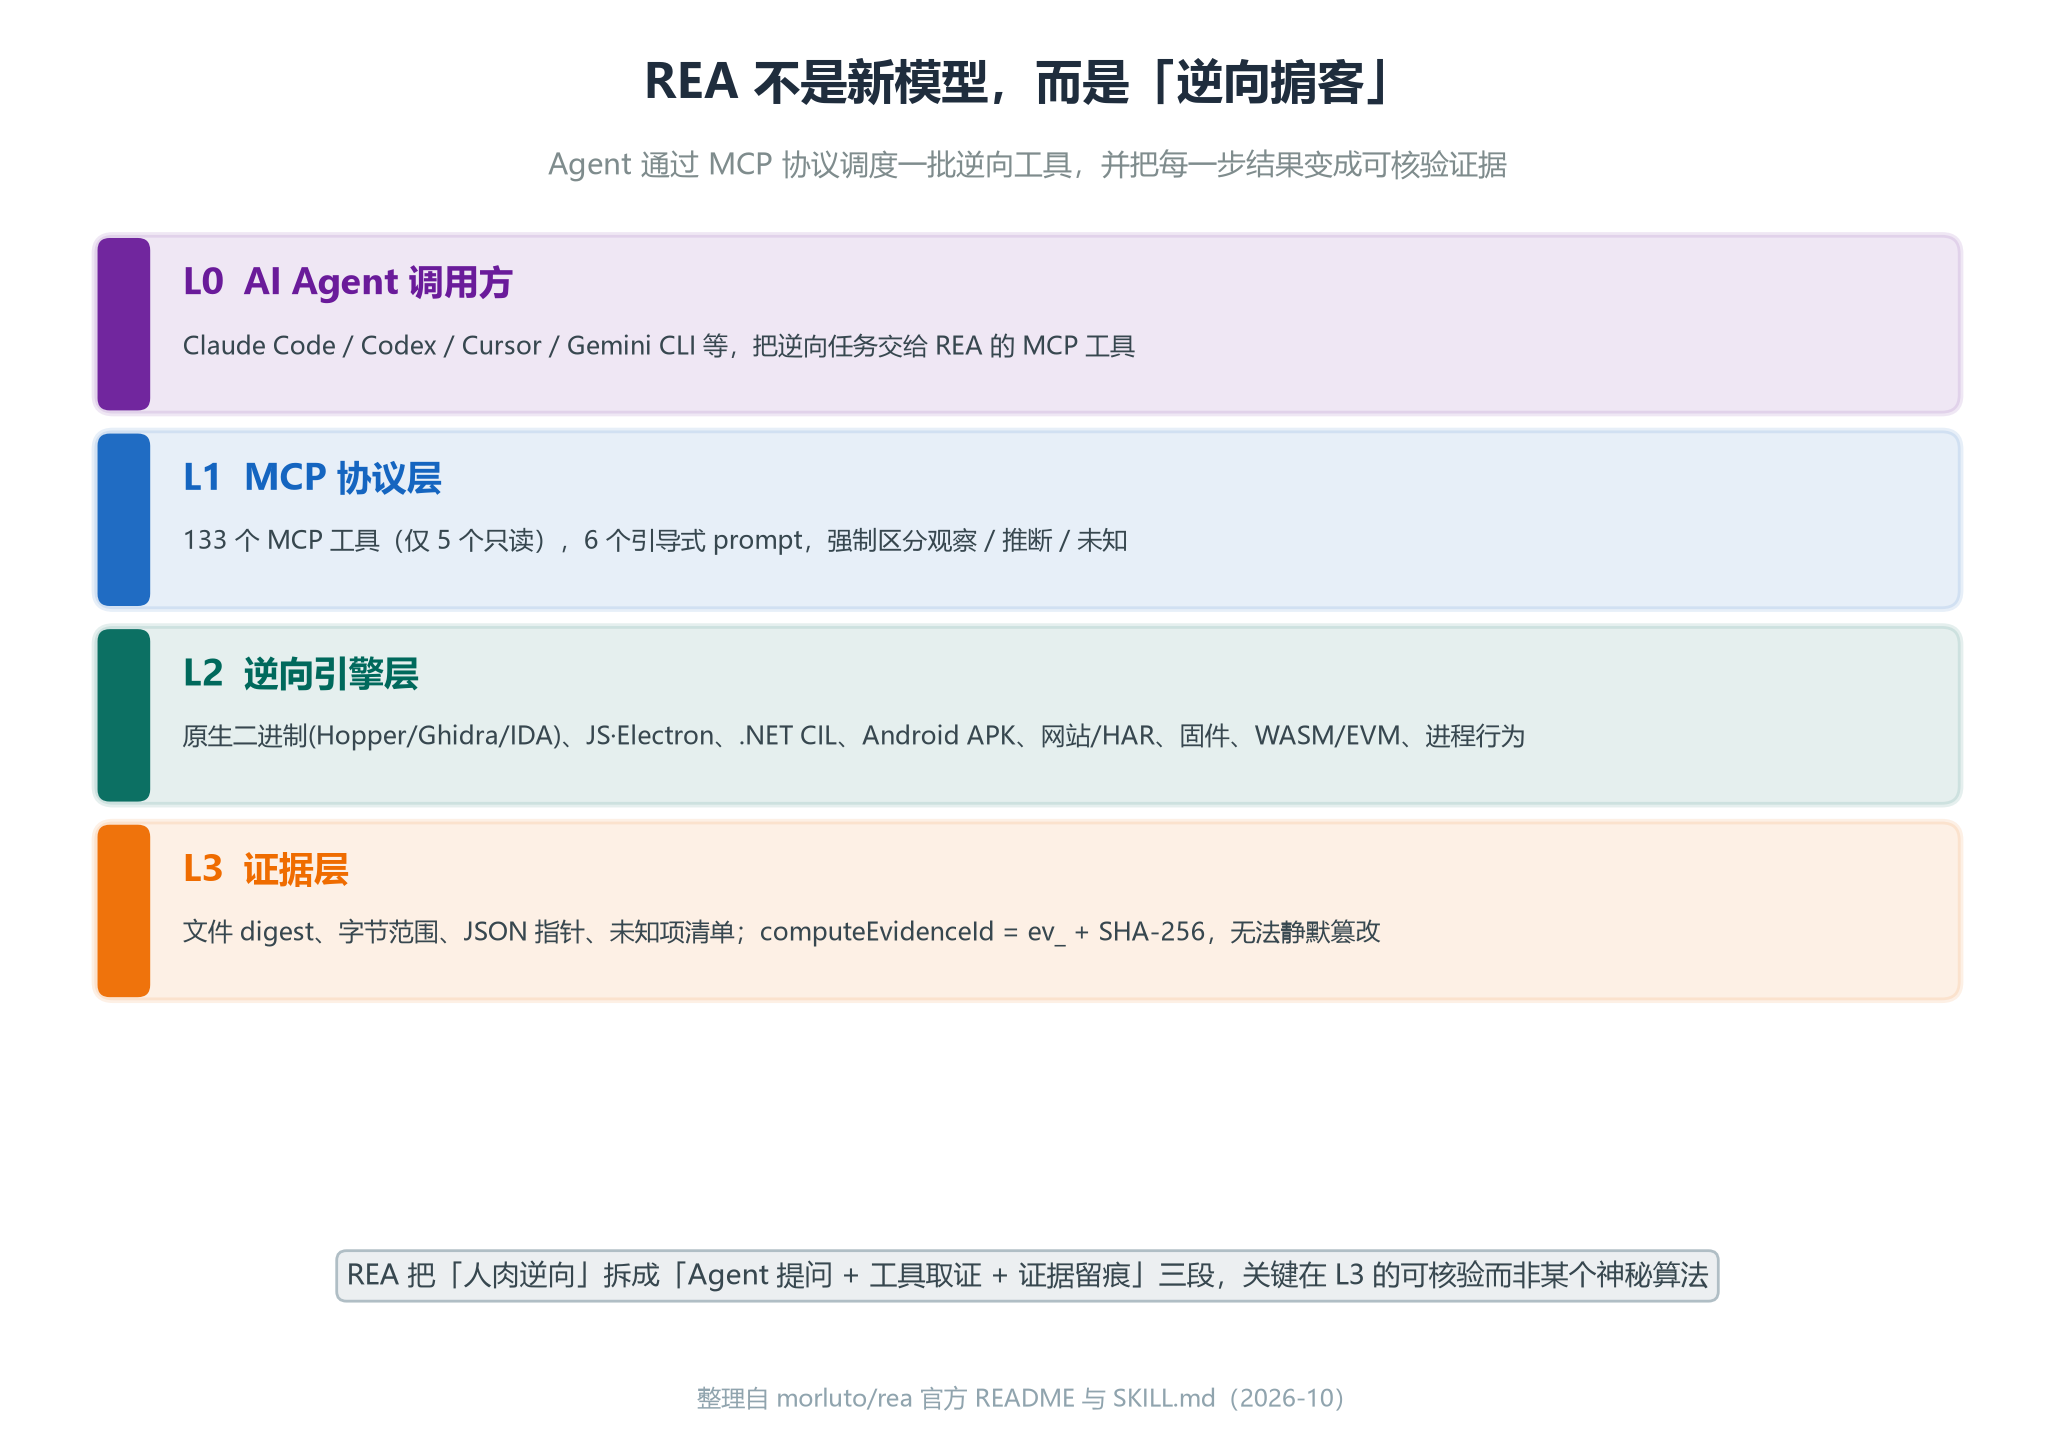
(图一:REA 把「人肉逆向」拆成 Agent 提问、工具取证、证据留痕三段)
证据模型:把能证明的和不能证明的分开
REA 里最值得普通开发者借鉴的,不是那 133 个工具,而是它的「事实 / 推断 / 未知」三层分离。SKILL.md 一共 216 行,核心要求就是:Agent 在输出时必须把三类内容分开写,读者一眼就能判断结论的硬度。
能直接观察的是事实。例如 10 月 12 日项目超 11.5 万星、2.5 万 fork;工具数量是 133;SKILL.md 行数是 216;DX-Ball(一款 1996 年的游戏,PE 文件 158208 字节、i386 架构)被 REA 4.1.0 配 Ghidra 12.1.4 重建出 C 代码,生成的 3205 组测试全部一致,连 63 字节的机器码都对得上;Aegis 这款 2FA 工具的 TOTP 逻辑重建后 133 组也一致。这些是硬事实。
还有更多可核验的案例支撑这个结论:Notion 的剪贴板桥接逻辑被它定位并解释;东方幻想乡这类弹幕游戏的渲染与判定流程被梳理出来;甚至有人把 Halo CE 用浏览器做了移植,中间对原始二进制的理解就借助了这类逆向流程。这些案例的共同点是------结论都跟着证据走,而不是跟着「感觉它对」走。
基于事实能做合理推断,但要标注「待验证」。比如登顶速度确实超过了 Jev 与 OpenClaw 同期曲线;再比如一次针对 8 个文件、Electron 应用的分析实测耗了 209619 个 token,说明日常高频使用成本不低;安装体积约 90MB、131 个依赖包、装好大约 11 秒,也提示它对轻量环境不算友好。这还只是初始安装,后续每次大版本更新都可能带来新的依赖与配置变动,长期维护成本不可忽视。
还有一批目前只能诚实标注为「未知」的项。2.5 万 fork 里有多少是真实在用、多少只是顺手收藏,没有公开数据;watchers 只有 0.32%(83k 星里约 269 人),远低于正常仓库近 2% 的水平;82 个 contributors 占 0.10%,这些数据让外界对星数真实性产生疑问。把未知单列出来,恰恰是证据模型的价值------它不把「能证明的」和「不能证明的」混成一句「它很神」。
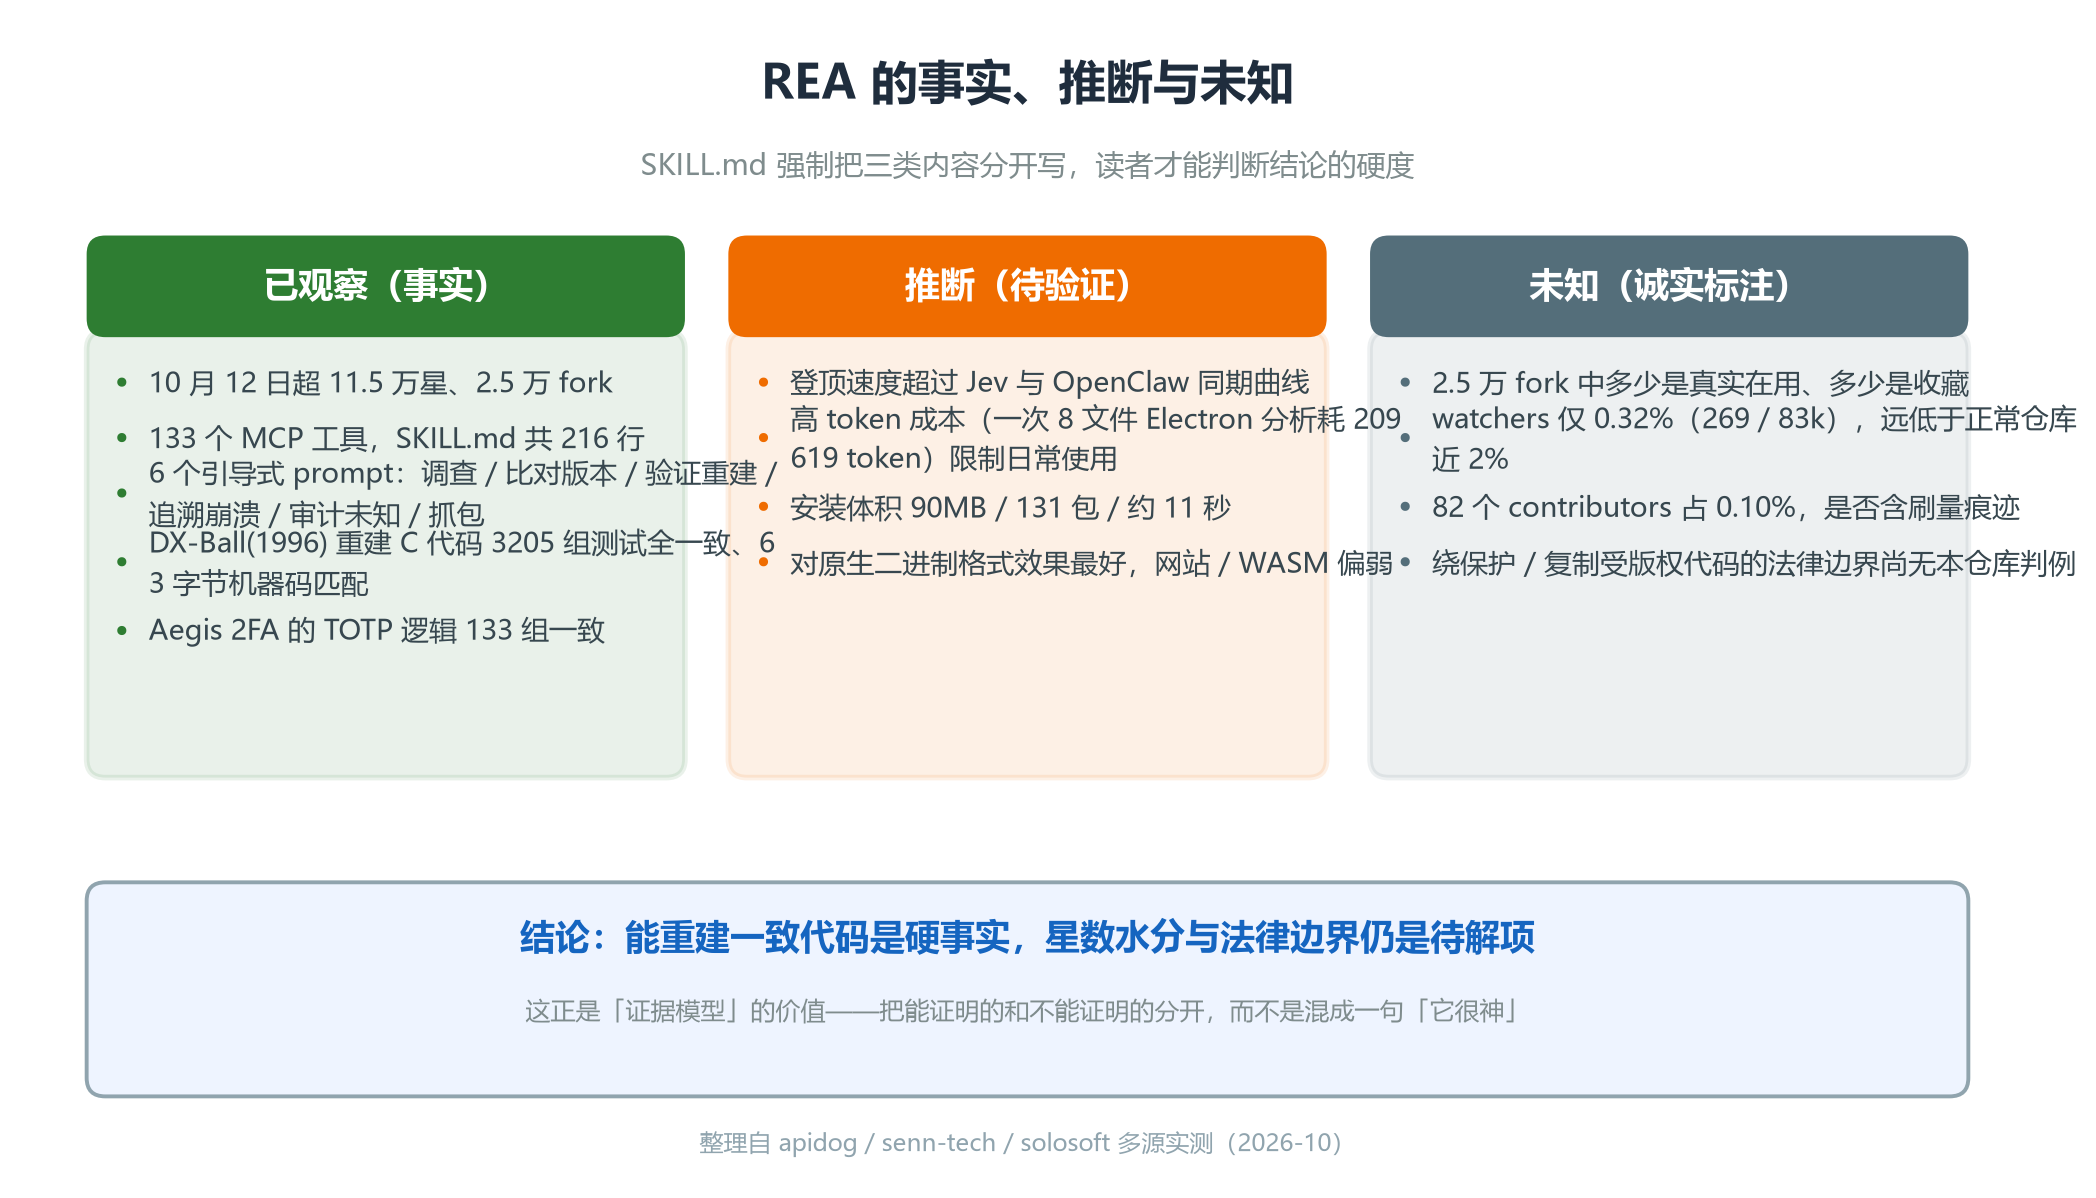
(图二:REA 要求把已观察、推断、未知三类内容分开呈现)
横向对比:REA、Jev、OpenClaw 与传统逆向
把 REA 和常被一起提到的项目摆在一起,能看清它真正的定位。
REA 是开源的 MCP 逆向掮客,133 个工具覆盖九类目标,强在证据留痕,10 月 12 日超 11.5 万星、2.5 万 fork,要求 Node 22.19+ / 24.11+ / 26+(23 与 25 不在支持列表)。对运行环境的要求也说明它依赖较新的运行时特性,老机器直接跑会踩坑。
Jev 是另一条赛道的东西。它是闭源的高频结构化决策模型,前 3 天 npm 下载约 3.5 万,和 REA 累计约 4.4 万的体量同量级,但用途完全不同------Jev 解决的是「分类、路由、打分、是非」这类判断,本身不是逆向工具。社区拿两者比,更多是叙事需要,不是技术可比。
OpenClaw 是年初爆火的项目,第 3 天约 6 万星,而 REA 第 3 天已近 8 万星实现反超;两者技术路线不同,但都受过「增长是否真实」的质疑,且 OpenClaw 比 REA 早了半年。
把三者放回各自语境会更清楚:REA 火在「让 AI 第一次能规模化地动逆向工具」,Jev 火在「把决策成本压到极低」,OpenClaw 火在「年初那波 Agent 热潮」。它们被放在一起讨论,是因为都出现了「几天登顶」的曲线,但技术内核互不替代。这也提示一个务实的搭配:把 REA 当作「先用 AI 快速摸清轮廓」的入口,遇到它覆盖不到或证据不足的硬骨头,再回到 Ghidra / IDA 手工深挖。两者不是二选一,而是前后道工序。
传统逆向(Ghidra / IDA 人工流程)依旧不可替代。它纯靠专家手工加反汇编工具,没有 AI 编排、慢、难复现、不可留痕,但在硬核原生二进制上仍是最强方案。REA 本质上是把传统工具包成了 Agent 可调用的能力,而不是取代它们。
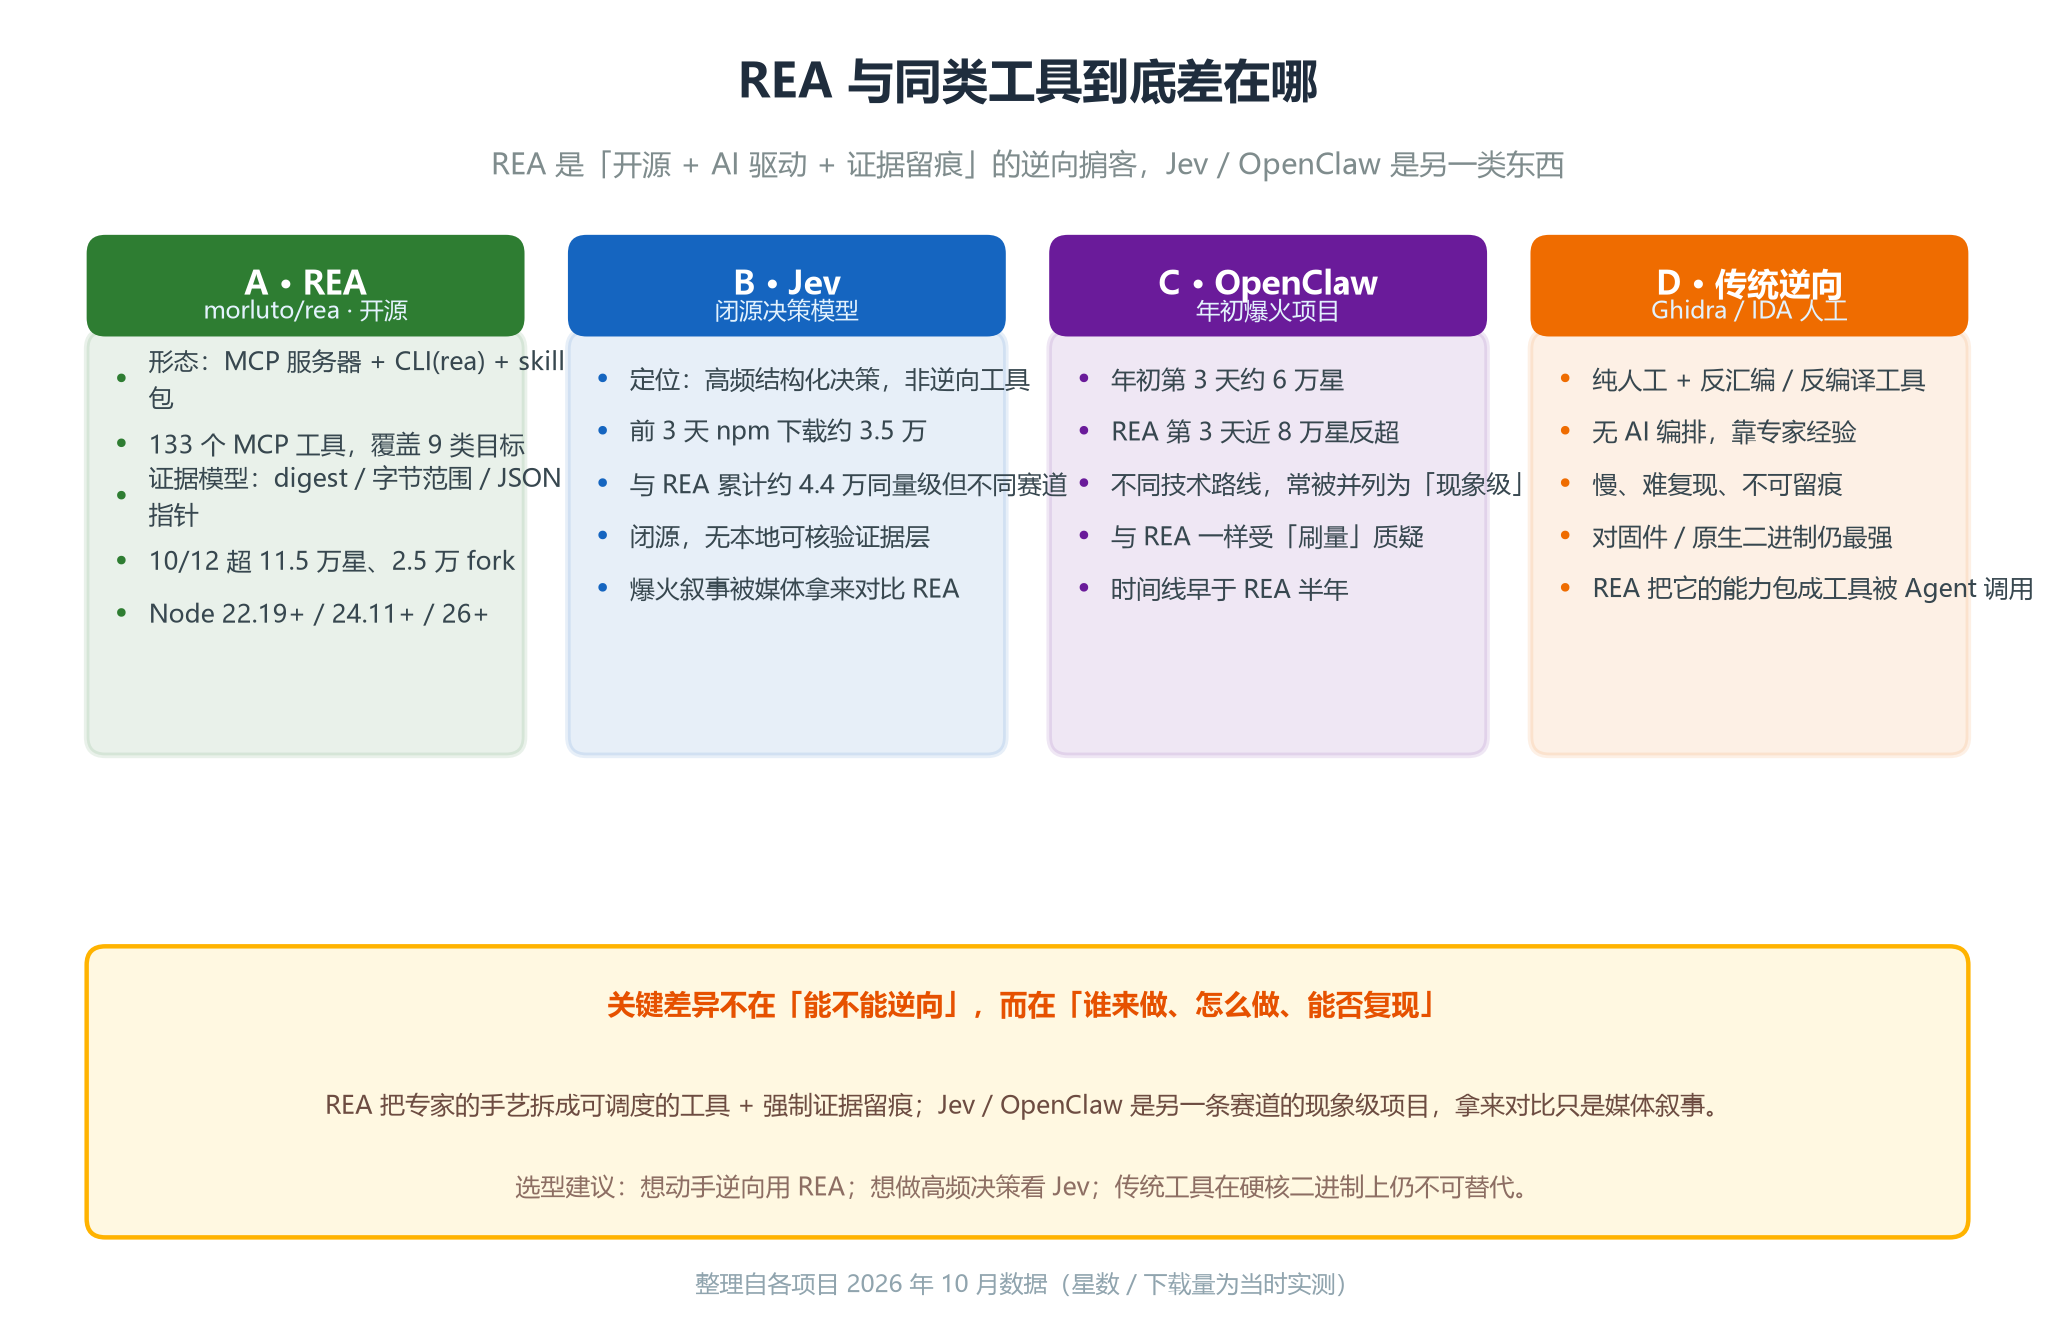
(图三:REA 与 Jev、OpenClaw、传统逆向的关键差异在「谁来做、怎么做、能否复现」)
上手路径:现在就能试的两条路
REA 的安装门槛不高,官方提供了两条路,按需选。
第一条是完整接入你的 Agent。保证本机有受支持的 Node 版本后,运行官方引导命令,它会让你选要接入的客户端(Claude Code、Codex、Cursor、Gemini CLI 等),并把 MCP 配置写进对应环境:
【触发条件】本机已装 Node 22.19+ / 24.11+ / 26+
bash
npx rea-agents setup --client claude-code装好之后,直接在 Agent 里用自然语言下任务即可,比如「调查这个 Electron 应用的本地存储逻辑」。
第二条是免本地原生引擎的快速体验。如果你不想在机器上装 Hopper / Ghidra 那一套,可以用官方提供的分析入口,直接把一个 JavaScript 应用的分析任务以 JSON 形式提交,由远端返回结构化结果:
【触发条件】只想先看效果、本机没有逆向工具链
bash
npx -y rea-agents@latest analyze-javascript-application ./your-app --json这条命令不依赖你本地是否装了原生反编译工具,适合先验证 REA 能不能解决你的问题,再决定要不要完整部署。注意,部分官方入口存在限流,遇到排队时回到第一条本地路径更稳。
不管走哪条路,都建议把 REA 锁在固定小版本上再投入生产。它迭代太快,今天能跑的命令下周可能改名;在团队里最好由一个人负责跟版本,其他人只调用封装好的接口,避免每人机器上行为不一致。
增长曲线:半年潜伏,十月爆发
REA 的星数曲线很典型:前面半年几乎无人问津,爆发集中在 2026 年 10 月。仓库创建于 4 月 14 日,采用 MIT 协议、TypeScript 写成;10 月 3 日还在 v3.2,到 10 月 4 日第一次出现在 Trending,当天约 1373 星;随后版本几乎按天迭代,v4.0(10/5)、v5.0(10/7)、v6.0(10/8)一路推进;10 月 9 日到 11 日连发 v6.1 到 v6.4,配套的 rea-agents 到 6.3.0;有第三方在 10 月 11 日 09:41 UTC 实测记录到 83089 星;到 10 月 12 日站上 11.5 万星、2.5 万 fork。
有意思的是,星数暴涨的同时,贡献者数量并没有同比例跟上------这是「口碑传播快、深度参与慢」的典型特征,也和部分观察者怀疑的「增长不完全来自真实使用」相互呼应。
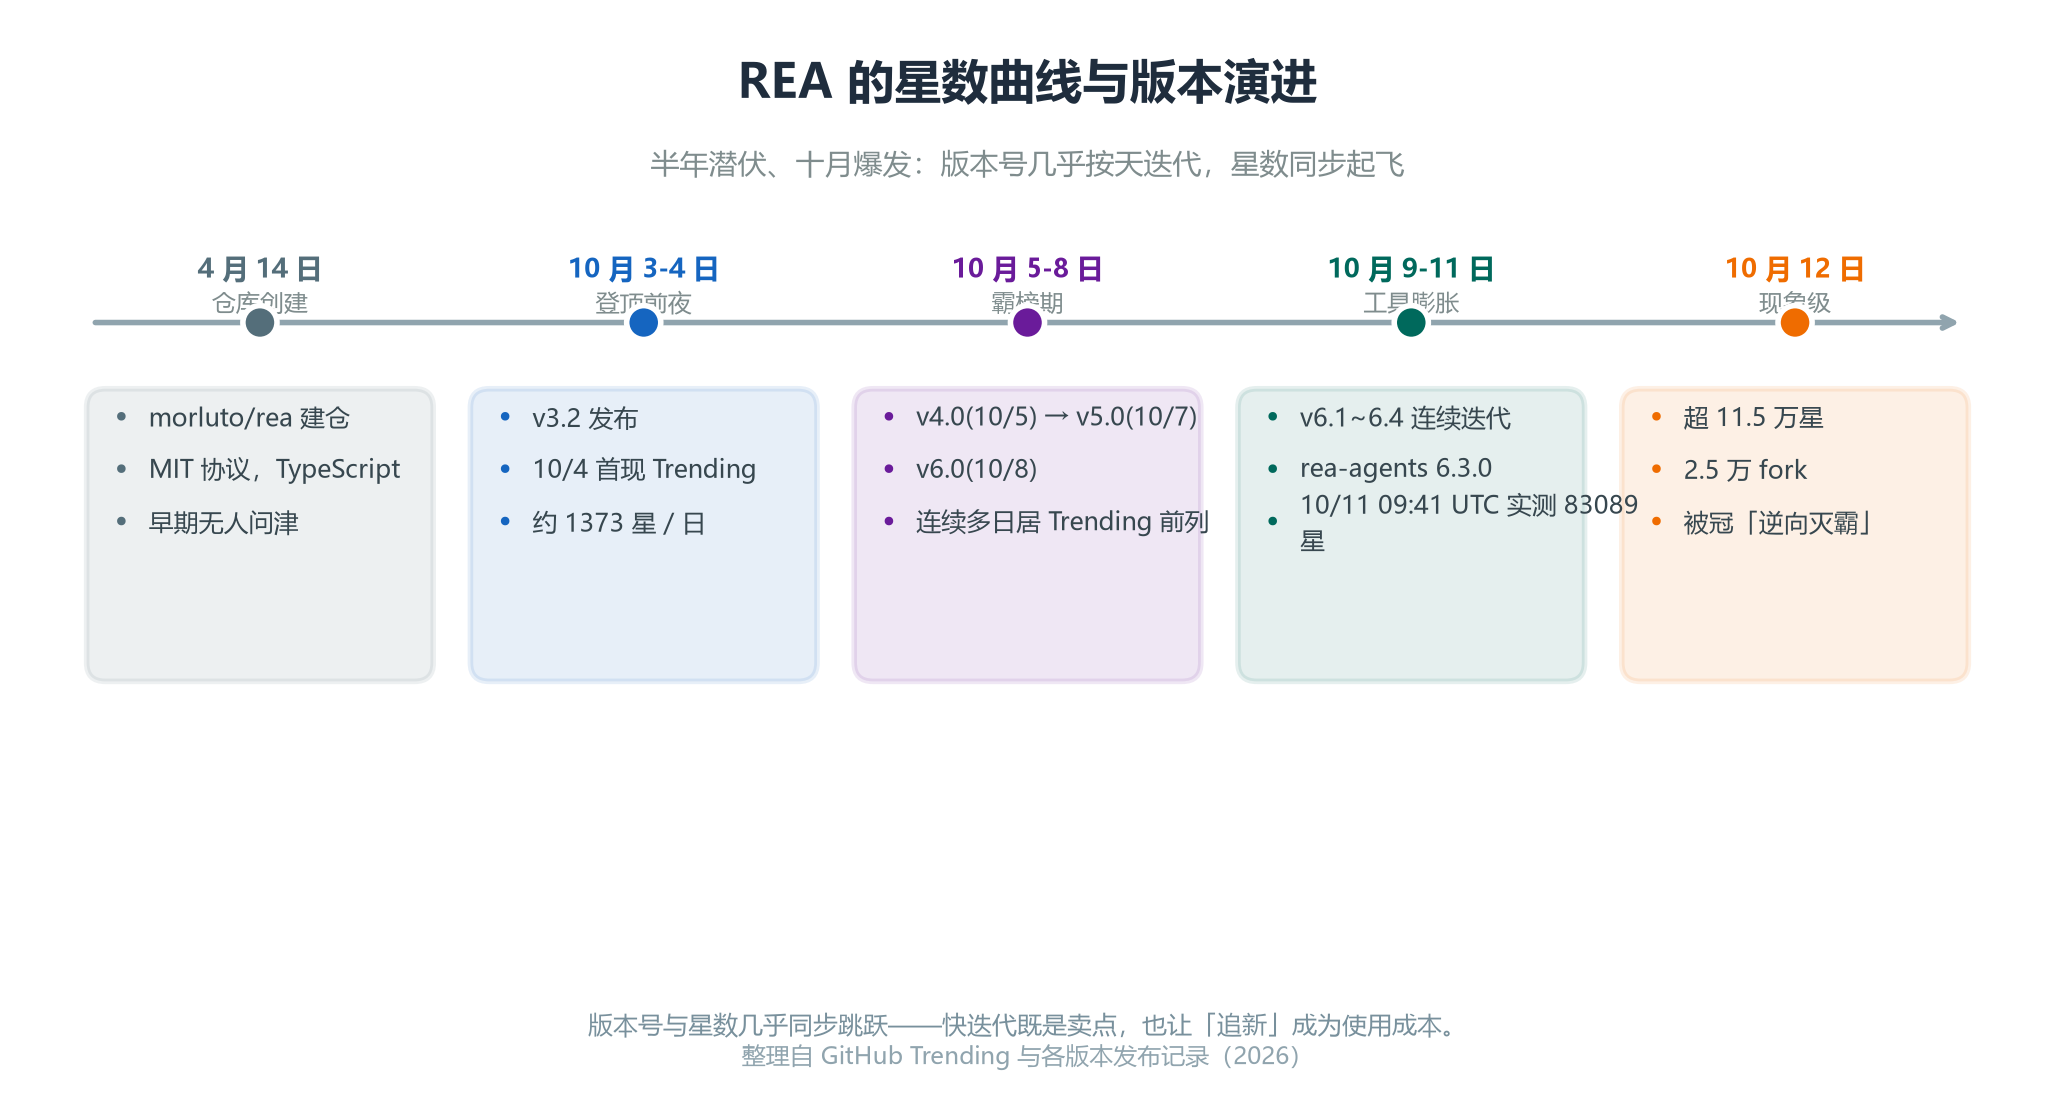
(图四:版本号与星数几乎同步跳跃,快迭代既是卖点也是追新成本)
版本号与星数同步跳跃,说明社区对它「边用边改」的节奏高度敏感。对使用者来说,这也意味着今天照着文档装好的配置,下周可能就要跟着新版本调整。
冷静视角:三个值得保留的疑问
爆火项目容易被叙事带着走,REA 有三个点建议先打问号再下结论。
其一,星数里有没有水分。前面提到 watchers 仅 0.32%、contributors 占 0.10%,且有人实测 fork 的增速在夜间异常平稳,像机器节奏。这些不等于「刷量」的定论,但足以让「11.5 万星」这个数字的含金量存疑。一个健康的爆款仓库,watchers 通常接近星数的 2%,而 REA 只有三成不到的水平;contributors 占比同样偏低。这些信号单独看都不构成结论,但叠加起来,足以提醒读者在引用星数时不要直接等同于「被广泛使用」。
其二,token 成本约束了使用场景。一次 8 文件的 Electron 分析就耗 209619 token,这意味着把 REA 当日常「随手看一眼」的工具并不经济,更适合偶发的、价值高的逆向任务,而不是高频流水线。如果把 REA 接进自动化流水线、对每个提交都跑一遍逆向校验,token 账单会非常难看;它更适合「发布前的关键版本做一次深度体检」这类低频高价值场景。
其三,法律边界要自己守住。逆向本身在很多司法辖区并不必然违法,但绕过技术保护措施、复制受版权保护的代码、或把逆向结果用于与权利人的商业竞争,都可能引发纠纷。REA 提供的是技术能力,落到具体用途上责任在使用者。
其四,不要把「能重建一致代码」误解成「能合法复制」。REA 验证的是你对程序行为的理解是否正确,而不是给你一份可以照搬的源码。理解边界和复制边界之间,差着一整条法律与伦理的线。
小结
REA 的价值不在「又训练了一个模型」,而在把零散、靠经验、不可复现的逆向工作,变成了 Agent 可调度、带出处、能留痕的工程流程。对开发者来说,它降低了「看懂一个闭源软件」的门槛;对安全与兼容场景来说,它的证据模型尤其值得参考。但 11.5 万星背后有增长真实性的疑问,token 成本也划定了它的适用边界。把它当「逆向工作的 AI 编排层」来理解,比当「万能神器」来理解更接近事实。