本篇是《MySQL 索引全解》系列的下篇。
上篇回答了"慢在哪":磁盘的机械结构 → 操作系统的 4KB 数据块 → MySQL 的 16KB 页,核心论断是"IO 的主要矛盾是次数,不是单次数据量"。中篇回答了"怎么解决":从一页数据推导出 B+ 树,验证了它为什么最优,并把聚簇索引、回表、覆盖索引、最左匹配一一讲透。
目录:
[8.1 主键索引](#8.1 主键索引)
[8.2 唯一索引](#8.2 唯一索引)
[8.3 普通索引](#8.3 普通索引)
[8.4 复合索引](#8.4 复合索引)
[8.5 全文索引](#8.5 全文索引)
[9.1 查看索引](#9.1 查看索引)
[9.2 删除索引](#9.2 删除索引)
[9.3 最容易踩的坑](#9.3 最容易踩的坑)
[10.1 四条"不要"](#10.1 四条"不要")
[10.2 一条"要"](#10.2 一条"要")
[10.3 总结](#10.3 总结)
[11.1 三层 IO 单位](#11.1 三层 IO 单位)
[11.2 磁盘核心概念](#11.2 磁盘核心概念)
[11.3 B+ 树三大特征及收益](#11.3 B+ 树三大特征及收益)
[11.4 为什么不用其他数据结构](#11.4 为什么不用其他数据结构)
[11.5 关键数字(估算)](#11.5 关键数字(估算))
[11.6 聚簇索引 vs 非聚簇索引](#11.6 聚簇索引 vs 非聚簇索引)
[11.7 索引类型总览](#11.7 索引类型总览)
[11.8 创建索引语法](#11.8 创建索引语法)
[11.9 查看与删除索引](#11.9 查看与删除索引)
[11.10 show index 关键字段](#11.10 show index 关键字段)
[11.11 高频概念](#11.11 高频概念)
[11.12 explain 关键字段](#11.12 explain 关键字段)
[11.13 索引创建原则](#11.13 索引创建原则)
八、索引怎么建:五种类型的操作
前面七章,我们把索引的原理 从头到尾走了一遍。现在终于可以来看语法了。
好消息是:理解了原理之后,这些语法会显得非常自然------因为每一条语法背后,都能对应到前面讲过的某个结构。
8.1 主键索引
主键索引有三种建法,区别只在于时机。
方式一:在创建表时,直接在字段名后指定 primary key
-- 建表的同时就把 id 定成主键
create table user1(id int primary key, name varchar(30));
方式二:在创建表的最后,指定某列或某几列为主键索引
-- 主键的定义写在所有列定义的最后
-- 注意:这种写法支持"复合主键",即用多列共同组成一个主键
create table user2(id int, name varchar(30), primary key(id));
方式三:先建表,建完以后再添加主键
-- 先建一张没有主键的表
create table user3(id int, name varchar(30));

-- 事后再给它补上主键
alter table user3 add primary key(id);
主键索引的特点:
- 一个表中,最多只能有一个主键索引(当然,可以是复合主键)
- 主键索引的效率高------因为主键不可重复,检索时能快速定位
- 创建主键索引的列,它的值不能为 NULL,且不能重复
- 主键索引的列基本都是 int 类型
8.2 唯一索引
唯一索引同样有三种建法:
方式一:在表定义时,在某列后直接指定 unique 唯一属性
-- name 列加上 unique,表示这一列的值不允许重复
create table user4(id int primary key, name varchar(30) unique);
方式二:创建表时,在表的后面指定某列或某几列为 unique
create table user5(id int primary key, name varchar(30), unique(name));方式三:先创建表,再通过 alter table 添加唯一索引
create table user6(id int primary key, name varchar(30));

-- 建表之后补加唯一约束
alter table user6 add unique(name);
唯一索引的特点:
- 一个表中,可以有多个唯一索引
- 查询效率高
- 如果在某一列建立唯一索引,必须保证这列不能有重复数据
- 如果一个唯一索引上指定了
not null,约束层面上等价于主键索引(不能讲内核中相等)
这里有个重要的认知需要澄清。
以前你可能以为"约束"和"索引"是两回事------约束归约束,索引要自己手动建。但通过前面的分析你应该已经看出来了:当我们在建表时写下 primary key 或 unique,MySQL 在底层会自动为我们创建对应的 B+ 树索引结构。
换句话说,约束本身就意味着索引。只不过你后来发现主键和唯一键不够用,可能还想给其他列也加索引,那是后话。
8.3 普通索引
方式一:在表的定义最后,指定某列为索引
create table user8(
    id int primary key,
    name varchar(20),
    email varchar(30),
    index(name)          -- 在表的定义最后,指定 name 列为索引
);
方式二:创建完表以后,用 alter table 指定某列为普通索引
create table user9(id int primary key, name varchar(20), email varchar(30));

-- 建表之后再给 name 列加普通索引
alter table user9 add index(name);
方式三:用 create index 创建,可以自定义索引名
create table user10(id int primary key, name varchar(20), email varchar(30));

-- 创建一个索引名为 idx_name 的索引,建在 name 列上
create index idx_name on user10(name);
普通索引的特点:
- 一个表中可以有多个普通索引
- 实际开发中,普通索引是用得最多的
- 如果某列需要创建索引,但是该列有重复的值,那么就应该使用普通索引
⚠️ 一个必须记住的语法细节:
很多人会写成
alter table EMP index(empno);------这是错的 ,MySQL 会直接报ERROR 1064语法错误。正确写法必须带
add:alter table EMP add index(empno);
8.4 复合索引
复合索引就是用多列共同组成一个索引,建立方式和普通索引一样,只是列写多个:
-- 方式一
alter table test1 add index(name, email);

-- 方式二:自定义索引名
create index myindex on test1(name, email);关于它的存放结构和查询规则(默认用第一列命名、最左匹配原则),前面 7.6 节已经详细讲过了,这里不再重复。
这里只强调一个删除索引时最容易踩的坑:
Key_name    = 索引的名字      → 删除索引用它
Column_name = 索引建在哪一列   → 不是它!
复合索引 (name, email) 在 show index 里会显示为两行 ,但它们的 Key_name 都是 name。所以删除时:
-- ✅ 正确:删一次就够了,删的是索引名
alter table test1 drop index name;

-- ❌ 错误:email 是列名不是索引名,这行会报错
alter table test1 drop index email;
8.5 全文索引
前面讲的几种索引,处理的对象都是短值------ID、账号、姓名。但有一类场景它们处理不了。
现实需要解决什么问题
当我们要对文章字段或大量文字的字段进行检索时,前面那套索引就不管用了。
比如博客的正文:
body text -- 每一行可能有上千甚至上万个字符这时候我们的需求不是"找到某一条记录",而是**"在这一大段文字里,有没有出现某个关键词"**。
-- 用模糊匹配找包含 database 的文章
select * from articles where body like '%database%';
能查到结果吗?能。但它不能用上索引。
我们用 explain 工具验证一下:
explain select * from articles where body like '%database%'\G

*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: articles
         type: ALL              -- 全表扫描
possible_keys: NULL
          key: NULL             -- key 为 NULL,表示没有用到索引
      key_len: NULL
          ref: NULL
         rows: 6
        Extra: Using where
type: ALL 表示全表扫描 ,key: NULL 表示没有用到任何索引。这就是全文索引要解决的问题。
它由什么构成
MySQL 提供了全文索引机制。建表时这样写:
CREATE TABLE articles (
    id INT UNSIGNED AUTO_INCREMENT NOT NULL PRIMARY KEY,
    title VARCHAR(200),      -- 文章标题
    body TEXT,               -- 文章正文,大文本
    FULLTEXT (title, body)   -- 声明这两列建立全文索引
) engine=MyISAM;
插几条测试数据:
INSERT INTO articles (title, body) VALUES
    ('MySQL Tutorial',       'DBMS stands for DataBase ...'),
    ('How To Use MySQL Well','After you went through a ...'),
    ('Optimizing MySQL',     'In this tutorial we will show ...'),
    ('1001 MySQL Tricks',    '1. Never run mysqld as root. 2. ...'),
    ('MySQL vs. YourSQL',    'In the following database comparison ...'),
    ('MySQL Security',       'When configured properly, MySQL ...');
怎么用它
全文索引不能 用普通的 where ... like 来触发,它有专门的语法 MATCH ... AGAINST:
SELECT * FROM articles
WHERE MATCH (title, body) AGAINST ('database');

+----+-------------------+------------------------------------------+
| id | title             | body                                     |
+----+-------------------+------------------------------------------+
|  5 | MySQL vs. YourSQL | In the following database comparison ... |
|  1 | MySQL Tutorial    | DBMS stands for DataBase ...             |
+----+-------------------+------------------------------------------+
这次用上索引了吗?看执行计划:
explain SELECT * FROM articles WHERE MATCH (title,body) AGAINST ('database')\G

*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: articles
         type: fulltext          -- 变了!不再是 ALL
possible_keys: title
          key: title             -- key 用到了 title
      key_len: 0
          ref:
         rows: 1
        Extra: Using where
type 从 ALL 变成了 fulltext,key 从 NULL 变成了 title。索引用上了。
⚠️ 重要约束 :
MATCH()里写的列,必须和FULLTEXT()定义时的列完全一致。
它的原理和限制
全文索引和我们前面讲的 B+ 树是两套完全不同的体系。它不是按"列的值"建树,而是:
- 对文本内容做分词,把一篇文章切成一个个词
- 建立倒排索引,记录"某个词 → 出现在哪些文档中"

belike 👇:
正向索引(正常顺序)
- Doc1 → "MySQL","索引"
- Doc2 → "B + 树","原理"
- Doc3 → "MySQL","优化"
倒排索引
- MySQL → Doc1, Doc3
- 索引 → Doc1
- B + 树 → Doc2
- 原理 → Doc2
- 优化 → Doc3
最后说几个必须知道的限制:
- 存储引擎限制(历史) :早期版本中,全文索引要求表的存储引擎必须是 MyISAM,InnoDB 不支持。
- 语言限制 :默认的全文索引基于空格分词,只支持英文,不支持中文。如果要对中文做全文检索,传统做法是使用 Sphinx 的中文版(Coreseek)等外部工具。
- 现代版本补充 :MySQL 5.6 起 InnoDB 也支持了全文索引 ;MySQL 5.7.6+ 内置了 ngram 解析器,可以支持中文分词。请以你的实际版本为准。
九、索引的查看与删除
9.1 查看索引
有三种查看方式,信息量和便利性各不相同。
方法一:show keys from 表名
show keys from goods\G (携带\G不用加";"了哦)

*************************** 1. row ***************************
        Table: goods
   Non_unique: 0              -- 0 表示唯一索引
     Key_name: PRIMARY        -- 索引名:主键索引
 Seq_in_index: 1
  Column_name: goods_id       -- 索引建在哪一列
   Collation: A
 Cardinality: 0
    Sub_part: NULL
      Packed: NULL
        Null:
  Index_type: BTREE           -- 索引的组织结构
     Comment:
Index_comment:
1 row in set (0.00 sec)输出字段比较多,但对我们真正有用的其实只有四个。这里逐个说明它们在回答什么问题:
Non_unique:这个索引允许重复吗 ?0表示唯一索引(不允许重复),1表示允许重复Key_name:索引叫什么名字?(删除索引时用的就是它)Column_name:索引建在哪一列上?Index_type:索引用什么结构组织?
方法二:show index from 表名
show index from test1; 输出格式和 show keys from 完全一致。这两个命令是等价的,用哪个都行。
顺带解释一个你可能疑惑的点:为什么输出里的字段叫 Key_name 而不是 Index_name?因为在 MySQL 内部,统一使用 KEY 这个词 来描述索引。所以 show keys 和 show index 是一回事。
方法三:desc 表名(信息最简略)
desc test1;

+-------+-------------+------+-----+---------+-------+
| Field | Type        | Null | Key | Default | Extra |
+-------+-------------+------+-----+---------+-------+
| id    | int(11)     | NO   | PRI | NULL    |       |
| name  | varchar(20) | NO   | UNI | NULL    |       |
| email | varchar(30) | YES  |     | NULL    |       |
+-------+-------------+------+-----+---------+-------+
3 rows in set (0.00 sec)
Key 列的几个标记含义:
PRI:主键索引UNI:唯一索引MUL:普通索引(值可以重复)
这种方式最方便,但信息也最少------只能看到"有没有索引、是什么类型",看不到索引名。
9.2 删除索引
删除索引分两种情况,这个区别很重要。
删除主键索引:
alter table 表名 drop primary key;

-- 举例
alter table test1 drop primary key;
注意:删除主键索引不需要指定索引名。 因为一个表只有一个主键,直接 drop primary key 就行,不会有歧义。
删除其他索引:
-- 方式一
alter table 表名 drop index 索引名;

-- 方式二
drop index 索引名 on 表名;

-- 举例
alter table user10 drop index idx_name;
drop index name on user8;这两种方式效果一样,都必须指定索引名。
9.3 最容易踩的坑
这里有一个非常容易犯错的地方,值得单独拎出来说。
"索引名"指的是
show keys from 表名输出里的Key_name字段,不是列名(Column_name)!
这两者不一定相同:
- 用
create index idx_name on t(name)创建 → 索引名是idx_name,列名是name - 用
alter table t add index(name)创建 → 索引名默认取列名name - 用复合索引
(name, email)创建 → 索引名默认取第一列name
还有一个经典的错误写法------很多人想删唯一索引时会这么写:
-- ❌ 错误:MySQL 根本没有 drop unique 这种语法
alter table test1 drop unique name;
为什么会错? 因为------唯一索引本质上就是一个普通索引。
回顾一下 show index from 的输出就会发现,唯一索引和普通索引唯一的区别只在 Non_unique 这个字段(0 或 1),底层的 B+ 树结构是完全一样的。
所以规律是:
创建时可以写:add unique(name)   ← 这是在建立"约束"
删除时必须写:drop index 索引名   ← 这是在删除"索引"
🎯 关键认知 :唯一索引和普通索引,本质上是完全一样的,都是普通索引。 我们说"唯一",只是在语法上额外强调了那一列的唯一性约束而已。
一句话记忆:
主键索引很特殊 ------建的时候
add primary key,删的时候drop primary key; 其他所有索引都一样 ------建的时候add index/add unique,删的时候统一drop index 索引名。
十、索引的创建原则:什么样的列才配拥有索引
现在你会建索引了,但还有个更重要的问题:该给哪些列建索引?
索引不是越多越好。建错了不仅不能提速,还会白白拖慢写入、浪费空间。这一章把判断标准讲清楚。
10.1 四条"不要"
第一条:唯一性太差的字段,不适合单独创建索引,即使它频繁作为查询条件。
什么叫"唯一性太差"?就是这一列的取值种类特别少。典型例子是"性别"------只有"男"和"女"两个值。
给它建 B+ 树会怎样?树的第一个分支就只有"男"和"女"两个选项,查找时一次只能淘汰掉大约一半的数据,和全表扫描几乎没有区别。
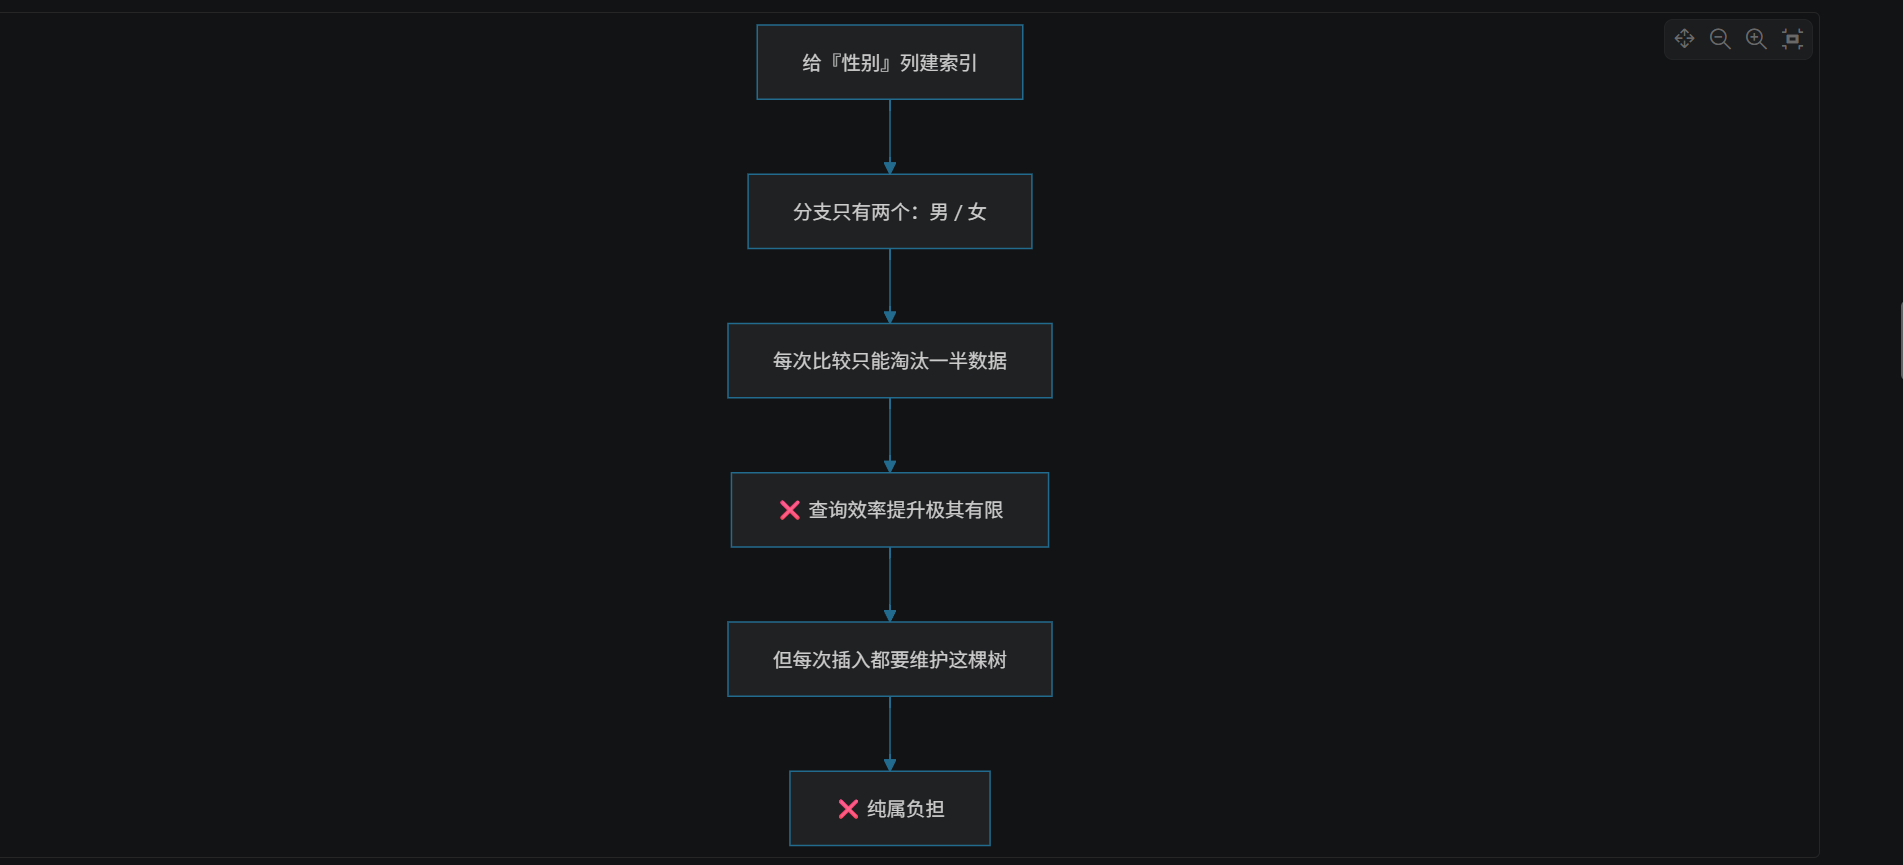
更糟的是,每次插入数据都要维护这棵几乎没用的树------查询没快多少,写入反而变慢了。
第二条:更新非常频繁的字段,不适合创建索引。
比如:考试成绩、登录状态、最近在线时间......
为什么?因为每次修改这一列的值,对应的 B+ 树都要重新调整。你为了查询快建了索引,结果写入被拖慢了,而这类字段的查询收益本身就不稳定。
注意,这里不是说这个字段永远不能改,而是说改得太频繁了,建索引不划算。
第三条:不会出现在 where 子句中的字段,不该创建索引。
一个字段永远不会被当作筛选条件,那给它建索引就是纯粹的浪费------只有成本,没有收益。
第四条:唯一性太差的字段不适合单独建索引(重复强调)。
这条和第一条是同一个道理。之所以单列出来,是因为它是实际工作中最容易犯的错误。
10.2 一条"要"
反过来讲就清楚了:
比较频繁作为查询条件的字段,应该创建索引。
10.3 总结
把上面四条"不要"和一条"要"揉在一起,就是一整套判断标准:
高频被读取、高频在
where语句中出现、唯一性非常好、低频被修改的列,才适合创建索引。
再换一个角度理解这句话:
索引是为"查"服务的。查得多、改得少、区分度高,才是索引的好朋友。
十一、知识速查表
11.1 三层 IO 单位
| 层级 | 基本单位 | 说明 |
|---|---|---|
| 磁盘硬件 | 512 字节 | 扇区 Sector,物理读写的最小单位 |
| 操作系统 | 4 KB | 数据块 Block,与内存页框对齐 |
| MySQL InnoDB | 16 KB | page(页),可通过 innodb_page_size 查看 |
11.2 磁盘核心概念
| 概念 | 含义 |
|---|---|
| 盘片 Platter | 数据载体,每片双面可读写 |
| 磁头 Head | 与盘面 1 对 1,选中磁头即选中盘面 |
| 磁道 Track | 盘片上的同心圆 |
| 柱面 Cylinder | 各盘片同半径磁道叠成,与磁道等价 |
| 扇区 Sector | 磁道沿半径切分的小段,默认 512 字节 |
| CHS 寻址 | 磁头号 + 柱面号 + 扇区号,硬件使用 |
| LBA | 逻辑块地址,线性编号,系统软件使用 |
| 连续访问 | 本次扇区地址紧接上次,磁头几乎不动,快 |
| 随机访问 | 本次扇区地址与上次相差很大,慢 |
11.3 B+ 树三大特征及收益
| 特征 | 带来的收益 |
|---|---|
| 非叶子节点只存目录项,不存数据 | 单节点能存更多 key → 树更矮 → 经过节点更少 → IO 次数更少 |
| 叶子节点全部用链表相连 | 找到起点后顺序遍历 → 范围查找极快 |
| 节点内部有序 | 可建立页目录 → 从线性查找变为目录定位 |
11.4 为什么不用其他数据结构
| 数据结构 | 结论 | 致命问题 |
|---|---|---|
| 链表 | ❌ | 线性遍历,太慢 |
| 二叉搜索树 | ❌ | 会退化,可能退化成线性结构 |
| AVL / 红黑树 | ❌ | 平衡但"瘦高",层高远超多叉树,IO 次数多 |
| Hash | ❌(仅限等值场景) | 范围查找无能为力 |
| B 树 | ❌ | 非叶子节点存数据 → 树更高;叶子节点不相连 → 范围查找难 |
| B+ 树 | ✅ | --- |
11.5 聚簇索引 vs 非聚簇索引
| 对比项 | InnoDB(聚簇索引) | MyISAM(非聚簇索引) |
|---|---|---|
| 索引与数据 | 放在一起 | 分离 |
| 主键索引叶子节点存放 | 完整行数据 | 数据记录的地址 |
| 辅助索引叶子节点存放 | 主键值(需回表) | 数据记录的地址(无需回表) |
| 磁盘文件 | .frm + .ibd |
.frm + .MYD + .MYI |
| 事务支持 | ✅ 支持 | ❌ 不支持 |
| MySQL 默认引擎 | ✅ 是 | 否 |
11.6 索引类型总览
| 索引类型 | 数量限制 | 值可重复 | 值可为 NULL | 典型场景 |
|---|---|---|---|---|
| 主键索引 | 每表最多 1 个(可为复合) | ❌ | ❌ | 唯一标识一行 |
| 唯一索引 | 多个 | ❌ | ✅(加 NOT NULL 则等价主键) | 邮箱、身份证号 |
| 普通索引 | 多个 | ✅ | ✅ | 姓名、状态(最常用) |
| 复合索引 | 多个 | 视定义而定 | 视定义而定 | 多列联合查询 |
| 全文索引 | 多个 | --- | --- | 大文本关键词检索 |
11.9 创建索引语法
| 索引类型 | 建表时 | 建表后 |
|---|---|---|
| 主键索引 | primary key 跟在列后,或写在表末尾 primary key(id) |
alter table t add primary key(id); |
| 唯一索引 | unique 跟在列后,或表末尾 unique(name) |
alter table t add unique(name); |
| 普通索引 | 表末尾 index(name) |
alter table t add index(name); create index idx_name on t(name); |
| 复合索引 | 表末尾 index(name, email) |
alter table t add index(name, email); create index idx_name on t(name, email); |
| 全文索引 | 表末尾 fulltext(title, body) |
alter table t add fulltext(title, body); |
⚠️
alter table 表名 index(列名);是错误语法 ,会报ERROR 1064。必须加add。
11.10 查看与删除索引
| 操作 | 语法 |
|---|---|
| 查看索引① | show keys from 表名;(加 \G 竖排更易读) |
| 查看索引② | show index from 表名;(与①完全等价) |
| 查看索引③ | desc 表名;(信息最简) |
| 删除主键索引 | alter table 表名 drop primary key;(无需索引名) |
| 删除其他索引 | alter table 表名 drop index 索引名; |
| 删除其他索引 | drop index 索引名 on 表名; |
| ❌ 错误写法 | alter table t drop unique name;(无此语法) |
11.11 show index 关键字段
| 字段 | 回答的问题 |
|---|---|
Non_unique |
这个索引允许重复吗?0 = 唯一,1 = 可重复 |
Key_name |
索引叫什么名字?(删除索引用它) |
Column_name |
索引建在哪一列上? |
Seq_in_index |
在复合索引中是第几列?(从 1 开始) |
Index_type |
用什么结构组织?BTREE = B+ 树 ,FULLTEXT = 全文索引 |
📌
BTREE指 B+ 树,不是"二叉树"。B+ 树是多叉树。
11.12 高频概念
| 概念 | 定义 |
|---|---|
| 回表查询 | 用辅助索引找到主键值,再用主键值到主键索引中检索,拿到完整记录。需查两棵树 |
| 索引覆盖 | 查询所需字段全部能从索引中获取,无需回表 |
| 最左匹配原则 | 复合索引查找时,必须从最左侧的列开始向后匹配,不能跳过 |
| 聚簇索引 | 索引和数据放在一起(InnoDB) |
| 非聚簇索引 | 索引和数据分离(MyISAM) |
| 页目录 | 页内用于快速定位的结构,存放「最小键值 + 偏移量」 |
| 局部性原理 | 程序访问数据时大概率还会访问其周边数据,是预加载生效的前提 |
11.13 explain 关键字段
| 字段 | 含义 |
|---|---|
id |
查询序号,一般越大越先执行 |
select_type |
查询类型,SIMPLE = 简单查询 |
table |
正在查的表 |
type |
访问方式。ALL = 全表扫描;fulltext = 全文索引;ref / range / const 为更优方式 |
possible_keys |
可能用到的索引 |
key |
实际用到的索引 ,NULL 表示没用上任何索引 |
rows |
预估扫描行数 |
11.14 索引创建原则
| 判断项 | 结论 |
|---|---|
| 频繁作为查询条件 | ✅ 应该建 |
| 唯一性太差(如性别) | ❌ 不适合单独建 |
| 更新非常频繁 | ❌ 不适合建 |
不出现在 where 中 |
❌ 不该建 |
🎯 一句话 :高频被读取 + 高频在
where中出现 + 唯一性非常好 + 低频被修改。
十二、收尾:整条故事线回顾
我们从一个 5.43 秒的查询出发,一路挖到了磁盘的扇区。现在,把这条线索完整地串一遍。
现象:800 万行查一条记录要 5.43 秒
问题:时间花在哪了?
**第 1 层:**磁盘 机械装置,寻道 + 旋转是主要开销
发现:IO 的主要矛盾是『次数』,不是『单次数据量』
**第 2 层:**操作系统 用 4KB 数据块,靠局部性原理预加载
启发:单位做大 → 次数减少
**第 3 层:**MySQL 用 16KB 的 page,配 128MB Buffer Pool
共识:减少 IO 次数 = 提高效率
**第 4 层:**索引结构
排序,为了引入页目录
页目录,解决单页内线性查找
页目录分级,解决多页间线性遍历
递归下去 ------ 这就是 B+ 树
**验证:**为什么不是链表/二叉树/AVL/Hash/B树
**落点:**聚簇 vs 非聚簇、回表、覆盖索引、最左匹配
**结果:**5.43 秒 → 0.00 秒
你会发现,B+ 树的每一个设计特征,都能对应到一个具体的现实约束:
- 为什么非叶子节点不存数据?------ 为了让树更矮,IO 更少
- 为什么叶子节点要连成链表?------ 为了让范围查找不必反复回到根
- 为什么数据要按主键排序?------ 为了能建立页目录
- 为什么要一整页一整页地读?------ 因为 IO 的主要矛盾是次数
这些设计没有一个是"拍脑袋"想出来的,全部是被逼出来的。
最后提醒一句:索引不是万能的。 在面对复杂生产场景时,还有分表、分库、读写分离等手段。但索引是成本最低、收益最高 的那一个------不用改代码、不用改架构,只要一条 create index 语句,就能让查询速度提升成百上千倍。
前提是:你要理解它,才能用对它。