摘要:在机载、雷达、光电侦察等加固嵌入式场景,经常会遇到两类强需求:①多 GPU 大算力 AI 推理;②超大规模 FPGA 实时信号预处理。本文结合两套 6U‑VPX 工程硬件方案,梳理硬件架构设计要点、接口资源、以及实际项目落地过程中的取舍问题,供做 VPX 信号处理方案选型参考。
一、双 AGX Orin GPU 计算板(VPX322)方案
1、硬件架构概述
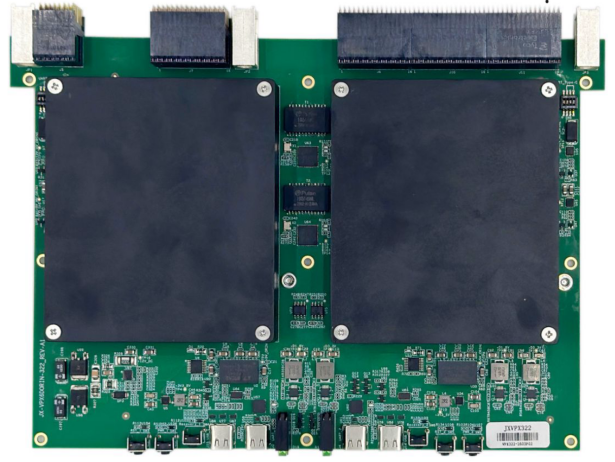
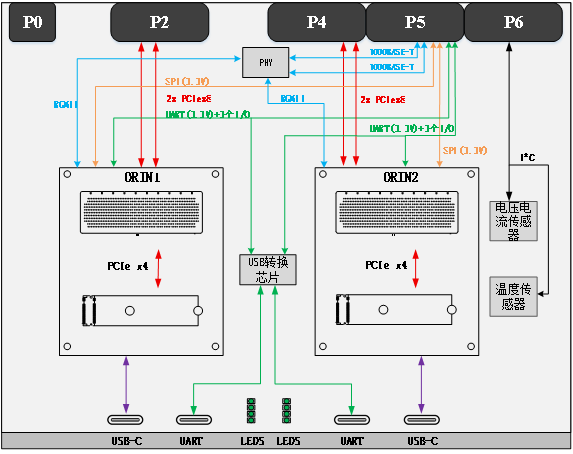
这是一款标准 6U‑VPX(VITA65)加固 GPU 计算板,板卡搭载两片 NVIDIA Jetson AGX Orin 模组,面向边缘端多模态 AI 推理、目标检测识别场景,支持风冷 / 导冷两种散热形态,满足‑40℃~+85℃宽温工作条件,适配军工加固整机环境。
算力配置分为两档:
- 32GB 内存版本:单模块 200TOPS(INT8)AI 算力,单模块 32GB LPDDR5;
- 64GB 内存版本:单模块 275TOPS(INT8)AI 算力,单模块 64GB LPDDR5; 整机最大合计算力可达 550TOPS INT8。
2、关键接口与 VPX 背板互联设计
板卡对外通过 VPX 接插件引出高速与低速信号,核心资源:
- 高速互联:P2、P4 分别引出两路 PCIe4.0 x8,可与背板上 FPGA 处理板、交换板做高速数据交互;
- 存储:板载 M.2 插槽,支持 2280/2230 规格 SSD,用于推理模型、原始数据本地存储;
- 低速外设:板卡引出千兆以太网、UART 调试口、SPI 信号到 P5;P6 输出电压、电流、温度监测信号,可供整机 IPMC 管理单元采集;
- 本地调试:板卡面板预留 Type‑C 的 UART 调试口、USB 接口,搭配开机、复位、强制恢复按键,方便板卡独立调试与系统排错。
供电输入为 VPX 标准 + 12V@10A,板卡物理尺寸为标准 6U VPX:160mm×233.35mm。
3、方案适用边界与短板(工程踩坑)
✅适合场景:机载光电、多源感知数据的 AI 推理,需要单槽位提供双 Orin 算力,背板 PCIe4.0 做数据输入输出。 ⚠️局限:
- GPU 模组为进口器件,型号项目需要提前评估器件供应链风险,做好备选方案;
- 板卡本身没有大规模 FPGA 逻辑资源,原始信号预处理、高速 AD 采集需要依靠背板对接外部 FPGA 板卡完成;
- 整机功耗较高,做导冷设计时,冷板散热能力、槽位功耗分配需要在机箱方案阶段提前核算。
二、双 VU13P FPGA 实时信号处理板(VPX323)方案
1、硬件架构概述
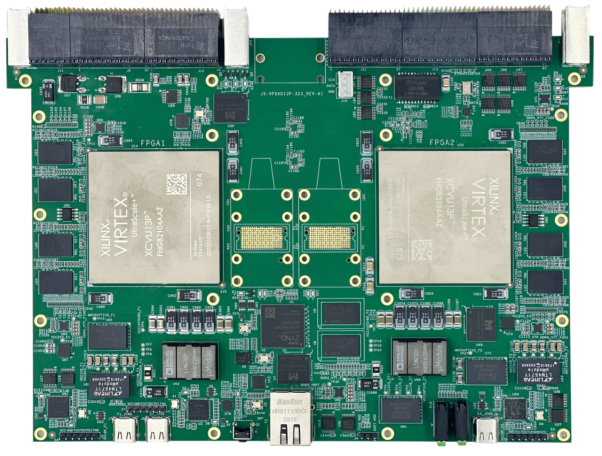
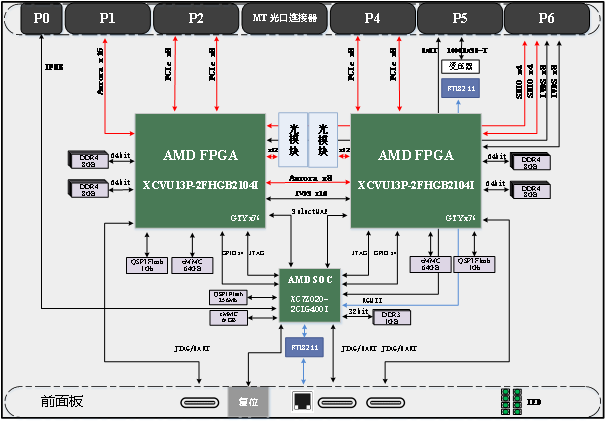
该 6U‑VPX 板卡采用双 XCVU13P(VU13P)大规模 FPGA + XC7Z020 管理 SoC三级架构,主打雷达基带处理、宽带射频信号实时运算、高速光数据转发场景,同样支持风冷、导冷,‑40℃~+85℃宽温工作环境。
- 两片主 FPGA:每片配备独立 8GB DDR4(64bit,2400MT/s)、1Gb QSPI Flash、64GB eMMC 非易失存储;
- 辅助 SoC XC7Z020:负责板卡管理、调试、网口控制,自带 1GB DDR3、64GB eMMC;
- FPGA 之间板内通过 GTY x8 高速 Serdes + LVDS x16 实现芯片间高速数据交互;FPGA 与 Zynq‑7020 之间使用 SelectMAP+GPIO 完成控制交互。
2、VPX 背板接口资源
板卡把高速光口、PCIe、SRIO、Aurora 全部引到 VPX 连接器,方便整机组网:
- P1:Aurora x16 高速串行接口接 FPGA1;
- P2/P4:分别引出两组 PCIe3.0 x8,分别连接两片 VU13P,用于对接背板 GPU 板或者主机;
- P3:引出两组 12 通道 25G 光收发,用于高速原始雷达数据输入输出;
- P6:引出 SRIO x4、LVDS x8,分别接入两片 FPGA,适合传统雷达系统 SRIO 组网;
- P5:千兆网、UART 低速调试接口接入管理 SoC;
- 面板本地调试:两路 Type‑C JTAG、UART 调试口,方便独立逻辑开发调试。
供电 + 12V@10A,标准 6U 尺寸 160mm×233.35mm。
3、方案适用边界与短板
✅适合场景:大带宽雷达信号预处理、多通道基带运算、25G 光口高速数据流转发,需要两片超大规模 FPGA 并行处理。 ⚠️局限:
- VU13P 属于进口高端 FPGA,国产化型号项目要评估替代方案(复旦微 JFM7VX690T);
- Zynq7020 仅作为管理辅助 SOC,不适合跑大型业务软件;
- 板内 GTY 通道资源消耗大,做逻辑开发时,Serdes 时序约束、信号完整性调试工作量大。
三、两种硬件方案选型对比总结
表格
| 项目 | VPX322(双 AGX Orin) | VPX323(双 VU13P) |
|---|---|---|
| 核心算力载体 | 双 GPU,擅长 AI 推理 | 双超大 FPGA,擅长实时信号处理 |
| 核心优势 | 单槽位高 INT8 推理算力,软件生态成熟 | 并行实时信号处理、25G 光口大带宽数据流处理 |
| 主要短板 | 无 FPGA 预处理资源;进口器件风险 | AI 推理能力弱;Serdes 时序调试复杂 |
| 典型用法 | 接收预处理之后的数据做 AI 识别 | 原始射频 / 光信号实时处理,输出处理后数据给 GPU 板 |
工程实践建议:
- 很多雷达光电项目会把这两类板卡同时部署在同一套 VPX 机箱:VPX323 做前端原始信号的滤波、FFT 预处理;通过背板 PCIe 把处理完的数据送到 VPX322 完成 AI 目标识别;
- 预研阶段可以使用上述进口芯片原型平台开展算法验证;装备定型阶段,需要同步开展国产化替代评估;
- 导冷 VPX 设计中,无论 GPU 板还是多 FPGA 板,功耗、冷板热阻、槽位功耗分配,必须在原理图阶段和机箱结构协同设计,后期改动成本极高。