题目**:**Vision--Language--Action Models Meet World Models: Embodied Agentic AI for Low-Altitude Wireless Networks
作者:江沸菠,董莉,毛磊,王可之,潘存华,Dong In Kim,and Naofal Al-Dhahir
来源:Arxiv
论文地址:https://arxiv.org/abs/2606.11618(查看全文请点击原文链接)
摘要: 低空无线网络(LAWNs)由无人机(UAVs)及其他空中平台构成,在低空空域提供感知、通信与计算一体化服务。然而,在该领域部署大型生成式模型面临三大挑战:1)具身动作映射能力有限;2)物理环境建模不足;3)闭环优化不充分。为应对上述挑战,本文提出一种具身智能体无人机框架。该框架以视觉--语言--动作(VLA)模型为执行核心,构建了从多模态环境感知到连续控制生成的端到端具身决策流程。此外,引入世界模型(WM),用于刻画无人机动作与环境状态演化之间的耦合关系,从而支持环境预测、策略验证与动态优化。进一步地,引入记忆与反思机制,构建由决策、执行、评估与更新构成的自适应闭环优化范式,从而增强系统在复杂动态环境中的自主决策能力与持续进化能力。实验结果验证了该方法在低空无线网络中实现鲁棒、可预测且可持续的自主控制的有效性。
1. 引言
低空无线网络(LAWNs)是指运行于数百米以下空域的空天地一体化通信系统,其中无人机(UAVs)等空中平台提供通信、感知与计算服务。依托快速部署与高度可重构能力,LAWNs能够在基础设施受限或突发业务场景中实现按需连接,已成为低空经济与空天地融合系统的重要支撑技术。然而,空中节点的三维机动性使网络拓扑呈现快速时变特性,同时空地信道高度动态,易受遮挡与干扰影响。此外,通信、感知与控制过程高度耦合,并受到飞行安全、机载算力以及有限电池能量的严格约束,这使得系统必须在动态不确定环境中具备自主智能决策能力。
近年来,大语言模型(LLMs)与视觉语言模型(VLMs)在语义理解与跨模态推理方面展现出显著能力。以自然语言为中心,LLMs能够实现高层任务意图理解、任务分解与约束表达,为复杂系统提供面向目标的推理与决策支持。VLMs进一步将语言语义与环境感知对齐,形成语义结构化的场景表示,并与无线物理状态融合,从而为决策提供更全面的信息基础并提升可解释性。在LAWNs中,由于网络拓扑与信道条件快速变化,基于LLM/VLM的认知模块在任务对齐与可解释推理方面具有明显优势。然而,这类方法通常缺乏对"动作--环境动力学"的显式建模,从而在LAWNs应用中面临如下挑战:
1)具身动作映射能力有限: 现有基于LLM/VLM的方法主要侧重语义理解与高层策略生成,但缺乏将任务目标与多模态观测直接映射为可执行控制动作的端到端机制。在LAWNs中,在线决策需同时满足飞行动力学约束、避障约束以及多重任务约束。若缺乏具身动作接口,模型输出难以转化为标准化参数形式,也难以有效映射至可行解空间并通过严格约束验证,从而显著削弱系统的可部署性、可控性与闭环稳定性。
2)物理环境建模不足: LAWNs中的在线决策依赖于与物理环境的持续交互及其演化动力学的准确建模。尽管VLMs能够提供视觉--语义层面的场景理解能力,但其缺乏统一的表示机制与跨模态对齐能力,难以联合建模无线物理量与网络状态。因此,系统难以在轨迹优化与网络演化过程中,将视觉语义与遮挡、多径效应、能量约束及动态业务负载等关键因素建立稳定关联,进而削弱其在高度动态环境中的可预测性、泛化能力与决策可靠性
3)闭环优化机制不足: LAWNs需要在动态环境中进行持续决策,其中轨迹规划与资源分配决策会对能耗与任务性能产生长期影响。然而,现有基于LLM/VLM的方法多局限于单步或阶段式决策,缺乏跨"规划---执行---反馈---优化"循环的持续优化机制。此外,其决策过程通常缺乏可解释性与一致性的风险评估机制,从而制约了长期稳定优化与系统可靠运行。
为应对上述挑战,本文将VLA与世界模型(WM)相结合,提出一种面向LAWNs的具身智能体无人机框架(Embodied Agentic UAV framework)。主要贡献总结如下:
1)VLA视角: 提出一种面向LAWNs的可执行控制模块,在端到端控制框架中统一多模态感知、语言理解与动作生成。模型首先将来自LAWNs环境的多模态感知信息编码为共享状态表示,并将任务目标作为条件信号注入,使高层语义意图能够直接影响无人机动作生成。不同于生成抽象策略或离散决策,该VLA模块直接解码为描述无人机机动行为的连续低维动作向量,并与飞行控制接口对齐,从而构建由语义目标驱动的实时控制闭环。
2)世界模型视角: 进一步引入面向LAWNs的世界模型。该模型基于多模态连续观测学习视觉世界表征,以保持长期视频一致性与空间记忆。通过显式引入飞行动作作为驱动变量,建模无人机控制输入对环境状态演化的影响关系。通过学习条件于动作的世界状态连续动力学,世界模型能够实现对无人机飞行过程的持续内部仿真与趋势预测,从而形成一种交互式、可预测的环境抽象,为离线策略学习与在线优化提供稳定且可泛化的物理世界表示。
3)智能体系统视角: 构建面向LAWNs的具身智能体系统。VLA模块作为动作执行主体,在记忆模块支持下生成可执行动作;记忆模块从相似历史场景中检索有效策略与风险边界,以指导当前决策;反思模块在世界模型预测支持下对执行结果进行评估,并将关键经验与因果解释以结构化形式写回记忆,同时持续更新其有效性与置信度。通过"VLA决策 → 执行 → WM评估 → 记忆更新"的闭环机制,实现系统的持续自适应优化。
本文其余部分结构如下:第二部分综述从感知到动作的发展演进;第三部分介绍语言、视觉与世界建模的融合方法;第四部分讨论从人工智能智能体到具身智能体AI的演进路径;第五部分提出所设计的具身智能体无人机框架;第六部分给出实验结果;第七部分讨论开放问题;第八部分总结全文。
2. 从VLM到VLN再到VLA:从感知到动作的演进
2.1 面向多模态语义感知的VLM
在LAWNs中,VLMs作为多模态语义感知与场景理解的核心模块,其主要作用是将无人机视角下的图像或视频数据、地理环境信息以及任务描述映射至统一的语义空间。通过跨模态对齐机制,VLMs能够生成结构化且具可解释性的环境表示,使系统能够从语义层面对场景组成、任务需求以及潜在约束进行建模。这类表示为网络部署决策与资源管理提供了认知层输入。更为重要的是,VLMs显著增强了复杂场景下的环境理解能力,并提升了跨场景知识迁移与泛化能力,从而支持在多样化低空任务环境中的稳定应用。
2.2 面向目标驱动空间导航的VLN
在语义理解的基础上,视觉语言导航模型(VLN)进一步引入空间决策能力,通过将任务目标与视觉或地图感知信息联合映射为导航策略,实现从语义任务到空间路径规划的转换。在LAWNs场景中,该能力天然适用于无人机部署与轨迹规划任务,使高层任务需求能够转化为可执行的导航策略,并支持任务执行过程中的动态调整。与主要侧重环境语义理解的VLM相比,VLN实现了从"理解环境"到"生成可执行空间行为"的关键转变。此外,VLN能够将通信性能与资源消耗等因素纳入导航决策过程,从而形成一种联合考虑任务目标、安全性、覆盖质量、链路可靠性与能量效率的综合优化部署策略。
2.3 面向端到端动作生成的VLA
VLA进一步将该范式从理解与导航扩展至完全可执行的端到端动作生成,使无人机运动控制指令能够被直接生成。通过在统一框架下联合建模视觉感知、任务目标与动作生成,VLA有效应对LAWNs在线决策中通信、控制与安全高度耦合的需求。因此,高层语义目标能够被转化为可执行控制信号,从而提升系统的实时响应能力与闭环控制效率。与主要关注位置级与轨迹级决策的VLN相比,VLA提供了更加完整的动作空间,其输出更贴近执行接口,并具备更强的闭环控制能力。这些优势使其成为LAWNs中实现自主控制与优化的重要基础。
综上所述,VLMs、VLN与VLA共同构成了LAWNs中智能能力的渐进式演化路径,即从语义理解到可执行动作生成的演进过程。VLMs提供语义感知与态势理解能力,VLN实现目标驱动的导航与部署,而VLA进一步支持可执行控制与在线闭环优化。三者共同构成具身智能处理流水线,为实现自主、鲁棒的低空无线网络系统奠定基础。
****3.从语言与视觉到世界模型:迈向统一智能
在LAWNs的智能演进过程中,语言模型( LMs)、视觉模型(VMs)与世界模型分别对应语义推理、环境感知与动态预测三类基础能力,共同构成一个逐级演进的统一框架,使网络智能从静态认知逐步迈向具身自治。
3.1 语言模型:任务理解与语义表示
在LAWNs中,语言模型的核心价值在于其自然语言理解与抽象推理能力,使系统能够解析高层任务描述,并将其转化为结构化意图、运行约束以及优化目标。相较于传统依赖预定义规则或显式解析模型的网络控制方法,语言模型通过从大规模语料中学习得到的知识与策略模式,支持在复杂任务场景下的任务分解、优先级组织与决策逻辑构建。因此,网络智能从传统的参数级调节逐步演进为面向目标的语义级决策。然而,该类能力仍主要局限于符号推理与静态决策过程,缺乏对环境动态变化的直接感知能力,也缺乏对动作后果的显式建模机制。
3.2 视觉模型:物理世界感知与场景理解
在语言模型语义推理能力的基础上,视觉模型为LAWNs引入了对物理环境的具身感知能力。通过视觉观测,无人机节点能够获取环境结构与运行语境,从而弥补仅依赖无线测量或先验规则方法在状态信息表达上的不足。视觉感知能力使得系统能够构建具有物理一致性的状态表示,为信号覆盖优化、轨迹调整与安全控制提供更为可靠的环境参照。然而,视觉模型的输出主要聚焦于对当前场景的解释,其本质仍属于"观测理解"范畴,难以刻画智能体动作作用下环境随时间演化的动态过程。
3.3 世界模型:物理世界动力学与演化预测
世界模型进一步将网络智能从感知与理解拓展至预测与规划层面。其核心目标是学习在智能体动作条件下环境与系统状态的演化动力学,尤其是基于物理一致性约束对状态转移过程进行建模,从而构建适用于多步推理与仿真的内部世界表征。在LAWNs中,该能力使系统能够刻画无人机动作及资源分配决策对后续物理环境与网络状态的影响,为滚动规划、风险评估以及长期优化提供关键支撑。不同于主要依赖观测信息的语言模型与视觉模型,世界模型强调对物理过程与状态演化的连续建模,从而推动LAWNs向模型驱动的自主控制范式演进。
综上所述,语言模型、视觉模型与世界模型分别对应LAWNs中的三类核心能力:语义理解、环境感知与动态预测。语言模型用于解析任务目标并形成语义表示,视觉模型用于刻画物理环境与场景状态,而世界模型用于建模物理世界动力学以支持预测与规划。三者共同构成从理解与感知到动态预测的演进路径,为实现自主、可验证的低空无线网络系统奠定基础。
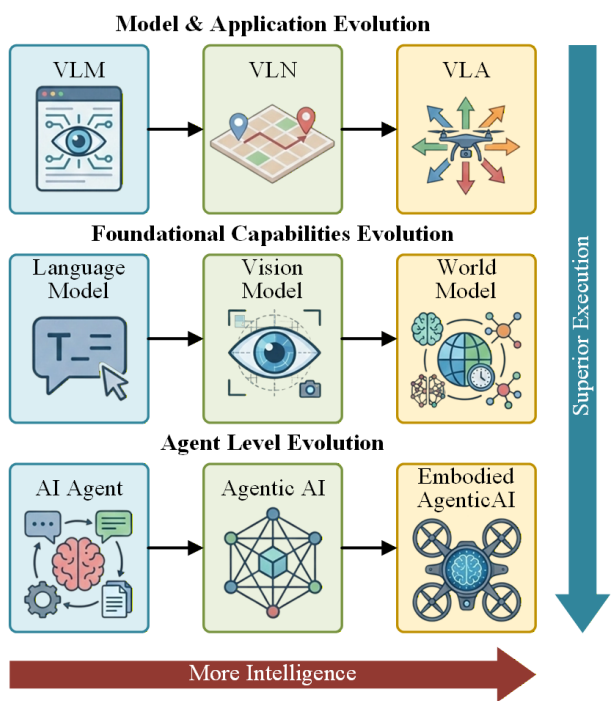
图1:面向LAWNs的具身智能体人工智能发展路线图
****4.从AI Agent到Agentic AI再到Embodied Agentic AI:从虚拟到物理智能体的演进
为实现高效的实时控制与长期优化,LAWNs需要一种更为先进的智能体系结构,该结构不仅超越高层任务理解与决策推理,还需进一步融合环境感知、交互与自我优化能力。因此,AI Agents、Agentic AI以及Embodied Agentic AI共同构成了一个从任务认知到自主控制的渐进式框架,推动LAWNs向更高水平的自主性、智能性与可解释性演进。
4.1 AI Agent:面向任务的智能
在LAWNs中,AI Agent通常以LLMs为核心,代表网络智能的初始阶段。其主要能力包括任务理解、意图解析、策略生成与优化。此类智能体能够接收自然语言指令,并将其转化为结构化的网络意图、操作约束与决策方案。通过利用知识推理与学习得到的经验模式,它们可以对复杂任务进行分解,生成高层控制建议,并通过反馈实现有限的在线自适应。然而,这类智能体仍然属于"非具身"的认知实体,既无法直接感知物理环境,也未显式建模其决策对飞行轨迹、网络拓扑演化及安全状态的影响。
4.2 Agentic AI:协同多智能体智能
随着多智能体系统的引入,低空网络智能从静态认知智能体演进为智能体式人工智能,其特征表现为通过协同机制实现持续感知、反馈与策略自适应更新。在此类系统中,部分智能体专注于利用多模态感知(如空中视觉与雷达)进行实时环境感知,以获取环境地图、障碍分布、交通状态及风险区域;另一些智能体则基于感知信息进行规划、决策与反思推理。通过这种协同结构,Agentic AI能够持续将任务目标与动态环境状态耦合,实现灵活且具上下文感知能力的决策更新。然而,其整体机制仍主要遵循"感知--响应"范式,缺乏对长期演化过程及因果效应的深度建模能力。
4.3 Embodied Agentic AI:世界模型驱动的物理智能体****
当视觉--语言--动作模型与世界模型融入Agentic AI框架后,LAWNs进一步演化为具身智能体人工智能,形成由感知、决策、动作、反馈与优化构成的闭环自治机制。世界模型通过学习并仿真潜在网络状态与动态机制,刻画无人机轨迹、信道演化、能量消耗与任务效用之间的因果关系。因此,智能体不仅能够感知环境,还能够在仿真环境中进行多步反事实推理,预测不同动作选择对网络性能与安全风险的长期影响。同时,VLA模块作为动作执行层,直接生成与物理接口对齐的可执行控制指令。通过该融合机制,网络控制从被动响应转变为可预测、可验证且持续优化的自主行为。
综上所述,低空无线网络的智能能力从基于语言的任务认知,演进至协同决策,再发展至由世界模型驱动的自主控制。基于语言模型的智能体为任务理解与决策表达奠定基础,多智能体协同机制实现自适应行为,而世界模型与VLA的融合则使智能体能够预测未来并执行相应动作。这一演进路径为构建长期自主且鲁棒的低空无线网络系统提供了清晰框架。
5. 具身智能体无人机框架
如图2所示,具身智能体无人机框架(Embodied Agentic UAV framework)由五个关键模块构成:多模态数据感知、VLA模块、世界模型(WM)、记忆与反思机制以及具身执行器。上述组件协同工作,共同支撑低空无线网络(LAWNs)中的自主感知、决策与闭环控制能力。
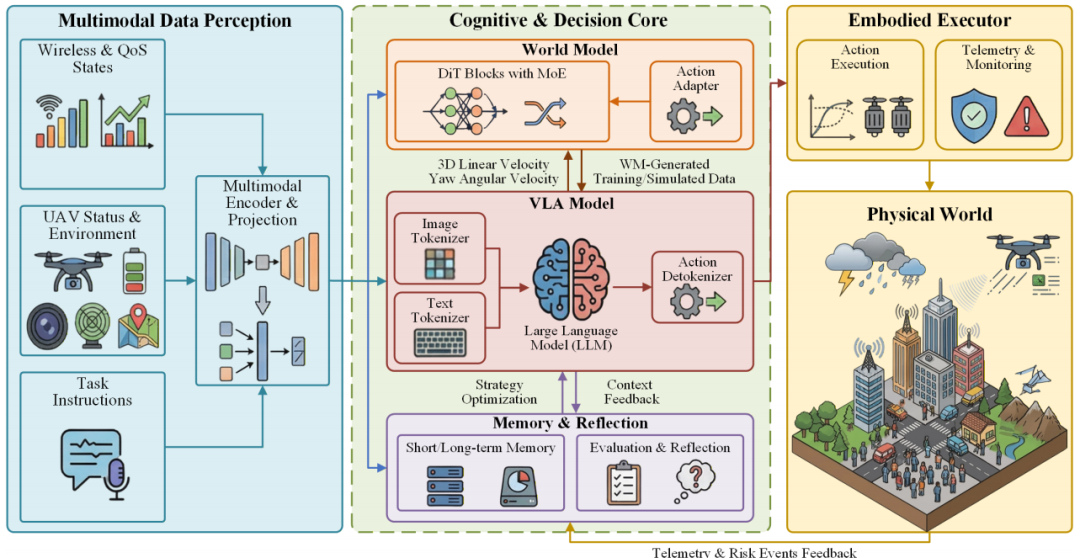
图2:具身智能体无人机框架系统架构
5.1 多模态数据感知
该框架首先构建面向LAWNs的多模态感知层,以提供统一且可靠的环境与网络状态输入。
1)数据获取:该层从物理环境与网络运行状态中采集异构信息,具体包括:无线测量信息(如信道质量统计、干扰水平与队列长度指标)、无人机状态数据(如飞行姿态、速度、高度、电池电量及机载设备温度)、环境感知数据(如相机图像、雷达信号及地图信息),以及服务质量(Quality-of-Service, QoS)需求等。这些信息共同构成系统的全局态势感知基础,为后续决策与控制提供支撑。
2)数据预处理:为保证异构感知源之间的一致性,系统执行数据对齐、去噪、缺失值补全以及异常检测,从而实现精确的时间同步并消除噪声与冗余信息。处理后的多模态输入通过多模态编码器进行表示学习,生成统一的状态表示。随后,投影模块进一步完成特征融合,将原始多模态观测映射为适用于下游决策与优化的高质量状态特征。
5.2 VLA
VLA模型通过融合视觉编码与语言推理能力,使无人机在复杂环境中具备自主导航与实时决策能力。
1)模型架构:如图3所示,VLA模型采用从多模态输入到动作输出的端到端架构。具体而言,无人机摄像头采集的第一视角(FPV)图像与自然语言任务指令首先输入至模型输入层。视觉与文本信息分别经过图像分词器与文本分词器处理,并映射至共享表示空间,以便在LLM中进行联合推理。在融合后的多模态表示基础上,动作解码器(action detokenizer)生成可执行控制输出,包括三维线速度与偏航角速度。相较于传统基于航路点(waypoint-based)的规划方法,该架构能够直接生成低层控制指令,实现对动态环境的连续自适应调节与高效轨迹控制。
2)训练与部署:在训练阶段,VLA模型同时利用真实飞行数据与世界模型(WM)生成的仿真数据进行学习,数据形式包括FPV图像、视频序列及对应任务指令。训练过程首先采用监督学习建立多模态输入到动作输出的基本映射关系,随后通过微调与强化学习进一步提升模型在动态环境下的控制性能。为提高训练效率与推理速度,引入LoRA(Low-Rank Adaptation)进行参数高效微调;在部署阶段采用量化技术降低计算开销。上述优化策略使得模型能够在受限机载计算资源条件下实现高效实时决策与控制,从而支持无人机在复杂环境中的快速响应能力。
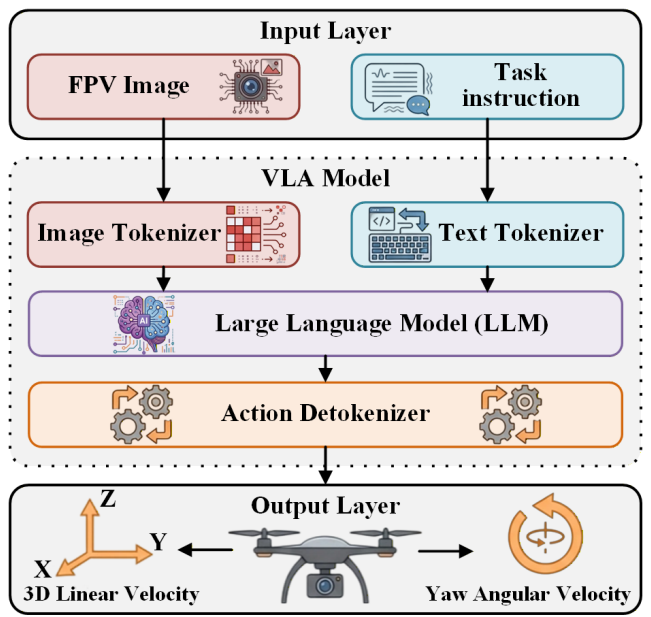
图3:端到端VLA流程:从多模态输入到动作输出
5.3 World Model
本文提出的世界模型作为LAWNs的预测性环境建模模块,使无人机能够在动作与指令条件下,对飞行过程及物理世界演化进行交互式仿真。
1)模型架构:该世界模型以扩散Transformer( DiT)为骨干网络,并引入混合专家机制(MoE),以在提升生成能力的同时保持计算效率。如图4所示,模型输入层由图像与视频观测、带噪潜变量以及动作--指令条件共同构成。这些输入被送入堆叠的DiT模块进行联合建模,其中:自注意力机制用于捕获潜在表示中的全局依赖关系;基于动作条件的自适应层归一化通过尺度与偏移调制注入控制信息;交叉注意力机制实现潜在状态与外部条件之间的对齐;前馈网络进一步对隐藏特征进行精炼。DiT骨干网络输出视频潜变量表示,随后由潜变量解码器重建为未来的模拟观测结果。基于该设计,世界模型能够实现具有长期时间一致性与空间记忆能力的交互式世界仿真,从而刻画智能体动作对未来环境演化的影响机制。
2)训练策略:世界模型采用多阶段渐进式训练策略。首先,引入在大规模数据集上预训练的DiT基础模型作为先验,以保证静态物理环境生成的高保真性。随后,在大部分冻结骨干参数的基础上,对动作适配器进行微调,使模型逐步从短时序生成扩展至长时序状态演化建模,从而获得动作条件下的长期时间一致性与响应能力。在训练后期,重点优化模型的实时性与稳定性。通过引入分布匹配蒸馏(DMD)与基于辅助判别器的对抗优化机制,实现对扩散采样步骤的压缩,从而降低推理延迟,并支持实时交互式仿真。
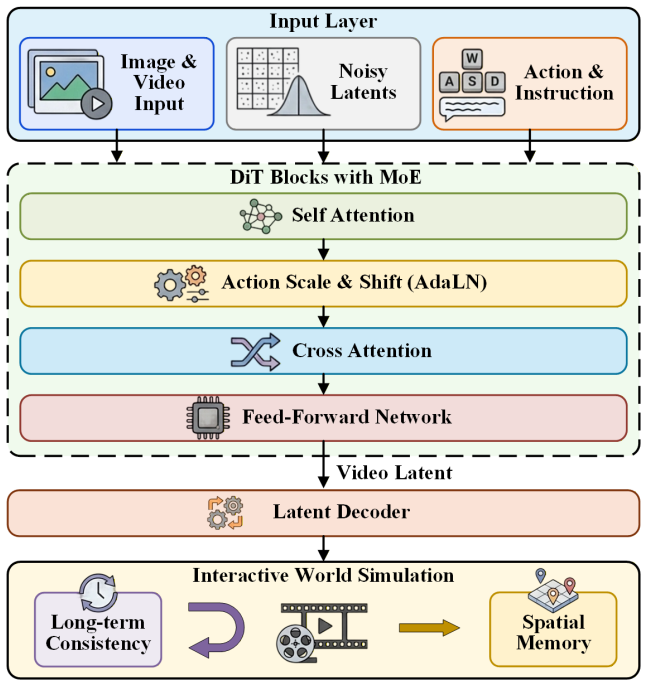
图4:用于交互式世界仿真的基于DiT的世界模型架构
5.4 记忆与反思机制
1)记忆增强模块:记忆模块通过层次化结构设计提升决策效率与质量,包括短期工作记忆与长期经验记忆两部分。短期记忆用于存储与当前情境相似的近期状态信息,为VLA智能体提供上下文相关参考,从而支持基于上下文的快速推理并提升响应效率。长期记忆则用于存储历史任务经验与策略优化轨迹,包括成功策略、失败案例以及跨场景领域知识等。这些经验为后续评估与反思过程提供重要依据,从而支持决策质量的持续改进。
2)评估与反思模块:评估与反思模块负责对执行结果进行实时评估,并生成可解释的决策依据。在动作执行完成后,该模块基于任务完成情况、时延以及能耗等关键指标对系统性能进行评估。同时,结合世界模型的预测能力,对潜在策略进行前瞻性分析,从而生成改进策略,并形成结构化解释,包括"为何采取该动作""预期收益"以及"潜在风险"等内容。这些反馈信息作为可验证证据被写入长期记忆,并以结构化形式进行存储。通过经验置信度的持续累积与更新,系统能够逐步优化决策策略,从而在长期运行过程中实现更加稳定与鲁棒的控制与决策能力。
5.5 具身执行器
具身执行器为真实无人机网络提供确定性时延与高可靠性的执行能力,并将运行状态与风险事件反馈至上层模块,以支持闭环优化。
1)动作执行模块:该模块对VLA模型输出的动作向量进行标准化与封装,并执行协议适配,将其映射为飞行控制模块可直接解析的控制指令序列。在飞控层中,轨迹跟踪控制器将高层控制指令转换为电机推力与姿态控制信号,从而实现对滚转、俯仰、偏航及高度的闭环控制。在严格控制频率约束下,无人机能够在满足实时性、可重复性与安全性要求的同时保持稳定飞行,适用于低空复杂运行环境。
2)遥测与监控模块:该模块主要承担两类功能。首先,其负责采集并传输关键遥测数据,包括姿态、速度、高度、剩余电量、设备温度、链路质量、吞吐量与时延等,用于支撑评估与反思模块的决策分析。其次,其提供实时安全监测与决策仲裁功能,通过持续检测禁飞区、碰撞风险以及速度/高度约束,实现对系统运行状态的安全约束。当检测到安全违规时,系统将自动降级或重写控制指令,并触发备份策略,从而确保系统在严格安全约束下稳定运行。此外,该模块还为VLA反馈学习与世界模型校准提供可靠且可审计的真实运行数据支持。
6. 实验结果
6.1 实验设置
本文构建了一个仿真环境,用于评估所提出的具身智能体无人机框架的性能。其中,VLA模块基于OpenVLA-7B模型实现,并采用LoRA方法进行参数高效微调。世界模型采用开源LingBot-World架构,该架构集成高噪声与低噪声专家模块,总参数规模约为28B。
VLA微调数据集基于RaceVLA数据集构建,该数据集包含无人机第一视角图像、对应的四维动作向量以及自然语言任务描述。在实验设置中,沿用RaceVLA中的无人机动力学模型与信道模型进行仿真构建。数据集按照70%与30%的比例划分为训练集与测试集。每个任务独立运行100次实验,并在5个随机种子下取平均结果以保证统计可靠性。为提升数据多样性与模型泛化能力,额外利用世界模型生成了50%的合成数据,并将其纳入训练过程。记忆模块基于Milvus向量数据库实现,反思模块则由DeepSeek R1模型驱动。实验在硬件平台上完成,该平台配置为Intel Xeon Gold CPU(2.6 GHz)以及两块NVIDIA A800 GPU(单卡80 GB显存)。
我们首先评估VLA模块将自然语言指令与多模态感知输入映射为可执行飞行动作的能力,重点关注其准确性与鲁棒性。该任务要求无人机在满足给定指令的前提下无碰撞到达单一目标区域。本文所提出的VLA模型与RT-2-X 及OpenVLA 进行对比。评价指标采用成功率(SR),其定义为:在满足指令要求且无碰撞条件下,无人机成功完成任务的实验比例。实验在三类泛化任务下进行评估:(1)目标泛化任务(Target-Gen Task):在未见过的目标位置上的成功率;(2)指令泛化任务(Instr-Gen Task):在未见过的语言指令条件下的成功率;(3)环境泛化任务(Env-Gen Task):在未见过的环境与背景条件下的成功率。如图5所示,本文VLA模型在三类泛化任务中均取得最高成功率(SR),相较现有基线方法在指令对齐能力与实时动作生成能力方面表现出显著优势。
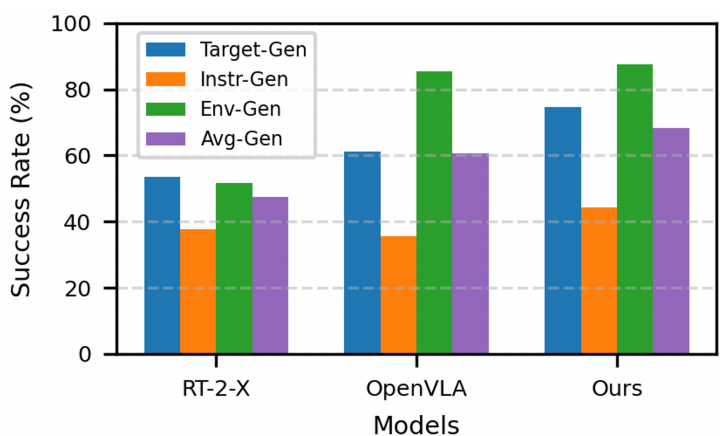
图5:VLA模型在三种泛化任务下的成功率对比
进一步地,我们评估完整具身智能体无人机系统的整体性能,该系统集成了世界模型(WM)以及记忆--反思机制。在该实验设置中,无人机需要在无碰撞约束下依次到达多个目标区域。对比方法包括:(1)仅VLA模型;(2)VLA + 记忆与反思模块;(3)本文方法(VLA + Memory + WM)。评价指标采用完成率(Completion Rate, CR),其定义为在无碰撞条件下成功到达目标区域数量与总目标区域数量之比。如图6所示,本文方法在所有基线方法中取得最高完成率(CR)。该性能提升主要来源于世界模型与记忆机制的协同作用:具体而言,世界模型能够在内部对不同动作序列的潜在结果进行仿真,从而为策略调整提供可验证的前瞻性预测;同时,记忆模块能够从相似历史场景中检索相关策略与失败案例,从而辅助决策生成并提升系统的稳定性与鲁棒性。
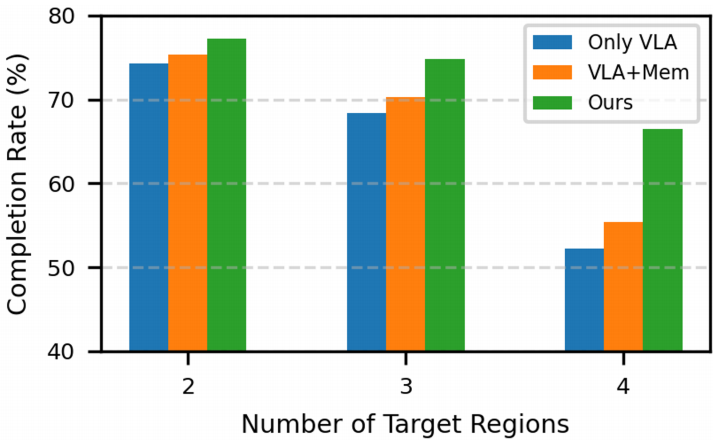
图6:空中智能体式人工智能的典型应用场景
7. 开放问题
**1)VLA推理时延:**在LAWNs中,VLA模块需要将高层任务指令与多模态观测信息实时映射为连续控制指令。然而,当前VLA实现通常依赖自回归推理,其时延波动主要由上下文长度与视觉编码开销引起。如何在不显著降低决策质量的前提下实现低时延、低抖动的稳定执行,是一个关键挑战。潜在方向包括并行或非自回归动作预测、边云协同推理,以及模型蒸馏与量化,以实现稳定的实时无人机控制。
**2)世界模型累积误差:**世界模型通过学习环境与系统动力学支持滚动预测与规划,但其在LAWNs中的预测过程容易受到累积误差影响。无人机运动与能耗的非线性与时变特性使得多步预测中的近似误差不断放大。此外,动态遮挡与外部扰动等未建模因素进一步加剧偏差,使长时域预测逐渐偏离真实轨迹。如何显式建模并抑制该类累积误差仍是一个重要开放问题。
**3)智能体学习稳定性:**在长期部署场景中,无人机智能体需要在非平稳环境中持续吸收新经验并更新策略。然而,在线更新可能引发灾难性遗忘与分布偏移,使系统难以在新场景中保持稳定性能。关键问题包括如何协调短期上下文记忆与长期经验记忆以实现受控写入、有效检索与动态更新,以及如何构建稳定的持续学习管线,在跨任务分布变化下保持鲁棒泛化与长期性能。
**4)时延-多普勒域表示:**在LAWNs中,高机动性无人机导致信道与网络状态快速变化,需要频繁更新以避免状态信息过时。这会显著增加基于VLA/WM的自主控制开销,尤其在信道相干时间较短时更为明显。一种有前景的方向是利用OTFS体制在时延-多普勒域对信道进行表征,其中信道状态通常具有稀疏性与结构性,并在高机动场景下表现出更强稳定性。这种紧凑表示有望降低状态更新开销,并为基于VLM的感知与基于WM的预测提供高效输入。
8. 结论
本文提出了一种面向LAWNs的具身智能体无人机框架,通过融合VLA、世界模型与智能体式人工智能,实现从任务语义到可执行控制的端到端闭环优化。该框架集成了多模态状态感知、基于VLA的决策机制、由WM驱动的环境仿真与策略优化,以及记忆--反思机制以实现经验的持续积累,同时具身执行器保障硬件层的稳定可靠执行。总体而言,该框架为LAWNs向预测型、可执行且可持续优化的自主网络演进提供了一条系统化路径。
